

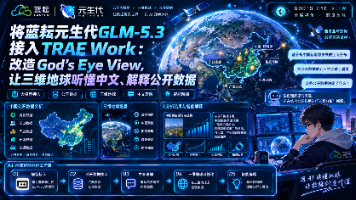
把航班、卫星和地震放在同一个三维地球上,第一眼确实很抓人.但玩过一轮后,我更想解决一个具体问题:面对一排英文图层开关,能不能直接说“飞到东京,打开航班”,再用中文问清楚屏幕上的数据来自哪里、能说明什么?这次选的是GitHub上的 God’s Eye View.God’s Eye View 是一个将航班、卫星、地震等公开数据放进可交互三维地球的开源项目.我选它,是因为模型的作用很容易被检验:操作指令有没有让地图发生变化,数据解释能不能与实际记录对应,都有直观的参照.这也让它适合用来探索 Agent 如何调用现有软件能力.我保留它的三维地图和公开数据图层,在本机TRAE Work中选用已经接好的蓝耘GLM-5.3,增加中文文字操作和数据解读入口.整个实验在本地浏览器运行.通过蓝耘 MaaS 接口为项目增加中文操作与数据解读能力.接下来会从模型配置、项目启动讲到功能改造和成果验证,也会记录一个实际遇到的问题:当航班数据源发生回退时,怎样避免模型把屏幕上的数量解释错.
目录
一、为什么选 God’s Eye View
它适合拿来做一次有结果可看的AI二次开发.地球可以旋转、缩放,城市能进入写实三维视角,飞机、卫星和地震又有各自的数据来源.改造有没有用,很容易观察:一句指令下去,镜头和图层必须真的变化,不能只在聊天框里回答“已经打开”.
我更看重的是它能同时容纳两类任务.操作类任务需要把中文转换成明确动作,例如定位城市、切换图层;解释类任务需要读取程序里已经加载的数据,再说明来源、时间和局限.模型的语言能力在这里有具体用途,地图也能给结果提供可核对的参照.
这个方向也贴近现在大家关注的Agent应用:让模型理解用户意图,再调用已有软件能力.原项目已经有地图动作入口,没必要为了接一个新模型重写Cesium.复用原有动作执行器,可以把改动集中在接口适配、参数校验和中文面板上,后续跟随上游更新时也容易定位自己的修改.
项目的视觉包装带有“卫星操作台”风格,画面里的 TOP SECRET 等文字属于界面设计.这次展示的是公开数据可视化,不代表拥有专用监控系统.原版还自带OpenAI Realtime语音交互,本次新增的是中文文字能力,文章里的“听懂中文”指理解中文指令.
二、先把蓝耘接入TRAE Work
本机在项目实测前已经完成模型配置.这里按“准备 API Key、添加自定义模型、确认启用”的顺序,把配置过程补完整.
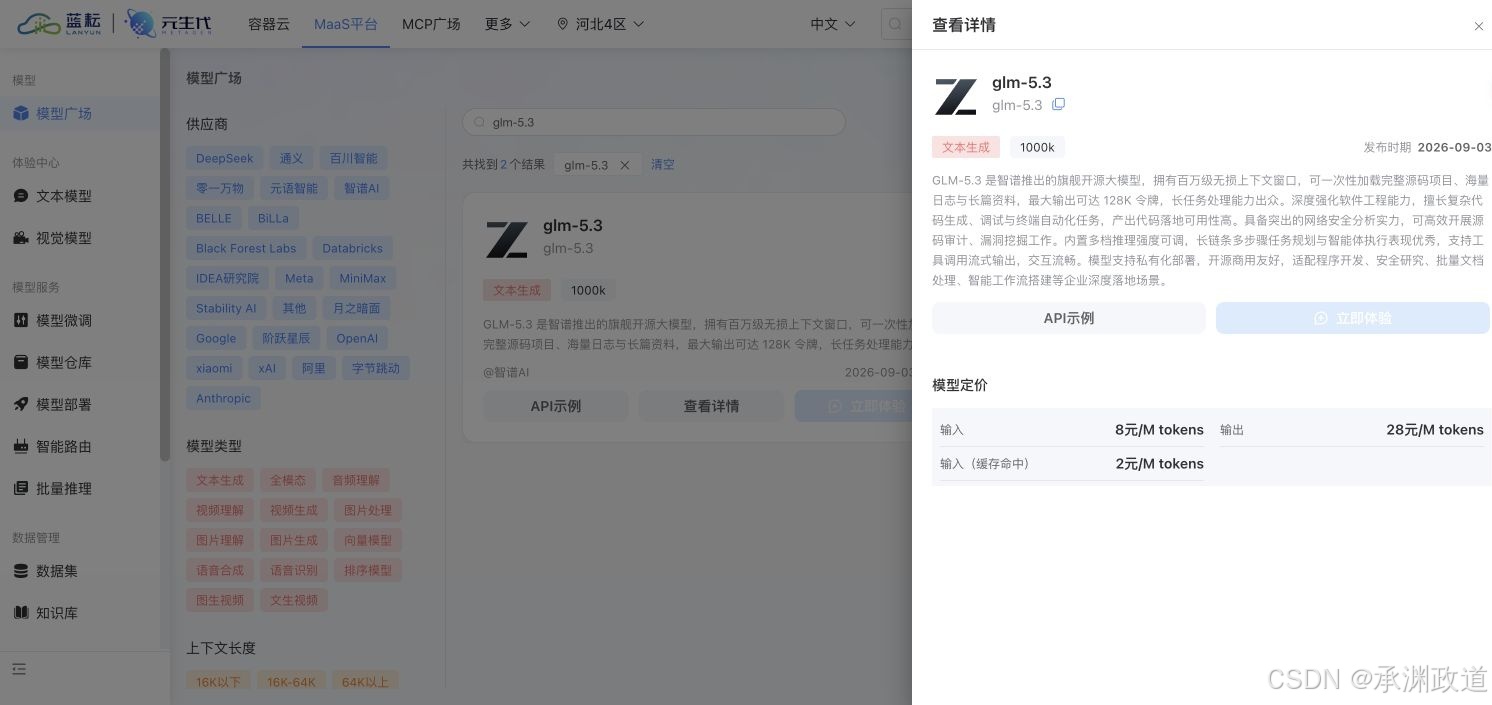
选择蓝耘的原因也很具体:本次需要的GLM-5.3可以在它的MaaS模型广场找到,同一套 Chat Completions 接口既能供TRAE Work使用,也能接进本地应用.我可以沿用同一平台的模型入口完成开发和运行,不必在两条链路里维护不同的模型接入方式.
蓝耘模型广场的模型详情还列出了输入、缓存输入和输出的单价.本文截图对应的是测试当天的页面,标价不能直接当作整次开发的总费用:TRAE 的多轮读代码、推理和项目内问答都会产生各自的调用.这次也没有做其他平台的同条件性能测试,因此不据此下“更快”或“更便宜”的结论.
(一)在蓝耘创建 API Key
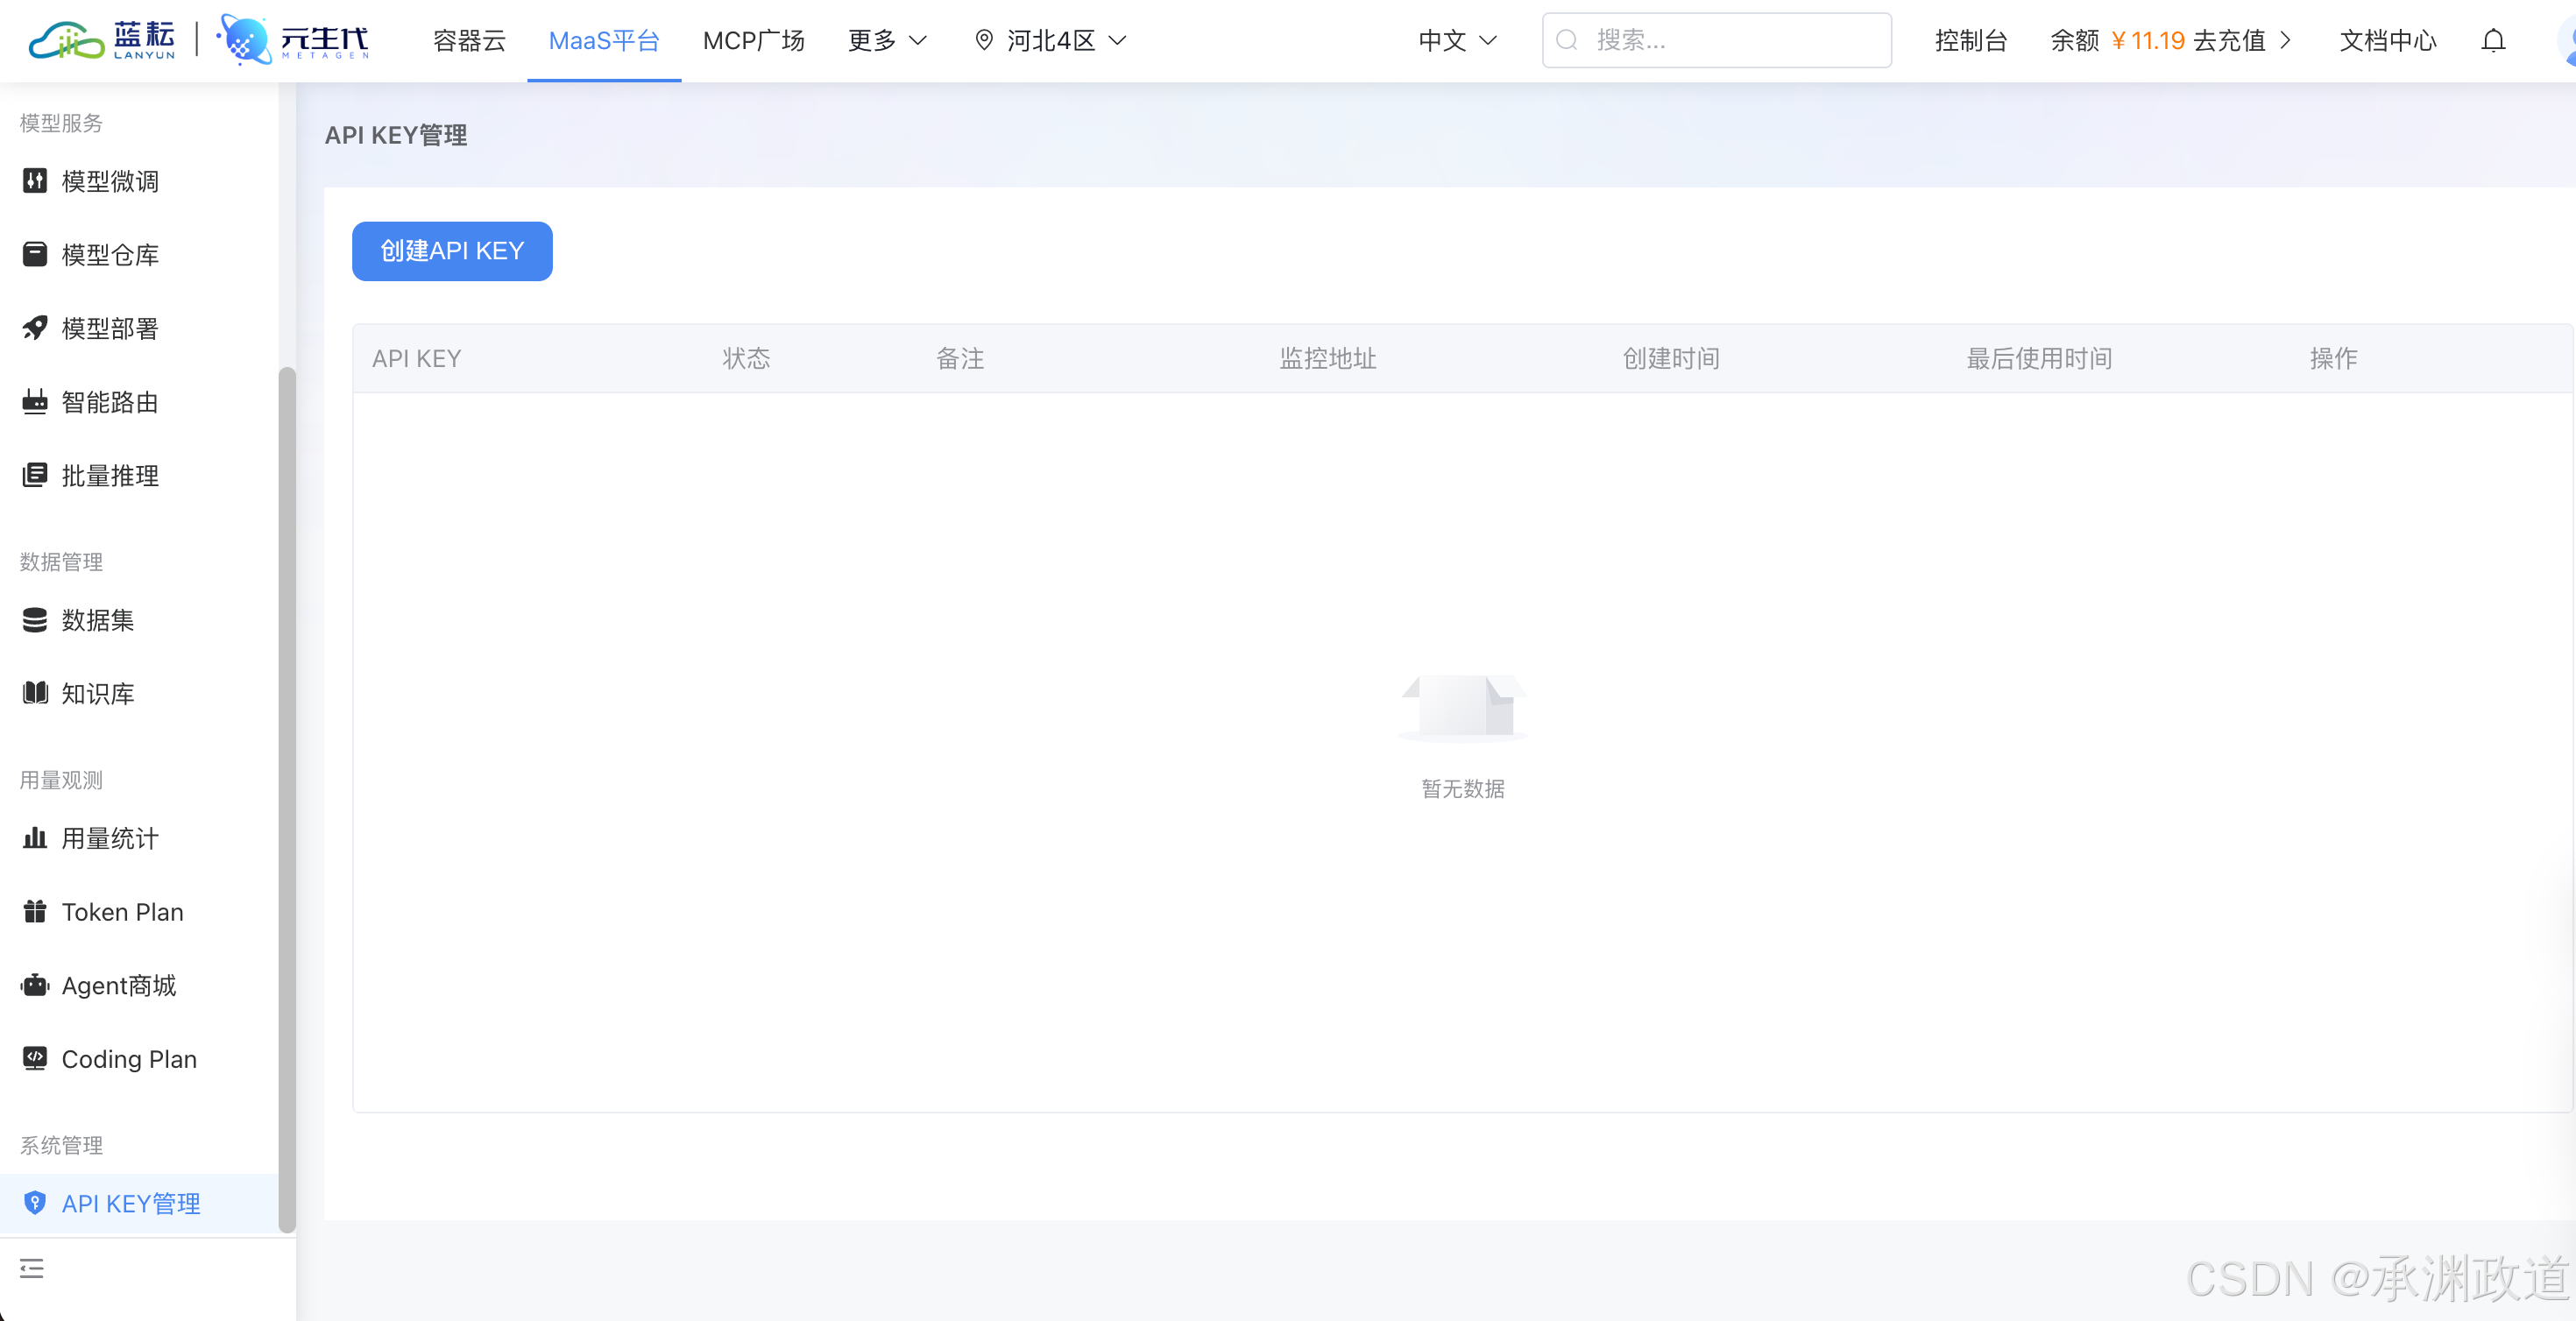
进入蓝耘 MaaS 平台,在左侧“系统管理”中打开“API KEY 管理”,点击“创建 API KEY”.下面这张图展示的是创建前的页面状态.
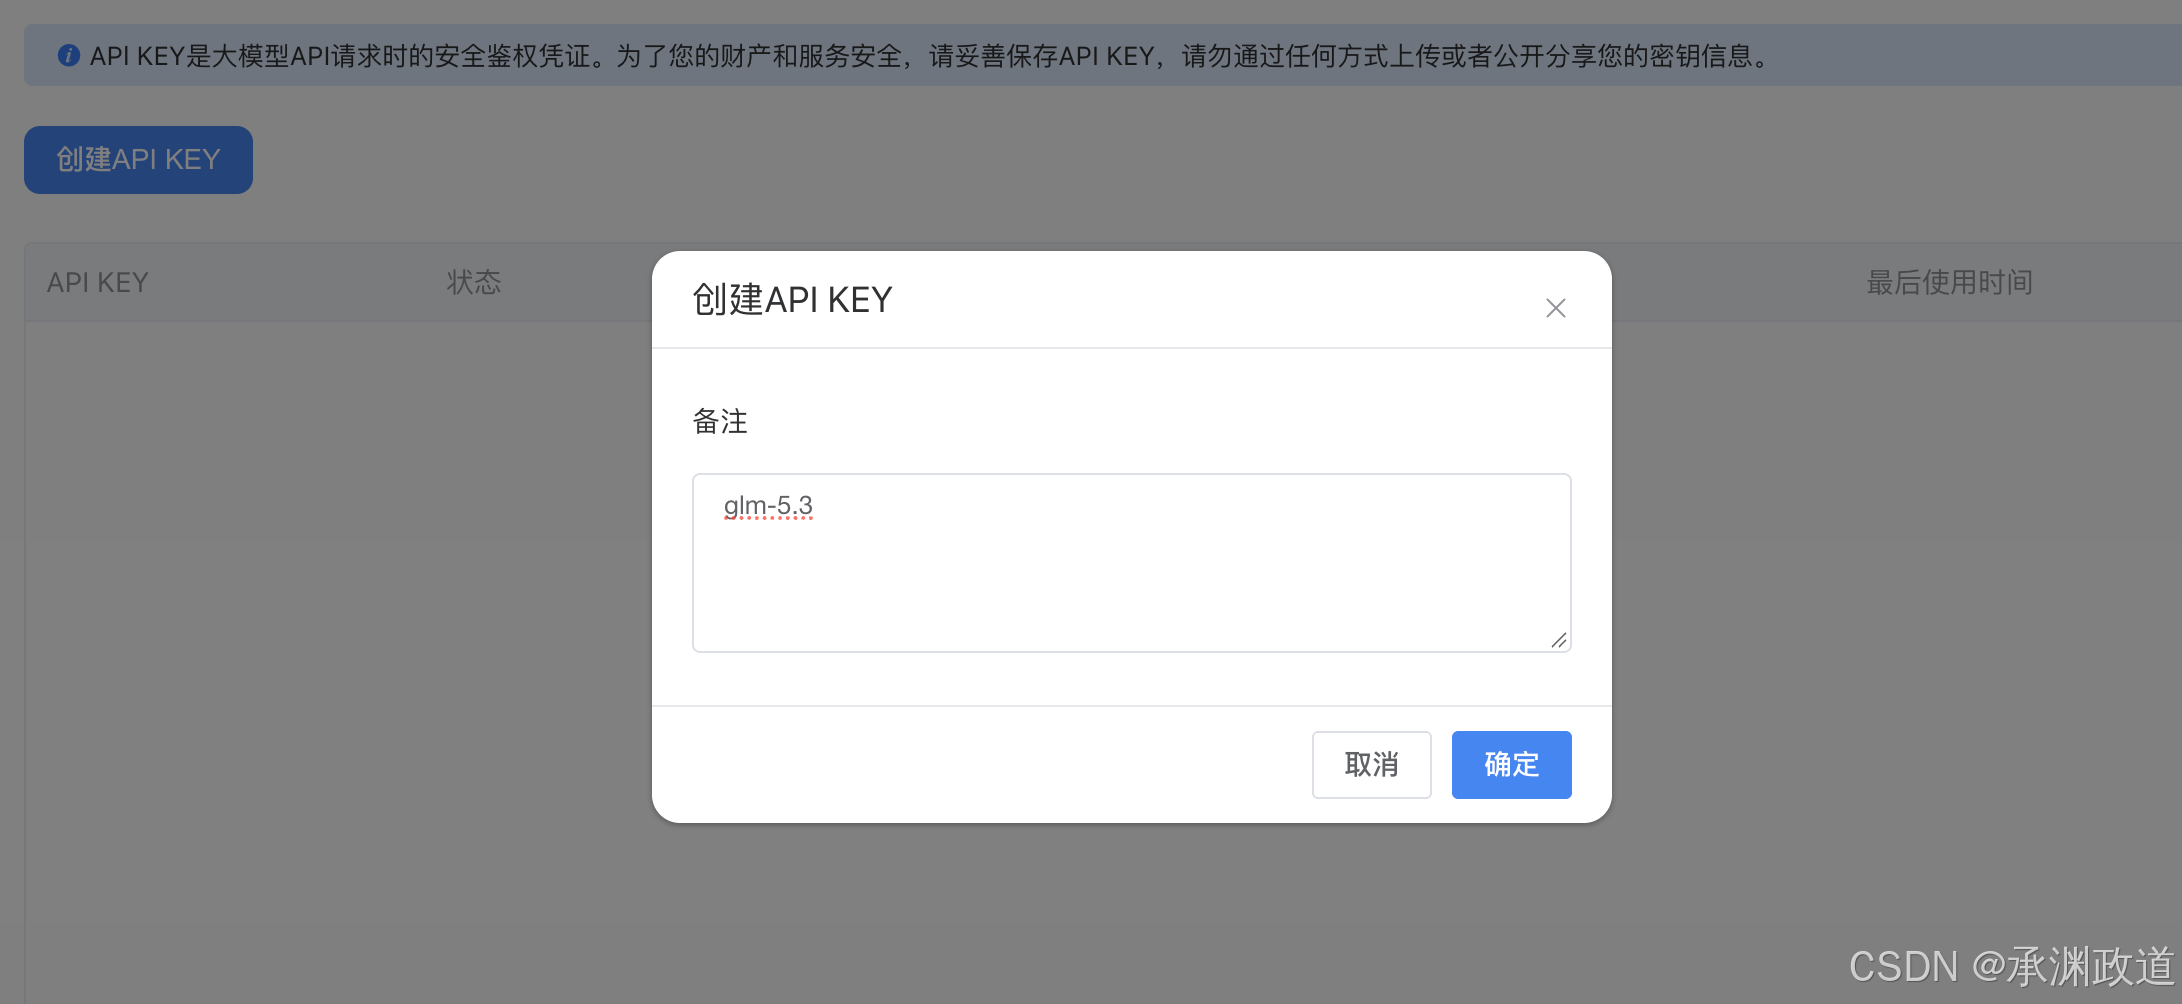
创建窗口里的备注填写为 glm-5.3,便于辨认这把 Key 的用途.这里填写的是备注,实际调用哪个模型,仍由请求中的 model 字段决定.
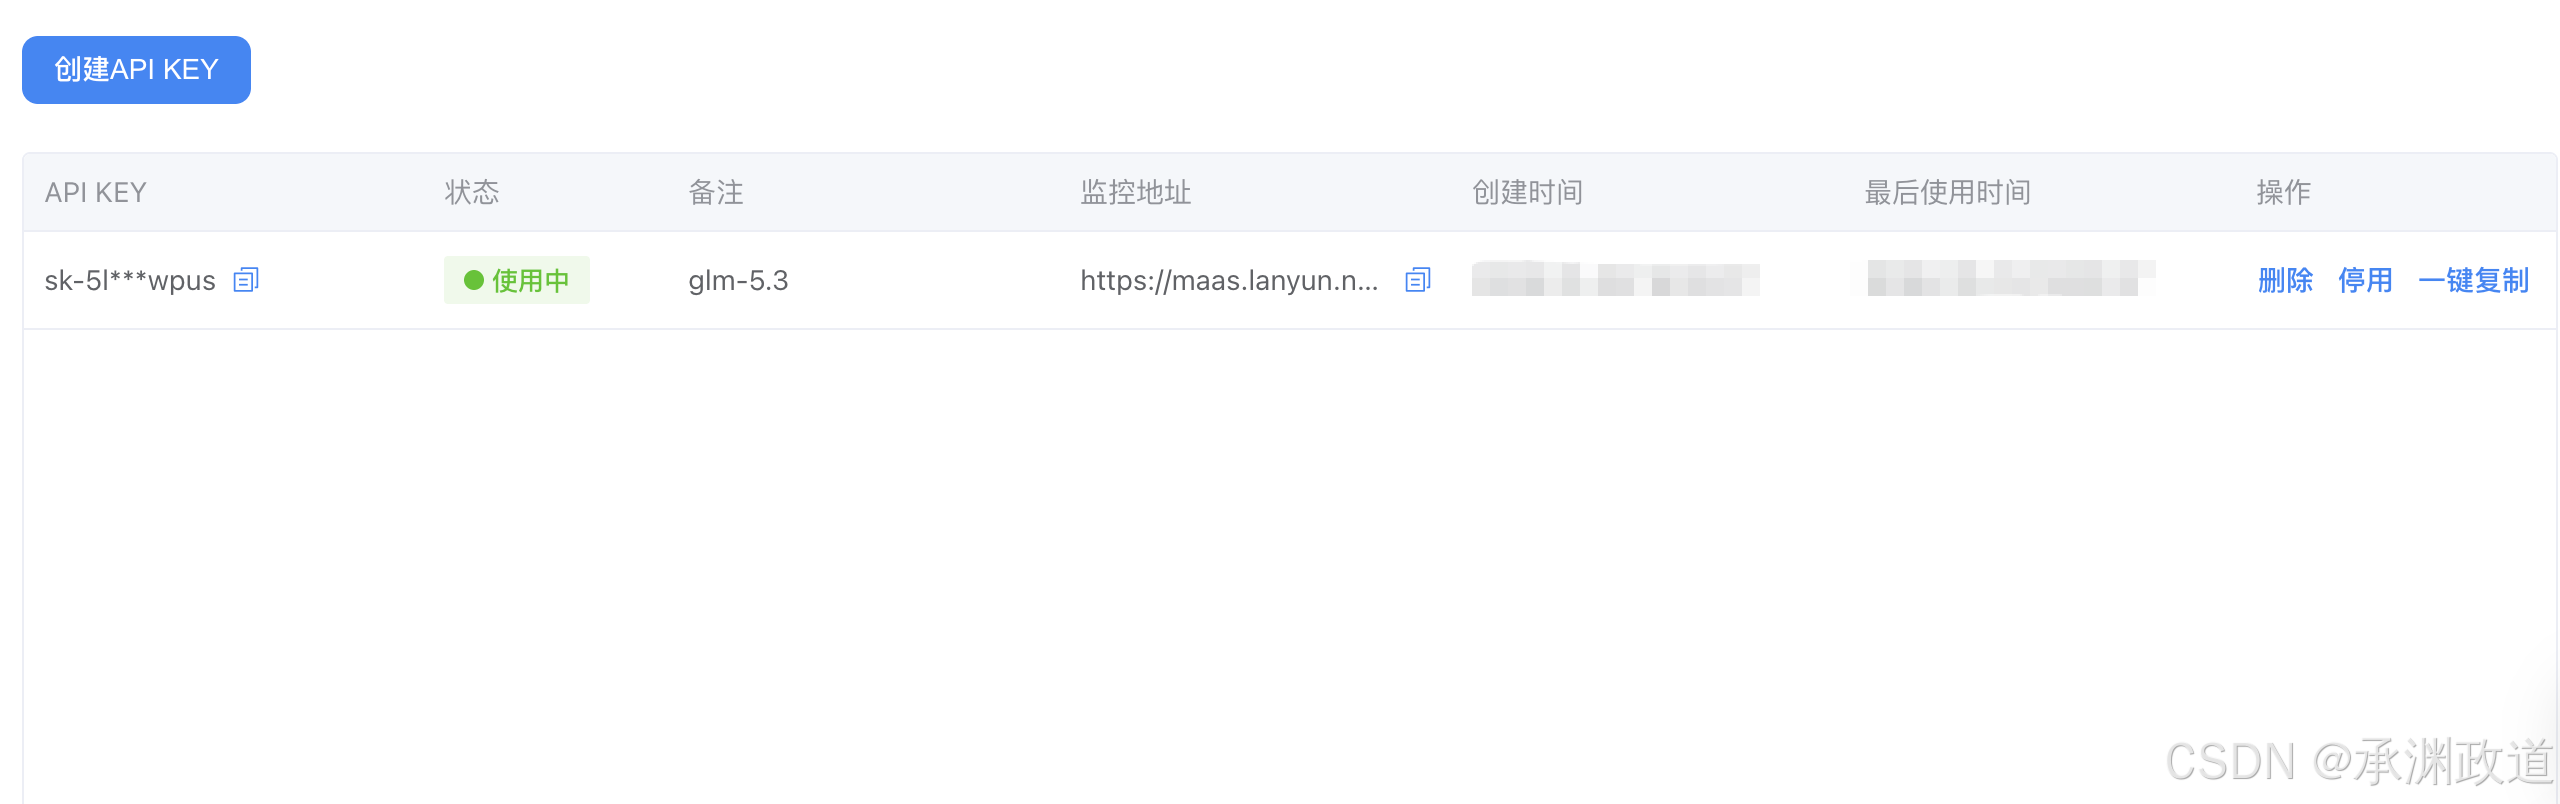
创建后,列表里出现对应记录,状态显示“使用中”.接下来把这把 Key 填入 TRAE 的“API 密钥”字段.截图中的密钥保留掩码,创建时间和最后使用时间也已遮蔽.
(二)在 TRAE Work 找到添加模型入口
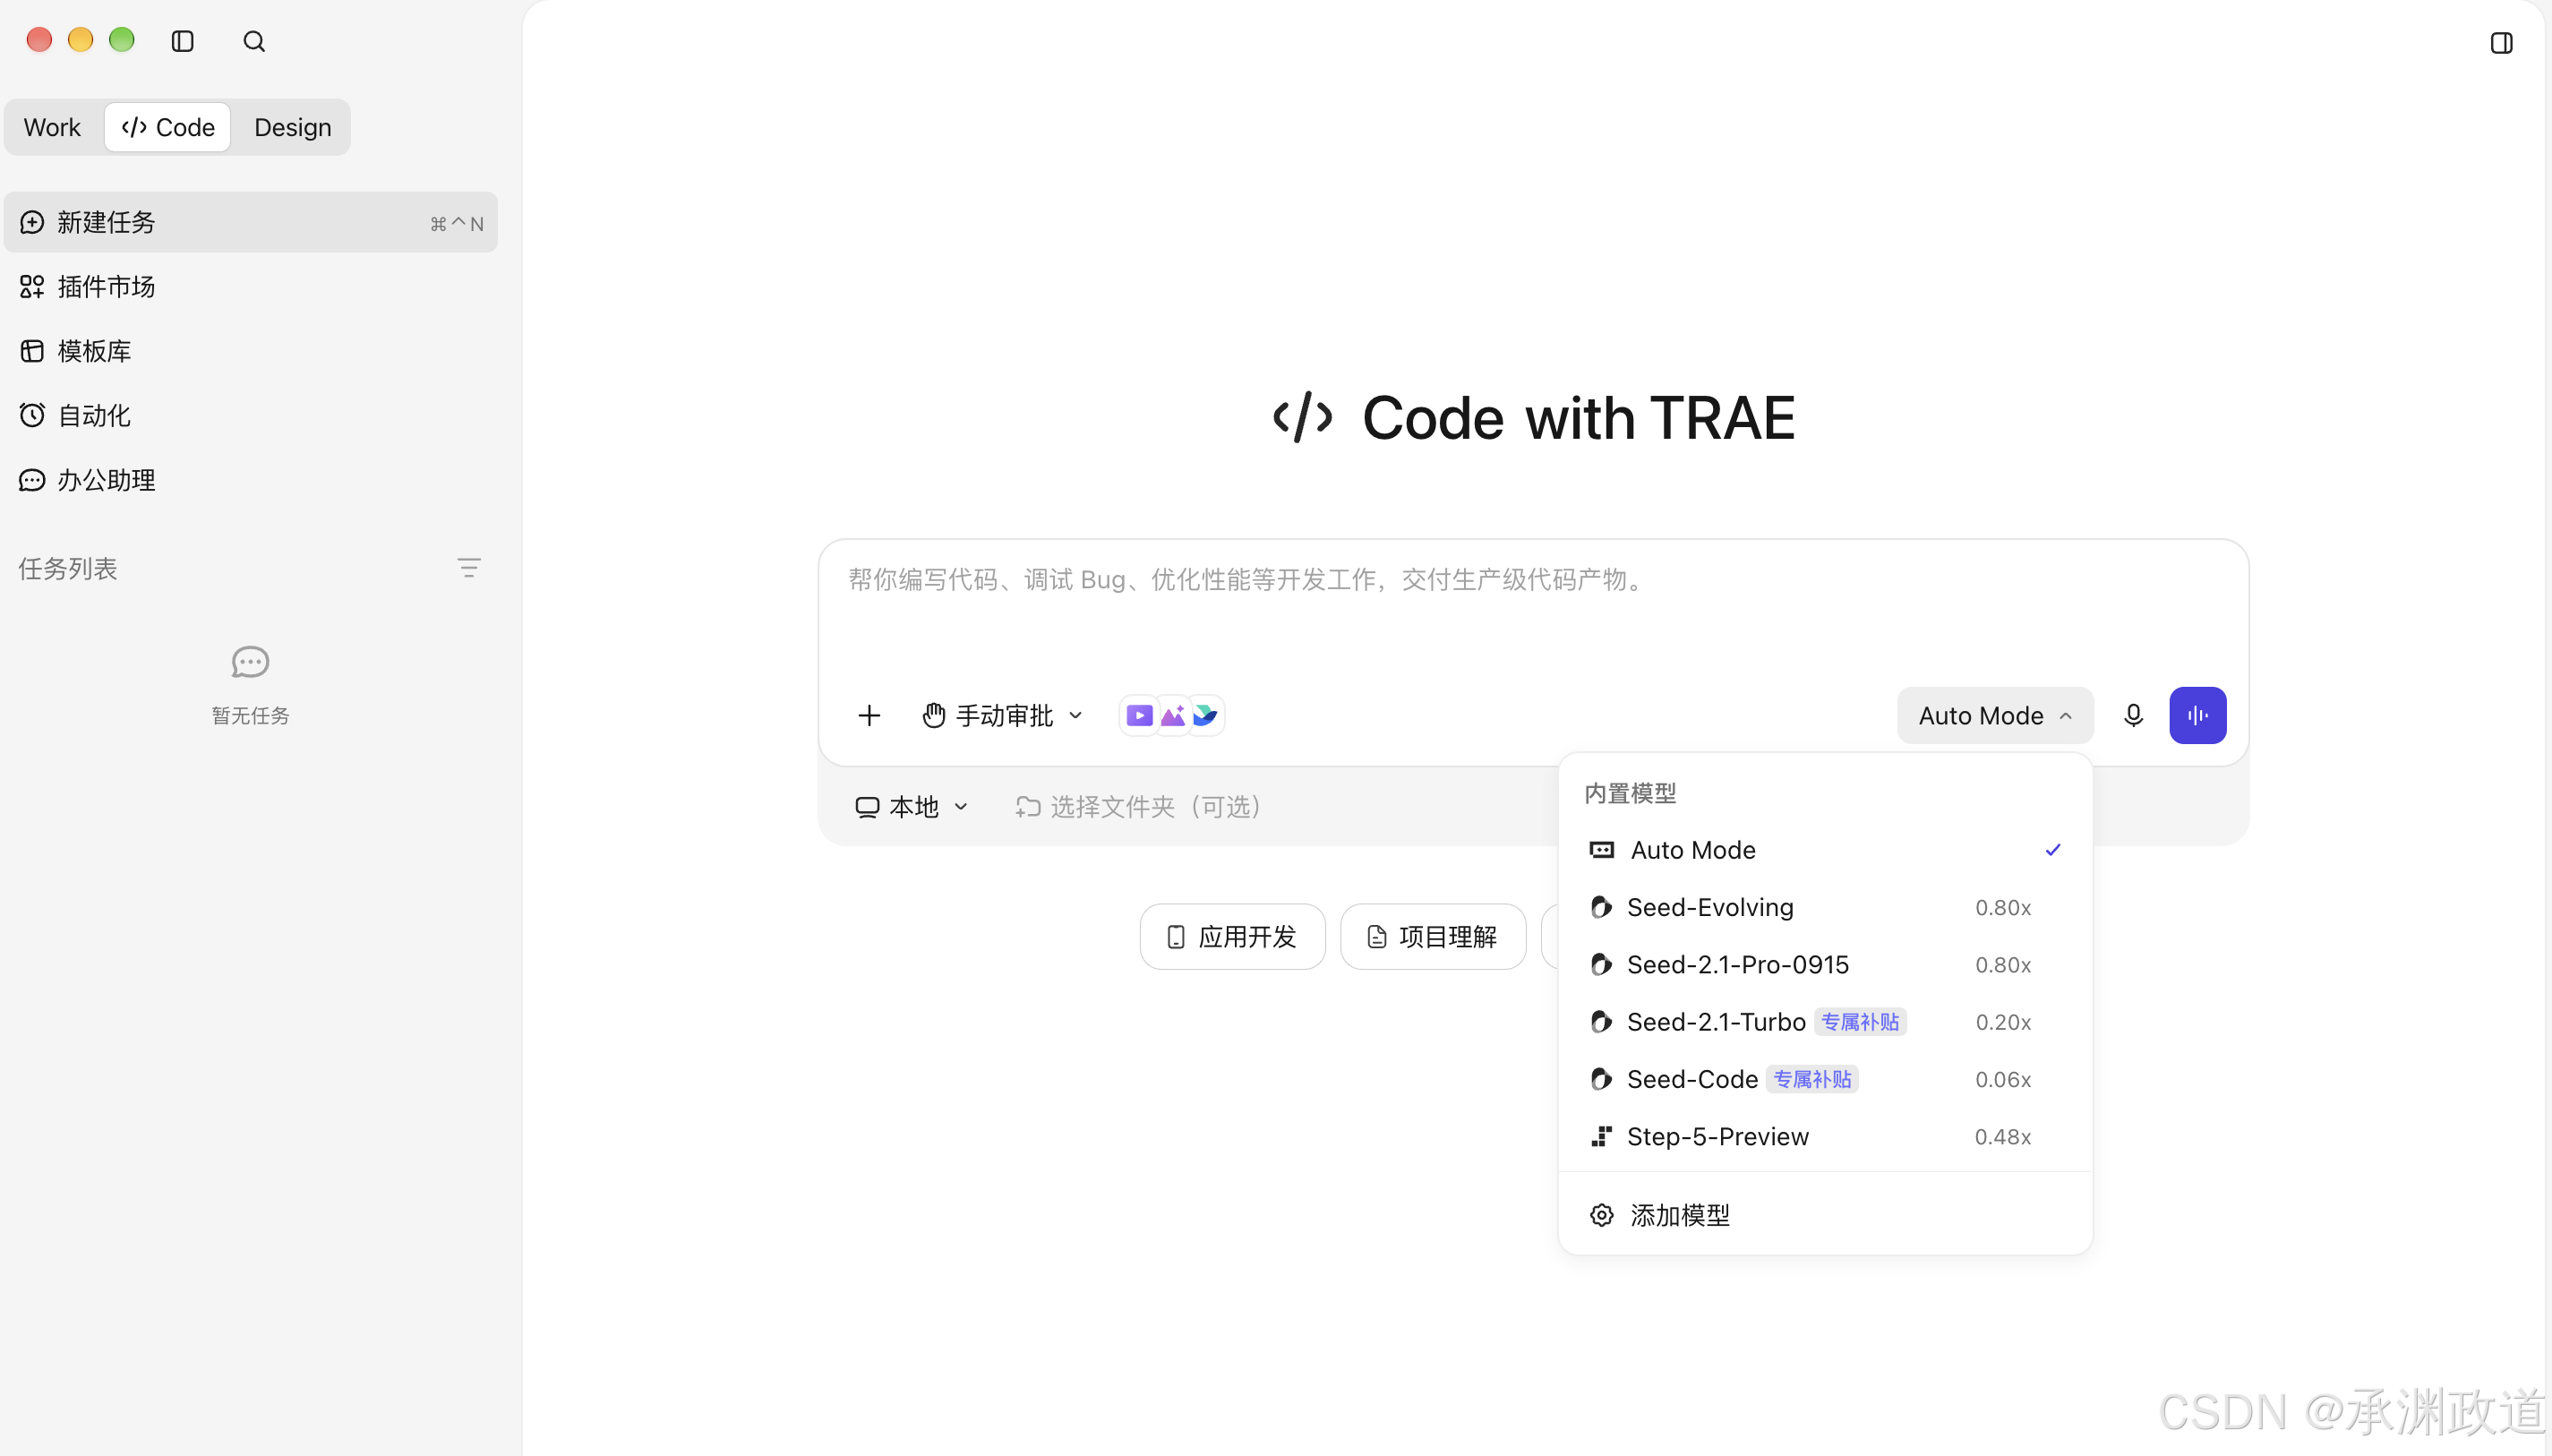
切到TRAE Work 的 Code 页,展开输入框右下方的模型菜单,点击底部“添加模型”.图中的 Auto Mode 是进入配置前的选择状态.
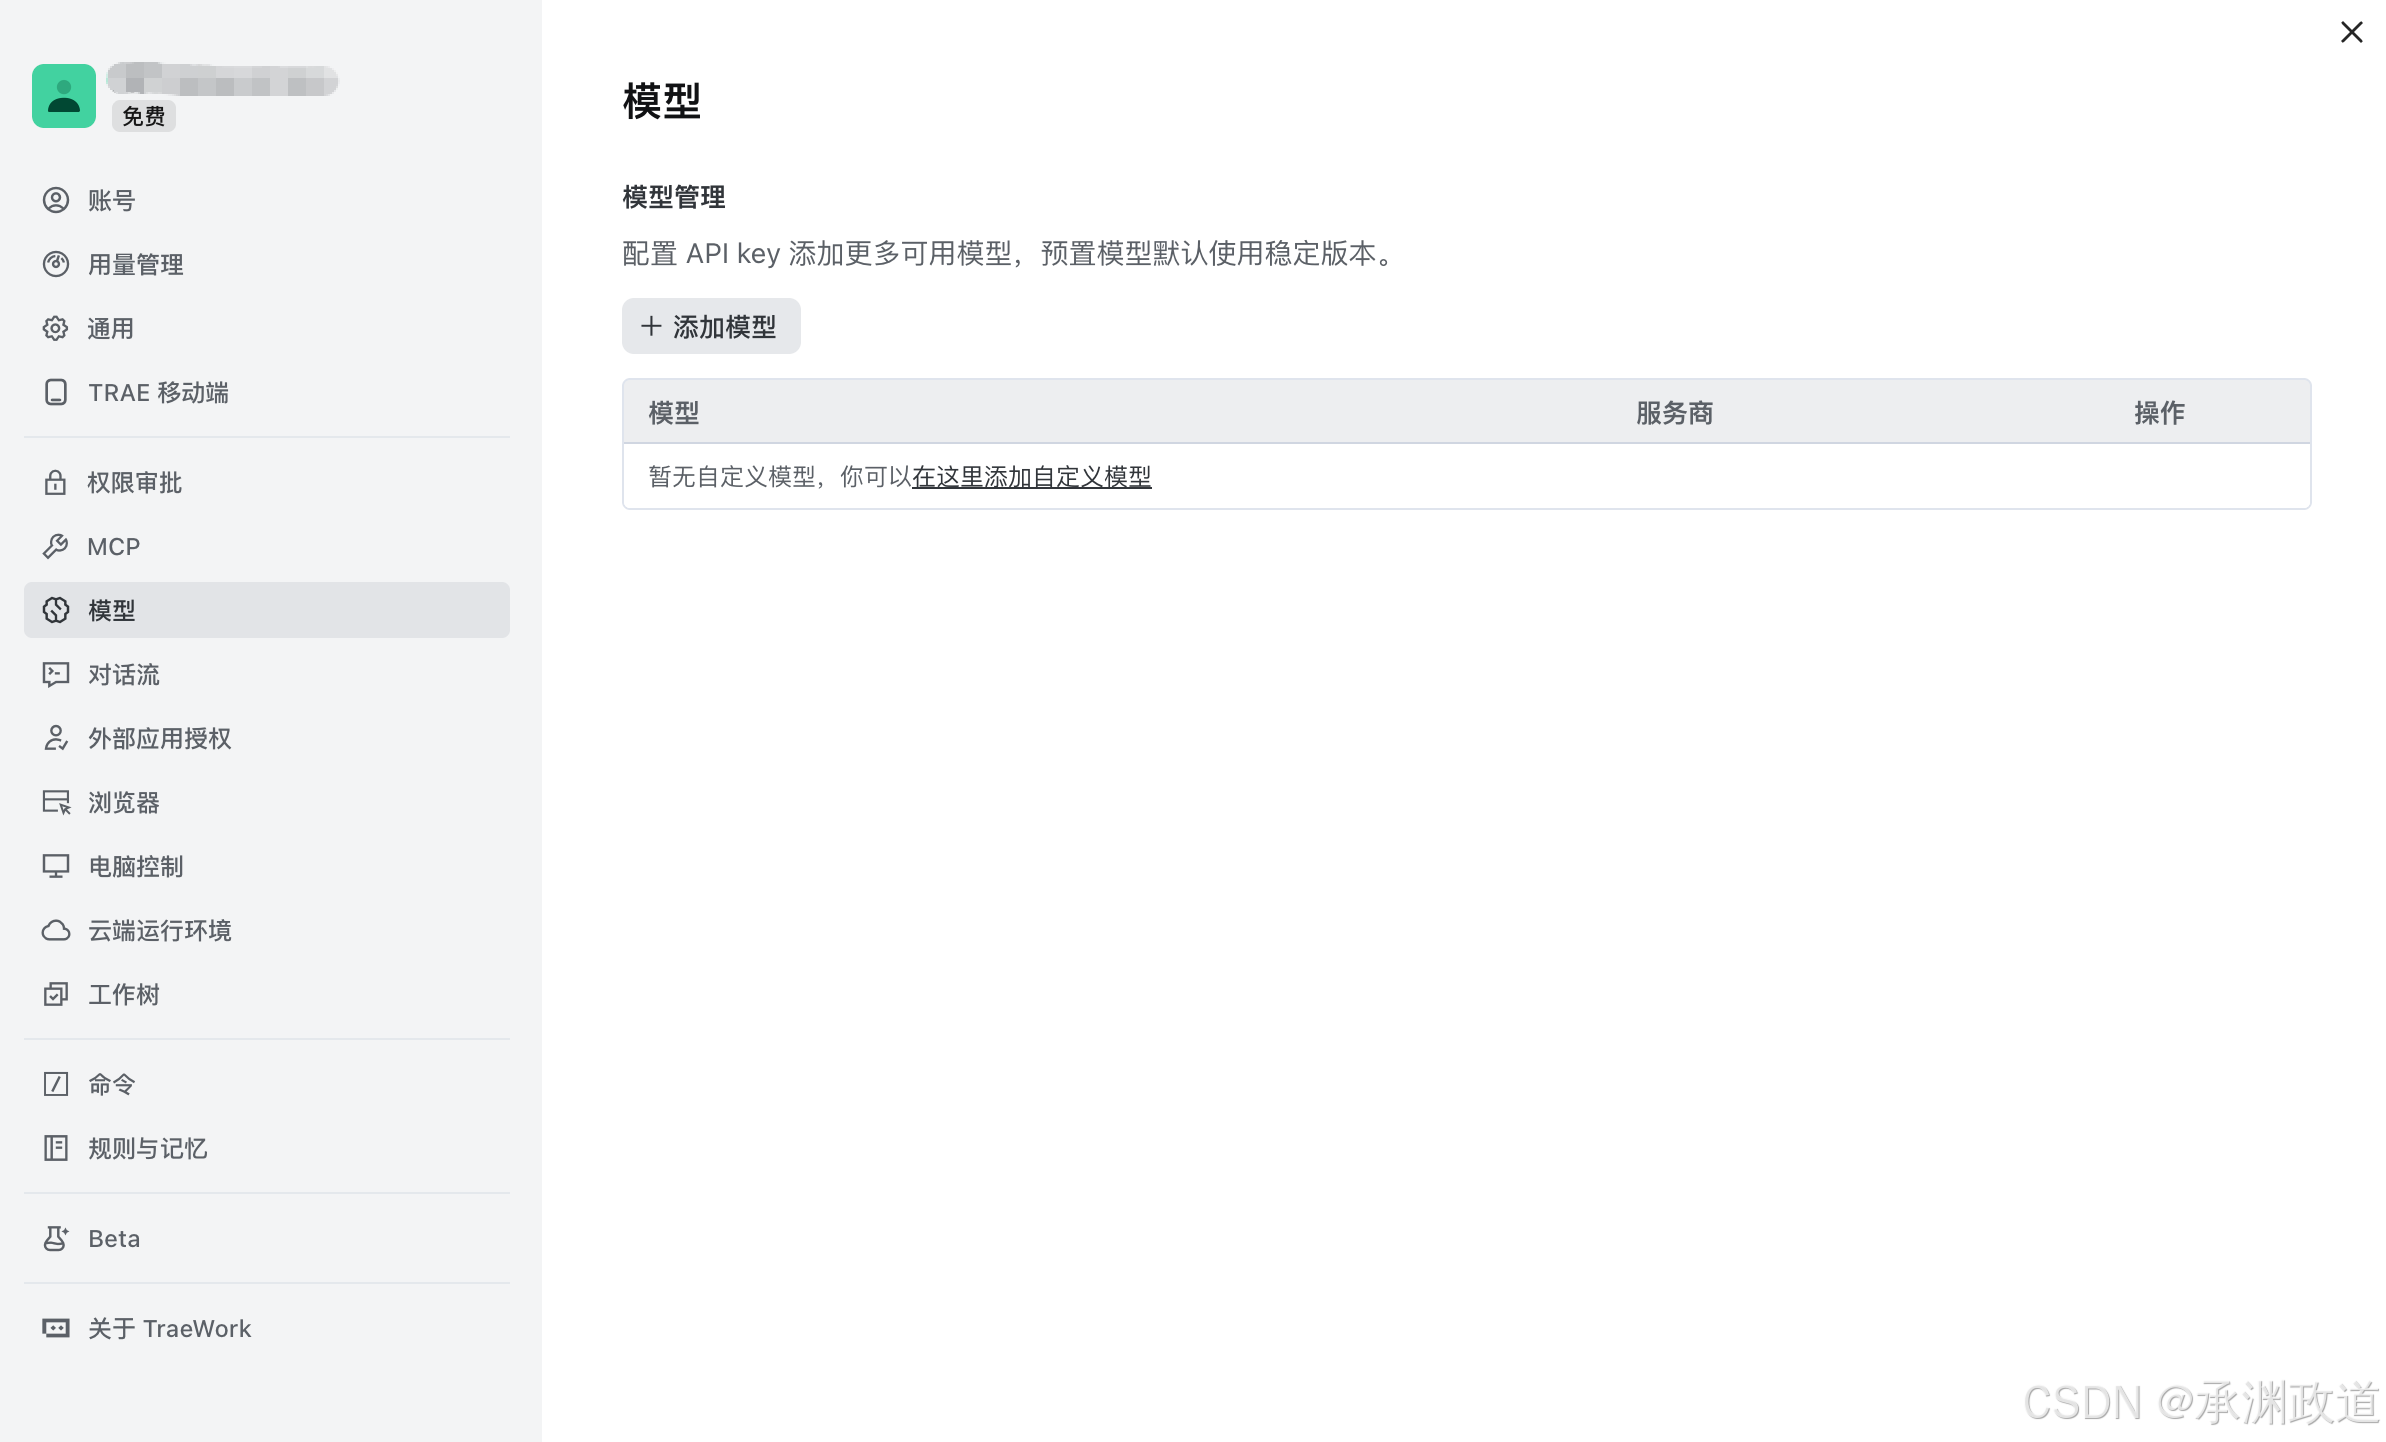
进入模型管理页后,点击“添加模型”,继续填写自定义模型配置.此时列表为空,表示尚未添加自定义模型.
(三)填写配置,确认模型已启用
本次使用以下配置:
| 字段 | 本次使用的值 |
|---|---|
| API 格式 | OpenAI Chat Completions |
| Base URL | https://maas-api.lanyun.net/v1 |
| 模型 ID | glm-5.3 |
| 显示名称 | GLM-5.3 |
将蓝耘 Key 填入“API 密钥”字段,确认后点击“添加模型”.页面提示连通性测试会发起一次真实请求,并消耗少量模型 Token.
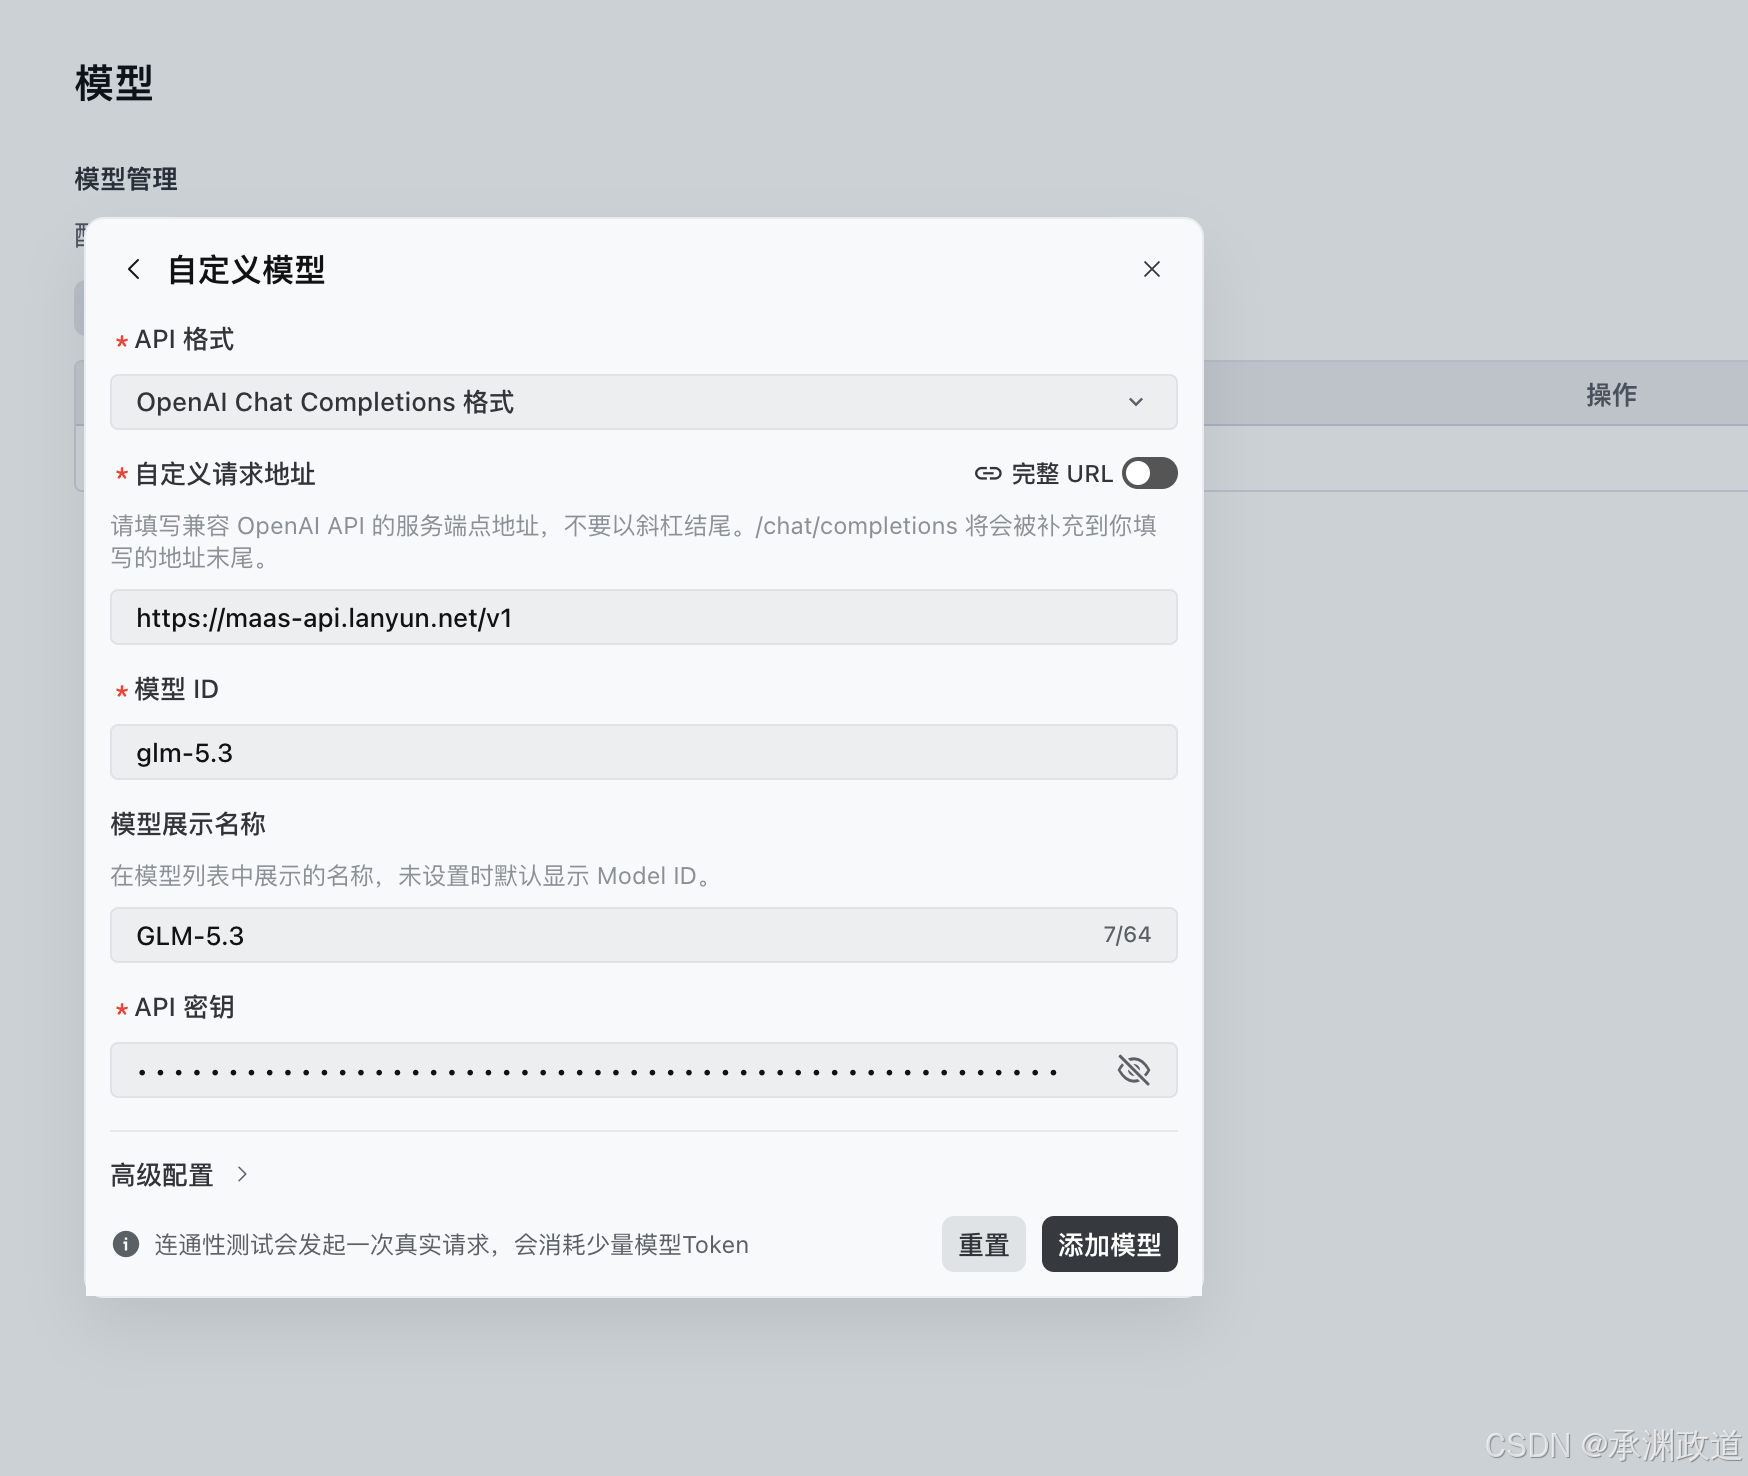
配置页里的“完整 URL”开关保持关闭,Base URL 填到 /v1 为止,TRAE 会补上 /chat/completions.项目服务端实际请求的也是 /v1/chat/completions.显示名称是界面标签,发送请求时使用的是模型 ID.
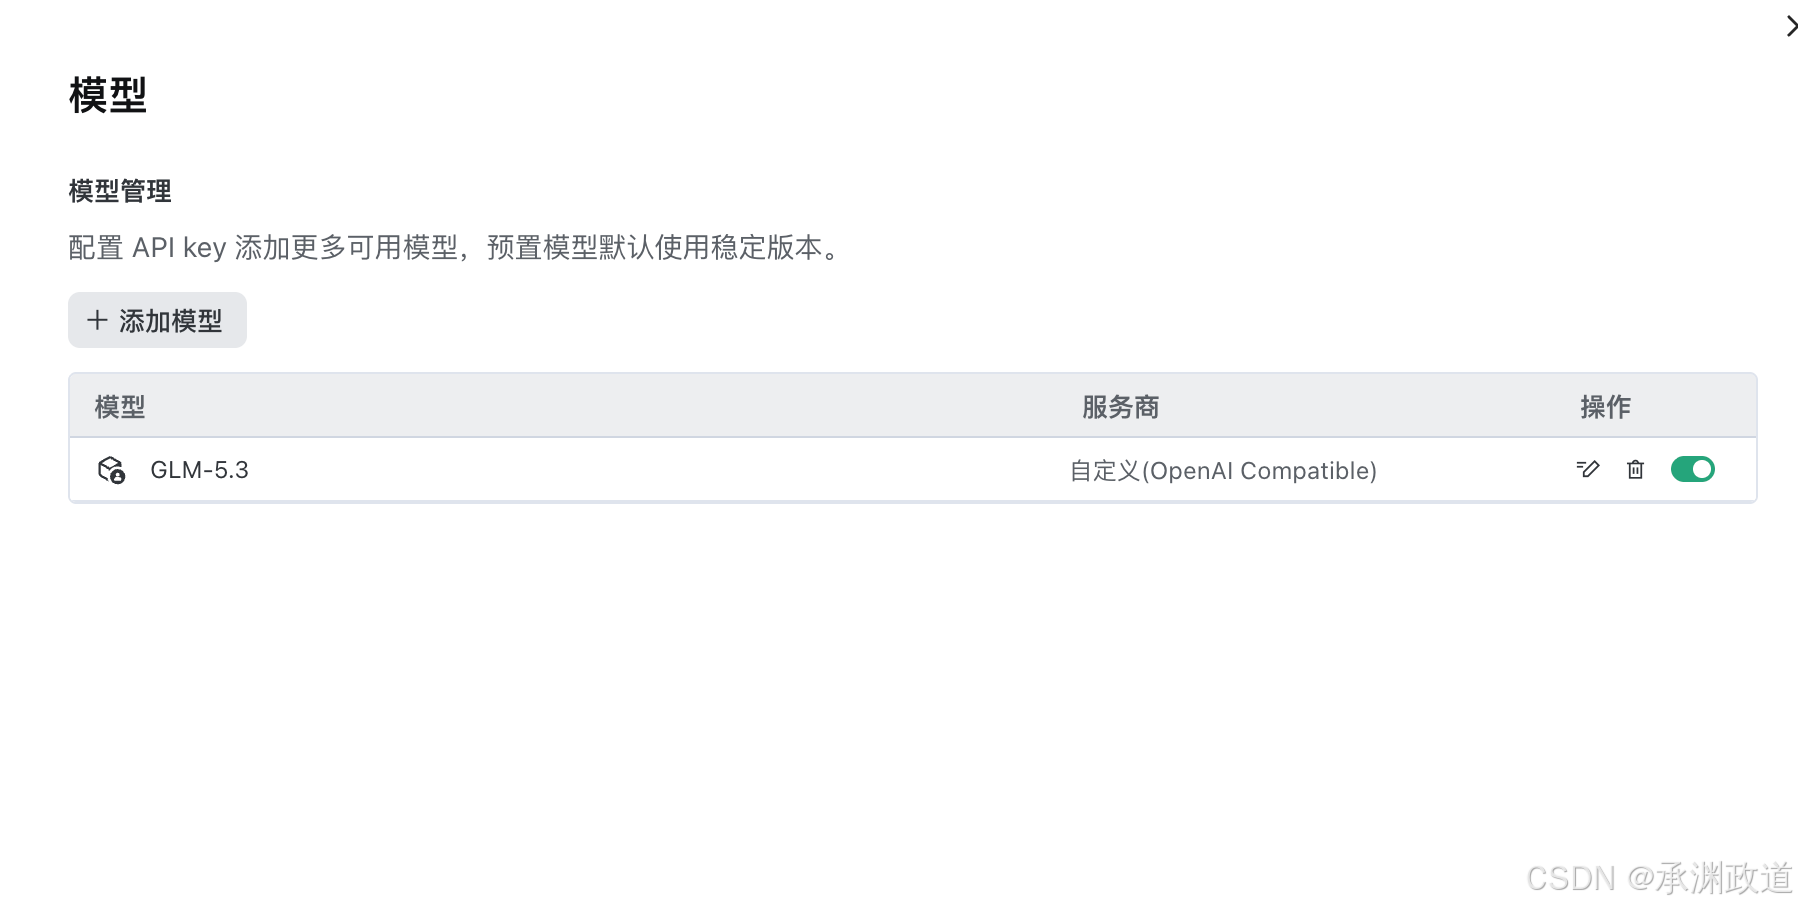
添加完成后,模型管理列表出现 GLM-5.3,服务商显示“自定义(OpenAI Compatible)”,右侧开关处于启用状态.回到Code任务中,即可选择这个模型继续开发.
三、在TRAE Work里打开原项目,先跑出基线
本次使用的原项目版本是 0.2.1,固定到提交 aa16b7c3b0166a89d8c7a6089e0aff53a22faaee.环境为 macOS、Node.js 26.8.2、npm 11.19.1.固定版本的目的很简单:后面遇到的行为,可以对应到当时跑过的代码.
我把仓库放进独立的临时目录,在TRAE Work的Code页关联这个目录,选择自定义的 GLM-5.3.依赖安装后先运行项目自带的 npm run doctor,通过检查,再启动原版看航班、卫星和地震图层.这样可以区分原项目的数据源问题和自己新增的 AI 问题.
本次基线检查和本地启动使用原仓库的命令:
npm ci --ignore-scripts
npm run doctor
npm run dev -- --host 127.0.0.1 --port 4173 --strictPort
服务只监听本机,浏览器访问 http://127.0.0.1:4173.这一步先验证原版,后面再接入新增的中文助手.
Cesium ion Token 用于三维地图,蓝耘API Key用于模型,两者放在本地配置中,各自负责不同的服务.TRAE Work里配好模型,也不会自动替应用后端完成配置:编辑器会调用模型,与访问本地网页时后端会调用模型,是两条独立链路.
原版在没有三维资源配置时可以先显示 Esri 底图.这次补齐 Cesium 配置并重启本地服务后,我还在 VISUAL PRESETS → MAP SOURCE 中选择了 Google 3D,因为界面保留了此前的 Esri 选择.东京塔附近的立体建筑随后正常显示.
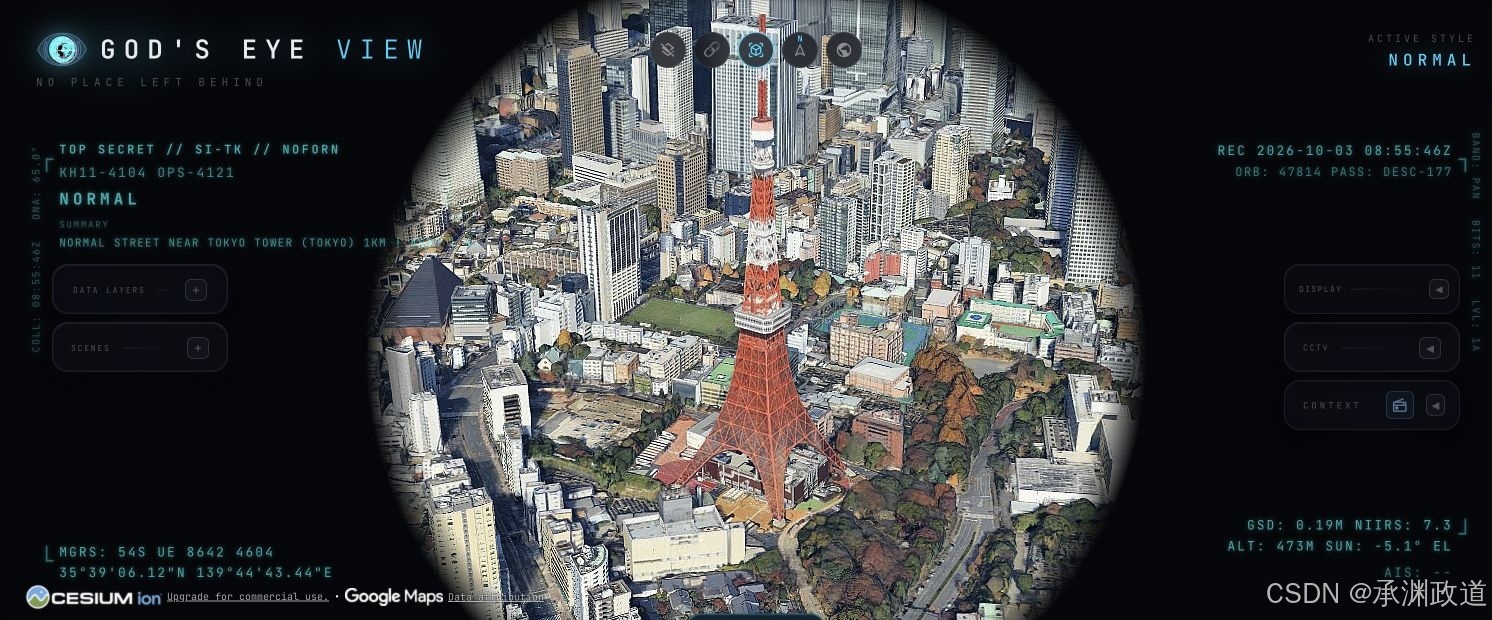
这一步很值得保留.只看“Token 已填写”无法证明三维资源已经加载,真正的验证应该落到画面和当前底图状态上.本次是本地探索性试验;Cesium、地图和数据源都有各自的条款与额度,后续对外部署仍需按实际用途核对.原仓库的MIT许可覆盖代码,不会替第三方数据统一授权.
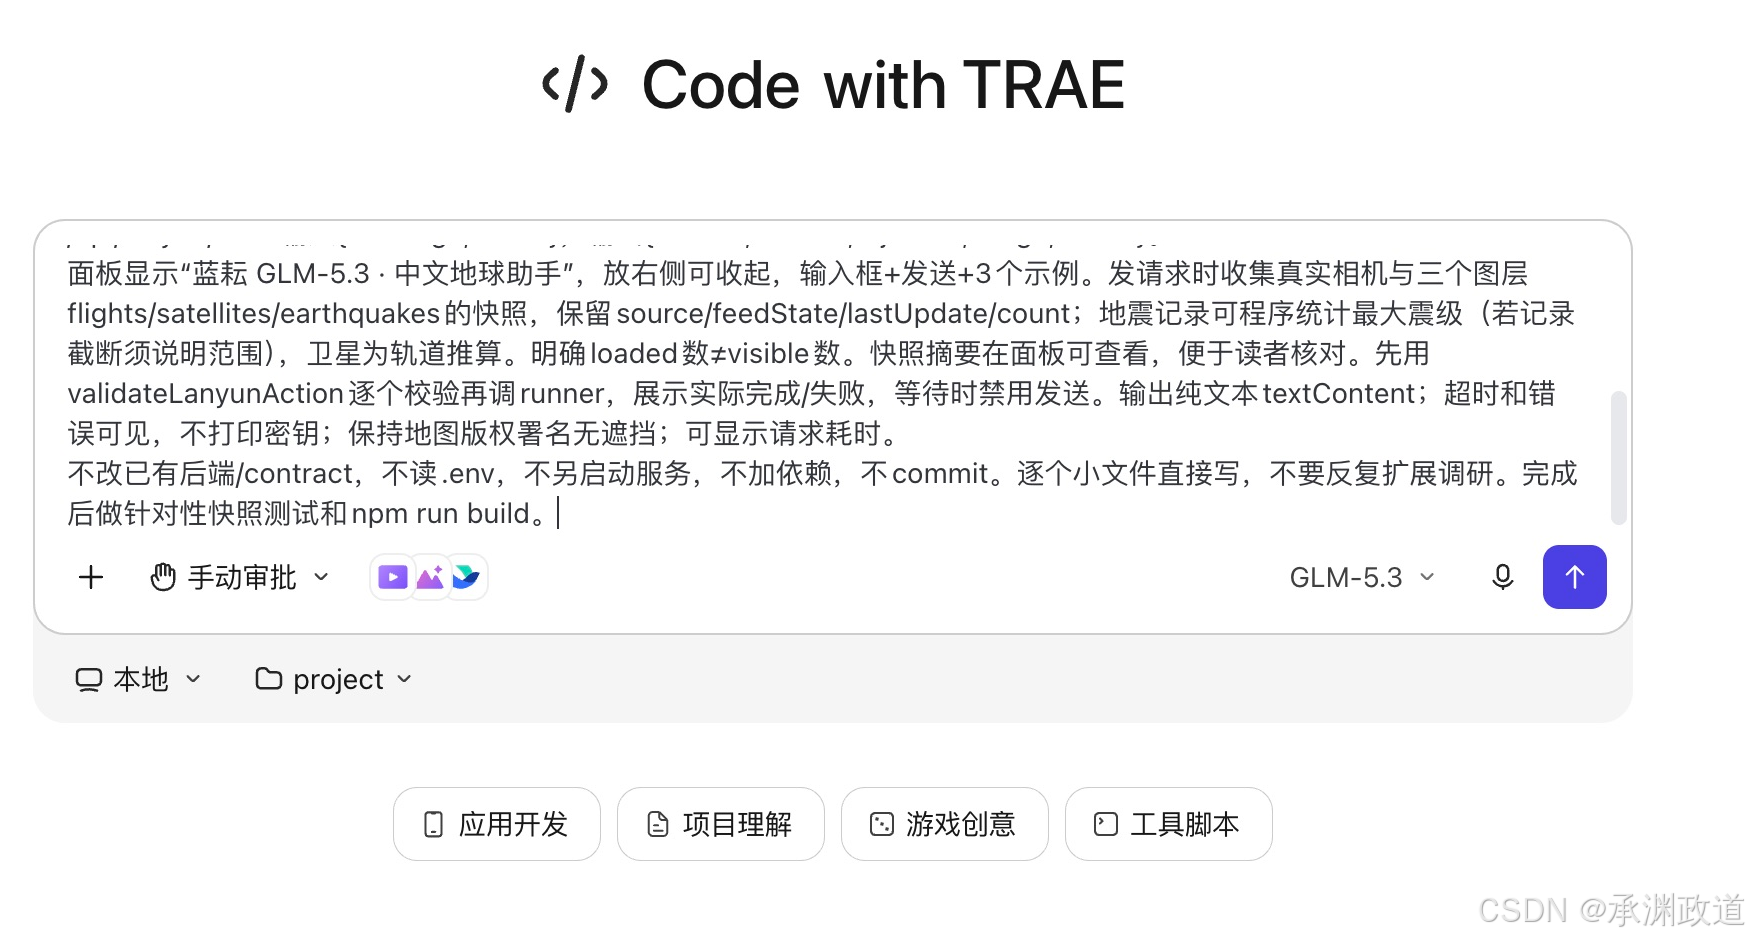
我给 TRAE 的开发任务也限定得比较具体,核心要求可以概括为:
保留原英文地球界面,增加“蓝耘 GLM-5.3 · 中文地球助手”。支持中文定位城市、切换航班/卫星/地震图层、回到全球,以及根据已经加载的数据解释当前场景。复用原地图动作入口,不重写地图内核;先校验模型提出的动作,再执行并显示真实结果;没有数据时说明缺失,不补造数字。
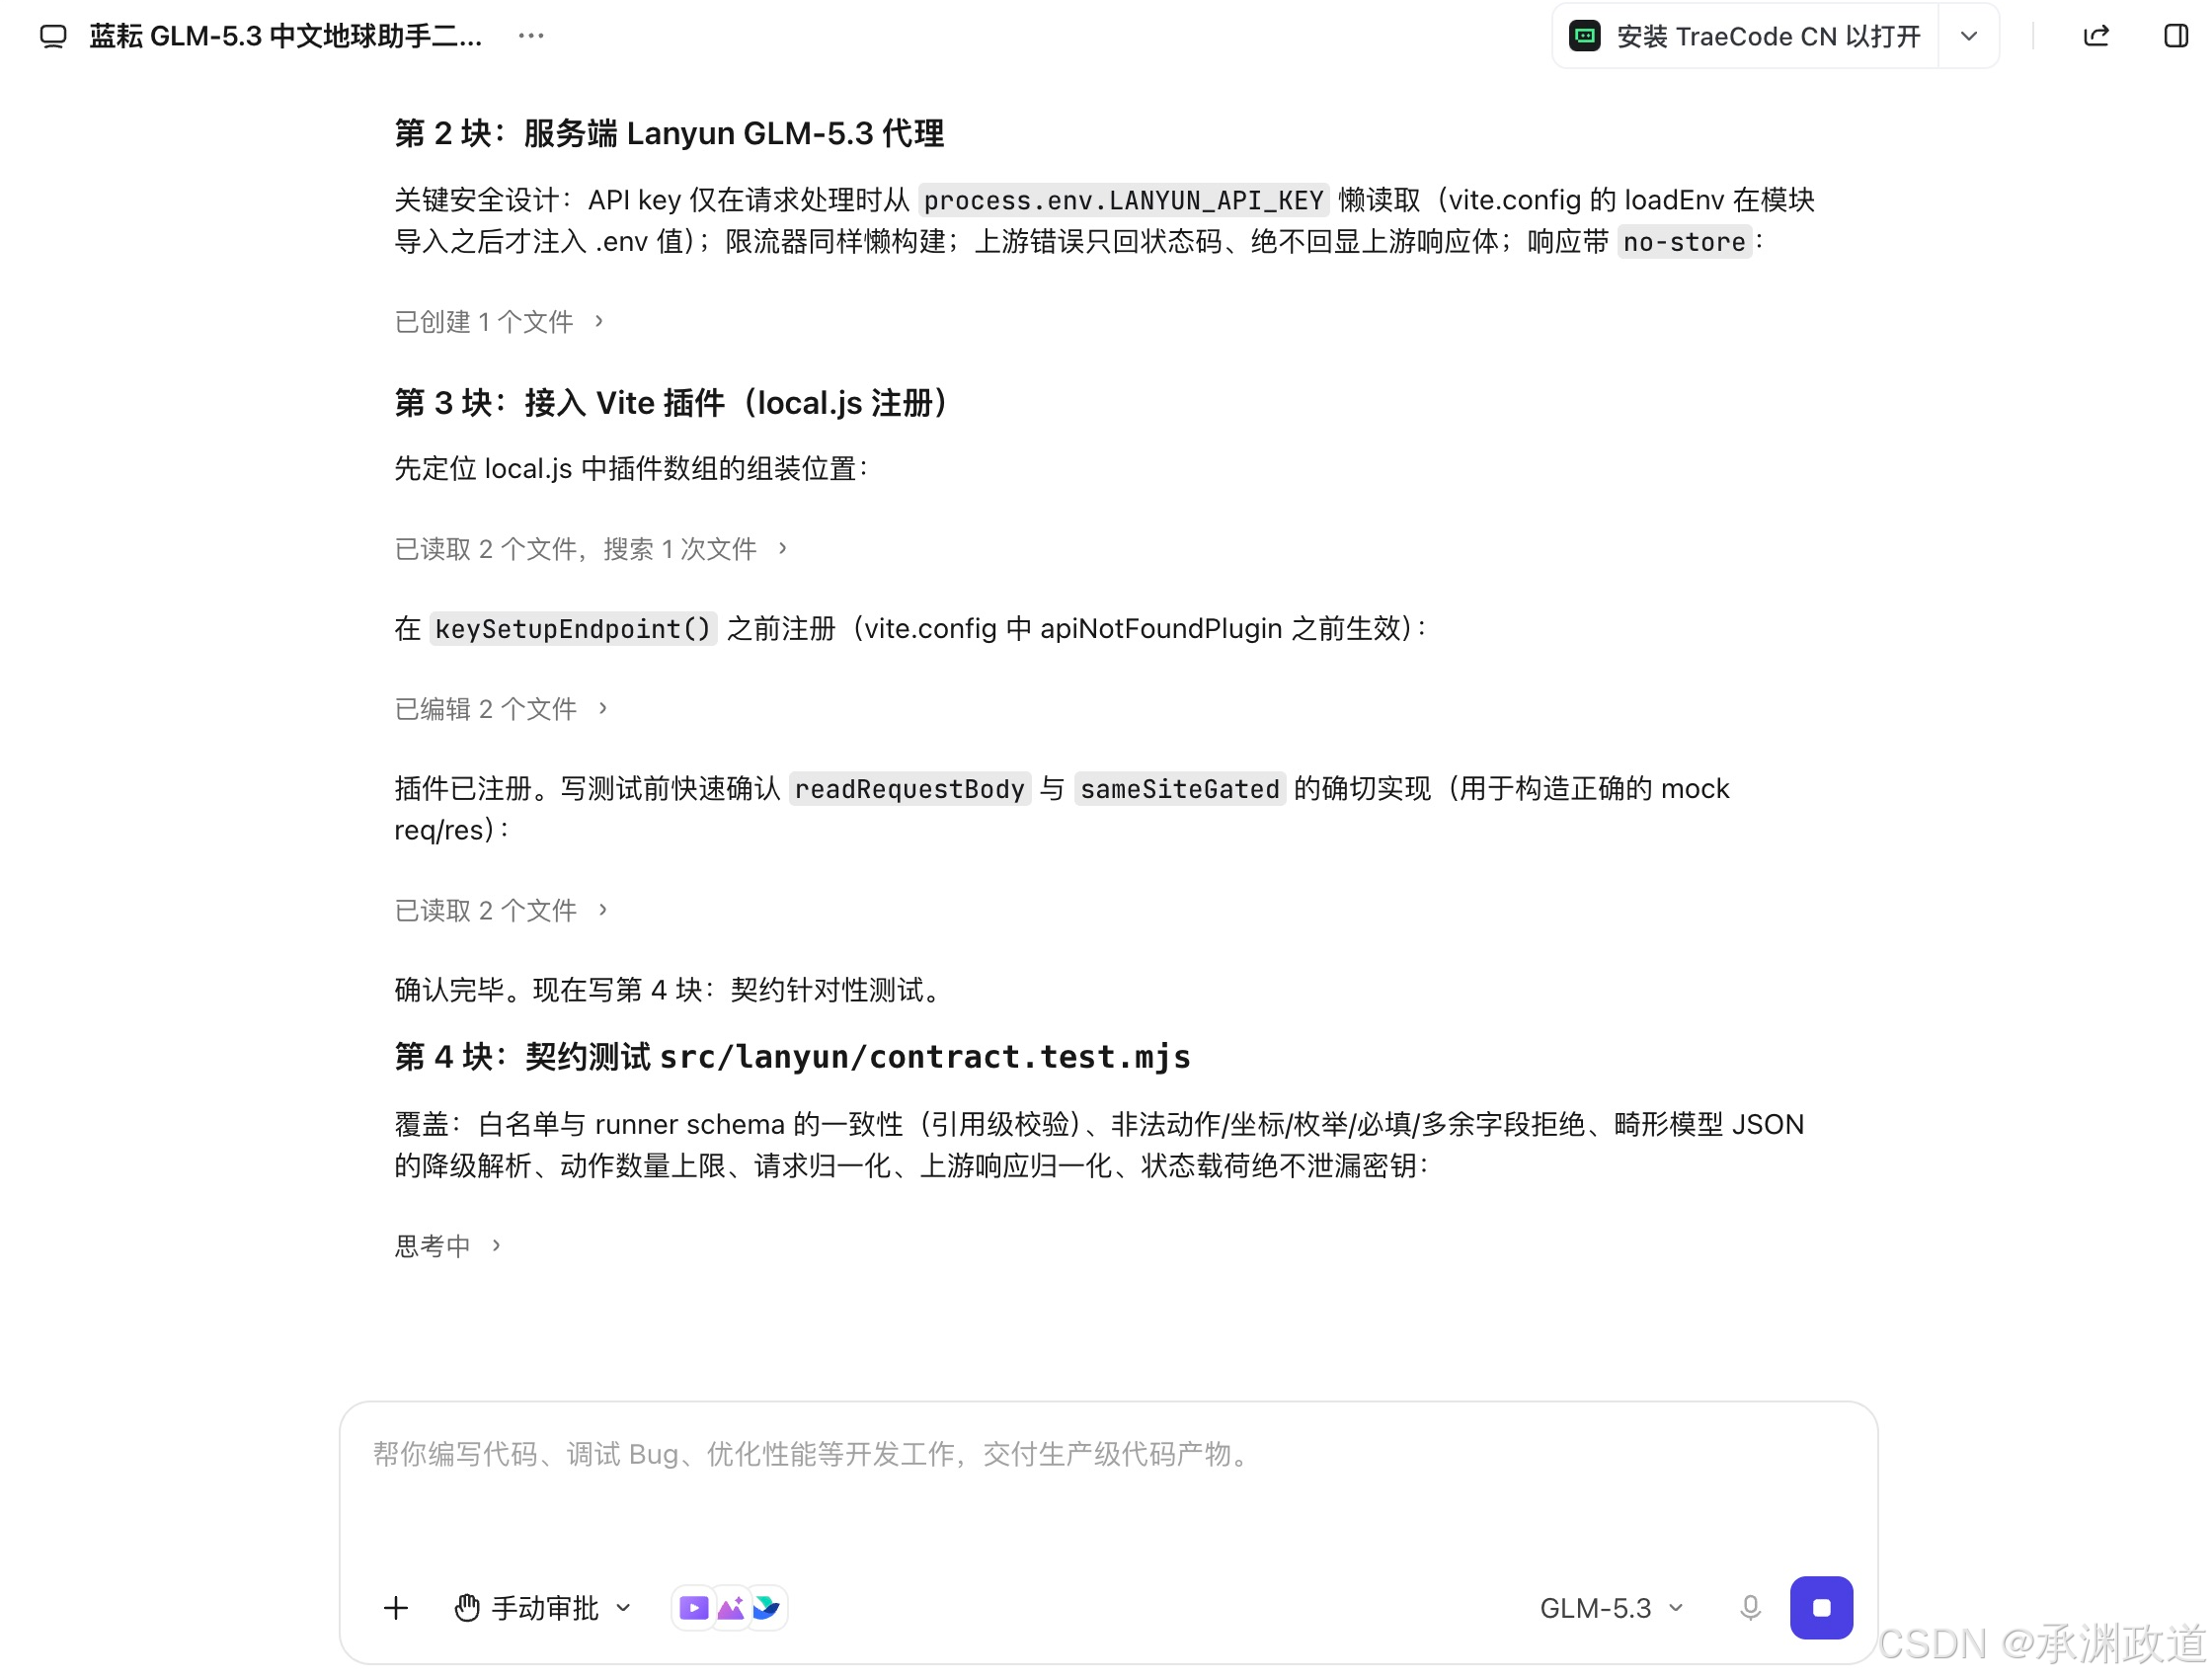
实际开发并不是一次提示词就全部完成.TRAE Work中的GLM-5.3产出了蓝耘代理接口、动作契约和测试初稿;前端任务则出现了反复读文件、规划、压缩上下文后重新读取的情况,迟迟没有写入文件.我停止了这轮任务,再借助Codex补齐前端接线、复核接口并完成联调.下面展示的是这次协作后的真实结果.
这段经历给我的提醒很直接:接已有仓库时,要先指出可以复用的入口,再把验收标准落实到文件和行为上.例如第一步只完成代理与测试,第二步再接面板,并明确“输入后必须能看见执行器结果”.让任务持续输出分析,并不能替代可运行的改动.
四、中文指令怎样真正变成地图操作
改造链路可以按下面的分工理解:
| 环节 | 实际负责的事情 |
|---|---|
| 中文面板 | 收集输入,读取当前场景,展示回答与执行结果 |
| 本地后端 | 读取蓝耘密钥,调用 GLM-5.3,处理超时与上游异常 |
| GLM-5.3 | 理解中文,提出有限的地图动作,解释附带的数据 |
| 动作校验 | 检查动作名称、参数类型、坐标范围和允许的图层 |
| 原项目执行器 | 调用已有能力,让镜头、图层或视觉风格真正变化 |
网页的模型请求只访问本地的 /api/lanyun/chat.蓝耘 API Key 由服务端从 LANYUN_API_KEY 读取,不需要放进前端代码.服务端再向固定的蓝耘接口发送请求:
const endpoint = 'https://maas-api.lanyun.net/v1/chat/completions';
const model = 'glm-5.3';
这两行只是关键配置,不是完整工程.真正影响结果的是请求前后的处理:输入要限长,外部调用要有超时,模型的返回值也要当成待检查的数据.
第一次项目接口实测中,输入“飞到东京并打开航班图层”,蓝耘 GLM-5.3 返回的动作结构如下:
{
  "actions": [
    { "name": "fly_to_location", "args": { "locationId": "tokyo" } },
    { "name": "set_layer_visibility", "args": { "layerId": "flights", "enabled": true } }
  ]
}
收到这段 JSON 还不算完成操作.前端必须先通过白名单校验,再交给原项目的 tools.voiceCommands.runner(name, args) 执行,并检查执行器返回的结果.如果执行失败,聊天面板就要显示失败;不能因为模型说了一句“已打开”,就把它当作成功.
这种分工也让模型的权限更容易控制.本次只保留定位、航班/卫星/地震图层开关、回到全球和原有视觉风格切换.模型不能把任意字符串变成脚本执行,也不能自行增加一个外部数据服务.
五、数据解读先要说明统计口径
数据问答的输入来自应用当前快照.这里最容易出错的是把不同意义的“数量”混在一起:当前图层加载了多少条记录,镜头里能看见多少个标记,某个区域实际存在多少个对象,三者并不相同.
本次重点处理的三个图层,各有自己的口径:
| 图层 | 本次使用的数据与展示边界 |
|---|---|
| 航班 | 原项目优先读取 OpenSky,必要时回退到 adsb.lol 区域源。回退范围会显示在界面上,不能把区域结果当作全球飞机总数 |
| 卫星 | 使用 CelesTrak 轨道数据并推算位置;画面上的运动不等于每颗卫星都在实时回传定位 |
| 地震 | 输入为 USGS 最近一天的数据,原项目还会筛选 M2.5 及以上记录。图层数量因此不等于所有震级事件的总量 |
新鲜度也不能只看一个“刚刚更新”.原项目的时间字段并不是统一口径:航班的 lastUpdate 使用源快照时间,地震和卫星记录的是图层成功获取数据的时间.它们都不能被解释成“每条观测刚刚发生”.因此快照除了来源、状态和覆盖范围,还需要携带每个图层的时间含义.
六、实测:一句中文,让镜头和图层一起变化
先把航班图层关闭,再输入:
飞到东京并打开航班图层
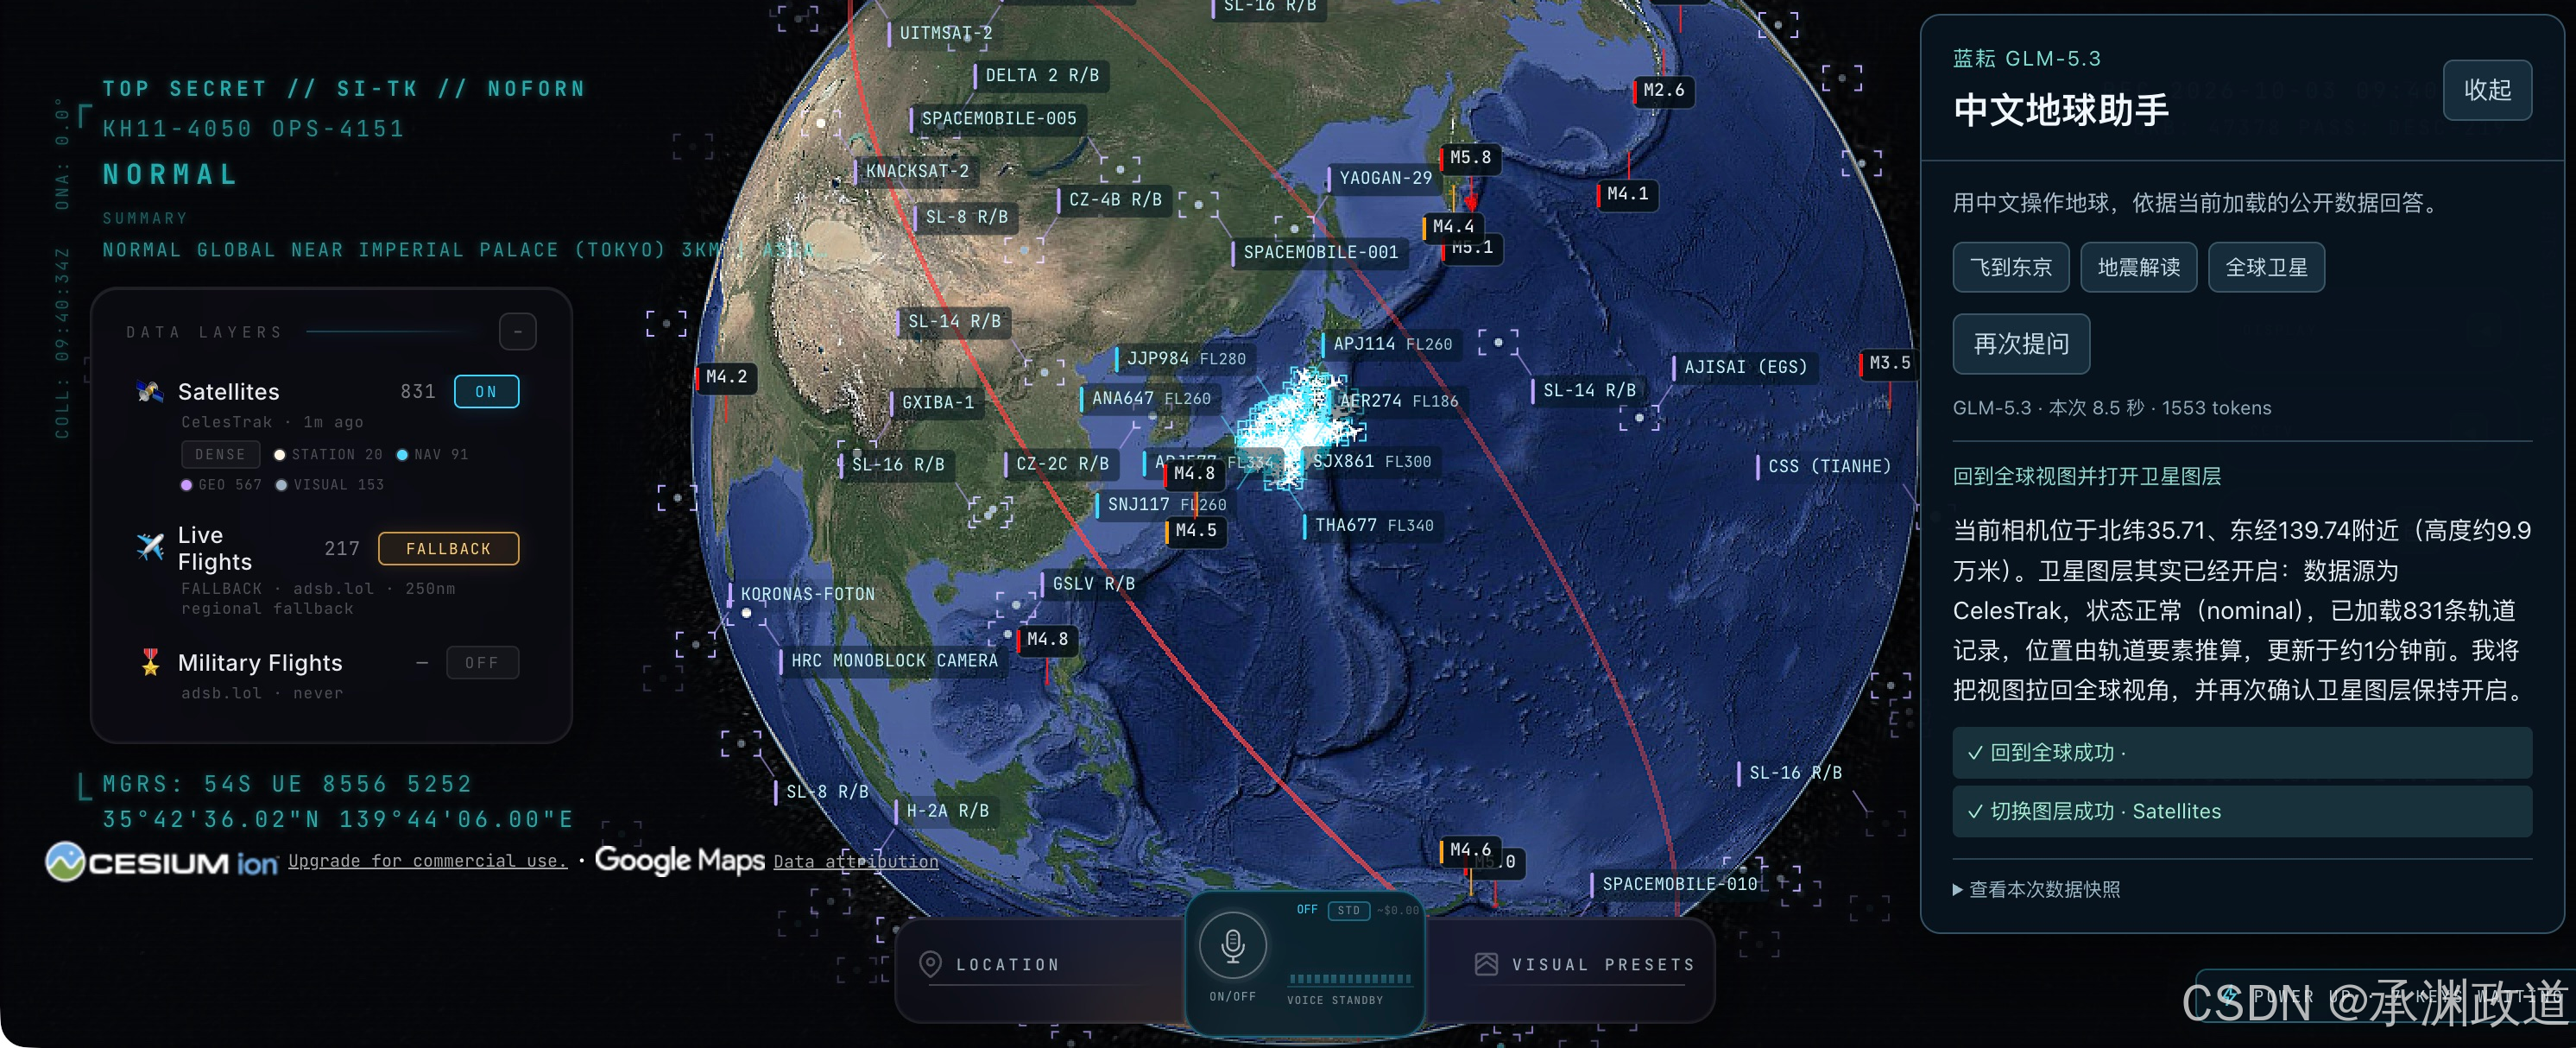
这一次,面板里分别出现“定位城市成功”和“切换图层成功”.地图落到东京区域,航班标记随图层开启显示出来.它没有只给出一段操作建议,而是把中文意图交给了原项目的地图能力.
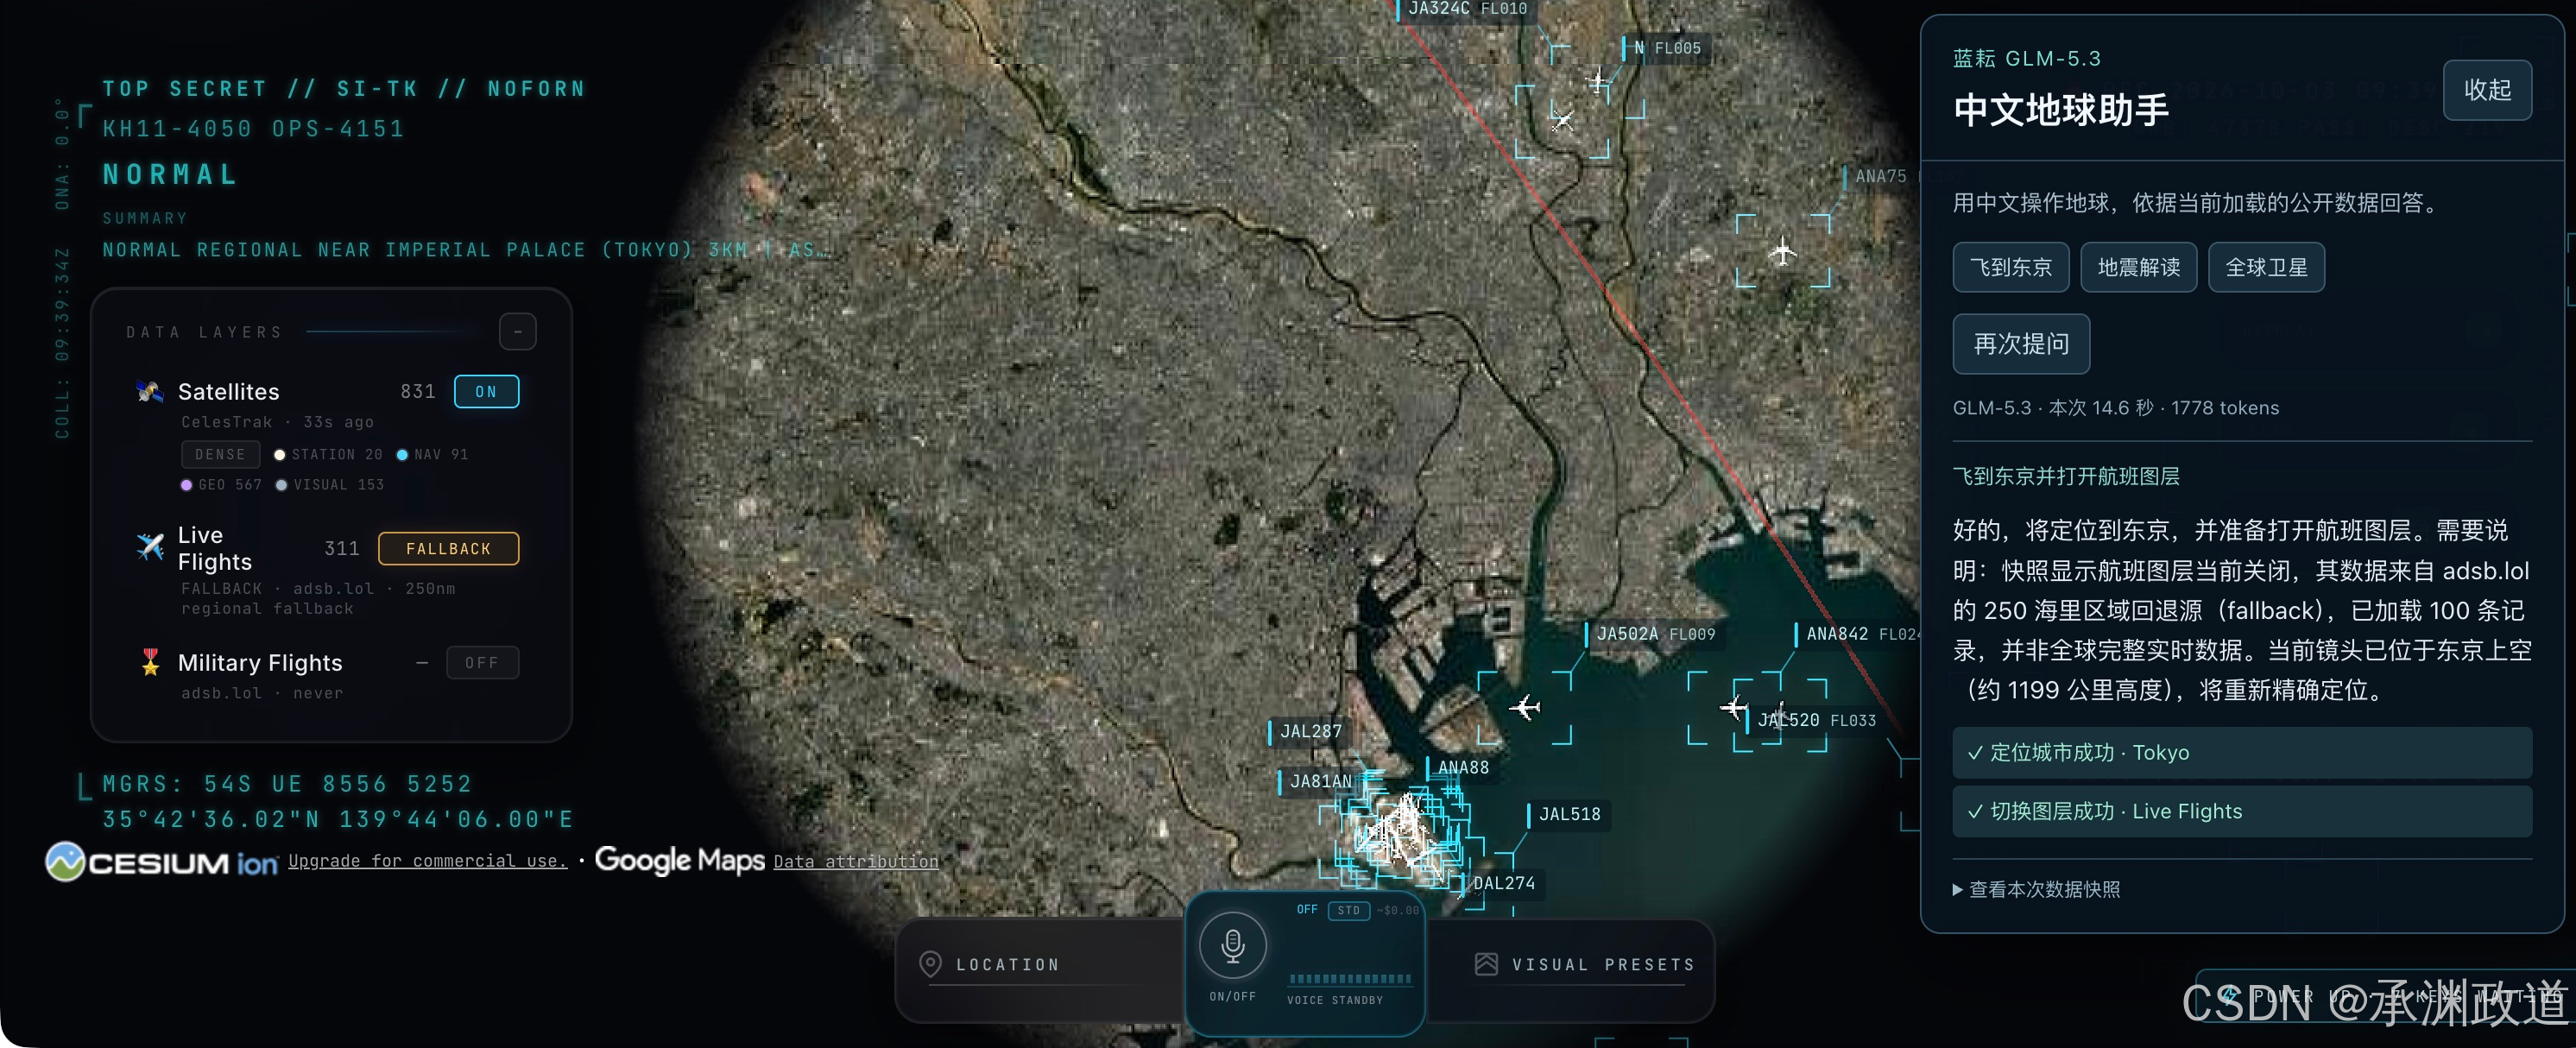
这里有一个容易忽略的细节:回答依据的是点击发送时的快照,地图则会在动作执行和数据刷新后继续变化.因此截图中回答提到的旧计数,与左侧稍后刷新的计数可能不同.数据说明不能脱离快照时间;界面里的两条执行结果,才是动作完成的依据.
这条完整组合指令在本次界面显示为14.6 秒、1778 tokens.这个时间包含浏览器等待和动作执行,tokens 是接口返回的本次请求用量.它只是一次样本,不是GLM-5.3的平均速度,也不是整篇文章的开发成本.
接着输入:
回到全球视图并打开卫星图层
镜头从东京区域退回全球视角,面板确认全球导航与卫星图层操作成功.回答还说明了当时的 831 条记录来自 CelesTrak,位置由轨道要素推算.
这样的体验适合用来做项目演示或数据浏览:用户先用一句话决定看哪里,再继续问当前图层的含义.卫星标记在动,并不意味着应用正在收到每颗卫星的实时定位;这层区别应该在问答里说清楚.
七、实测:让地震解读能回到原始快照核对
第二个问题只要求解释,不要求改地图:
请解释当前地震数据的数量、最大震级、来源和时间口径。不要操作地图。
这一轮请求的场景快照采集于 2026-10-03T09:42:29.995Z,即北京时间 17:42:29.995.对应的数据是:
| 核对项 | 本次快照 |
|---|---|
| 图层来源 | USGS |
| 图层状态 | nominal |
| 已加载地震记录 | 37 条 |
| 返回用于统计的记录 | 37 条,覆盖本次已加载图层 |
| 最大震级 | 5.8 |
| 该事件位置 | 俄罗斯 Vilyuchinsk 东南偏南约 165 公里 |
| 该事件深度 | 29.477 千米 |
| 数据筛选范围 | 最近一天,M2.5 及以上 |
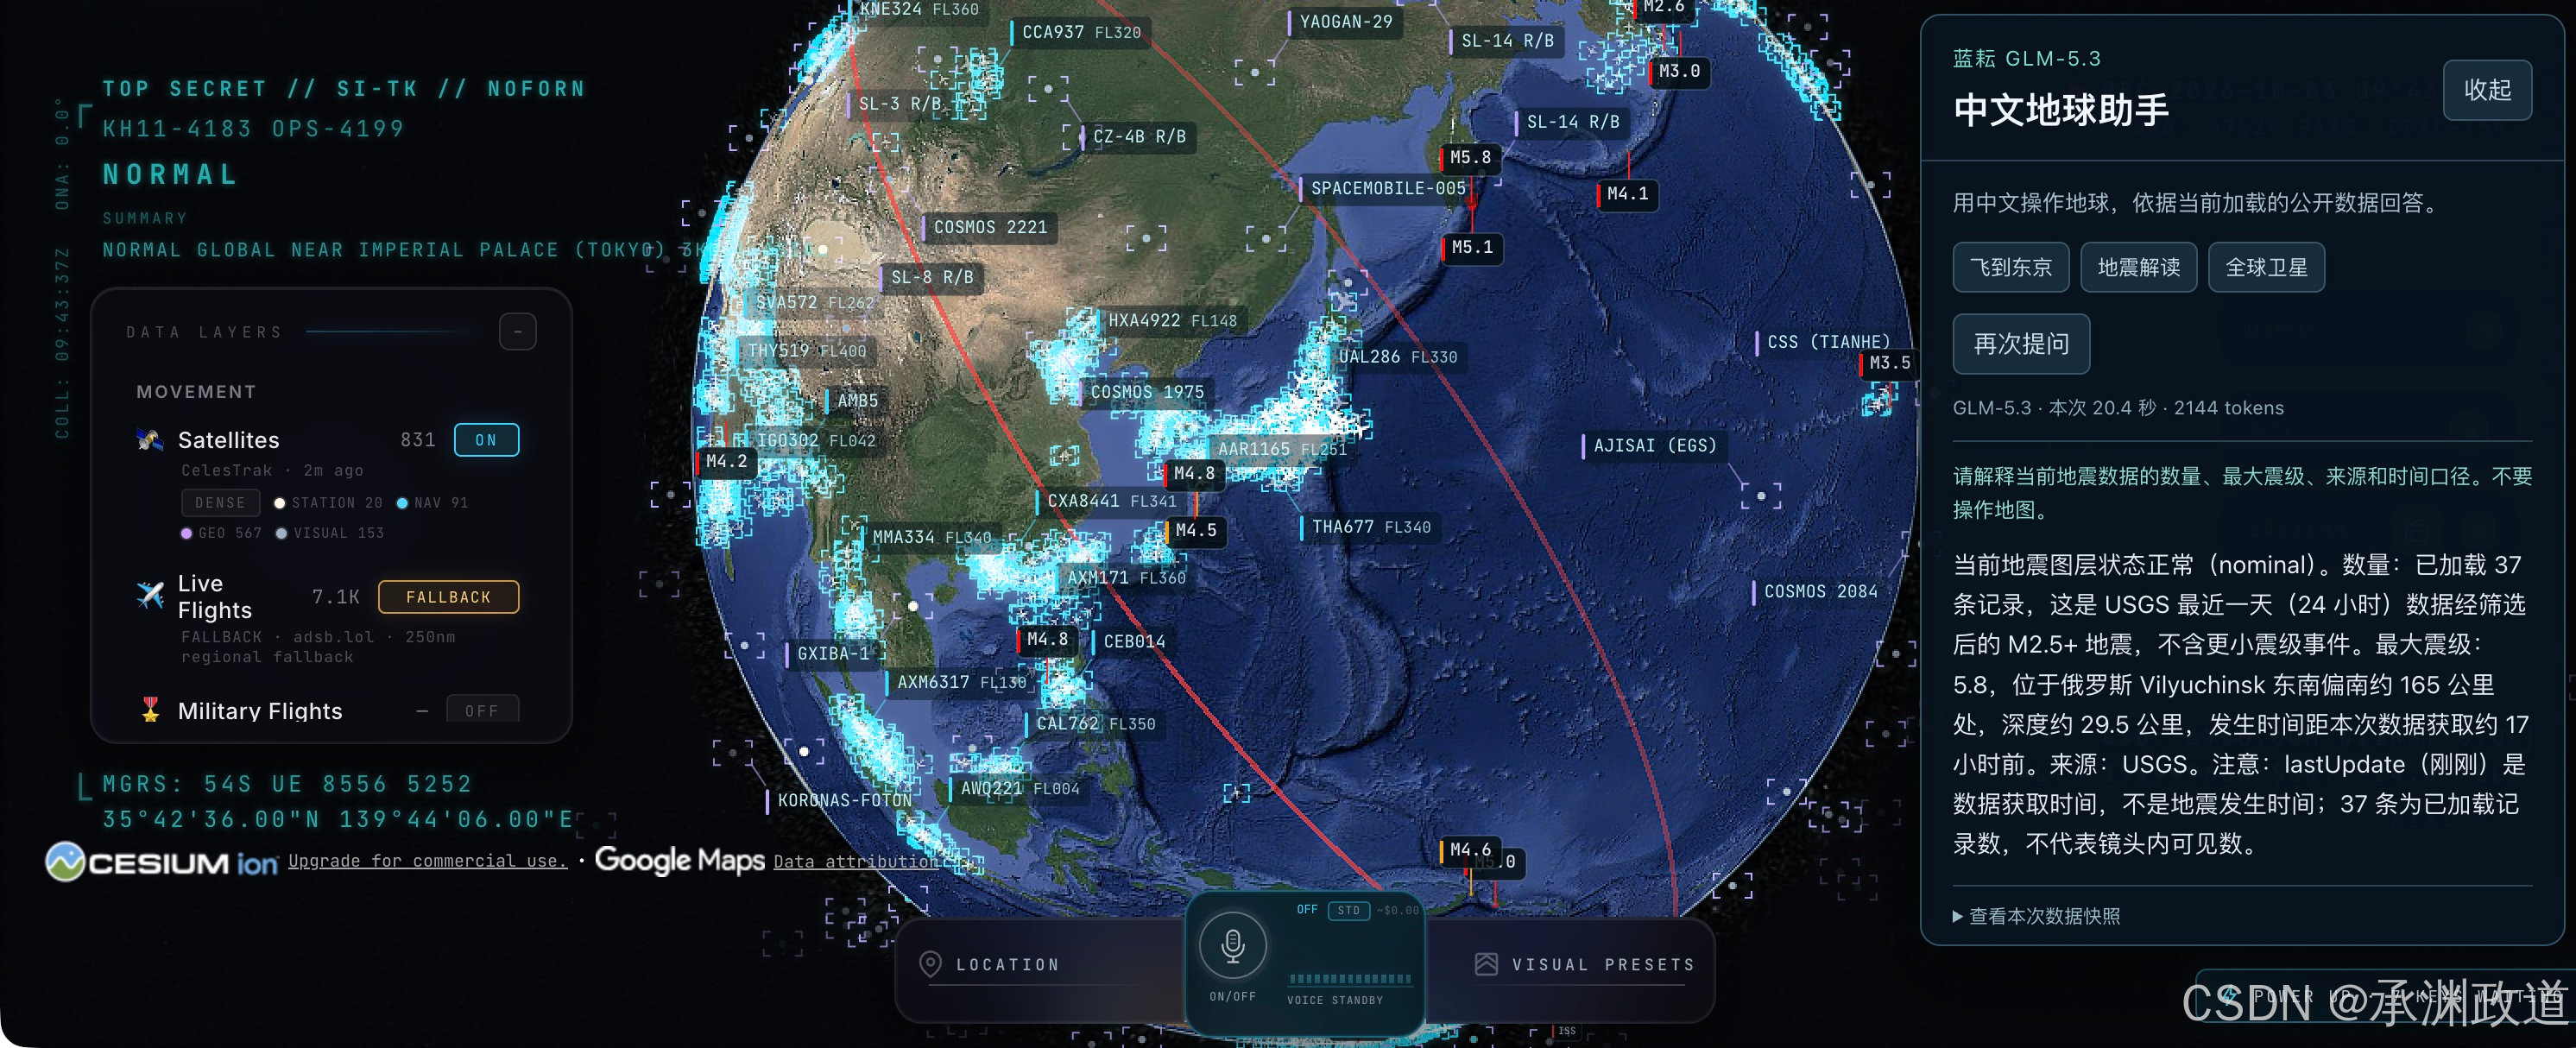
模型把深度写成约29.5千米,说明了 USGS、24 小时与 M2.5+ 的筛选条件,也提醒“刚刚更新”指数据获取时间,不是刚刚发生了这些地震.这个回答能够逐项回到快照核对.
为了减少模型做数字运算时出错,我没有把一大串事件交给它自由计算最大值.程序先在实际返回的记录中求最大震级,再附上统计范围,模型负责组织中文解释.
还要防一种隐蔽的错误:程序最多读取2000条地震记录,如果将来图层超过这个上限,样本最大值不能直接叫“全部记录的最大值”.所以快照还带有“本次返回是否覆盖已加载图层”的判断.这次37条对37条,可以确认统计覆盖当前图层;这仍然不是对全球全部地震事件的断言.
八、真正需要处理的问题:数据源回退后,数字的含义变了
联调中,航班图层多次从OpenSky切到 adsb.lol,左侧出现 FALLBACK · 250nm regional fallback.这是原项目的数据源回退行为,不能把它归因于蓝耘模型服务.
更容易误读的是计数.初版回答虽然识别出“250 海里区域回退”,仍把显示数量进一步解释成“回退区域内的航班规模”.我沿着原项目代码检查后发现,这个推断站不住脚:航班计数取自当前渲染层保留的对象,部分数据未出现在新快照中时,原项目还会暂时保留旧轨迹.
也就是说,当前源的覆盖范围,与画面里全部保留对象的范围,不一定相同.把 count 和 coverage 并排传给模型,还不足以让它理解二者的关系.
我的处理是给场景快照补上明确的口径:
count可能包含前序数据源保留的轨迹,不能当作本次接口返回条数.coverage描述当前数据源,不能据此认定全部显示对象都位于这个区域.- 航班的
lastUpdate是源快照时间,不能说成浏览器刚刚取到数据的时间,也不能替代逐架飞机的观测时间.
对应到代码,关键不是增加一句泛泛的“不要胡编”,而是把领域规则作为数据一起传入.最后这部分简化为两个字段:
scope: '渲染层保留的航班条数,可能含旧源轨迹;不能推断全部位于当前回退区域',
timestampMeaning: 'lastUpdate 为源快照时间,不是每架飞机的观测时间'
补充口径后,我在真实的回退状态下重新提问.这次快照显示212条航班对象,回答明确指出它们可能包含前序源留下的轨迹,不能推断全都位于当前回退区域;对 lastUpdate 的解释也改成了源快照时间.
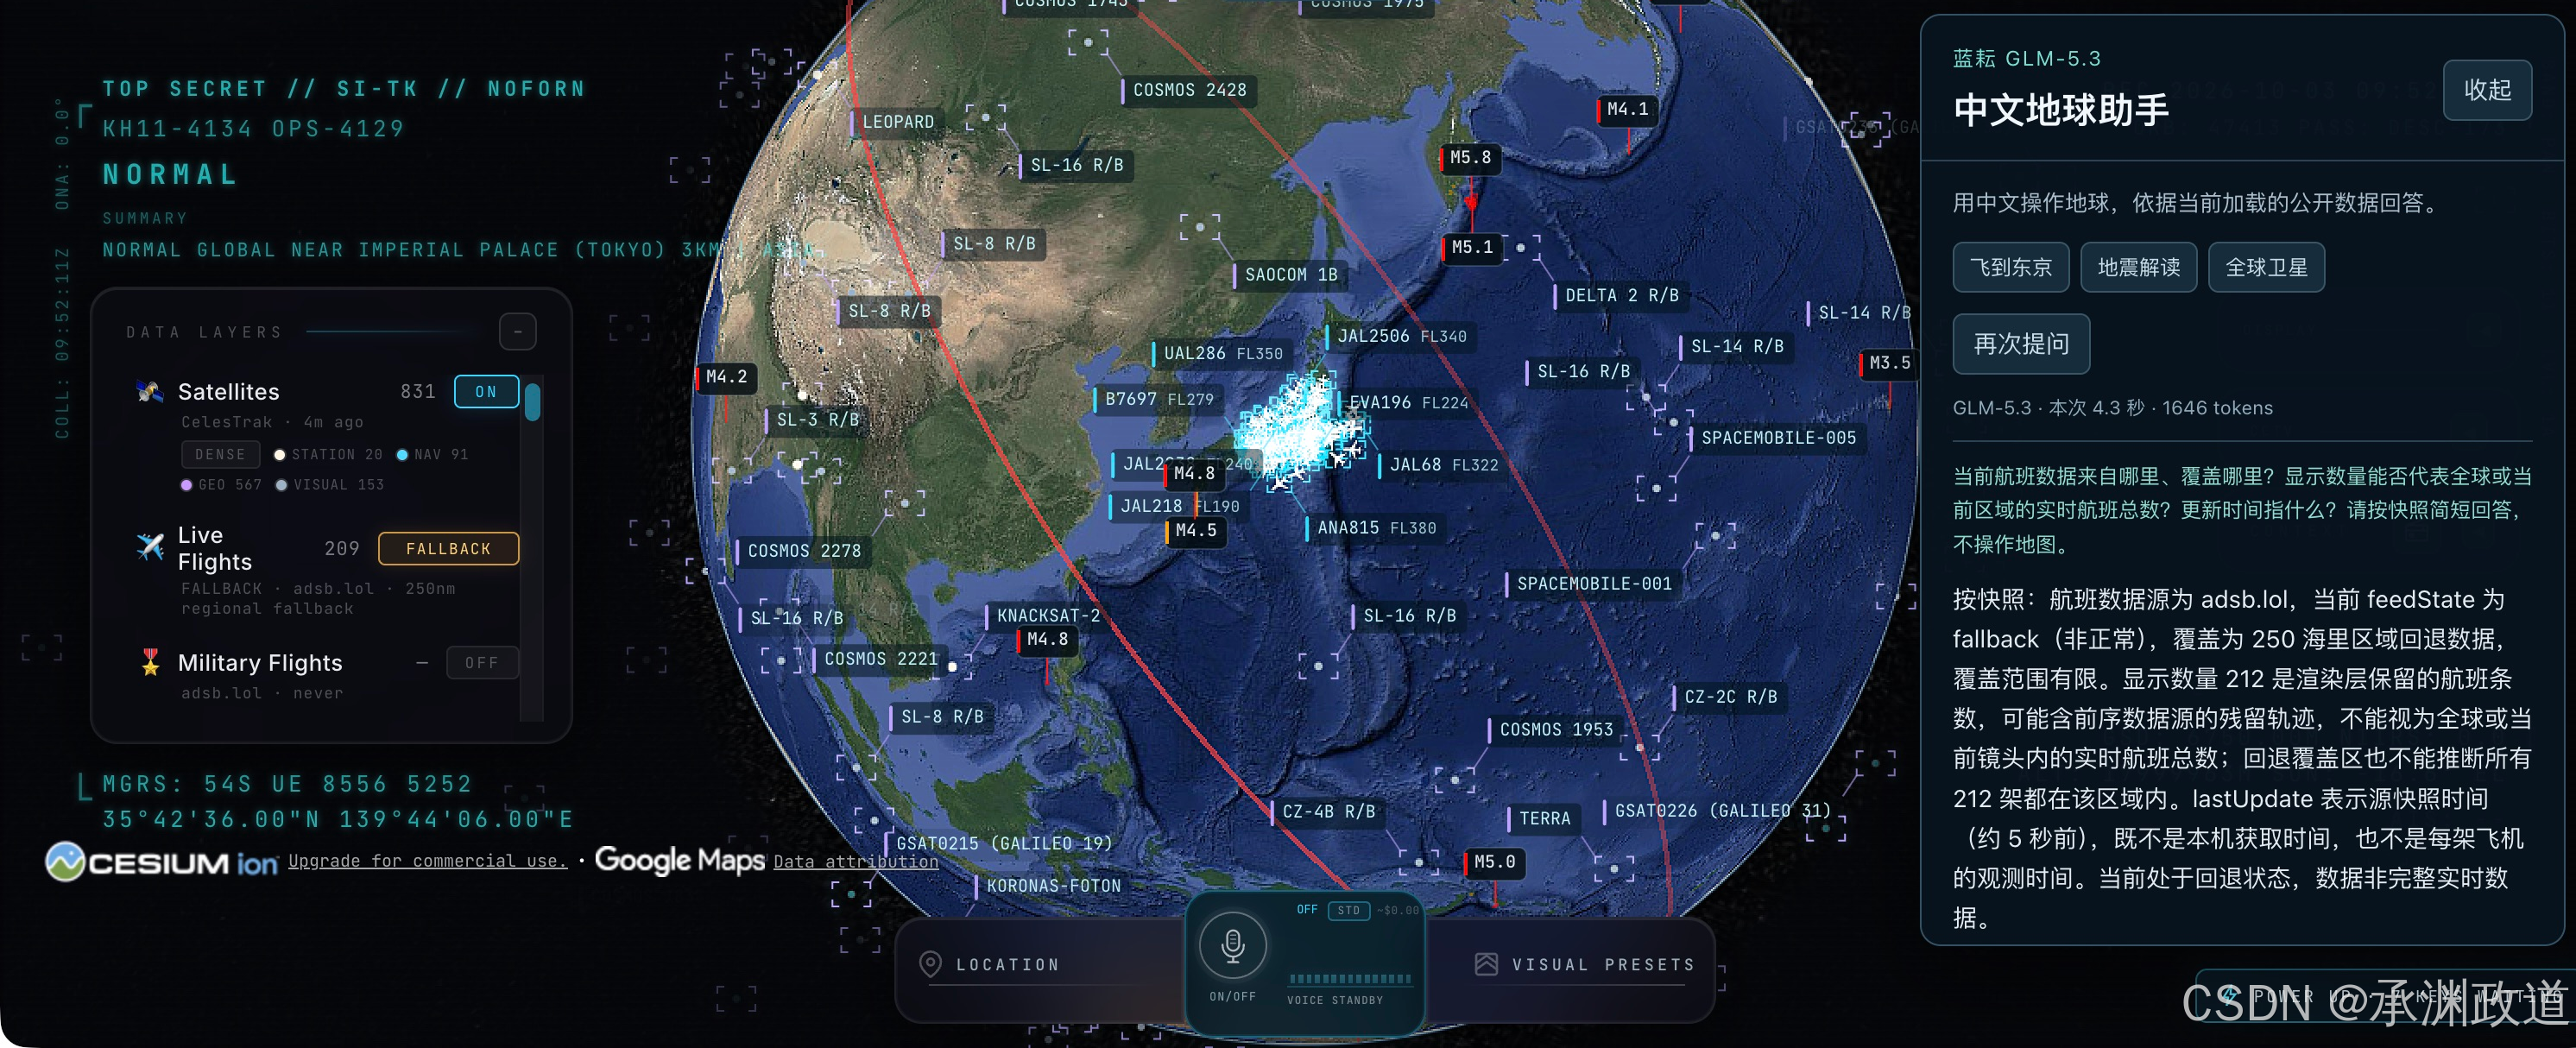
这也是这次改造最有用的部分.接口连通后,还要把软件里的业务含义交代清楚.蓝耘负责提供 GLM-5.3 的调用能力,数据含义仍要由项目代码和数据源定义;模型服务不会自动替我们补齐这些规则.
九、再做一个反向测试:没有明细时,它会不会硬答
我关闭地震图层,再问它能否给出当前最大震级,并明确要求不要开启图层.
当时界面还保留着 36 条的旧计数,但传入快照的地震明细数量为 0,最大震级字段为空.模型回答“不能”,解释缺少震级明细,也没有擅自打开图层.
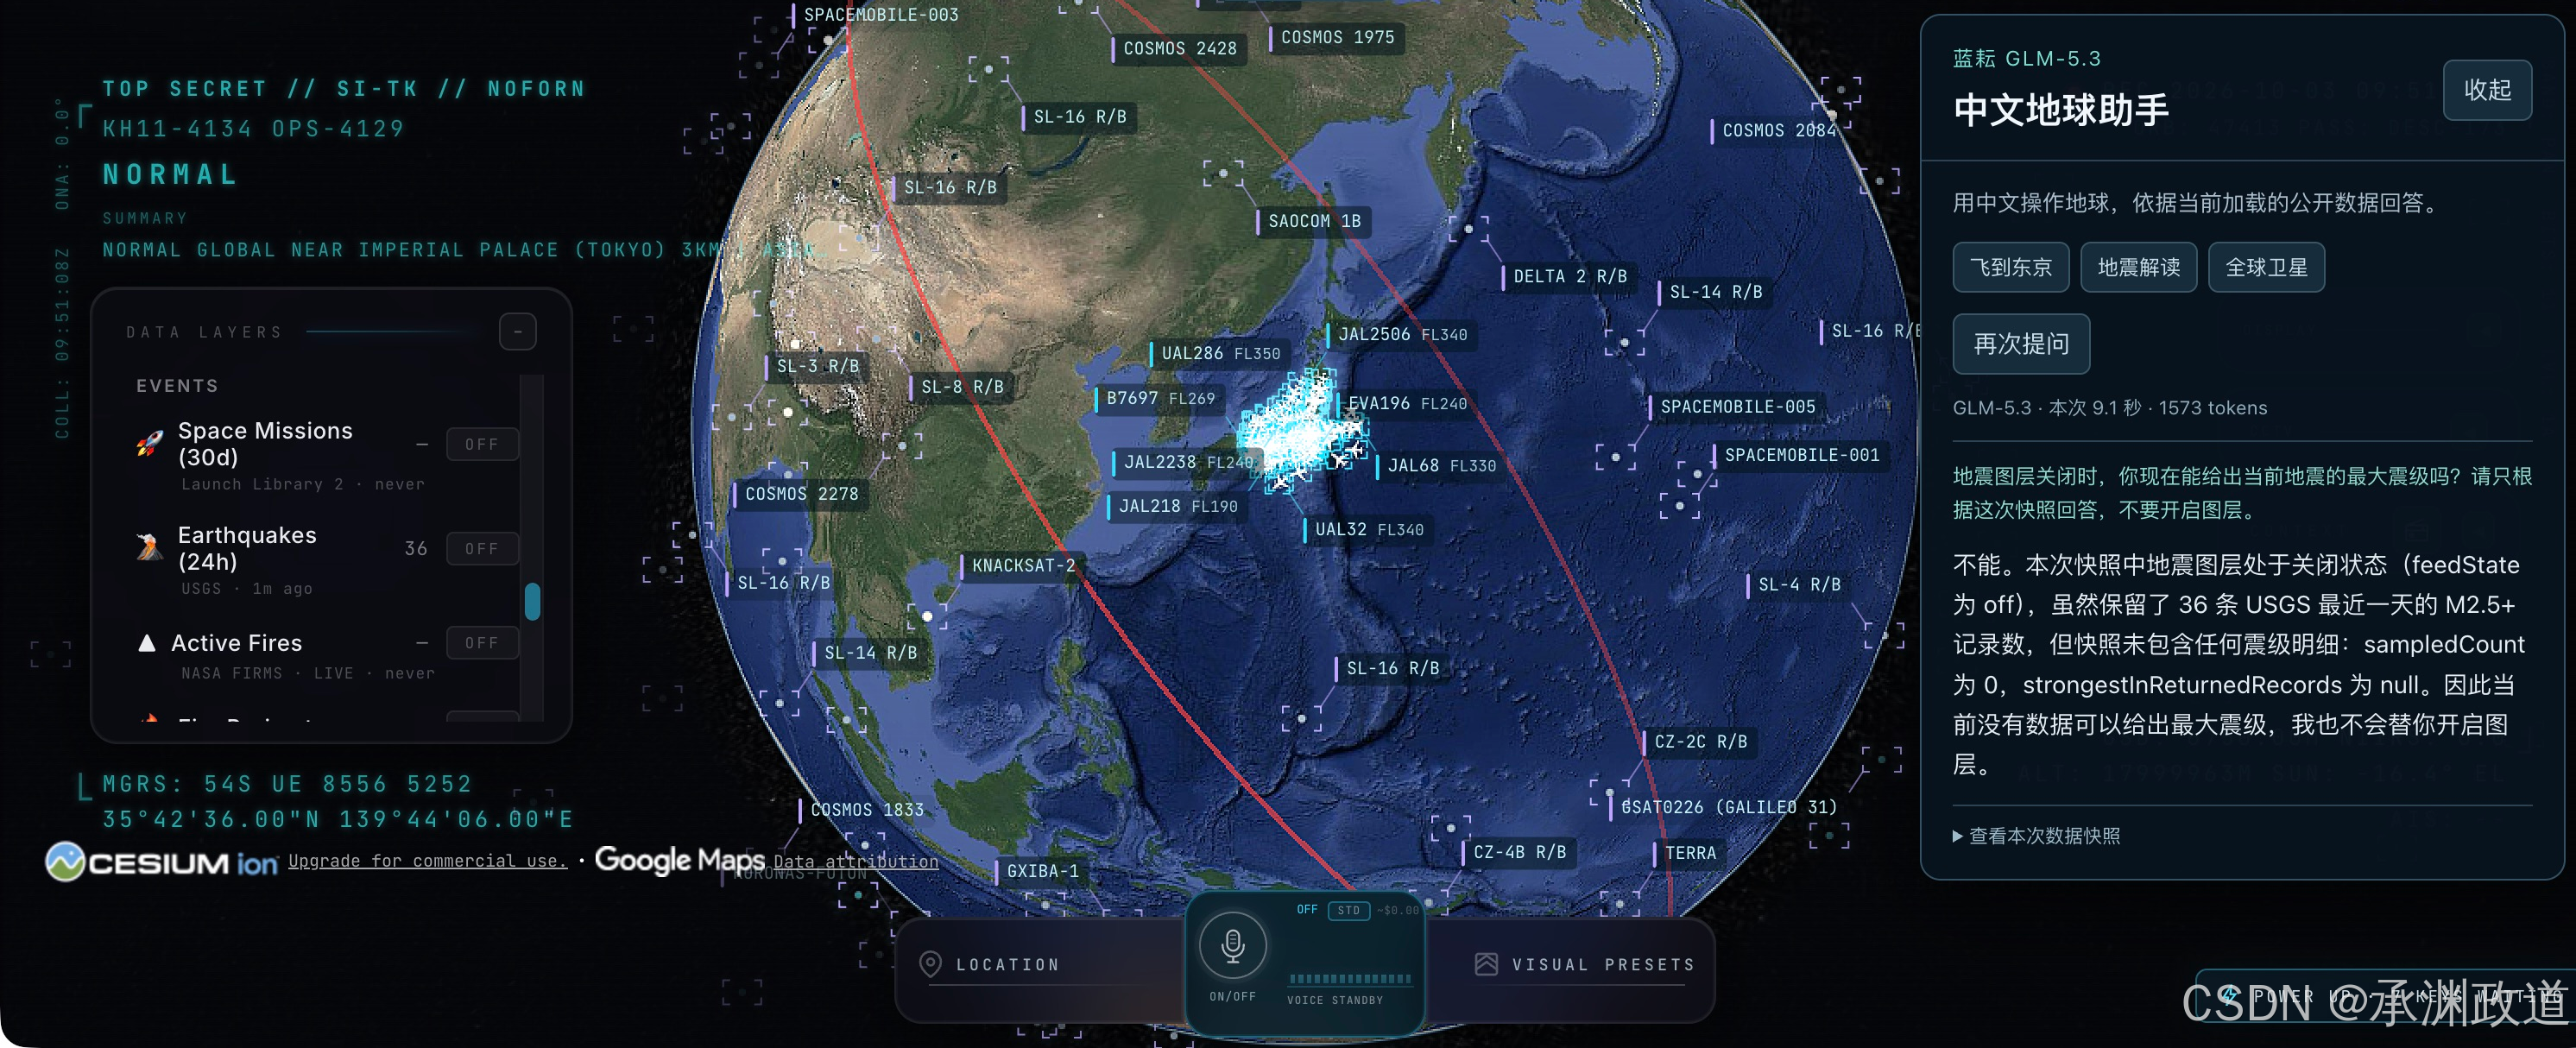
这张图比一段流畅的介绍更能说明边界:保留一个数量,并不代表仍然具备回答所有细节的数据.界面允许用户展开“本次数据快照”自行核对;每次提问读取一次快照,这个版本没有实现持续推送解读,也没有把上一轮聊天当作数据库.
十、这次实际验证到了什么
| 验证项 | 结果与范围 |
|---|---|
| 蓝耘接入 | 项目后端真实调用 GLM-5.3,取得回答、动作与用量 |
| 东京组合指令 | 镜头定位、航班图层开启,执行器分别确认成功 |
| 全球视图 | 全球导航与卫星图层操作成功 |
| 地震解释 | 37 条、最大震级 5.8,与该次真实快照对应 |
| 航班回退解释 | 能说明区域源、保留轨迹与时间字段的区别 |
| 地震关闭场景 | 无明细时不提供最大值,不擅自开图层 |
| 自动化检查 | 新增模块 30 项测试、相关原项目 92 项回归测试,共 122 项通过 |
| 工程检查 | 构建与导入边界检查通过;仍有原工程已有的大文件分块警告 |
联调中也有一次地震回答未通过返回校验,重试后才获得前面展示的结果.这次没有完成持续运行、并发或跨平台对照测试,因此上述结果只说明这些本地场景已经跑通.最终版本为模型输出预留了 2048 tokens,上游请求超时为45秒;非法动作、无效坐标和不完整输出仍需由程序拦截,不能靠多重试几次来代替校验.
如果继续把它做成日常使用的应用,我会先补上可选择的历史快照和更清楚的时间标记,让用户能够比较“刚才”和“现在”;随后再考虑更复杂的区域查询.直接增加更多图层,反而可能先放大数据口径不一致的问题.
这次蓝耘在项目里的角色很明确:它既是 TRAE Work 中 GLM-5.3 的开发调用入口,也是本地应用理解中文和解释快照的模型服务.God’s Eye View 提供地图与公开数据,原项目执行器负责操作,新增校验和快照规则负责约束输出.把这些分工接好后,三维地球才从一个好看的展示页,变成了可以用中文操作、追问并核对结果的小工具.
十一、项目与资料
敬请期待下一篇文章内容
每日心灵鸡汤: 真正强大的内心,从稳住情绪开始!
想要拥有强大的内心,就要学会稳住自己的情绪.接纳考试的得失,不因为一次成绩自我否定,分清他人的评价,哪些值得参考,哪些不必在意;遇到挫折不逃避,把难题当成磨炼自己的契机,允许自己有短板,明白成长本就是循序渐进,减少多余的内耗,不反复纠结已经发生的事情,定下属于自己的目标,不盲目和同学攀比高低.坚持日常点滴努力,在积累中积攒底气,内心笃定从容,便不惧求学路上的风雨.
转载自 CSDN-专业IT技术社区
原文链接:https://blog.csdn.net/2401_87629362/article/details/167038585

