

摘要: 在 AI Agent 应用中,传统的请求-响应模式已无法满足用户对实时反馈的期待。本文系统讲解如何使用 SSE(Server-Sent Events)和 WebSocket 两种技术方案实现 Agent 的流式输出,涵盖后端架构设计、前端打字机效果渲染、Markdown 实时解析、中断处理策略,以及一个完整的前后端实战案例。文章深入对比了 SSE 与 WebSocket 的适用场景,提供了生产级的代码实现,并给出了明确的风险边界。无论你正在构建对话式 Agent 还是复杂的多步骤 Agent 工作流,本文都能为你提供可直接落地的技术方案。
版本声明: 本文基于 Python 3.11+、FastAPI 0.110+、Python-SocketIO 5.11+、前端原生 JavaScript / React 18 编写。相关方案同样适用于 Node.js / Go 等后端语言,核心思路一致。文章中涉及的 LLM API 以 OpenAI 兼容接口为例,兼容 DeepSeek、通义千问等主流模型。阅读本文前,建议你已具备基本的 Web 开发经验和 AI Agent 构建基础。
文章目录
一、为什么 Agent 需要流式输出:用户体验与交互设计
1.1 传统请求-响应模式的痛点
想象一个场景:用户向 Agent 发送一条指令——“帮我分析这份财报,总结核心数据并给出投资建议”。在传统的同步模式下,用户面对的是一个漫长的等待过程:请求发出后,页面转圈,几秒甚至十几秒后才返回完整结果。这段等待期间,用户无法知道 Agent 到底在做什么、进展到哪一步、是否遇到了错误。
这种体验有几个严重的问题:
- 感知延迟高:LLM 生成一个长回答可能需要 10-30 秒,用户在等待期间完全看不到任何反馈
- 不确定性焦虑:用户不知道 Agent 是否正常工作,是否会超时失败
- 无法中断:即使用户发现方向不对,也无法中途叫停,只能等整个响应完成后才能重新提问
- 缺乏过程透明度:Agent 的中间思考步骤(如搜索、工具调用、推理链)对用户不可见
1.2 流式输出带来的交互变革
流式输出(Streaming Output)将 Agent 的响应过程从"一次性交付"变为"持续交付"。它的核心价值体现在三个层面:
第一层:Token 级流式——LLM 每生成一个 Token 就推送给前端,用户看到文字逐字出现,就像有人在实时打字。这大幅降低了感知延迟,从"等 10 秒看一大段文字"变成"立刻看到第一个字"。
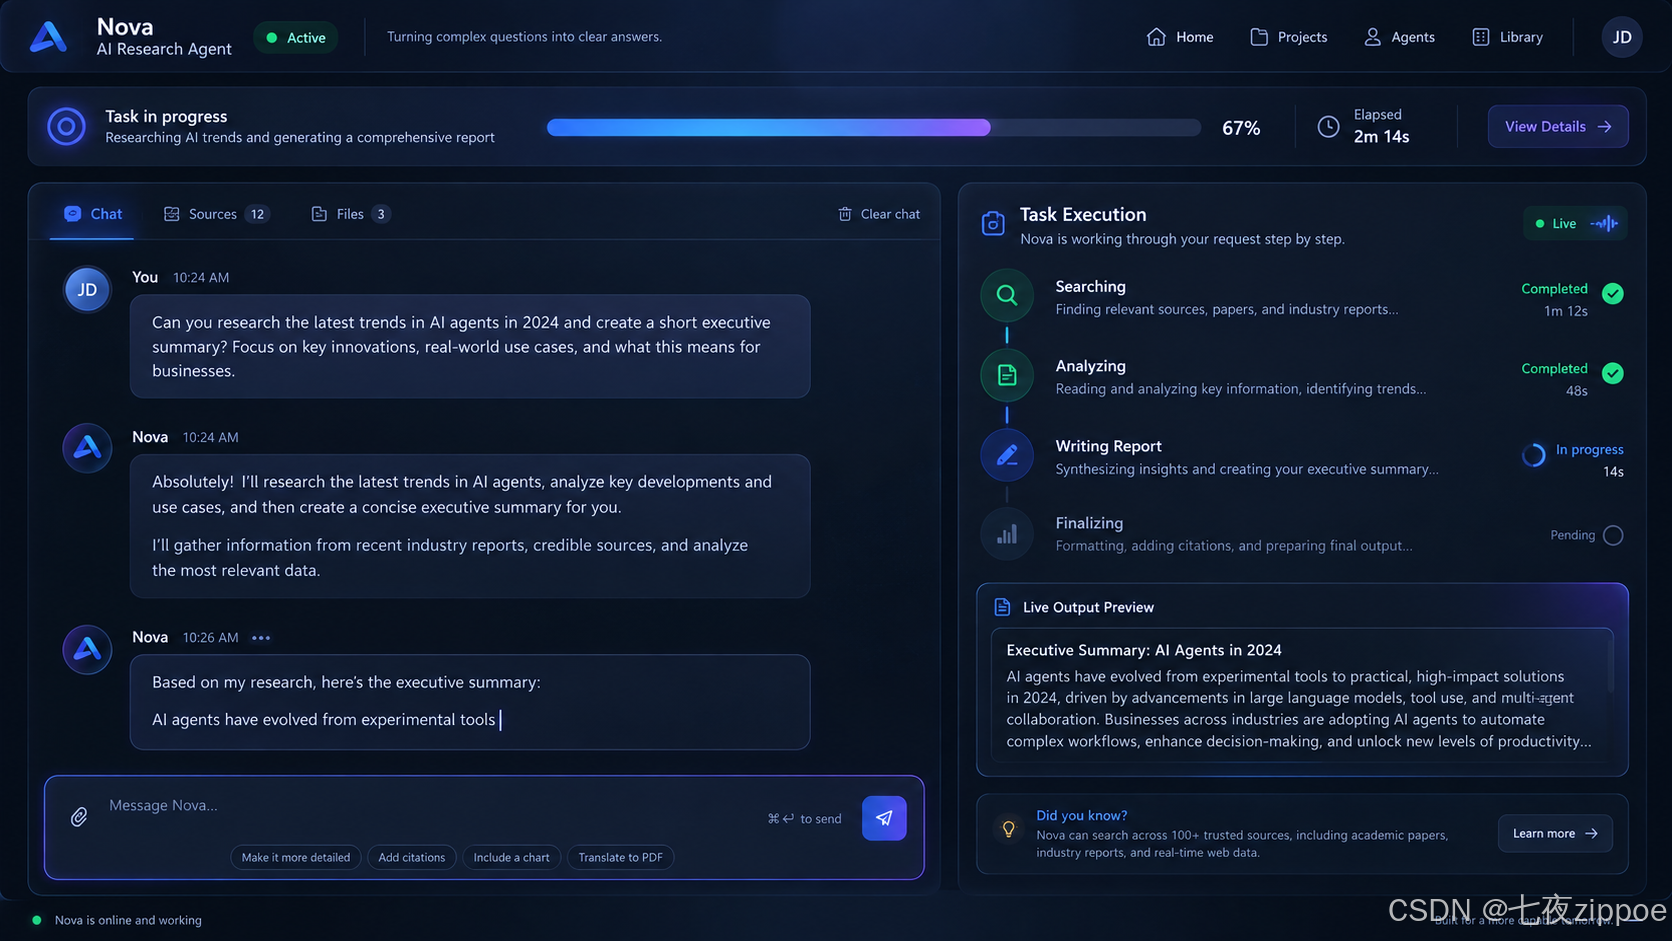
第二层:步骤级流式——当 Agent 执行多步骤任务(如"搜索→分析→总结"),每个步骤的开始、进展、完成都实时推送。用户能看到 Agent 正在执行什么操作,而不是面对一个黑盒。
第三层:交互级流式——在流式过程中,用户可以发送新的指令来影响 Agent 的后续行为。比如用户看到前半段输出方向不对,可以中途发送"换个角度分析",Agent 能感知并调整。
1.3 流式输出 vs 传统模式的对比
| 维度 | 传统请求-响应 | 流式输出 |
|---|---|---|
| 首字节延迟 | 等待完整生成(5-30s) | 接近实时(<1s) |
| 中间状态可见 | 不可见 | 完全透明 |
| 中断能力 | 不支持 | 支持,可随时停止 |
| 用户体验 | 焦虑等待 | 掌控感强,参与感强 |
| 实现复杂度 | 简单 | 中等到复杂 |
| 网络协议 | HTTP 请求-响应 | SSE 或 WebSocket |
| 服务器资源 | 短连接,快速释放 | 长连接,需管理 |
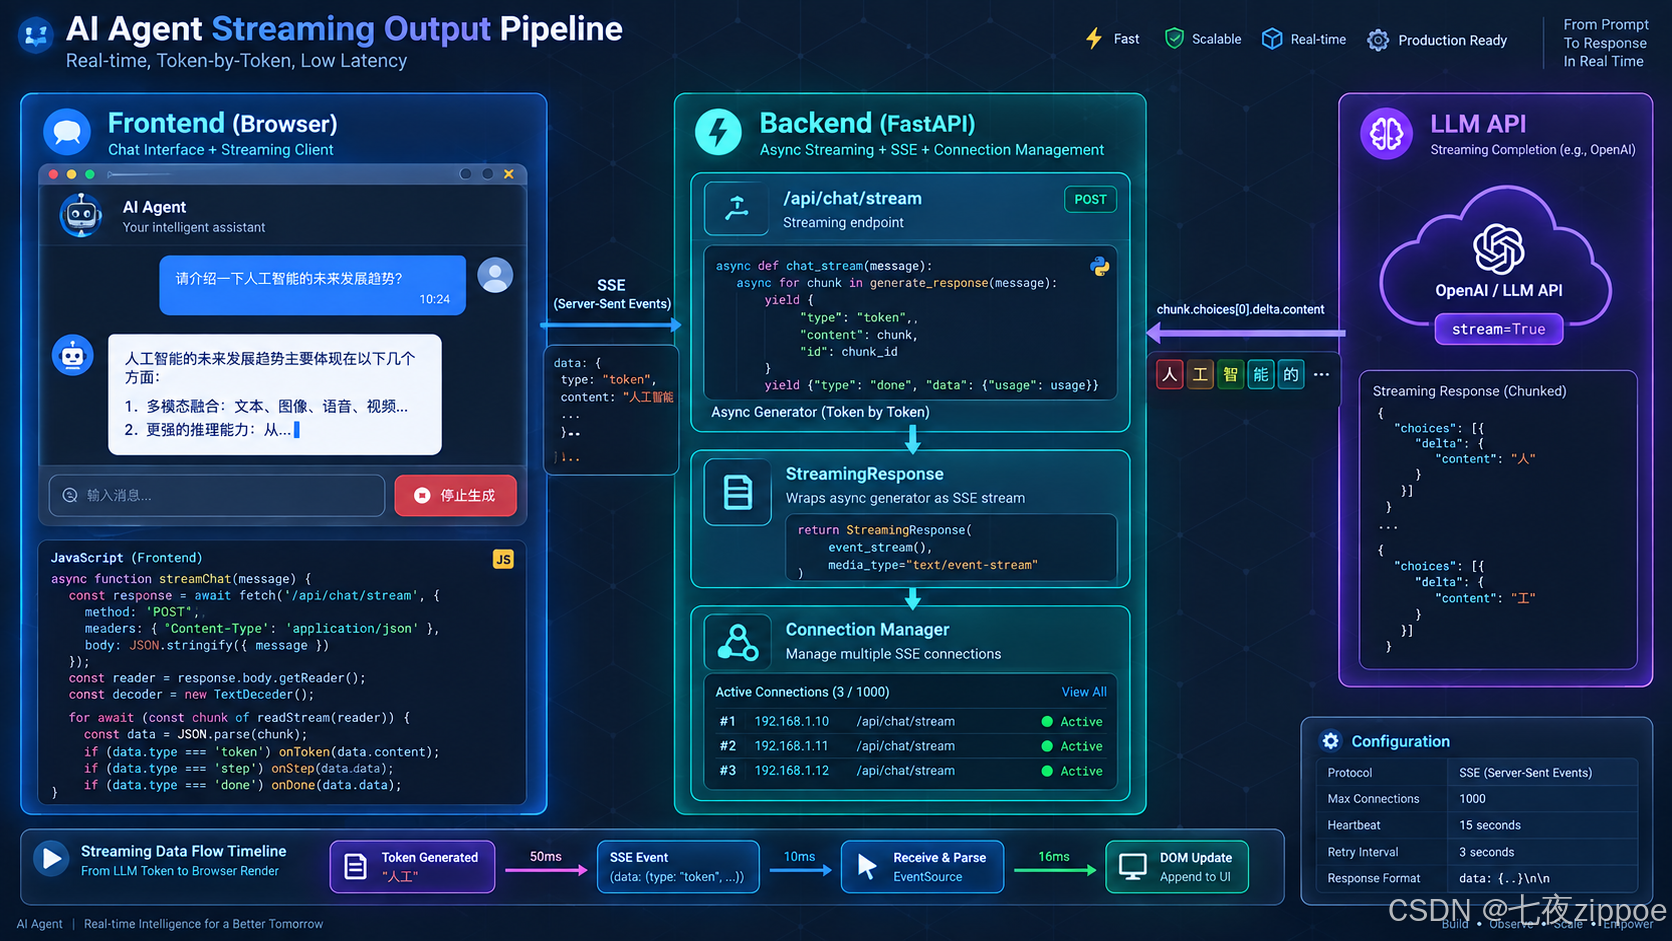
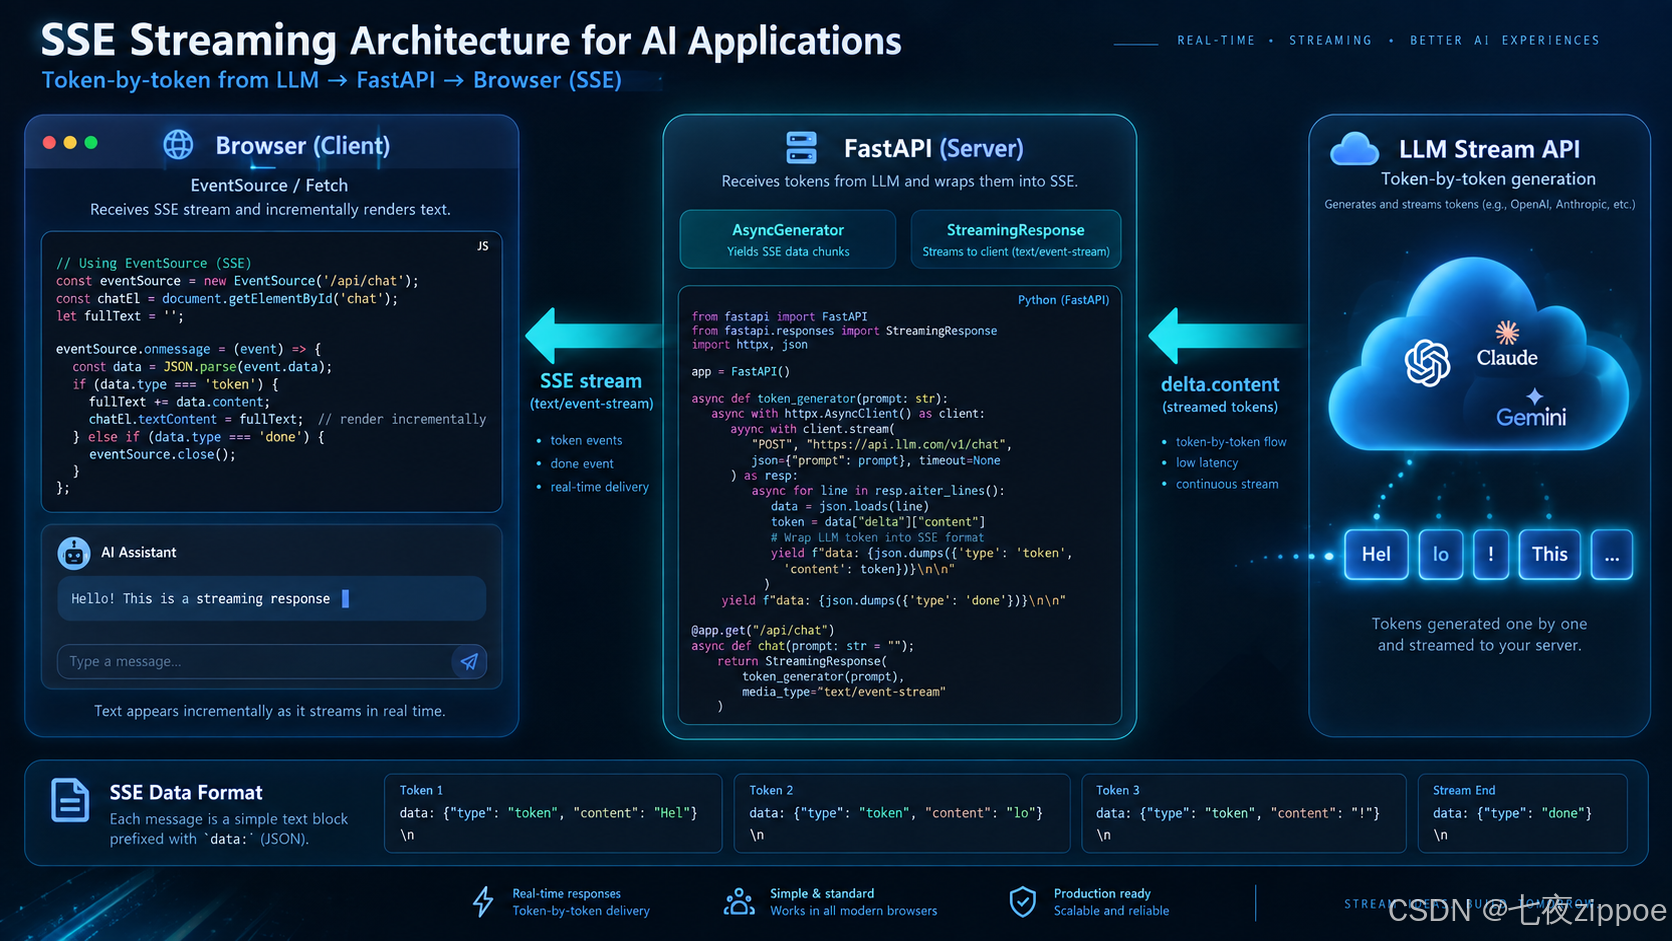
图:流式输出三层架构:前端(EventSource/Fetch接收+打字机渲染)→后端(FastAPI StreamingResponse+异步生成器)→LLM API(流式Token输出)
1.4 什么时候需要流式输出
不是所有场景都需要流式。以下是需要流式的典型场景:
- 对话式 Agent——用户发送消息,等待 Agent 回复。流式输出让用户更快看到回答。
- 任务执行型 Agent——Agent 执行多步骤任务(如写报告、做分析),用户需要看到每一步的进展。
- 工具调用型 Agent——Agent 调用外部工具(如搜索、代码执行),用户需要知道调用了什么工具、结果如何。
- 协作型 Agent——多个 Agent 协作完成任务,用户需要看到每个 Agent 的工作状态。
1.5 流式输出的技术演进路径
在 AI Agent 的发展历程中,流式输出的实现方式也经历了一个演进过程:
第一阶段:轮询(Polling)
早期的 Agent 应用采用轮询方式——前端每隔 1-2 秒向后端发送一次请求,查询当前进度。这种方式实现简单,但存在明显缺陷:大量无效请求浪费带宽、实时性差(最多 2 秒延迟)、服务器日志被轮询请求淹没。
第二阶段:长轮询(Long Polling)
长轮询是对普通轮询的改进——前端发送请求后,服务器保持连接不立即返回,直到有新数据或超时才返回。前端收到响应后立即发送下一个请求。Comet 技术就是典型的长轮询方案。这种方式减少了无效请求,但每次返回后需要重新建立连接,且 HTTP 头部开销大。
第三阶段:SSE / WebSocket
也就是本文要深入讲解的两种方案。SSE 和 WebSocket 都基于持久连接,一次连接建立后可以持续推送数据,真正实现了实时通信。它们是当前 AI Agent 流式输出的主流选择,也是本文的核心内容。
第四阶段:Agent 原生流式协议
随着 Agent 框架的发展,一些更高级的流式协议开始出现。例如 LangChain 的 astream_events API、LangGraph 的事件流、OpenAI Assistants API 的流式事件等。这些协议不仅流式输出 LLM token,还能流式推送工具调用、思考过程、状态变更等结构化事件,让 Agent 的整个执行过程完全透明化。但无论上层的协议如何设计,底层的传输机制仍然是 SSE 或 WebSocket。
二、SSE 方案:Server-Sent Events 实现流式文本输出
2.1 SSE 原理与特点
SSE(Server-Sent Events)是 HTML5 标准的一部分,它允许服务器通过 HTTP 长连接向客户端推送数据。与 WebSocket 不同,SSE 是单向的——只能从服务器到客户端,但这恰恰是 Agent 流式输出最需要的模式。
SSE 的核心优势在于简洁:它基于标准 HTTP 协议,不需要额外的协议升级,不需要特殊的代理配置,天然支持断线重连。对于 Agent 的流式输出场景(服务器→客户端的单向数据流),SSE 通常是首选方案。
2.2 SSE 数据格式
SSE 使用纯文本格式,每条消息以 data: 开头,以两个换行符 \n\n 结束:
data: {"type": "token", "content": "你"}\n\n
data: {"type": "token", "content": "好"}\n\n
data: {"type": "step", "name": "搜索完成", "status": "done"}\n\n
data: [DONE]\n\n
2.3 后端实现:FastAPI + SSE
以下是使用 FastAPI 实现 SSE 流式输出的完整后端代码:
import json
import asyncio
from fastapi import FastAPI, Request
from fastapi.responses import StreamingResponse
from openai import AsyncOpenAI

app = FastAPI(title="Agent Streaming API")

# 初始化 LLM 客户端(兼容 OpenAI 接口的模型均可)
client = AsyncOpenAI(
    api_key="your-api-key",
    base_url="https://api.deepseek.com/v1"  # 以 DeepSeek 为例
)


async def agent_stream_generator(user_message: str, request: Request):
    """
    Agent 流式输出生成器
    产出三种类型的事件:
    1. step - 步骤状态更新(如"正在思考"、"正在搜索")
    2. token - LLM 生成的文本片段
    3. done - 流结束标记
    """
    # 第一步:推送"正在思考"状态
    yield f"data: {json.dumps({'type': 'step', 'step': 'thinking', 'status': 'started', 'message': 'Agent 正在思考...'})}\n\n"

    await asyncio.sleep(0.3)  # 模拟思考延迟

    # 第二步:调用 LLM 并流式传输
    yield f"data: {json.dumps({'type': 'step', 'step': 'thinking', 'status': 'completed', 'message': '思考完成,开始生成回复'})}\n\n"

    yield f"data: {json.dumps({'type': 'step', 'step': 'generating', 'status': 'started', 'message': '正在生成回复...'})}\n\n"

    try:
        stream = await client.chat.completions.create(
            model="deepseek-chat",
            messages=[
                {"role": "system", "content": "你是一个专业的AI助手,请用中文回答。"},
                {"role": "user", "content": user_message},
            ],
            stream=True,  # 关键:启用流式输出
        )

        async for chunk in stream:
            # 检查客户端是否断开连接
            if await request.is_disconnected():
                print("客户端已断开,停止生成")
                break

            if chunk.choices[0].delta.content is not None:
                token_data = {
                    "type": "token",
                    "content": chunk.choices[0].delta.content
                }
                yield f"data: {json.dumps(token_data, ensure_ascii=False)}\n\n"

        # 流结束
        yield f"data: {json.dumps({'type': 'step', 'step': 'generating', 'status': 'completed'})}\n\n"
        yield "data: [DONE]\n\n"

    except Exception as e:
        error_data = {
            "type": "error",
            "message": f"生成过程中出错: {str(e)}"
        }
        yield f"data: {json.dumps(error_data, ensure_ascii=False)}\n\n"


@app.post("/api/chat/stream")
async def chat_stream(request: Request):
    """
    SSE 流式对话接口
    接收用户消息,返回 SSE 流
    """
    body = await request.json()
    user_message = body.get("message", "")

    return StreamingResponse(
        agent_stream_generator(user_message, request),
        media_type="text/event-stream",
        headers={
            "Cache-Control": "no-cache",
            "Connection": "keep-alive",
            "X-Accel-Buffering": "no",  # 关闭 Nginx 缓冲,确保实时推送
        }
    )
代码解析: 上面的代码实现了完整的 SSE 流式输出后端。核心要点有三个:第一,agent_stream_generator 是一个异步生成器,通过 yield 逐步产出 SSE 格式的数据,它推送的不只是 LLM 的 token,还有步骤状态变更事件(step 类型),让前端能展示 Agent 当前在做什么。第二,StreamingResponse 是 FastAPI 提供的流式响应类,它将异步生成器的输出以 text/event-stream 的 MIME 类型返回给客户端,这是 SSE 的标准内容类型。第三,X-Accel-Buffering: no 这个响应头至关重要——Nginx 默认会缓冲后端的响应内容,这会导致 SSE 数据不能实时推送到客户端,设置此头可以关闭缓冲。
2.4 前端实现:EventSource 接收 SSE
前端使用浏览器原生的 EventSource API 或 fetch 来接收 SSE 数据。由于 EventSource 只支持 GET 请求,而 Agent 交互通常需要 POST(发送消息体),因此推荐使用 fetch + ReadableStream 方案:
/**
 * SSE 流式对话客户端
 * 使用 fetch + ReadableStream 实现,支持 POST 请求
 */
class AgentSSEClient {
  constructor(url) {
    this.url = url;
    this.controller = null;  // AbortController,用于中断
    this.onToken = null;      // token 回调
    this.onStep = null;       // 步骤状态回调
    this.onError = null;      // 错误回调
    this.onDone = null;       // 完成回调
  }

  async sendMessage(message) {
    this.controller = new AbortController();

    try {
      const response = await fetch(this.url, {
        method: "POST",
        headers: { "Content-Type": "application/json" },
        body: JSON.stringify({ message }),
        signal: this.controller.signal,
      });

      if (!response.ok) {
        throw new Error(`HTTP error! status: ${response.status}`);
      }

      const reader = response.body.getReader();
      const decoder = new TextDecoder();
      let buffer = "";

      while (true) {
        const { done, value } = await reader.read();
        if (done) break;

        buffer += decoder.decode(value, { stream: true });

        // SSE 数据以 \n\n 分隔
        const lines = buffer.split("\n\n");
        buffer = lines.pop();  // 保留最后不完整的数据

        for (const line of lines) {
          if (!line.startsWith("data: ")) continue;

          const data = line.slice(6).trim();
          if (data === "[DONE]") {
            this.onDone?.();
            return;
          }

          try {
            const event = JSON.parse(data);
            switch (event.type) {
              case "token":
                this.onToken?.(event.content);
                break;
              case "step":
                this.onStep?.(event);
                break;
              case "error":
                this.onError?.(event.message);
                break;
            }
          } catch (e) {
            console.warn("Failed to parse SSE data:", data);
          }
        }
      }
    } catch (err) {
      if (err.name === "AbortError") {
        console.log("请求已被用户中断");
      } else {
        this.onError?.(err.message);
      }
    }
  }

  // 中断当前流式请求
  stop() {
    if (this.controller) {
      this.controller.abort();
      this.controller = null;
    }
  }
}

// 使用示例
const client = new AgentSSEClient("/api/chat/stream");
let fullText = "";

client.onToken = (token) => {
  fullText += token;
  document.getElementById("output").textContent = fullText;
  // 滚动到底部
  document.getElementById("output").scrollTop =
    document.getElementById("output").scrollHeight;
};

client.onStep = (event) => {
  console.log(`步骤: ${event.step} -> ${event.status}`, event.message);
  // 更新 UI 显示当前步骤状态
  const statusEl = document.getElementById("status");
  statusEl.textContent = event.message || `${event.step}: ${event.status}`;
};

client.onError = (msg) => {
  console.error("Agent 错误:", msg);
};

client.onDone = () => {
  console.log("流式输出完成");
};

// 发送消息
client.sendMessage("请解释什么是 Transformer 架构");
代码解析: 这段前端代码封装了一个 AgentSSEClient 类,核心使用 fetch API 配合 ReadableStream 来消费 SSE 流。选择 fetch 而非原生 EventSource 的原因是,EventSource 只支持 GET 请求,无法发送 JSON 消息体。代码中有几个关键设计:AbortController 提供了中断能力,用户可以随时停止生成;buffer 变量处理 TCP 分包问题——一次 read() 可能返回不完整的 SSE 数据,需要缓存拼接后按 \n\n 分隔;事件通过回调函数分发,不同类型的消息(token、step、error)分别处理,使得 UI 更新逻辑清晰。
2.5 SSE 的多步骤 Agent 流式
当 Agent 需要执行多个步骤(如搜索→分析→生成)时,SSE 可以推送完整的执行链路:
async def multi_step_agent_stream(user_message: str, request: Request):
    """
    多步骤 Agent 的流式输出
    每个步骤都有状态推送 + 内容输出
    """
    steps = [
        {"id": "understand", "name": "理解用户意图", "executor": understand_intent},
        {"id": "search", "name": "搜索相关信息", "executor": search_web},
        {"id": "analyze", "name": "分析搜索结果", "executor": analyze_results},
        {"id": "generate", "name": "生成最终回复", "executor": generate_response},
    ]

    context = {"user_message": user_message}

    for step in steps:
        # 推送步骤开始
        yield f"data: {json.dumps({'type': 'step_start', 'step_id': step['id'], 'step_name': step['name']}, ensure_ascii=False)}\n\n"

        # 执行步骤,可能产出中间结果
        async for chunk in step["executor"](context):
            if await request.is_disconnected():
                return
            yield f"data: {json.dumps({'type': 'step_data', 'step_id': step['id'], 'content': chunk}, ensure_ascii=False)}\n\n"
            await asyncio.sleep(0.01)  # 让出事件循环

        # 推送步骤完成
        yield f"data: {json.dumps({'type': 'step_end', 'step_id': step['id']}, ensure_ascii=False)}\n\n"

    yield "data: [DONE]\n\n"
代码解析: 这段代码展示了一个多步骤 Agent 的流式输出框架。它将 Agent 的执行流程抽象为有序的步骤列表,每个步骤包含三个阶段——开始、执行、结束,对应三种 SSE 事件类型。step_data 事件携带步骤执行过程中产生的中间结果(如搜索到的网页摘要、分析得出的关键点),让用户能实时看到每一步的产出。context 字典在步骤间传递数据,understand_intent 的输出成为 search_web 的输入,依此类推。这种设计让复杂的 Agent 工作流变得透明可观测。
2.6 SSE 连接管理与断线重连
在生产环境中,网络不稳定是常态。SSE 的一个重要优势是原生支持断线重连——浏览器 EventSource API 自动在连接断开后重试。但使用 fetch 实现 SSE 时,需要手动实现重连逻辑。
async def sse_with_reconnect(request: Request, last_event_id: str = None):
    """
    支持断线重连的 SSE 接口
    通过 Last-Event-ID 头部恢复中断的流
    """
    async def event_stream():
        # 检查是否有断点恢复信息
        if last_event_id:
            yield f"data: {json.dumps({'type': 'resuming', 'from_event': last_event_id})}\n\n"
            # 从存储中恢复之前的事件位置
            # 例如从 Redis 中获取已发送的事件 ID 列表
            resume_from = int(last_event_id)
        else:
            resume_from = 0
            yield f"data: {json.dumps({'type': 'start', 'message': '新会话开始'})}\n\n"

        event_id = resume_from

        while True:
            if await request.is_disconnected():
                break

            # 获取下一条事件(从消息队列、数据库等)
            event = await get_next_event(event_id)
            if event is None:
                # 没有新事件,发送心跳保持连接
                yield f": heartbeat\n\n"
                await asyncio.sleep(15)  # 每15秒发送一次心跳
                continue

            event_id += 1
            yield f"id: {event_id}\n"
            yield f"data: {json.dumps(event, ensure_ascii=False)}\n\n"

    return StreamingResponse(
        event_stream(),
        media_type="text/event-stream",
        headers={
            "Cache-Control": "no-cache",
            "Connection": "keep-alive",
            "X-Accel-Buffering": "no",
        }
    )
代码解析: 这段代码展示了 SSE 断线重连的生产级实现。Last-Event-ID 是 SSE 协议的标准字段——浏览器 EventSource 在重连时会自动在请求头中携带 Last-Event-ID,服务端可以根据它恢复中断的流。代码中 id: {event_id} 行为每个事件分配序号,客户端会记录最后收到的事件 ID。当连接断开后重连,服务端从 resume_from 继续推送。心跳机制(: heartbeat)是 SSE 的注释行——以冒号开头的数据不会被客户端当作消息处理,但它能保持 TCP 连接活跃,防止中间代理超时断开。
2.7 SSE 在 Nginx 反向代理下的配置
这是生产环境中最常见的 SSE 踩坑点。Nginx 默认会缓冲后端的响应,导致 SSE 数据积压后才一次性发送,完全失去实时性:
# Nginx SSE 配置
server {
    listen 80;
    server_name api.youragent.com;

    # SSE 接口专用配置
    location /api/sse/ {
        proxy_pass http://backend:8000;

        # 关闭缓冲,关键配置
        proxy_buffering off;
        proxy_cache off;

        # 关闭 TCP 缓冲,确保小数据包立即发送
        proxy_set_header Connection "";
        proxy_http_version 1.1;
        proxy_set_header X-Accel-Buffering no;

        # SSE 长连接超时设置(建议 5-10 分钟)
        proxy_read_timeout 300s;
        proxy_send_timeout 300s;

        # 传递客户端真实 IP
        proxy_set_header X-Real-IP $remote_addr;
        proxy_set_header X-Forwarded-For $proxy_add_x_forwarded_for;
    }

    # WebSocket 接口配置
    location /ws/ {
        proxy_pass http://backend:8000;
        proxy_http_version 1.1;
        proxy_set_header Upgrade $http_upgrade;
        proxy_set_header Connection "upgrade";
        proxy_read_timeout 300s;
        proxy_send_timeout 300s;
    }
}
代码解析: Nginx SSE 配置的核心是 proxy_buffering off——关闭响应缓冲后,后端产生的每个 SSE 事件会立即转发给客户端。proxy_read_timeout 300s 将读取超时设为 5 分钟,防止 Nginx 在 Agent 思考期间断开连接(默认超时只有 60 秒)。WebSocket 配置中的 Upgrade 和 Connection 头部是协议升级所必需的,缺少任何一个都会导致 WebSocket 握手失败。
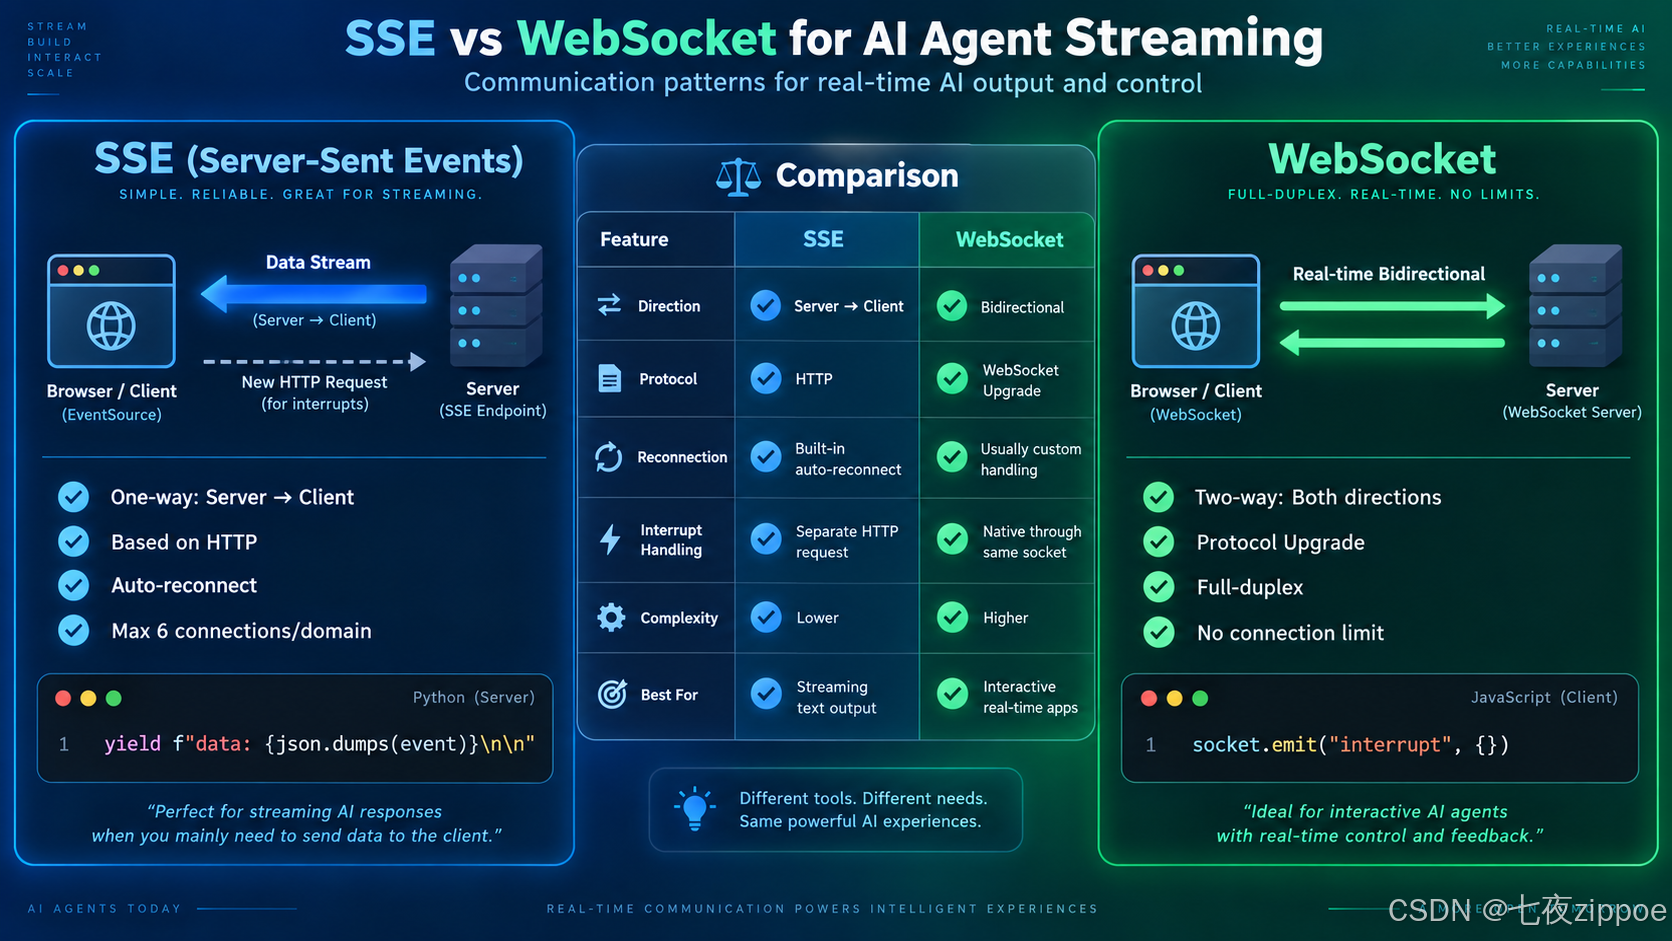
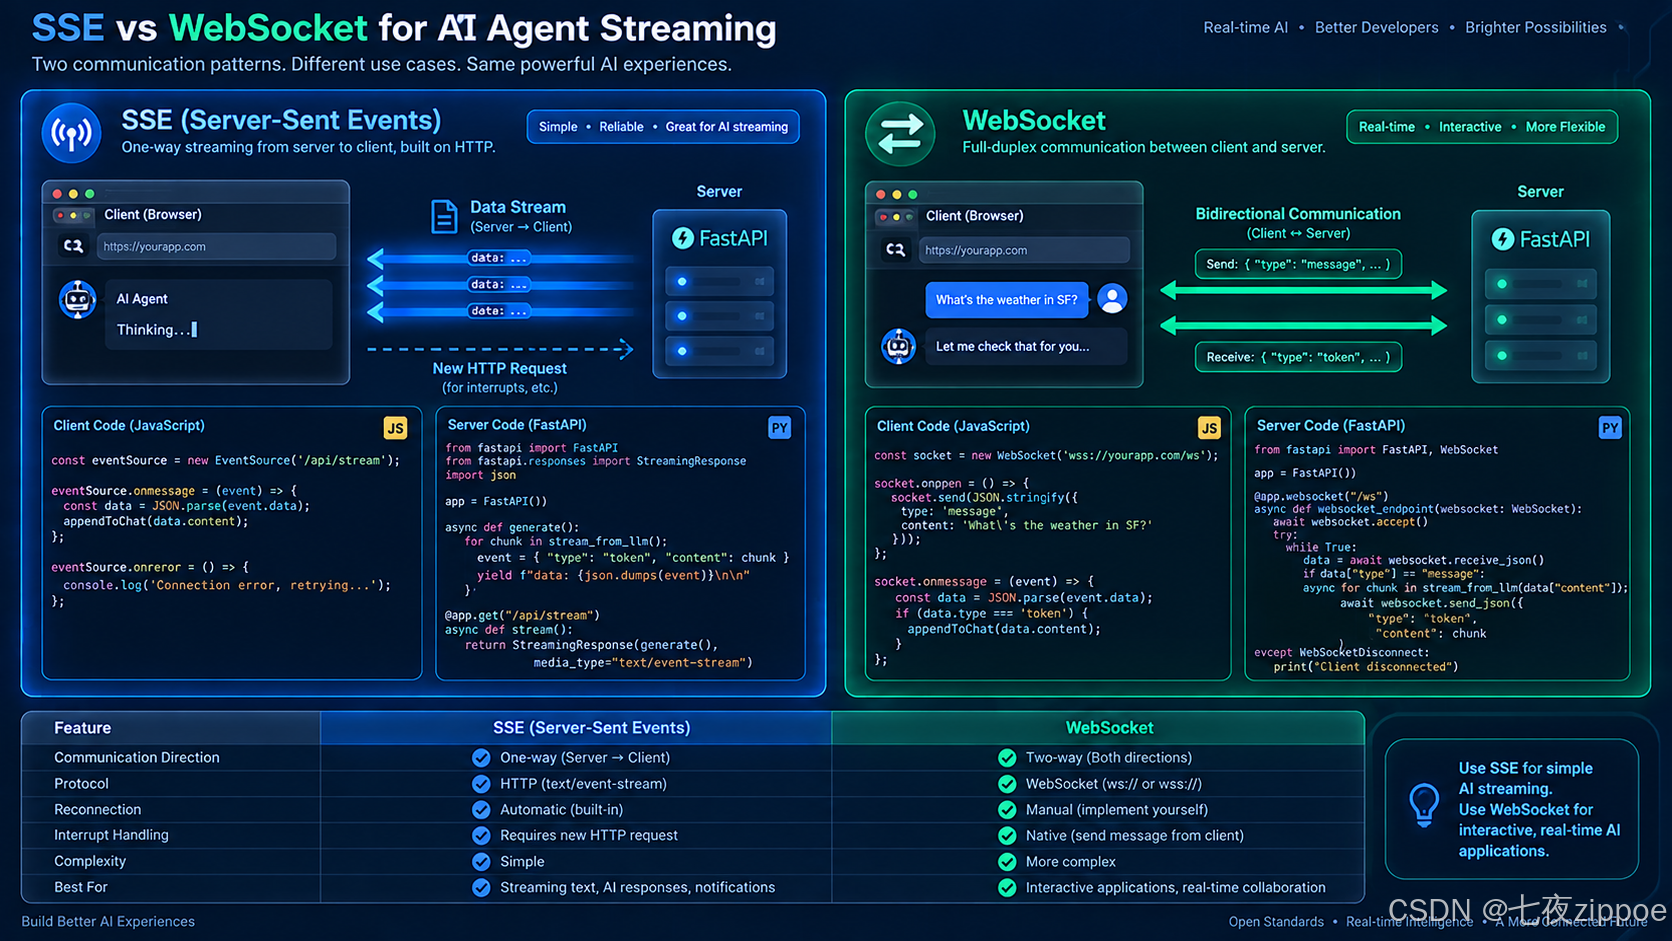
图:左侧SSE单向通信(服务器→客户端数据流,客户端需新建连接发消息),右侧WebSocket双向通信(实时双向箭头,随时发送和接收)
2.8 SSE 的事件类型设计
一个设计良好的 Agent SSE 事件系统应该包含哪些事件类型?以下是经过实践验证的事件协议设计:
| 事件类型 | 描述 | 典型字段 | 前端处理方式 |
|---|---|---|---|
step_start | 步骤开始 | step_id, step_name, timestamp | 显示步骤指示器 |
step_data | 步骤中间数据 | step_id, content, data_type | 渲染中间结果 |
step_end | 步骤完成 | step_id, duration, result | 更新步骤状态为完成 |
token | LLM token | content | 追加到文本缓冲 |
tool_call | 工具调用 | tool_name, args, call_id | 显示工具调用卡片 |
tool_result | 工具返回 | call_id, result, duration | 更新工具调用结果 |
thinking | Agent 思考过程 | content, depth | 显示折叠的思考链 |
error | 错误 | message, code, recoverable | 显示错误提示 |
interrupted | 被中断 | partial_output, reason | 保留部分输出 |
done | 完整完成 | full_output, metadata | 标记完成,保存结果 |
这种事件协议设计的关键在于结构化——每个事件都有明确的类型和字段,前端可以根据类型做出不同的渲染决策。例如 tool_call 和 tool_result 事件可以让前端渲染出工具调用的可视化卡片,而不是把工具信息混在 LLM 的文本输出中。这种结构化的事件系统也让前端可以实现更丰富的交互——比如点击工具调用卡片查看完整的输入参数和返回结果。
2.9 SSE 的性能优化技巧
在处理大量并发 SSE 连接时,有几个性能优化点值得关注:
1. 使用 uvicorn 的多 worker 模式
SSE 是长连接,单个 worker 能处理的并发连接数有限。使用 uvicorn --workers 4 启动多个 worker 进程可以提升并发能力。但注意每个 worker 是独立进程,不共享内存中的会话状态,需要使用 Redis 等外部存储来共享状态。
2. 使用异步 I/O,避免阻塞事件循环
SSE 连接会占用一个协程,如果在处理请求时使用了同步阻塞操作(如同步的数据库查询),会阻塞整个事件循环,影响所有 SSE 连接。所有 I/O 操作必须使用异步库(如 asyncpg 代替 psycopg2,aiohttp 代替 requests)。
3. 设置最大连接数限制
每个 SSE 连接都会占用内存和文件描述符。需要在应用层设置最大连接数限制,防止服务器资源耗尽:
from asyncio import Semaphore

# 全局连接数限制
MAX_CONNECTIONS = 1000
connection_semaphore = Semaphore(MAX_CONNECTIONS)

@app.post("/api/sse/chat")
async def sse_chat(request: Request):
    if connection_semaphore.locked():
        raise HTTPException(503, "服务器繁忙,请稍后重试")

    async with connection_semaphore:
        # 处理 SSE 流
        return StreamingResponse(...)
4. 使用 HTTP/2 减少 TCP 连接数
HTTP/2 支持多路复用,多个 SSE 流可以复用同一个 TCP 连接,减少了服务器端的文件描述符消耗。在 Nginx 中启用 HTTP/2 非常简单:listen 443 ssl http2;。
三、WebSocket 方案:双向通信与中间状态推送
3.1 WebSocket 与 SSE 的本质区别
SSE 是服务器→客户端的单向流,而 WebSocket 是全双工的双向通信。在 Agent 场景中,这意味着用户可以在 Agent 正在输出时,发送新的消息或控制指令——比如"停下来"、“换个方向”、“详细说说第三点”。
3.2 何时选择 WebSocket
| 场景 | SSE 够用吗? | 推荐 WebSocket? |
|---|---|---|
| 单轮对话流式输出 | ✅ 完全够用 | 不必要 |
| 多步骤任务执行 | ✅ 基本够用 | 可选 |
| 流式过程中用户可打断 | ⚠️ 需额外连接 | ✅ 推荐 |
| 多 Agent 实时协作 | ❌ 不够 | ✅ 推荐 |
| Agent 主动推送通知 | ❌ 不够 | ✅ 推荐 |
| 实时多用户协作 | ❌ 不够 | ✅ 推荐 |
| 前端需发送大量中间数据 | ❌ 不够 | ✅ 推荐 |
3.3 后端实现:FastAPI + Python-SocketIO
import socketio
from openai import AsyncOpenAI

# 创建 Socket.IO 服务器
sio = socketio.AsyncServer(
    async_mode="asgi",
    cors_allowed_origins="*",
    ping_interval=20,   # 心跳间隔
    ping_timeout=30,   # 心跳超时
)

# LLM 客户端
llm_client = AsyncOpenAI(api_key="your-api-key", base_url="https://api.deepseek.com/v1")

# 存储每个会话的活跃生成任务
active_tasks: dict[str, asyncio.Task] = {}


@sio.event
async def connect(sid, environ):
    """客户端连接时触发"""
    print(f"客户端 {sid} 已连接")
    await sio.emit("connected", {"sid": sid}, to=sid)


@sio.event
async def disconnect(sid):
    """客户端断开时触发"""
    print(f"客户端 {sid} 已断开")
    # 如果有正在进行的生成任务,取消它
    if sid in active_tasks:
        active_tasks[sid].cancel()
        del active_tasks[sid]


@sio.on("chat")
async def handle_chat(sid, data):
    """
    处理用户消息,开始流式输出
    data: {"message": "用户消息", "session_id": "会话ID"}
    """
    user_message = data.get("message", "")

    # 推送"开始处理"事件
    await sio.emit("agent_event", {
        "type": "step",
        "step_id": "start",
        "status": "started",
        "message": "开始处理你的请求..."
    }, to=sid)

    # 创建异步任务处理 LLM 调用
    task = asyncio.create_task(stream_llm_response(sid, user_message))
    active_tasks[sid] = task


async def stream_llm_response(sid: str, user_message: str):
    """
    流式调用 LLM 并通过 WebSocket 推送结果
    """
    try:
        stream = await llm_client.chat.completions.create(
            model="deepseek-chat",
            messages=[
                {"role": "system", "content": "你是一个专业的AI助手。"},
                {"role": "user", "content": user_message},
            ],
            stream=True,
        )

        async for chunk in stream:
            # 检查任务是否被取消(用户中断)
            if sid not in active_tasks:
                print(f"会话 {sid} 已中断")
                return

            content = chunk.choices[0].delta.content
            if content:
                await sio.emit("agent_event", {
                    "type": "token",
                    "content": content
                }, to=sid)

        # 推送完成事件
        await sio.emit("agent_event", {
            "type": "done",
            "message": "回复完成"
        }, to=sid)

    except asyncio.CancelledError:
        # 用户主动中断
        await sio.emit("agent_event", {
            "type": "interrupted",
            "message": "生成已被中断"
        }, to=sid)
    except Exception as e:
        await sio.emit("agent_event", {
            "type": "error",
            "message": str(e)
        }, to=sid)
    finally:
        if sid in active_tasks:
            del active_tasks[sid]


@sio.on("interrupt")
async def handle_interrupt(sid, data):
    """
    用户主动中断当前生成
    """
    if sid in active_tasks:
        active_tasks[sid].cancel()
        # 注意:cancel() 会触发 CancelledError,由 stream_llm_response 内部处理
代码解析: 这段代码使用 Python-SocketIO 实现了 WebSocket 双向通信。与 SSE 的本质区别在于 active_tasks 字典——它维护了每个会话的活跃生成任务,使得用户可以通过 interrupt 事件随时中断正在进行的 LLM 生成。stream_llm_response 被封装为独立的异步任务,通过 asyncio.Task.cancel() 实现优雅中断。CancelledError 的捕获确保中断后能正确通知前端。ping_interval 和 ping_timeout 的配置防止了长连接被中间代理超时断开。
3.4 前端实现:Socket.IO 客户端
/**
 * WebSocket 流式 Agent 客户端
 * 支持双向通信:接收流式输出 + 发送中断指令
 */
import { io } from "socket.io-client";

class AgentWebSocketClient {
  constructor(url) {
    this.socket = io(url, {
      transports: ["websocket"],
      reconnection: true,
      reconnectionDelay: 1000,
      reconnectionAttempts: 5,
    });

    this.socket.on("connect", () => {
      console.log("已连接到 Agent 服务器");
    });

    this.socket.on("agent_event", (event) => {
      switch (event.type) {
        case "step":
          // 步骤状态更新
          this.onStep?.(event);
          break;
        case "token":
          // LLM token
          this.onToken?.(event.content);
          break;
        case "done":
          this.onDone?.();
          break;
        case "interrupted":
          this.onInterrupted?.();
          break;
        case "error":
          this.onError?.(event.message);
          break;
      }
    });

    this.socket.on("disconnect", () => {
      console.log("与 Agent 服务器断开连接");
    });
  }

  // 发送消息
  send(message) {
    this.socket.emit("chat", { message });
  }

  // 中断当前生成
  interrupt() {
    this.socket.emit("interrupt", {});
  }

  // 事件回调(由使用者设置)
  onToken = null;
  onStep = null;
  onDone = null;
  onInterrupted = null;
  onError = null;
}

// 使用示例
const agent = new AgentWebSocketClient("http://localhost:8000");
let outputText = "";

agent.onToken = (token) => {
  outputText += token;
  renderMarkdown(outputText);
};

agent.onStep = (event) => {
  updateStepIndicator(event.step_id, event.status, event.message);
};

agent.onDone = () => {
  setLoading(false);
};

agent.onInterrupted = () => {
  outputText += "\n\n[生成已被中断]";
  renderMarkdown(outputText);
  setLoading(false);
};

// 发送消息
agent.send("分析一下2024年AI Agent的发展趋势");
代码解析: 前端使用 Socket.IO 客户端库,它提供了比原生 WebSocket 更强大的能力——自动重连、消息确认、房间机制等。transports: ["websocket"] 强制使用 WebSocket 传输,避免降级到轮询。reconnection 配置确保网络抖动时自动恢复连接。回调函数的设计与 SSE 方案保持一致,使得切换底层协议时前端业务逻辑改动最小。最关键的新能力是 interrupt() 方法——用户可以在 Agent 输出过程中随时中断,这通过 WebSocket 的双向通信实现,无需新建连接。
3.5 WebSocket 的房间与命名空间机制
Socket.IO 提供了房间(Room)和命名空间(Namespace)机制,在多用户场景下非常有用。例如,多个用户可能同时与同一个 Agent 交互,或者一个 Agent 需要向多个用户广播状态:
@sio.on("join_room")
async def join_room(sid, data):
    """用户加入指定的 Agent 会话房间"""
    room = data.get("room_id")
    await sio.enter_room(sid, room)
    await sio.emit("room_joined", {"room_id": room}, to=sid)


@sio.on("agent_broadcast")
async def agent_broadcast(sid, data):
    """Agent 向房间内所有用户广播事件"""
    room = data.get("room_id")
    event = data.get("event")
    # 向房间内所有连接推送,包括发送者
    await sio.emit("agent_event", event, to=room)
    # 如果要排除发送者,使用 skip_sid=sid
    # await sio.emit("agent_event", event, room=room, skip_sid=sid)


# 使用命名空间隔离不同类型的 Agent
@sio.on("connect", namespace="/research-agent")
async def research_connect(sid, environ):
    print(f"研究 Agent 客户端 {sid} 已连接")
    await sio.emit("ready", {"agent_type": "research"}, to=sid, namespace="/research-agent")


@sio.on("chat", namespace="/research-agent")
async def research_chat(sid, data):
    """研究 Agent 专用聊天接口"""
    # 专门处理研究类查询
    message = data.get("message")
    # 启动研究 Agent 流式输出
    task = asyncio.create_task(stream_research_agent(sid, message))
    active_generations[f"{sid}:research"] = task
代码解析: 房间机制允许将多个连接分组——同一房间内的消息会广播给所有成员。这在多用户协作场景中非常有用,例如多个分析师同时查看同一 Agent 的研究报告生成过程。命名空间则用于隔离不同类型的 Agent 通信——研究 Agent 和代码 Agent 各有自己的命名空间,消息互不干扰。这种设计使得单个 Socket.IO 服务器可以同时服务多种 Agent,而不需要为每种 Agent 部署独立的服务器。
3.6 WebSocket 鉴权与安全
WebSocket 连接建立后的鉴权与 HTTP 不同——连接升级后无法再修改请求头。常见的 WebSocket 鉴权方案有三种:
| 鉴权方案 | 实现 | 优点 | 缺点 |
|---|---|---|---|
| URL 参数 | ws://host?token=xxx | 简单直接 | Token 暴露在日志中 |
| Cookie | 依赖 HTTP Cookie | 自动携带,安全 | 跨域问题 |
| 初始消息 | 连接后先发 Auth 事件 | 灵活 | 增加一次 RTT |
推荐使用 Cookie + 初始消息的双重验证方案:
@sio.event
async def connect(sid, environ):
    """连接时验证身份"""
    # 1. 检查 Cookie 中的会话 ID
    cookie_header = environ.get("HTTP_COOKIE", "")
    cookies = parse_cookie(cookie_header)
    session_id = cookies.get("session_id")

    if not session_id or not verify_session(session_id):
        # 拒绝连接
        return False  # 返回 False 会拒绝连接

    # 2. 将用户信息关联到会话
    user = get_user_from_session(session_id)
    await sio.save_session(sid, {"user_id": user.id, "name": user.name})

    await sio.emit("auth_success", {"user": user.name}, to=sid)


@sio.on("chat")
async def handle_chat(sid, data):
    # 从会话中获取用户信息
    session = await sio.get_session(sid)
    user_id = session["user_id"]
    print(f"用户 {session['name']} (sid={sid}) 发送消息")
    # ... 处理聊天
代码解析: WebSocket 鉴权的关键时机是 connect 事件——在连接建立之前进行身份验证,返回 False 可以拒绝连接。save_session 将用户信息绑定到 Socket.IO 会话,后续事件处理时可以通过 get_session 获取。这种方案结合了 Cookie 的自动携带特性和服务端会话验证,既安全又无需前端额外处理。
四、流式输出的前端渲染:打字机效果、Markdown 实时渲染
4.1 前端渲染的挑战
流式输出的前端渲染不是简单的"追加文本"这么容易。它面临几个关键挑战:
- Markdown 实时解析——LLM 输出的是 Markdown 格式文本,但流式接收时 Markdown 是不完整的。比如收到
```python\nimport os\n时,代码块还没结束,如何渲染? - 性能——每个 token 都触发一次 DOM 更新会导致频繁重排。当输出达到数千字时,页面会明显卡顿。
- 滚动控制——用户可能在向上滚动查看历史内容,此时自动滚动到底部会打断阅读。
- 光标效果——打字机效果需要一个闪烁的光标指示当前输出位置。
4.2 打字机效果实现
/**
 * 打字机渲染器
 * 高性能流式文本渲染,支持光标效果和智能滚动
 */
class TypewriterRenderer {
  constructor(containerEl, options = {}) {
    this.container = containerEl;
    this.buffer = "";               // 完整文本缓冲
    this.renderedLength = 0;        // 已渲染长度
    this.cursor = options.cursor || "▋";
    this.cursorBlink = options.cursorBlink !== false;
    this.autoScroll = true;
    this.renderQueue = [];
    this.rendering = false;

    // 检测用户滚动
    this.container.addEventListener("scroll", () => {
      const { scrollTop, scrollHeight, clientHeight } = this.container;
      // 用户距离底部超过 50px 时,暂停自动滚动
      this.autoScroll = scrollHeight - scrollTop - clientHeight < 50;
    });

    // 光标闪烁
    if (this.cursorBlink) {
      setInterval(() => this.blinkCursor(), 500);
    }
  }

  /**
   * 追加 token 到缓冲区
   */
  append(token) {
    this.buffer += token;
    this.scheduleRender();
  }

  /**
   * 调度渲染(使用 requestAnimationFrame 合并多个 token)
   */
  scheduleRender() {
    if (this.rendering) return;
    this.rendering = true;
    requestAnimationFrame(() => {
      this.render();
      this.rendering = false;
    });
  }

  /**
   * 渲染当前缓冲区内容
   */
  render() {
    // 使用 markdown 解析库(如 marked.js)渲染
    const html = this.parseMarkdown(this.buffer);
    this.container.innerHTML = html + this.getCursorHTML();

    if (this.autoScroll) {
      this.container.scrollTop = this.container.scrollHeight;
    }
  }

  /**
   * Markdown 解析(处理不完整 Markdown)
   */
  parseMarkdown(text) {
    // 补全不完整的代码块
    const codeBlockCount = (text.match(/```/g) || []).length;
    if (codeBlockCount % 2 !== 0) {
      text = text + "\n```";  // 临时闭合代码块
    }

    // 使用 marked.js 解析
    if (window.marked) {
      return window.marked.parse(text);
    }
    // 降级为纯文本
    return text.replace(/\n/g, "<br>");
  }

  getCursorHTML() {
    return this.cursorVisible
      ? `<span class="typing-cursor">${this.cursor}</span>`
      : "";
  }

  blinkCursor() {
    this.cursorVisible = !this.cursorVisible;
    const cursor = this.container.querySelector(".typing-cursor");
    if (cursor) {
      cursor.style.opacity = this.cursorVisible ? "1" : "0";
    }
  }

  /**
   * 完成渲染(移除光标)
   */
  finish() {
    const html = this.parseMarkdown(this.buffer);
    this.container.innerHTML = html;
  }

  /**
   * 重置
   */
  reset() {
    this.buffer = "";
    this.renderedLength = 0;
    this.container.innerHTML = "";
  }
}
代码解析: 这个 TypewriterRenderer 解决了流式渲染的几个核心问题。第一,scheduleRender 使用 requestAnimationFrame 合并多个 token 的渲染请求——当 token 到达速度快于屏幕刷新率时,多余的渲染会被合并,避免性能浪费。第二,parseMarkdown 处理了不完整 Markdown 的问题——当检测到代码块标记 ````的数量为奇数时,临时补一个闭合标记,让 Markdown 解析器能正确渲染未完成的代码块。第三,scroll` 事件监听器实现了"智能滚动"——当用户向上滚动查看历史内容时,暂停自动滚到底部;当用户滚回底部附近时,恢复自动滚动。
4.3 React 组件实现
import React, { useState, useRef, useCallback, useEffect } from "react";
import { marked } from "marked";

/**
 * React 流式 Markdown 渲染组件
 * 支持打字机效果、代码高亮、智能滚动
 */
function StreamingMessage({ isStreaming }) {
  const [content, setContent] = useState("");
  const [isAtBottom, setIsAtBottom] = useState(true);
  const containerRef = useRef(null);
  const rafRef = useRef(null);

  // 智能滚动检测
  const handleScroll = useCallback(() => {
    const el = containerRef.current;
    if (!el) return;
    const { scrollTop, scrollHeight, clientHeight } = el;
    setIsAtBottom(scrollHeight - scrollTop - clientHeight < 50);
  }, []);

  // 追加 token(暴露给父组件使用)
  const appendToken = useCallback((token) => {
    setContent((prev) => {
      const newContent = prev + token;
      // 使用 rAF 合并 DOM 更新
      if (rafRef.current) cancelAnimationFrame(rafRef.current);
      rafRef.current = requestAnimationFrame(() => {
        if (isAtBottom && containerRef.current) {
          containerRef.current.scrollTop = containerRef.current.scrollHeight;
        }
      });
      return newContent;
    });
  }, [isAtBottom]);

  // 暴露 appendToken 给父组件
  useImperativeHandle(ref, () => ({ appendToken, reset: () => setContent("") }));

  // 渲染 Markdown
  const html = useMemo(() => {
    let text = content;
    // 补全不完整的代码块
    const fenceCount = (text.match(/```/g) || []).length;
    if (fenceCount % 2 !== 0) text += "\n```";
    return marked.parse(text);
  }, [content]);

  return (
    <div
      ref={containerRef}
      onScroll={handleScroll}
      className="streaming-message"
      dangerouslySetInnerHTML={{
        __html: html + (isStreaming ? '<span class="cursor">▋</span>' : "")
      }}
    />
  );
}
代码解析: 这是 React 版本的流式渲染组件。useMemo 对 Markdown 解析做了缓存优化——只有 content 变化时才重新解析。useImperativeHandle 将 appendToken 方法暴露给父组件,使得 SSE/WebSocket 客户端可以直接调用它追加 token。dangerouslySetInnerHTML 看起来危险,但因为内容经过 marked.parse 转义处理,XSS 风险已被消除。光标元素在流式结束后自动移除。配合 CSS 动画 @keyframes blink,光标会闪烁。
4.3 代码高亮的流式处理
LLM 输出经常包含代码块,而流式接收时代码块是不完整的。如何在代码还在生成时就开始语法高亮?这里的关键是使用支持增量更新的代码高亮库,如 highlight.js 或 Prism.js 的实时模式:
/**
 * 流式代码高亮处理器
 * 在代码块生成过程中持续更新高亮
 */
class StreamingCodeHighlighter {
  constructor() {
    this.codeBlockCount = 0;
    this.currentBlock = null;
  }

  /**
   * 处理流式文本
   * 检测代码块边界,在代码块结束时触发高亮
   */
  process(text) {
    // 统计代码块标记数量
    const fenceCount = (text.match(/```/g) || []).length;

    if (fenceCount % 2 === 0) {
      // 所有代码块都完整,可以安全高亮
      return this.highlightAll(text);
    } else {
      // 有未闭合的代码块
      // 临时闭合后高亮,但标记最后一个代码块为"正在输入"
      const tempText = text + "\n```";
      const highlighted = this.highlightAll(tempText);

      // 给最后一个代码块添加"正在输入"样式
      return highlighted.replace(
        /(<pre[^>]*>)([\s\S]*?)(<\/pre>)(?!.*<pre)/,
        '$1$2<span class="typing-cursor">▋</span>$3'
      );
    }
  }

  highlightAll(text) {
    // 使用 marked.js 解析 Markdown
    const html = marked.parse(text);

    // 使用 highlight.js 对 <pre><code> 块进行高亮
    const wrapper = document.createElement("div");
    wrapper.innerHTML = html;
    wrapper.querySelectorAll("pre code").forEach((block) => {
      hljs.highlightElement(block);
    });

    return wrapper.innerHTML;
  }
}
代码解析: 代码高亮的核心挑战是代码块未闭合时的语法解析问题。highlight.js 需要完整的代码才能正确高亮,但流式输出时代码是不完整的。解决方案是检测 ` ````标记的数量——偶数表示所有代码块完整,奇数表示有未闭合的代码块。对于未闭合的情况,临时添加一个闭合标记让 Markdown 解析器能正常工作,然后在渲染后的代码块末尾添加闪烁光标。每次新 token 到达时都会重新高亮整个代码块——虽然有些性能开销,但由于代码块通常不长,现代浏览器可以轻松应对。如果性能确实是问题,可以加入节流逻辑,每 100ms 更新一次代码高亮。
4.4 渲染性能优化实践
当 Agent 的输出达到数千字时(如生成长报告),前端渲染会面临性能瓶颈。以下是经过实践验证的优化策略:
策略一:分层渲染
将已完成的段落和正在生成的段落分离——已完成的段落不再重新渲染,只更新正在生成的最后一个段落:
class LayeredRenderer {
  constructor(container) {
    this.container = container;
    this.completedParagraphs = [];  // 已完成的段落
    this.currentParagraph = "";      // 正在生成的段落
  }

  append(token) {
    this.currentParagraph += token;

    // 检测段落结束(双换行)
    if (this.currentParagraph.includes("\n\n")) {
      const parts = this.currentParagraph.split("\n\n");
      // 已完成的段落移到 completedParagraphs
      this.completedParagraphs.push(parts.shift());
      this.currentParagraph = parts.join("\n\n");
    }

    this.render();
  }

  render() {
    // 只渲染容器,已完成的段落用 innerHTML 设置一次
    const completedHtml = this.completedParagraphs
      .map(p => marked.parse(p))
      .join("");
    const currentHtml = marked.parse(this.currentParagraph);

    this.container.innerHTML =
      completedHtml +
      '<div class="streaming-paragraph">' + currentHtml +
      '<span class="cursor">▋</span></div>';
  }
}
策略二:虚拟滚动
对于超长输出(如万字报告),可以使用虚拟滚动技术——只渲染视口可见的 DOM 元素。这需要使用 react-window 或 vue-virtual-scroller 等库。虽然实现复杂度增加,但可以支持无限长度的流式输出而不卡顿。
策略三:Web Worker 解析
将 Markdown 解析和代码高亮放到 Web Worker 中执行,避免阻塞主线程。主线程只负责接收 token 和更新 DOM。这在处理包含大量代码块的输出时效果尤为明显。
五、中断处理:用户中途打断 Agent 的处理策略
5.1 中断的场景与复杂度
Agent 的中断处理远比"停止生成"复杂。一个完整的 Agent 任务可能涉及多个资源:LLM 流式生成、外部工具调用、数据库写入、文件创建等。中断时需要确保:
- LLM 生成停止——取消正在进行的流式请求
- 部分结果保留——已生成的内容不丢失,用户可以参考
- 资源清理——已打开的文件、数据库连接等正确关闭
- 状态一致性——Agent 的内部状态保持一致,不留下"半成品"状态
- 通知前端——前端收到中断确认,更新 UI
5.2 后端中断处理实现
import asyncio
from dataclasses import dataclass, field
from enum import Enum
from typing import Optional, Any


class AgentState(Enum):
    IDLE = "idle"
    RUNNING = "running"
    GENERATING = "generating"
    TOOL_CALLING = "tool_calling"
    INTERRUPTED = "interrupted"
    COMPLETED = "completed"
    FAILED = "failed"


@dataclass
class AgentSession:
    """Agent 会话上下文,管理状态和资源"""
    session_id: str
    state: AgentState = AgentState.IDLE
    llm_task: Optional[asyncio.Task] = None
    tool_tasks: list[asyncio.Task] = field(default_factory=list)
    partial_output: str = ""
    cleanup_callbacks: list = field(default_factory=list)

    async def interrupt(self):
        """
        中断当前 Agent 执行
        按顺序取消所有任务并清理资源
        """
        if self.state in (AgentState.COMPLETED, AgentState.INTERRUPTED):
            return

        self.state = AgentState.INTERRUPTED
        print(f"[{self.session_id}] 开始中断 Agent...")

        # 1. 取消 LLM 生成任务
        if self.llm_task and not self.llm_task.done():
            self.llm_task.cancel()
            try:
                await asyncio.wait_for(self.llm_task, timeout=2.0)
            except (asyncio.CancelledError, asyncio.TimeoutError):
                pass

        # 2. 取消工具调用任务
        for task in self.tool_tasks:
            if not task.done():
                task.cancel()
                try:
                    await asyncio.wait_for(task, timeout=2.0)
                except (asyncio.CancelledError, asyncio.TimeoutError):
                    pass

        # 3. 执行清理回调(关闭文件、数据库连接等)
        for callback in self.cleanup_callbacks:
            try:
                result = callback()
                if asyncio.iscoroutine(result):
                    await result
            except Exception as e:
                print(f"清理回调出错: {e}")

        # 4. 保留部分输出
        print(f"[{self.session_id}] 中断完成,已保留 {len(self.partial_output)} 字符的部分输出")

        self.state = AgentState.IDLE


class InterruptibleAgent:
    """
    支持中断的 Agent
    """

    def __init__(self):
        self.sessions: dict[str, AgentSession] = {}

    async def run(self, session_id: str, user_message: str, emit_callback):
        """
        运行 Agent,支持被中断
        emit_callback: 用于推送事件的回调函数
        """
        session = AgentSession(session_id=session_id)
        self.sessions[session_id] = session

        try:
            session.state = AgentState.RUNNING
            await emit_callback({"type": "state", "state": "running"})

            # 注册清理函数
            session.cleanup_callbacks.append(
                lambda: print(f"[{session_id}] 清理: 关闭数据库连接")
            )
            session.cleanup_callbacks.append(
                lambda: print(f"[{session_id}] 清理: 删除临时文件")
            )

            # LLM 流式生成
            session.state = AgentState.GENERATING
            await emit_callback({"type": "state", "state": "generating"})

            async for token in self._stream_llm(user_message, session):
                if session.state == AgentState.INTERRUPTED:
                    # 被中断,停止生成
                    await emit_callback({
                        "type": "interrupted",
                        "partial_output": session.partial_output,
                        "message": "Agent 已被中断,以上为部分输出"
                    })
                    return

                session.partial_output += token
                await emit_callback({"type": "token", "content": token})

            session.state = AgentState.COMPLETED
            await emit_callback({"type": "done", "output": session.partial_output})

        except asyncio.CancelledError:
            await session.interrupt()
            raise
        except Exception as e:
            session.state = AgentState.FAILED
            await emit_callback({"type": "error", "message": str(e)})
        finally:
            if session_id in self.sessions:
                del self.sessions[session_id]

    async def _stream_llm(self, message: str, session: AgentSession):
        """模拟 LLM 流式输出(实际应调用 LLM API)"""
        response = "这是一个模拟的流式响应,用于演示中断机制。每个字都是单独生成的。"
        for char in response:
            if session.state == AgentState.INTERRUPTED:
                return
            yield char
            await asyncio.sleep(0.05)  # 模拟生成延迟

    async def interrupt(self, session_id: str):
        """外部调用:中断指定会话"""
        if session_id in self.sessions:
            await self.sessions[session_id].interrupt()
代码解析: 这段代码实现了一个完整的可中断 Agent 框架。AgentSession 是核心数据结构,它跟踪 Agent 的状态(通过状态机管理)、持有所有活跃任务的引用、保存部分输出、维护清理回调列表。interrupt() 方法的清理顺序经过精心设计:先取消 LLM 任务(最耗资源),再取消工具任务,然后执行资源清理回调,最后保留部分输出。每个取消操作都有 2 秒超时保护,防止任务无法被取消时无限等待。cleanup_callbacks 的设计允许各步骤注册自己的清理逻辑(如关闭文件、回滚事务),实现了关注点分离。
5.3 前端中断 UI 设计
/**
 * 带中断功能的 Agent 对话组件
 */
function AgentChat() {
  const [messages, setMessages] = useState([]);
  const [isStreaming, setIsStreaming] = useState(false);
  const [currentMessage, setCurrentMessage] = useState("");
  const clientRef = useRef(null);

  const handleSend = async (text) => {
    setIsStreaming(true);
    setCurrentMessage("");

    // 根据 URL 选择 SSE 或 WebSocket 客户端
    const client = new AgentWebSocketClient("ws://localhost:8000");
    clientRef.current = client;

    client.onToken = (token) => {
      setCurrentMessage((prev) => prev + token);
    };

    client.onDone = () => {
      setMessages((prev) => [...prev, { role: "agent", content: currentMessageRef.current }]);
      setCurrentMessage("");
      setIsStreaming(false);
    };

    client.onInterrupted = () => {
      // 保留部分输出
      setMessages((prev) => [
        ...prev,
        { role: "agent", content: currentMessageRef.current + "\n\n[已中断]" },
      ]);
      setCurrentMessage("");
      setIsStreaming(false);
    };

    client.send(text);
  };

  const handleStop = () => {
    if (clientRef.current) {
      clientRef.current.interrupt();
    }
  };

  return (
    <div className="chat-container">
      {/* 消息列表 */}
      <div className="messages">
        {messages.map((msg, i) => (
          <div key={i} className={`message ${msg.role}`}>
            <ReactMarkdown>{msg.content}</ReactMarkdown>
          </div>
        ))}
        {/* 正在生成的消息 */}
        {isStreaming && currentMessage && (
          <div className="message agent streaming">
            <ReactMarkdown>{currentMessage}</ReactMarkdown>
            <span className="cursor">▋</span>
          </div>
        )}
      </div>

      {/* 输入区域 */}
      <div className="input-area">
        {isStreaming ? (
          <button onClick={handleStop} className="stop-btn">
            ⏹ 停止生成
          </button>
        ) : (
          <ChatInput onSend={handleSend} />
        )}
      </div>
    </div>
  );
}
代码解析: 前端中断 UI 的关键是状态管理。isStreaming 控制输入区域和停止按钮的切换——当 Agent 正在生成时,输入框变成停止按钮,防止用户发送新消息。onInterrupted 回调保留了部分输出并标记 [已中断],让用户知道这不是完整回答。这种设计让用户始终掌控 Agent 的行为,增强了信任感。
5.3 中断后的恢复策略
中断并不意味着放弃。好的 Agent 设计应该支持中断后的恢复——用户可以选择从断点继续生成,而不是从头开始。这需要后端保存中断时的上下文:
@dataclass
class InterruptedSession:
    """中断会话的上下文保存"""
    session_id: str
    original_message: str          # 原始用户消息
    conversation_history: list      # 对话历史
    partial_output: str             # 已生成的部分输出
    interrupt_reason: str           # 中断原因(用户主动、超时等)
    timestamp: float                # 中断时间
    llm_context: dict = None        # LLM 上下文(如缓存的 KV Cache)

    def resume_prompt(self) -> str:
    	"""生成恢复提示词"""
        return (
            f"之前的回复被中断,已生成的部分内容如下:\n\n"
            f"{self.partial_output}\n\n"
            f"请从断点处继续,不要重复已有内容。"
        )


# 存储中断的会话(实际应使用 Redis)
interrupted_sessions: dict[str, InterruptedSession] = {}


async def handle_resume(sid: str, session_id: str):
    """从中断点恢复生成"""
    session = interrupted_sessions.get(session_id)
    if not session:
        await sio.emit("event", {
            "type": "error",
            "message": "中断会话已过期,无法恢复"
        }, to=sid)
        return

    # 使用部分输出作为上下文,继续生成
    messages = session.conversation_history + [
        {"role": "assistant", "content": session.partial_output},
        {"role": "user", "content": session.resume_prompt()}
    ]

    await sio.emit("event", {
        "type": "step",
        "step": "resuming",
        "status": "started",
        "message": f"从断点恢复,已有 {len(session.partial_output)} 字符"
    }, to=sid)

    # 继续流式生成
    task = asyncio.create_task(_stream_to_client(sid, session.resume_prompt(), messages))
    active_generations[sid] = task
代码解析: 中断恢复的关键是保存足够多的上下文信息。InterruptedSession 不仅保存了已生成的部分输出,还保存了完整的对话历史和原始用户消息,使得恢复时可以重建完整的 LLM 上下文。resume_prompt 方法构造了一个特殊的提示,告诉 LLM 从断点继续而不是重新开始。需要注意的是,由于 LLM 的无状态特性,恢复后的生成质量可能不如一次性生成——因为 LLM 需要根据部分输出推断之前的思路。在生产环境中,可以考虑保存 LLM 的 KV Cache(如果模型 API 支持),这样可以实现真正的断点续传。
5.4 不同中断场景的处理策略
Agent 的中断可能由多种原因触发,不同原因需要不同的处理策略:
| 中断原因 | 触发方式 | 处理策略 | 恢复选项 |
|---|---|---|---|
| 用户主动停止 | 点击停止按钮 | 立即取消任务,保留部分输出 | 支持恢复生成 |
| 网络断开 | 连接超时/断开 | 保存上下文到 Redis,等待重连 | 自动恢复 |
| 服务器错误 | 异常/崩溃 | 记录错误日志,清理资源 | 手动重试 |
| 超时 | 生成时间过长 | 软中断,通知用户等待过长 | 可继续等待或停止 |
| 并发限制 | 超过最大连接数 | 排队等待 | 可自动开始 |
六、实战:一个完整的流式 Agent 前后端实现
6.1 项目结构
streaming-agent/
├── backend/
│   ├── main.py              # FastAPI 入口,挂载 SSE + WebSocket
│   ├── sse_handler.py        # SSE 流式处理
│   ├── ws_handler.py        # WebSocket 流式处理
│   ├── agent.py             # Agent 核心逻辑
│   └── interrupt.py         # 中断管理
├── frontend/
│   ├── index.html           # 页面入口
│   ├── app.js              # 前端逻辑
│   └── styles.css          # 样式
├── requirements.txt
└── README.md
6.2 完整后端入口
"""
流式 Agent 完整后端
同时提供 SSE 和 WebSocket 两种接口
"""
import os
import json
import asyncio
from fastapi import FastAPI, Request, HTTPException
from fastapi.responses import StreamingResponse
from fastapi.middleware.cors import CORSMiddleware
from openai import AsyncOpenAI

app = FastAPI(title="Streaming Agent")
app.add_middleware(
    CORSMiddleware,
    allow_origins=["*"],
    allow_methods=["*"],
    allow_headers=["*"],
)

llm_client = AsyncOpenAI(
    api_key=os.getenv("LLM_API_KEY", "sk-xxx"),
    base_url=os.getenv("LLM_BASE_URL", "https://api.deepseek.com/v1")
)

# ====== SSE 接口 ======

@app.post("/api/sse/chat")
async def sse_chat(request: Request):
    """SSE 流式对话接口"""
    body = await request.json()
    message = body.get("message", "")
    conversation = body.get("conversation", [])

    async def event_stream():
        try:
            # 推送步骤:思考中
            yield format_sse({"type": "step", "step": "thinking", "status": "started", "message": "正在理解你的问题..."})
            await asyncio.sleep(0.3)
            yield format_sse({"type": "step", "step": "thinking", "status": "completed"})

            # 推送步骤:生成中
            yield format_sse({"type": "step", "step": "generating", "status": "started", "message": "正在生成回复..."})

            # 调用 LLM
            messages = [
                {"role": "system", "content": "你是专业AI助手,回答要准确、简洁。"}
            ] + conversation + [{"role": "user", "content": message}]

            stream = await llm_client.chat.completions.create(
                model="deepseek-chat",
                messages=messages,
                stream=True,
                max_tokens=2000,
            )

            full_text = ""
            async for chunk in stream:
                if await request.is_disconnected():
                    yield format_sse({"type": "interrupted", "partial": full_text})
                    return

                token = chunk.choices[0].delta.content
                if token:
                    full_text += token
                    yield format_sse({"type": "token", "content": token})

            yield format_sse({"type": "step", "step": "generating", "status": "completed"})
            yield format_sse({"type": "done", "full_text": full_text})

        except Exception as e:
            yield format_sse({"type": "error", "message": str(e)})

    return StreamingResponse(
        event_stream(),
        media_type="text/event-stream",
        headers={"Cache-Control": "no-cache", "X-Accel-Buffering": "no"}
    )


def format_sse(data: dict) -> str:
    return f"data: {json.dumps(data, ensure_ascii=False)}\n\n"


# ====== WebSocket 接口 ======

import socketio

sio = socketio.AsyncServer(async_mode="asgi", cors_allowed_origins="*")
socket_app = socketio.ASGIApp(sio)

active_generations: dict[str, asyncio.Task] = {}


@sio.on("chat")
async def ws_chat(sid, data):
    message = data.get("message", "")
    conversation = data.get("conversation", [])

    await sio.emit("event", {"type": "step", "step": "thinking", "status": "started"}, to=sid)
    await asyncio.sleep(0.3)
    await sio.emit("event", {"type": "step", "step": "thinking", "status": "completed"}, to=sid)
    await sio.emit("event", {"type": "step", "step": "generating", "status": "started"}, to=sid)

    task = asyncio.create_task(_stream_to_client(sid, message, conversation))
    active_generations[sid] = task


async def _stream_to_client(sid: str, message: str, conversation: list):
    try:
        messages = [
            {"role": "system", "content": "你是专业AI助手,回答要准确、简洁。"}
        ] + conversation + [{"role": "user", "content": message}]

        stream = await llm_client.chat.completions.create(
            model="deepseek-chat",
            messages=messages,
            stream=True,
            max_tokens=2000,
        )

        async for chunk in stream:
            if sid not in active_generations:
                await sio.emit("event", {"type": "interrupted"}, to=sid)
                return

            token = chunk.choices[0].delta.content
            if token:
                await sio.emit("event", {"type": "token", "content": token}, to=sid)

        await sio.emit("event", {"type": "done"}, to=sid)

    except asyncio.CancelledError:
        await sio.emit("event", {"type": "interrupted"}, to=sid)
    except Exception as e:
        await sio.emit("event", {"type": "error", "message": str(e)}, to=sid)
    finally:
        active_generations.pop(sid, None)


@sio.on("interrupt")
async def ws_interrupt(sid, data):
    if sid in active_generations:
        active_generations[sid].cancel()


# 挂载 Socket.IO
app.mount("/ws", socket_app)


if __name__ == "__main__":
    import uvicorn
    uvicorn.run(app, host="0.0.0.0", port=8000)
代码解析: 这是一个同时提供 SSE 和 WebSocket 两种接口的完整后端。SSE 接口挂载在 /api/sse/chat,适合简单的对话场景;WebSocket 接口挂载在 /ws 路径下,适合需要中断控制的场景。两个接口共享同一个 LLM 客户端和对话逻辑,只是传输机制不同。format_sse 工具函数确保所有 SSE 数据格式一致。active_generations 字典管理 WebSocket 会话的生成任务,支持用户随时中断。app.mount("/ws", socket_app) 将 Socket.IO 应用挂载为子应用,与 FastAPI 的路由共存。
6.3 完整前端实现
<!DOCTYPE html>
<html lang="zh-CN">
<head>
<meta charset="UTF-8">
<meta name="viewport" content="width=device-width, initial-scale=1.0">
<title>流式 Agent Demo</title>
<style>
* { margin: 0; padding: 0; box-sizing: border-box; }
body { font-family: -apple-system, sans-serif; background: #1a1a2e; color: #eee; }
.container { max-width: 800px; margin: 0 auto; height: 100vh; display: flex; flex-direction: column; }
.header { padding: 16px; border-bottom: 1px solid #333; display: flex; justify-content: space-between; align-items: center; }
.messages { flex: 1; overflow-y: auto; padding: 16px; }
.msg { margin-bottom: 16px; padding: 12px 16px; border-radius: 12px; max-width: 80%; }
.msg.user { background: #16213e; margin-left: auto; }
.msg.agent { background: #0f3460; }
.msg.agent.streaming .cursor { animation: blink 0.8s infinite; }
@keyframes blink { 0%, 50% { opacity: 1; } 51%, 100% { opacity: 0; } }
.input-area { padding: 16px; border-top: 1px solid #333; display: flex; gap: 8px; }
.input-area input { flex: 1; padding: 12px; border: 1px solid #333; border-radius: 8px; background: #16213e; color: #eee; }
.btn { padding: 12px 24px; border: none; border-radius: 8px; cursor: pointer; font-size: 14px; }
.btn-send { background: #e94560; color: white; }
.btn-stop { background: #e74c3c; color: white; }
.status-bar { padding: 4px 16px; font-size: 12px; color: #888; min-height: 20px; }
.step-indicator { display: inline-block; margin-right: 8px; padding: 2px 8px; border-radius: 4px; background: #16213e; font-size: 11px; }
.step-indicator.active { background: #e94560; color: white; }
.step-indicator.done { background: #2ecc71; color: white; }
</style>
</head>
<body>
<div class="container">
<div class="header">
<h1>🤖 流式 Agent</h1>
<select id="protocol">
<option value="sse">SSE 模式</option>
<option value="ws">WebSocket 模式</option>
</select>
</div>
<div class="status-bar" id="status-bar"></div>
<div class="messages" id="messages"></div>
<div class="input-area">
<input type="text" id="input" placeholder="输入消息..." />
<button class="btn btn-send" id="send-btn" onclick="send()">发送</button>
<button class="btn btn-stop" id="stop-btn" onclick="stop()" style="display:none">停止</button>
</div>
</div>
<script>
let isStreaming = false;
let currentController = null;
let wsSocket = null;
const messagesEl = document.getElementById("messages");
const inputEl = document.getElementById("input");
const statusEl = document.getElementById("status-bar");
const protocolEl = document.getElementById("protocol");
const sendBtn = document.getElementById("send-btn");
const stopBtn = document.getElementById("stop-btn");
inputEl.addEventListener("keypress", (e) => {
if (e.key === "Enter" && !isStreaming) send();
});
async function send() {
const message = inputEl.value.trim();
if (!message || isStreaming) return;
inputEl.value = "";
isStreaming = true;
sendBtn.style.display = "none";
stopBtn.style.display = "block";
// 渲染用户消息
appendMessage("user", message);
// 创建 Agent 消息容器
const agentMsg = appendMessage("agent", "");
agentMsg.classList.add("streaming");
const protocol = protocolEl.value;
if (protocol === "sse") {
await sendSSE(message, agentMsg);
} else {
sendWebSocket(message, agentMsg);
}
}
async function sendSSE(message, agentMsg) {
currentController = new AbortController();
let fullText = "";
try {
const response = await fetch("/api/sse/chat", {
method: "POST",
headers: { "Content-Type": "application/json" },
body: JSON.stringify({ message }),
signal: currentController.signal,
});
const reader = response.body.getReader();
const decoder = new TextDecoder();
let buffer = "";
while (true) {
const { done, value } = await reader.read();
if (done) break;
buffer += decoder.decode(value, { stream: true });
const lines = buffer.split("\n\n");
buffer = lines.pop();
for (const line of lines) {
if (!line.startsWith("data: ")) continue;
const data = line.slice(6).trim();
if (data === "[DONE]") continue;
const event = JSON.parse(data);
handleEvent(event, agentMsg, (t) => {
fullText += t;
agentMsg.innerHTML = renderMarkdown(fullText) + '<span class="cursor">▋</span>';
scrollToBottom();
});
}
}
agentMsg.classList.remove("streaming");
agentMsg.innerHTML = renderMarkdown(fullText);
} catch (err) {
if (err.name === "AbortError") {
agentMsg.innerHTML = renderMarkdown(fullText) + '<p style="color:#888">[已中断]</p>';
} else {
agentMsg.innerHTML = `<p style="color:#e74c3c">错误: ${err.message}</p>`;
}
} finally {
resetState();
}
}
function sendWebSocket(message, agentMsg) {
let fullText = "";
wsSocket = io("ws://localhost:8000/ws", { transports: ["websocket"] });
wsSocket.on("event", (event) => {
handleEvent(event, agentMsg, (t) => {
fullText += t;
agentMsg.innerHTML = renderMarkdown(fullText) + '<span class="cursor">▋</span>';
scrollToBottom();
});
if (event.type === "done" || event.type === "interrupted" || event.type === "error") {
agentMsg.classList.remove("streaming");
if (event.type === "interrupted") {
agentMsg.innerHTML = renderMarkdown(fullText) + '<p style="color:#888">[已中断]</p>';
}
wsSocket.disconnect();
resetState();
}
});
wsSocket.emit("chat", { message });
}
function handleEvent(event, agentMsg, onToken) {
switch (event.type) {
case "step":
updateStatus(event);
break;
case "token":
onToken(event.content);
break;
case "done":
updateStatus({ type: "step", step: "completed", status: "done", message: "完成" });
break;
case "interrupted":
updateStatus({ message: "已中断" });
break;
case "error":
updateStatus({ message: "错误: " + event.message });
break;
}
}
function updateStatus(event) {
if (event.message) {
statusEl.textContent = event.message;
}
}
function stop() {
if (protocolEl.value === "sse") {
currentController?.abort();
} else if (wsSocket) {
wsSocket.emit("interrupt", {});
}
}
function appendMessage(role, content) {
const div = document.createElement("div");
div.className = `msg ${role}`;
div.innerHTML = role === "user" ? escapeHtml(content) : renderMarkdown(content);
messagesEl.appendChild(div);
scrollToBottom();
return div;
}
function renderMarkdown(text) {
// 简易 Markdown 渲染(生产环境请使用 marked.js)
return text
.replace(/&/g, "&")
.replace(/</g, "<")
.replace(/>/g, ">")
.replace(/```(\w*)\n([\s\S]*?)```/g, '<pre><code>$2</code></pre>')
.replace(/`([^`]+)`/g, '<code>$1</code>')
.replace(/\*\*(.+?)\*\*/g, '<strong>$1</strong>')
.replace(/\n/g, '<br>');
}
function escapeHtml(text) {
const div = document.createElement("div");
div.textContent = text;
return div.innerHTML;
}
function scrollToBottom() {
messagesEl.scrollTop = messagesEl.scrollHeight;
}
function resetState() {
isStreaming = false;
sendBtn.style.display = "block";
stopBtn.style.display = "none";
statusEl.textContent = "";
}
</script>
</body>
</html>
代码解析: 这是一个完整的单页面前端实现,同时支持 SSE 和 WebSocket 两种模式,用户可以通过下拉框切换。页面包含消息列表、状态栏、输入区域和停止按钮。SSE 模式使用 fetch + ReadableStream 接收流式数据,通过 AbortController 实现中断;WebSocket 模式使用 Socket.IO 客户端,通过 emit("interrupt") 事件实现中断。renderMarkdown 函数提供了简易的 Markdown 渲染能力(生产环境建议使用 marked.js),支持代码块、行内代码、粗体和换行。光标闪烁效果通过 CSS @keyframes blink 动画实现。状态栏实时显示 Agent 当前步骤(思考中→生成中→完成),让用户始终了解 Agent 的工作状态。整个页面无任何框架依赖,原生 HTML + JS + CSS 即可运行。
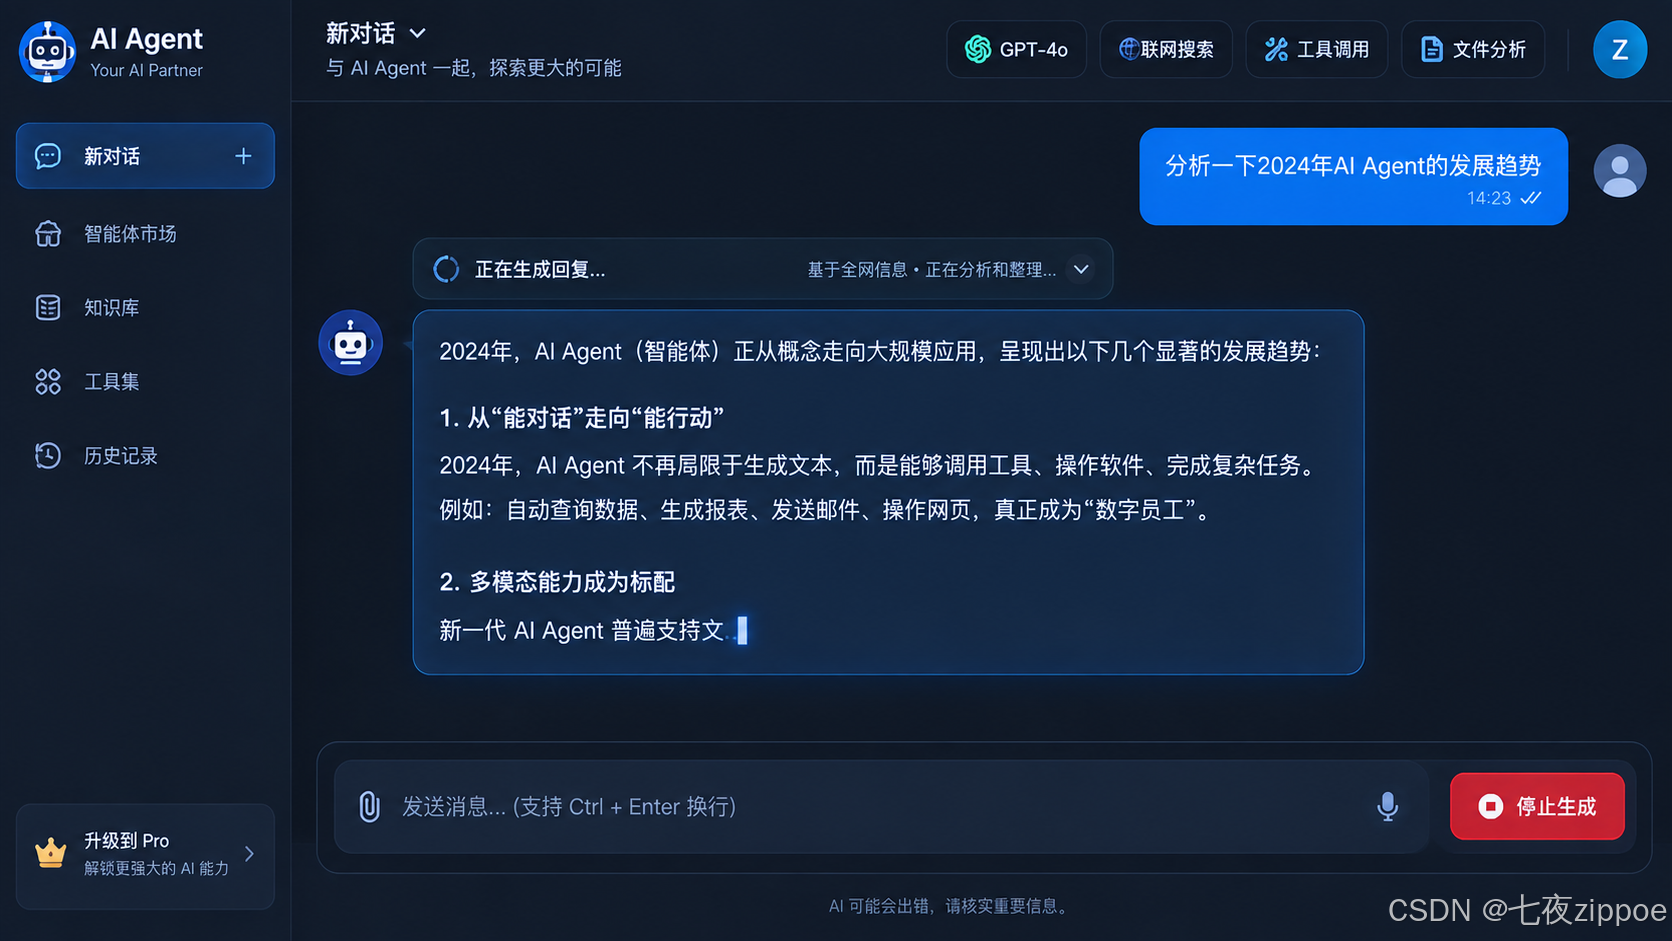
6.4 完整的前端渲染效果
当用户发送消息后,界面会经历以下状态变化:
- 发送瞬间:用户消息显示在右侧(蓝色背景),下方出现一个空的 Agent 消息气泡(深蓝色背景),带闪烁光标
- 思考阶段:状态栏显示"正在理解你的问题…",Agent 气泡为空
- 生成阶段:状态栏显示"正在生成回复…",文字逐字出现在 Agent 气泡中
- 完成阶段:光标消失,状态栏显示"完成",输入框恢复可用
- 中断场景:用户点击"停止"按钮,生成立即停止,已生成的文字保留,下方标注"[已中断]"
七、适用边界与风险提示
7.1 SSE 的适用边界
SSE 方案虽然简洁,但有其局限性:
- 单向通信:只支持服务器→客户端,用户中断需要额外的 HTTP 请求或 WebSocket 连接
- 连接数限制:浏览器对同一域名的 SSE 连接数有限制(HTTP/1.1 下通常 6 个),HTTP/2 下有所改善
- POST 请求不支持:原生
EventSourceAPI 只支持 GET,需要用fetch替代 - 代理兼容性:某些反向代理(如旧版 Nginx)可能缓冲 SSE 流,需要配置
X-Accel-Buffering: no - 移动端不稳定:iOS Safari 对 SSE 的后台连接有较严格的超时限制
SSE 适合的场景:
- 单轮对话流式输出
- 简单的步骤状态推送
- 不需要用户在流式过程中发送消息的场景
- 快速原型开发
7.2 WebSocket 的适用边界
WebSocket 功能强大,但复杂度也更高:
- 协议升级开销:连接建立时需要 HTTP→WS 协议升级,略增加首次连接延迟
- 运维复杂度高:长连接管理、心跳机制、连接状态同步都需要额外处理
- 负载均衡挑战:WebSocket 是有状态连接,负载均衡需要使用 IP Hash 或 Sticky Session
- 移动端兼容性:部分移动网络(如某些 4G 代理)可能不支持 WebSocket 升级
- 安全考量:需要额外实现鉴权、消息校验,防止未授权访问和注入攻击
WebSocket 适合的场景:
- 需要双向实时通信的复杂 Agent
- 多用户协作场景
- Agent 需要主动推送通知
- 对中断实时性要求高的场景
7.3 风险提示与生产环境建议
| 风险点 | 影响 | 建议 |
|---|---|---|
| 连接泄漏 | 服务器资源耗尽 | 设置连接超时 + 心跳检测 + 最大连接数限制 |
| 消息洪泛 | 前端渲染卡顿 | 使用 requestAnimationFrame 合并渲染 + 限流 |
| XSS 注入 | 安全漏洞 | 对 LLM 输出做 HTML 转义 + CSP 策略 |
| 中断后资源未清理 | 内存/连接泄漏 | 使用 try/finally 确保资源释放 + 超时兜底 |
| 网络抖动导致断连 | 用户体验中断 | 实现自动重连 + 断点续传 |
| 并发连接过多 | 服务器压力大 | 实现连接池 + 排队机制 |
| LLM 输出不当内容 | 合规风险 | 添加输出过滤层 + 敏感词检测 |
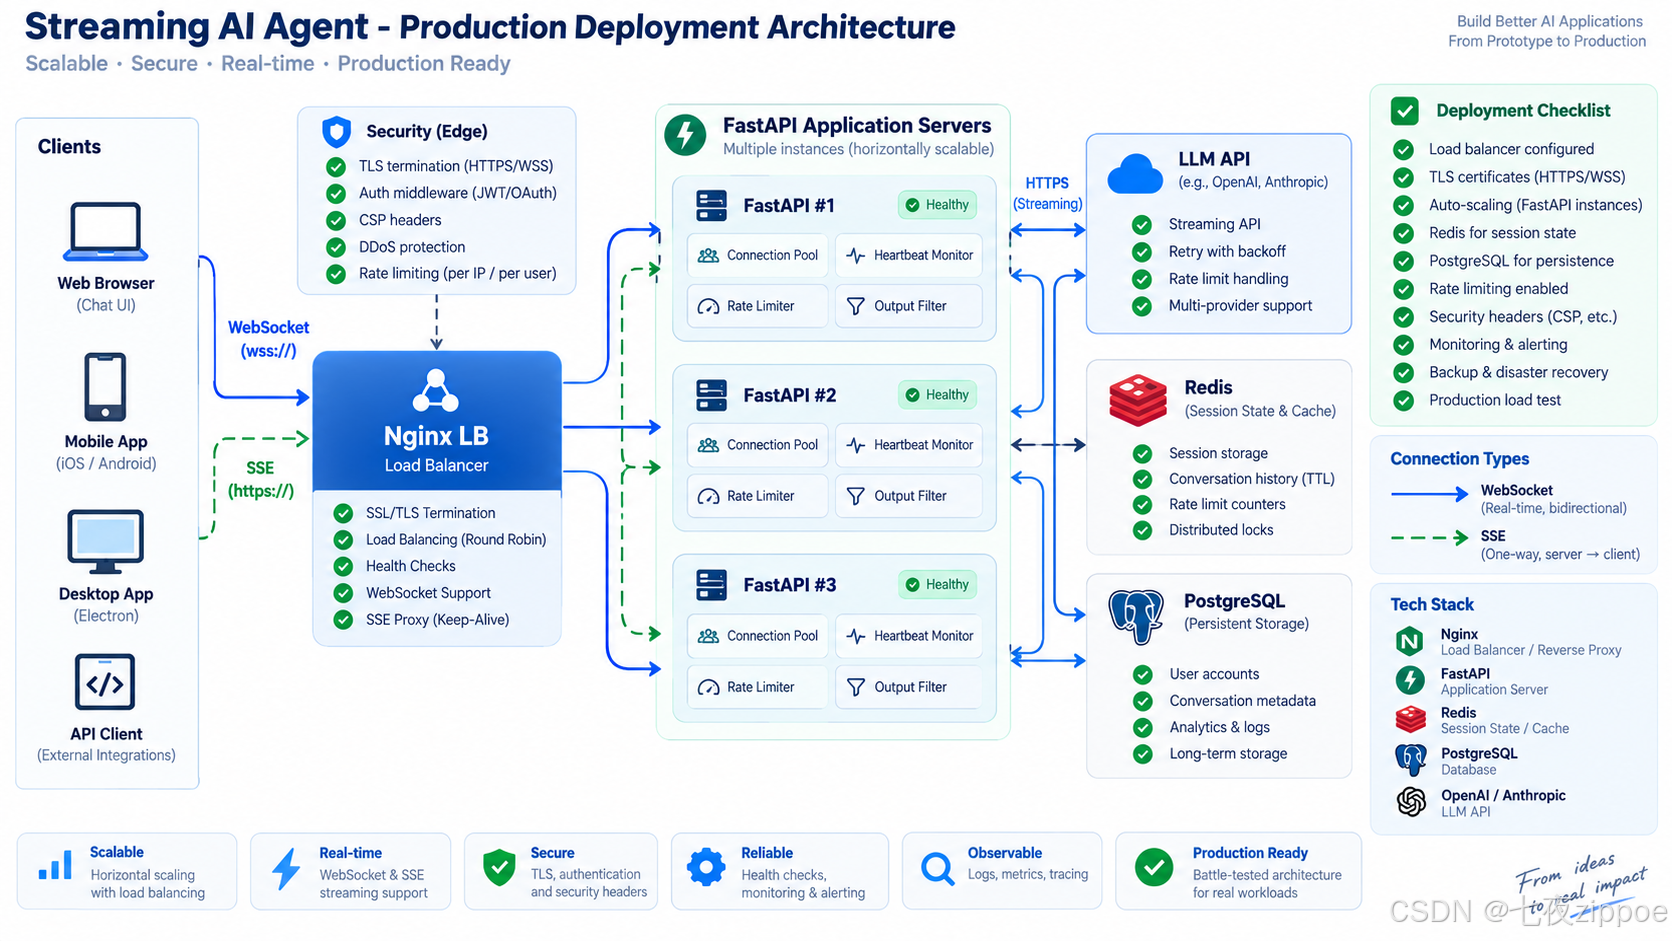
7.4 生产环境检查清单
上线前,请逐项检查以下内容:
- SSE/Ws 连接设置了合理的超时时间(建议 5-10 分钟)
- 实现了心跳检测,能及时发现断连
- 前端实现了自动重连机制(指数退避重试)
- 服务器设置了最大连接数限制
- LLM 输出经过 HTML 转义,防止 XSS
- 中断后所有资源(Task、连接、文件)被正确清理
- 负载均衡配置支持长连接(IP Hash 或 Sticky Session)
- Nginx 配置关闭了 SSE 响应缓冲
- 监控告警覆盖了连接数、延迟、错误率等指标
- 压力测试验证了高并发下的稳定性
八、总结
流式输出是 AI Agent 从"能用"到"好用"的关键一跃。它不仅仅是技术实现的问题,更是用户体验设计的核心环节。
回顾本文的核心内容:
第一,SSE 和 WebSocket 是两种主流的流式输出方案。 SSE 基于 HTTP,实现简单,适合服务器→客户端的单向流式场景;WebSocket 是全双工协议,适合需要双向实时通信的复杂场景。选择哪个方案,取决于你的 Agent 是否需要支持流式过程中的用户交互。对于大多数对话式 Agent,SSE 已经足够;对于需要中断、多 Agent 协作、实时通知的场景,WebSocket 更合适。
第二,前端渲染是体验的关键。 流式 Markdown 渲染需要处理不完整语法的边界情况——代码块未闭合、列表未结束、表格未完成等。使用 requestAnimationFrame 合并渲染请求是性能优化的关键手段。智能滚动检测确保用户向上查看历史时不会被自动滚动打断。
第三,中断处理是生产级的必需品。 一个完整的 Agent 中断流程包括:取消 LLM 生成任务、取消工具调用任务、执行资源清理回调、保留部分输出、通知前端。每个环节都需要超时保护,防止异常情况下的资源泄漏。AgentSession 数据结构提供了清晰的状态管理和资源追踪机制。
第四,技术方案的选择要回归业务需求。 不要为了用 WebSocket 而用 WebSocket。如果你的 Agent 只需要简单的对话流式输出,SSE 的实现成本更低、维护更简单。如果你的 Agent 需要复杂的交互(中断、追加指令、多步骤协作),WebSocket 的双向通信能力会带来更好的用户体验。
第五,生产环境需要系统性的保障措施。 连接管理(超时、心跳、重连)、安全防护(XSS 转义、鉴权、CSP)、性能优化(渲染合并、限流)、监控告警(连接数、延迟、错误率),这些缺一不可。本文提供的检查清单可以作为上线前的最后防线。
流式输出的本质是让 Agent 的"思考过程"变得可见,让用户从被动的等待者变成主动的参与者。当用户能实时看到 Agent 在做什么、能随时叫停、能即时调整方向,Agent 就从一个黑盒工具变成了一个透明的协作者。这种透明度,是用户信任 Agent 的基础。
参考资料
- MDN Web Docs - Server-Sent Events (SSE) — SSE 标准文档
- MDN Web Docs - WebSocket API — WebSocket 标准 API
- FastAPI StreamingResponse 官方文档 — FastAPI 流式响应
- Socket.IO 官方文档 — Socket.IO 完整指南
- OpenAI API - Streaming Responses — OpenAI 流式 API
- HTML Living Standard - Section 9.2 Server-sent events — SSE 规范
- RFC 6455 - The WebSocket Protocol — WebSocket 协议规范
- marked.js - Markdown Parser — 前端 Markdown 解析库
- Python-SocketIO 文档 — Python Socket.IO 实现
- nginx SSE 配置指南 — Nginx 代理缓冲配置
转载自 CSDN-专业IT技术社区
原文链接:https://blog.csdn.net/sinat_41617212/article/details/166903865

