

为什么普通数据库还不够
Embedding 会把每个知识片段变成高维向量。数据量很小时,可以把所有向量装进内存,逐个计算相似度;当数据增长到几十万、几百万甚至更多条时,全量比较的延迟和资源消耗就难以接受。
向量数据库专门解决高维向量的存储、索引和近邻检索问题。它不仅保存向量,还管理原文、来源、权限、版本等字段,并提供新增、更新、删除和持久化能力。
一条完整记录通常长这样:
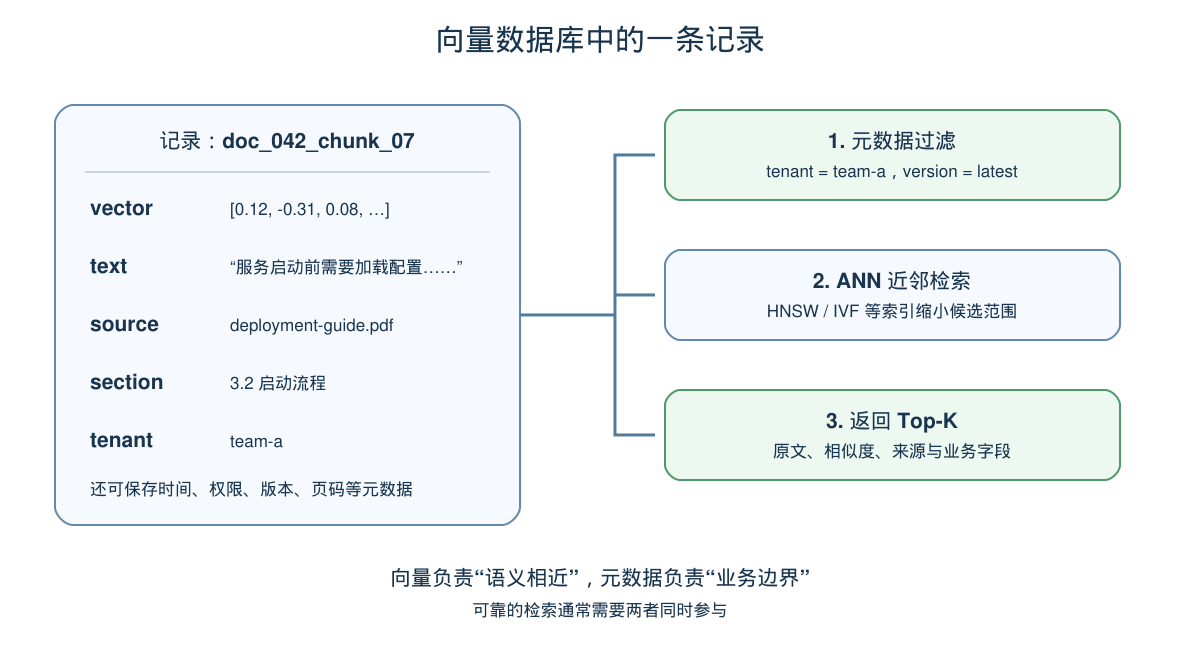
{
  "id": "doc_042_chunk_07",
  "vector": [0.12, -0.31, 0.08],
  "text": "服务启动前需要加载配置文件……",
  "metadata": {
    "source": "deployment-guide.pdf",
    "section": "3.2 启动流程",
    "tenant": "team-a",
    "version": "latest"
  }
}
向量负责表达语义,text 用来交给大模型,元数据则定义业务边界。缺少其中任何一部分,RAG 都很难稳定工作。
KNN 与 ANN
精确近邻 KNN
KNN 会把查询向量与库中每一个向量比较,然后返回距离最近的 K 条。它能得到精确结果,但计算量随数据规模线性增长。
scores = [cosine(query, item.vector) for item in all_items]
top_k = sorted(zip(scores, all_items), reverse=True)[:5]
这个实现适合小数据集、离线评估,或者用来判断近似索引损失了多少召回。
近似近邻 ANN
ANN(Approximate Nearest Neighbor)用索引快速缩小候选范围,以少量召回损失换取显著的速度提升。生产向量检索大多采用这种方式。
“近似”不意味着随便返回结果。索引会暴露参数,让系统在召回率、延迟和内存之间调节。调参时应该与精确 KNN 结果对照,而不是只看接口是否足够快。
两类常见索引
HNSW:在多层图上寻找近邻
HNSW 会把向量组织成多层邻接图。查询先在稀疏高层快速接近目标区域,再下沉到密集底层细致搜索。它通常有较好的低延迟和召回率,但图结构会占用较多内存,构建索引也需要时间。
常见参数包括:
M:每个节点保持的连接数量,越大通常召回更好,也更占内存。efConstruction:建索引时搜索候选的范围,越大构建越慢,图质量通常越高。ef或efSearch:查询时考察的候选范围,越大通常越准、也越慢。
这些参数的具体名称和范围以数据库实现为准。HNSW 的图结构与查询参数可参考 Milvus 官方文档。
IVF:先聚类,再搜索部分分区
IVF 会先把向量聚成若干簇。查询时找到最接近的几个簇,只在这些分区内比较候选。
全部向量
  ├── 簇 1
  ├── 簇 2  ← 查询只探测这里
  ├── 簇 3  ← 以及这里
  └── 簇 4
分区数量和查询时探测的簇数会影响速度与召回。探测太少可能漏掉边界附近的正确结果,探测太多又会接近全量搜索。
一套基本 CRUD 流程
不同产品的 SDK 写法各异,但核心操作相近。建表时要先固定向量维度与距离类型:
collection = db.create_collection(
    name="jys_docs",
    dimension=1024,
    metric="cosine",
)
插入数据时,主键应稳定可重建。不要使用每次导入都会变化的随机 ID,否则文档更新后很难准确覆盖旧片段。
collection.upsert([
    {
        "id": "manual-v3#section-3#chunk-2",
        "vector": vector,
        "text": chunk_text,
        "source": "manual-v3.pdf",
        "tenant": "team-a",
    }
])
查询时先做权限和版本过滤,再做向量搜索:
hits = collection.search(
    vector=query_vector,
    top_k=10,
    filter={
        "tenant": "team-a",
        "status": "published",
    },
    output_fields=["text", "source", "section"],
)
删除文档时不能只删原文件,还要删除它对应的全部 Chunk:
collection.delete(filter={"source_id": "manual-v2"})
这也是为什么要设计稳定的 source_id、版本和更新时间字段。
元数据过滤为什么重要
只按向量距离检索,很可能召回语义相关但业务上不可用的内容。例如用户问休假制度,系统找到了五年前的旧版本;两个租户使用同一套平台,结果却互相看见了内部文档。
过滤条件应尽量在向量检索期间生效,而不是先取回结果再由应用删除。后过滤会让 Top-K 名额被无权限或过期数据占满,最终可用结果不足。
语义条件:与“休假额度”相近
业务条件:tenant = 当前组织
版本条件:effective_at <= 今天,expired_at > 今天
权限条件:用户所在组可读
真正可靠的知识检索,是语义条件与业务条件共同作用。
常见产品怎样分类
Milvus、Qdrant、Weaviate、Pinecone 和 Chroma 等产品以向量检索为核心;Elasticsearch、Redis、MongoDB Atlas 等在原有数据能力上加入了向量搜索;PostgreSQL 可以通过 pgvector 扩展保存和检索向量。
不存在对所有项目都最好的产品。可以从这些问题出发:
- 数据规模和并发量多大,是否真的需要分布式集群?
- 是否依赖复杂元数据过滤、全文检索或混合检索?
- 团队已经擅长运维哪类数据库?
- 数据能否使用云服务,还是必须本地部署?
- 如何备份、迁移、隔离租户和滚动重建索引?
- 总成本来自存储、查询、网络还是运维人力?
对中小型项目,复用现有 PostgreSQL 或搜索引擎可能更简单;对超大规模、低延迟的专用检索,再考虑独立向量数据库。技术选型首先是系统边界问题,而不是功能列表比赛。
距离分数不能直接设成通用阈值
不同模型、距离函数和数据库返回的分数含义可能不同。有的值越大越相似,有的距离越小越近;同样的 0.8 在两个模型上也不可直接比较。
更稳妥的方式是用标注数据绘制“阈值—准确率—召回率”曲线,再根据业务容错选择阈值。同时保留 Top-K 和重排,不要让一个未经验证的固定分数独自决定是否回答。
小结
向量数据库把高维向量变成可持续运营的检索系统:它用 ANN 索引提高搜索速度,用元数据过滤守住版本、权限和租户边界,并通过 CRUD 管理知识变化。
开始选型前,先定义数据规模、检索方式和运维约束;完成选型后,则要用精确 KNN 与真实问题集检验近似索引。快,只是要求之一;能够稳定找到正确且有权使用的证据,才是最终目标。
转载自 CSDN-专业IT技术社区
原文链接:https://blog.csdn.net/dev_jin/article/details/167082471

