

在初学MySQL时,大家第一个学习的SQL一定是select语句,例如下面的语句:
select * from table where id=1;
但是期间你想是否想过,MySQL 执行一条 select 查询语句,在 MySQL 中期间发生了什么?
下面我们带着这个问题,了解MySQL的世界。
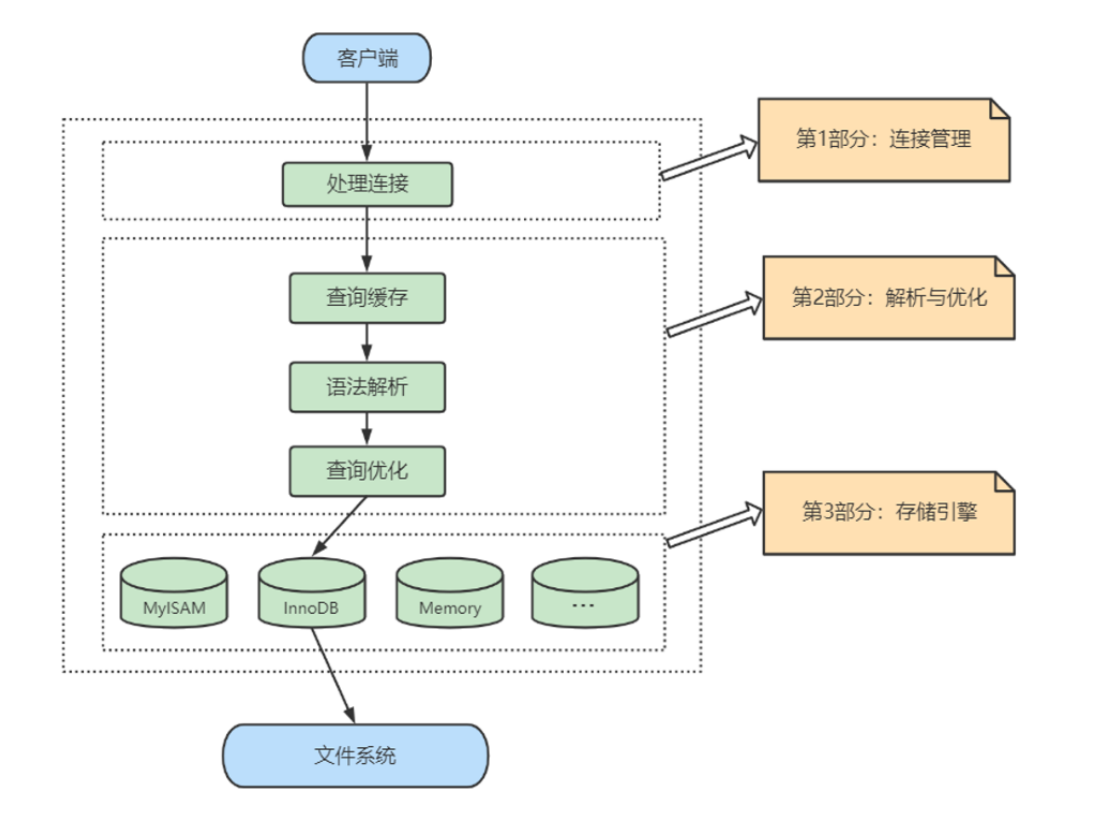
我们可以看上面的图片数据库主要分为三个部分:
- 连接管理
- 解析优化
- 存储引擎
接下来我们就先MySQL架构的各个组件做详细的了解。
第1层:连接层
系统(客户端)访问 MySQL 服务器前,做的第一件事就是建立 TCP连接。经过三次握手建立连接成功后, MySQL 服务器对 TCP 连接。 TCP 传输过来的账号密码做身份认证、权限获取。
# -h 指定 MySQL 服务得 IP 地址,如果是连接本地的 MySQL服务,可以不用这个参数;
# -u 指定用户名,管理员角色名为 root;
# -p 指定密码,如果命令行中不填写密码(为了密码安全,建议不要在命令行写密码),就需要在交互对话里面输入密码
mysql -h$ip -u$user -p
- 用户名或密码不对,会收到一个Access denied for user错误,客户端程序结束执行。
- 用户名密码认证通过,会从权限表查出账号拥有的权限与连接关联,之后的权限判断逻辑,都将依赖于此时读到的权限。
TCP 连接收到请求后,必须要分配给一个线程专门与这个客户端的交互。还会有个线程池,去走后面的流程。每一个连接从线程池中获取线程进行数据库操作,省去了创建和销毁线程的开销。
第2层:服务层
对SQL语句进行查询处理,与数据库文件的存储方式无关。
在服务层,服务器会解析查询并创建相应的内部解析树,并对其完成相应的优化:如确定查询表的顺序,是否利用索引等,最后生成相应的执行操作。
如果是select语句,服务器还会查询内部的缓存。如果缓存空间足够大,这样在解决大量读操作的环境中能够很好的提升系统的性能。
- SQL接口 SQL Interface:接收用户的SQL命令,并且返回用户续约查询的结果
- SQL的分析和优化 Parser 解析器: 在解析器中对SQL语句进行语法分析、语义分析。将SQL语句分解成数据结构并将这个结构传递到后续步骤。以后SQL语句的传递和处理就是基于这个结构的。 生成对应的语法树
(1) SQL Interface: SQL接口
- 接收用户的SQL命令,并且返回用户需要查询的结果。比如SELECT ...FROM就是调用SQL Interface
- MySQL支持DML(数据操作语言)、DDL(数据定义语言)、存储过程、视图、触发器、自定义函数等多种SQL语言接口
(2) Parser: 解析器
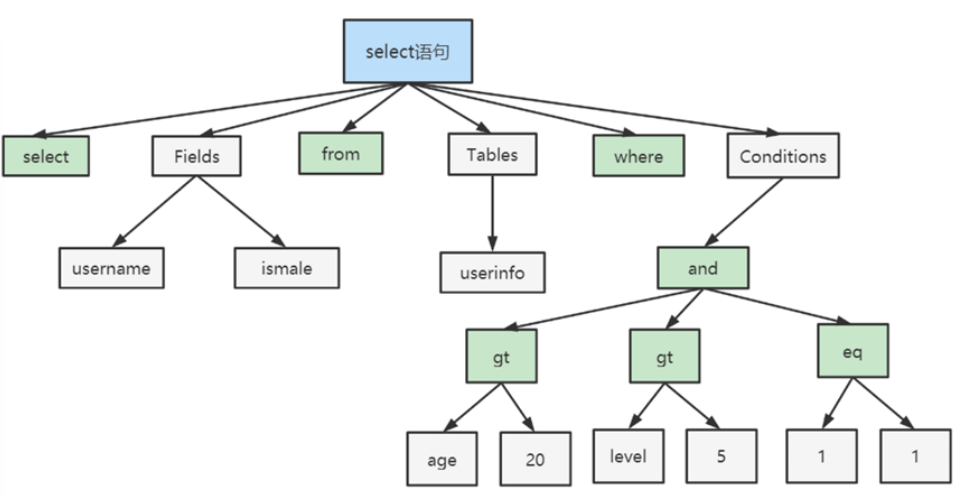
- 在解析器中对 SQL 语句进行语法分析、语义分析。将SQL语句分解成数据结构,并将这个结构传递到后续步骤,以后SQL语句的传递和处理就是基于这个结构的。如果在分解构成中遇到错误,那么就说明这个SQL语句是不合理的。
- 在SQL命令传递到解析器的时候会被解析器验证和解析,并为其创建语法树,并根据数据字典验证该客户端是否具有执行该查询的权限。创建好语法树后,MySQL还 会对SQl查询进行语法上的优化,进行查询重写。
(3) Optimizer: 查询优化器
- SQL语句在语法解析之后、查询之前会使用查询优化器确定 SQL 语句的执行路径,生成一个执行计划。
- 这个执行计划表明应该使用哪些索引进行查询(全表检索还是使用索引检索),表之间的连接顺序如何,最后会按照执行计划中的步骤调用存储引擎提供的方法来真正的执行查询,并将查询结果返回给用户。
- 它使用“ 选取-投影-连接 ”策略进行查询。例如:SELECT id,name FROM student WHERE gender = '女'; 这个SELECT查询先根据WHERE语句进行选取,而不是将表全部查询出来以后再进行gender过滤。 这个SELECT查询先根据id和 name进行属性过滤,将这两个查询条件投影,而不是将属性全部取出以后再进行过 连接起来生成最终查询结果。
(4) Caches & Buffers: 查询缓存组件
- MySQL内部维持着一些Cache和Buffer,比如Query Cache用来缓存一条SELECT语句的执行结 果,如果能够在其中找到对应的查询结果,那么就不必再进行查询解析、优化和执行的整个过 程了,直接将结果反馈给客户端。
- 这个缓存机制是由一系列小缓存组成的。比如表缓存,记录缓存,key缓存,权限缓存等 。
- 这个查询缓存可以在 不同客户端之间共享。
- 从MySQL 5.7.20开始,不推荐使用查询缓存,并在 MySQL 8.0中删除 。
第3层:引擎层
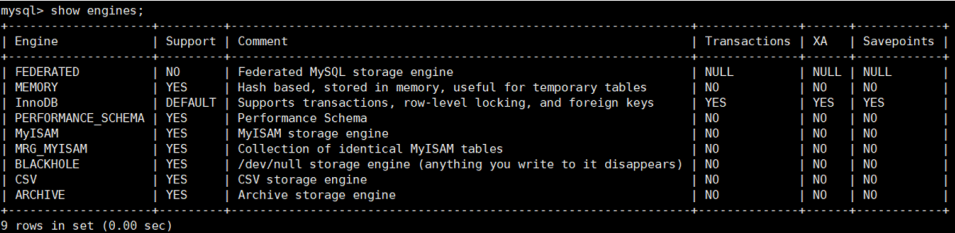
插件式存储引擎层( Storage Engines),真正的负责了MySQL中数据的存储和提取,对物理服务器级别 维护的底层数据执行操作,服务器通过API与存储引擎进行通信。不同的存储引擎具有的功能不同,这样我们可以根据自己的实际需要进行选取。
MySQL 8.0.25默认支持的存储引擎如下:
存储层
所有的数据,数据库、表的定义,表的每一行的内容,索引,都是存在 文件系统上,以 文件的方式存在的,并完成与存储引擎的交互。当然有些存储引擎比如InnoDB,也支持不使用文件系统直接管理裸设 备,但现代文件系统的实现使得这样做没有必要了。在文件系统之下,可以使用本地磁盘,可以使用 DAS、NAS、SAN等各种存储系统。
总结:
MySQL架构图本节开篇所示。下面为了熟悉SQL执行流程方便,我们可以简化如
下:
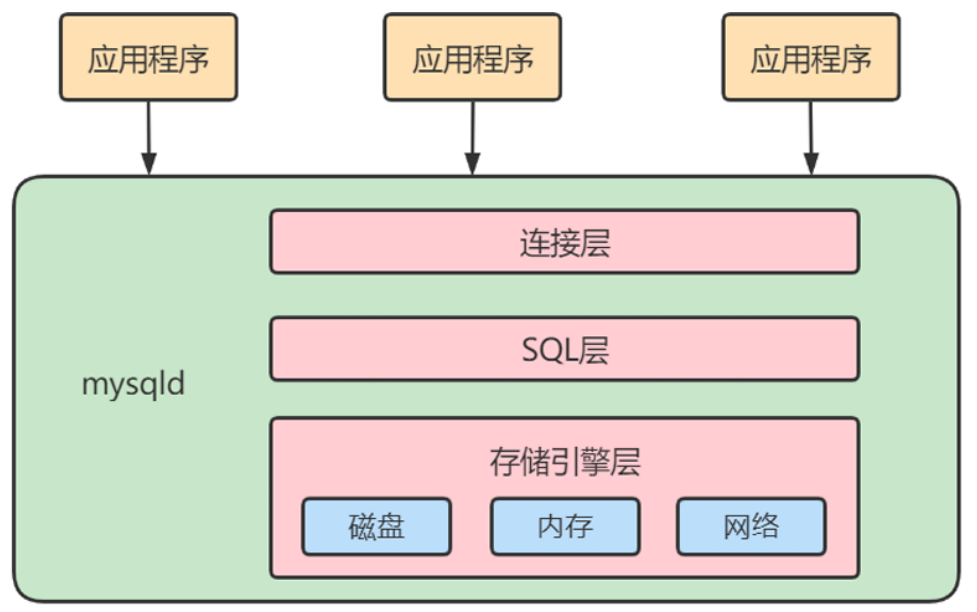
简化为三层结构:
- 连接层:客户端和服务器端建立连接,客户端发送 SQL 至服务器端;
- SQL 层(服务层):对 SQL 语句进行查询处理;与数据库文件的存储方式无关;
- 存储引擎层:与数据库文件打交道,负责数据的存储和读取。
了解完MySQL的架构我们再来看看SQL语句的执行流程
MySQL 中的 SQL执行流程
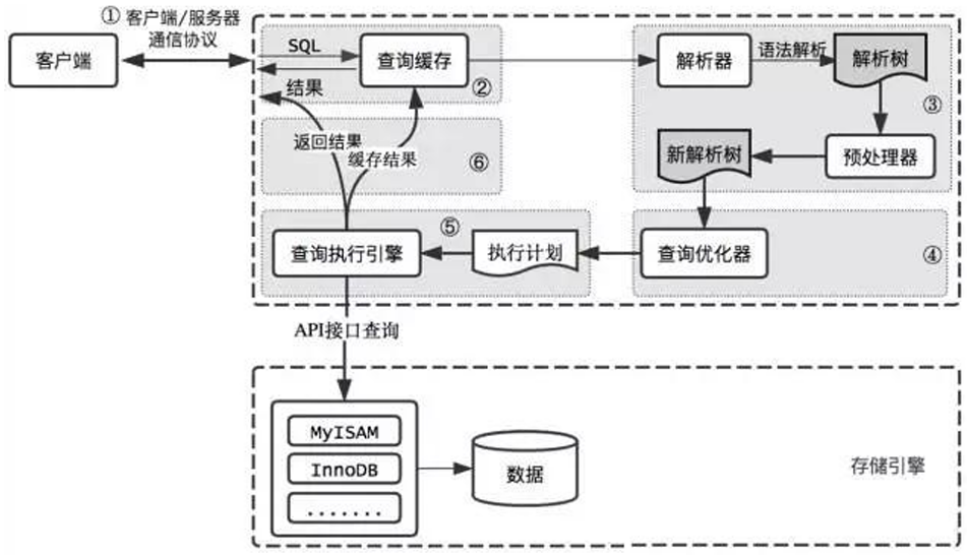
MySQL的查询流程:
(1).查询缓存:Server 如果在查询缓存中发现了这条 SQL 语句,就会直接将结果返回给客户端;如果没有,就进入到解析器阶段。需要说明的是,因为查询缓存往往效率不高,所以在 MySQL8.0 之后就抛弃了这个功能。
大多数情况查询缓存就是个鸡肋,为什么呢?
SELECT employee_id,last_name FROM employees WHERE employee_id =
101;
SELECT employee_id,last_name FROM employees WHERE employee_id =
102;
- 查询缓存是提前把查询结果缓存起来,这样下次不需要执行就可以直接拿到结果。需要说明的是,在 MySQL 中的查询缓存,不是缓存查询计划,而是查询对应的结果。这就意味着查询匹配的准确性大大降。相同的查询操作才会命中查询缓存。两个查询请求在任何字符上的不同(例如:空格、注释、大小写),都会导致缓存不会命中。因此 MySQL 的 查询缓存命中率不高。
- 同时,如果查询请求中包含某些系统函数、用户自定义变量和函数、一些系统表,如 mysql 、 information_schema、 performance_schema 数据库中的表,那这个请求就不会被缓存。以某些系统函数 举例,可能同样的函数的两次调用会产生不一样的结果,比如函数 NOW ,每次调用都会产生最新的当前 时间,如果在一个查询请求中调用了这个函数,那即使查询请求的文本信息都一样,那不同时间的两次 查询也应该得到不同的结果,如果在第一次查询时就缓存了,那第二次查询的时候直接使用第一次查询 的结果就是错误的!
- 此外,既然是缓存,那就有它缓存失效的时候。MySQL的缓存系统会监测涉及到的每张表,只要该表的 结构或者数据被修改,如对该表使用了INSERT 、 UPDATE 、 DELETE 、 TRUNCATE TABLE 、 TABLE 、 DROP TABLE 或 ALTER DROP DATABASE 语句,那使用该表的所有高速缓存查询都将变为无效并从高速缓存中删除!对于更新压力大的数据库来说,查询缓存的命中率会非常低。
总之,查询缓存往往弊大于利,一般建议大家在静态表里面使用查询缓存。什么是静态表呢?就是一般我们很少更新的表,比如系统配置表、字典表。这些表上的查询才适合查询缓存。
(2).解析器:在解析器中对 SQL 语句进行语法分析、语义分析
如果没有命中查询缓存,就要开始真正执行sql语句了。首先MySQL需要知道你要做什么,因此需要对SQL语句做解析,SQL语句的解析分为词法解析和语法解析。
1.分析器先做“ 词法分析”。你输入的是由多个字符串和空格组成的一条 SQL 语句,MySQL 需要识别出里面 的字符串分别是什么,代表什么。 MySQL 从你输入的"select"这个关键字识别出来,这是一个查询语句。它也要把字符串“T”识别成“表名 T”,把字符串“ID”识别成“列 ID”。
select * from emp where id = 1; #词法分析正确
select * form emp where id = 1; # 词法分析不正确
2.接着,要做“ 语法分析”。根据词法分析的结果,语法分析器(比如:Bison)会根
据语法规则,判断你输 入的这个 SQL 语句是否满足 MySQL 语法。
select department_id,job_id,avg(salary) from employees group by department_id; # 词法分析正确,但是语法分析不正确,会报错。
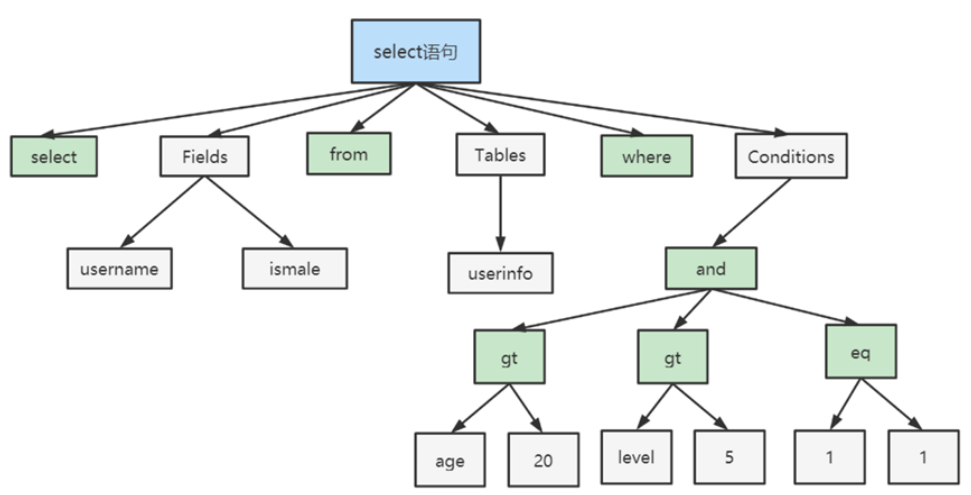
如果SQL语句正确,则会生成一个类似这样的语法树:
(3) 优化器:在优化器中会确定 SQL 语句的执行路径,比如是根据全表检索,还是根据索引检索等。
经过了解析器,MySQL知道你要做什么了。在开始执行之前,还要经过优化器的处理。一条SQL语句有很多种执行方式,最后都返回相同的结果。优化器的作用就是找到结果的最好的执行计划。
在查询优化器中,可以分为 逻辑查询优化阶段和 物理查询优化阶段。
- 逻辑查询优化就是通过改变SQL语句的内容使得SQL语句查询更为高效。通常采用的方式对SQL语句进行等价替换。比如嵌套子查询的写法,我们可以使用多表连接的方式来实现,因为多表连接比子查询更为高效。
- 物理查询优化更多的是需要结合索引进行查询,使用索引提供查询效率。
(4)执行器
截止到现在,还没有真正去读写真实的表,仅仅只是产出了一个执行计划。于是就进入了执行器阶段。
在执行之前需要判断该用户是否具备权限。如果没有,就会返回权限错误。如果具备权限,就执行 SQL 查询并返回结果。在 MySQL8.0 以下的版本,如果设置了查询缓存,这时会将查询结果进行缓存。
select * from test where id=1;
比如:表 test 中,ID 字段没有索引,那么执行器的执行流程是这样的:
- 调用 InnoDB 引擎接口取这个表的第一行,判断 ID 值是不是1,如果不是则跳过,如果是则将这行存在结果集中;
- 调用引擎接口取“下一行”,重复相同的判断逻辑,直到取到这个表的最后一行。
- 执行器将上述遍历过程中所有满足条件的行组成的记录集作为结果集返回给客户端。
至此,这个语句就执行完成了。对于有索引的表,执行的逻辑也差不多。
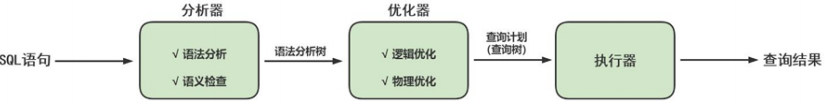
SQL 语句在 MySQL 中的流程是: SQL语句→查询缓存→解析器→优化器→执行器。
转载自 CSDN-专业IT技术社区
原文链接:https://blog.csdn.net/weixin_72753562/article/details/161323327

