

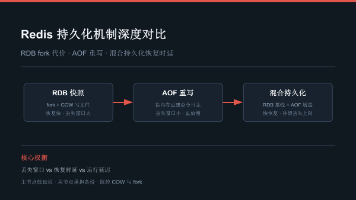
Redis 持久化机制深度对比:RDB fork 代价、AOF 重写与混合持久化的恢复时延
1. 从一次主从切换说起:为什么持久化一直在被低估
假设你负责一个电商详情页缓存集群,Redis 里存了 3 亿个商品摘要,实例内存 32GB。某天凌晨机房网络抖动,主节点触发哨兵切换,从节点提升为主。切换完成后监控报警:这个新主节点的写入 QPS 掉了一半,P99 延迟从 2ms 涨到 40ms,持续了将近 90 秒才恢复。
你登上机器看 INFO,发现切换过程中从节点正在做全量同步,同时触发了 RDB 落盘;而它内存里因为长期开启 AOF、appendfsync everysec,在切换瞬间又赶上了 AOF 缓冲区刷盘。三个动作挤在一起:fork 复制页表、磁盘写入快照、AOF 缓冲区 fsync。CPU 没满,磁盘 util 打满,主线程被 fsync 阻塞。
这类事故的根因往往不是“Redis 慢”,而是持久化策略和业务写入模式不匹配。持久化看起来只是三个配置项,实际决定了三件事:故障时丢多少数据、重启要等多久、正常运行要付出多少延迟。本文就把这三件事拆开讲清楚。
先记住一个最小模型:
- RDB 是把某一刻的整份数据写成一个二进制快照文件,像给内存拍照片。
- AOF 是把每条写命令按顺序追加到一个日志文件,像录像。
- 混合持久化 是重启基线用 RDB 快照,快照之后的增量用 AOF 追加,照片加录像。
这三个名字背后的关键差异,不在文件格式,而在什么时候写、谁去写、写的时候主线程要不要停下来。
2. 整体框架:谁在什么时候写什么文件
先把角色和连接关系理清楚,后面所有细节都挂在这张图上。
                客户端写命令
                     |
                     v
        +---------------------------+
        |      Redis 主线程          |
        |  1. 执行命令改内存         |
        |  2. 追加到 AOF 缓冲区      |
        |  3. 返回客户端             |
        +---------------------------+
             |                |
             |                |  fork()
             v                v
   +----------------+   +--------------------+
   | AOF 缓冲区      |   |   子进程            |
   | everysec 刷盘   |   |  遍历内存写 RDB     |
   +----------------+   +--------------------+
             |                |
             v                v
        appendonly.aof    dump.rdb
从这张图能看到三条独立的写路径:
- 主线程写内存并追加 AOF 缓冲区,这是同步路径,直接影响命令延迟。
fork()出子进程写 RDB,这是异步路径,但fork那一刻主线程要短暂停顿。- AOF 缓冲区按策略刷盘,
always每条都 fsync,everysec每秒一次,no交给操作系统。
再看一次完整的“写入到落盘”时序,把两者叠起来:
时间轴 --->

主线程:  [写命令]--[写命令]--[写命令]--[写命令]------------
AOF缓冲:    \          \          \          \
             +----------+----------+----------+--> [fsync 每秒]
RDB子进程:              |
                        +-- fork --[遍历页表]--[写文件]--[退出]
                                    |
                                    +-- 期间主线程写入的页被复制(COW)
这里出现了后面要反复讲的两个关键词:fork 的写时复制(Copy-On-Write,COW) 和 AOF 重写。前者决定 RDB 生成过程中内存会不会膨胀,后者决定 AOF 文件会不会无限增长。
3. RDB:快照到底“快”在哪里,代价又在哪里
3.1 一个具体场景:每天凌晨的定时快照
很多团队配置是这样的:
# redis.conf 简化节选
save 900 1        # 900 秒内至少 1 个 key 变化
save 300 10       # 300 秒内至少 10 个 key 变化
save 60 10000     # 60 秒内至少 10000 个 key 变化
dbfilename dump.rdb
dir /data/redis/6379
rdbcompression yes
三个 save 是“或”关系,任意一条满足就触发一次 RDB。凌晨低峰时,save 60 10000 很容易被满足,于是持续有 fork。
RDB 的优势很直接:文件是紧凑的二进制,加载时比逐条重放 AOF 快得多;适合做备份和跨机房传输。代价集中在两点:fork 的停顿和生成期间的 COW 内存膨胀。
3.2 fork 到底做了什么
fork() 是操作系统调用,Linux 上它给子进程复制一份父进程的页表,把内存页标记为只读共享。子进程开始遍历内存写 RDB 文件,父进程继续处理客户端请求。任何一方要修改某个内存页时,内核才真正复制那一页,这就是写时复制。
关键工程结论:
- fork 本身耗时和页表大小正相关,和实际数据量只间接相关。32GB 实例、开启大页或使用大量小对象时,页表项多,fork 更慢。
- COW 会产生额外内存占用。生成快照期间主线程写入越激烈,被复制的页越多,最坏情况下接近翻倍。
- fork 是阻塞主线程的,阻塞时长可以用
INFO stats里的latest_fork_usec观察。
3.3 用数据验证 fork 代价
下面这个 Java 示例用 Jedis(Redis 官方 Java 客户端)做一次可复现的观测实验。目标:在高写入压力下触发一次 BGSAVE,记录 latest_fork_usec 和内存变化。
前置环境:Redis 7.x 单实例,本地或测试环境;JDK 17;Maven 依赖 redis.clients:jedis:5.1.0。
import redis.clients.jedis.Jedis;
import redis.clients.jedis.JedisPool;

import java.util.concurrent.CountDownLatch;
import java.util.concurrent.ExecutorService;
import java.util.concurrent.Executors;
import java.util.concurrent.TimeUnit;

public class RdbForkObservation {

    public static void main(String[] args) throws Exception {
        JedisPool pool = new JedisPool("127.0.0.1", 6379);
        int writers = 4;
        int opsPerWriter = 20000;
        ExecutorService executor = Executors.newFixedThreadPool(writers);
        CountDownLatch done = new CountDownLatch(writers);

        try {
            // 1. 制造持续写入,让内存处于变动状态
            for (int w = 0; w < writers; w++) {
                final int id = w;
                executor.submit(() -> {
                    try (Jedis jedis = pool.getResource()) {
                        for (int i = 0; i < opsPerWriter; i++) {
                            String key = "fork:test:" + id + ":" + i;
                            jedis.set(key, "payload-payload-payload-payload");
                        }
                    } finally {
                        done.countDown();
                    }
                });
            }

            // 2. 等写入进行到一半时触发 BGSAVE
            Thread.sleep(500);
            long beforeFork = readForkUsec(pool);
            try (Jedis jedis = pool.getResource()) {
                System.out.println("BGSAVE 结果: " + jedis.bgsave());
            }
            long afterFork = readForkUsec(pool);
            System.out.println("本次 fork 耗时(us): " + afterFork);
            System.out.println("触发前 fork 耗时(us): " + beforeFork);

            done.await(60, TimeUnit.SECONDS);
            System.out.println("used_memory_human: " + readInfoField(pool, "used_memory_human"));
            System.out.println("rdb_last_cow_size: " + readInfoField(pool, "rdb_last_cow_size"));
        } finally {
            executor.shutdownNow();
            pool.close();
        }
    }

    private static long readForkUsec(JedisPool pool) {
        try (Jedis jedis = pool.getResource()) {
            String value = jedis.info("stats");
            return parseLong(value, "latest_fork_usec");
        }
    }

    private static String readInfoField(JedisPool pool, String field) {
        try (Jedis jedis = pool.getResource()) {
            // used_memory_human 在 memory 段,rdb_last_cow_size 在 stats 段
            String all = jedis.info();
            return String.valueOf(parseRaw(all, field));
        }
    }

    private static long parseLong(String info, String field) {
        return Long.parseLong(String.valueOf(parseRaw(info, field)));
    }

    private static Object parseRaw(String info, String field) {
        for (String line : info.split("\n")) {
            if (line.startsWith(field + ":")) {
                return line.substring(field.length() + 1).trim();
            }
        }
        return -1L;
    }
}
怎么读结果:latest_fork_usec 是最近一次 fork 的微秒数,通常几百到几千;如果达到几万以上,说明页表复制已经很重。rdb_last_cow_size 是上一次 RDB 期间被 COW 复制的字节数,它直接告诉你“快照期间主线程写入造成了多少额外内存复制”。写入压力越大,这个值越接近内存的很大一部分。
容易改错的地方:很多同学直接把 latest_fork_usec 当成 RDB 总耗时,这是误解。fork 只是“复制页表”,真正写文件是子进程慢慢做的,不阻塞主线程。真正需要警惕的是 fork 停顿叠加 COW 内存膨胀。
3.4 RDB 的适用边界
- 适合:数据可以接受分钟级丢失、需要快速重启、需要定期异地备份。
- 不适合:要求几乎不丢数据的交易类场景,纯 RDB 无法满足。
- 注意:
save ""关闭自动 RDB 后,仍可手动BGSAVE或依赖主从复制触发。
4. AOF:录像机为什么会越录越厚
4.1 三条刷盘策略的本质区别
AOF 把每条写命令追加到文件。问题在于,命令写进文件后是否立刻刷到磁盘,由 appendfsync 决定。
| 策略 | 行为 | 丢数据窗口 | 对主线程延迟影响 | 适用场景 |
|---|---|---|---|---|
always | 每条命令都 fsync | 几乎不丢 | 最大,受磁盘 IOPS 限制 | 强一致要求、低写入量 |
everysec | 每秒 fsync 一次 | 最多丢 1 秒 | 较小,但可能被后台 fsync 阻塞 | 绝大多数生产场景 |
no | 交给操作系统决定 | 可能丢几十秒 | 最小 | 对丢失不敏感、追求吞吐 |
这里最容易误解的是 everysec 的“每秒一次”。它并不是主线程主动每秒刷盘,而是后台线程每秒执行 fsync。如果上一次 fsync 还没完成、磁盘又慢,主线程在写 AOF 缓冲区时可能被拖延,这就是很多“偶发毛刺”的来源。
4.2 AOF 重写:为什么要重写
录像越录越长,但很多命令是重复覆盖的。比如对同一个 key 先 SET a 1,再 SET a 2,再 SET a 3,最终只需要 SET a 3。AOF 重写就是启动一个子进程,把当前内存状态“翻译”成一批等效的最小命令集合,替换掉旧文件。
注意:重写不是读取旧 AOF 再压缩,而是直接遍历内存生成新 AOF。所以它同样依赖 fork(),同样有 COW 代价。
重写期间主线程还在接收写命令,这批新命令必须被记录,否则会丢。Redis 的做法是:主线程把重写期间的新命令同时写入一个 AOF 重写缓冲区,子进程写完后,主线程把这个缓冲区追加到新文件末尾,再原子替换。
AOF 重写时序(简化)

主线程:   [接收写命令]--[写命令]--[写命令]--------[追加重写缓冲]--[替换文件]
             |             |          |
             v             v          v
旧 AOF:   append...
重写缓冲:  +------------+------------+----------+
子进程:          |
                 +-- fork --[遍历内存生成新 AOF]--[完成]
4.3 一个可复现的重写观测实验
目标:制造大量会被覆盖的写命令,观察重写前后 AOF 文件大小变化。
步骤(在测试 Redis 上执行,务必不要在生产执行):
# 1. 开启 AOF
redis-cli CONFIG SET appendonly yes
redis-cli CONFIG SET appendfsync everysec

# 2. 写入 10 万个同 key 的覆盖写
for i in $(seq 1 100000); do redis-cli SET hot:key $i > /dev/null; done

# 3. 查看当前 AOF 大小
redis-cli INFO persistence | grep -E "aof_current_size|aof_base_size"

# 4. 手动触发重写
redis-cli BGREWRITEAOF

# 5. 等重写完成后再看
sleep 5
redis-cli INFO persistence | grep -E "aof_current_size|aof_base_size"
预期结果:重写前 aof_current_size 是几十 MB 级别,重写后可能缩小到几百 KB,因为 10 万次覆盖只保留最后一次。
边界与常见错误:
- 重写完成后文件变小,是正常现象;如果重写后反而更大,检查是否有大量未被覆盖的独立 key。
BGREWRITEAOF在已有子进程重写时会返回错误或排队,不要反复触发。- 重写期间如果磁盘写满,可能导致重写失败甚至数据不一致,务必监控磁盘水位。
5. 混合持久化:为什么要“照片加录像”
纯 AOF 的问题是重启慢。假设 AOF 有 20GB,重启时 Redis 要逐条重放这 20GB 命令,可能几分钟才能对外服务。RDB 加载快,但生成间隔内会丢数据。混合持久化就是折中:重启时先加载 RDB 快照拿到基线,再重放快照之后的 AOF 增量。
开启方式:
# redis.conf
appendonly yes
aof-use-rdb-preamble yes
混合持久化下,AOF 文件的前半段是 RDB 格式的二进制快照,后半段是文本命令。重写时,子进程直接以 RDB 格式写基线,主线程再把增量命令追加在后面。重启流程变成:
加载 aof 文件
   |
   +-- 检测到 RDB preamble --> 用 RDB 加载器快速还原基线
   |
   +-- 后续文本命令 --> 逐条重放
   |
   v
恢复完成,开始服务
这样既保留了 AOF 秒级丢数据上限,又避免了重放整份历史命令。代价是 AOF 文件不再能被普通文本工具直接阅读,排障时要先解析 RDB 段。
5.1 三种方案对比
| 维度 | 纯 RDB | 纯 AOF | 混合持久化 |
|---|---|---|---|
| 数据丢失窗口 | 分钟级 | 秒级(everysec) | 秒级 |
| 重启恢复速度 | 快 | 慢,与文件大小线性相关 | 快,接近 RDB |
| 文件可读性 | 差,二进制 | 好,文本命令 | 前段二进制后段文本 |
| fork 代价 | 有 | 有,重写时 | 有,重写时 |
| 磁盘占用 | 小 | 大,需要重写压缩 | 中等 |
| 适用场景 | 备份、容灾 | 接受慢重启、要求低丢失 | 生产默认推荐 |
6. 恢复时延:一次重启完整走一遍
把重启过程按顺序走一遍,理解时延花在哪里。
Redis 进程启动
   |
   +-- 1. 读取配置,决定加载哪个文件
   |
   +-- 2. 若 appendonly yes 且有 aof --> 加载 AOF
   |         |
   |         +-- 有 RDB preamble ? 先加载 RDB 段 : 直接重放文本
   |         +-- 重放剩余命令
   |
   +-- 3. 若 appendonly no 且有 dump.rdb --> 加载 RDB
   |
   +-- 4. 构建内存数据结构、重建过期时间
   |
   +-- 5. 开始监听端口,对外服务
影响恢复时延的要素:
- 文件大小:AOF 越大,重放越久;RDB 加载是顺序反序列化,快很多。
- 命令复杂度:一条
ZADD和一条SET的重放成本不同,大 key 的加载更慢。 - key 数量:重建哈希表和过期字典的耗时与 key 数量相关。
- 磁盘 IO:冷启动从机械盘读取比 SSD 慢一个数量级。
6.1 用 Java 测量恢复时延的思路
恢复时延不发生在客户端代码里,但可以用客户端做端到端观测:重启实例,记录从进程启动到 PING 成功、且 INFO persistence 显示 loading:0 的时间。
import redis.clients.jedis.Jedis;
import redis.clients.jedis.JedisPool;

public class RestartLatencyProbe {

    public static void main(String[] args) throws Exception {
        JedisPool pool = new JedisPool("127.0.0.1", 6379);
        long start = System.currentTimeMillis();
        boolean ready = false;
        while (System.currentTimeMillis() - start < 300_000) {
            try (Jedis jedis = pool.getResource()) {
                jedis.ping();
                String loading = readField(jedis.info("persistence"), "loading");
                if ("0".equals(loading)) {
                    ready = true;
                    break;
                }
            } catch (Exception e) {
                // 连接被拒绝说明还没起来,继续等
            }
            Thread.sleep(500);
        }
        System.out.println("恢复就绪: " + ready + ",耗时(ms): " + (System.currentTimeMillis() - start));
        pool.close();
    }

    private static String readField(String info, String field) {
        for (String line : info.split("\n")) {
            if (line.startsWith(field + ":")) {
                return line.substring(field.length() + 1).trim();
            }
        }
        return "unknown";
    }
}
说明:loading:1 表示正在加载持久化文件,此时 Redis 可能已经接受 TCP 连接但拒绝大多数命令。判断“真正可服务”要同时看 PING 成功和 loading:0。
7. 设计取舍:什么时候选哪种
把上面的机制收束成一组条件化结论:
- 当你能接受分钟级数据丢失、且更关注重启速度和备份成本时,选纯 RDB。
- 当你需要秒级丢失上限、能接受较长重启时间、且会定期重写时,选纯 AOF。
- 当你既要秒级丢失上限、又要快速重启时,选混合持久化,这也是大多数生产集群的默认。
- 当写入压力极大、fork 停顿已经影响 P99 时,减少自动 RDB 频率,改为低峰定时 BGSAVE 或只做从节点备份。
一个常被忽略的点:持久化策略应该由从节点承担。主节点负责写入和复制,从节点上开启 RDB 或 AOF 用于备份和恢复,可以避免 fork 直接冲击主节点延迟。
8. 生产实践建议
8.1 参数配置清单
# 主节点:优先低延迟
appendonly yes
aof-use-rdb-preamble yes
appendfsync everysec
no-appendfsync-on-rewrite yes        # 重写期间不 fsync,降低阻塞,但可能丢更多
save ""                              # 关闭自动 RDB,避免与重写叠加

# 复制积压与重写触发
auto-aof-rewrite-percentage 100      # 文件比上次大一倍时重写
auto-aof-rewrite-min-size 64mb       # 至少 64MB 才重写
8.2 内存与 COW 的容量规划
- 生成快照或重写期间,预留至少 50% 空闲内存,极端写入下 COW 会明显膨胀。
- 使用
INFO stats的rdb_last_cow_size、aof_last_cow_size建立长期监控。 - 避免在业务高峰触发
BGSAVE或BGREWRITEAOF。
8.3 大 key 与持久化的关系
一个大 key(比如含百万元素的 Hash)在 AOF 重写、RDB 生成、恢复加载时都会成为瓶颈。它可能在重放时一次性占用大量内存和 CPU。建议对大 key 做拆分,或至少单独监控其加载耗时。
9. 排障清单
遇到持久化相关异常时,按以下顺序检查:
| 现象 | 优先检查 | 常见原因 |
|---|---|---|
| 周期性延迟毛刺 | latest_fork_usec、COW 大小 | 自动 RDB 与高写入叠加 |
| 重启特别慢 | AOF 文件大小、是否混合持久化 | 未开启混合持久化 |
| 磁盘持续增长 | aof_current_size、重写是否失败 | 重写触发条件未满足 |
| 重写反复失败 | 磁盘水位、aof_last_bgrewrite_status | 磁盘写满或权限问题 |
| 丢数据超过预期 | appendfsync、no-appendfsync-on-rewrite | 策略放宽导致窗口变大 |
| 内存异常上涨 | COW 大小、是否在重写 | 快照期间写入过猛 |
10. 常见误区
- 误区一:fork 会复制整个内存。实际上只复制页表,数据页靠 COW 按需复制。但写入激烈时,复制的页可能接近全量。
- 误区二:AOF 重写是压缩旧文件。它是遍历内存重新生成,不读旧文件。
- 误区三:混合持久化的 AOF 可以当纯文本看。前段是 RDB 二进制,必须用工具解析。
- 误区四:关掉持久化就不影响延迟。主从全量同步同样会 fork 生成 RDB。
- 误区五:
everysec绝不会丢超过 1 秒。磁盘卡顿或 fsync 堆积时,丢失窗口可能更大。
11. 面试/复盘问题
- RDB 的
fork为什么是阻塞的,阻塞时长和什么相关? - AOF 重写期间的新写命令如何保证不丢?
- 混合持久化如何兼顾恢复速度和丢失窗口?
- 为什么建议把持久化压力放到从节点?
- COW 在什么写入模式下最危险,如何量化?
no-appendfsync-on-rewrite的取舍是什么?
12. 总结
回到开头的切换事故:从节点在提升瞬间同时承受全量同步 RDB、AOF 刷盘和客户端写入,延迟自然飙升。如果主节点关闭自动 RDB、从节点负责备份,并开启混合持久化控制恢复时延,这类毛刺会明显减少。
一张决策框架收尾:
- 要低丢失:开启 AOF,用
everysec。 - 要快恢复:开启
aof-use-rdb-preamble,走混合持久化。 - 要控延迟:主节点减少 fork,把快照压力转移到从节点。
- 要容量安全:长期监控 COW 大小,预留 50% 内存。
- 要可排障:把 AOF 大小、重写状态、fork 耗时纳入监控面板。
持久化不是“开或关”的开关,而是一组关于丢失窗口、恢复时间、运行延迟的权衡。理解 fork、重写和恢复加载这三条路径,你就能在监控告警出现之前把问题挡住。
13. 参考资料
- Redis 官方文档:Persistence(https://redis.io/docs/management/persistence/)
- Redis 官方文档:INFO command(https://redis.io/commands/info/)
- Redis 源码
src/rdb.c、src/aof.c - Linux man-pages:fork(2)、copy-on-write 相关说明
- 《Redis 设计与实现》,黄健宏
转载自 CSDN-专业IT技术社区
原文链接:https://blog.csdn.net/qq_29029209/article/details/166795143

