

💖💖作者:计算机毕业设计杰瑞
💙💙个人简介:曾长期从事计算机专业培训教学,本人也热爱上课教学,语言擅长Java、微信小程序、Python、Golang、安卓Android等,开发项目包括大数据、深度学习、网站、小程序、安卓、算法。平常会做一些项目定制化开发、代码讲解、答辩教学、文档编写、也懂一些降重方面的技巧。平常喜欢分享一些自己开发中遇到的问题的解决办法,也喜欢交流技术,大家有技术代码这一块的问题可以问我!
💛💛想说的话:感谢大家的关注与支持!
💜💜
网站实战项目
安卓/小程序实战项目
大数据实战项目
深度学校实战项目
计算机毕业设计选题推荐
目录
基于大数据的能见度探测数据分析与可视化介绍
本系统名为《基于大数据的能见度探测数据分析与可视化》,主要面向能见度探测记录的大规模存储、清洗、统计与可视化展示需求,采用Hadoop+HDFS完成底层数据存储,借助Spark与Spark SQL对能见度探测数据进行分布式计算与聚合分析,并使用Pandas、NumPy完成必要的数值处理,后端分别提供Django与Spring Boot两个版本,前端采用Vue、ElementUI、Echarts、HTML、CSS、JavaScript与jQuery实现交互与图表渲染,数据库使用MySQL保存分析结果与基础信息。系统功能涵盖系统首页、能见度探测记录、站点覆盖分析、时间序列分析、空间分布分析、等级结构分析、极端事件分析、区域差异分析以及雾霾模式分析,能够对能见度探测数据按时间、站点、区域和等级等维度进行统计分析,并通过可视化方式呈现能见度变化趋势、空间分布特征、极端事件出现情况以及雾霾模式规律,从而为能见度探测数据的整理、查询与分析提供一套相对完整的大数据毕设实现方案。
基于大数据的能见度探测数据分析与可视化演示视频
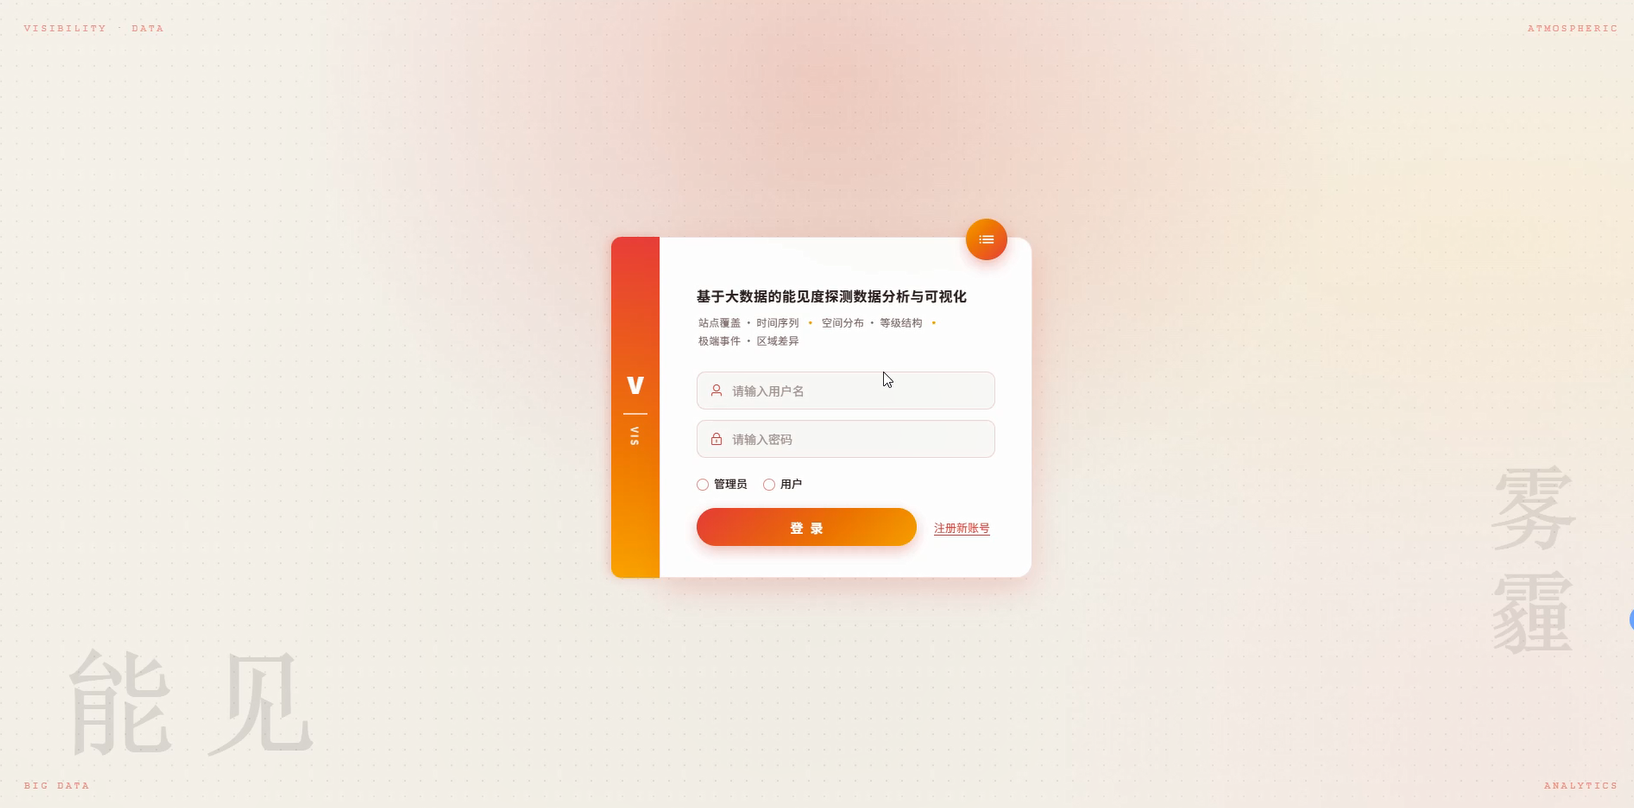
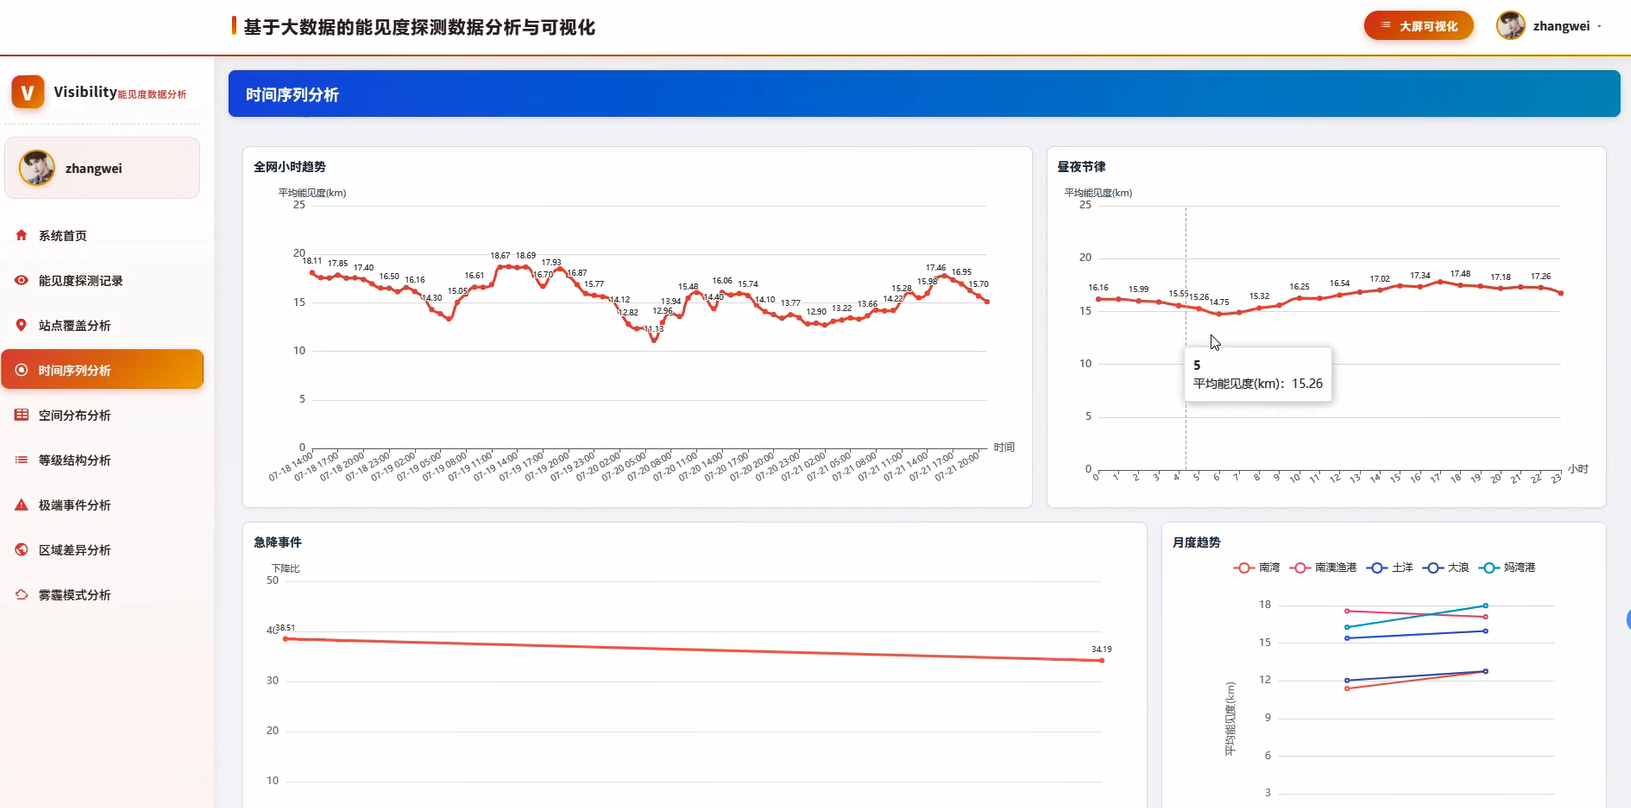
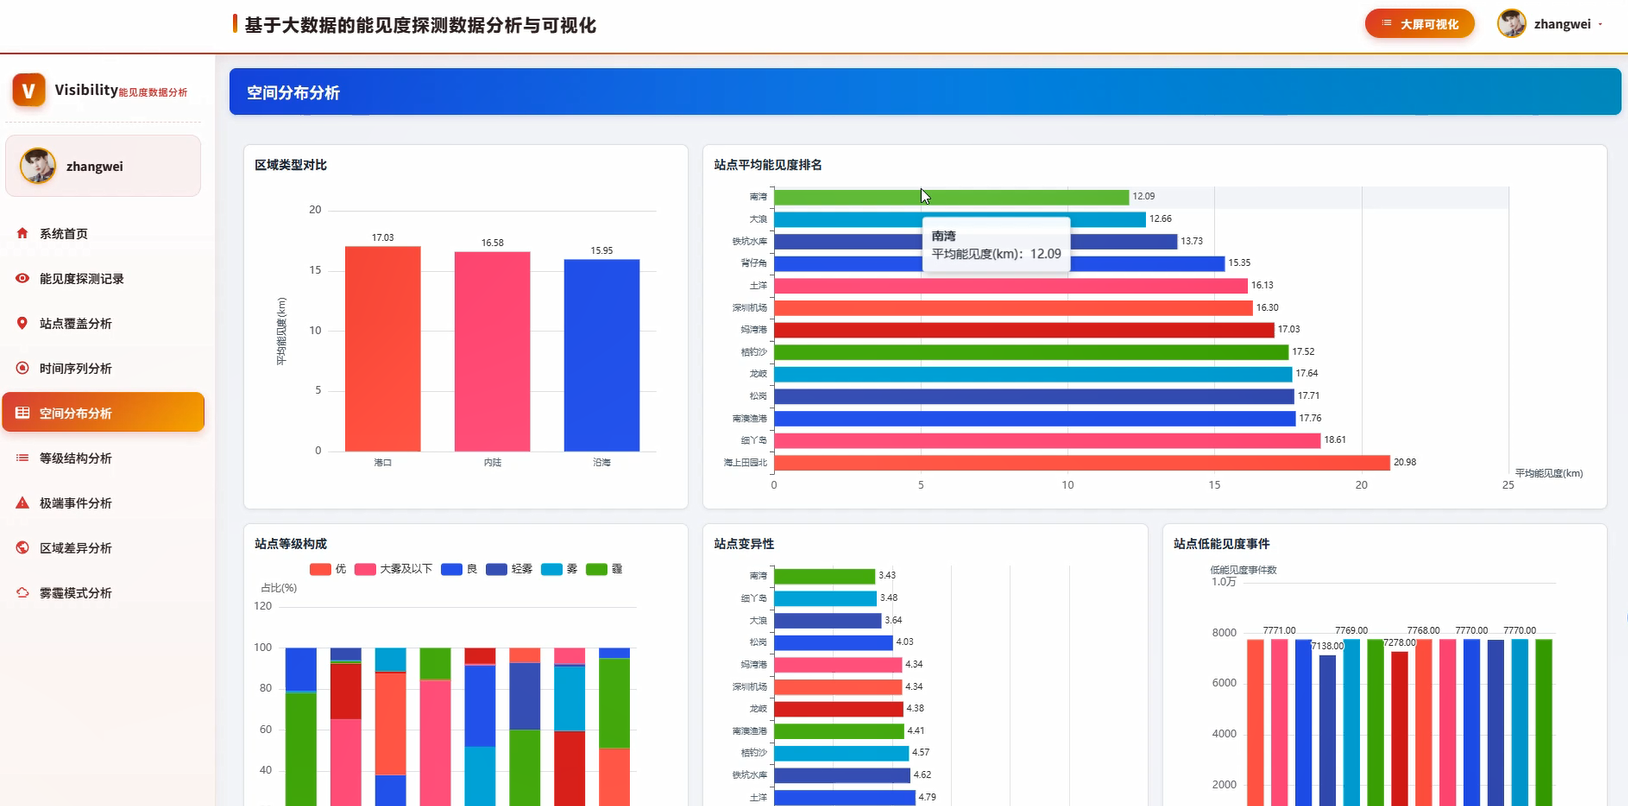
基于大数据的能见度探测数据分析与可视化演示图片
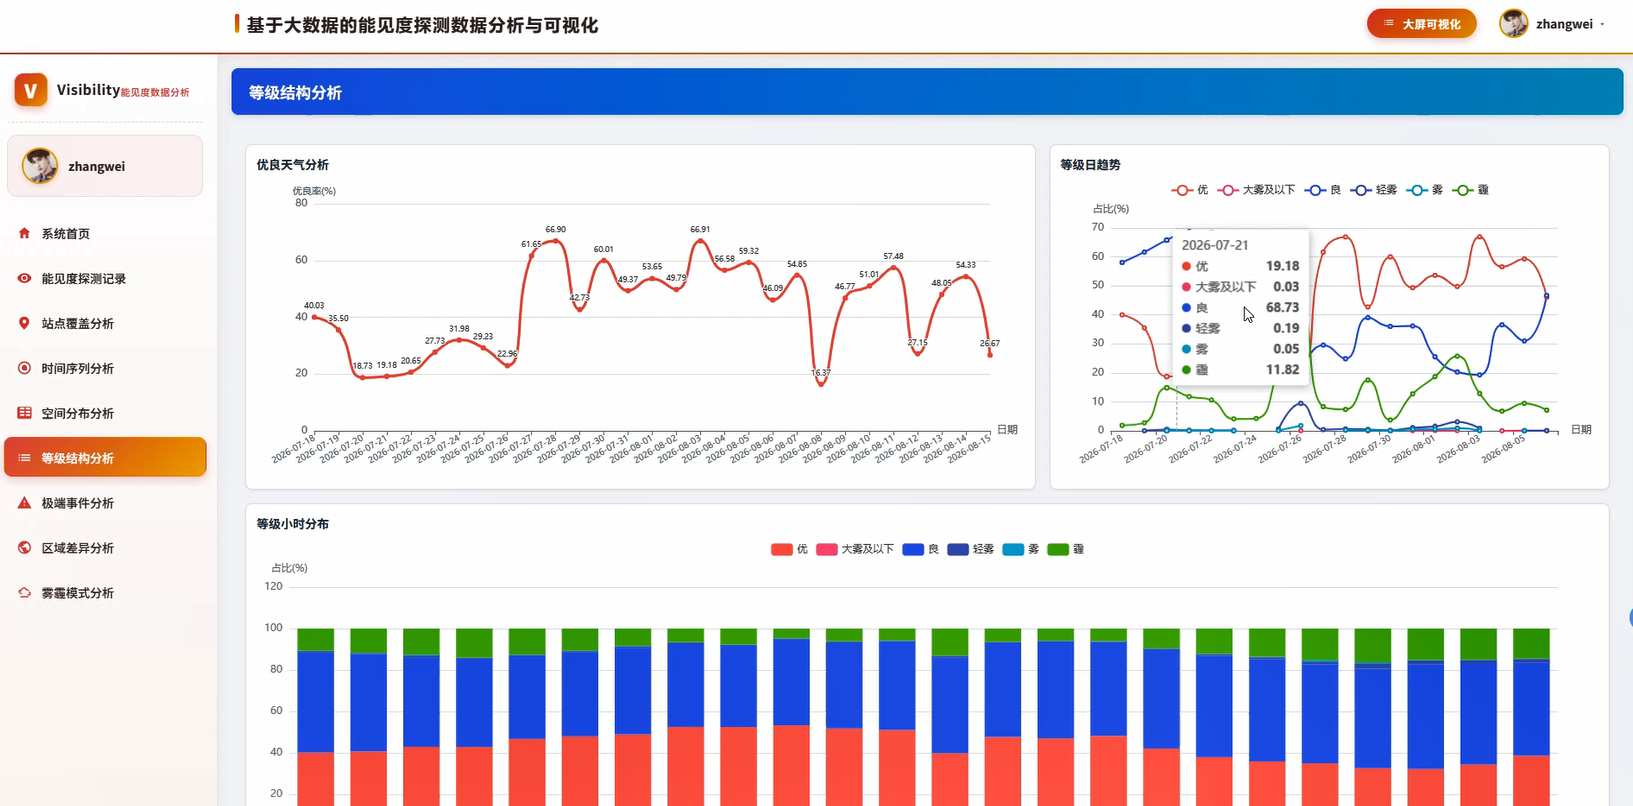
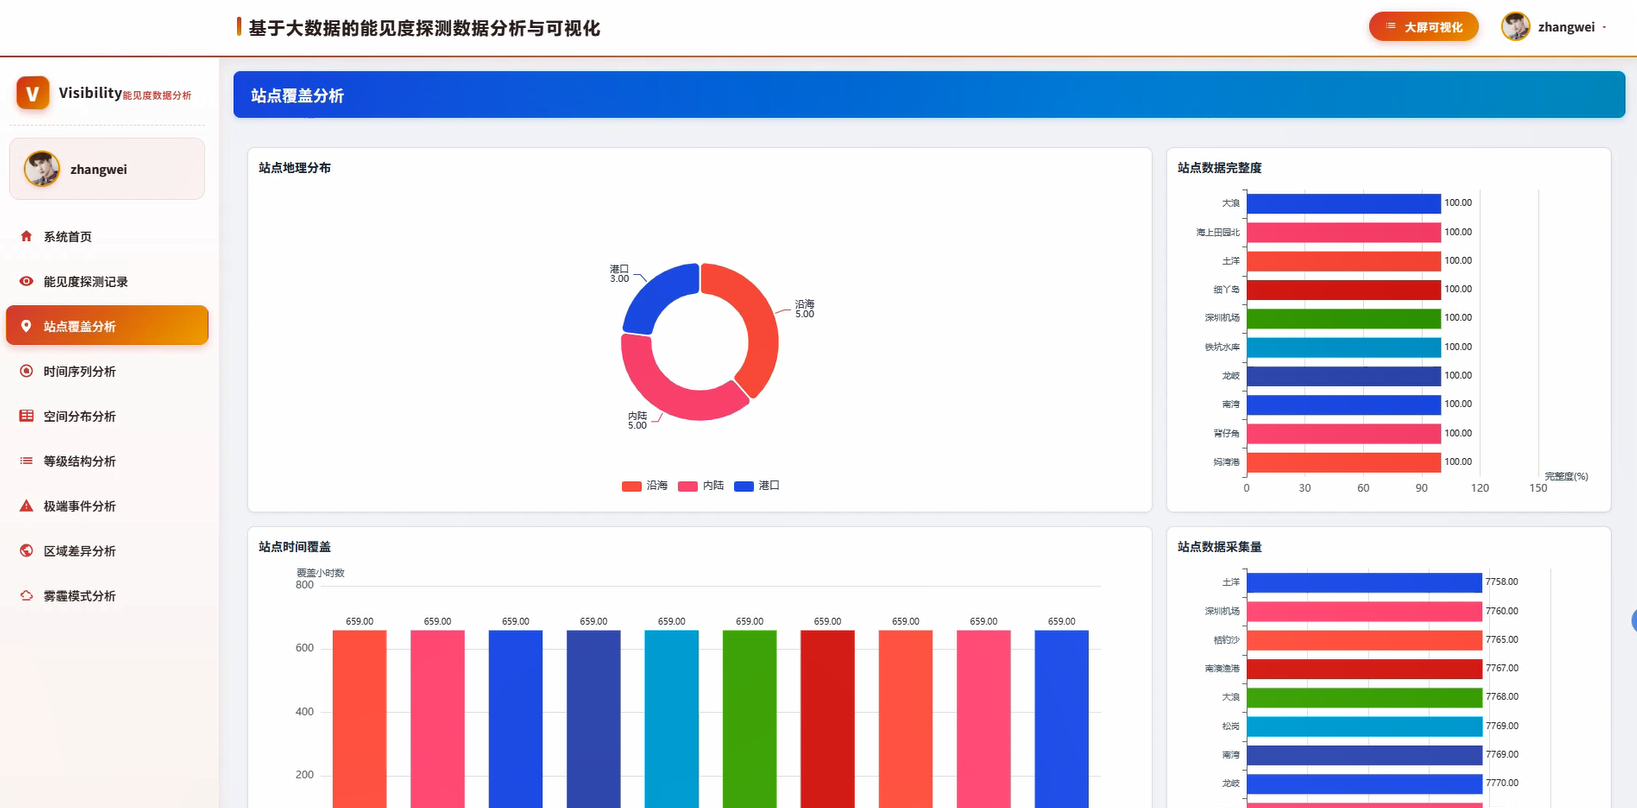
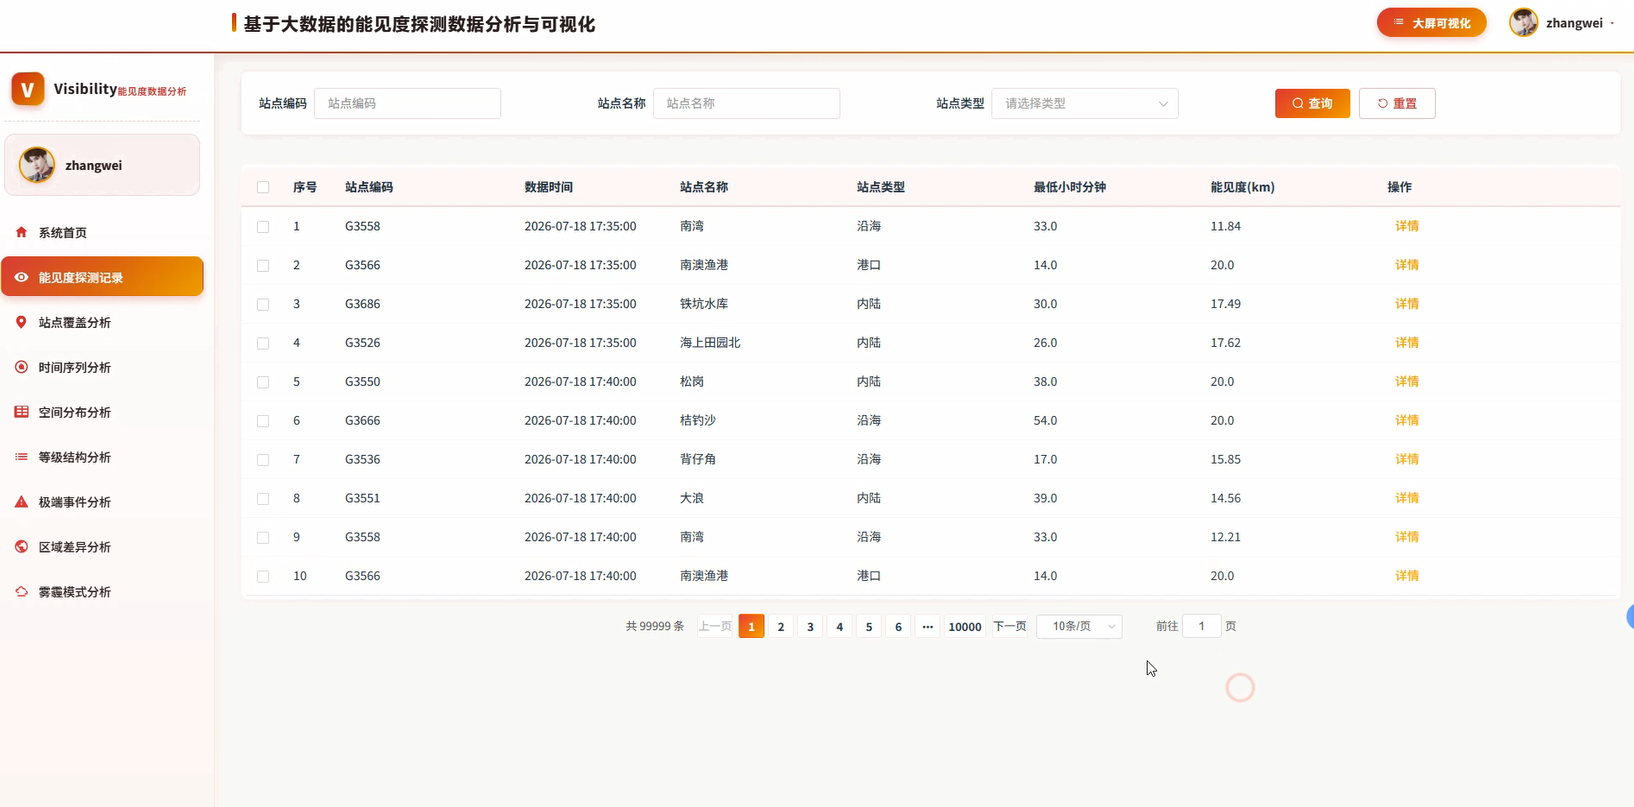
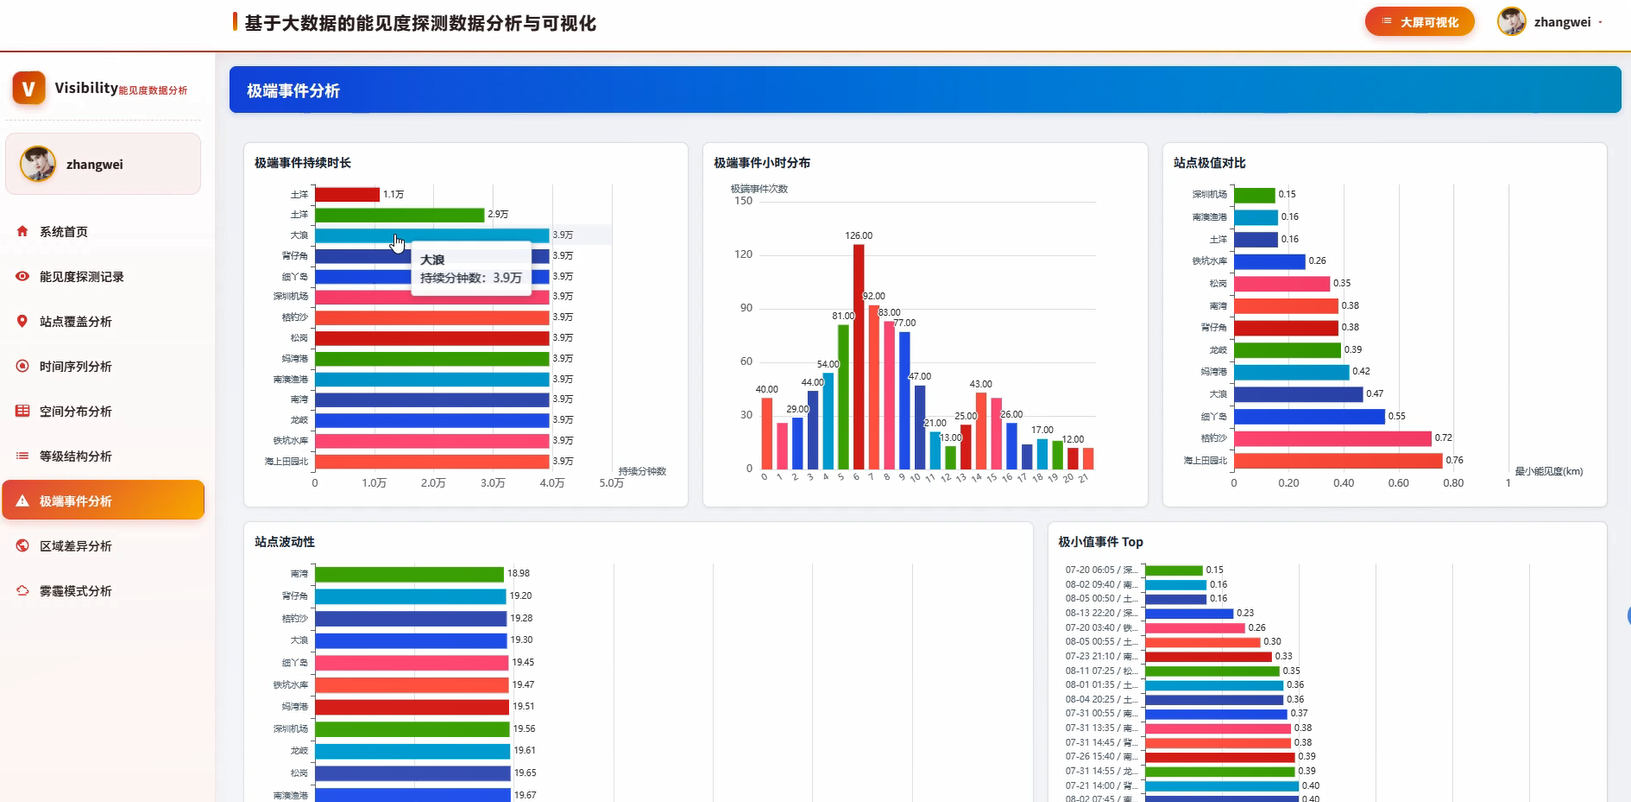
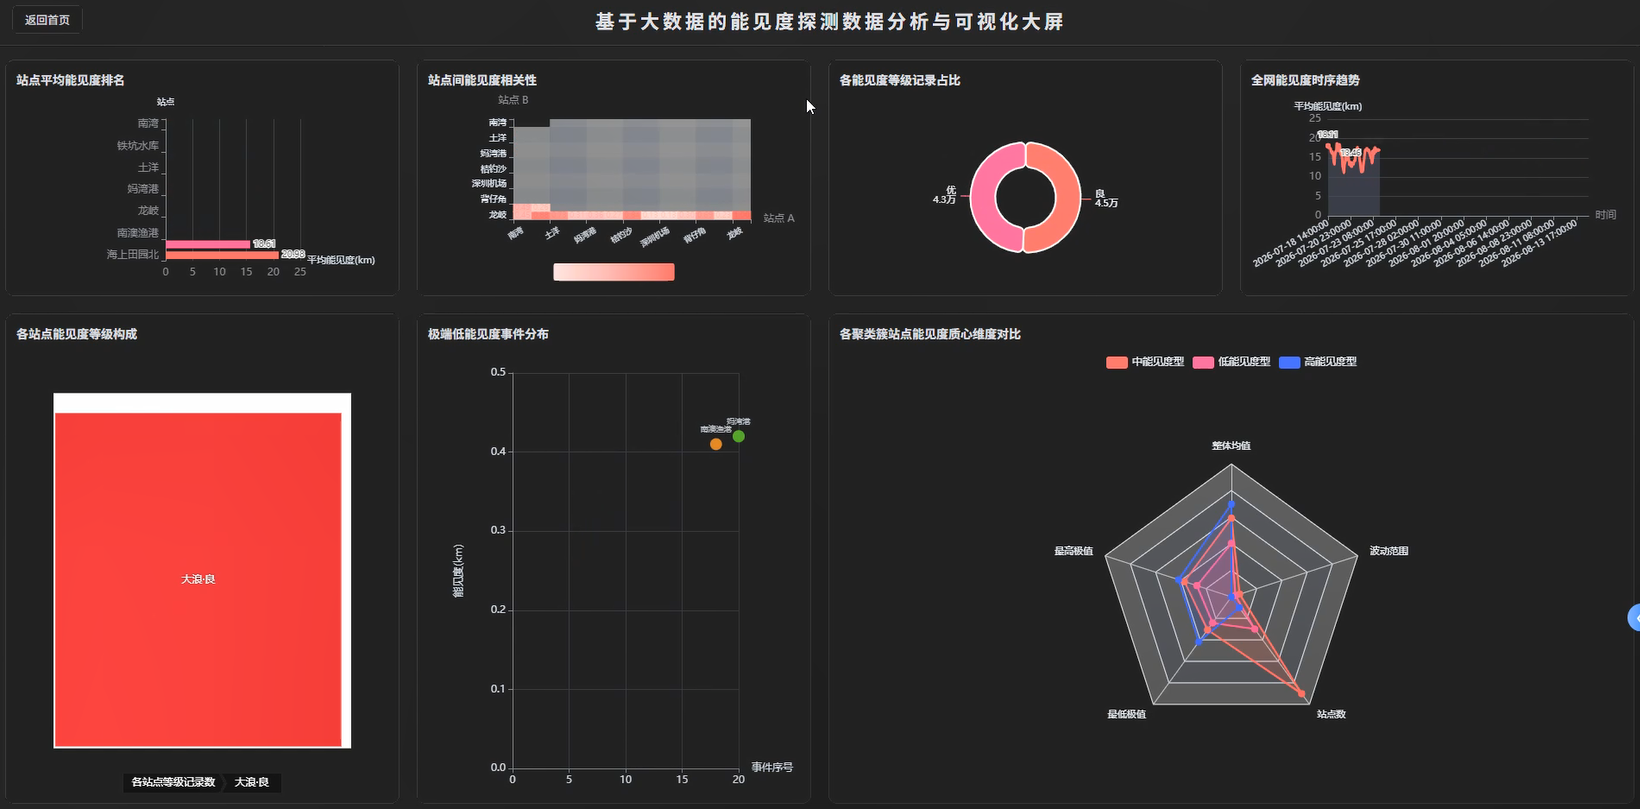
基于大数据的能见度探测数据分析与可视化代码展示
# 核心功能一:能见度探测记录的大数据清洗与入库
def process_visibility_records(spark, mysql_conf):
    spark_session = SparkSession.builder.appName("VisibilityRecordProcess").config("spark.sql.shuffle.partitions", "4").getOrCreate()
    raw_df = spark_session.read.option("header", "true").csv("hdfs:///visibility/raw/records")
    clean_df = raw_df.dropDuplicates(["station_id", "observe_time"]).filter("visibility >= 0").filter("station_id is not null").filter("observe_time is not null")
    clean_df = clean_df.withColumn("visibility_level", when(col("visibility") < 0.5, "强浓雾").when(col("visibility") < 1.0, "浓雾").when(col("visibility") < 2.0, "雾").when(col("visibility") < 5.0, "轻雾").otherwise("一般"))
    clean_df = clean_df.withColumn("observe_date", to_date(col("observe_time"))).withColumn("observe_hour", hour(col("observe_time")))
    clean_df.write.mode("overwrite").option("header", "true").csv("hdfs:///visibility/clean/records")
    clean_df.select("station_id", "observe_time", "visibility", "visibility_level", "observe_date", "observe_hour").write.mode("append").format("jdbc").option("url", mysql_conf["url"]).option("dbtable", "visibility_record").option("user", mysql_conf["user"]).option("password", mysql_conf["password"]).save()
    level_count = clean_df.groupBy("visibility_level").count().orderBy(desc("count"))
    level_count.write.mode("overwrite").format("jdbc").option("url", mysql_conf["url"]).option("dbtable", "visibility_level_stat").option("user", mysql_conf["user"]).option("password", mysql_conf["password"]).save()
    return clean_df.count()
# 核心功能二:时间序列分析与极端事件分析
def analyze_time_series(spark, mysql_conf):
    spark_session = SparkSession.builder.appName("VisibilityTimeSeries").config("spark.sql.shuffle.partitions", "4").getOrCreate()
    record_df = spark_session.read.format("jdbc").option("url", mysql_conf["url"]).option("dbtable", "visibility_record").option("user", mysql_conf["user"]).option("password", mysql_conf["password"]).load()
    hourly_df = record_df.groupBy("observe_date", "observe_hour").agg(avg("visibility").alias("avg_visibility"), min("visibility").alias("min_visibility"), max("visibility").alias("max_visibility"), count("visibility").alias("record_count"))
    hourly_df = hourly_df.withColumn("visibility_fluctuation", col("max_visibility") - col("min_visibility")).orderBy("observe_date", "observe_hour")
    hourly_df.write.mode("overwrite").format("jdbc").option("url", mysql_conf["url"]).option("dbtable", "visibility_time_series").option("user", mysql_conf["user"]).option("password", mysql_conf["password"]).save()
    extreme_df = record_df.filter((col("visibility") < 1.0) | (col("visibility") > 20.0))
    extreme_df = extreme_df.withColumn("extreme_type", when(col("visibility") < 1.0, "低能见度").otherwise("高能见度"))
    extreme_stat = extreme_df.groupBy("station_id", "extreme_type").agg(count("visibility").alias("extreme_count"), avg("visibility").alias("extreme_avg")).orderBy(desc("extreme_count"))
    extreme_stat.write.mode("overwrite").format("jdbc").option("url", mysql_conf["url"]).option("dbtable", "visibility_extreme_stat").option("user", mysql_conf["user"]).option("password", mysql_conf["password"]).save()
    return hourly_df.count()
# 核心功能三:空间分布分析与区域差异分析
def analyze_spatial_distribution(spark, mysql_conf):
    spark_session = SparkSession.builder.appName("VisibilitySpatialAnalysis").config("spark.sql.shuffle.partitions", "4").getOrCreate()
    record_df = spark_session.read.format("jdbc").option("url", mysql_conf["url"]).option("dbtable", "visibility_record").option("user", mysql_conf["user"]).option("password", mysql_conf["password"]).load()
    station_df = spark_session.read.format("jdbc").option("url", mysql_conf["url"]).option("dbtable", "station_info").option("user", mysql_conf["user"]).option("password", mysql_conf["password"]).load()
    join_df = record_df.join(station_df, on="station_id", how="left")
    station_stat = join_df.groupBy("station_id", "station_name", "longitude", "latitude").agg(avg("visibility").alias("avg_visibility"), count("visibility").alias("record_count"))
    station_stat.write.mode("overwrite").format("jdbc").option("url", mysql_conf["url"]).option("dbtable", "visibility_station_distribution").option("user", mysql_conf["user"]).option("password", mysql_conf["password"]).save()
    region_stat = join_df.groupBy("region_name").agg(avg("visibility").alias("region_avg_visibility"), min("visibility").alias("region_min_visibility"), max("visibility").alias("region_max_visibility"), count("visibility").alias("region_record_count"))
    region_stat = region_stat.withColumn("region_gap", col("region_max_visibility") - col("region_min_visibility")).orderBy(desc("region_avg_visibility"))
    region_stat.write.mode("overwrite").format("jdbc").option("url", mysql_conf["url"]).option("dbtable", "visibility_region_difference").option("user", mysql_conf["user"]).option("password", mysql_conf["password"]).save()
    return region_stat.count()
基于大数据的能见度探测数据分析与可视化文档展示
💖💖作者:计算机毕业设计杰瑞
💙💙个人简介:曾长期从事计算机专业培训教学,本人也热爱上课教学,语言擅长Java、微信小程序、Python、Golang、安卓Android等,开发项目包括大数据、深度学习、网站、小程序、安卓、算法。平常会做一些项目定制化开发、代码讲解、答辩教学、文档编写、也懂一些降重方面的技巧。平常喜欢分享一些自己开发中遇到的问题的解决办法,也喜欢交流技术,大家有技术代码这一块的问题可以问我!
💛💛想说的话:感谢大家的关注与支持!
💜💜
网站实战项目
安卓/小程序实战项目
大数据实战项目
深度学校实战项目
计算机毕业设计选题推荐
转载自 CSDN-专业IT技术社区
原文链接:https://blog.csdn.net/2501_92994129/article/details/165484616

