

✍✍计算机毕设指导师**
⭐⭐个人介绍:自己非常喜欢研究技术问题!专业做Java、Python、小程序、安卓、大数据、爬虫、Golang、大屏等实战项目。
⛽⛽实战项目:有源码或者技术上的问题欢迎在评论区一起讨论交流!也可以在主页上或文末下与博主交流~~
⚡⚡Java、Python、小程序、大数据实战项目集](https://blog.csdn.net/2301_80395604/category_12487856.html)
⚡⚡文末获取源码
温馨提示:文末有CSDN平台官方提供的博客联系方式!
温馨提示:文末有CSDN平台官方提供的博客联系方式!
温馨提示:文末有CSDN平台官方提供的博客联系方式!
电动汽车品牌与车型流行趋势数据分析系统-简介
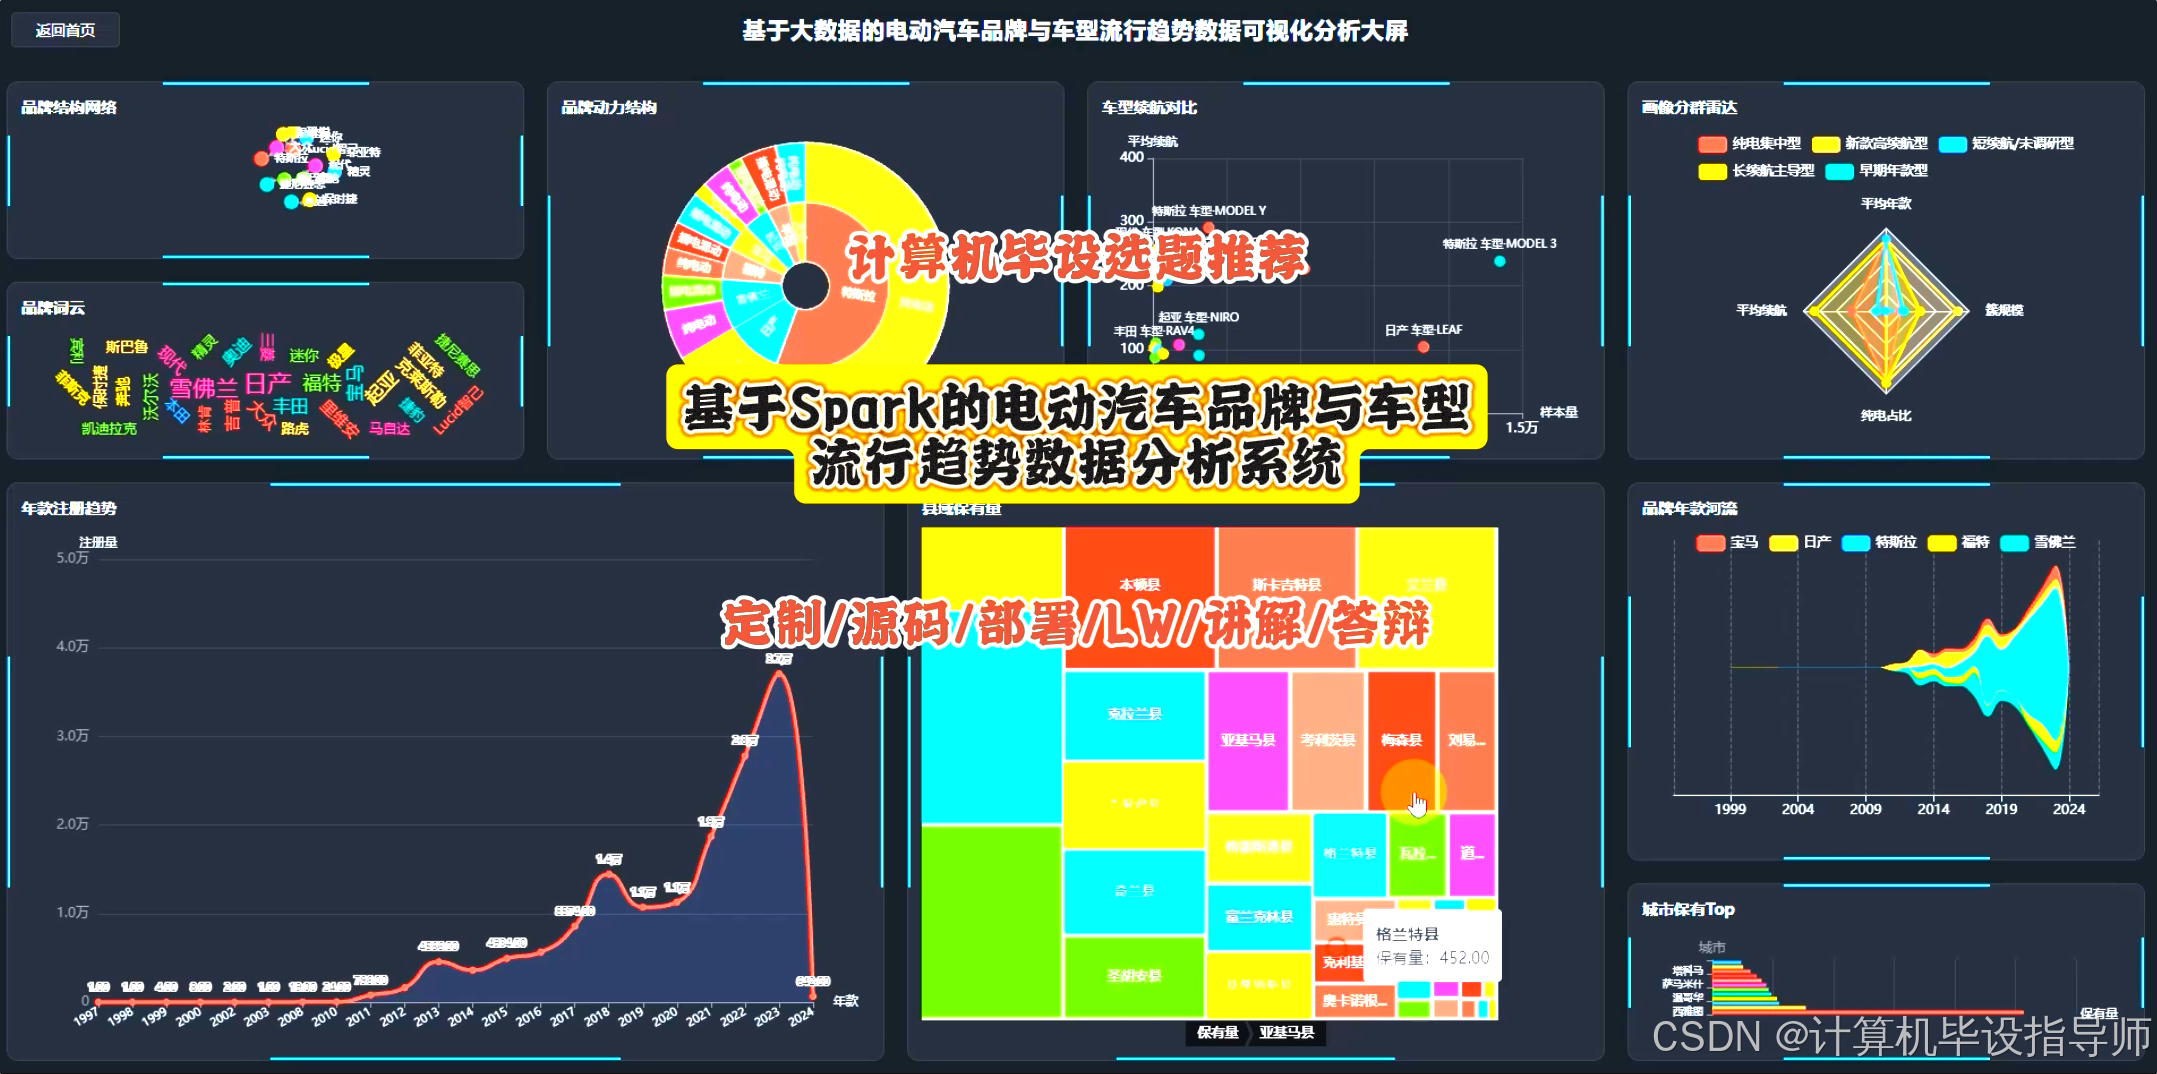
该系统采用Python作为主要开发语言,后端基于Django框架构建,前端集成Vue、ElementUI以及Echarts可视化库。在大数据处理层面,系统引入Hadoop生态与Spark计算框架,通过SparkSession对海量电动汽车注册数据进行高效分布式处理。数据层使用MySQL存储处理后的结构化结果。系统包含十六个核心分析模块,基础分析方面涵盖了按Make统计的品牌保有排名、Make+Model组合的车型保有排名、年款流行走势分析、BEV与PHEV动力类型占比分析、有效续航区间分布统计、县域及城市保有热度分析、CAFV资质资格构成分析以及公用配套分布分析。进阶分析方面,系统实现了品牌动力结构对比与头部品牌年款走势分析,并对主流车型平均有效续航进行对比。在算法应用层面,系统利用K-Means算法对车辆进行无监督画像分群,发掘典型流行画像,结合FP-Growth算法挖掘县域内高频共现品牌组合,发现区域品牌搭配模式,运用Isolation Forest探测有效续航样本中的离群车辆画像,利用Cosine Similarity计算品牌在年款与动力类型上的结构相似度。整个系统从数据读取、分布式计算到最终的可视化展示,形成了一套完整的电动汽车流行趋势分析链路。
电动汽车品牌与车型流行趋势数据分析系统-技术
大数据框架:Hadoop+Spark(本次没用Hive,支持定制)
开发语言:Python+Java(两个版本都支持)
后端框架:Django+Spring Boot(Spring+SpringMVC+Mybatis)(两个版本都支持)
前端:Vue+ElementUI+Echarts+HTML+CSS+JavaScript+jQuery
数据库:MySQL
电动汽车品牌与车型流行趋势数据分析系统-背景
近年来,随着环保意识逐渐增强和政策引导,新能源汽车慢慢走进了大家的日常生活,电动汽车的保有量每年都在往上涨。大家在买车的时候,越来越倾向于考虑电动车型,这就使得各个品牌和车型的市场表现发生了很大的变化。市面上虽然有很多汽车登记数据,但把这些数据好好整理出来,看看哪个品牌更受欢迎、哪种续航里程的车型卖得更好,对了解市场走向挺有用的。对于咱们学计算机的学生来说,面对这么多的车辆登记数据,用大数据技术去理一理这些数据背后的规律,刚好是一个很合适的锻炼机会,也就有了这个基于Spark的电动汽车流行趋势分析系统的想法。
做这个系统的实际意义其实挺朴实的。一方面,它能帮咱们把书本上的大数据理论用到真实的数据集上,像用Spark处理大批量数据、用算法找规律,这些都是实打实的动手锻炼,对提升自己的编程能力很有帮助。另一方面,系统算出来的这些品牌排名、续航分布或者车辆画像分群结果,也能给普通购车者或者车行老板提供一个参考,让他们直观地看到现在市面上哪些车型比较火,不同区域的人喜欢买什么牌子的车。虽然这只是一个毕业设计,算不上多完美的商业级产品,但这种把数据分析结果用图表展示出来的尝试,也算是咱们用所学知识去解释现实生活现象的一点小努力,对顺利完成毕设和巩固专业技能都有好处。
电动汽车品牌与车型流行趋势数据分析系统-视频展示
基于Spark的电动汽车品牌与车型流行趋势数据分析系统源码
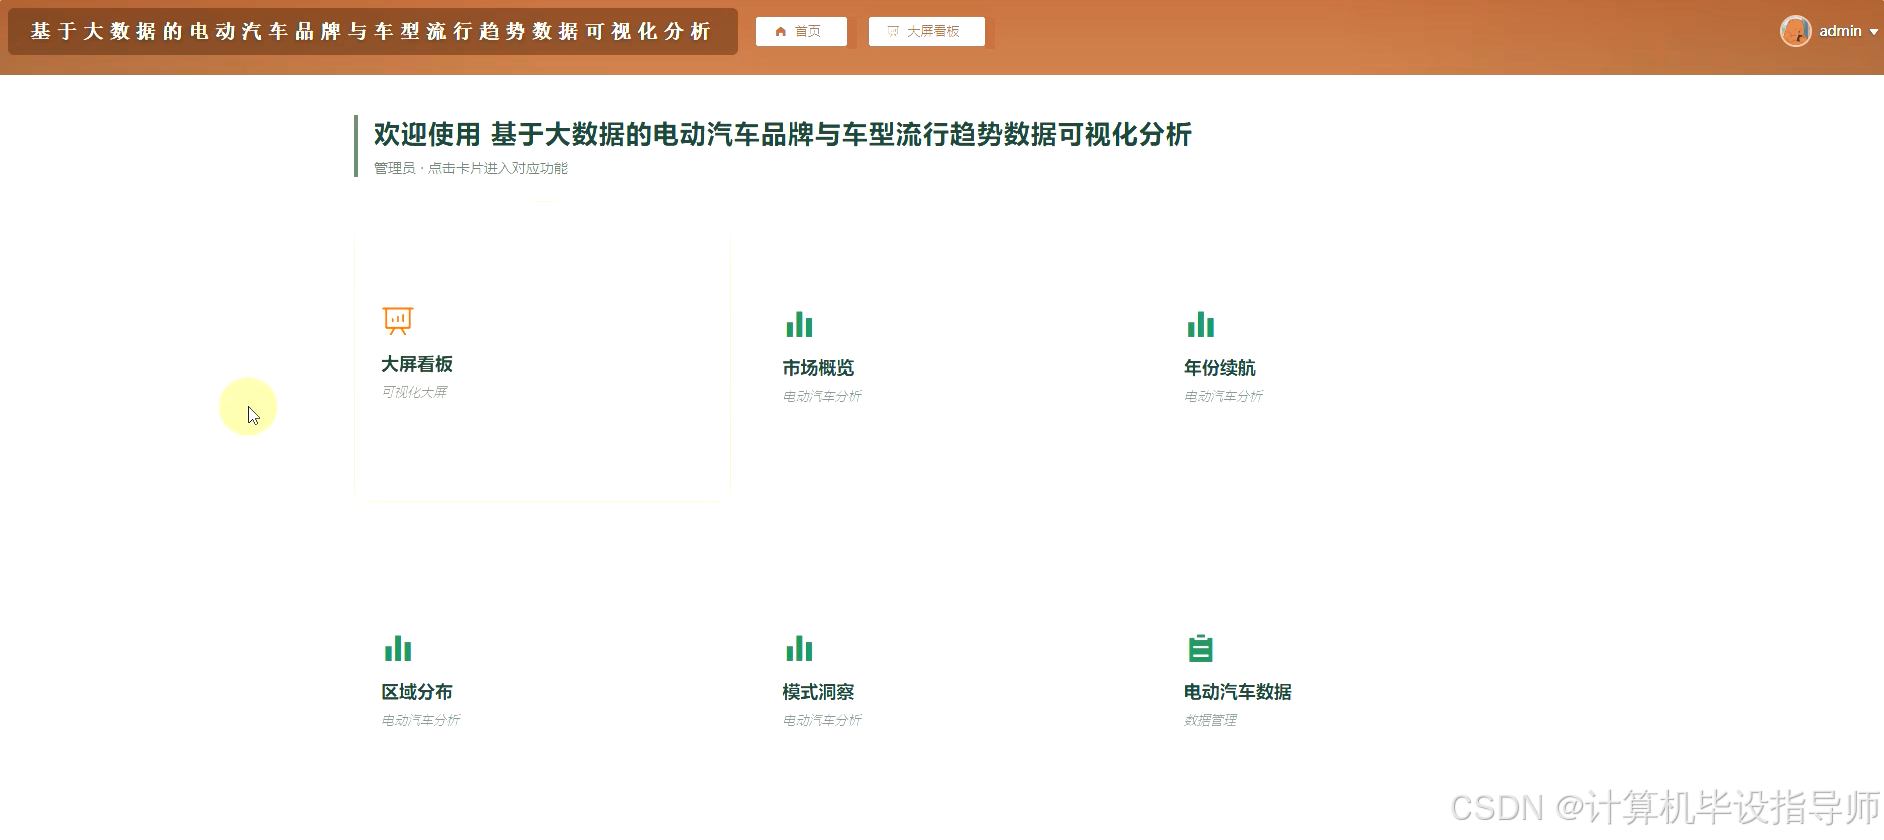
电动汽车品牌与车型流行趋势数据分析系统-图片展示
电动汽车品牌与车型流行趋势数据分析系统-代码展示
from pyspark.sql import SparkSession
from pyspark.ml.clustering import KMeans
from pyspark.ml.feature import VectorAssembler, StandardScaler
from pyspark.ml.fpm import FPGrowth
from pyspark.sql.functions import col, count, desc, collect_set, when, lit, udf, size
from pyspark.sql.types import IntegerType
spark = SparkSession.builder.appName("EvPopularityAnalysis").master("local[*]").getOrCreate()
df = spark.read.csv("hdfs://localhost:9000/data/ev_data.csv", header=True, inferSchema=True)
df_a13 = df.filter(col("Model Year").isNotNull() & col("Electric Range").isNotNull() & col("Electric Vehicle Type").isNotNull())
map_type_udf = udf(lambda t: 1 if t == "BEV" else 0, IntegerType())
df_a13 = df_a13.withColumn("ev_type_code", map_type_udf(col("Electric Vehicle Type")))
df_a13 = df_a13.withColumnRenamed("Model Year", "model_year").withColumnRenamed("Electric Range", "electric_range")
df_a13 = df_a13.withColumn("model_year", col("model_year").cast("int"))
df_a13 = df_a13.withColumn("electric_range", col("electric_range").cast("int"))
vec_assembler = VectorAssembler(inputCols=["model_year", "electric_range", "ev_type_code"], outputCol="raw_features")
vec_df = vec_assembler.transform(df_a13).select("raw_features")
scaler = StandardScaler(inputCol="raw_features", outputCol="scaled_features", withStd=True, withMean=True)
scaler_model = scaler.fit(vec_df)
scaled_df = scaler_model.transform(vec_df)
kmeans = KMeans(k=4, seed=42, featuresCol="scaled_features", predictionCol="cluster_id", maxIter=20)
kmeans_model = kmeans.fit(scaled_df)
clustered_df = kmeans_model.transform(scaled_df)
cluster_summary = clustered_df.groupBy("cluster_id").count().orderBy("cluster_id")
cluster_centers = kmeans_model.clusterCenters()
cluster_summary.coalesce(1).write.mode("overwrite").csv("output/EvPopularityAnalysis_analysis/vehicle_profile_cluster.csv", header=True)
df_a14 = df.filter(col("County").isNotNull() & col("Make").isNotNull())
df_a14 = df_a14.withColumnRenamed("County", "county").withColumnRenamed("Make", "make")
df_a14 = df_a14.withColumn("county", col("county").cast("string"))
df_a14 = df_a14.withColumn("make", col("make").cast("string"))
county_brands = df_a14.groupBy("county").agg(collect_set("make").alias("brand_items"))
county_brands = county_brands.filter(col("brand_items").isNotNull() & (col("brand_items").getItem(0).isNotNull()))
county_brands = county_brands.filter(size(col("brand_items")) >= 2)
fp_growth = FPGrowth(itemsCol="brand_items", minSupport=0.05, minConfidence=0.3, numPartitions=10)
fp_model = fp_growth.fit(county_brands)
freq_itemsets = fp_model.freqItemsets.filter(col("freq") >= 10)
freq_itemsets.coalesce(1).write.mode("overwrite").csv("output/EvPopularityAnalysis_analysis/county_brand_fpgrowth_freq.csv", header=True)
assoc_rules = fp_model.associationRules.select("antecedent", "consequent", "confidence", "lift")
assoc_rules = assoc_rules.filter(col("lift") > 1.0)
assoc_rules.coalesce(1).write.mode("overwrite").csv("output/EvPopularityAnalysis_analysis/county_brand_fpgrowth.csv", header=True)
df_a09 = df.filter(col("Make").isNotNull() & col("Electric Vehicle Type").isNotNull())
df_a09 = df_a09.withColumnRenamed("Make", "make").withColumnRenamed("Electric Vehicle Type", "ev_type")
df_a09 = df_a09.withColumn("make", col("make").cast("string"))
df_a09 = df_a09.withColumn("ev_type", col("ev_type").cast("string"))
df_a09 = df_a09.dropDuplicates(["make", "ev_type", "Model Year"])
brand_counts = df_a09.groupBy("make").count().withColumnRenamed("count", "total_count")
top_brands = brand_counts.orderBy(desc("total_count")).limit(15)
top_brands_list = [row.make for row in top_brands.collect()]
df_top_brands = df_a09.filter(col("make").isin(top_brands_list))
df_top_brands = df_top_brands.na.drop()
total_by_brand = df_top_brands.groupBy("make").count().withColumnRenamed("count", "brand_total")
df_top_brands.createOrReplaceTempView("top_brand_ev_data")
structure_df = spark.sql("SELECT make, ev_type, COUNT(*) as count FROM top_brand_ev_data GROUP BY make, ev_type ORDER BY make, ev_type")
structure_pandas = structure_df.toPandas()
structure_pandas.to_csv("output/EvPopularityAnalysis_analysis/brand_evtype_structure.csv", index=False)
spark.stop()
电动汽车品牌与车型流行趋势数据分析系统-结语
做计算机毕设卡壳了不知道从哪下手?别慌,这套系统的思路和实现过程我都在文章里掰开了讲,希望能帮你理清方向,如果内容对你有帮助,别忘了点赞、收藏、关注支持一下,你的鼓励就是我持续输出的动力。有具体的技术问题,欢迎直接在评论区提出来,看到都会回复。架构怎么搭、数据怎么跑、模块怎么调,咱们公开讨论,一起把计算机毕设顺利搞定!
实战项目:有源码或者技术上的问题欢迎在评论区一起讨论交流!
如果遇到具体的技术问题或其他需求,你也可以问我,我会尽力帮你分析和解决问题所在,支持我记得点赞、收藏,再点个关注,学习不迷路!~~
转载自 CSDN-专业IT技术社区
原文链接:https://blog.csdn.net/2301_80395604/article/details/166993021

