

页面看起来一点没变,导出的中文却消失了。2026 年 9 月 30 日这轮 PDF 核验里,我测了两份相同内容的通知来复现这种情况:一份保留字符映射,一份删掉正文所用字体的 ToUnicode。两份测试文件都由同一段已知原文生成。拿这个样本排查的好处,是能够确认变化来自哪一步,不需要靠文件外观猜测原因。
我的第一个动作是把正常版和缺映射版交给同一个引擎渲染。使用 MuPDF 1.26.10、1.5 倍比例和相同颜色设置,两份页面都得到 893×1263 像素。对整张 RGB 图像计算的原始像素摘要也完全相同。这个结果比“肉眼差不多”明确。不过它只能回答当前渲染条件下的外观问题。接下来需要检查的是同一页经过文字提取之后所保存的实际字符内容。预览比对通过并没有顺带证明提取、搜索和复制环节得到的词语都忠于原文。
我把两份文件分别交给 PyMuPDF 1.26.5 提取文字。这份 5 行通知正常有 56 个汉字。缺映射版未能从相同位置恢复出任何一个与原文对应的汉字。两个结果的总长度还都是 152 个字符。这个几乎没有长度变化的结果很容易让只有总字数检查的验收误判。丢失的中文位置变成了其他字符或控制码。日期数字和英文仍在原来的行附近出现并保持人能够阅读的形式。仅检查输出非空和长度正常会让坏结果轻易混过去。
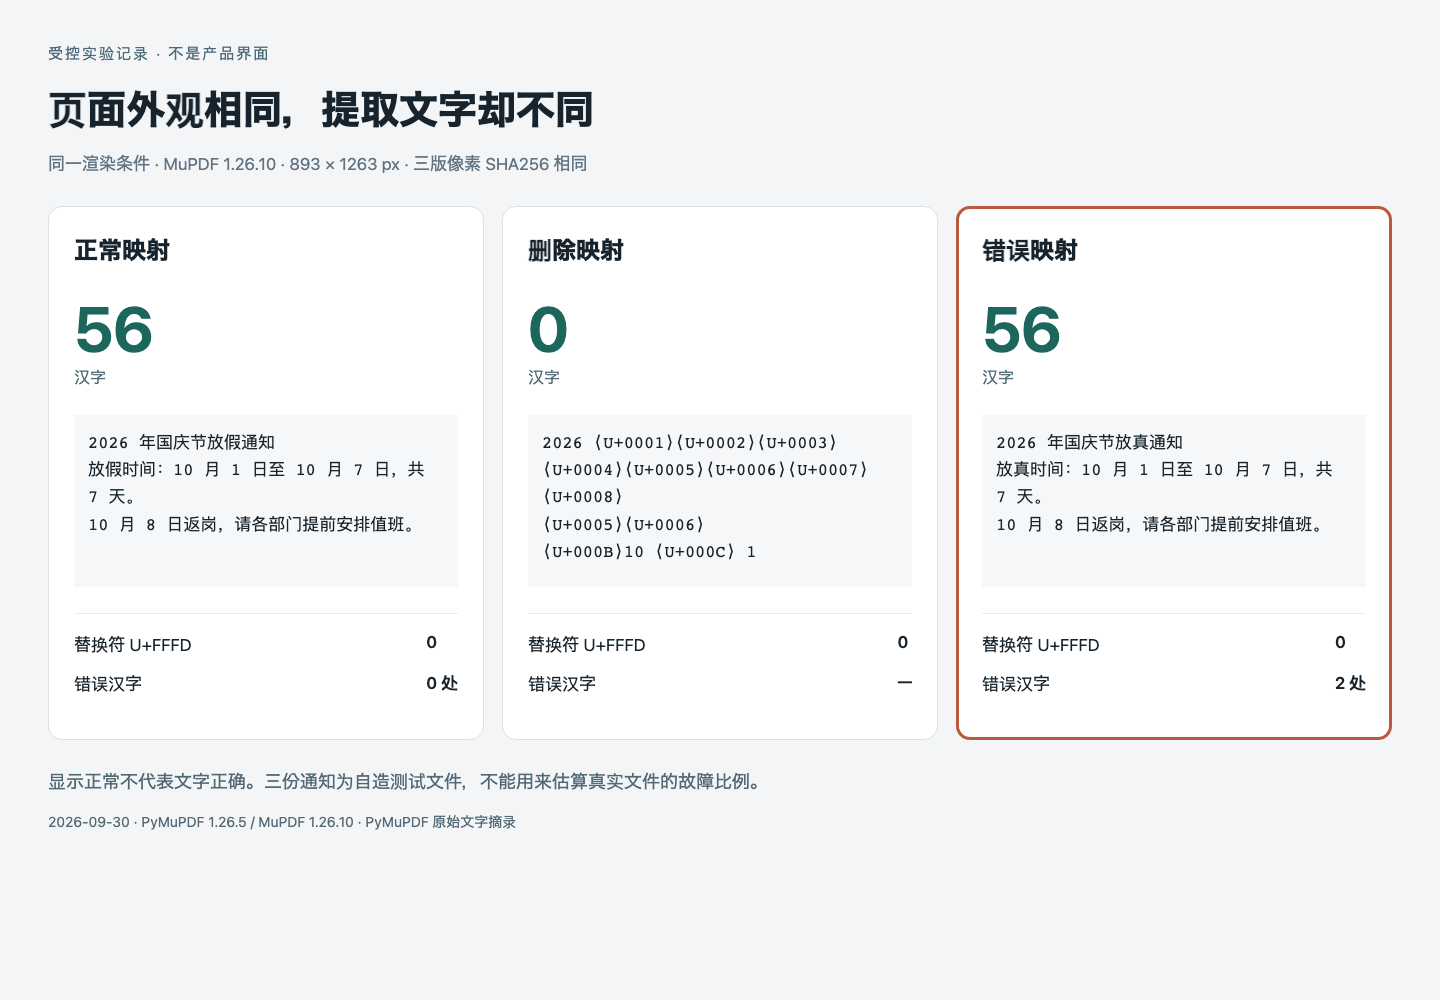
这张图来自独立实验报告,不能当成产品界面。先看正常版和删除映射版的汉字数量,再看最右边仍有 56 个汉字的错误映射版。第三份只把“假”的映射目标改为“真”就让标题和正文出现 2 处错字。把第三份文件放回同一渲染条件下比较以后也得到了与正常版一致的页面像素。可见有汉字、能读通与忠于原文之间也存在差别。
随后我用图映 ImgIng的 PDF 内容提取处理正常与缺映射通知。正常内容可读。缺映射版在识别图片内文字开关打开和关闭时得到相同文本,中文问题没有改善。这里记录的最终结果不足以推断按钮背后的内部执行流程。PDF 引擎不是我参与实现的模块。这次独立核验只观察相同输入经过公开界面以后返回的文本是否符合已知原文。
实际拿到一份“能看不能复制”的文件,我会先固定同一页同一段。看原页上写的是什么,再看提取或粘贴到纯文本工具里的内容。若页面本身就缺字,先调查渲染;若页面清楚而文字不对,继续调查提取所需的映射信息。样本中的日期数字在失去中文映射后仍正常存在于输出里。抽查不能只挑数字。标题和一段连贯中文更容易暴露这个故障范围。
接着区分显示问题和内容问题。纯文本里看见方块未必足以归因。还需要确认底层字符究竟是什么;直接出现“放真通知”则已经是合法但错误的文字。换编辑器可能改变显示方式,却不能让我们跳过原文核对。本文没有测试所有阅读器,也没有做一次完整的剪贴板兼容性比较,所以不会根据这些文件给工具排优劣。
这种做法也适合补充已有验收。预览截图保留一个结果,文本样段另留一个结果,两项都写明页号与所用文件版本。出现异常时能够直接看出哪条路径需要继续检查。反过来,只有一张正常截图无法回答“复制出来为什么不对”。截图承担的展示证据不能代替针对原页中文标题与正文样段的字符内容证据。
目前还没找到能脱离可信原文就自动判定任意 PDF 中所有合法错字的通用方法。三个独立提取器在错映射文件上都输出“放真”,在没有原文核对的前提下选择多数提取器的相同答案仍然没有解决这个问题。下一次复验时,我会先检查原页标题与输出标题是否逐字对应,再检查日期关联的中文说明。固定这两个对象以后才能评估换工具或走图片识别有没有真的改善。
转载自 CSDN-专业IT技术社区

