

💖💖作者:计算机毕业设计杰瑞
💙💙个人简介:曾长期从事计算机专业培训教学,本人也热爱上课教学,语言擅长Java、微信小程序、Python、Golang、安卓Android等,开发项目包括大数据、深度学习、网站、小程序、安卓、算法。平常会做一些项目定制化开发、代码讲解、答辩教学、文档编写、也懂一些降重方面的技巧。平常喜欢分享一些自己开发中遇到的问题的解决办法,也喜欢交流技术,大家有技术代码这一块的问题可以问我!
💛💛想说的话:感谢大家的关注与支持!
💜💜
网站实战项目
安卓/小程序实战项目
大数据实战项目
深度学校实战项目
计算机毕业设计选题推荐
目录
基于大数据的二手房成交信息分析与可视化介绍
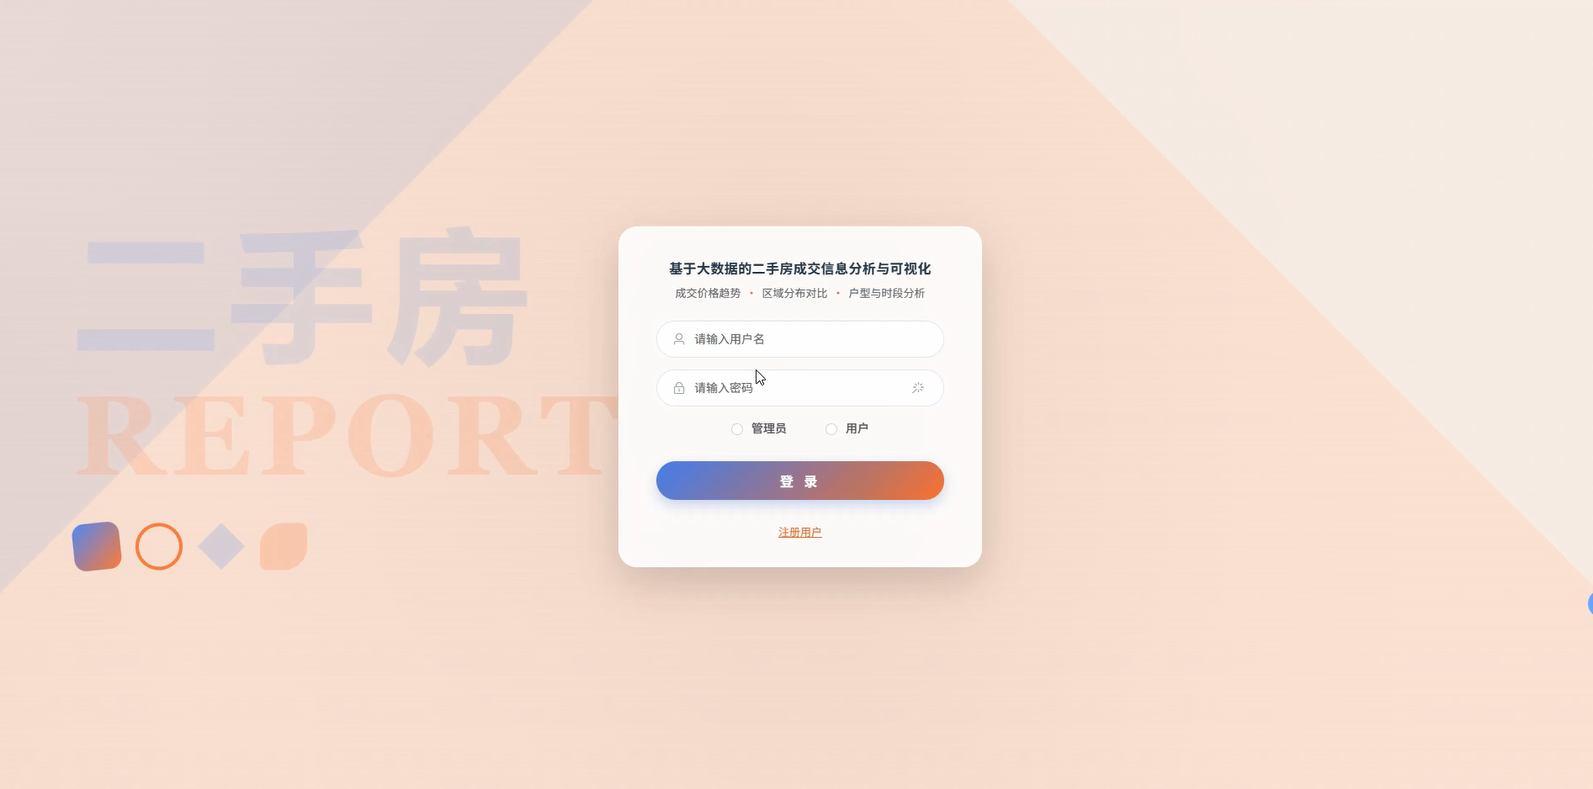
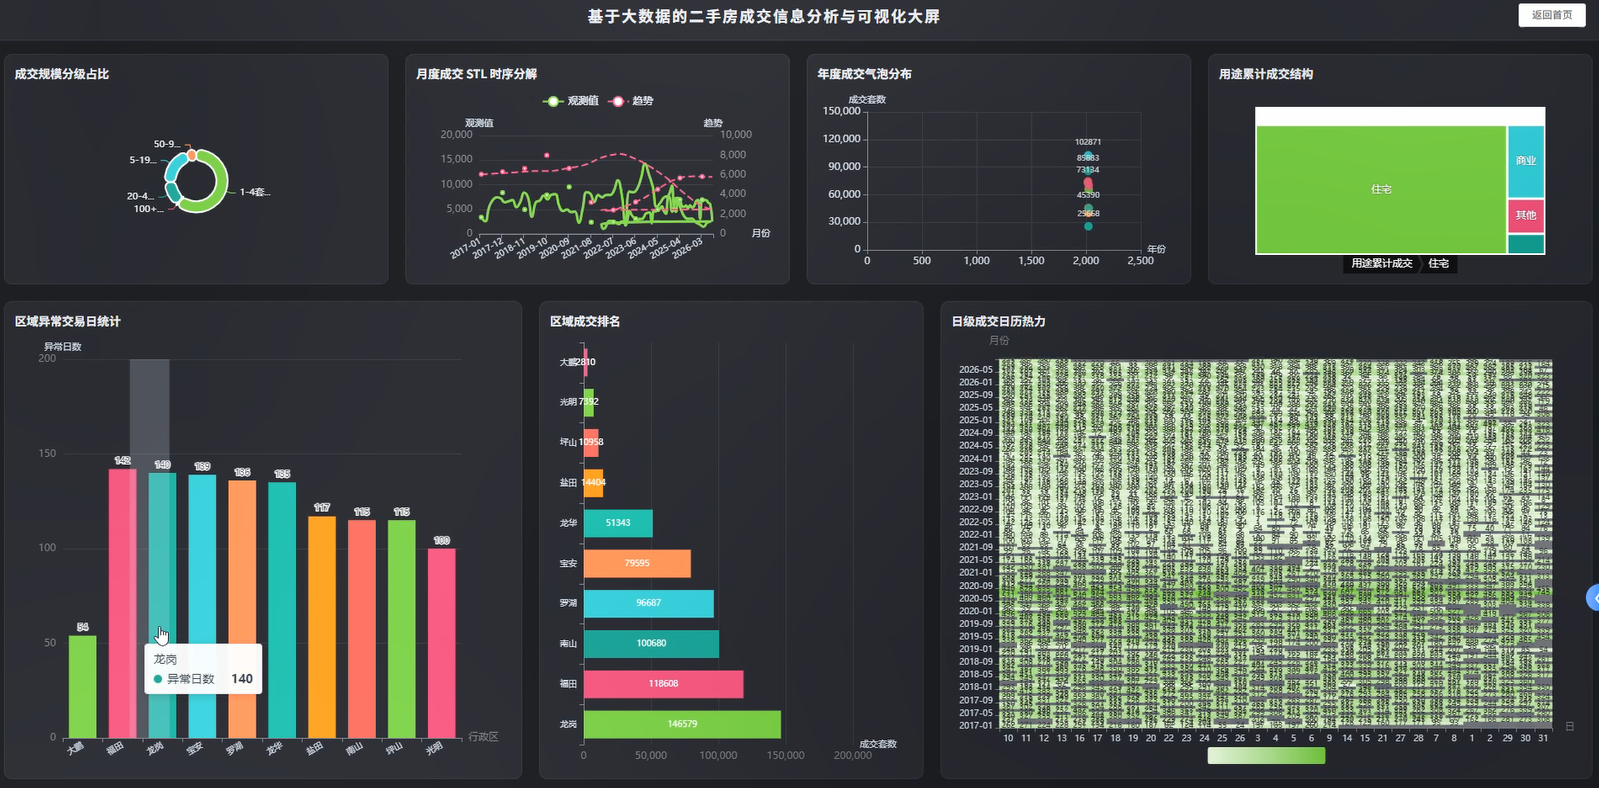
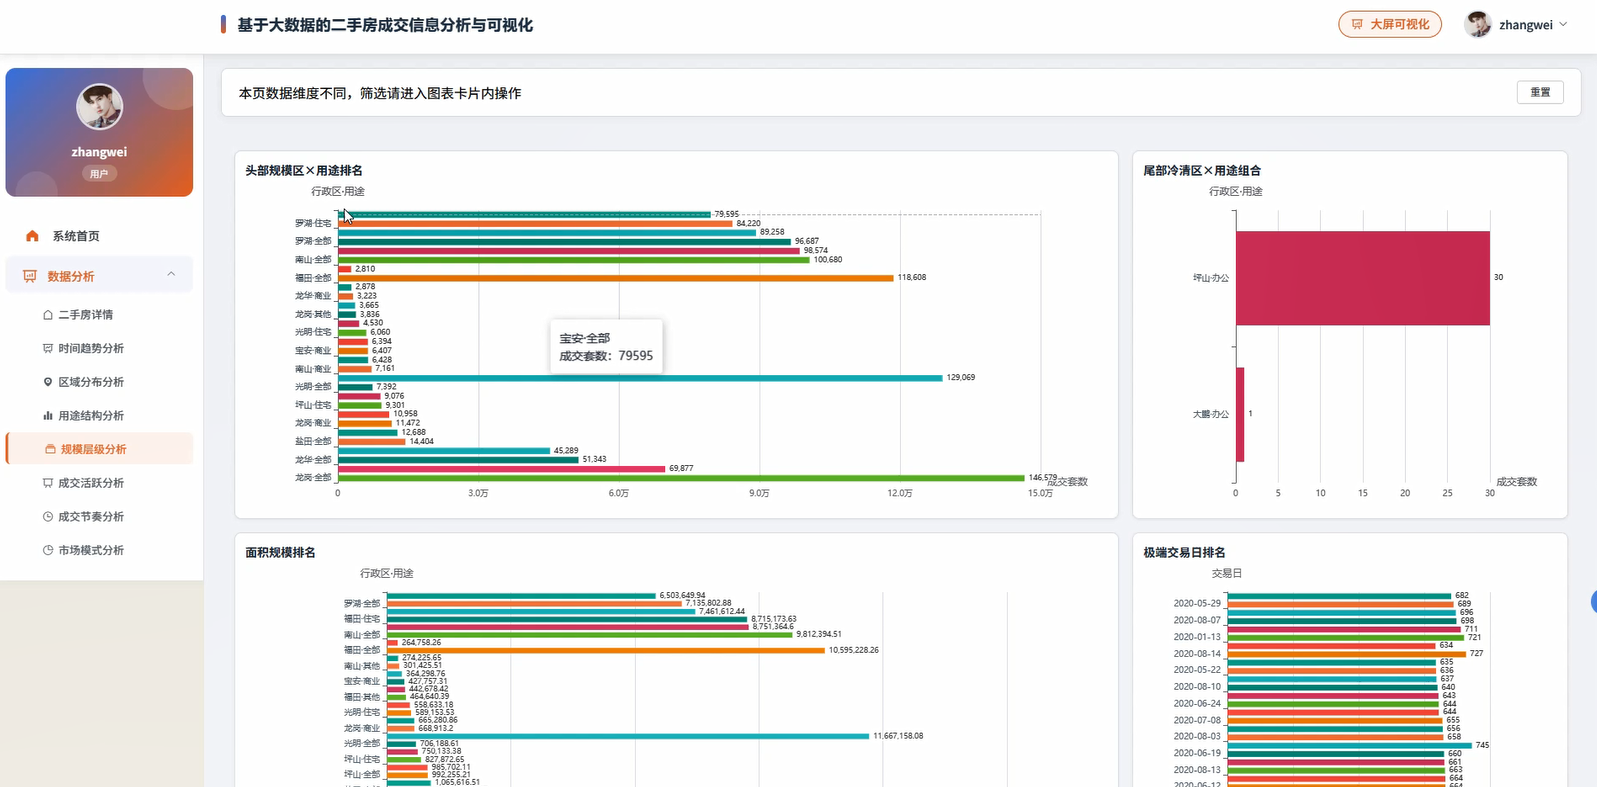
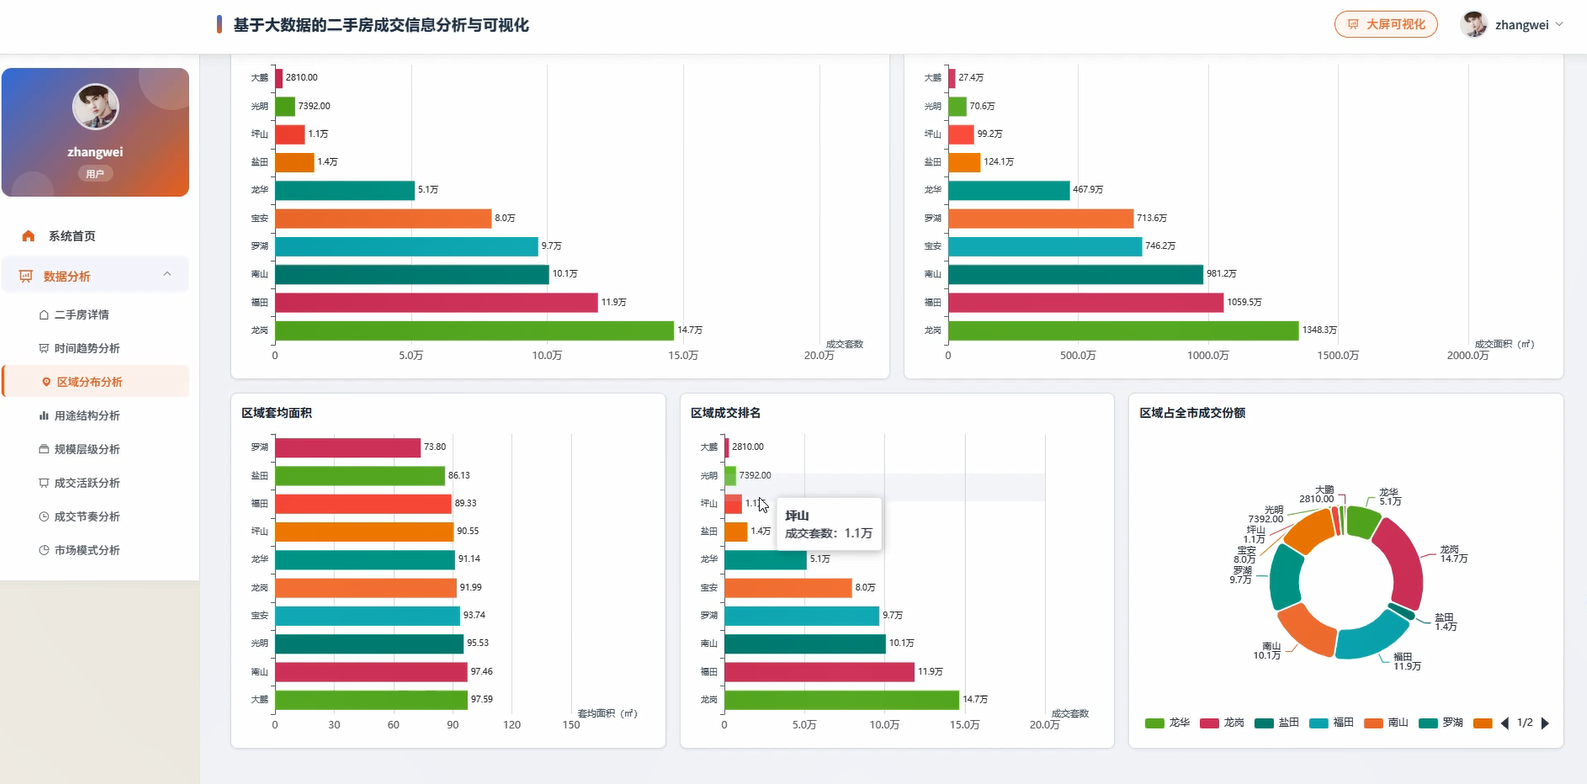
本系统名为《基于大数据的二手房成交信息分析与可视化》,面向二手房交易场景下的成交数据展开分析与展示。系统以Hadoop与HDFS作为底层数据存储支撑,借助Spark与Spark SQL完成成交数据的清洗、聚合与统计计算,并结合Pandas、NumPy对分析结果做进一步处理。后端提供Python与Java两个版本,分别基于Django与Spring Boot实现,数据统一存储于MySQL。前端采用Vue、ElementUI、Echarts与HTML、CSS、JavaScript、jQuery构建页面与图表展示。功能层面涵盖二手房详情、时间趋势分析、区域分布分析、用途结构分析、规模层级分析、成交活跃分析、成交节奏分析以及市场模式分析等模块,能够从时间、空间、用途、规模等多个维度呈现二手房成交信息,帮助使用者较为直观地了解市场成交状况与变化特征。
基于大数据的二手房成交信息分析与可视化演示视频
基于大数据的二手房成交信息分析与可视化演示图片
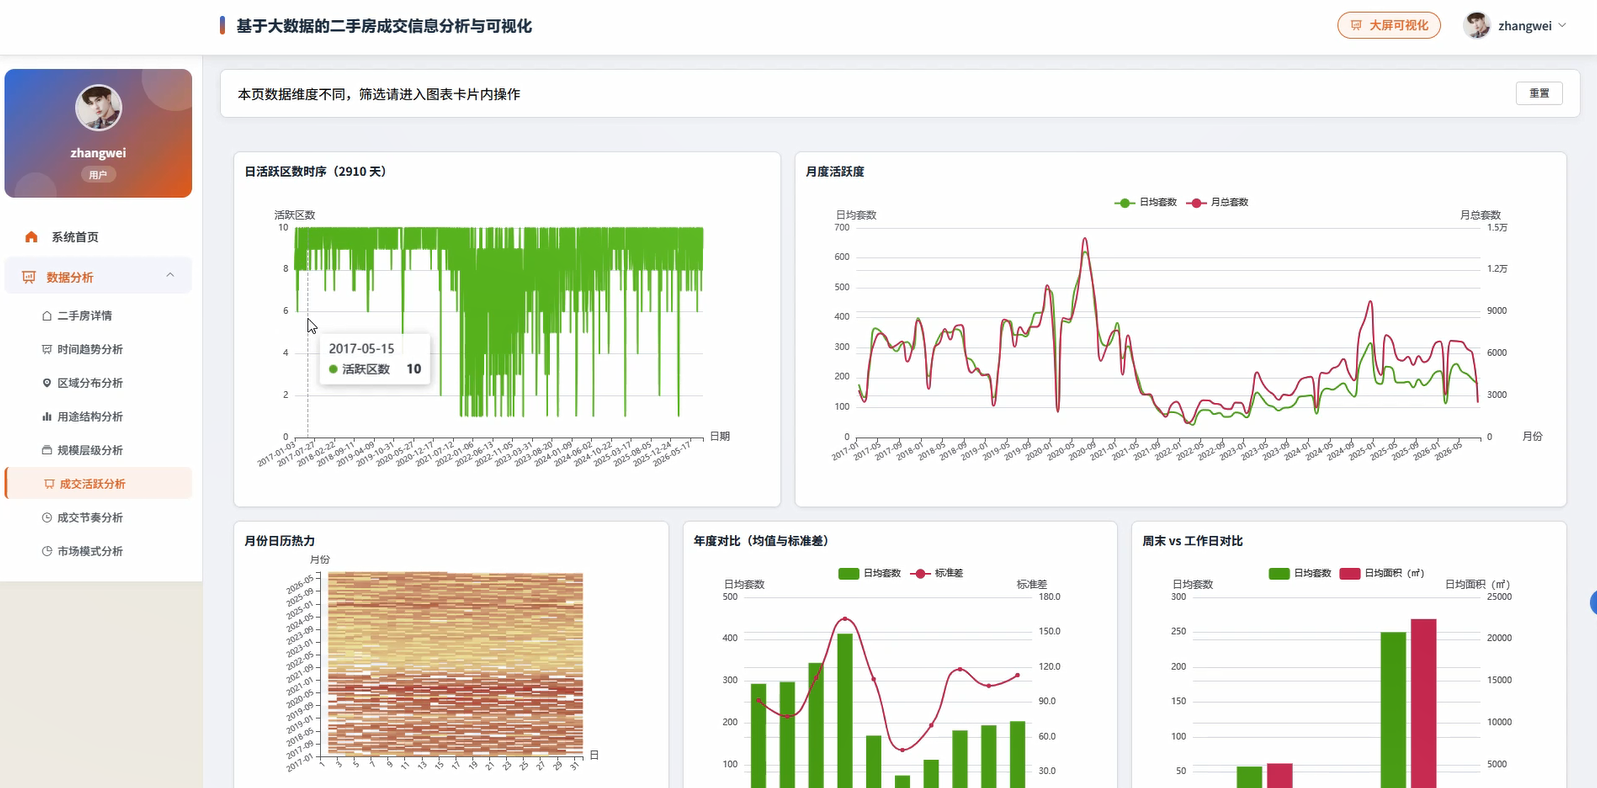
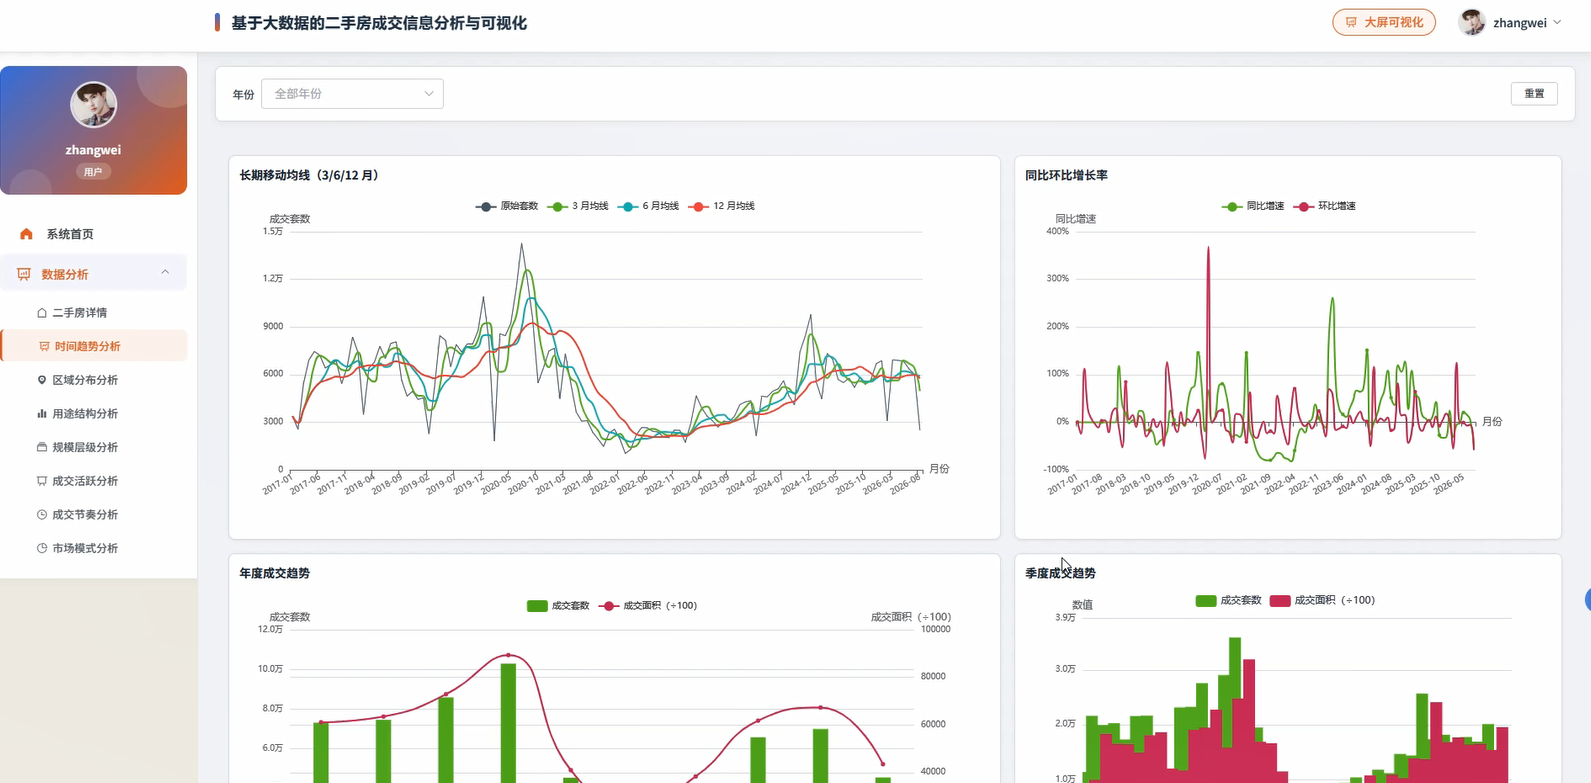
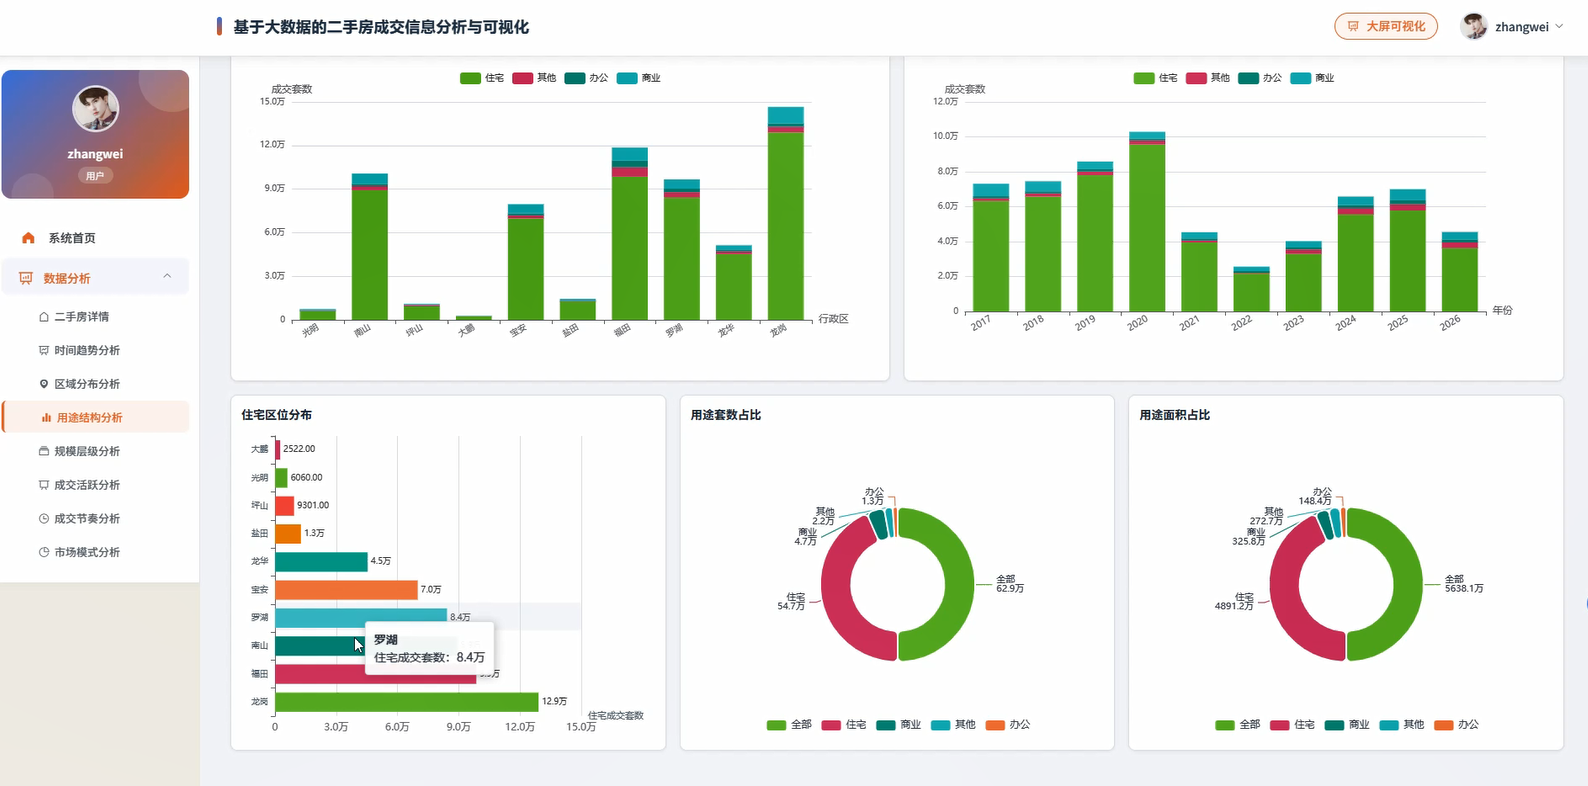
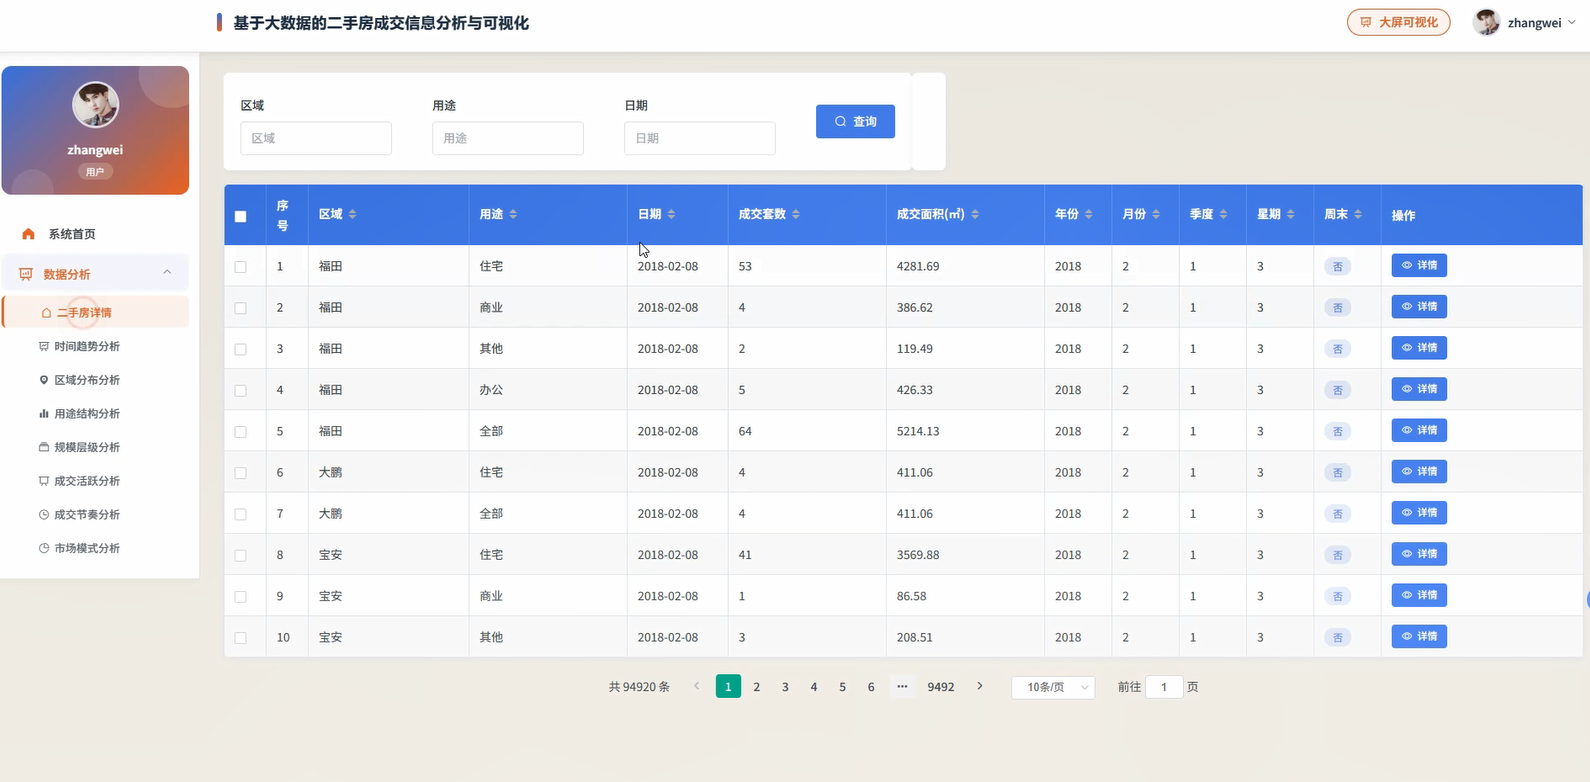
基于大数据的二手房成交信息分析与可视化代码展示
from pyspark.sql import SparkSession
from pyspark.sql.functions import col, count, avg, sum, date_format, when, desc
import pandas as pd
import numpy as np

spark = SparkSession.builder.appName("SecondHandHouseAnalysis").config("spark.sql.warehouse.dir", "/user/hive/warehouse").enableHiveSupport().getOrCreate()
house_df = spark.read.format("csv").option("header", "true").option("inferSchema", "true").load("hdfs://localhost:9000/second_hand_house/deal_info.csv")
house_df.createOrReplaceTempView("house_deal")
def time_trend_analysis():
    trend_df = spark.sql("SELECT date_format(deal_time, 'yyyy-MM') AS deal_month, COUNT(*) AS deal_count, AVG(deal_price) AS avg_price FROM house_deal GROUP BY date_format(deal_time, 'yyyy-MM') ORDER BY deal_month")
    trend_pd = trend_df.toPandas()
    trend_pd["deal_month"] = pd.to_datetime(trend_pd["deal_month"])
    trend_pd = trend_pd.sort_values("deal_month")
    trend_pd["avg_price"] = trend_pd["avg_price"].round(2)
    trend_pd["deal_count"] = trend_pd["deal_count"].astype(int)
    result = trend_pd.to_dict(orient="records")
    return result
def region_distribution_analysis():
    region_df = spark.sql("SELECT region_name, COUNT(*) AS deal_count, SUM(deal_amount) AS total_amount, AVG(unit_price) AS avg_unit_price FROM house_deal GROUP BY region_name ORDER BY deal_count DESC")
    region_pd = region_df.toPandas()
    region_pd["total_amount"] = region_pd["total_amount"].round(2)
    region_pd["avg_unit_price"] = region_pd["avg_unit_price"].round(2)
    region_pd["deal_ratio"] = (region_pd["deal_count"] / region_pd["deal_count"].sum()).round(4)
    region_pd = region_pd.sort_values("deal_ratio", ascending=False)
    result = region_pd.to_dict(orient="records")
    return result
def deal_activity_analysis():
    activity_df = spark.sql("SELECT region_name, COUNT(*) AS deal_count, COUNT(DISTINCT date_format(deal_time, 'yyyy-MM-dd')) AS active_days, COUNT(*) / COUNT(DISTINCT date_format(deal_time, 'yyyy-MM-dd')) AS avg_daily_deal FROM house_deal GROUP BY region_name")
    activity_pd = activity_df.toPandas()
    activity_pd["avg_daily_deal"] = activity_pd["avg_daily_deal"].round(2)
    activity_pd["active_level"] = np.where(activity_pd["avg_daily_deal"] >= activity_pd["avg_daily_deal"].mean(), "活跃", "一般")
    activity_pd = activity_pd.sort_values("avg_daily_deal", ascending=False)
    result = activity_pd.to_dict(orient="records")
    return result
基于大数据的二手房成交信息分析与可视化文档展示
💖💖作者:计算机毕业设计杰瑞
💙💙个人简介:曾长期从事计算机专业培训教学,本人也热爱上课教学,语言擅长Java、微信小程序、Python、Golang、安卓Android等,开发项目包括大数据、深度学习、网站、小程序、安卓、算法。平常会做一些项目定制化开发、代码讲解、答辩教学、文档编写、也懂一些降重方面的技巧。平常喜欢分享一些自己开发中遇到的问题的解决办法,也喜欢交流技术,大家有技术代码这一块的问题可以问我!
💛💛想说的话:感谢大家的关注与支持!
💜💜
网站实战项目
安卓/小程序实战项目
大数据实战项目
深度学校实战项目
计算机毕业设计选题推荐
转载自 CSDN-专业IT技术社区
原文链接:https://blog.csdn.net/2501_92994129/article/details/165006931

