

👋 欢迎阅读
🔥 愿旖旎 · 个人主页
📘 学习专栏: 《算法专栏》《LangChain学习》《贪心算法》
🌄 钱塘江上潮信来,今日方知我是我
✨当前学习内容:《LangGraph》
📑 目录
一、前置讲解
在进入正文前,先花 10 秒了解本篇会反复用到的核心概念,带着印象去读正文,学习效率更高。
🧠 前置知识一:Reducer 与 Overwrite
Reducer 决定状态怎么合并(追加还是覆盖),而 Overwrite 能强制绕过它,直接整体替换。
🧩 前置知识二:input_schema 与 output_schema
让图只收该收的输入、只吐该吐的输出,内部状态可以比对外接口更复杂。
🔒 前置知识三:私有状态(Private State)
用类型注解给节点开一条私有数据通道:节点之间能传,但不出现在最终输出里。
🔀 前置知识四:扇出与扇入(Fan-out / Fan-in)
START 同时指向多个节点就是扇出(并行),多个节点汇合到一个节点就是扇入。
📮 前置知识五:Send(动态派发任务)
在条件边里返回 Send("节点名", 状态),让并行分支的数量在运行时才决定。
二、LangGraph 的三个进阶特性
前面两篇我们用 State、Nodes、Edges、Reducer 搭出了搜索 Agent 和代理式 RAG。这一篇先补三个"进阶开关",它们直接决定了状态怎么被改写、图的对外接口长什么样、数据谁可见。
2.1 使用 Overwrite 绕过 reducer
在 LangGraph 中,reducers 用于控制状态更新的处理方式。默认情况下,每个状态键都有独立的 reducer 函数,决定如何合并节点返回的更新。但有时候我们需要完全覆盖状态值而不是合并,这时就要用 Overwrite。
最典型的场景是聊天应用:
| 情况 | 期望行为 | 靠什么实现 |
|---|---|---|
| 正常对话 | 新消息追加到消息列表 | 默认的 operator.add reducer |
| 清空聊天记录重新开始 | 直接覆盖整个消息列表 | Overwrite 强制绕过 reducer |
代码示例:
from langgraph.graph import StateGraph, START, END
from langgraph.types import Overwrite
from typing_extensions import Annotated, TypedDict
import operator
# ---------- 1. 定义状态(State)----------
# State 是图中流转的"共享数据",用 TypedDict 声明字段结构
class State(TypedDict):
# Annotated[list, operator.add] 中的 operator.add 是【reducer(归约函数)】
# 作用:节点返回的新值会与旧值"相加/追加",而不是直接覆盖
messages: Annotated[list, operator.add]
# ---------- 2. 定义节点函数(每个节点就是一个普通函数)----------
def add_message(state: State):
"""节点1:往 messages 追加一条消息(走 reducer,会追加)"""
return {"messages": ["first message"]}
def replace_messages(state: State):
"""节点2:用 Overwrite 绕过 reducer,直接【替换】整个列表"""
# Overwrite(...):强制绕过 reducer,不做追加,而是整体替换
return {"messages": Overwrite(["replacement message"])}
# ---------- 3. 构建图(Graph)----------
builder = StateGraph(State) # 创建状态图构建器(绑定 State)
# add_node:添加【节点】(名称, 函数)—— 节点 = 图中执行的一步
builder.add_node("add_message", add_message)
builder.add_node("replace_messages", replace_messages)
# add_edge:添加【边】—— 定义节点的执行顺序(从一个节点走到另一个)
builder.add_edge(START, "add_message") # 入口:START → add_message
builder.add_edge("add_message", "replace_messages") # add_message → replace_messages
builder.add_edge("replace_messages", END) # 出口:replace_messages → END
# compile:编译图,生成可执行的对象
graph = builder.compile()
# ---------- 4. 执行图 ----------
# invoke:传入初始状态,运行整张图
result = graph.invoke({"messages": ["initial"]})
print(result["messages"])运行结果:
💡 对照看这两个结果就很清楚了:不加
Overwrite时,replace_messages返回的列表被 reducer 当成"要追加的内容",所以三条消息全在;加上Overwrite后,整个列表被整体替换,连最初的initial也一起没了。
使用 Overwrite 的应用场景:
| 场景 | 说明 |
|---|---|
| 重置对话 | 清空聊天历史,开始新对话 |
| 状态重置 | 在错误恢复后重置应用状态 |
| 数据清理 | 替换损坏或过时的数据 |
2.2 定义输入输出模式
默认情况下,LangGraph 使用单一的状态模式。但我们可以定义独立的输入和输出模式:
| 模式 | 作用 |
|---|---|
| 独立的输入模式 | 验证输入数据的结构 |
| 独立的输出模式 | 过滤输出数据,只返回需要的信息 |
| 内部模式 | 节点间通信使用的完整状态 |
为什么需要独立的内部模式? 考虑一个问答系统:
| 环节 | 内容 |
|---|---|
| 输入 | 用户的问题(字符串) |
| 输出 | AI 的答案(字符串) |
| 内部 | 可能需要存储中间结果、上下文等信息 |
对应到 StateGraph 的三个参数:
| 参数名 | 类型 | 描述 |
|---|---|---|
input_schema | type[InputT] 或 None | 定义 StateGraph 输入的 State 类 |
output_schema | type[OutputT] 或 None | 定义 StateGraph 输出的 State 类 |
state_schema | type[StateT] | 定义 StateGraph 内部的 State 类(第一个位置参数) |
代码示例:
from langgraph.graph import StateGraph, START, END
from typing_extensions import TypedDict
# ---------- 1. 定义输入模式(只包含用户问题)----------
# input_schema:调用 invoke 时传入的状态,只允许有 question 字段
class InputState(TypedDict):
question: str
# ---------- 2. 定义输出模式(只包含 AI 答案)----------
# output_schema:图跑完后返回的状态,只保留 answer 字段
class OutputState(TypedDict):
answer: str
# ---------- 3. 定义完整状态模式(图内部实际使用)----------
# OverallState 同时继承 InputState 和 OutputState → 内部既有 question 又有 answer
class OverallState(InputState, OutputState):
pass
# ---------- 4. 定义节点函数 ----------
def answer_node(state: InputState):
"""处理输入并生成答案"""
# 这里可以访问 question,生成 answer
# 返回两个字段:answer(新生成)+ question(原样带回,供内部流转)
return {
"answer": f"Answer to: {state['question']}",
"question": state["question"],
}
# ---------- 5. 构建图时指定输入 / 输出模式 ----------
builder = StateGraph(
OverallState,
input_schema=InputState, # 输入验证:只接受 question
output_schema=OutputState, # 输出过滤:只返回 answer
)
# add_node:添加节点;add_edge:添加边(定义执行顺序)
builder.add_node("answer_node", answer_node)
builder.add_edge(START, "answer_node") # 入口 → answer_node
builder.add_edge("answer_node", END) # answer_node → 出口
# compile:编译图
graph = builder.compile()
# ---------- 6. 测试 ----------
result = graph.invoke({"question": "What is LangGraph?"})
print(result)运行结果:
{'answer': 'Answer to: What is LangGraph?'}
💡 节点内部明明返回了
question和answer两个字段,但print(result)里只有answer——这就是output_schema在过滤输出。同时input_schema还顺手做了输入校验:如果 invoke 时传了一个InputState里没有的键,会直接报错,而不是悄悄带进流程里。
独立的输入和输出模式,实际应用场景:
| 场景 | 说明 |
|---|---|
| API 开发 | 定义清晰的请求/响应格式 |
| 微服务 | 服务间明确的数据契约 |
| 数据管道 | 明确的输入输出规范 |
2.3 在节点间传递私有状态
有时候节点之间需要传递临时数据:这些数据对中间逻辑很重要,但不该出现在最终输出里,只在特定节点间共享——这就是私有状态。
举个例子,要根据数据库里的信息生成数据报告,可以设置三个节点:
| 节点 | 职责 | 能看到什么 |
|---|---|---|
| 节点 1 | 从数据库获取原始数据(含敏感信息) | 完整原始数据 |
| 节点 2 | 处理数据,过滤掉敏感信息 | 完整原始数据(要处理它) |
| 节点 3 | 生成最终报告 | 只有清理后的结果 |
也就是说:节点 1 和节点 2 需要共享原始数据,但节点 3 不应该看到敏感信息。
代码示例:
from langgraph.graph import StateGraph, START, END
from typing_extensions import TypedDict
# ---------- 1. 定义公共状态(最终输出中可见)----------
class OverallState(TypedDict):
final_result: str
# ---------- 2. 定义节点1的私有输出(不进入最终状态)----------
class Node1Output(TypedDict):
sensitive_data: str # 这个字段不会出现在最终状态中
# ---------- 3. 定义节点2需要的输入(包含私有数据)----------
class Node2Input(TypedDict):
sensitive_data: str
# ---------- 4. 定义三个节点函数 ----------
# 每个节点用【类型注解】声明自己"需要什么输入"和"产出什么输出"
def node_1(state: OverallState) -> Node1Output:
"""第一步:获取包含敏感信息的原始数据"""
private_data = "这是敏感信息"
print("Node1: 获取到敏感数据,但不会暴露给最终输出")
return {"sensitive_data": private_data}
def node_2(state: Node2Input) -> OverallState:
"""第二步:处理数据,移除敏感信息"""
print(f"Node2: 处理敏感数据: {state['sensitive_data']}")
# 处理数据,返回清理后的结果(只返回公共状态字段)
return {"final_result": "清理后的处理结果"}
def node_3(state: OverallState) -> OverallState:
"""第三步:只看到清理后的数据"""
print(f"Node3: 只能看到最终结果: {state['final_result']}")
return {"final_result": state["final_result"] + " - 完成"}
# ---------- 5. 构建图 ----------
builder = StateGraph(OverallState)
# add_sequence:支持一次添加一系列节点,按所给顺序依次执行
# 注意:这里使用 add_sequence,但类型系统会处理私有状态
builder.add_sequence([node_1, node_2, node_3])
# add_edge:添加入口边(START → node_1)
builder.add_edge(START, "node_1")
# compile:编译图
graph = builder.compile()
# ---------- 6. 测试 ----------
response = graph.invoke({"final_result": "initial"})
print(f"\n最终输出: {response}")运行结果:
Node1: 获取到敏感数据,但不会暴露给最终输出
Node2: 处理敏感数据: 这是敏感信息
Node3: 只能看到最终结果: 清理后的处理结果
最终输出: {'final_result': '清理后的处理结果 - 完成'}
💡 注意
add_sequence([node_1, node_2, node_3])只是把三个节点的执行顺序串起来(内部自动补节点间的边),入口边仍要自己加:builder.add_edge(START, "node_1")。另外它取节点名的方式和add_node(函数)一样,默认用函数名。
Node1Output 和 Node2Input 到底有什么用?
这两个类的字段完全一样(都是 sensitive_data: str),看着像重复,其实它们定义的是节点之间的数据通道:
node_1 的产出是 Node1Output
      ↓ (同名同类型字段 sensitive_data 直接对接)
node_2 的输入是 Node2Input
也就是说:node_1 交出的 sensitive_data,正好被 node_2 读走,数据流是连通的。关键点在于:这类字段不在 OverallState(公共状态)里,所以它的可见性是"半开"的:
| 行为 | 结果 |
|---|---|
| 节点之间传递(node_1 → node_2) | ✅ 能读到 sensitive_data |
| 出现在最终输出里 | ❌ 被过滤掉了 |
带来两个实际好处:
-
数据可见性可控:敏感信息、API Key、中间大对象只在节点间流转,不对外暴露;
-
对外只返回干净字段:外部拿到的就是干净的
final_result。
能不能合并成一个类? 能!因为字段一样,写成同一个类完全等价:
# 合并写法(与拆成两个类等价) class SensitiveData(TypedDict): sensitive_data: str def node_1(state: OverallState) -> SensitiveData: ... def node_2(state: SensitiveData) -> OverallState: ...
💡 教程里之所以写成两个类,是为了让"谁的输出 / 谁的输入"这层语义更清晰;真正跑起来,一个类也完全没问题。
节点间传递私有状态,实际应用场景:
| 场景 | 说明 |
|---|---|
| 数据处理 | 中间处理步骤的临时数据 |
| 认证流程 | 令牌等敏感信息的传递 |
| 复杂计算 | 中间计算结果 |
| 错误处理 | 错误详情在内部传递,但对外提供友好消息 |
以上三个特性让 LangGraph 能够处理复杂的企业级应用场景,同时保持代码的清晰和安全性。
三、工作流的四大常见模式
工作流模式是预先定义好的执行路径,就像工厂的流水线一样,每个步骤都有明确的输入输出和顺序。不同需求场景,对应不同的模式选择。
| 模式 | 一句话概括 | 典型场景 |
|---|---|---|
| 提示链 | 一条直线,前一步的输出喂给后一步 | 大纲 → 初稿 → 润色 → 终稿 |
| 并行化 | 多个任务同时干,最后汇总 | 多维度分析、批量处理 |
| 路由 | 先分类,再分流到专用处理器 | 智能客服、工单分派 |
| 协调者-工作者 | 一个大脑拆任务,多个工人并行干 | 长文档分章节撰写 |
3.1 提示链模式(Prompt Chaining)
3.1.1 概念
提示链就像流水线一样,前一个步骤的输出作为下一个步骤的输入。这跟做内容创作时一样:需要 大纲 → 初稿 → 润色 → 最终稿,每一步的输出都要传给下一步,才能让内容质量逐步提升。
📷 插图位置:提示链模式示意图(START → 输入主题 → 大纲生成 → 大纲 → 初稿生成 → 初稿 → 润色文章 → 润色版 → 最终稿生成 → 终稿 → END)
3.1.2 模式实践
我们创建一个内容创作场景的工作流,包含 大纲 → 初稿 → 润色 → 最终稿。节点设计为:
| 节点 | 职责 |
|---|---|
generate_outline | 只负责大纲生成 |
generate_draft | 只负责初稿写作 |
polish_content | 只负责内容润色 |
finalize_content | 只负责最终整合 |
代码示例:
from langchain.chat_models import init_chat_model
from langchain_core.messages import HumanMessage
from typing_extensions import TypedDict
from langgraph.graph import StateGraph, START, END

# 定义大模型(适配 DeepSeek)
model = init_chat_model(model="deepseek-chat", model_provider="deepseek")


# ---------- 1. 定义输入模式(只包含用户输入)----------
class InputState(TypedDict):
   topic: str              # 用户输入的主题


# ---------- 2. 定义输出模式(只包含最终结果)----------
class OutputState(TypedDict):
   final_content: str      # 最终的内容


# ---------- 3. 定义完整状态模式(内部使用)----------
class OverallState(InputState, OutputState):
   outline: str            # 第一步:生成的大纲
   draft: str              # 第二步:生成的初稿
   polished_draft: str     # 第三步:润色后的稿件


# ---------- 4. 第一步:生成大纲 ----------
PROMPT_1 = (
   "根据主题生成文章大纲。\n"
   "主题:{topic}\n"
   "要求:"
   "1.只需两个最核心标题"
   "2.不用进行说明,只返回最终大纲"
)


def generate_outline(state: InputState):
   """根据主题生成内容大纲"""
   print("*" * 50)
   print(f"内容大纲生成中...\n")
   prompt = PROMPT_1.format(topic=state['topic'])
   outline = model.invoke([HumanMessage(content=prompt)]).content
   print(f"大纲已生成:\n{outline}\n")
   return {
       "outline": outline,
       "topic": state["topic"],
   }


# ---------- 5. 第二步:基于大纲生成初稿 ----------
PROMPT_2 = (
   "根据以下内容生成文章完整初稿。\n"
   "主题:{topic}\n"
   "大纲: "
   "{outline}\n"
   "要求:"
   "1.每个标题下,最多使用三句话的内容即可"
   "2.不用进行说明,只返回最终结果"
)


def generate_draft(state: OverallState):
   """根据大纲生成完整初稿"""
   print("*" * 50)
   print(f"生成初稿中...\n")
   prompt = PROMPT_2.format(topic=state['topic'], outline=state['outline'])
   draft = model.invoke([HumanMessage(content=prompt)]).content
   print(f"初稿已生成:\n{draft}\n")
   return {"draft": draft}


# ---------- 6. 第三步:润色稿件 ----------
PROMPT_3 = (
   "根据文章初稿进行润色。\n"
   "主题:{topic}\n"
   "初稿: "
   "{draft}\n"
   "要求:"
   "1.润色后,文章不能太长"
)


def polish_content(state: OverallState):
   """对初稿进行润色优化"""
   print("*" * 50)
   print(f"文章润色中...\n")
   prompt = PROMPT_3.format(topic=state['topic'], draft=state['draft'])
   polished = model.invoke([HumanMessage(content=prompt)]).content
   print(f"润色完成,内容如下:\n{polished}\n")
   return {"polished_draft": polished}


# ---------- 7. 第四步:生成最终稿 ----------
PROMPT_4 = (
   "根据润色版文章,生成文章终稿。\n"
   "主题:{topic}\n"
   "大纲: "
   "{outline}\n"
   "润色版文章: "
   "{polished_draft}\n"
)


def finalize_content(state: OverallState):
   """生成最终版本的内容"""
   prompt = PROMPT_4.format(
       topic=state['topic'],
       outline=state['outline'],
       polished_draft=state['polished_draft'],
   )
   final_content = model.invoke([HumanMessage(content=prompt)]).content
   return {"final_content": final_content}


# ---------- 8. 构建工作流 ----------
builder = StateGraph(
   OverallState,
   input_schema=InputState,     # 输入验证:只接受 topic
   output_schema=OutputState,   # 输出过滤:只返回 final_content
)

# add_node:添加节点(直接传函数,节点名自动取函数名)
builder.add_node(generate_outline)     # 节点1:生成大纲
builder.add_node(generate_draft)       # 节点2:生成初稿
builder.add_node(polish_content)       # 节点3:润色稿件
builder.add_node(finalize_content)     # 节点4:生成最终稿

# add_edge:添加边(连接节点,直线流程)
builder.add_edge(START, "generate_outline")              # 开始 → 生成大纲
builder.add_edge("generate_outline", "generate_draft")   # 大纲 → 生成初稿
builder.add_edge("generate_draft", "polish_content")     # 初稿 → 润色
builder.add_edge("polish_content", "finalize_content")   # 润色 → 最终稿
builder.add_edge("finalize_content", END)                # 最终稿 → 结束

# compile:编译工作流
chain = builder.compile()


# ---------- 9. 使用工作流 ----------
result = chain.invoke({"topic": "人工智能的未来发展"})
print("=" * 50)
print("最终创作结果:")
print("=" * 50)
print(result["final_content"])
print("=" * 50)
运行结果(示意,实际内容随模型与参数变化):
**************************************************
内容大纲生成中...

大纲已生成:
一、技术突破:从大模型到通用智能
二、社会影响:效率革命与伦理挑战
**************************************************
生成初稿中...

初稿已生成:
(两个标题下各三句话的初稿内容)
**************************************************
文章润色中...

润色完成,内容如下:
(更精炼的两个小节内容)
==================================================
最终创作结果:
==================================================
人工智能的未来发展

一、技术突破:从大模型到通用智能
……

二、社会影响:效率革命与伦理挑战
……
==================================================
💡 这条链四步串行,每一步只干一件事,这就是单一职责带来的好处:哪一步效果差,就单独改那一步的提示词,不用动整张图。注意
result里只有final_content——中间的outline、draft、polished_draft全被output_schema过滤掉了。
3.2 并行化模式(Parallelization)
3.2.1 概念
并行化是指多个任务同时进行,提高效率,最终汇总结果。在多角度处理同一问题时,常用这个模式。
例如要研发一款主打城市通勤的智能电动自行车,具有导航、社交、防盗等功能。在开始研发前,需要进行多维度分析:
| 维度 | 分析要点 |
|---|---|
| 市场分析 | 用户关注续航里程、车身重量、防盗能力,并对"骑行社交"(组队、分享路线)有新兴兴趣 |
| 竞品分析 | 传统品牌车型智能化不足;互联网品牌车型续航和线下售后服务是短板 |
| 技术分析 | 评估更轻量化的电池材料与车身设计以提升续航和便携性,并开发基于 GPS 和移动网络的智能防盗系统与社交功能 App 的集成 |
最后汇总分析结果。而并行分析不仅省时,还能提升决策质量。
📷 插图位置:并行化模式示意图(START 同时扇出到 市场分析 / 竞品分析 / 技术分析,再扇入到 汇总报告 → END)
3.2.2 模式实践
代码示例:
from typing import TypedDict
from langgraph.constants import START, END
from langgraph.graph import StateGraph


# ---------- 1. 定义状态 ----------
class AnalysisState(TypedDict):
    concept: str        # 概念
    market: str         # 市场分析
    competitor: str     # 竞品分析
    tech: str           # 技术分析
    report: str         # 汇总报告


# ---------- 2. 定义三个【并行】分析任务 ----------
def market_task(state: AnalysisState):
    """市场分析"""
    return {"market": "用户关注续航、重量、防盗,对骑行社交有兴趣..."}


def competitor_task(state: AnalysisState):
    """竞品分析"""
    return {"competitor": "传统品牌智能化不足,互联网品牌续航和售后差..."}


def tech_task(state: AnalysisState):
    """技术分析"""
    return {"tech": "轻量化电池车身、GPS防盗、社交App集成..."}


# ---------- 3. 汇总结果 ----------
def combine_results(state: AnalysisState):
    """生成最终报告"""
    report = "产品分析报告\n\n"
    report += f"市场分析:\n{state['market']}\n\n"
    report += f"竞品分析:\n{state['competitor']}\n\n"
    report += f"技术分析:\n{state['tech']}\n\n"
    report += "建议:聚焦续航、防盗、社交功能的平衡发展"
    return {"report": report}


# ---------- 4. 构建工作流 ----------
builder = StateGraph(AnalysisState)

# add_node:添加节点
builder.add_node("market", market_task)
builder.add_node("competitor", competitor_task)
builder.add_node("tech", tech_task)
builder.add_node("combine", combine_results)

# add_edge:添加边
# 并行执行三个分析:START 同时指向三个节点(扇出 fan-out)
builder.add_edge(START, "market")
builder.add_edge(START, "competitor")
builder.add_edge(START, "tech")

# 三个并行任务都完成后,汇合到 combine(扇入 fan-in)
builder.add_edge("market", "combine")
builder.add_edge("competitor", "combine")
builder.add_edge("tech", "combine")

builder.add_edge("combine", END)

# compile:编译工作流
workflow = builder.compile()


# ---------- 5. 使用 ----------
result = workflow.invoke({"concept": "城市通勤智能电动自行车"})
print(result["report"])
运行结果:
产品分析报告

市场分析:
用户关注续航、重量、防盗,对骑行社交有兴趣...

竞品分析:
传统品牌智能化不足,互联网品牌续航和售后差...

技术分析:
轻量化电池车身、GPS防盗、社交App集成...

建议:聚焦续航、防盗、社交功能的平衡发展
并行化靠"边的形状"实现,两个关键动作:
| 动作 | 做法 | 效果 |
|---|---|---|
| 扇出(fan-out) | START 同时 add_edge 到 3 个节点 | 三个分析同时开跑 |
| 扇入(fan-in) | 3 个节点都 add_edge 到 combine | 全部完成后才执行汇总 |
💡 扇入节点会自动等待所有上游分支完成再执行,所以
combine_results里能放心地同时读market、competitor、tech三个字段,不用自己写"等三个都好了"的判断。另外这三个分支各自写的是不同字段,所以即便并行也不会互相覆盖。
3.3 路由模式(Routing)
3.3.1 概念
路由模式也被称为"智能分流":根据输入内容决定执行哪个分支。最典型的案例就是智能客服系统,可以按用户问题自动分类处理。
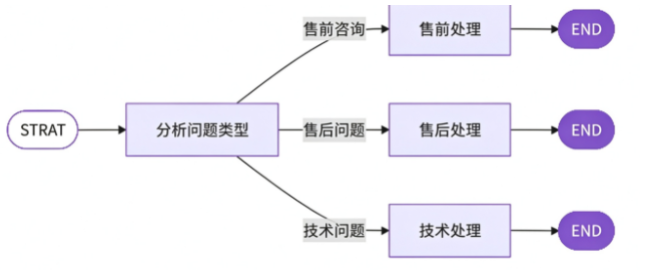
3.3.2 模式实践
实现一个智能客服系统,根据用户问题自动分类,达到精准匹配处理能力。核心设计在条件路由机制:
| 设计点 | 说明 |
|---|---|
| 动态路径选择 | 基于 LLM 分析结果动态决定执行路径(结构化返回) |
| 分支隔离 | 不同类型的问题由专用处理器处理 |
代码示例:
from langchain.chat_models import init_chat_model
from langgraph.constants import START, END
from langgraph.graph import StateGraph
from typing_extensions import Literal, TypedDict
from pydantic import BaseModel, Field


# ---------- 1. 定义状态 ----------
class State(TypedDict):
    input: str          # 用户输入
    decision: str       # 路由决策
    output: str         # 最终输出


# ---------- 2. 定义路由决策的数据结构(结构化输出)----------
class Route(BaseModel):
    # Literal:限定取值范围,模型只能在这三个里选
    step: Literal["pre_sale", "after_sale", "technical"] = Field(
        description="根据用户问题类型决定路由到售前、售后还是技术处理"
    )


# ---------- 3. 路由决策节点 ----------
def model_call_router(state: State):
    """分析用户输入,决定问题类型"""
    model = init_chat_model(model="deepseek-chat", model_provider="deepseek")
    # with_structured_output:让模型按 Route 结构返回(只输出 pre_sale/after_sale/technical)
    decision = model.with_structured_output(Route).invoke(state["input"])
    return {"decision": decision.step}


# ---------- 4. 三个不同的处理节点 ----------
def pre_sale_handler(state: State):
    """处理售前咨询"""
    return {"output": "售前咨询已处理,处理内容....."}


def after_sale_handler(state: State):
    """处理售后问题"""
    return {"output": "售后问题已处理,处理内容....."}


def technical_handler(state: State):
    """处理技术问题"""
    return {"output": "技术问题已处理,处理内容....."}


# ---------- 5. 路由函数(根据决策返回下一个节点名)----------
def route_decision(state: State):
    if state["decision"] == "pre_sale":
        return "pre_sale_handler"       # 去售前处理节点
    elif state["decision"] == "after_sale":
        return "after_sale_handler"     # 去售后处理节点
    elif state["decision"] == "technical":
        return "technical_handler"      # 去技术处理节点


# ---------- 6. 构建路由工作流 ----------
router_builder = StateGraph(State)

# add_node:添加处理节点(统一写成"节点名, 执行对象")
router_builder.add_node("pre_sale_handler", pre_sale_handler)
router_builder.add_node("after_sale_handler", after_sale_handler)
router_builder.add_node("technical_handler", technical_handler)
router_builder.add_node("model_call_router", model_call_router)

# add_edge:先经过路由决策
router_builder.add_edge(START, "model_call_router")

# add_conditional_edges:条件边 —— 根据路由函数的结果选择走哪个分支
router_builder.add_conditional_edges(
    "model_call_router",                                        # 源节点
    route_decision,                                             # 路由函数(返回下一个节点名)
    ["pre_sale_handler", "after_sale_handler", "technical_handler"],  # 可选分支
)

# add_edge:所有分支最终都结束
router_builder.add_edge("pre_sale_handler", END)
router_builder.add_edge("after_sale_handler", END)
router_builder.add_edge("technical_handler", END)

# compile:编译工作流
router_workflow = router_builder.compile()


# ---------- 7. 测试 ----------
test_cases = [
    "我想了解一下你们产品的价格和功能",                    # 售前咨询
    "我购买的产品有质量问题,需要退货",                     # 售后问题
    "这个软件安装后无法正常运行,报错代码0x80070005",        # 技术问题
    "请问你们的售后服务政策是什么",                        # 售后问题
    "我的订单已经发货但还没收到",                          # 售后问题
    "如何配置数据库连接参数",                              # 技术问题
]

for test_case in test_cases:
    print("*" * 50)
    result = router_workflow.invoke({"input": test_case})
    print(f"用户问题:{test_case}\n{result['output']}")
运行结果:
**************************************************
用户问题:我想了解一下你们产品的价格和功能
售前咨询已处理,处理内容.....
**************************************************
用户问题:我购买的产品有质量问题,需要退货
售后问题已处理,处理内容.....
**************************************************
用户问题:这个软件安装后无法正常运行,报错代码0x80070005
技术问题已处理,处理内容.....
**************************************************
用户问题:请问你们的售后服务政策是什么
售后问题已处理,处理内容.....
**************************************************
用户问题:我的订单已经发货但还没收到
售后问题已处理,处理内容.....
**************************************************
用户问题:如何配置数据库连接参数
技术问题已处理,处理内容.....
💡 路由模式的关键在
Route这个 Pydantic 模型:Literal["pre_sale", "after_sale", "technical"]把模型的输出锁死在三个取值里,所以route_decision里的三个分支不会漏——不会出现"模型返回了一个没准备的类型"导致路由失败。这也解释了为什么结构化输出和条件边是天生一对。
3.4 协调者-工作者模式(Orchestrator-Workers)
3.4.1 概念
协调者-工作者模式可以理解为一个大脑(协调者)分配任务,多个工人(工作者)执行,最后合成最终结果。例如处理几百页的技术文档时,可以让协调者拆分文档,接着安排多个工作者并行处理不同章节,最终汇总结果。
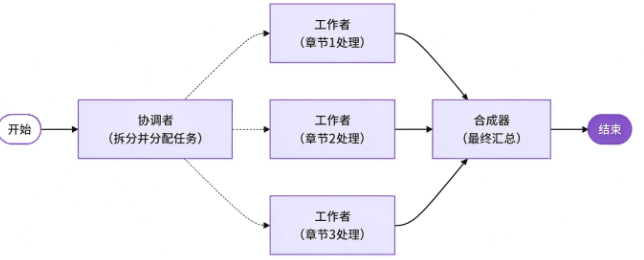
3.4.2 模式实践
三个角色分工如下:
| 角色 | 职责 |
|---|---|
| 协调者 | 根据 {topic} 生成报告大纲,并把生成内容的子任务指派给工作者 |
| 工作者 | 生成大纲对应的内容:协调者生成 3 个标题就需要 3 个工作者,生成 10 个标题就需要 10 个工作者 |
| 合成器 | 汇总所有工作者的成果 |
关键在于任务指派:协调者在运行时才需动态分配工作者,也就是说边的数量在运行时才能确定。为了支持这种模式,LangGraph 支持从条件边返回 Send 对象:
Send 的参数 | 含义 |
|---|---|
| 第 1 个 | 节点的名称(要把任务发给哪个节点) |
| 第 2 个 | 要传递给该节点的状态 |
代码示例:
from langchain.chat_models import init_chat_model
from langgraph.constants import START, END
from langgraph.graph import StateGraph
from langgraph.types import Send
from typing import Annotated, TypedDict, List
import operator
from pydantic import BaseModel


# ---------- 1. 定义状态 ----------
class State(TypedDict):
    topic: str
    sections: list                                     # 协调者生成的计划
    # Annotated[list, operator.add]:reducer —— 多个工作者的结果自动【合并/追加】
    completed_sections: Annotated[list, operator.add]  # 工作者完成的结果
    final_report: str


# ---------- 2. 定义数据结构(结构化输出)----------
class Section(BaseModel):
    name: str
    description: str


class Sections(BaseModel):
    sections: List[Section]


# ---------- 3. 创建规划器(让模型按 Sections 结构输出)----------
model = init_chat_model(model="deepseek-chat", model_provider="deepseek")
planner = model.with_structured_output(Sections)


# ---------- 4. 工作者私有状态(由 Send 传入,不在 State 中)----------
class WorkerState(TypedDict):
    section: Section      # 单个工作者领到的任务


# ---------- 5. 协调者节点 —— 制定计划 ----------
def orchestrator(state: State):
    """协调者:分析任务并制定执行计划"""
    report_sections = planner.invoke(
        f"为主题'{state['topic']}'制定报告大纲,包含3个章节"
    )
    return {"sections": report_sections.sections}


# ---------- 6. 工作者节点 —— 执行具体任务 ----------
def llm_call(state: WorkerState):
    """工作者:根据分配的任务生成内容"""
    section = state["section"]      # 从协调者接收的任务
    result = model.invoke(
        f"编写报告章节:{section.name},内容要求:{section.description}"
    )
    return {"completed_sections": [result.content]}   # 结果会自动合并


# ---------- 7. 汇总节点 ----------
def synthesizer(state: State):
    """汇总所有工作者的成果"""
    completed_sections = state["completed_sections"]
    final_report = "\n\n---\n\n".join(completed_sections)
    return {"final_report": final_report}


# ---------- 8. 任务分配函数 —— 关键部分!----------
def assign_workers(state: State):
    """为每个任务创建工作作者(动态生成多个并行任务)"""
    worker_tasks = []
    for section in state["sections"]:
        # Send("节点名", {传给该节点的状态}):把任务【动态发送】给工作者节点
        worker_tasks.append(Send("llm_call", {"section": section}))
    return worker_tasks


# ---------- 9. 构建工作流 ----------
builder = StateGraph(State)
builder.add_node("orchestrator", orchestrator)
builder.add_node("llm_call", llm_call)
builder.add_node("synthesizer", synthesizer)

builder.add_edge(START, "orchestrator")

# 关键:协调者后创建多个工作者(条件边 + Send 实现动态并行分发)
builder.add_conditional_edges(
    "orchestrator",
    assign_workers,
    ["llm_call"],       # 创建的工作者都指向 llm_call 节点
)

# 所有工作者完成后汇总
builder.add_edge("llm_call", "synthesizer")
builder.add_edge("synthesizer", END)

worker = builder.compile()

response = worker.invoke({"topic": "中国近代史"})
print(response)
运行结果:
{'topic': '中国近代史', 'sections': [Section(name='第一章:晚清变局与救亡图存的探索(1840—1911)', description='……'), Section(name='第二章:共和初建与革命新道路的探索(1912—1949)', description='……'), Section(name='第三章:……', description='……')], 'completed_sections': ['(第一章正文)', '(第二章正文)', '(第三章正文)'], 'final_report': '(第一章正文)\n\n---\n\n(第二章正文)\n\n---\n\n(第三章正文)'}
💡 这里是"边在运行时才确定"的最直观例子:
assign_workers遍历sections列表,有几个章节就返回几个Send——3 个章节就是 3 条并行分支,10 个章节就是 10 条。所以llm_call读到的state["section"]并不是State里的字段,而是Send第二参数单独传进去的私有状态(这正是 2.3 节讲的那套机制:能传,但不会出现在最终状态里)。另外completed_sections用operator.add做 reducer,多个工作者的结果才会自动合并成列表,而不是互相覆盖。
四、复盘(附答案)
💡 思考题
-
Overwrite解决的是什么问题?不加它,replace_messages节点的返回会怎样被处理? -
input_schema、output_schema、状态类本身(state_schema)分别管什么?为什么内部状态可以比对外接口更复杂? -
私有状态是怎么做到"节点之间能传、最终输出里没有"的?
Node1Output和Node2Input能不能合并成一个类? -
并行化模式里,扇出和扇入分别靠什么实现?扇入节点需要自己判断"上游都跑完了"吗?
-
路由模式里,
Route模型为什么要用Literal限定取值范围? -
Send的第一个参数和第二个参数分别是什么?为什么说协调者-工作者模式"边的数量在运行时才确定"?
📝 答案
-
Overwrite解决的是"某些场景下必须整体覆盖、而不是合并"的问题,典型就是清空聊天记录重新开始。messages字段挂着operator.add这个 reducer,节点的返回值会被当作"要追加的内容"合并进旧列表;不加Overwrite时结果是['initial', 'first message', 'replacement message'],加上之后变成['replacement message']——强制绕过 reducer,直接整体替换。 -
input_schema验证调用图形时的输入结构(只接受声明的字段);output_schema过滤图的输出(只返回声明的字段);状态类本身是图内部流转的完整状态,节点之间通信用。所以内部状态可以比对外接口更复杂——它可以装着中间结果、上下文、临时数据,而对外只暴露该暴露的字段,既保护内部实现,也让接口稳定。 -
靠节点的类型注解:node_1 的返回注解是
Node1Output、node_2 的参数注解是Node2Input,两者有同名同类型字段sensitive_data,于是 node_1 交出的数据正好被 node_2 读走;而这个字段不在OverallState里,所以不会出现在最终输出中(最终只剩final_result)。能合并成一个类——字段一样,写成同一个SensitiveData完全等价;拆成两个类只是让"谁的输入 / 谁的输出"语义更清晰。 -
扇出靠从同一个起点加多条边:
START同时连到market、competitor、tech,三个节点同时开跑;扇入靠多个节点连到同一个节点:三个分析节点都连到combine。不需要自己判断——扇入节点会自动等待所有上游分支完成再执行,所以combine_results里可以直接读三个字段。 -
因为结构化输出需要约束取值范围。
Literal["pre_sale", "after_sale", "technical"]让模型只能在这三个值里选,于是route_decision里的三个分支覆盖了全部可能,不会出现"模型返回了第四个值、路由函数却没有对应分支"导致流程中断的情况。条件边 + 结构化输出因此是天然搭配。 -
第一个参数是节点的名称(任务发给哪个节点),第二个参数是要传递给该节点的状态(这里是
{"section": section})。之所以说"边的数量在运行时才确定",是因为assign_workers是在运行时遍历state["sections"]才能知道有几个章节,然后返回几个Send——3 个章节就 3 条并行分支,10 个章节就 10 条,图结构里写死的只有"协调者 →(条件边)→llm_call"这一条。
🎯 闭幕
如果本文对你有帮助,欢迎:
👍 点赞 | ⭐ 收藏 | 👤 关注作者 | 💬 留言交流你的疑问或补充
你的每一次互动都是我继续更新的动力,我们下一篇见!🚀
转载自 CSDN-专业IT技术社区
原文链接:https://blog.csdn.net/2601_96587588/article/details/167127657

