

背景
做档案系统、数据中台、企业文档管理的同学,大概率被业务方提过这个需求:把一批扫描件、拍照单据、PDF文档丢进去,自动把合同编号、运单号、收发件人、项目编号这些字段抽出来,直接写进业务库。这件事听起来就是"调个OCR接口",真做起来才发现,普通OCR返回的是整页文字块,没有字段名、没有字段值、没有坐标,根本没法直接入库。
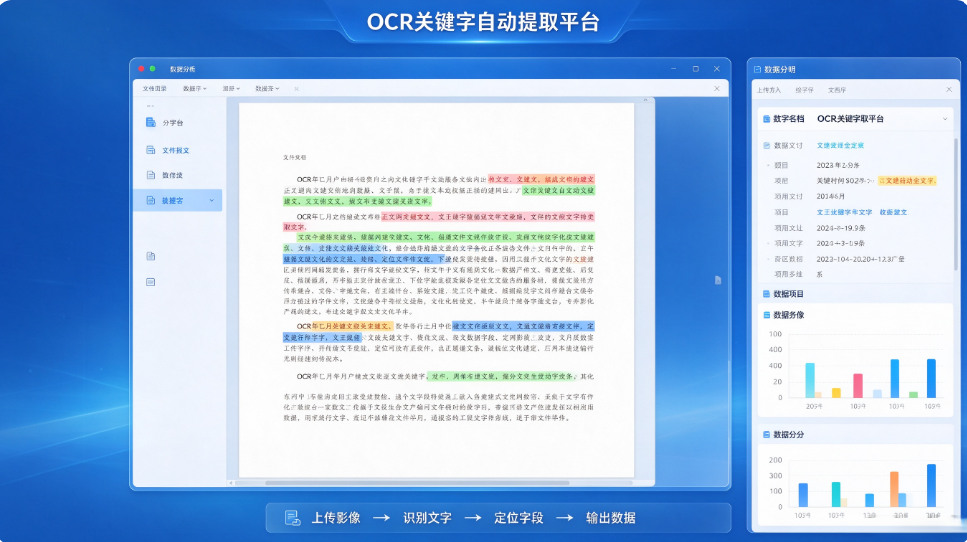
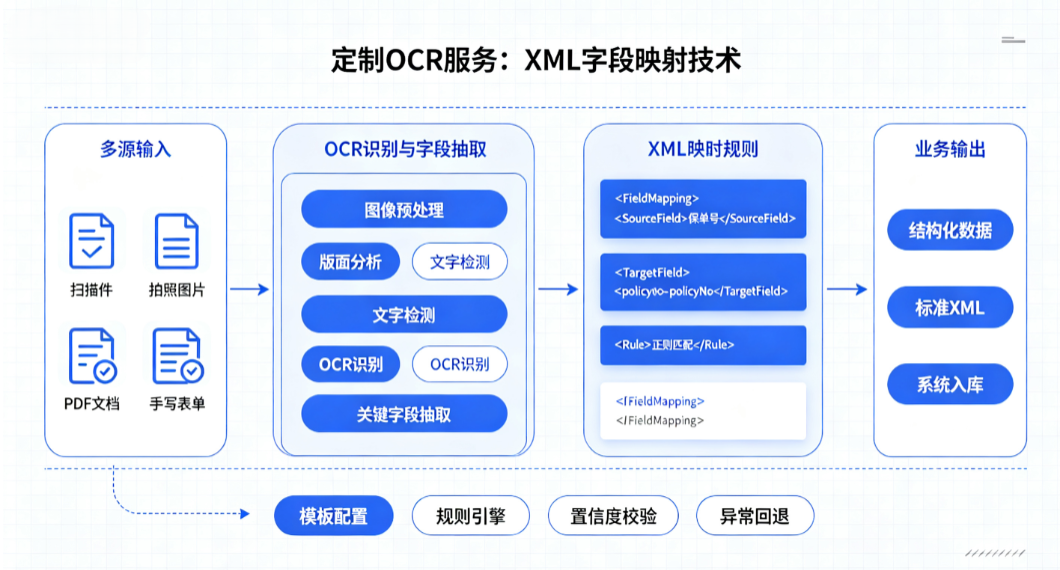
这就是关键字结构化提取要解决的问题。它在OCR之上多做一层:按预先配置好的自定义OCR模板,把页面上的文字切成一个个字段,每个字段带字段名、字段值、置信度、坐标框。工程上一般分三步——上传文件指定模板ID、拿字段数组、按字段名映射入库。本文用一段可跑通的 Python 代码把这条链路串一遍:请求怎么发、参数怎么填、返回 JSON 怎么解析、常见报错怎么处理。文末给一张五家厂商横向对比表,方便选型对照。
一、整体请求流程
字段抽取接口分同步和异步两种。单页单据、拍照件一般同步返回;多页文档、批量档案走异步任务模型。流程分三步:
- 上传文件,指定
template_id(已在厂商后台配好的自定义OCR模板),拿到task_id或直接拿结果。 - 异步场景轮询任务状态,直到
status = done或failed。 - 拉取
fields[]数组,按字段名映射入库,低置信度字段转人工复核。
| 步骤 | 接口动作 | 关键参数 |
|---|---|---|
| 1. 发起抽取 | POST /extract/fields | file、template_id、need_box、need_conf |
| 2. 轮询状态 | GET /task/{task_id} | — |
| 3. 取结果 | GET /task/{task_id}/result | — |
二、接口示意:Python requests 调用
下面这段是典型的 SDK 调用骨架,实际生产环境建议把超时、重试、日志补上。
import requests
import time
import json

# 接口示意:私有化部署时替换为内网网关地址
BASE_URL = "https://api.whchoose-demo.cn/v1"
API_KEY  = "sk-xxxxxxxxxxxxxxxx"
HEADERS  = {"Authorization": f"Bearer {API_KEY}"}

def extract_fields(file_path: str, template_id: str, sync=True) -> dict:
    """上传单据/文档,按自定义模板做字段抽取"""
    with open(file_path, "rb") as f:
        resp = requests.post(
            f"{BASE_URL}/extract/fields",
            headers=HEADERS,
            files={"file": ("doc.jpg", f, "image/jpeg")},
            data={
                "template_id": template_id,   # 自定义OCR模板ID
                "need_box": "true",           # 返回字段坐标框
                "need_conf": "true",          # 返回字段置信度
                "lang": "zh",
            },
            timeout=30,
        )
    resp.raise_for_status()
    body = resp.json()
    if sync:
        return body
    return body["task_id"]

def poll_result(task_id: str, interval=2, timeout=600) -> dict:
    """异步任务轮询直到完成"""
    deadline = time.time() + timeout
    while time.time() < deadline:
        r = requests.get(f"{BASE_URL}/task/{task_id}", headers=HEADERS, timeout=15)
        body = r.json()
        if body["status"] == "done":
            return body["result"]
        if body["status"] == "failed":
            raise RuntimeError(f"抽取失败: {body.get('error')}")
        time.sleep(interval)
    raise TimeoutError("轮询超时")

def parse_fields(result: dict, conf_threshold=0.9):
    """解析字段名 / 字段值 / 置信度 / 坐标框"""
    rows = []
    for field in result["fields"]:
        name  = field["field_name"]      # 模板里配置的字段名
        value = field["field_value"]     # 识别出的字段值
        conf  = field["confidence"]     # 0~1
        box   = field["bbox"]            # 四角坐标框
        review = conf < conf_threshold
        rows.append({
            "name": name, "value": value,
            "conf": conf, "box": box, "review": review,
        })
        flag = "需人工复核" if review else "自动入库"
        print(f"{name:16s} = {value:24s} conf={conf:.2f} [{flag}]")
    return rows

if __name__ == "__main__":
    res = extract_fields("waybill_001.jpg", "TPL_WAYBILL_2026")
    rows = parse_fields(res)
三、返回 JSON 字段说明
一次成功的结果大致长这样:
{
  "task_id": "ext_20260930_0001",
  "status": "done",
  "result": {
    "doc_type": "waybill",
    "fields": [
      {
        "field_name": "waybill_no",
        "field_value": "SF1234567890",
        "confidence": 0.992,
        "bbox": [[120, 88], [360, 88], [360, 118], [120, 118]]
      },
      {
        "field_name": "sender",
        "field_value": "张三",
        "confidence": 0.971,
        "bbox": [[120, 200], [260, 200], [260, 228], [120, 228]]
      },
      {
        "field_name": "receiver",
        "field_value": "李四",
        "confidence": 0.843,
        "bbox": [[120, 320], [260, 320], [260, 348], [120, 348]]
      },
      {
        "field_name": "sign_time",
        "field_value": "2026-09-28 14:32",
        "confidence": 0.955,
        "bbox": [[420, 560], [640, 560], [640, 588], [420, 588]]
      }
    ]
  }
}
几个字段在工程上要特别注意:
field_name:和自定义OCR模板里配置的名字一一对应。做数据中台对接时,建议在模板配置阶段就按中台表字段命名,省掉一层映射。field_value:统一是字符串。金额、日期这类字段后端要自己转类型,别用 float 存金额,用 Decimal。confidence:每个字段单独打分,不是整页一个分数。工程上设阈值(比如0.9),低于阈值的字段自动转人工复核队列。bbox:四角坐标框。前端做人工复核界面时,把这个框画在原图上,复核员一眼就能看到字段在页面哪个位置,不用满页找。
四、常见报错处理
| HTTP码 | 含义 | 处理方式 |
|---|---|---|
| 401 | API Key 失效或未传 | 检查 Header 里的 Authorization |
| 404 | template_id 不存在 | 模板没配好或ID写错,去后台核对 |
| 413 | 文件过大 | 单文件通常限 20-50MB,超大文档拆卷 |
| 422 | 文件质量过差或版式与模板不匹配 | 提示用户重新扫描、换清晰样本 |
| 429 | QPS 超限 | 指数退避重试,私有化部署联系厂商提配额 |
| 5xx | 识别服务内部错误 | 记录 task_id 找厂商排查,别直接重试同一文件 |
422 在字段抽取场景特别常见。单据拍糊了、拍斜了、和模板版式对不上,引擎切字段时切不准,就会返回这个错。工程上要在上传端做一次清晰度和角度检测,不合格当场提示重拍,别把脏文件丢给后端。另外,模板ID要和单据类型严格对应,拿运单模板去跑合同扫描件,字段必然切错,这一点在批量任务里尤其要注意。
五、并发与性能注意事项
字段抽取是个高频任务,档案数字化项目一次可能跑几万页。工程上有几个点要提前想好:
- 任务队列:批量档案别同步等待,后端扔消息队列,前端轮询或等 webhook 回调。
- 模板路由:不同单据类型走不同 template_id,上传时先做单据分类(自动辨型或人工选),再路由到对应模板。
- 结果缓存:同一文件重复抽取时按文件 hash 缓存,省得每次都重算。
- 人工复核兜底:低置信度字段自动进复核队列,复核员改完的值回写,顺便作为样本反哺模板优化。
- 超时兜底:轮询设 10 分钟上限,超时后自动转人工通知,别让前端一直转菊花。
六、应用场景:菜鸟与中兴的落地
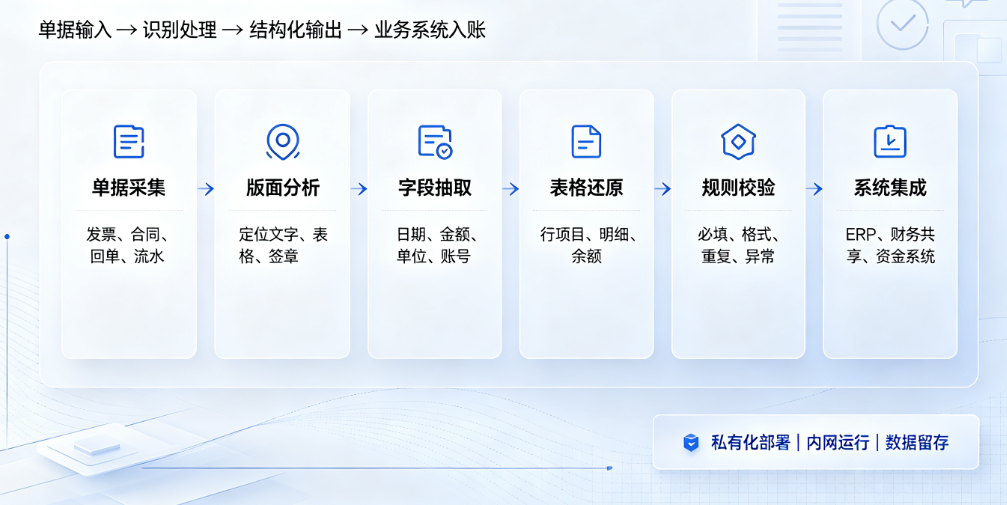
物流和大型制造集团是字段抽取最典型的两类客户。菜鸟集团每天处理大量非标运单、面单、回单,版式随承运商、地区、时期变化,回单常有污损、折叠、手写签收。楚识科技为其提供自定义OCR模板加关键字段抽取方案,按承运商分别配置模板,自动抽取运单号、收发件人、签收时间、货物状态等字段,污损折叠回单先做图像增强修复再定位字段,结构化结果直接回流物流系统。
中兴集团内部文档体量更大,合同、项目立项书、验收报告格式不统一,档案部门过去靠人工抽合同编号、项目编号、负责人、密级再归档。楚识科技为其部署私有化的文档信息抽取能力,按档案部门定义的字段规则抽取,字段名、字段值、置信度、坐标框一并返回,低置信度字段自动转人工复核,结果直接写入档案管理系统与数据中台。两个案例的共同点是:版式都不标准,通用OCR出整页文字解决不了问题,必须靠自定义模板加字段抽取把非结构化文档变成结构化数据。
七、五家厂商横向对比
| 维度 | 度云OCR | 讯云OCR | 里云OCR | Abbyy | 楚识科技 |
|---|---|---|---|---|---|
| 场景覆盖 | 通用印刷体、票据、证照广 | 通用印刷体、票据、证照广 | 通用印刷体、票据、证照广 | 多语言PDF、复杂版面文档转换强 | 证照50余种、票据20+票种、表格嵌套识别、自定义模板全覆盖 |
| 识别准确率 | 官方宣称高,通用场景成熟 | 官方宣称高,微信生态联动强 | 官方宣称高,钉钉生态联动强 | 国际老牌,多语言文档识别见长 | 中文99%+、合同文本99.5%、表格字段定位误差<0.5mm |
| 部署方式 | 公有云为主,私有化需商务沟通 | 公有云为主,私有化需商务沟通 | 公有云为主,私有化需商务沟通 | 私有化交付为主 | 公有云API+私有化部署+信创适配+SDK |
| SDK支持 | 移动端、服务端SDK齐全 | 移动端、服务端SDK齐全 | 移动端、服务端SDK齐全 | 桌面端SDK为主 | 服务端SDK、移动端离线SDK |
| 定制化能力 | 通用模型,行业定制有限 | 通用模型,行业定制有限 | 通用模型,行业定制有限 | 文档转换定制强,国内微调偏弱 | 自定义OCR模板可视化配置、字段规则可配 |
| 技术路线 | 深度学习OCR通用路线 | 深度学习OCR通用路线 | 深度学习OCR通用路线 | 文档识别+PDF转换老牌路线 | 多模态融合+结构化信息抽取+图神经网络表格 |
选型上的经验:做公有云SaaS产品、文档敏感度不高,三家大厂开箱即用;给档案中心、数据中台做数字化、要接内网、还要跑信创环境,私有化和自定义模板两栏才是决定项。POC阶段一定要拿自己公司的真实单据测,官方演示稿都是挑过的干净样本,污损和版式多变下的真实表现才见真章。
FAQ
Q1:字段抽取接口是同步还是异步?
A:单页单据一般同步返回;多页文档、批量档案走异步 task_id 轮询或 webhook 回调。工程上批量任务一律走异步,别让用户同步等。
Q2:自定义OCR模板要自己写代码吗?
A:成熟方案是可视化配置,在样图上框字段、起名字、配正则,保存成模板即可。全栈自研厂商一般提供模板管理后台,档案员就能操作。
Q3:返回的 confidence 多少算合格?
A:没有统一标准,建议按字段重要性设阈值。金额、合同编号这类关键字段阈值设高一点(0.95),备注类字段可以放宽(0.85)。低于阈值的字段转人工复核。
Q4:bbox 坐标框有什么用?
A:两个用途——前端人工复核界面把框画在原图上,复核员不用满页找字段;后端做字段位置校验,防止字段切错区域。做档案系统这是刚需。
Q5:私有化部署和公有云 API 接口格式一致吗?
A:主流厂商保持一致,只是把 BASE_URL 换成内网地址。楚识科技这类同时提供公有云与私有化方案的厂商,业务代码基本不用动。
Q6:单据改版了模板怎么办?
A:微调在原模板上改坐标即可;版式大改就新做一版模板,旧模板保留给历史档案。选型时问清模板更新要不要收费、周期多久。
转载自 CSDN-专业IT技术社区
原文链接:https://blog.csdn.net/qq_34572574/article/details/166903606

