

💖💖作者:计算机毕业设计杰瑞
💙💙个人简介:曾长期从事计算机专业培训教学,本人也热爱上课教学,语言擅长Java、微信小程序、Python、Golang、安卓Android等,开发项目包括大数据、深度学习、网站、小程序、安卓、算法。平常会做一些项目定制化开发、代码讲解、答辩教学、文档编写、也懂一些降重方面的技巧。平常喜欢分享一些自己开发中遇到的问题的解决办法,也喜欢交流技术,大家有技术代码这一块的问题可以问我!
💛💛想说的话:感谢大家的关注与支持!
💜💜
网站实战项目
安卓/小程序实战项目
大数据实战项目
深度学校实战项目
计算机毕业设计选题推荐
目录
基于大数据的大白菜价格分析与可视化介绍
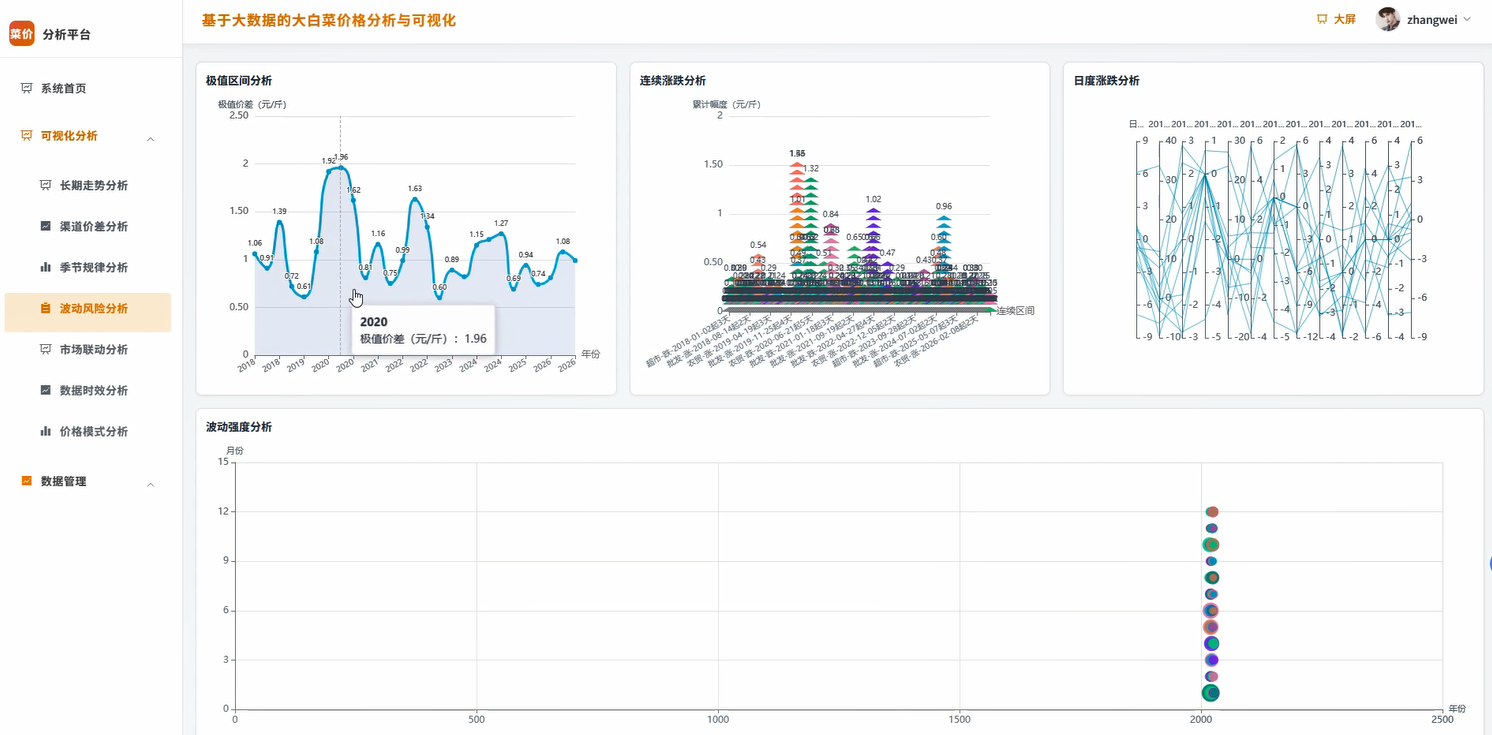
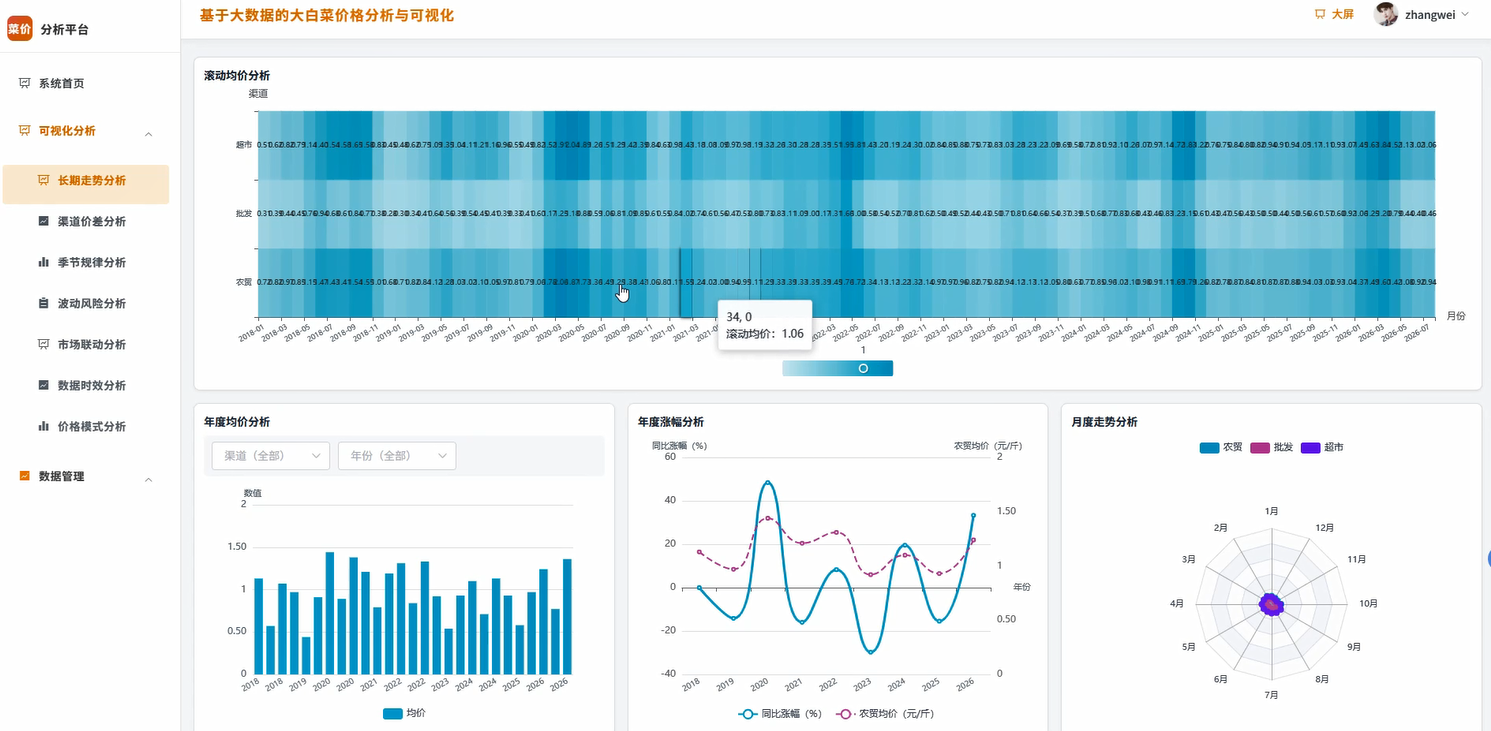
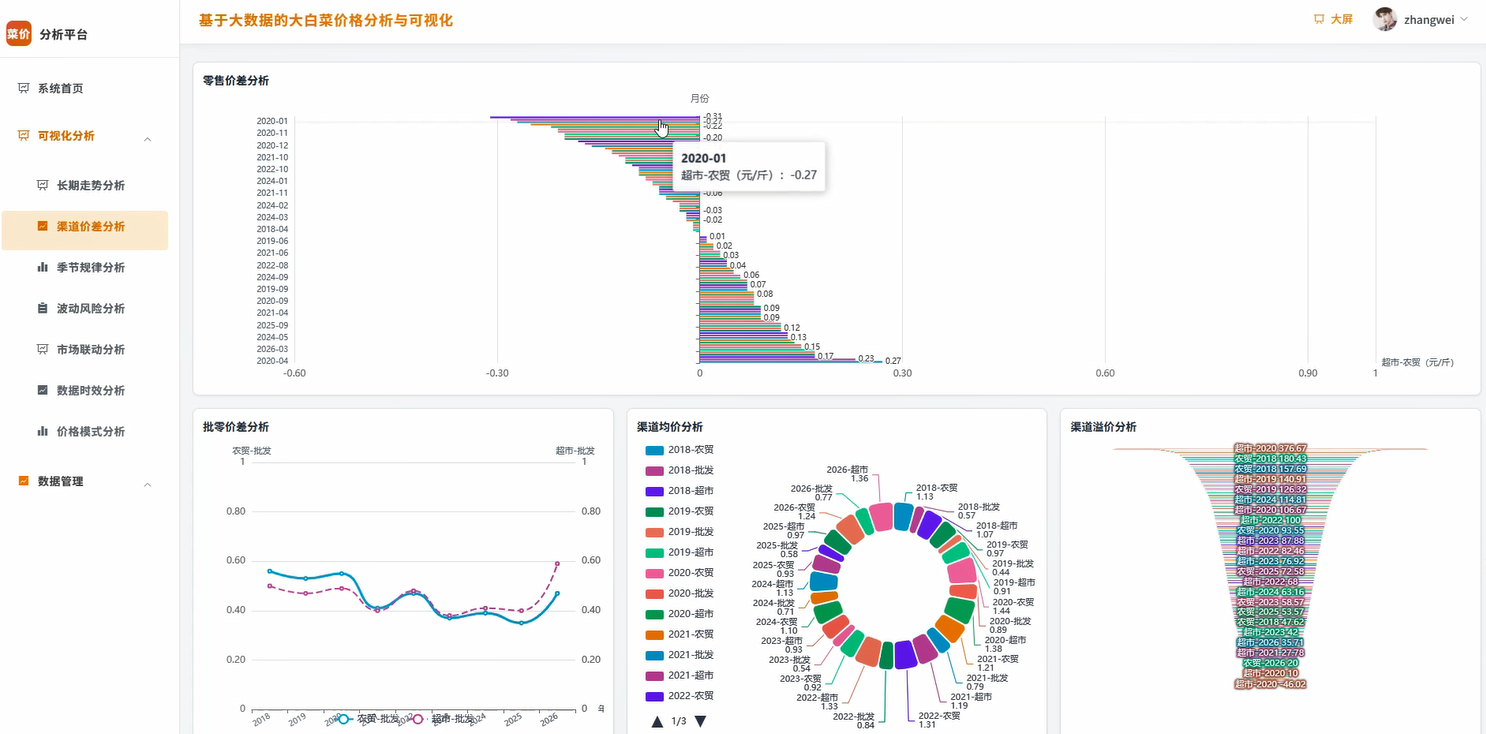
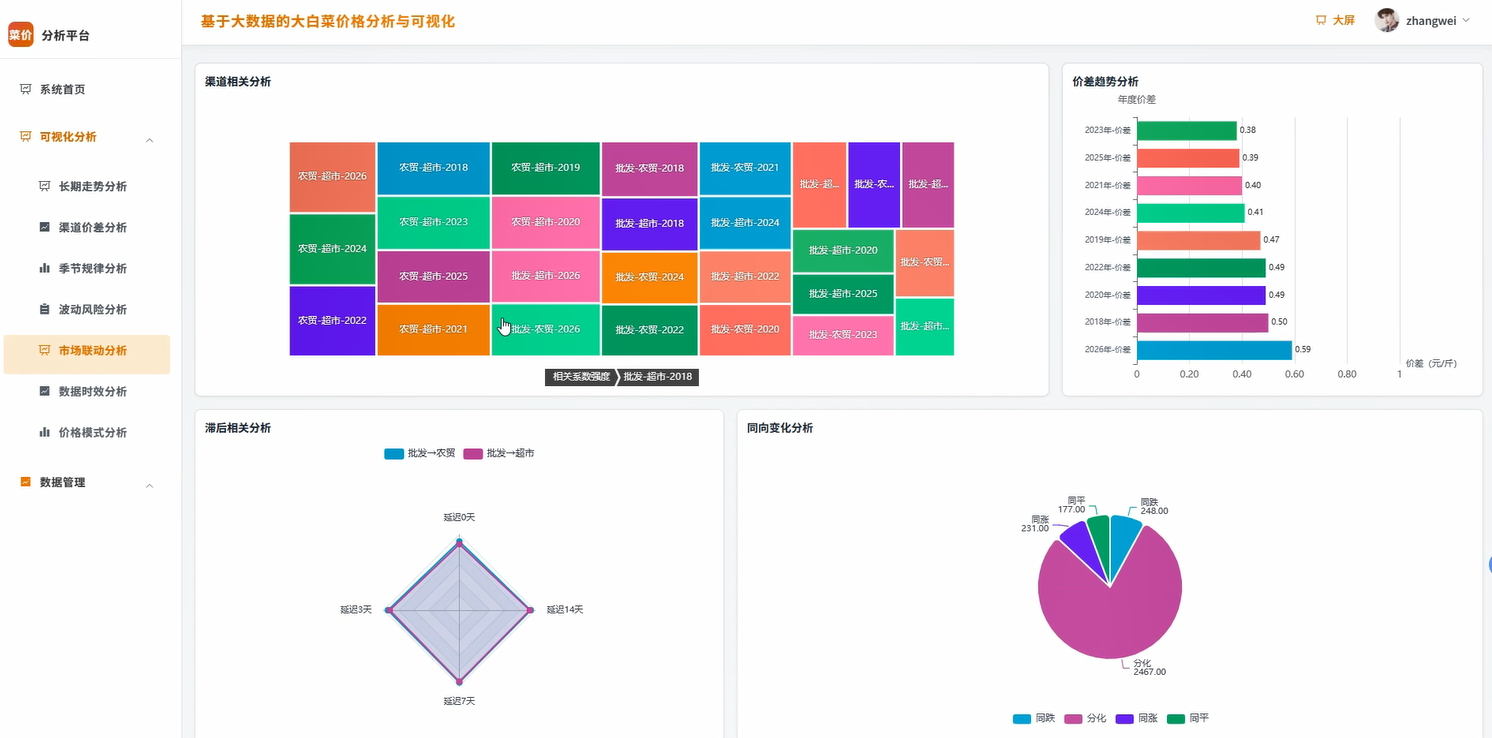
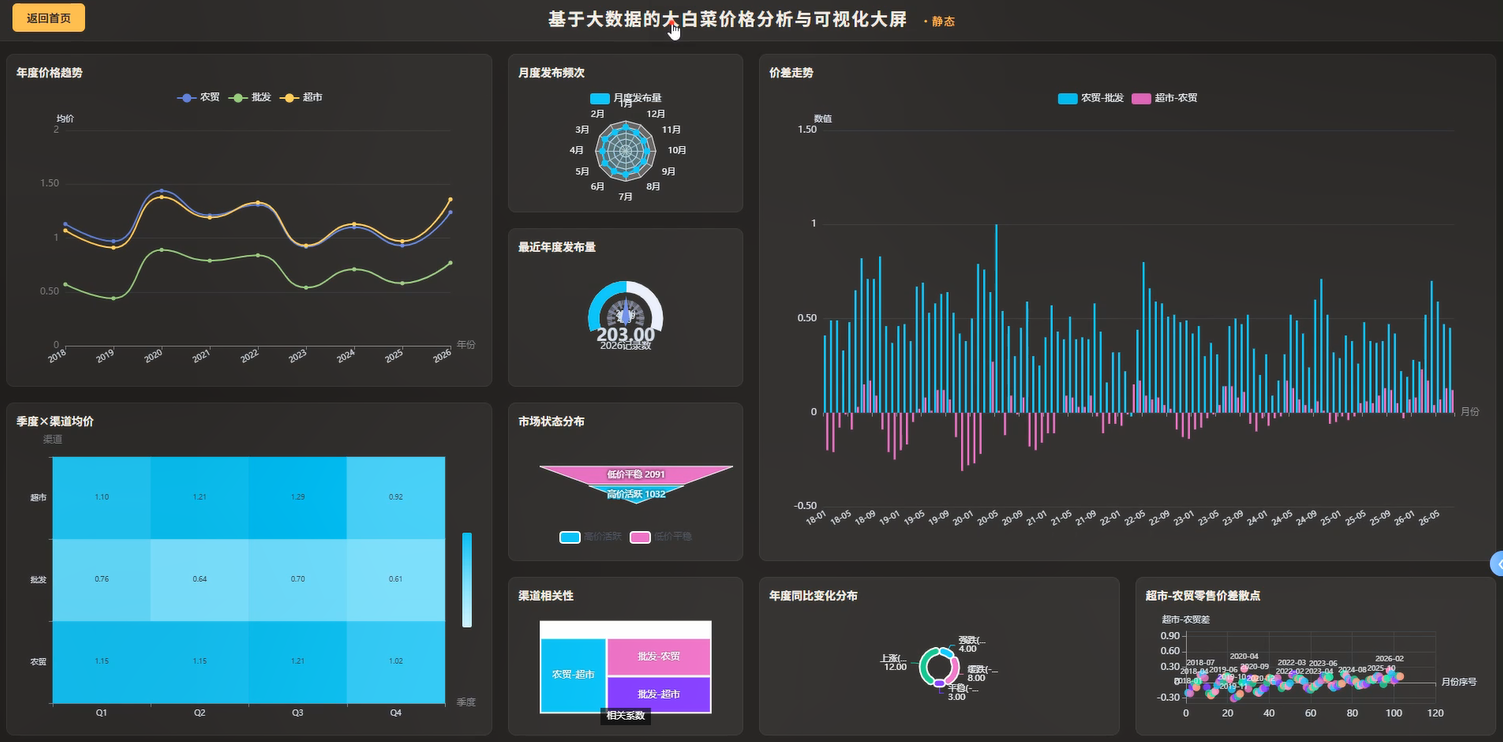
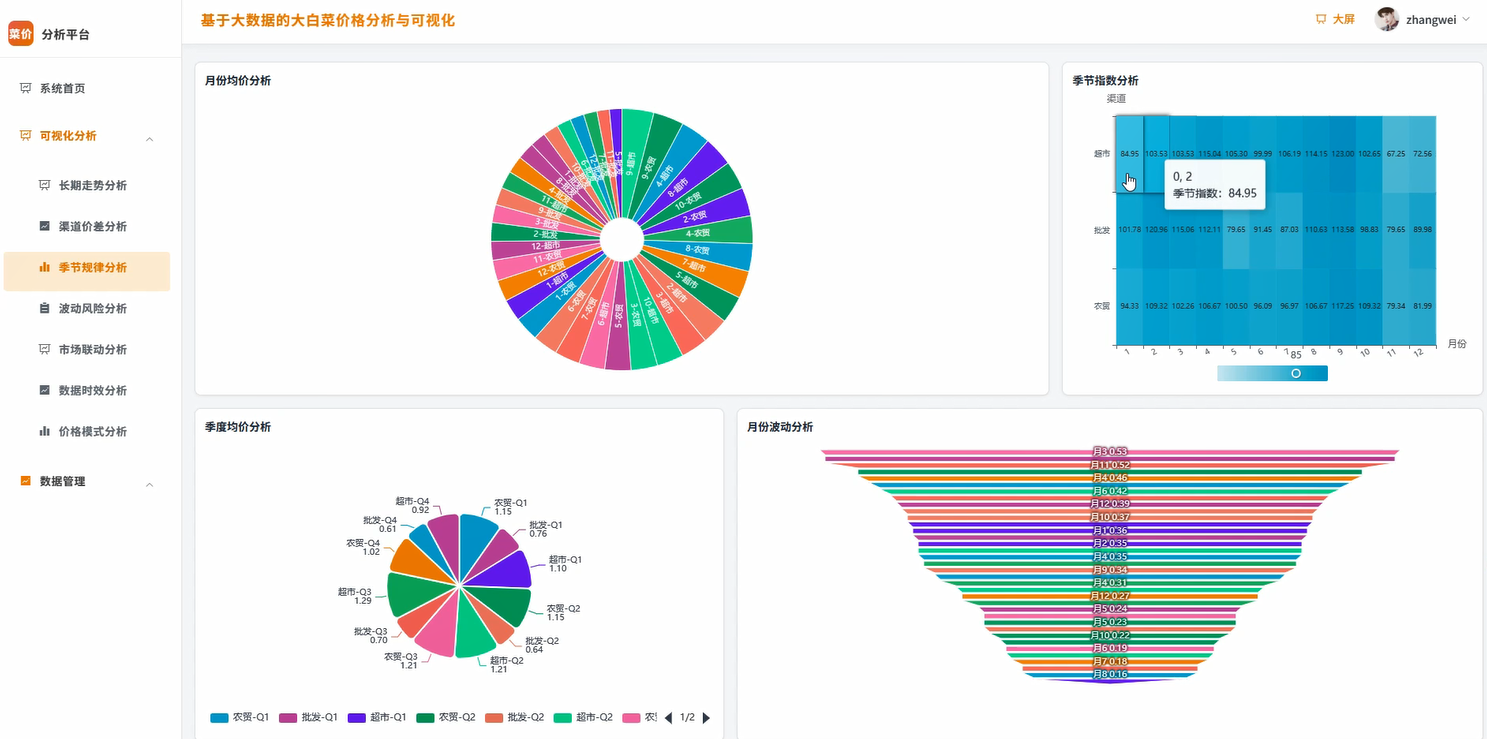
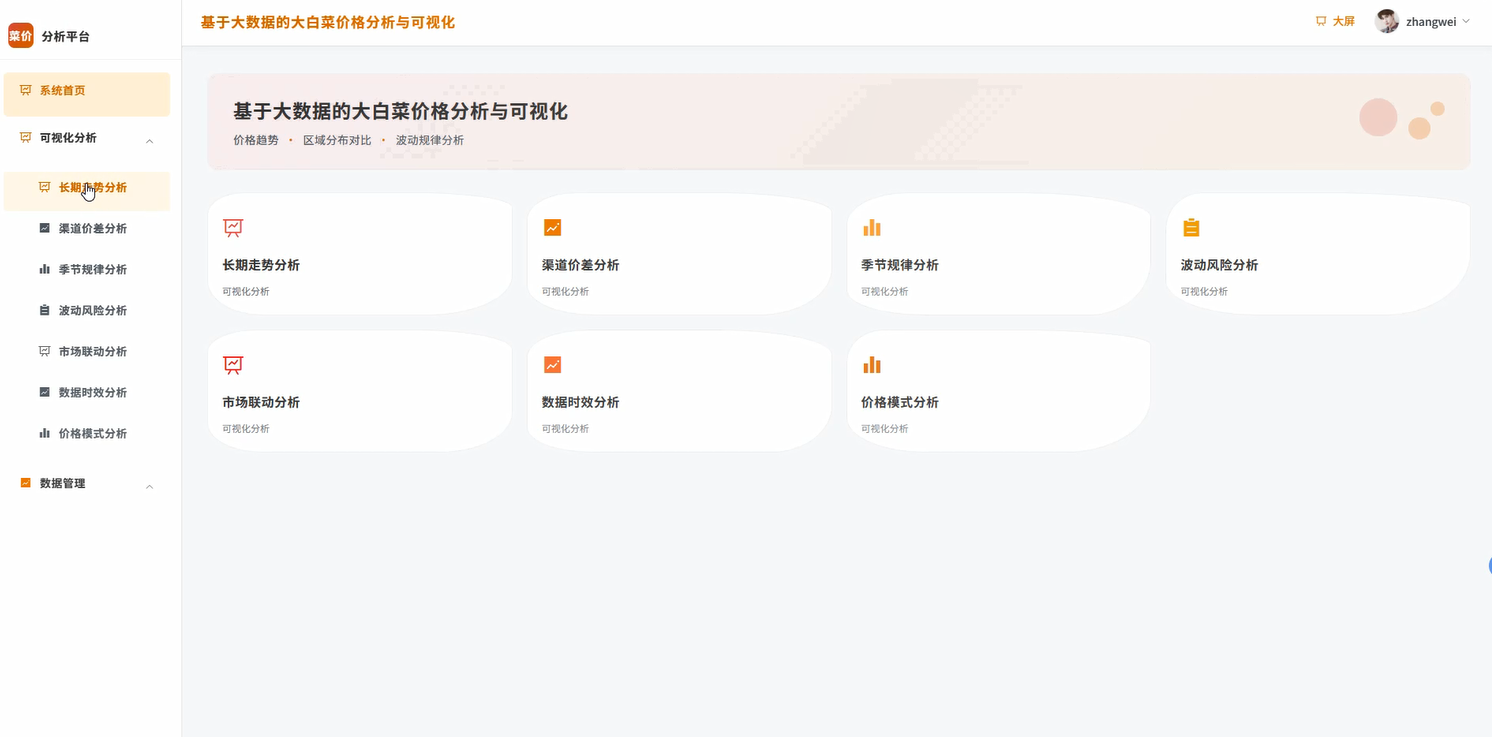
《基于大数据的大白菜价格分析与可视化》系统是一套面向计算机专业本科毕业设计的实战型数据分析平台,内置了覆盖近五年全国七大区域的大白菜每日交易价格数据集,涵盖产地价、批发价及零售价三类价格体系。技术实现上采用HDFS存储原始数据,利用Spark SQL完成月环比计算、年度同比分析、变异系数波动评估及市场联动检测等聚合任务。后端提供Python(Django)与Java(Spring Boot)双版本接口,前端配合ECharts实现价格走势折线图、季节箱线图及波动风险仪表盘等可视化组件。功能模块覆盖首页总览、长期趋势分析、渠道价差对比、季节规律挖掘、波动风险分级、市场联动分析、数据时效监控及价格模式识别等核心单元,配套数据管理后台支持增删改查与文件导入,形成完整的数据处理与展示闭环。
基于大数据的大白菜价格分析与可视化演示视频
基于大数据的大白菜价格分析与可视化演示图片
基于大数据的大白菜价格分析与可视化代码展示
from pyspark.sql import SparkSession
from pyspark.sql.functions import col, year, month, avg, stddev, round as spark_round, when
spark = SparkSession.builder.appName("CabbagePriceAnalysis").config("spark.sql.adaptive.enabled", "true").getOrCreate()
df = spark.read.option("header", "true").option("inferSchema", "true").csv("hdfs://localhost:9000/data/cabbage_price_raw.csv")
df_clean = df.filter(col("price").isNotNull()).filter(col("price") > 0).withColumn("year", year(col("trade_date"))).withColumn("month", month(col("trade_date")))
trend_df = df_clean.groupBy("year", "month").agg(spark_round(avg("price"), 3).alias("avg_price")).orderBy("year", "month")
trend_result = trend_df.collect()
for row in trend_result:
    print(f"{row['year']}年{row['month']}月均价:{row['avg_price']}元/公斤")
volatility_df = df_clean.groupBy("year").agg(spark_round(avg("price"), 3).alias("yearly_avg"), spark_round(stddev("price"), 3).alias("yearly_std")).withColumn("cv", when(col("yearly_avg") > 0, col("yearly_std") / col("yearly_avg")).otherwise(0)).withColumn("risk_level", when(col("cv") < 0.15, "低").when(col("cv") < 0.30, "中").otherwise("高"))
volatility_result = volatility_df.collect()
for row in volatility_result:
    print(f"{row['year']}年变异系数{row['cv']:.3f},风险{row['risk_level']}")
price_diff_df = df_clean.filter(col("price_type").isin(["产地价", "批发价"])).groupBy("trade_date", "region").pivot("price_type", ["产地价", "批发价"]).agg(avg("price")).withColumn("diff", spark_round(col("批发价") - col("产地价"), 3)).filter(col("diff").isNotNull()).orderBy(col("diff").desc())
price_diff_result = price_diff_df.collect()
for row in price_diff_result:
    print(f"{row['trade_date']}{row['region']}产地{row['产地价']}批发{row['批发价']}差价{row['diff']}")
spark.stop()
基于大数据的大白菜价格分析与可视化文档展示
💖💖作者:计算机毕业设计杰瑞
💙💙个人简介:曾长期从事计算机专业培训教学,本人也热爱上课教学,语言擅长Java、微信小程序、Python、Golang、安卓Android等,开发项目包括大数据、深度学习、网站、小程序、安卓、算法。平常会做一些项目定制化开发、代码讲解、答辩教学、文档编写、也懂一些降重方面的技巧。平常喜欢分享一些自己开发中遇到的问题的解决办法,也喜欢交流技术,大家有技术代码这一块的问题可以问我!
💛💛想说的话:感谢大家的关注与支持!
💜💜
网站实战项目
安卓/小程序实战项目
大数据实战项目
深度学校实战项目
计算机毕业设计选题推荐
转载自 CSDN-专业IT技术社区
原文链接:https://blog.csdn.net/2501_92994129/article/details/164732250

