

文章目录
在线体验:点击打开 TraceBack
做设备维修验收时,光看一份维修报告还不够。报告里写的报警时间、处理过程和恢复结论,都要和现场记录核对。麻烦在于,维修记录是 Word,监测数据是 Excel,报警信息可能只有一张截图,正常运行的标准又在另一份 PDF 里。
报告写着“已恢复正常”,就要去找当时的监测读数,再查规程里的标准;复测结果没填,也得在验收时找出来。即使发现了问题,还要把对应文件和原文位置整理好,否则别人接手时仍得从头翻。
我想做一个工具,把报告里“首次报警”“恢复正常”这些结论逐条拿出来,让监测表、报警截图和操作规程提供对应依据。发现矛盾后可以直接打开原文,缺少记录时就列出需要补充的材料。
我选择 TextIn xParse,是因为这个场景首先要解决多种格式材料的解析问题:Word 里的处理结论、Excel 里的监测读数、扫描件里的交接记录,都要放到一起核对。xParse 能统一处理这些材料,提取文本和表格,并提供可用于回查原文的位置信息;官方 CLI 也方便通过 WorkBuddy 接入 Python 流程,让我把开发精力集中在声明与证据的核对上。
这就是 TraceBack,一个以 TextIn xParse 作为文档解析入口的维修报告核验台。上传报告和相关文件后,程序按设备、时间和规程核对,生成带原文出处的结果清单。
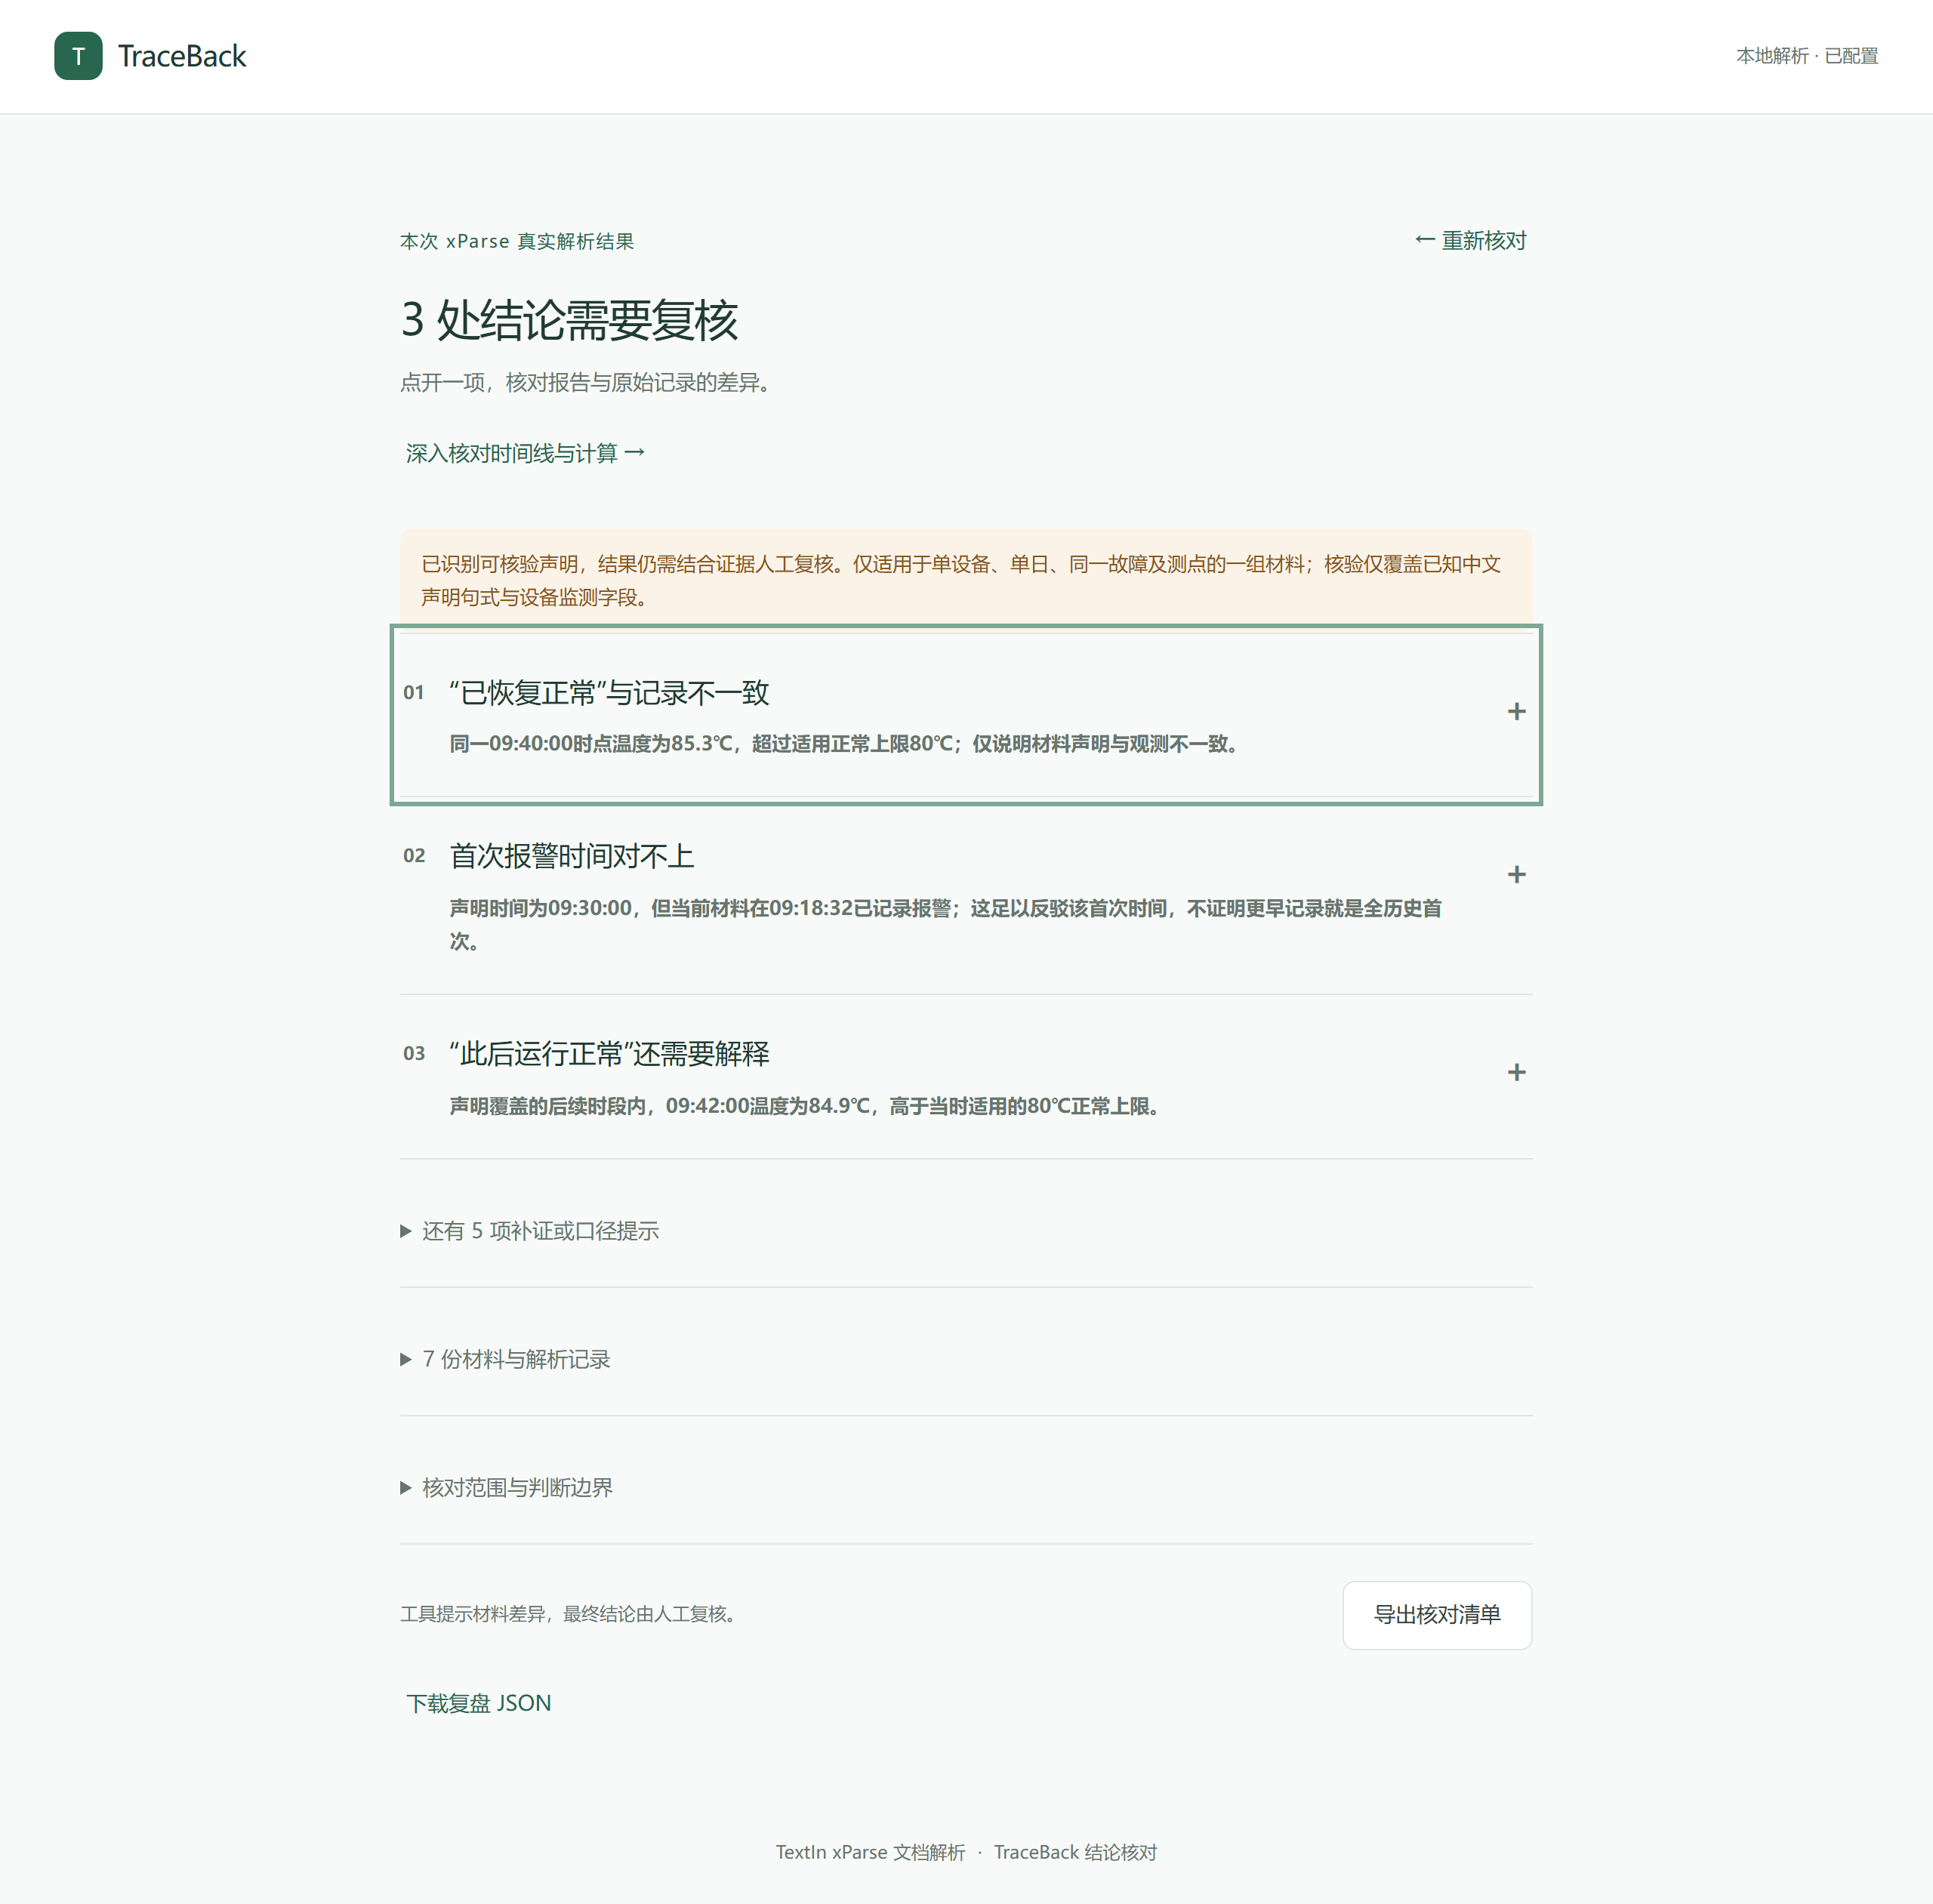
下面是七份材料的核对结果。三处需要复核的结论排在前面,点开就能查看依据:
本次核验使用的七份材料
本次核验使用了七份文件,包括 PDF、Word、Excel、扫描交接表和报警截图,共解析出12页内容:
| 材料 | 格式及解析页数 | 要从中找到什么 |
|---|---|---|
| 设备操作规程 | PDF,3页 | 正常温度上限、适用设备和生效日期 |
| 日常巡检记录 | XLSX,2页 | 巡检读数、发生时间与填写时间 |
| 值班交接记录 | 扫描 PDF,1页 | 勾选状态、现场读数是否填写 |
| 设备报警截图 | PNG,1页 | 报警时间、设备编号与当时读数 |
| 维修处理记录 | DOCX,2页 | 恢复声明、处置过程和阈值变更 |
| 环境监测数据 | XLSX,2页 | 自动记录的温度、流量和报警状态 |
| 异常事件报告 | PDF,1页 | 等待核验的汇总判断 |
这些文件记录的是同一台设备,但写法并不完全相同:工单里是 R-07,监测表里是 LAB-R07;处理完成时间和填表时间也分开记录。把设备和时间关联起来,后面的比较才有意义。
用 WorkBuddy 和 xParse 接通解析流程
这套工具需要先把不同格式的材料读出来。这里使用 TextIn xParse 的官方 CLI 统一解析,取得文本、表格以及可用的页码和位置字段,再交给 Python 代码关联设备、比较读数和核对规程。
开发时,我让 WorkBuddy 在终端执行项目里的批处理脚本,调用 xParse 解析七份材料,并保存每份文件的结果和请求标识:
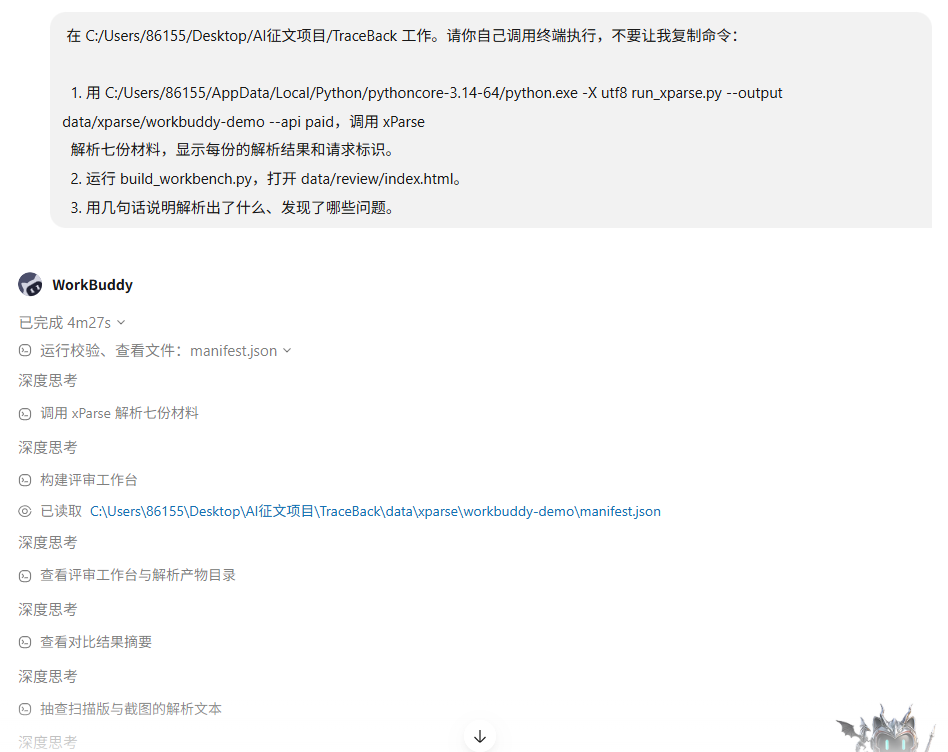
脚本通过 [email protected] 逐份获取结构化结果,下面是解析第一份规程时的实际命令:
npm exec --yes --package=xparse-cli@2.4.3 -- xparse-cli parse `
  "demo-materials/01_设备操作规程.pdf" `
  --api paid --view json --include-char-details `
  --output "data/xparse/workbuddy-demo/runs/20260926T134339-c99347c5/01"
这一批七份文件都解析成功,共12页,每份都有对应的请求记录:
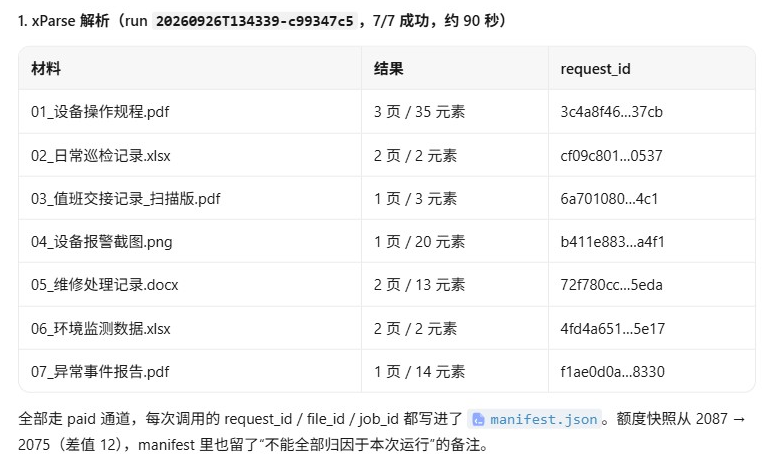
解析后的内容可以继续参与核对。例如,从 xParse 返回的监测表中取出09:40这一行,就能得到下面这些字段:
| 记录时间 | 设备编号 | 温度(℃) | 冷却水流量(L/min) |
|---|---|---|---|
| 2026-08-16 09:40:00 | LAB-R07 | 85.3 | 16.1 |
有了这些字段,程序就能把报告里的“09:40恢复正常”和同一时点的读数放在一起,再对照规程中的正常上限。整个处理过程是:
原始文件 → xParse解析 → 关联设备与时间 → 核对声明和记录 → 展示结果及原文依据。
上传材料,核对“09:40恢复正常”
打开工作台,多份材料可以一起选择,也能直接拖入。确认文件清单后,点击“用 xParse 解析并核对”,页面就会显示任务进度:
前端用 FormData 提交整组文件,并保存任务编号查询处理进度:
const body = new FormData();
selectedFiles.forEach(file => body.append('files',file,file.name));
const headers = {'X-Traceback-Token': capabilities.csrf_token};
const job = await api('/jobs',{method:'POST',headers,body});
jobId = job.id;
poll(token);
核验完成后,点开第一条“‘已恢复正常’与记录不一致”,查看核对说明,再展开“原文依据”。选中维修处理记录中的“设备已恢复正常。”片段,就能看到解析出的文字和原件中高亮的对应单元格。
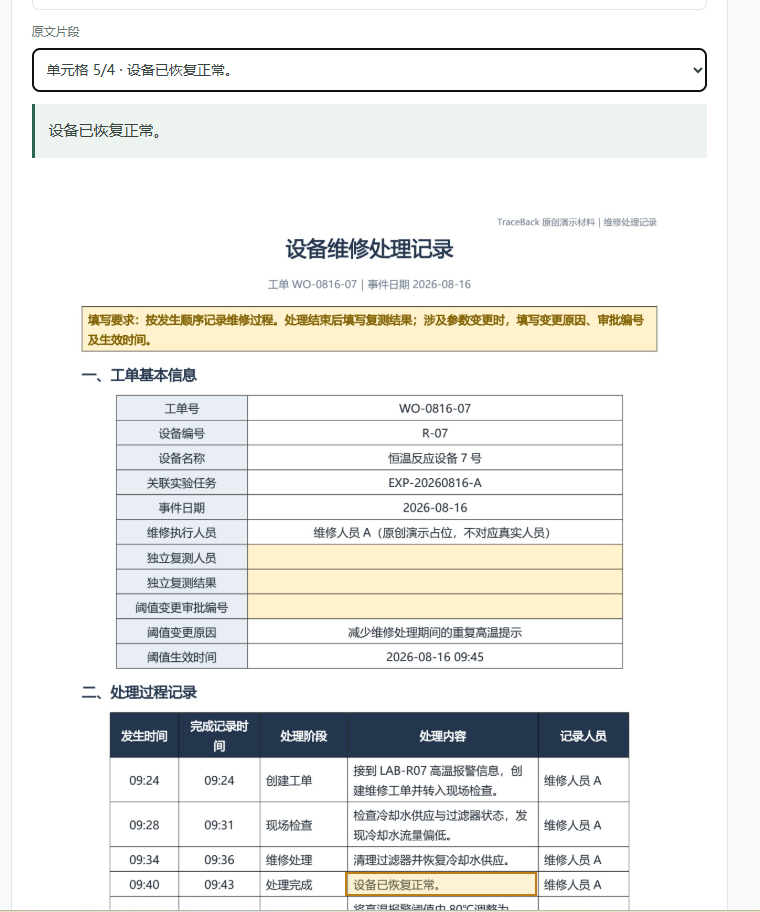
每条结论通过 evidence_ids 关联原文,前端按用户选择的文件找到对应片段:
const refs = (item.evidence_ids || [])
    .map(id => ({id,...result.evidence?.[id]})).filter(ref => ref.document_id);
const grouped = refs.filter(ref => ref.filename === evidenceFile);
const selected = grouped.find(ref => ref.id === evidenceId) || grouped[0];
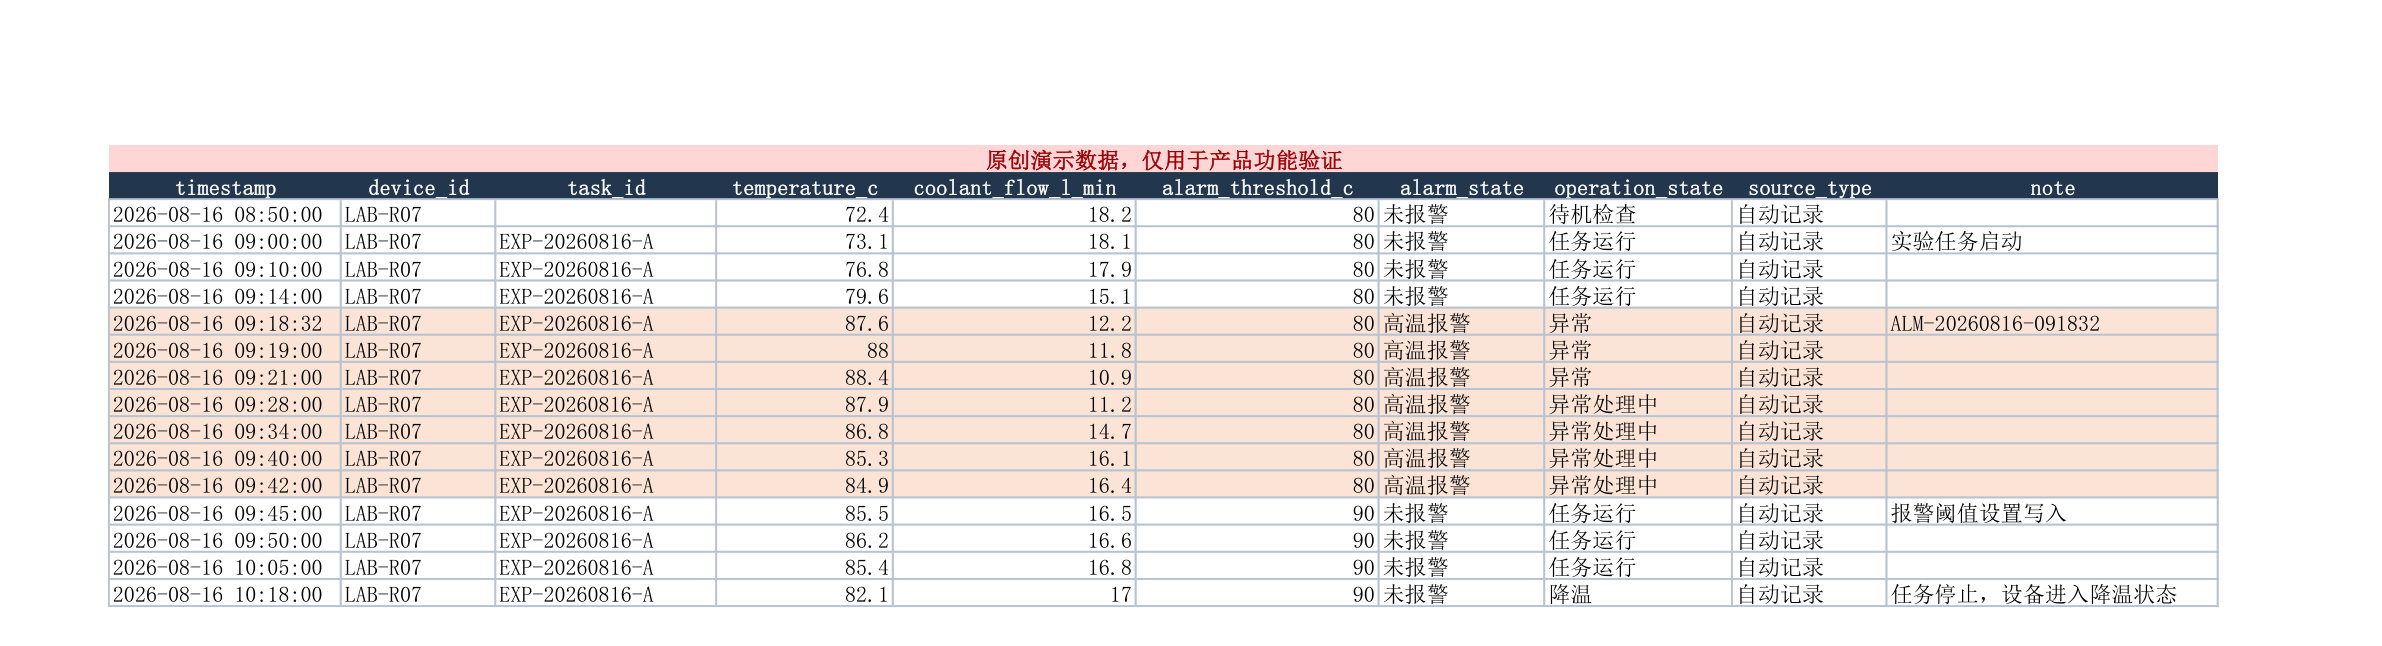
先看监测表,09:40这一行记录的温度是85.3℃,流量是16.1 L/min:
再看规程第2页,“正常运行参数”写的是温度不高于80℃:
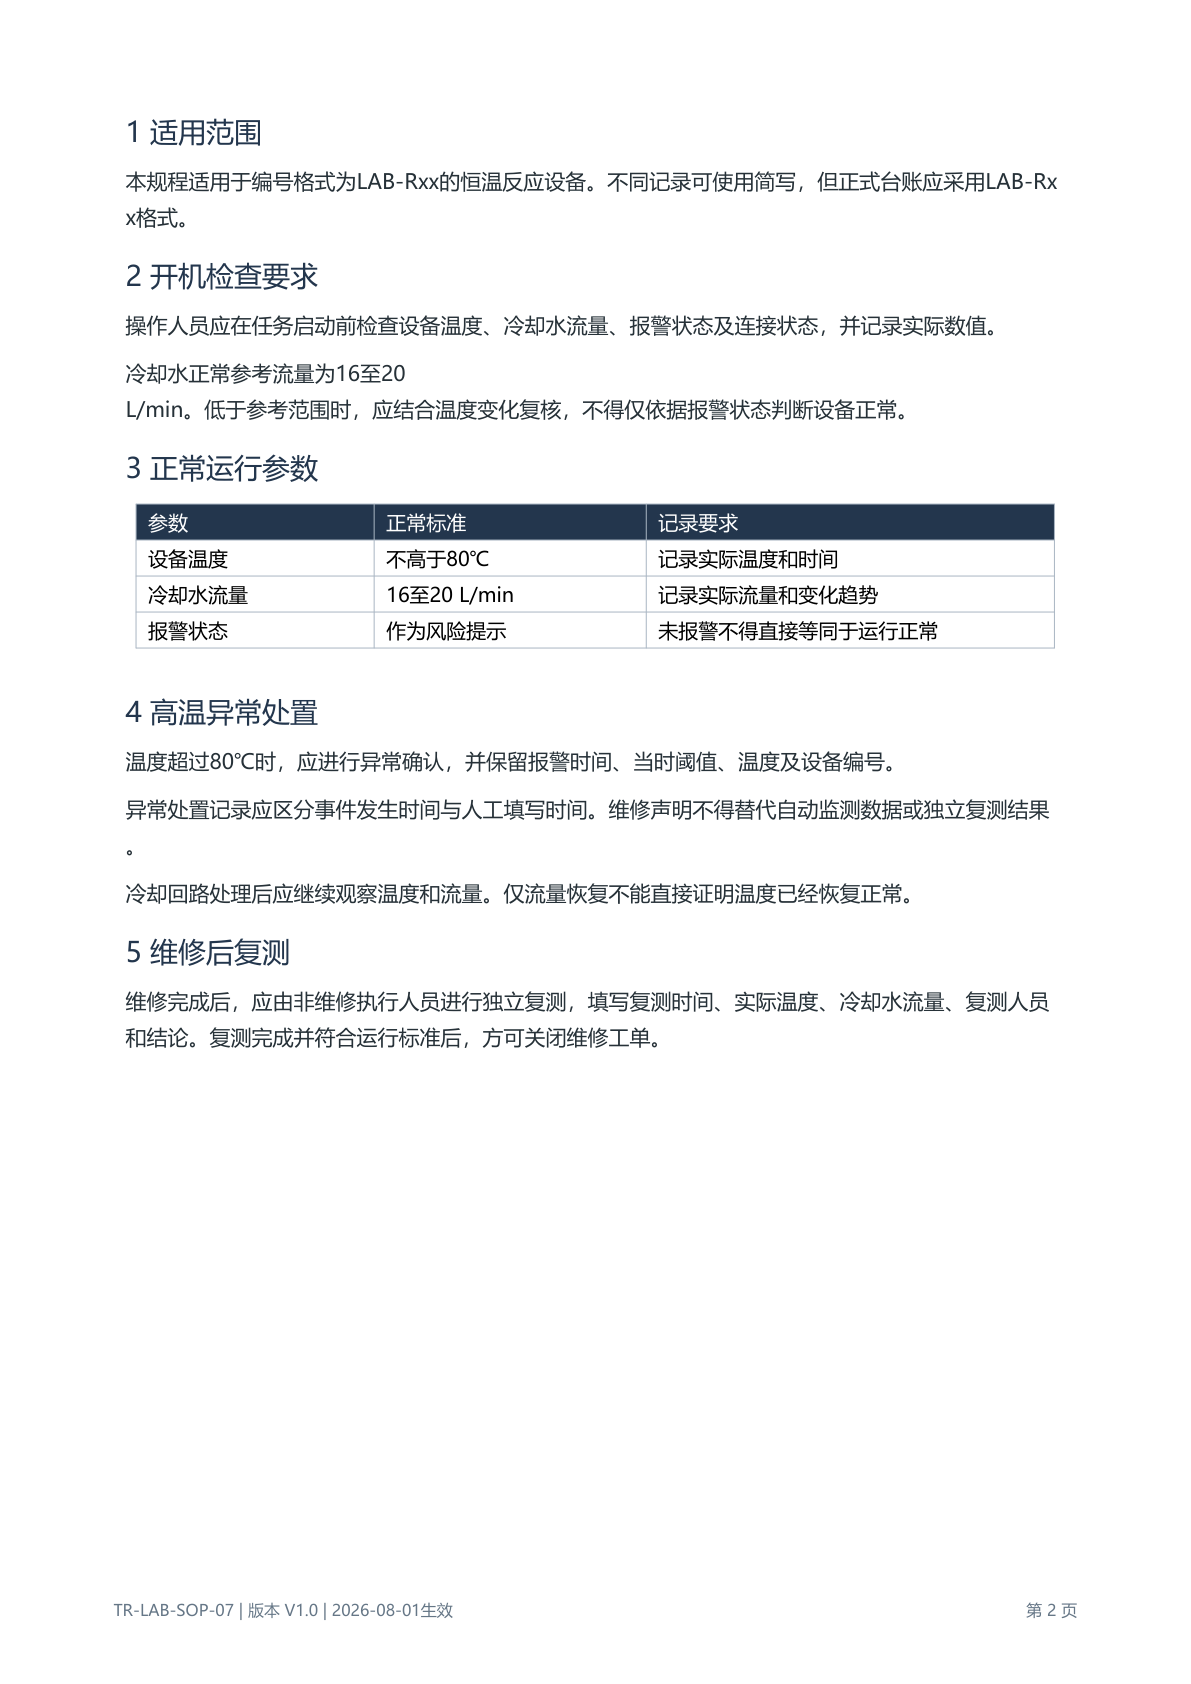
两份原件对上后,问题就清楚了:报告声称恢复正常,同一时刻的温度却高于规程上限。维修记录虽然在09:43填写,但处理完成时间是09:40,核对时仍要找09:40的读数。
设备、日期和适用规程匹配后,代码筛出同一时点超过上限的温度记录:
same = [item for item in candidates if item.time == claim.time and item.temperature is not None]
excess = [item for item in same if item.temperature > limit]
复核人员看到这条结果,可以带着监测值和规程条款要求重新核对恢复结论,再补查复测记录。问题在哪里、依据是什么,都集中在这条结果下面。
这批材料还发现了哪些问题
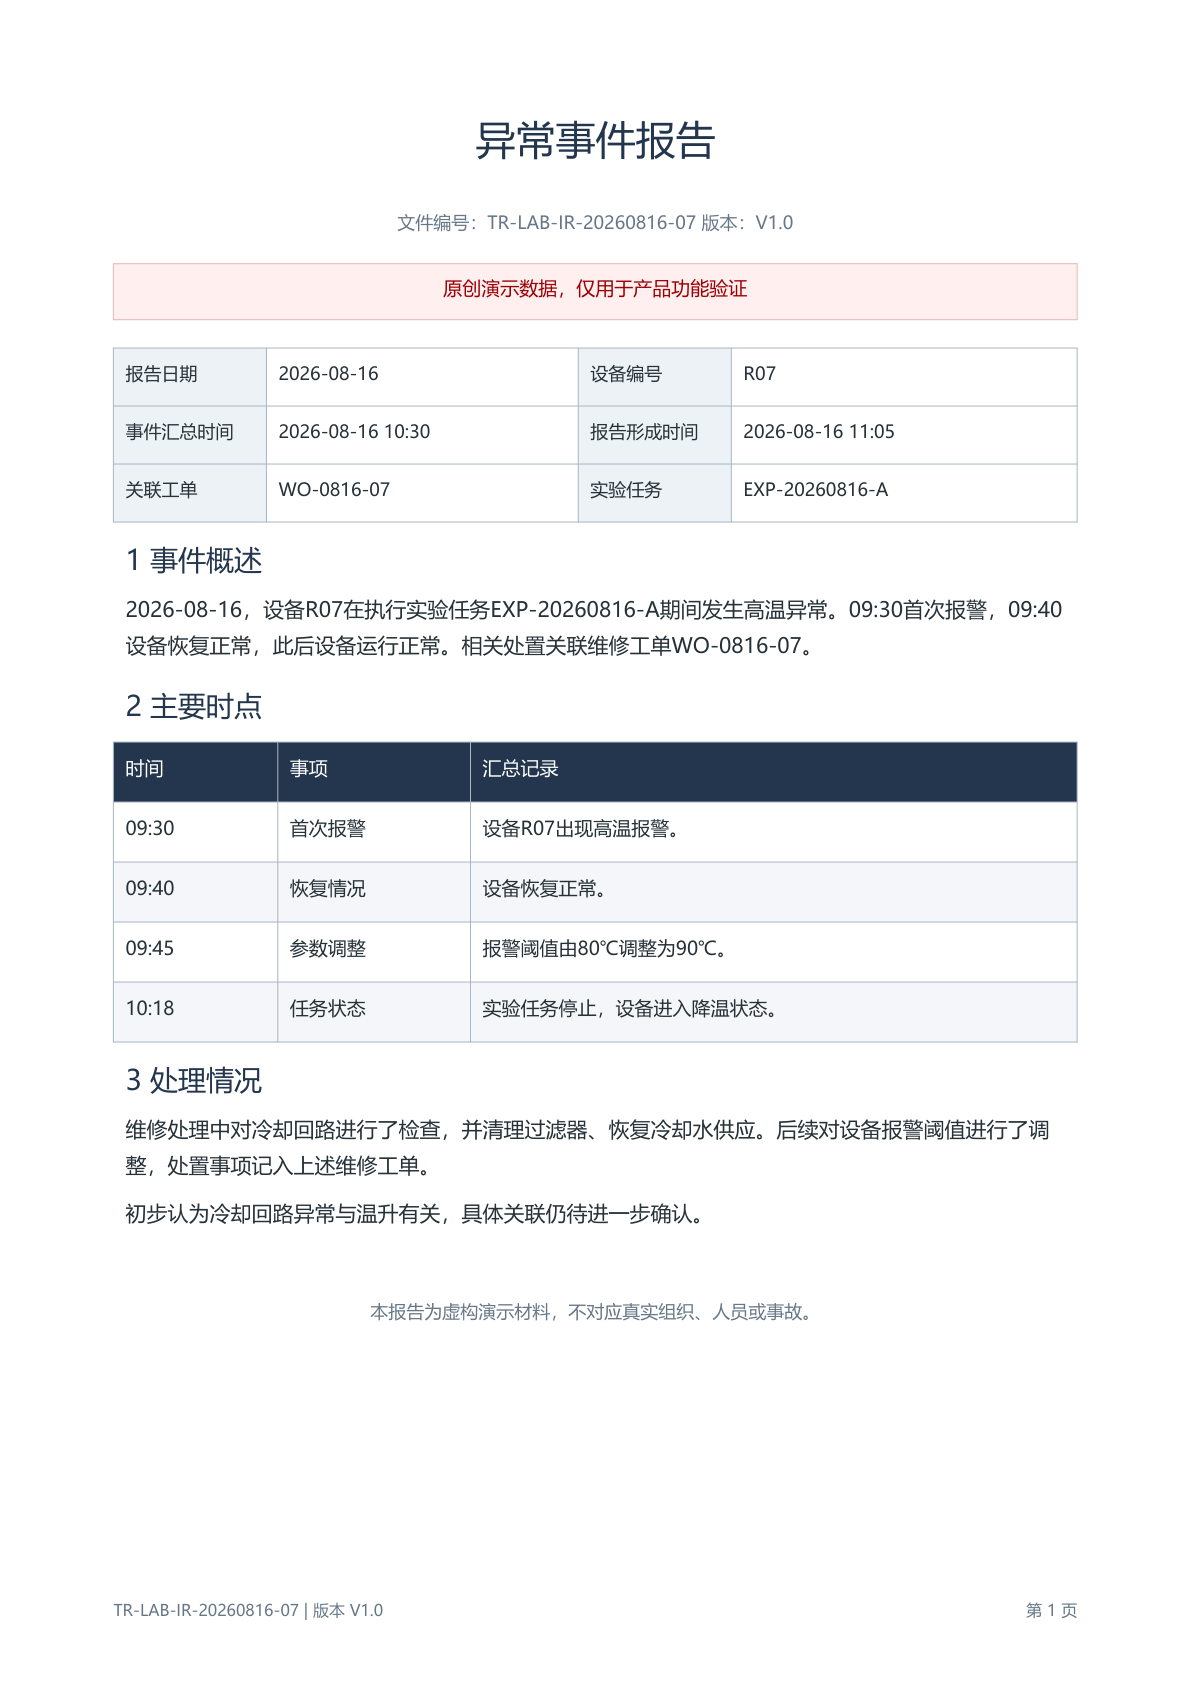
《异常事件报告》还写了“09:30首次报警”和“此后设备运行正常”:
报警截图显示,09:18:32,LAB-R07已经触发高温报警,温度87.6℃:
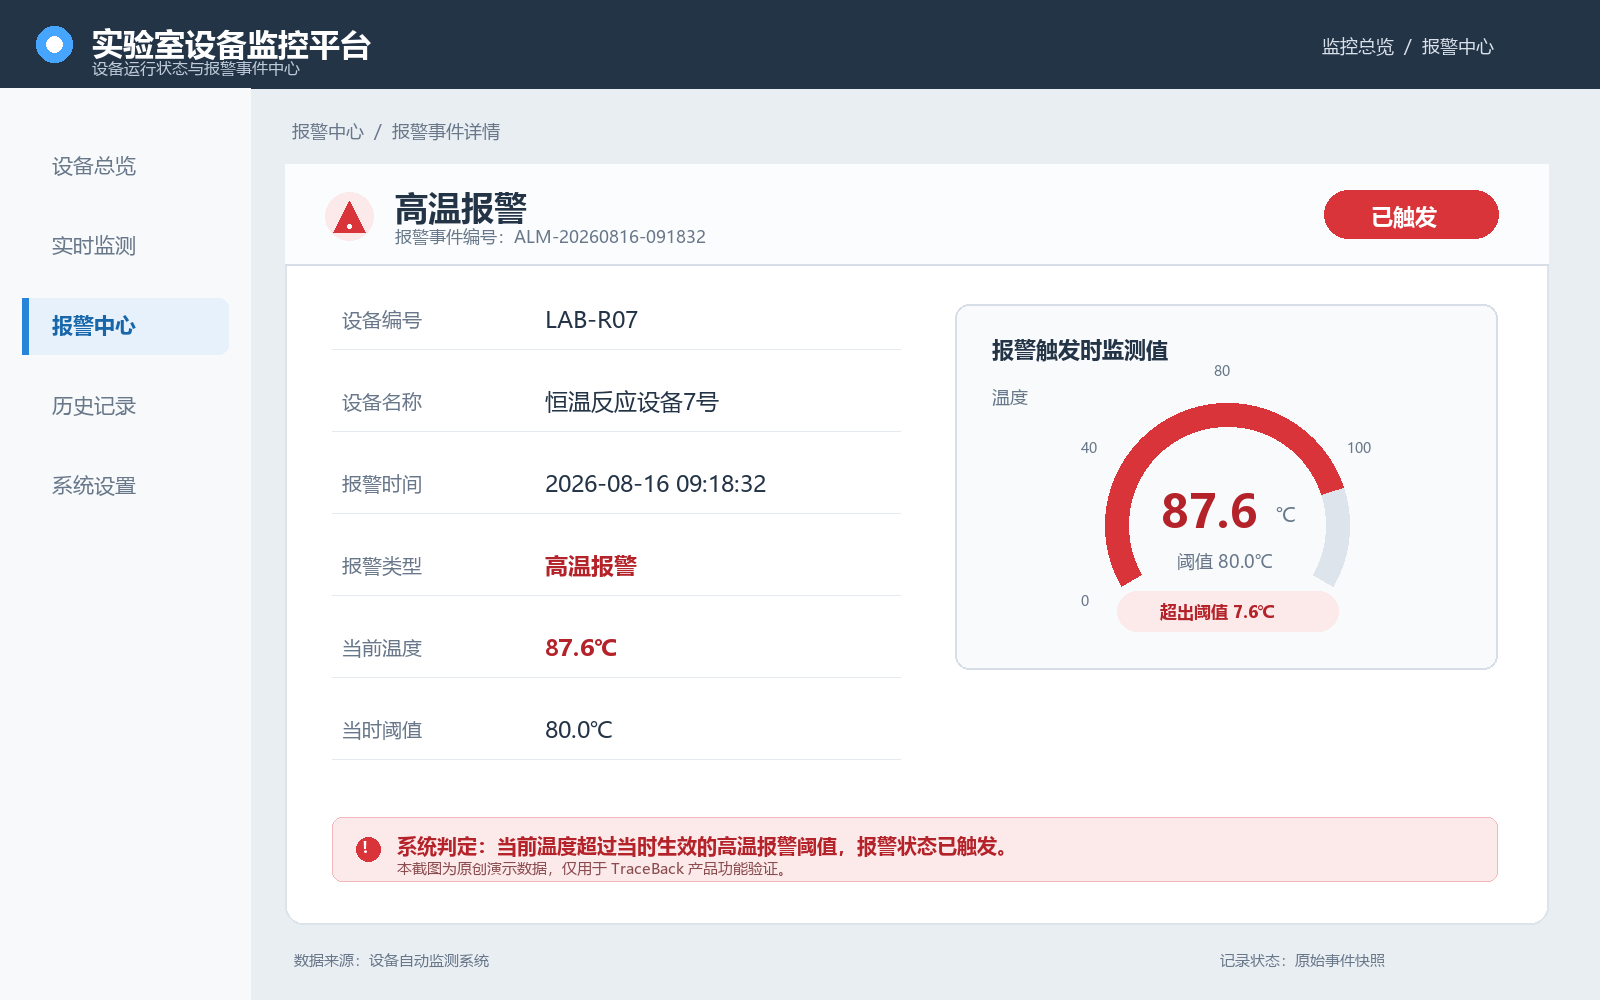
这条记录足以反驳“09:30首次报警”;完整历史日志尚未提供,所以结果保留为“存在更早反例”。“此后运行正常”也有对应的反例:监测表09:42的温度仍为84.9℃,高于80℃上限。
交接表反映的是另一类问题。09:25勾选了“设备无异常”,温度和冷却水流量却没有填写:
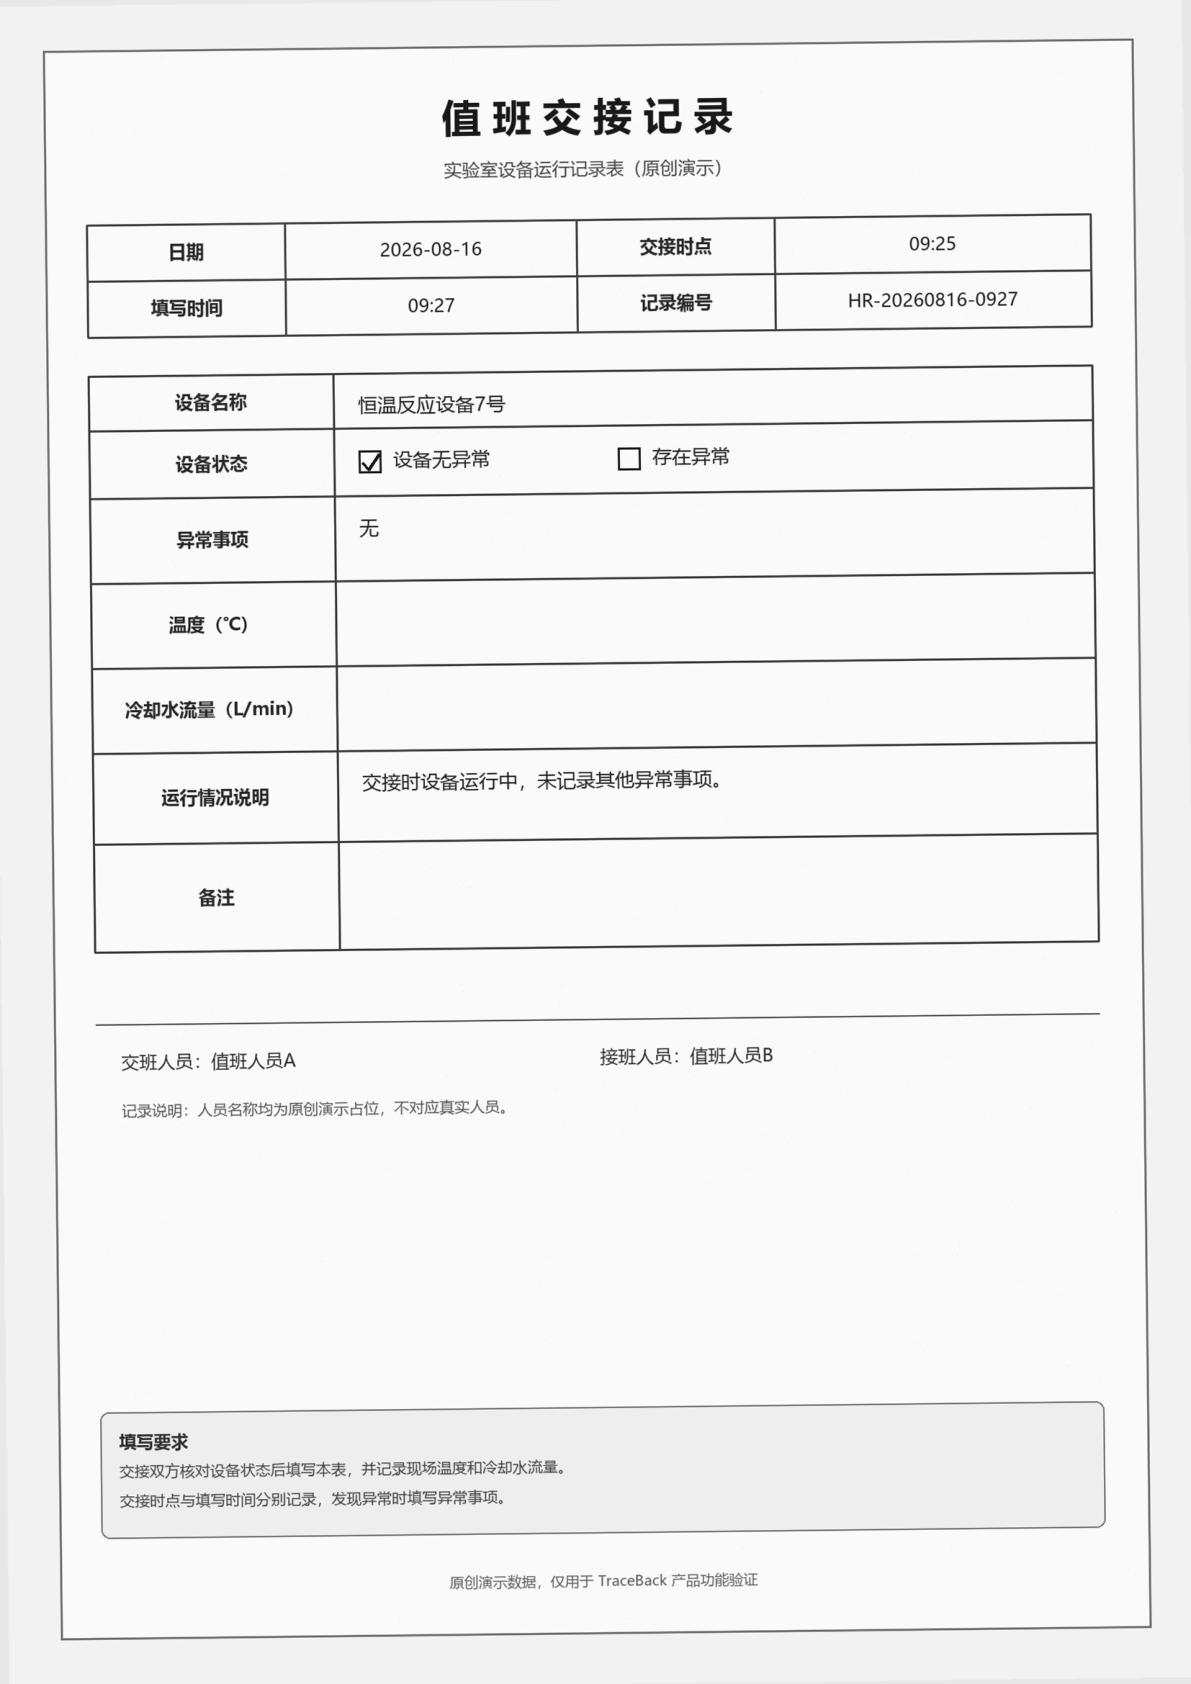
监测表里也没有09:25这个时点的记录,因此这一项列为“待核实”,提醒补充当时的读数或其他依据。
维修记录中,独立复测人员、复测结果、阈值变更审批编号同样空着,09:45又把报警阈值从80℃调到了90℃:
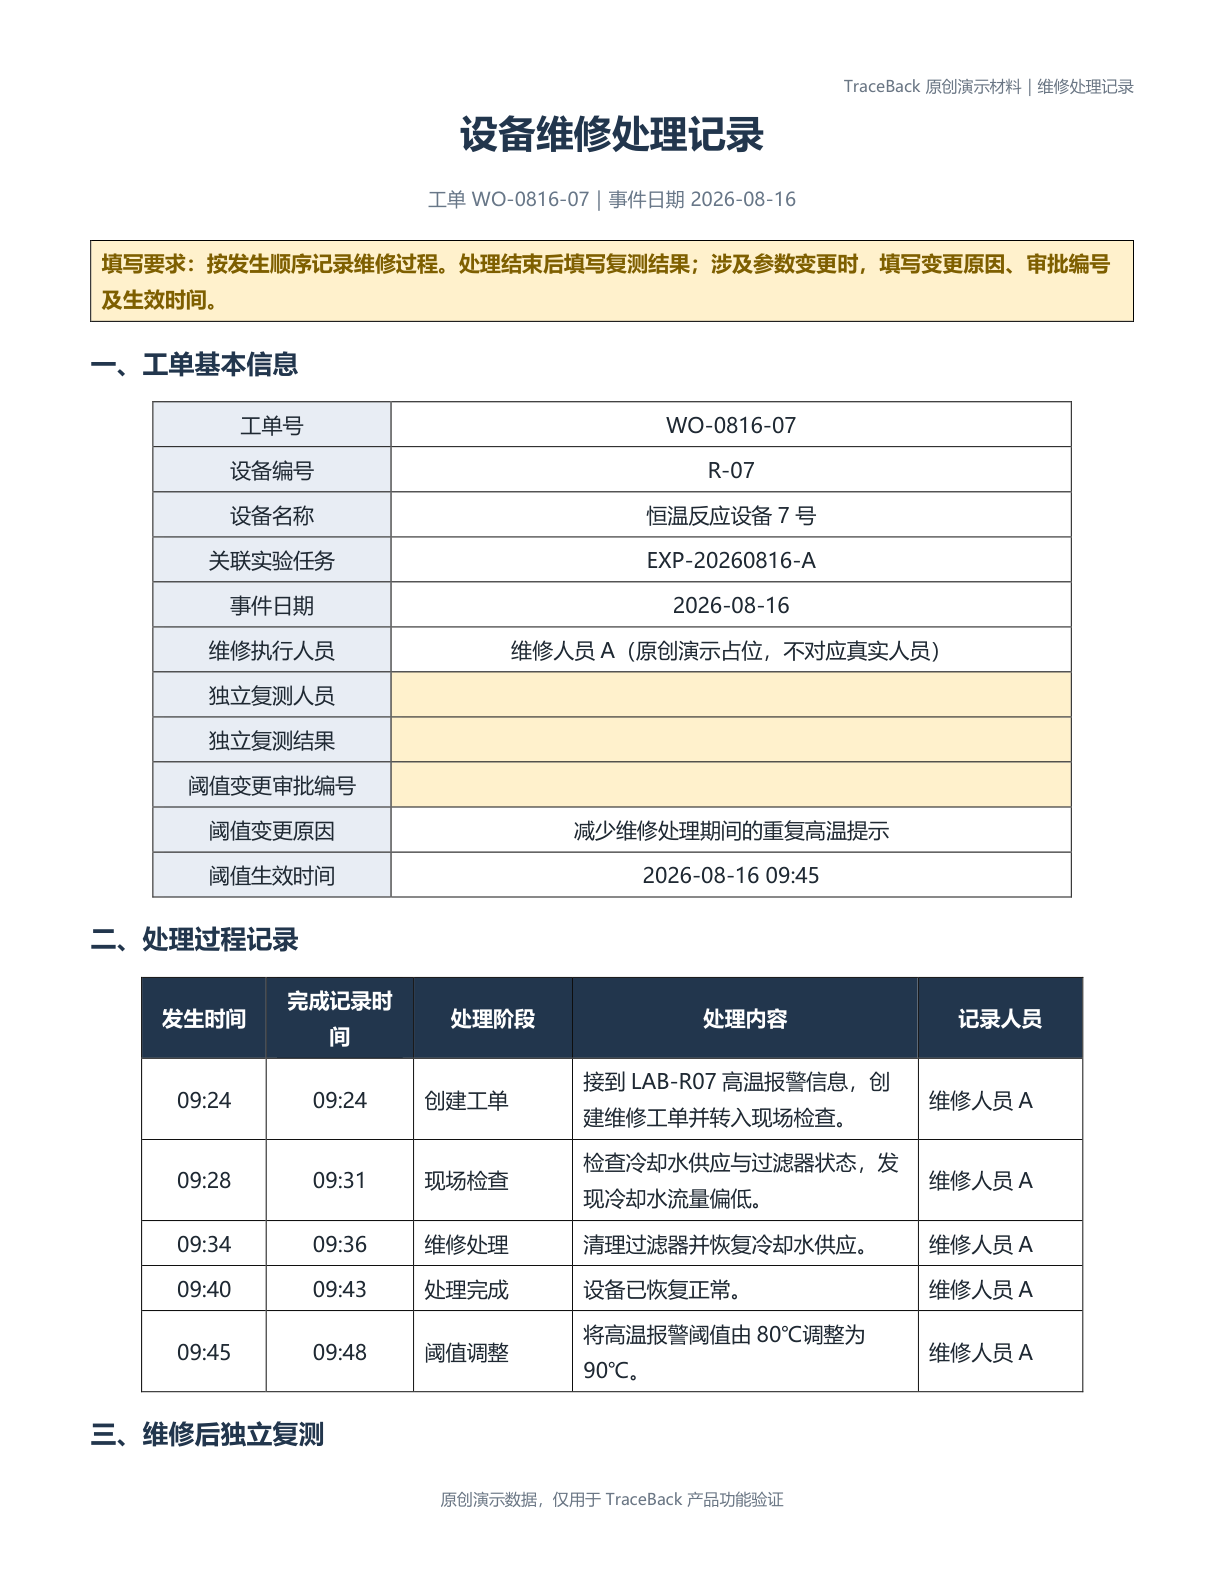
调高报警阈值后,09:50的86.2℃可能不再触发报警,但规程中的正常上限仍是80℃。工作台把这类标准差异单独提示,缺少的复测、审批记录则列入补充材料清单。
需要继续追查过程时,还可以打开“深入核对时间线与计算”。例如,流量从18.2降到10.9 L/min,降幅约40.1%;选取的是同一监测序列中任务启动前紧邻的待机读数和后续最低有效采样值。
代码用这两个有原文出处的读数计算降幅:
start, end = float(first['flow_l_min']), float(lowest['flow_l_min'])
percent = round((start - end) / start * 100, 10)
这个百分比描述两个采样点之间的变化,不能据此判断中间是否持续下降。
核验结果与处理方式的变化
这组材料最终得到3项明确冲突、1项待核实、3项字段缺口和1项口径提示。复核人员拿到的是一份可以逐项处理的清单:哪里需要解释,哪里需要补记录,哪里涉及标准差异,都有对应出处。
和逐份翻文件相比,工作台把几个原本分散的步骤放到了一起:
| 核对环节 | 逐份查看文件 | 使用 TraceBack |
|---|---|---|
| 查找相关记录 | 分别打开报告、监测表和规程,寻找对应时间与读数 | 在核验结论旁切换相关材料 |
| 整理问题依据 | 另行记录文件名、原文位置和判断理由 | 结果附带原文依据与核对说明 |
| 查找缺失材料 | 逐项检查复测、交接和审批栏 | 汇总字段缺口,提示需要补充的内容 |
材料是否齐全,也会影响工具能核对到哪一步。只纳入报告和纳入全部七份文件时,结果如下:
| 核对结果 | 仅纳入报告 | 纳入七份材料 |
|---|---|---|
| 可核验声明 | 3条 | 5条 |
| 明确冲突 | 0项 | 3项 |
| 待核实 | 0项 | 1项:09:25交接状态 |
| 字段缺口 | 3项 | 3项 |
| 口径提示 | 0项 | 1项:报警阈值与正常标准 |
| 时间线/计算 | 5条/0条 | 30条/37条 |
这组对照使用已有解析结果,只改变选入的材料。加入报警截图、监测值和规程后,报告中的三处冲突才有了可核对的依据。
另外,将报告里的两处“09:30”改成“09:18:32”、重新解析后,“首次报警”由冲突变为待证实,恢复声明和流量计算未受影响。修改材料后,结果也跟着更新,复核人员可以继续沿着补充后的记录往下查。
本地网页处理七份文件的一次完整任务约用了107秒,包含任务准备、解析和结果核验;打开原文后的人工复核未计入。目前尚未做人工计时对照,上表呈现的是处理方式的变化。
线上另跑的一次真实上传任务约用了12.387秒(批次20260929T154534-157dcf49),七份文件全部新解析、没有复用本地记录。这是和本地107秒相互独立的两次任务,环境与批次都不同,不用来表示提速或效率提升。
使用 TextIn xParse 的体会
这次做下来,TextIn xParse 让我觉得省心的地方,是多种格式的材料能走同一套解析流程。报告、电子表格和扫描件读出来后,后续开发就能集中在“哪些记录应该放在一起核对”上,这对把一个想法做成可用的小工具很有帮助。
表格解析也留下了比较好的印象。扫描交接表虽然有合并区域和空列,原始 JSON 里仍能找到09:25的交接时间、09:27的填写时间和记录编号;监测表中的温度、流量则直接参与了后续比较和计算。保留这些表格内容,让“核对恢复结论”有了具体可用的数据。
官方 CLI 接入 Python 批处理也很方便,WorkBuddy 在终端就能调用,原始 JSON 和请求标识还可以留作排查依据。对于文件格式混杂、需要逐项核对并回查原文的应用,xParse 是一个值得优先尝试的解析选择。在 TraceBack 里,它帮助把散落在文件中的内容组织成了一份带出处的核验清单,复核人员可以据此继续追问、补证和确认。
转载自 CSDN-专业IT技术社区
原文链接:https://blog.csdn.net/2401_84813926/article/details/166904024

