

用 Docker 部署服务的时候,我遇到过一个当时没想明白的现象:同一个镜像起了三个容器,往其中一个容器的 /app/data 目录写文件,另外两个容器完全看不到。但把镜像换成新版本重新构建,三个容器又都拿到了新代码。这两件事背后其实是两套不同的机制——镜像分层和卷挂载。搞不清它们的边界,排查问题时很容易往错误的方向找。
这篇文章不打算复述 Docker 文档,而是从文件系统层面把这两件事拆开看。下面所有命令都可以直接跑,存储驱动以 overlay2 为例(这是目前主流 Linux 发行版上 Docker 的默认驱动,可以用 docker info | grep "Storage Driver" 确认自己的环境)。
先看镜像到底存在哪
镜像不是一个 tar 包躺在磁盘上,而是被拆成了若干层,每层对应 Dockerfile 里的一条指令。可以先拉一个小镜像看看实际情况:
docker pull alpine:3.19
docker image inspect alpine:3.19 --format '{{json .RootFS.Layers}}' | python3 -m json.tool
输出是一个数组,每个元素是一个层的 digest。层数取决于镜像怎么构建的。alpine 这种官方精简镜像层数不多,但一个典型的 Python 应用镜像,从基础镜像到 pip install 再到 COPY . .,层数会明显增加。
这些层在宿主机上的落地位置,取决于存储驱动。overlay2 的情况下通常在 /var/lib/docker/overlay2/:
sudo ls /var/lib/docker/overlay2/ | head
每个目录下面一般有 diff、link、lower、merged、work 这几个子目录。diff 是这一层实际的文件内容,lower 记录了它下面压着哪些层,merged 是把多层叠起来之后的合并视图。这里能看到一个关键点:镜像层本身是只读的,多个容器共享同一份底层数据。
分层叠加:读时合并,写时复制
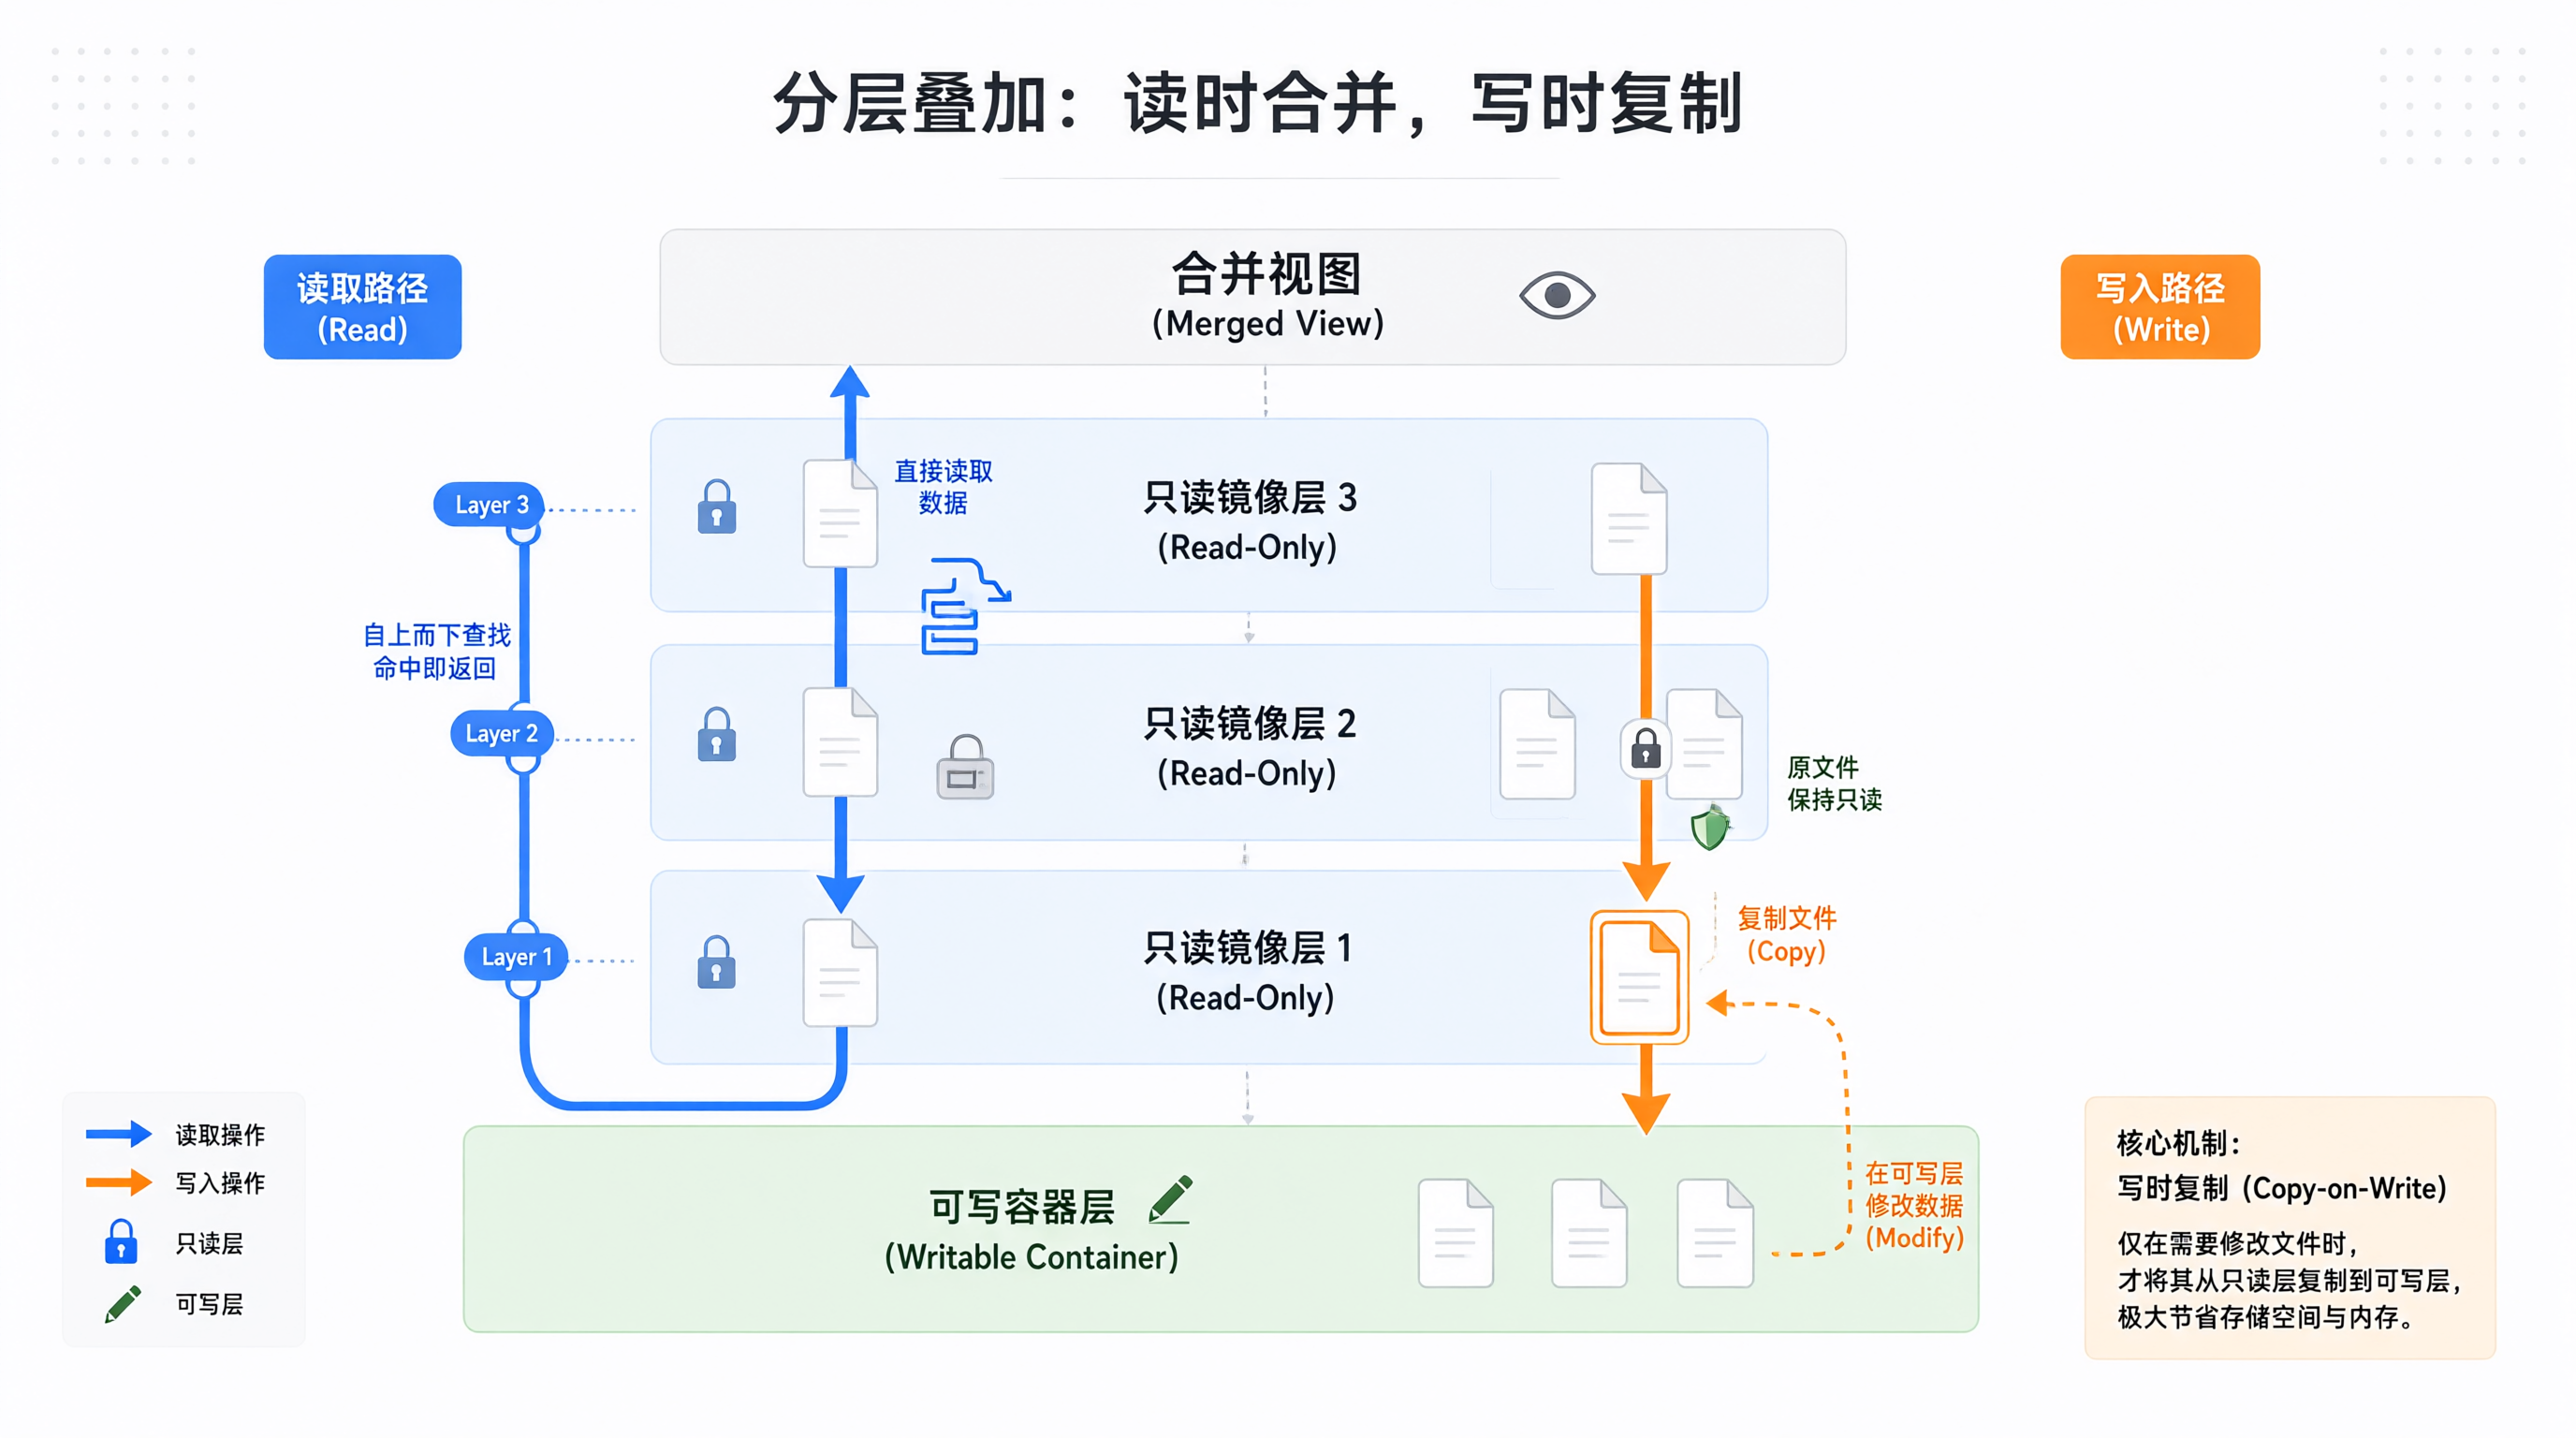
容器启动后,Docker 会在所有镜像层之上再加一个可写的容器层。读文件的时候,overlay2 从上往下找,找到第一个匹配的就返回;写文件的时候,如果文件在只读层里,就先把它复制到可写层再改。这就是常说的 Copy-on-Write(CoW)。
这个行为可以直接验证。先起一个容器:
docker run -d --name demo1 alpine:3.19 sleep 3600
docker exec demo1 sh -c 'echo hello > /tmp/test.txt'
然后在宿主机上找这个文件。容器层对应的是 overlay2 里某个目录的 diff,可以这样定位:
docker inspect demo1 --format '{{.GraphDriver.Data.UpperDir}}'
执行后会打印出容器可写层的实际路径。进去看一眼:
sudo ls -l <上面输出的路径>/tmp/
应该能看到 test.txt。这说明容器里新写的文件,物理上就落在宿主机这个目录里。
再验证 CoW:往一个镜像里已存在的文件写内容,看看会发生什么。alpine 里 /etc/hostname 是存在的,改它:
docker exec demo1 sh -c 'echo changed > /etc/hostname'
sudo ls -l <UpperDir>/etc/
这时候 /etc/hostname 会出现在可写层的 diff/etc/ 下——因为它原本在只读层,写入触发了复制。而如果只是读 /etc/passwd 不改,可写层里就不会有它。
【关键结论】镜像层共享且只读,容器层独立且可写。同一镜像起 N 个容器,镜像数据只有一份,容器层各有一份。这就是为什么改一个容器的文件不影响其他容器。
这个机制带来一个实际影响:容器里删文件并不会真的释放磁盘。用 rm 删掉镜像层里的文件,overlay2 采用的是 whiteout 机制,在可写层放一个特殊标记,底层数据还在。所以频繁在容器里增删大文件,容器层会越来越胖,镜像本身不受影响。
卷挂载:绕过叠加层
容器层可写,但生命周期跟着容器走,容器删了数据就没了。要在容器之间共享数据,或者让数据持久化,就得用卷。Docker 里有两类容易混淆的方式:volume 和 bind mount。
先看 volume:
docker volume create mydata
docker run -d --name demo2 -v mydata:/data alpine:3.19 sleep 3600
docker exec demo2 sh -c 'echo persisted > /data/file.txt'
volume 的实际路径可以通过 inspect 拿到:
docker volume inspect mydata --format '{{.Mountpoint}}'
通常在 /var/lib/docker/volumes/mydata/_data。进去能看到 file.txt。
再看 bind mount,直接把宿主机某个目录挂进去:
mkdir -p /tmp/hostdata
docker run -d --name demo3 -v /tmp/hostdata:/data alpine:3.19 sleep 3600
docker exec demo3 sh -c 'echo fromcontainer > /data/file.txt'
cat /tmp/hostdata/file.txt
宿主机上能直接看到容器写的文件。
这里有个容易忽略的细节:挂载点会覆盖容器内该路径原有的内容。比如镜像里 /data 本来有文件,一旦把卷挂到 /data,容器里看到的就是卷的内容,镜像里的那份被遮住了。这不是删除,只是被挂载点挡住了。把挂载去掉,原内容又回来了。这一点在排查"文件怎么不见了"的时候特别有用。
两种方式的区别整理一下:
| 方案 | 优点 | 缺点 | 适用场景 |
|---|---|---|---|
| volume | 由 Docker 管理,跨平台一致,权限问题少,适合生产 | 路径不直观,需 inspect 才能定位 | 数据库数据、应用持久化目录 |
| bind mount | 路径明确,宿主机可直接编辑 | 依赖宿主机目录结构,权限/路径差异大,可移植性差 | 本地开发挂代码、挂配置文件 |
三种写入路径的对比实验
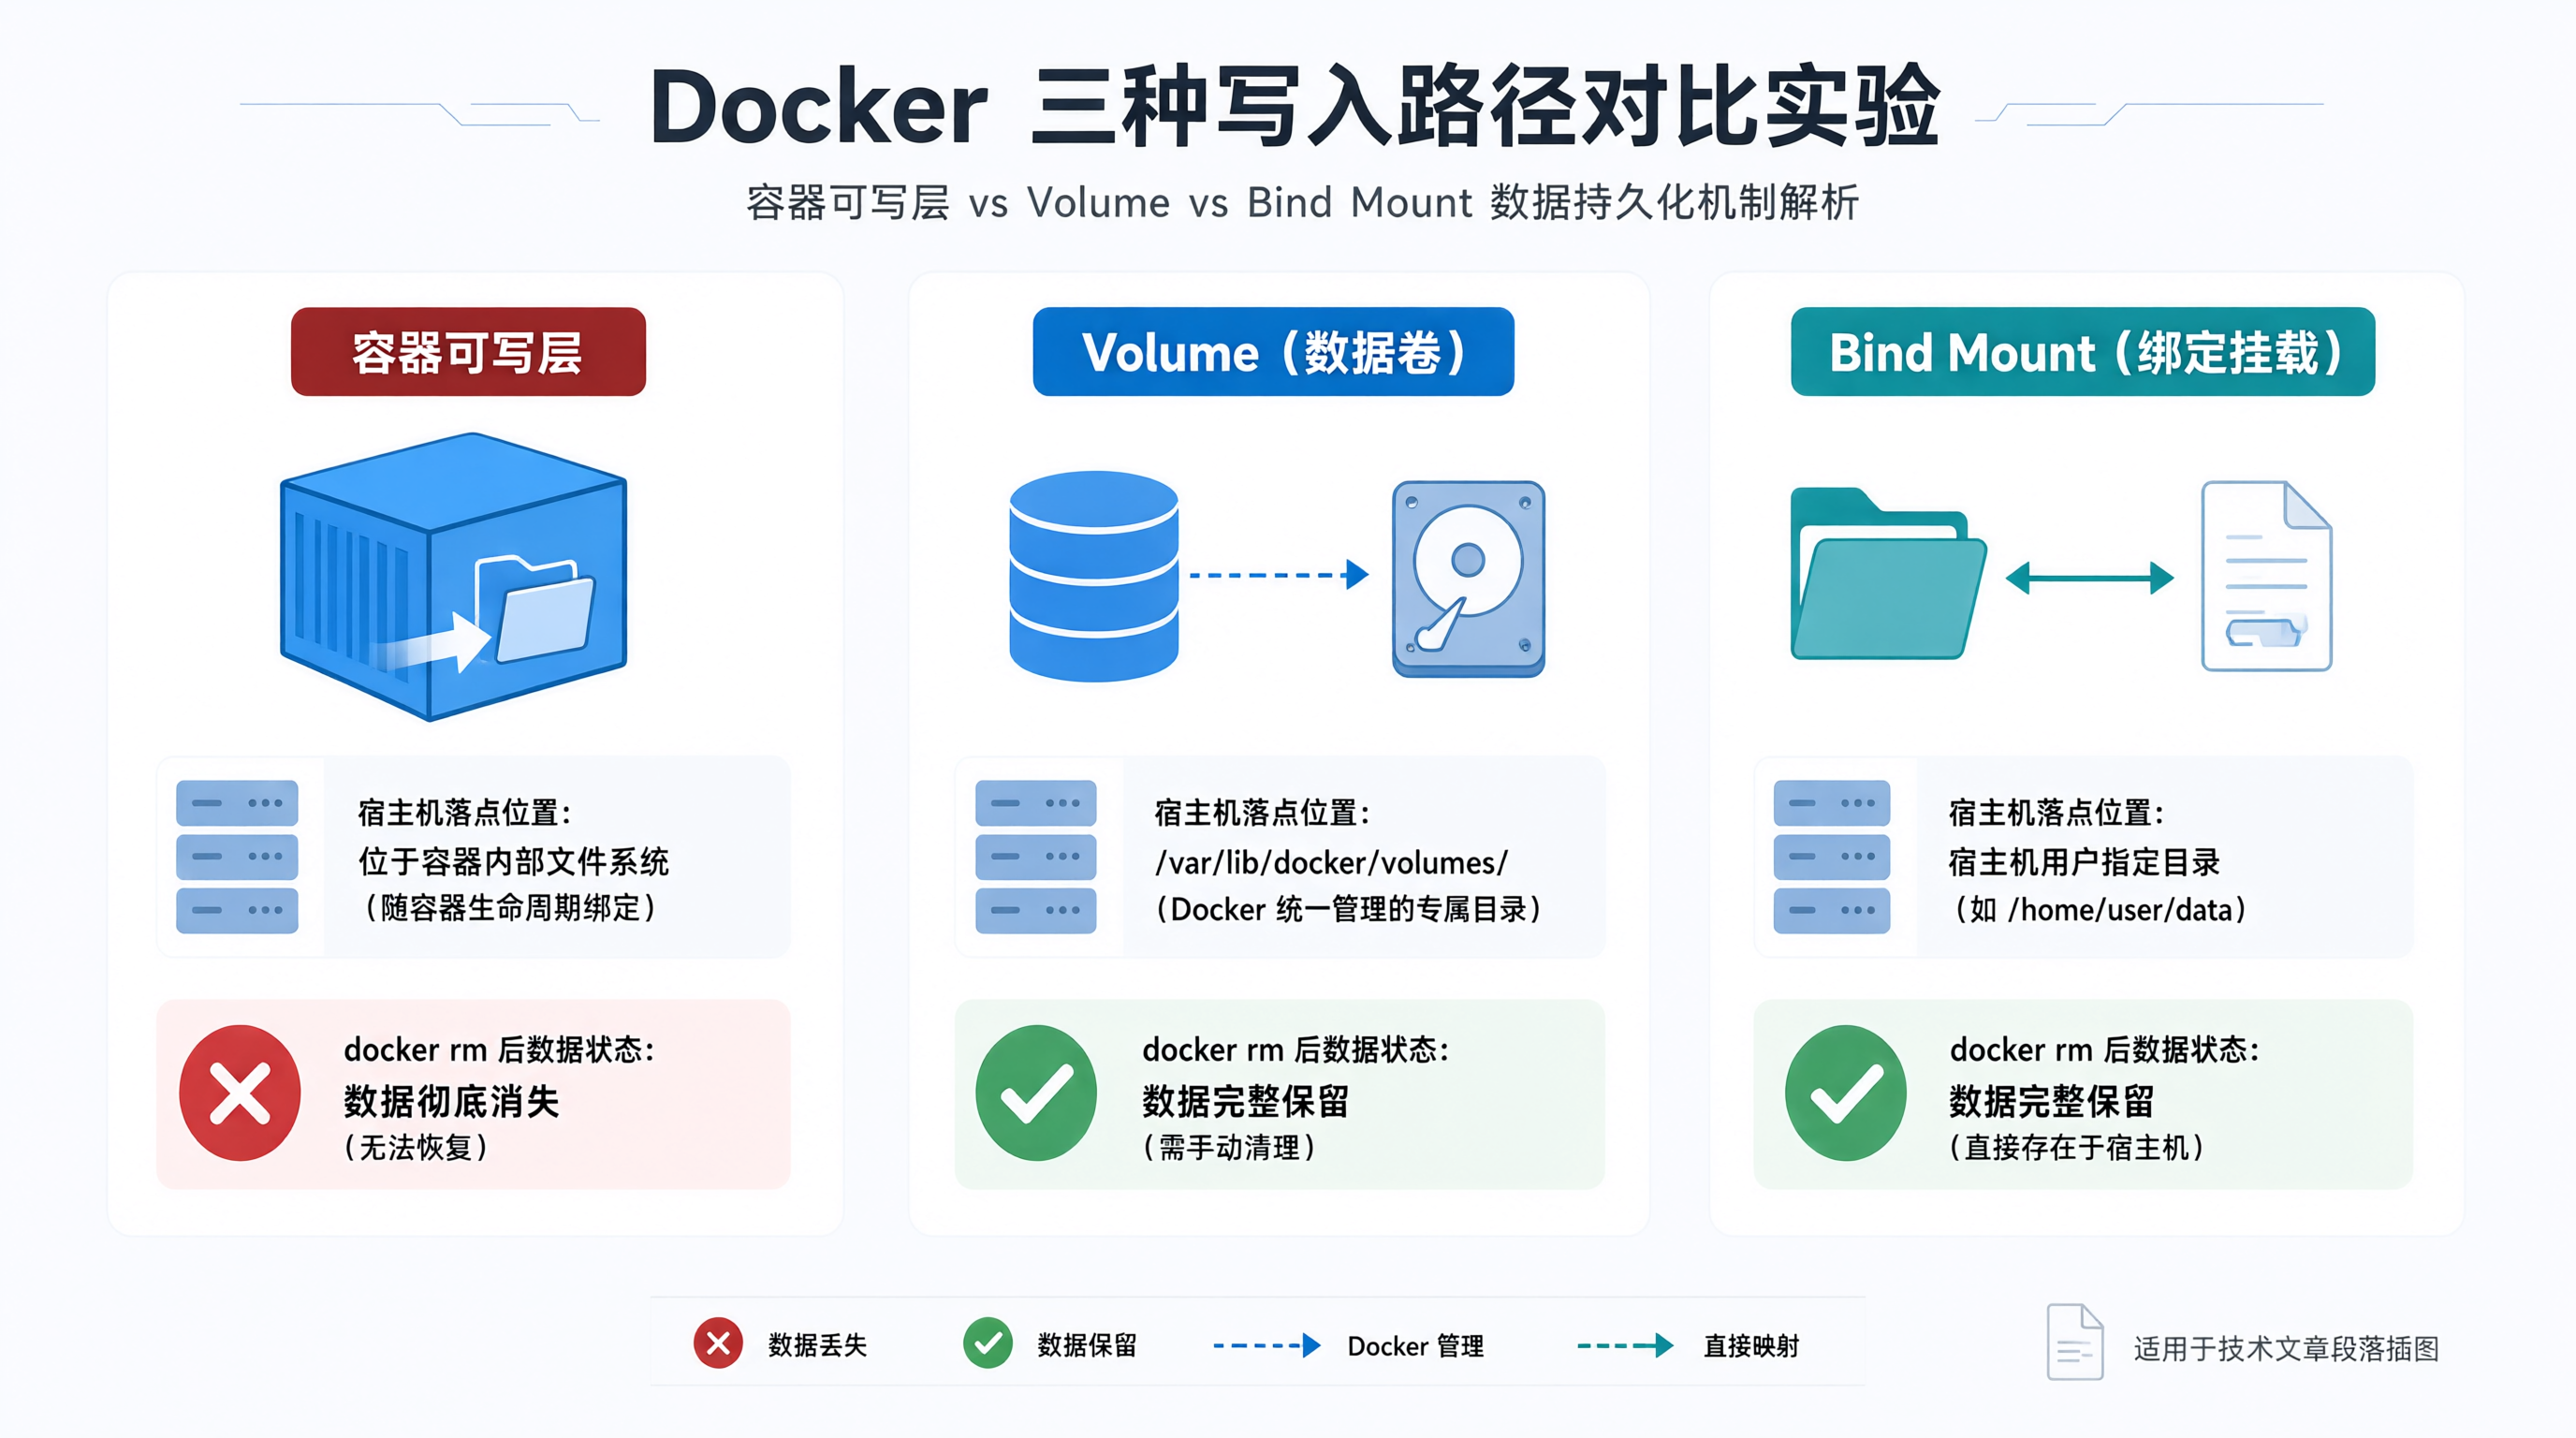
把上面几种情况放一起,能更清楚数据到底落在哪。设计一个对照:分别往容器可写层、volume、bind mount 写文件,然后看宿主机上的位置和容器删除后的表现。
# 1. 只写容器层
docker run --name t1 alpine:3.19 sh -c 'echo a > /root/a.txt'
# 2. 写 volume
docker run --name t2 -v voltest:/root alpine:3.19 sh -c 'echo b > /root/b.txt'
# 3. 写 bind mount
mkdir -p /tmp/bindtest
docker run --name t3 -v /tmp/bindtest:/root alpine:3.19 sh -c 'echo c > /root/c.txt'
三个容器跑完就退出了(没有 -d,命令执行完容器停止)。现在把它们删掉,再看数据:
docker rm t1 t2 t3
sudo cat /var/lib/docker/volumes/voltest/_data/b.txt   # 还在
cat /tmp/bindtest/c.txt                                 # 还在
# t1 的 a.txt 随着容器删除一起没了
【踩坑提醒】容器层的数据在 docker rm 之后会一起被清理。如果只是 docker stop,容器层还在,数据还在,docker start 起来能看到。真正丢数据是发生在 rm 的时候。所以把数据库这种需要持久化的东西放在容器层,是迟早要出问题的。
volume 的好处在这里体现出来:它的生命周期独立于容器,容器删了卷还在,新容器挂上同一个卷就能接着用。这也是为什么官方推荐生产环境用 volume 存数据。
一个容易搞混的点:volume 和 bind mount 的写法
-v 的两种写法长得像但含义不同:
-v mydata:/data          # mydata 不是绝对路径 → 当成 volume,Docker 管理
-v /tmp/hostdata:/data   # 以 / 开头 → 当成 bind mount,用宿主机路径
以 / 开头就是 bind mount,否则是 volume。这个规则在 --mount 语法里更明确:
--mount type=volume,source=mydata,target=/data
--mount type=bind,source=/tmp/hostdata,target=/data
--mount 写法更啰嗦,但意图清楚,不会因为少写一个 / 就把 bind mount 变成 volume。我个人在脚本里更倾向用 --mount,出问题的概率低一些。
关于性能的一点说明
overlay2 的 CoW 在写大文件时会有额外开销,因为要先复制。这一点在容器里跑数据库、频繁写大文件时能感觉到。把数据目录挂成 volume 能绕开这个复制过程,因为 volume 直接落在宿主机文件系统上,不经过叠加层。
不过具体差多少,取决于文件大小、写入模式和底层文件系统,我没有做过系统的基准测试,这里不下定量结论。只能说方向上,持久化数据走 volume 比留在容器层更合适。
收尾
把这两件事理清楚之后,很多现象就不奇怪了:
- 容器间数据不共享,是因为各自有独立的可写层。
- 重建镜像后所有容器都更新,是因为它们共享同一批只读镜像层,镜像换了层也就换了。
- 挂载卷后文件"消失",是被挂载点遮住了,不是真删了。
- 容器删了数据没了,是因为数据写在了容器层而不是卷里。
排查这类问题时,先问一句"这个文件在容器层、volume 还是 bind mount 里",基本能定位大半。剩下的就是去对应的宿主机路径看实际内容。docker inspect 拿 UpperDir 和 Mountpoint 这两个字段,是我用得最多的两个入口。
有一块我还没深入:overlay2 之外,btrfs、zfs 这些驱动的层管理方式不太一样,CoW 的实现和性能特征也不同。如果后面有环境,可以单独测一轮再做对比。
=备用标题=
- Docker 镜像分层与卷挂载实测:容器里的文件到底写到了哪
- 从 overlay2 看 Docker 存储:镜像层、容器层与卷的关系
- Docker 数据持久化怎么选:容器层、volume 与 bind mount 对比
- 一次搞懂 Docker 镜像分层和 CoW:附可复现验证步骤
- Docker 容器里的文件为什么删不掉也丢不了:存储机制拆解
转载自 CSDN-专业IT技术社区
原文链接:https://blog.csdn.net/2402_83344867/article/details/167223161

