

AI人声分离神器 PYMSS:支持300+模型,音频分离与修复一键完成
SEO关键词: PYMSS教程、AI人声分离工具、音频分离软件、MelBand Roformer、HT Demucs 4、AI伴奏提取、ComfyUI音频工作流、音频修复模型、AI音乐制作、人声伴奏分离软件。
大家好 这里是「代码简单说」,欢迎大家关注同名公众号,不定时更新更多实用有趣的教程 也欢迎大家在评论区一起讨论交流!~
前言
如果你经常处理音乐、翻唱、配音、短视频剪辑或者AI音频项目,那么一定接触过人声分离工具。
我之前介绍过几个比较热门的AI音频分离软件:
- UVR(Ultimate Vocal Remover)
- MSSST
- PYMSS
其中 UVR 5.6 已经很久没有更新了,目前新模型的适配速度也明显落后,因此现在更推荐使用后面两款工具。
而今天要介绍的 PYMSS,可以说是目前非常值得关注的新一代AI音频分离工具。
一、什么是PYMSS?
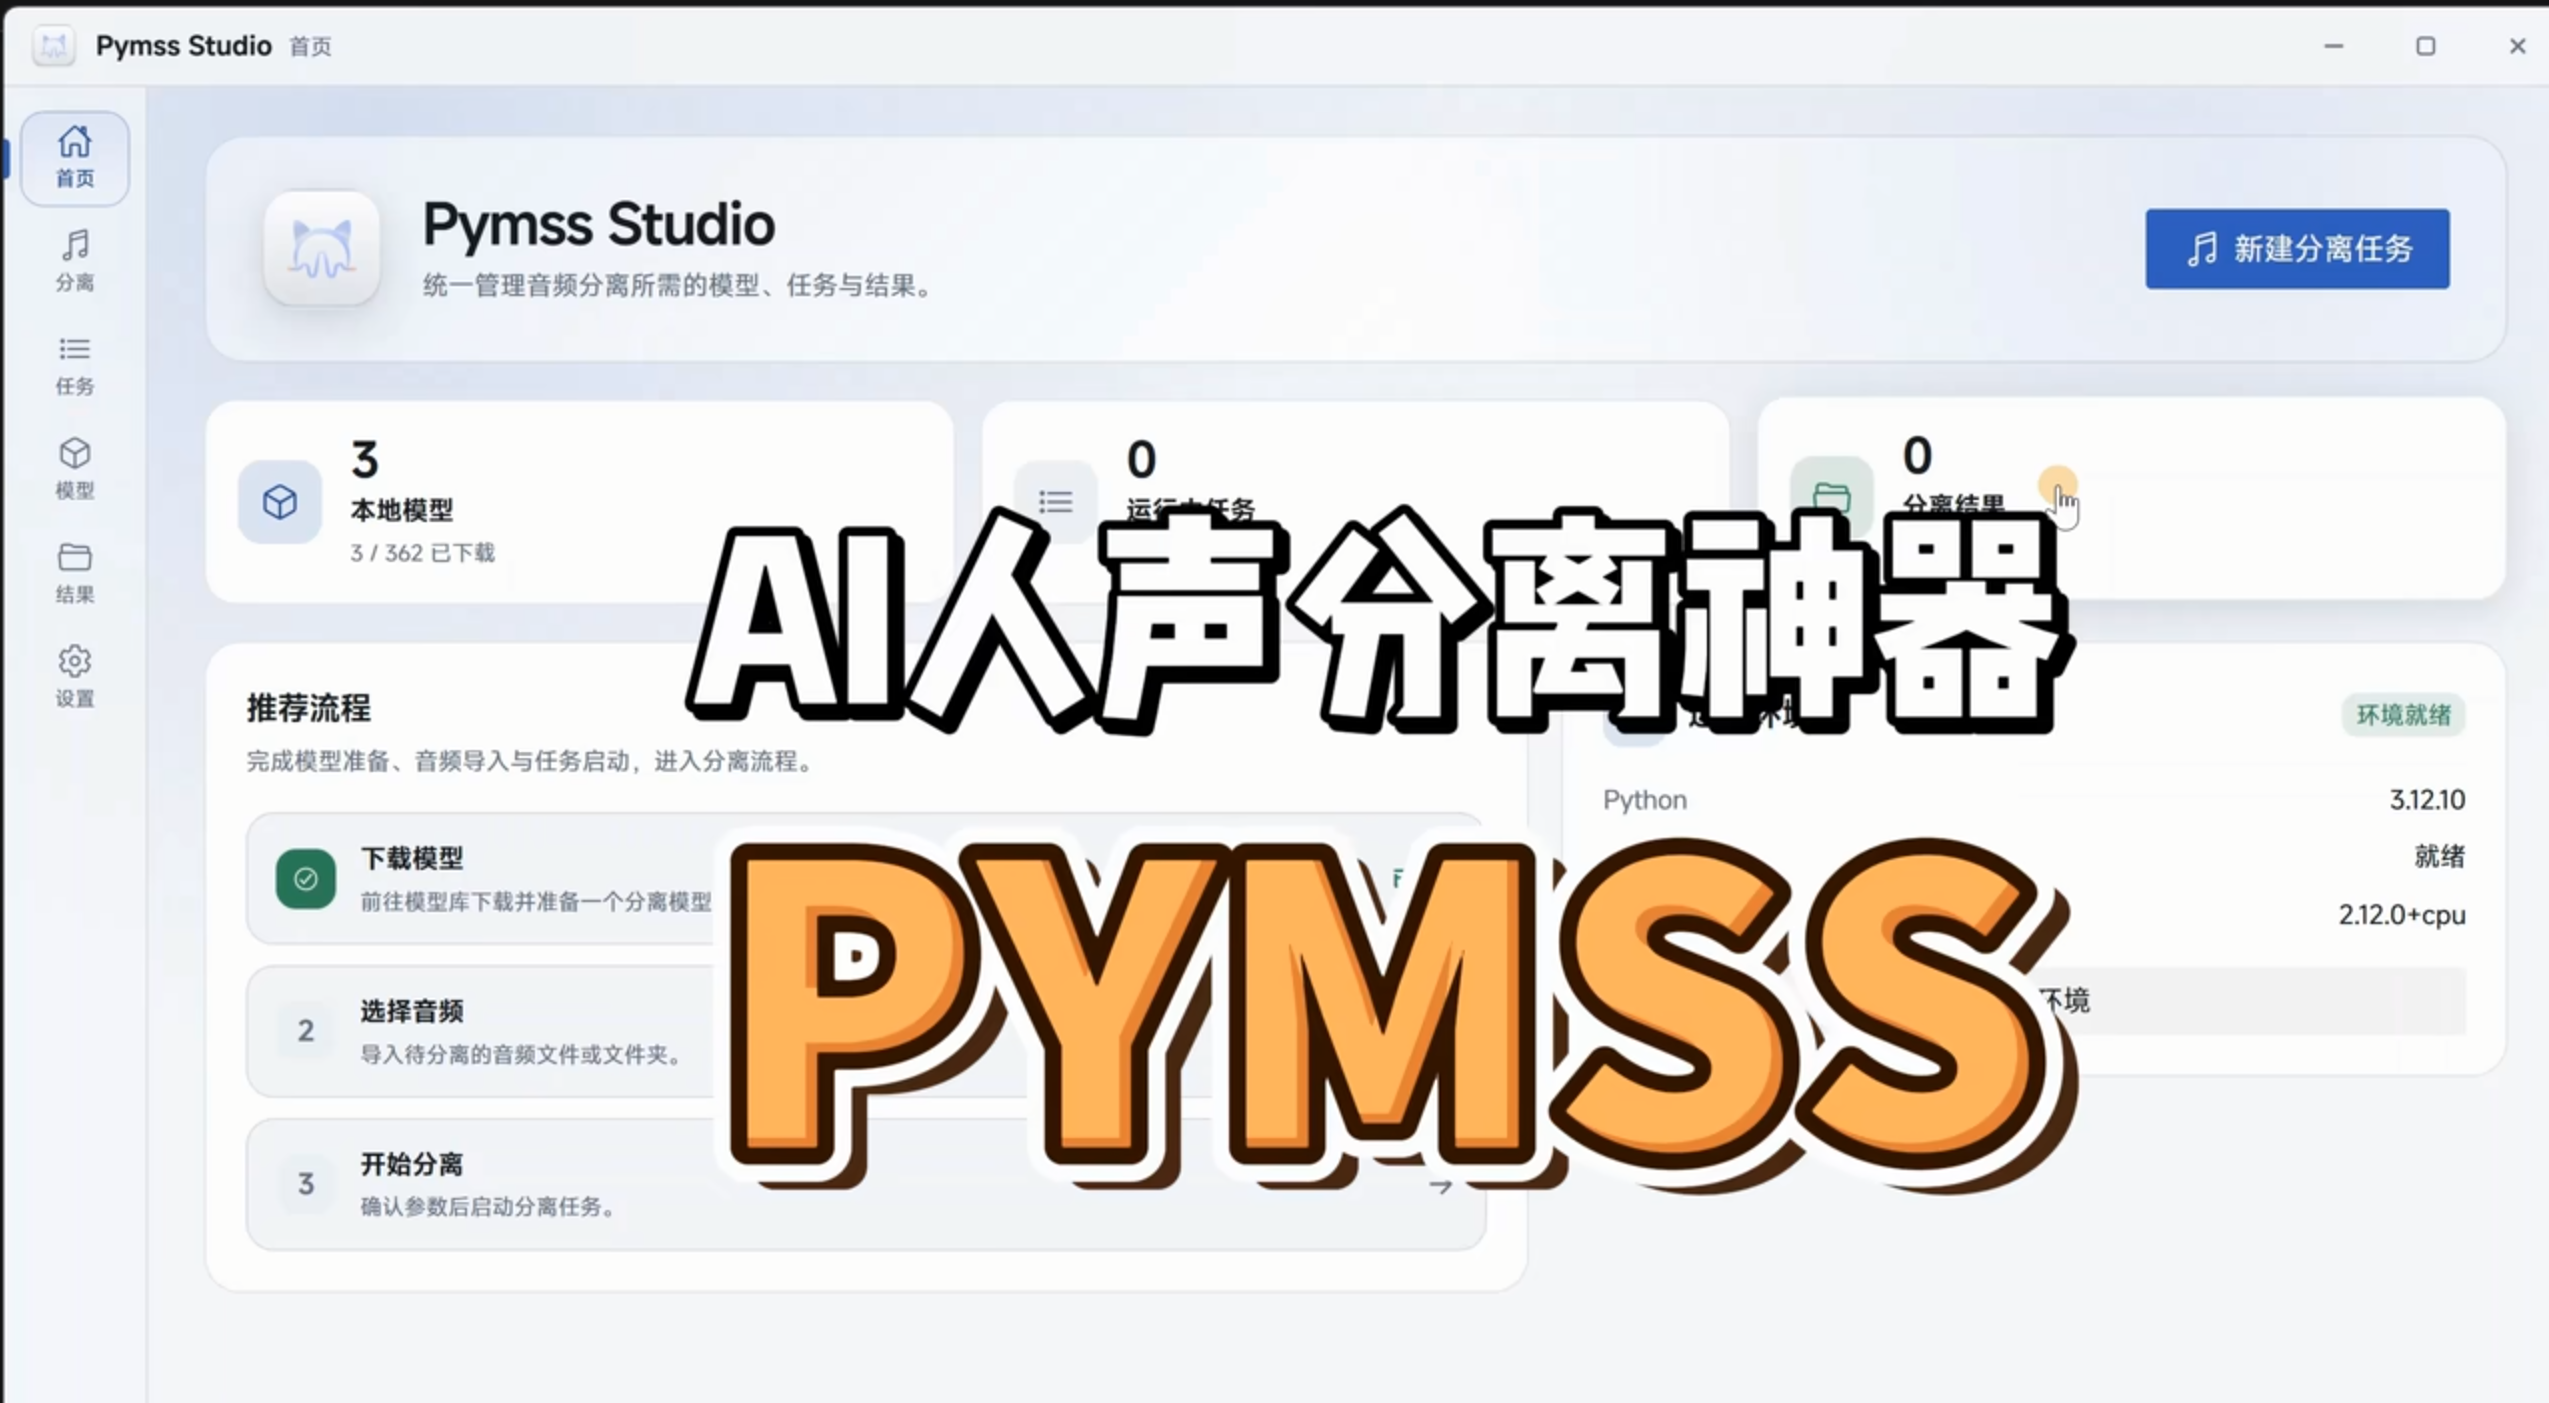
PYMSS是一款基于AI音频模型的人声分离工具。
它本质上并不是单独的一套AI模型,而是一个强大的模型管理和调用平台。
简单理解:
PYMSS负责提供界面和工作流,而真正决定分离效果的是背后的AI模型。
因此模型选择往往比软件本身更重要。
二、PYMSS有哪些版本?
目前主要有两种使用方式。
1、PYMSS Studio安装版
这是大多数用户使用最多的版本。
特点:
- 下载后直接安装
- 图形化界面
- 操作简单
- 适合普通用户
对于不熟悉命令行或者工作流的朋友来说,直接安装即可使用。
2、ComfyUI工作流版
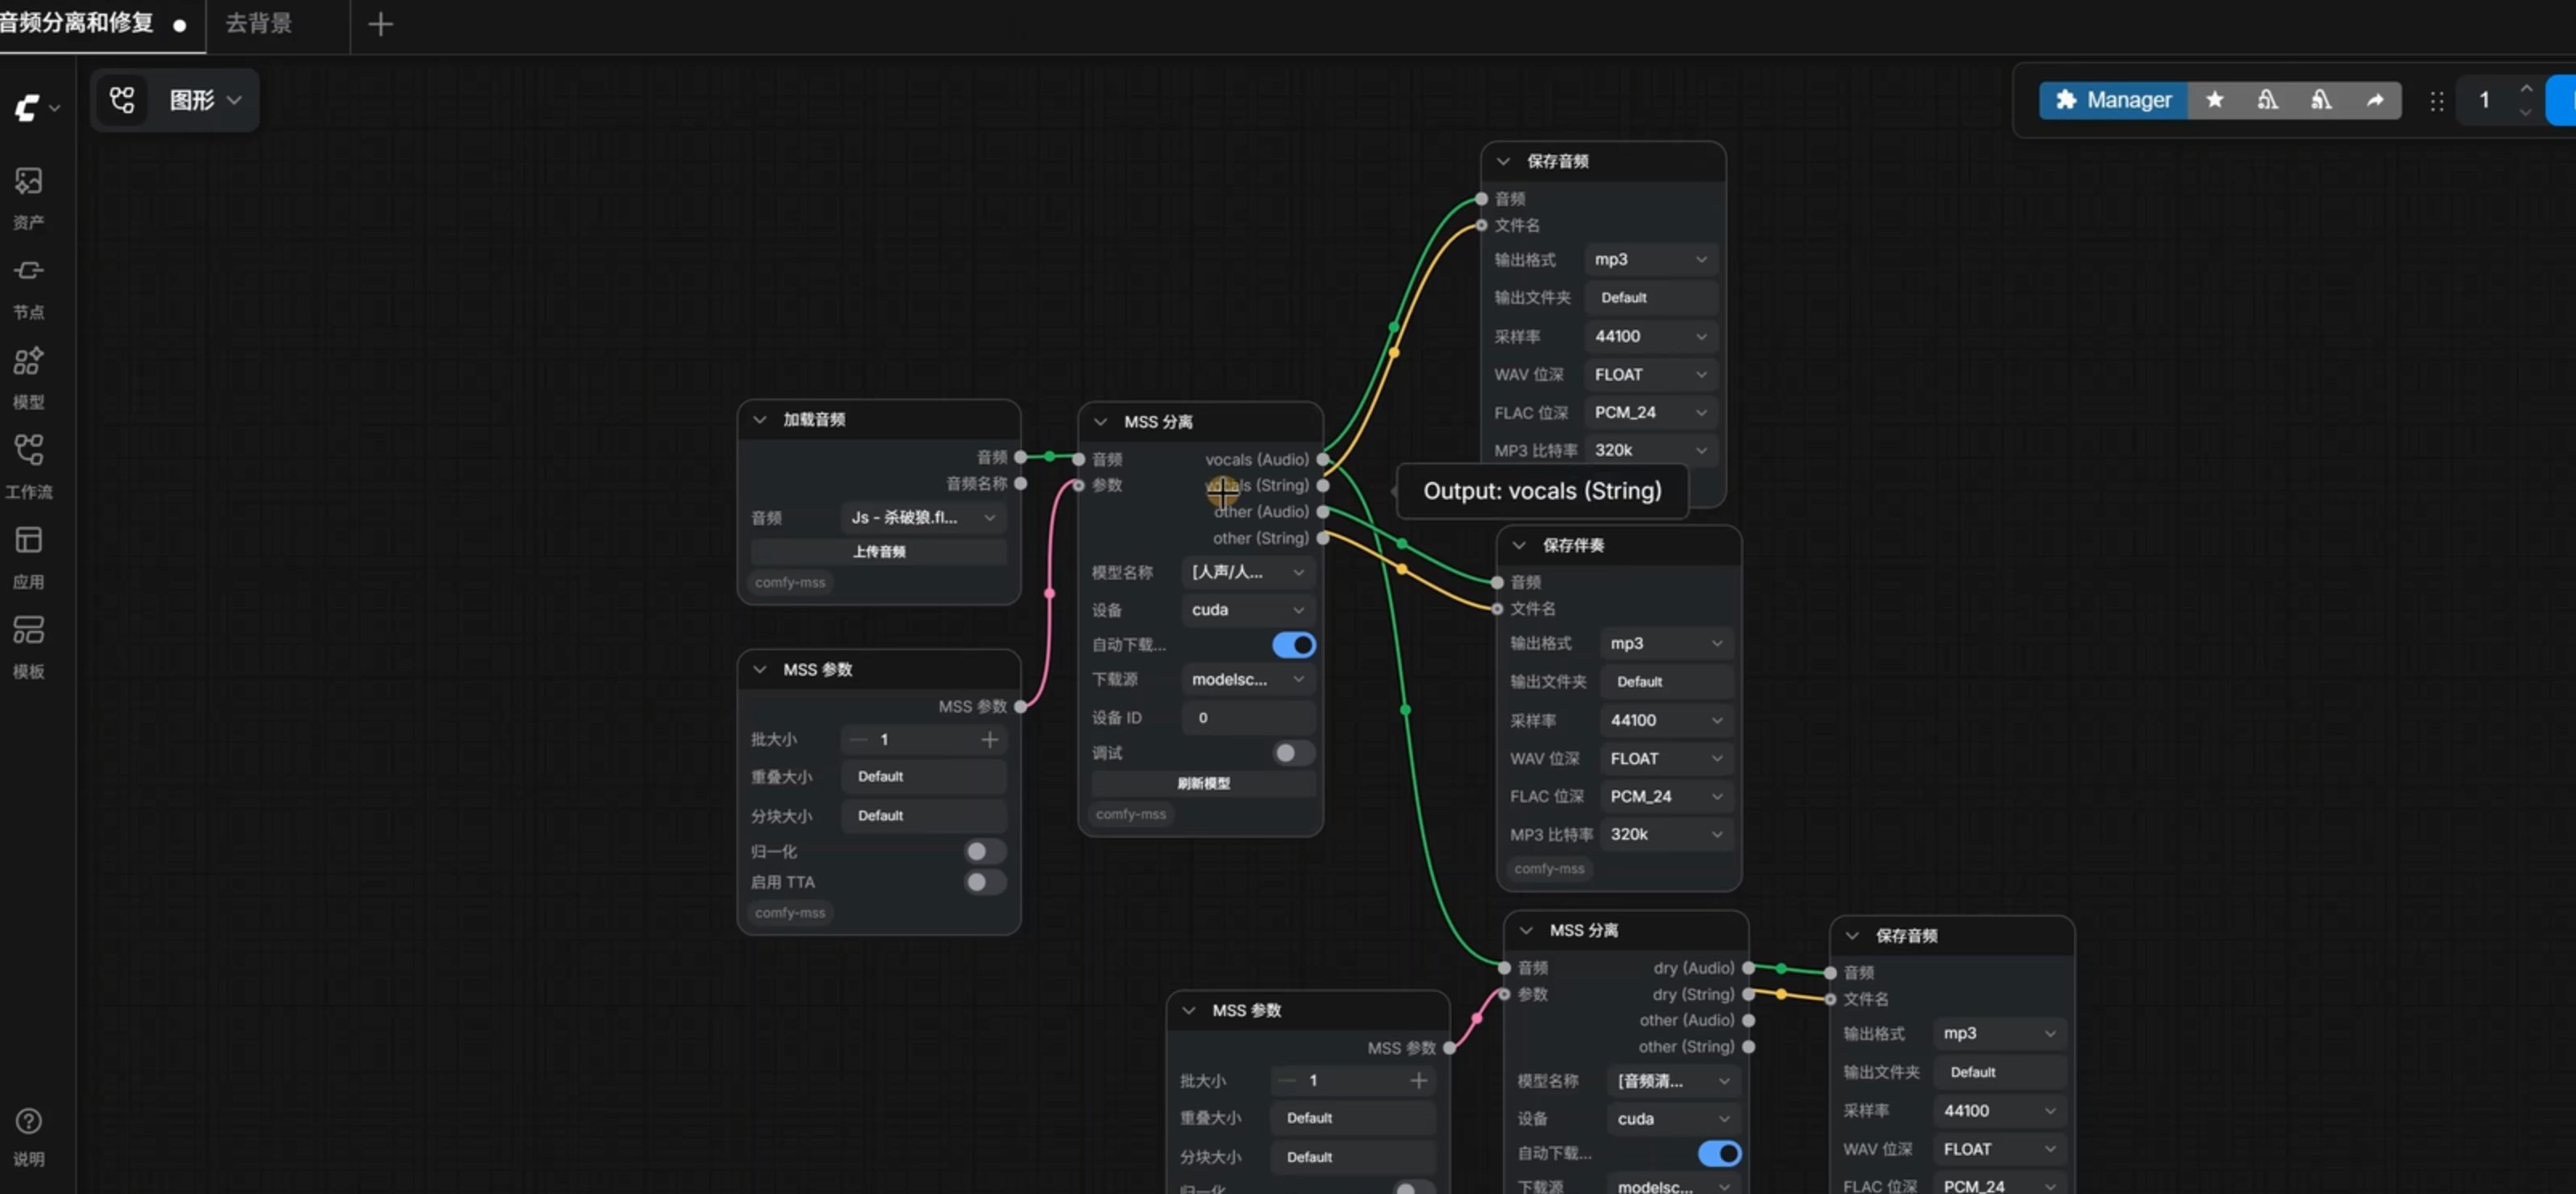
对于进阶用户来说,更推荐使用工作流模式。
优势包括:
- 多步骤自动化处理
- 音频分离
- 音频修复
- 降噪处理
- 批量处理
整个流程可以串联起来一次完成。
例如:
原始音频
    ↓
人声分离
    ↓
音频修复
    ↓
降噪处理
    ↓
导出结果
相比单独运行多个软件,效率会高很多。
三、PYMSS最大的优势
目前市面上的音频分离工具很多。
但PYMSS最大的优势在于:
模型数量极其丰富
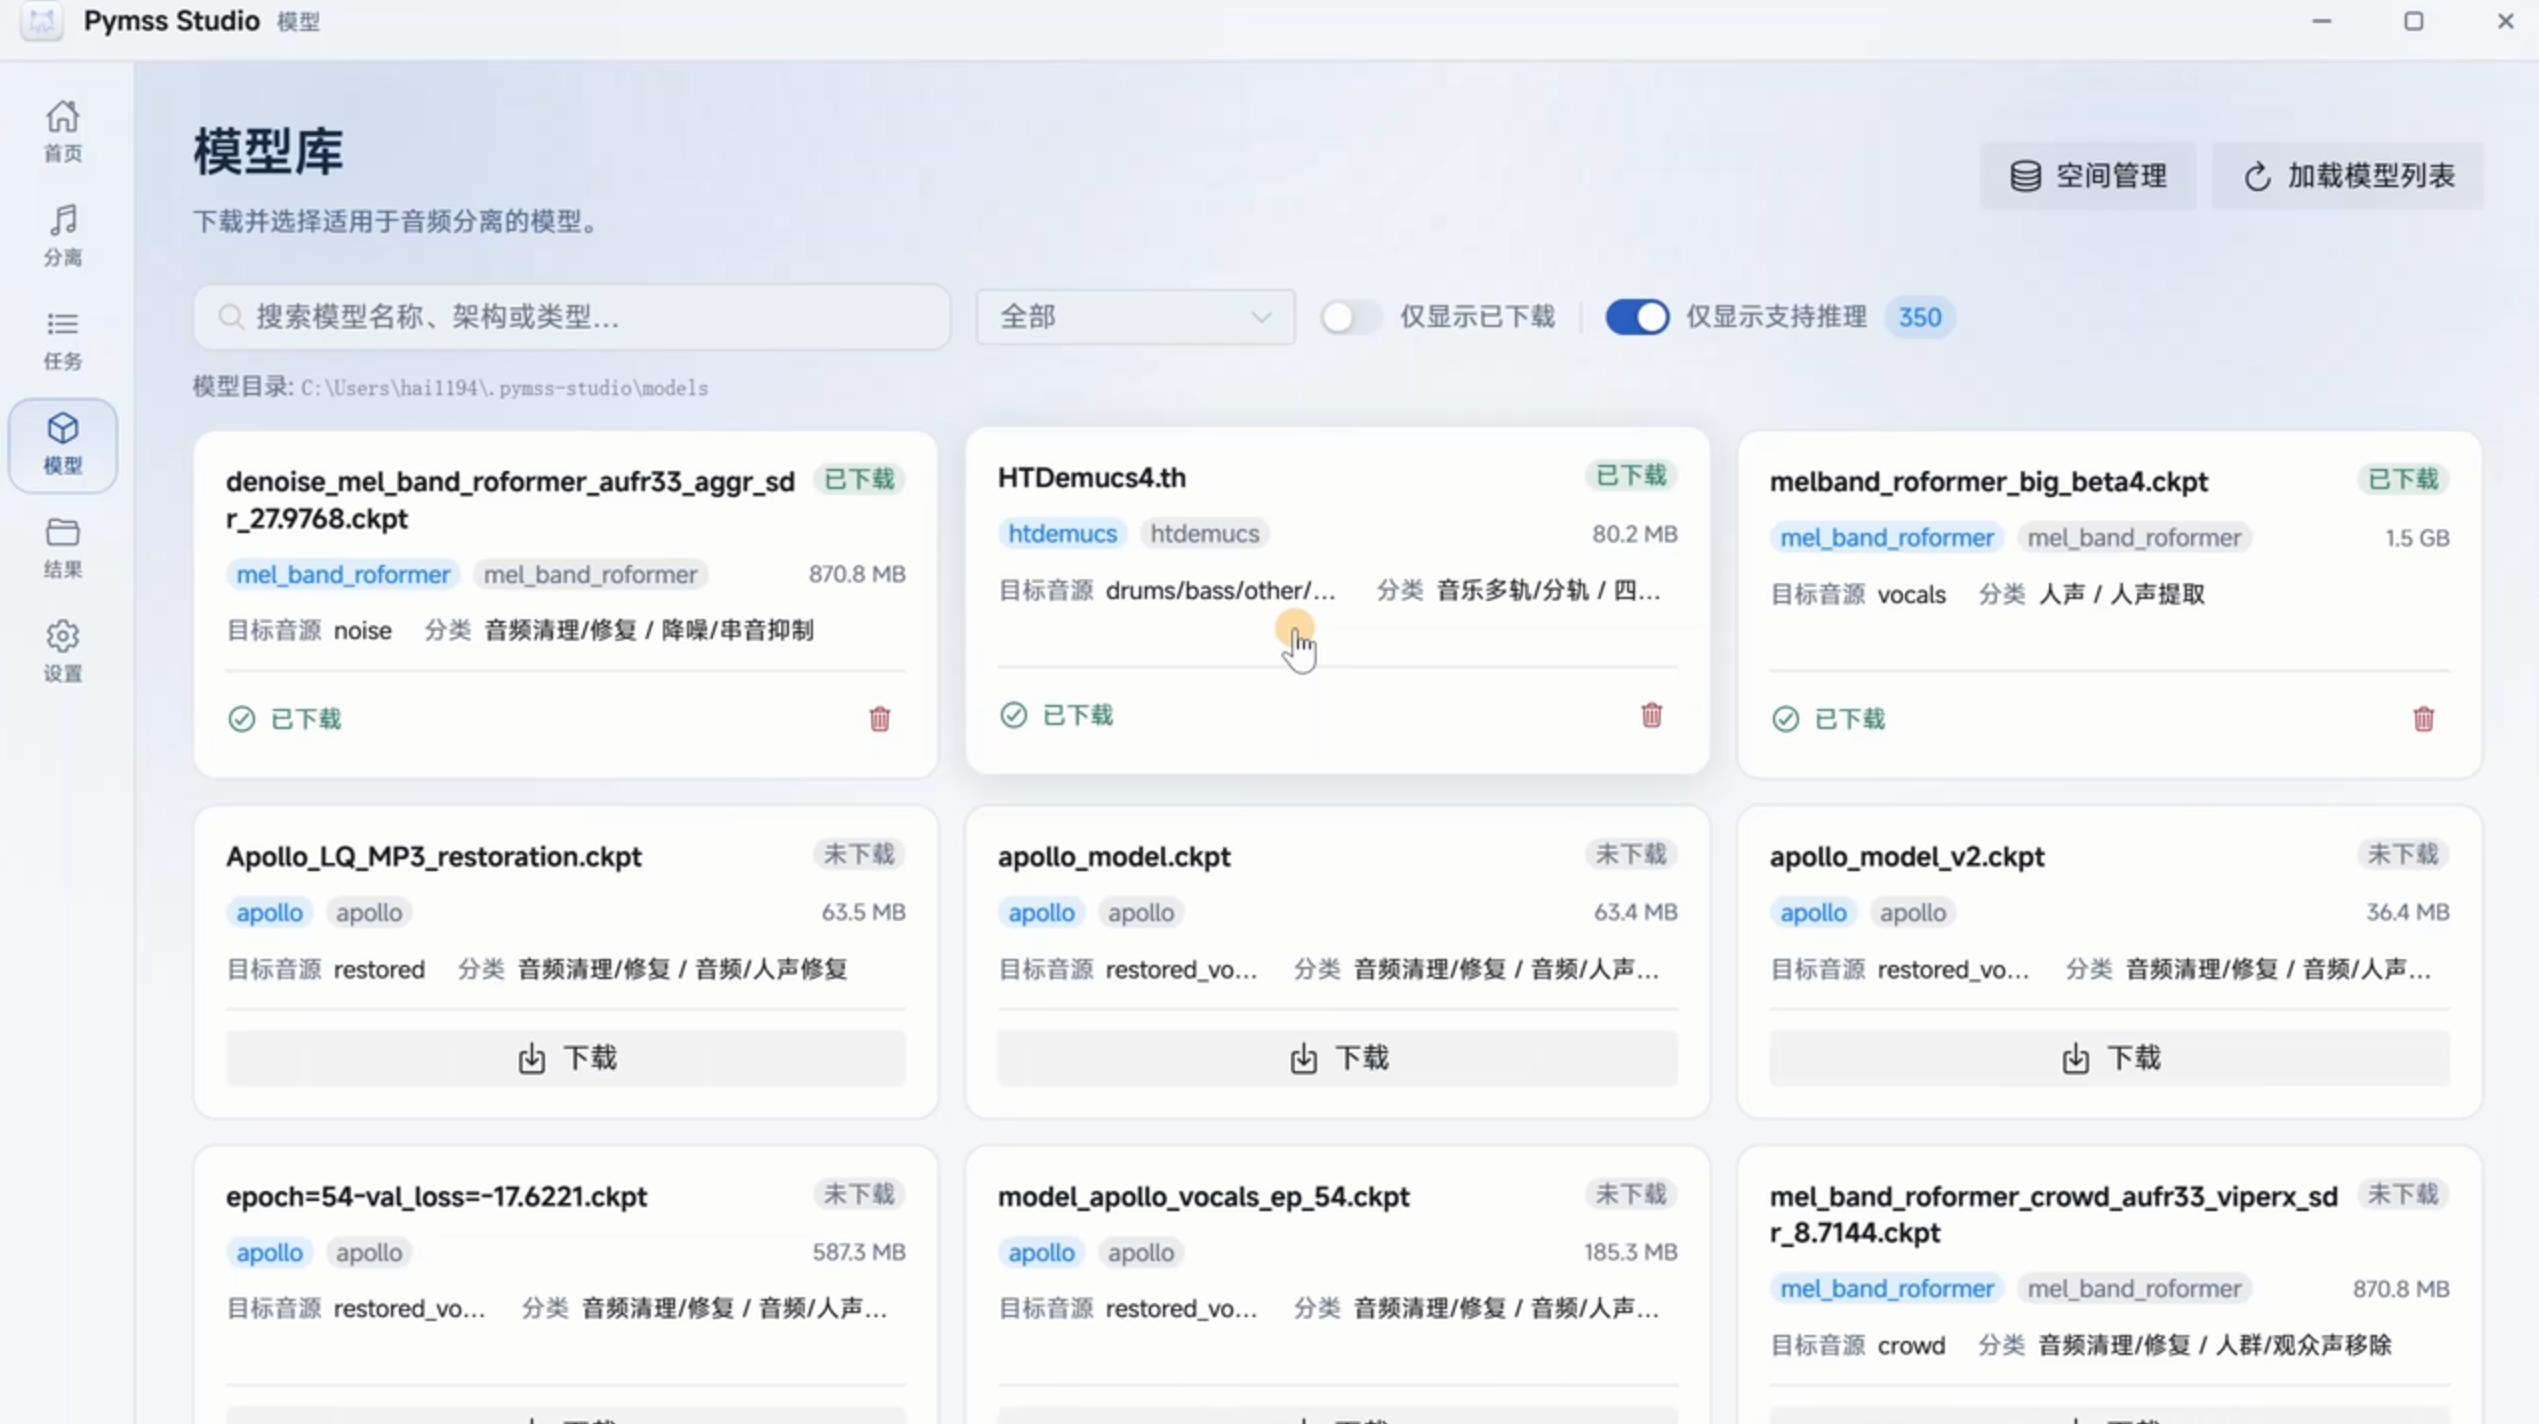
目前支持:
300多个音频模型
覆盖:
- 人声分离
- 伴奏提取
- 乐器分离
- 鼓点提取
- 贝斯提取
- 音频修复
- 降噪处理
几乎主流模型都能直接使用。
模型下载方便
很多工具配置模型比较麻烦。
而PYMSS集成了模型管理功能。
可以直接搜索并下载模型。
对于新手来说非常友好。
四、推荐几个实测效果不错的模型
经过实际测试,目前比较推荐以下几类模型。
1、人声分离模型
推荐:
MelBand Roformer
这是目前非常热门的一类模型。
优点:
- 人声保留完整
- 伴奏残留少
- 分离效果自然
- 高频细节优秀
适用于:
- 翻唱伴奏提取
- AI翻唱
- 配音制作
- 短视频剪辑
BigShifts系列模型
也是目前非常流行的大模型方案。
特点:
- 分离速度快
- 效果稳定
- 对流行歌曲兼容性好
适合日常批量处理。
2、乐器分离模型
推荐:
HT Demucs 4
这是很多用户公认的经典模型。
支持分离:
- 人声
- 鼓组
- 贝斯
- 吉他
- 钢琴
- 其他乐器
能够直接导出多个音轨。
适用于:
- 音乐制作
- 编曲学习
- 乐器扒谱
3、音频修复模型
推荐:
MelBand Roformer修复模型
在人声分离后使用。
主要作用:
- 减少分离伪影
- 提升清晰度
- 修复失真
- 改善细节表现
对于老歌曲和复杂混音效果尤其明显。
五、ComfyUI工作流演示
这里分享一下我常用的流程。
第一步:导入音频
加载待处理音乐文件。
第二步:执行人声分离
使用:
MelBand Roformer
输出:
人声.wav
伴奏.wav
第三步:执行音频修复
使用修复模型继续处理人声。
流程:
分离后人声
      ↓
修复模型
      ↓
优化后人声
第四步:运行工作流
点击运行即可。
整个过程基本全自动完成。
六、显卡要求高吗?
很多朋友关心显存占用。
从实际测试来看:
PYMSS对显存要求并不算高。
参考配置:
| 显存 | 使用情况 |
|---|---|
| 4GB | 可运行部分模型 |
| 6GB | 基本够用 |
| 8GB | 推荐 |
| 12GB+ | 大模型体验更好 |
一般游戏显卡都可以胜任。
七、效果展示
测试流程:
原始歌曲
    ↓
人声分离
    ↓
伴奏提取
    ↓
人声修复
最终得到三个文件:
文件1
原始分离后的人声
文件2
纯伴奏
文件3
修复优化后的人声
实际试听可以发现:
- 人声更加干净
- 伴奏残留更少
- 高频细节更加自然
- 失真明显减少
对于AI翻唱和后期制作来说帮助非常大。
八、下载地址
| 资源 | 地址 |
|---|---|
| PYMSS工具 | https://pan.quark.cn/s/b6b2e92435bb |
建议下载后优先体验:
- MelBand Roformer
- BigShifts系列
- HT Demucs 4
这几个模型目前都属于效果比较优秀的方案。
九、总结
如果说UVR代表了上一代AI音频分离工具,那么PYMSS可以说是目前的新一代接班人。
它最大的优势在于:
- 支持300+模型
- 模型下载方便
- 支持工作流处理
- 支持音频修复
- 支持乐器分离
- ComfyUI生态兼容
- 显存占用相对较低
对于音乐制作、AI翻唱、短视频创作、自媒体剪辑等场景来说,都是一款非常实用的工具。
如果你也在使用PYMSS,或者发现了效果更好的模型,欢迎在评论区分享你的使用体验。
转载自 CSDN-专业IT技术社区
原文链接:https://blog.csdn.net/weixin_41961749/article/details/162277791

