

一、认识搜索引擎优化
1.1、认识SEO
SEO:让搜索引擎更容易发现、理解你的文章
SEO 全称是 Search Engine Optimization,中文叫搜索引擎优化。
比如你写了一篇文章:Spring Boot 如何接入大模型 API?
你希望别人搜索“Spring Boot 接入大模型”时,能够找到你的博客。围绕这个目标做的内容和技术优化,就是 SEO。
先理解搜索引擎的大致工作过程:
| 阶段 | 搜索引擎在做什么 | 你需要解决什么 |
|---|---|---|
| 发现 | 找到你的文章网址 | 网站有导航、文章链接和 Sitemap |
| 抓取 | 访问网址,读取页面 | 页面可访问,正文能被读取 |
| 索引,也叫收录 | 分析页面,决定是否放进搜索数据库 | 内容清晰、有价值,减少重复页面 |
| 排名与展示 | 用户搜索时,挑选相关页面展示 | 内容符合搜索需求,网站体验良好 |
提交网址不等于一定收录,收录也不等于排名靠前。
示范内容生成平台,可以从两方面理解 SEO:
| 方向 | 具体例子 |
|---|---|
| 内容优化 | 标题说清楚问题;正文有步骤、代码和验证结果;文章之间有相关链接 |
| 技术优化 | 每篇文章有独立网址和标题;搜索引擎能读取正文;页面加载快;移动端能正常阅读 |
例如,一篇文章的 HTML 可以包含:
<title>Spring Boot 接入大模型 API 教程 - 长路的博客</title>

<meta
  name="description"
  content="介绍 Spring Boot 接入大模型 API 的完整过程,包含配置、调用代码与常见问题。"
/>
这里:
title告诉搜索引擎和读者:这页讲什么。description是页面摘要,搜索引擎可能用它生成搜索结果中的描述,也可能自行选取正文。
注意,SEO 并不是往页面里堆关键词。对技术博客而言,能把一个真实问题讲清楚,是最重要的基础。
1.2、基本技术名词概念 & 解决问题
总览结构组成
| 名词 | 解决问题 | 是否属于标准规范 | 规范来源/制定者 | 官方规范入口 | 内容生产平台应遵循什么 |
|---|---|---|---|---|---|
| Sitemap | 发现页面:告诉搜索引擎网站有哪些公开页面,哪些内容发生了更新 | 行业共同协议 | Sitemaps.org 公布的 Sitemap 协议 | Sitemaps XML 协议 | 按规范生成 XML,包含希望被收录的公开页面;发布、修改、下架后同步更新;遵守编码、网址和文件大小限制 |
| robots.txt | 管理抓取:告诉遵守协议的爬虫,哪些路径允许或禁止抓取 | IETF 标准轨道规范 | IETF,RFC 9309:Robots Exclusion Protocol | RFC 9309 | 在站点根目录提供 /robots.txt,正确配置爬虫及路径规则;避免误屏蔽正文和必要资源;不把它当作权限控制或禁止收录的手段 |
| canonical | 统一网址:同一内容存在多个网址时,声明首选版本,辅助合并重复内容信号 | IETF 标准轨道规范 | IETF,RFC 6596:The Canonical Link Relation | RFC 6596 | 为页面声明准确的首选网址;站内链接、Sitemap 与 canonical 保持一致;不要把不同内容的页面统一指向首页 |
| 结构化数据 | 理解内容:明确内容类型、标题、作者、发布时间等信息,支持搜索引擎理解及特定展示 | 多层规范组合:内容词汇、表达格式、搜索平台使用规则 | Schema.org 定义类型和属性;W3C 定义 JSON-LD 等格式;搜索引擎制定具体支持规则 | Schema.org/JSON-LD 1.1 | 选择符合实际内容的类型,如 Article、BlogPosting;用 JSON-LD 等支持的格式输出;字段真实并与可见内容一致;按目标搜索引擎规则验证 |
| RSS | 订阅更新:让读者通过阅读器持续获取新内容;也可辅助部分搜索引擎发现近期网址 | 公开内容订阅格式规范,通常指 RSS 2.0 | RSS Advisory Board 维护 RSS 2.0 规范 | RSS 2.0 Specification | 按 rss、channel、item 等结构提供订阅源;包含标题、链接、日期及摘要或全文;更新时同步维护,不输出私密内容 |
| 阅读页性能 | 提升阅读体验:让主要内容快速出现、操作及时响应、加载过程中布局稳定 | 不是单一协议;Core Web Vitals 是常用指标体系 | Google 推出 Web Vitals/Core Web Vitals | Web Vitals | 优化正文呈现、图片、脚本、服务端响应及缓存;为图片和广告预留空间;持续测量 LCP、INP、CLS,结合真实用户体验改进 |
**注意:**遵循规范能帮助抓取、理解和使用内容,但不保证搜索引擎收录或排名。
SEO
├── Sitemap
├── robots.txt
├── canonical
└── Structured Data

内容订阅
├── RSS
└── Atom

内容传播
└── Open Graph

用户体验
└── 阅读页性能
第一部分:SEO优化
1)Sitemap
Sitemap:把网站网址整理成机器可读的目录
Sitemap 中文叫站点地图。通常是一个 XML 文件,例如:
https://你的域名/sitemap.xml
内容大致如下,域名仅作示例:
<?xml version="1.0" encoding="UTF-8"?>
<urlset xmlns="http://www.sitemaps.org/schemas/sitemap/0.9">
  <url>
    <loc>https://example.com/</loc>
  </url>
  <url>
    <loc>https://example.com/posts/spring-boot-ai</loc>
    <lastmod>2026-10-02</lastmod>
  </url>
</urlset>
认识两个字段就够了:
| 字段 | 含义 |
|---|---|
loc | 页面完整网址 |
lastmod | 页面最近一次有实质内容修改的日期,可选 |
它相当于主动告诉搜索引擎:
“这些是我的公开页面,你可以来看看。”
它的作用是辅助发现和抓取页面,不是提高排名的快捷按钮,也不能保证收录。
“配置 Sitemap”通常包含三件事:
- 生成目录:从已发布文章中提取公开网址,生成 XML。
- 保持更新:发布、修改、删除文章后,同步更新目录。
- 告知搜索引擎:在
robots.txt中声明,也可以通过搜索引擎的站长工具提交。
例如在网站的 robots.txt 中放一行:
Sitemap: https://example.com/sitemap.xml
对于 BlogLoom,最好由程序自动生成。后台、登录页、草稿和私密文章不应该放进 Sitemap。但要注意,不放进去不等于保密,私密页面仍然需要权限控制。
2)robots.txt
简单理解:告诉爬虫哪些路径可以抓取
主要解决问题:哪些路径允许或禁止抓取?
它是放在网站根目录的文本文件:
https://example.com/robots.txt
例如:
User-agent: *
Disallow: /admin/
Disallow: /api/
Disallow: /preview/

Sitemap: https://example.com/sitemap.xml
含义是:
| 配置 | 含义 |
|---|---|
User-agent: * | 规则适用于所有遵守该规则的爬虫 |
Disallow: /admin/ | 不要抓取后台路径 |
Disallow: /api/ | 不要抓取 API 路径 |
Sitemap: ... | 告知站点地图地址 |
它是抓取规则,不是权限控制。别人仍可能直接访问这些网址,所以后台和私密内容依然需要登录鉴权。
另外,禁止抓取不等于禁止收录。如果一个公开页面允许访问,但你不希望它出现在搜索结果中,通常使用页面上的:
<meta name="robots" content="noindex">
搜索引擎需要能够抓取这个页面,才能读到 noindex。因此不要同时禁止抓取,又指望它读取页面里的不收录指令。
3)canonical(优化策略)
简单理解:告诉搜索引擎“这个页面以哪个网址为准”
同一篇文章可能有多个访问地址:
https://example.com/posts/123
https://example.com/posts/123?utm_source=csdn
https://example.com/posts/123?from=homepage
这些地址正文相同,就可以统一声明:
<link rel="canonical"
      href="https://example.com/posts/123">
意思是:这些内容对应的首选网址是 /posts/123。
放到内容生产平台中:每篇文章输出自己的标准完整 URL,并让站内文章链接、Sitemap 和 canonical 尽量保持一致。
注意两点:
- canonical 不会让浏览器跳转;浏览器跳转需要重定向。
- 不要让所有文章都指向首页,也不要把不同内容的分页随意指向同一页。
它是向搜索引擎提供首选网址的信号,最终采用哪个网址仍由搜索引擎判断。
4)结构化数据
简单介绍:用固定格式说明文章信息
读者看到标题、头像和日期,能够判断这是一篇谁写的文章。结构化数据则把这些信息用机器容易识别的格式表达出来。
常见形式是放在 HTML 中的 JSON-LD:
<script type="application/ld+json">
{
  "@context": "https://schema.org",
  "@type": "BlogPosting",
  "headline": "Spring Boot 接入大模型 API 教程",
  "author": {
    "@type": "Person",
    "name": "长路"
  },
  "datePublished": "2026-10-01T10:00:00+08:00",
  "dateModified": "2026-10-02T12:00:00+08:00",
  "description": "介绍接入步骤、调用代码及常见问题。",
  "url": "https://example.com/posts/123"
}
</script>
主要字段:
| 字段 | 含义 |
|---|---|
@type | 内容类型,这里是博客文章 |
headline | 文章标题 |
author | 作者 |
datePublished | 首次发布时间 |
dateModified | 最近实质修改时间 |
description | 内容摘要 |
在内容平台中:从文章数据库读取这些字段,在 Thymeleaf 渲染时统一生成即可。
它有助于搜索引擎理解内容,并可能支持更丰富的搜索展示,但不能保证特殊展示或排名提升。信息必须真实、与页面一致,不能每天自动更新日期来伪装文章有更新。
第二部分:内容订阅格式
RSS(读者订阅)
RSS:让读者主动订阅你的博客更新
RSS 是一种内容订阅格式。
普通读者看博客,需要隔一段时间主动打开网站,看看有没有更新。使用 RSS 后,读者可以把多个博客添加到同一个 RSS 阅读器里,集中查看新文章。
例如:读者订阅长路的博客 → 你发布新文章 → 阅读器定期检查订阅源 → 读者看到更新。
它通常也是一个 XML 文件,常见地址类似:
https://你的域名/rss.xml
文件里通常包含:
| 信息 | 例子 |
|---|---|
| 博客名称 | 长路的博客 |
| 文章标题 | Spring Boot 接入大模型 API 教程 |
| 原文链接 | 文章的完整网址 |
| 发布时间 | 2026 年 10 月 2 日 |
| 内容 | 文章摘要或全文 |
RSS 本身通常不是邮件通知,也不是即时推送。它是网站提供的订阅数据,阅读器负责检查和展示更新。
可以在 HTML 中声明订阅地址:
<link rel="alternate"
  type="application/rss+xml"
  title="长路的博客"
  href="https://example.com/rss.xml">
RSS 主要服务读者订阅,不是 SEO 的必备排名配置。它与 Sitemap 的区别是**:Sitemap 侧重列出网址;RSS 侧重提供近期内容更新**。
Atom Feed 订阅
Atom Feed:另一种标准化的内容订阅格式
Atom 和 RSS 的用途非常接近,都是让博客、资讯网站把最新内容以机器可读的方式提供给 RSS/Feed 阅读器。
常见地址例如:
https://example.com/atom.xml
https://example.com/feed.xml
用户可以把这个地址添加到 Feedly、Inoreader、NetNewsWire 等阅读器中。网站发布新文章后,阅读器定期检查 Atom Feed,就可以发现新的内容。
Atom 文件大致如下:
<?xml version="1.0" encoding="UTF-8"?>
<feed xmlns="http://www.w3.org/2005/Atom">

  <title>长路的博客</title>
  <link href="https://example.com/"/>
  <link href="https://example.com/atom.xml" rel="self"/>

  <updated>2026-10-02T12:00:00+08:00</updated>

  <entry>
    <title>Spring Boot 接入大模型 API 教程</title>

    <link href="https://example.com/posts/123"/>

    <id>https://example.com/posts/123</id>

    <published>2026-10-01T10:00:00+08:00</published>
    <updated>2026-10-02T12:00:00+08:00</updated>

    <summary>
      介绍 Spring Boot 接入大模型 API 的实现方式。
    </summary>
  </entry>

</feed>
主要字段:
| 字段 | 含义 |
|---|---|
title | 博客或文章标题 |
link | 网站或文章地址 |
id | 内容的唯一标识 |
published | 首次发布时间 |
updated | 最近更新时间 |
summary | 文章摘要 |
content | 文章正文,可选 |
可以在网页 HTML 中声明 Atom Feed:
<link
  rel="alternate"
  type="application/atom+xml"
  title="长路的博客"
  href="https://example.com/atom.xml">
对于 内容分发平台,可以在发布文章时自动更新 Atom Feed,通常只输出最近几十篇公开文章即可,不需要把整个博客历史文章全部塞进去。
RSS 和 Atom 有什么区别?
可以简单理解为:
| 对比 | RSS | Atom |
|---|---|---|
| 用途 | 内容订阅 | 内容订阅 |
| 文件格式 | XML | XML |
| 常见地址 | /rss.xml | /atom.xml |
| 发布时间 | pubDate 等 | published |
| 修改时间 | 不同 RSS 版本处理方式不同 | 原生提供 updated |
| 标准规范 | 历史版本较多 | 格式更加统一规范 |
| 阅读器支持 | 很广 | 很广 |
对博客系统来说,RSS 和 Atom 不一定必须两个都实现。如果 内容分发平台 已经支持:
/rss.xml
实际上已经可以满足绝大多数订阅场景。
如果希望博客平台更加完整,可以同时提供:
/rss.xml
/atom.xml
Atom 和 RSS 与 Sitemap 的定位也不同:
Sitemap
    ↓
主要服务搜索引擎
    ↓
告诉搜索引擎:网站有哪些 URL

RSS / Atom
    ↓
主要服务订阅读者和内容聚合器
    ↓
告诉阅读器:最近发布了哪些内容
它们本身都不是直接提高 SEO 排名的功能,但可以帮助内容发现、订阅和分发。
第三部分:内容传播
Open Graph 标签
Open Graph:控制网页分享到社交平台时显示什么内容
当一篇博客文章被分享到微信、Facebook、LinkedIn、Discord、Slack 或其他支持网页卡片的平台时,平台通常会尝试读取页面中的标题、描述和图片。
如果什么都不配置,平台可能自行从 HTML 中猜:
标题是什么?
摘要是什么?
应该显示哪张图片?
结果可能出现:
图片选错
标题被截断
摘要不合适
没有封面图
Open Graph 就是用一组 <meta> 标签明确告诉平台:
这篇文章分享到其他平台时,请使用这些标题、摘要、图片和链接。
例如:
<meta
  property="og:title"
  content="Spring Boot 接入大模型 API 教程">

<meta
  property="og:description"
  content="介绍 Spring Boot 接入大模型 API 的完整实现过程。">

<meta
  property="og:image"
  content="https://example.com/images/spring-boot-ai-cover.png">

<meta
  property="og:url"
  content="https://example.com/posts/123">

<meta
  property="og:type"
  content="article">

<meta
  property="og:site_name"
  content="长路的博客">
主要字段:
| 标签 | 含义 |
|---|---|
og:title | 分享卡片标题 |
og:description | 分享卡片摘要 |
og:image | 分享时显示的封面图 |
og:url | 页面标准网址 |
og:type | 内容类型 |
og:site_name | 网站名称 |
例如文章:
https://example.com/posts/123
页面中配置:
<meta property="og:title"
      content="Spring Boot 接入大模型 API 教程">

<meta property="og:description"
      content="从配置、代码到测试完整介绍 Spring Boot 接入大模型 API。">

<meta property="og:image"
      content="https://example.com/upload/2026/spring-ai.png">

<meta property="og:url"
      content="https://example.com/posts/123">

<meta property="og:type"
      content="article">
用户把文章链接分享到支持 Open Graph 的平台时,就可能形成类似:
┌──────────────────────────────┐
│                              │
│        文章封面图片           │
│                              │
├──────────────────────────────┤
│ Spring Boot 接入大模型 API 教程 │
│                              │
│ 从配置、代码到测试完整介绍……   │
│                              │
│ example.com                  │
└──────────────────────────────┘
对于 BlogLoom,这些信息基本都可以直接从文章数据库获取:
文章标题
    ↓
og:title

文章摘要
    ↓
og:description

文章首图 / 封面
    ↓
og:image

文章 canonical URL
    ↓
og:url

网站名称
    ↓
og:site_name
因此可以在 Thymeleaf 的文章模板中统一输出,例如:
<meta property="og:title"
      th:content="${article.title}">

<meta property="og:description"
      th:content="${article.description}">

<meta property="og:image"
      th:content="${article.cover}">

<meta property="og:url"
      th:content="${article.url}">

<meta property="og:type"
      content="article">

<meta property="og:site_name"
      content="BlogLoom">
对于文章类型,还可以进一步补充:
<meta
  property="article:published_time"
  content="2026-10-01T10:00:00+08:00">

<meta
  property="article:modified_time"
  content="2026-10-02T12:00:00+08:00">

<meta
  property="article:author"
  content="长路">
需要注意几个点:
第一,og:image 最好使用完整 URL。
推荐:
https://example.com/images/article-cover.png
而不是:
/images/article-cover.png
因为抓取分享卡片的是第三方平台。
第二,Open Graph 图片应该是公开可访问的。
如果图片需要登录、携带 Cookie,第三方平台通常无法抓取。
第三,Open Graph 和 SEO 不是一回事。
Open Graph 主要解决:
链接分享到外部平台之后长什么样
而普通 SEO 标签:
<title>...</title>

<meta name="description" content="...">
主要服务搜索结果和网页本身。
通常两套可以共用同一份数据:
article.title
├── <title>
└── og:title

article.description
├── meta description
└── og:description

article.cover
└── og:image
所以对于 内容平台,推荐把它理解成:
SEO
├── Sitemap
├── robots.txt
├── canonical
└── Structured Data

内容订阅
├── RSS
└── Atom

内容传播
└── Open Graph

用户体验
└── 阅读页性能
这样你前面这 8 个能力实际上已经形成了一套比较完整的博客内容基础设施:搜索引擎负责发现和理解,Feed 负责订阅,Open Graph 负责外部传播,性能优化负责真正的阅读体验。
第四部分:用户体验
阅读页性能
介绍:让文章打开快、交互顺、布局稳定
它不只是服务器响应速度,还包括读者真正看到和操作页面时的体验。
| 体验 | 常见问题 | BlogLoom 可以怎么改 |
|---|---|---|
| 主要内容出现快 | 等 JavaScript 和接口加载后才出现正文 | 首次 HTML 直接包含正文 |
| 点击响应及时 | 脚本太多,点按钮卡顿 | 减少重脚本,按需加载功能 |
| 页面不乱跳 | 图片、广告加载后把正文顶下去 | 为图片、广告预留尺寸 |
| 图片加载合理 | 首图过大,文章图片一次性全部下载 | 压缩图片,正文下方图片懒加载 |
| 正文不受附加功能拖累 | 评论、统计、广告阻塞阅读 | 异步加载这些功能 |
常听到的 Core Web Vitals(核心网页指标),主要关注:
| 指标 | 可以怎样理解 |
|---|---|
| LCP | 页面主要内容多久显示出来 |
| INP | 用户操作后,页面响应是否及时 |
| CLS | 页面加载过程中,内容是否意外移位 |
1.3、站点如何进行投放商业化广告?
通常支持的包含这几种:云服务推广返佣、直接品牌赞助,以及 Google AdSense。
- 接入 Google AdSense,则由Google AdSense来匹配广告,不一定展示 Google 自己的产品
三种变现方式
| 方式 | 你需要做什么 | 如何获得收入 | 对 BlogLoom 的适合程度 |
|---|---|---|---|
| 广告联盟 | 申请平台,审核通过后放入广告代码 | 按平台认可的广告展示等数据结算 | 接入省心,但内容和收益受广告需求影响 |
| 推广返佣,CPS | 推荐产品,使用专属推广链接 | 读者完成符合条件的购买后返佣 | 适合部署教程、云服务器、开发工具内容 |
| 直接赞助 | 自己与品牌协商广告位置、周期、素材 | 按月、按活动或约定效果收费 | 能控制品牌和展示质量,但需要自己谈合作 |
“广告质量好不好”不仅取决于平台名气,也取决于广告与你的读者是否相关。
相关平台渠道
| 平台/渠道 | 官方定位与准入情况 | 对你的建议 |
|---|---|---|
| Google AdSense | 面向网站内容变现;要求优质原创内容、符合政策、拥有网站控制权,申请人年满 18 岁。(Google AdSense帮助) | 可以作为网站广告联盟的首选测试对象 |
| 百度联盟/百青藤 | 官方存在网站、应用等流量合作入口;但本次公开页面不足以确认当前个人博客的完整准入条件。(so.baidu.com) | 国内联盟候选,先确认个人主体、网站接入及备案要求,再投入开发 |
| 腾讯云推广大使 | 个人实名认证后可申请;通过专属链接建立客户关联,符合条件的订单获得返佣。(cloud.tencent.com) | 若是有服务器、Docker、项目部署教程很匹配 |
| EthicalAds | 专注开发者网站;官方当前积极寻找月浏览量 5 万以上的站点。(EthicalAds) | 等技术内容和流量积累后考虑 |
| 腾讯营销联盟、穿山甲 | 公开产品和接入资料主要围绕 App 广告及 SDK。(e.qq.com) | 没有确认普通博客 Web 接入前,不作为首选 |
其中,EthicalAds 也有广告位置和同页广告数量约束;Carbon 则要求广告独占。因此这些平台不能默认全部混合接入。
广告收益评估
对展示广告,可以用 Page RPM:每千次页面浏览的收入来观察:
月广告收入 ≈ 月页面浏览量 ÷ 1000 × 实测 Page RPM
下面只是计算示例,不是平台报价或 BlogLoom 的收益预测:
| 月浏览量 | 假设 Page RPM 为 ¥2 | 假设 Page RPM 为 ¥10 |
|---|---|---|
| 10,000 | ¥20 | ¥100 |
| 50,000 | ¥100 | ¥500 |
| 100,000 | ¥200 | ¥1,000 |
实际收益受访客地区、文章主题、广告需求、广告拦截、展示成功率等因素影响。网站 PV 不等于广告展示次数,所以也不能把平台公布的广告 CPM 直接乘上全部网站 PV。
你需要分开看三组数据:
| 数据 | 主要看哪里 |
|---|---|
| 网站访问、来源、阅读 | GA4 或 Umami |
| 广告展示、预估收益、最终结算 | 广告联盟后台 |
| 推广关联、有效订单、佣金 | 返佣平台后台 |
不要自己点击广告或让朋友“帮忙点”,Google 明确禁止人工抬高展示、点击等无效流量。Google AdSense帮助
二、文章详情页SEO优化
2.1、参考来源:CSDN 博客文章拆解
这一节直接抓取一篇真实的 CSDN 博客详情页,从它的 HTTP 响应和 HTML 源码中,逐项拆解它做了哪些 SEO 优化、哪些 GEO(面向 AI 问答引擎的优化)优化,并和第一章讲到的能力逐条对应。
先看结论:CSDN 的文章详情页几乎把第一章提到的 8 项能力全部落地了,而且还额外做了一套 GEO 元信息。
2.1.1、采集方式(curl)
以下是本次拆解使用的请求。它带了浏览器 UA、Referer 和完整 Cookie,尽量模拟真实访客访问,避免被风控拦截:
curl --url 'https://blog.csdn.net/cl939974883/article/details/167174108?spm=1001.2014.3001.5501' \
  -H 'Accept: text/html,application/xhtml+xml,application/xml;q=0.9,image/avif,image/webp,image/apng,*/*;q=0.8,application/signed-exchange;v=b3;q=0.7' \
  -H 'Accept-Language: zh-CN,zh;q=0.9,en;q=0.8' \
  -H 'Cache-Control: no-cache' \
  -H 'Connection: keep-alive' \
  -b 'uuid_tt_dd=...; UserName=cl939974883; UserToken=97721fe9a1c34e158f3d8b9174e369fd; ...' \
  -H 'Pragma: no-cache' \
  -H 'Referer: https://blog.csdn.net/cl939974883?spm=1010.2135.3001.5343' \
  -H 'Sec-Fetch-Dest: document' \
  -H 'Sec-Fetch-Mode: navigate' \
  -H 'Sec-Fetch-Site: same-origin' \
  -H 'Sec-Fetch-User: ?1' \
  -H 'Upgrade-Insecure-Requests: 1' \
  -H 'User-Agent: Mozilla/5.0 (Macintosh; Intel Mac OS X 10_15_7) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/153.0.0.0 Safari/537.36' \
  -H 'sec-ch-ua: "Google Chrome";v="153", "Not_A Brand";v="8", "Chromium";v="153"' \
  -H 'sec-ch-ua-mobile: ?0' \
  -H 'sec-ch-ua-platform: "macOS"'
说明:Cookie 中内容是账号私密凭证,这里用
...省略;作用主要是让 CSDN 以“已登录访客”的身份返回完整页面。实际返回的是完整 HTML(本次约 350KB),本文只截取与 SEO/GEO 相关的源码片段。
返回状态:HTTP 200。
2.1.2、页面 SEO 能力总览(与第一章逐条对应)
| 第一章能力 | CSDN 是否实现 | CSDN 的具体做法 |
|---|---|---|
独立页面标题 <title> | ✅ | Java基础学习笔记 09、IO流—File类与IO流-CSDN博客 |
文章摘要 description | ✅ | <meta name="description"> + description:direct_answer |
| canonical | ✅ | 子域名、追踪参数统一指向 blog.csdn.net/cl939974883/article/details/167174108 |
| 结构化数据 | ✅✅ | Schema.org Article + 百度 Cambrian 两套 JSON-LD |
| RSS 自动发现 | ✅ | <link rel="alternate" type="application/rss+xml"> |
| Open Graph | ✅ | 完整 og:* + article:* + 字节 bytedance:* |
| 正文直接渲染 | ✅ | 正文写在 #content_views 里,服务端直出 |
| 分类与标签入口 | ✅ | article:section、标签链接到站内搜索页 |
| robots / 收录控制 | 全局级 | 文章页本身不出现 noindex,由站点统一管理 |
| Sitemap | 站点级 | 详情页不直接暴露,靠站点 Sitemap + 主动推送 |
| 阅读页性能 | ⚠️ 部分 | 图片走 CDN 压缩,但第三方脚本较多 |
| GEO(面向 AI 引擎) | ✅✅ | 一整套 geo:* 元信息 + GEO检测 入口 |
2.1.3、页面基础信息(<head>)
<!DOCTYPE html>
<html lang="zh-CN">
<head>
  <meta charset="utf-8">
  <title>Java基础学习笔记 09、IO流—File类与IO流-CSDN博客</title>
  <meta name="description"
        content="从 File 类入手,系统讲解 IO 流的体系与使用,涵盖字节流与字符流……">
  <meta name="keywords" content="Java,IO流,File,字节流,字符流">
  <meta name="viewport"
        content="width=device-width, initial-scale=1.0, minimum-scale=1.0, maximum-scale=1.0, user-scalable=no">
  <meta name="applicable-device" content="pc">
  <meta name="referrer" content="always">
  <link rel="shortcut icon" href="https://g.csdnimg.cn/static/logo/favicon32.ico" type="image/x-icon">
</head>
要点:
title采用「文章标题 + 站点名」的结构,站点名有助于品牌词。description是一段可读的摘要,和 OG、GEO 摘要复用同一份文案。keywords虽已不是主流排名因素,CSDN 仍保留,和标签一致。applicable-device: pc声明这版是 PC 页面(移动端另有版本)。
2.1.4、canonical:统一子域名 + 追踪参数
访问地址里带了追踪参数 ?spm=...,页面里 blog_address 也被设成个性化子域名 https://changlu.blog.csdn.net:
<link rel="canonical" href="https://blog.csdn.net/cl939974883/article/details/167174108"/>
var blog_address = "https://changlu.blog.csdn.net";
var articleDetailUrl = "https://changlu.blog.csdn.net/article/details/167174108";
也就是说:个性化的 changlu.blog.csdn.net、带 ?spm= 的追踪链接,全部收敛到同一个标准地址 blog.csdn.net/cl939974883/article/details/167174108。 这正是第一章讲的 canonical 用法——向搜索引擎声明首选网址,避免同一篇文章被拆成多个 URL 分散权重。
2.1.5、结构化数据:两套 JSON-LD
CSDN 在 <head> 里放了两份 JSON-LD,一份给通用搜索引擎,一份给百度:
第一份:Schema.org Article(含 GEO 扩展字段)
<script type="application/ld+json">
{
  "@context": "https://schema.org",
  "@type": "Article",
  "headline": "Java基础学习笔记 09、IO流—File类与IO流",
  "url": "https://blog.csdn.net/cl939974883/article/details/167174108",
  "image": "https://i-blog.csdnimg.cn/direct/998cac412100451991df30879630bd9b.png",
  "keywords": "Java,IO流,File,字节流,字符流",
  "inLanguage": "zh-CN",
  "datePublished": "2026-10-06T15:09:17+08:00",
  "dateModified": "2026-10-06T15:09:34+08:00",
  "description": "从 File 类入手,系统讲解 IO 流的体系与使用……",
  "articleSection": "Java",
  "author": [{
    "@type": "Person",
    "name": "长路ㅤ  ",
    "url": "https://blog.csdn.net/cl939974883"
  }],
  "publisher": {
    "@type": "Organization",
    "name": "CSDN",
    "logo": { "@type": "ImageObject", "url": "https://g.csdnimg.cn/static/logo/favicon32.ico" }
  },
  "geoSummary": {
    "heading": "内容摘要",
    "items": {
      "主题": "Java基础学习笔记 09、IO流—File类与IO流",
      "类型": "article",
      "适用场景": "从 File 类入手,系统讲解 IO 流的体系与使用……",
      "核心功能": "Java,IO流,File,字节流,字符流",
      "更新日期": "2026-10-06T15:09:34+08:00"
    },
    "keyPoints": ["Java", "IO流", "File", "字节流", "字符流"],
    "citationContext": {
      "authoritySource": "长路ㅤ  ",
      "factChecked": true,
      "lastVerified": "2026-10-06T15:09:34+08:00"
    }
  }
}
</script>
可以看到,除了标准的 Article 字段(标题、作者、发布/修改时间、publisher),它还在 JSON-LD 里塞了一个自定义的 geoSummary,把「主题 / 类型 / 适用场景 / 核心功能 / 更新日期 / 关键点 / 可引用性」结构化——这是专门喂给 AI 问答引擎的字段。
第二份:百度 Cambrian 结构化数据
<script type="application/ld+json">
{"@context":"https://ziyuan.baidu.com/contexts/cambrian.jsonld",
"@id":"https://blog.csdn.net/cl939974883/article/details/167174108",
"appid":"1638831770136827",
"pubDate":"2026-10-06T15:09:17",
"title":"Java基础学习笔记 09、IO流—File类与IO流-CSDN博客",
"upDate":"2026-10-06T15:09:17"}
</script>
这是百度资源平台(ziyuan.baidu.com)规定的 Cambrian 格式,用来告诉百度文章的发布时间和更新时间,便于百度在结果中展示时间信息。对不同搜索引擎分别输出结构化数据,是它的一个明显策略。
2.1.6、Open Graph 与分享元信息
分享到社交/IM 平台时用到的标签,CSDN 写得很完整:
<meta property="og:locale" content="zh_CN">
<meta property="og:type" content="article">
<meta property="og:title" content="Java基础学习笔记 09、IO流—File类与IO流-CSDN博客">
<meta property="og:description" content="从 File 类入手,系统讲解 IO 流的体系与使用……">
<meta property="og:url" content="https://blog.csdn.net/cl939974883/article/details/167174108">
<meta property="og:site_name" content="CSDN博客">
<meta property="og:image" content="https://i-blog.csdnimg.cn/direct/998cac412100451991df30879630bd9b.png">
<meta property="og:image:width" content="1200">
<meta property="og:image:height" content="630">
<meta property="og:image:alt" content="Java基础学习笔记 09、IO流—File类与IO流">
<meta property="article:published_time" content="2026-10-06T15:09:17+08:00">
<meta property="article:modified_time" content="2026-10-06T15:09:34+08:00">
<meta property="article:author" content="长路ㅤ  ">
<meta property="article:section" content="Java">
<meta property="article:tag" content="Java,IO流,File,字节流,字符流">
| 标签 | 作用 |
|---|---|
og:* | 分享卡片的标题、摘要、封面、标准网址、站点名 |
og:image:width/height | 明确封面尺寸,方便平台按 1200×630 排版 |
og:image:alt | 封面图替代文本,利于无障碍与图片理解 |
article:published_time / modified_time | 文章发布与更新时间 |
article:author / section / tag | 作者、分类、标签 |
值得注意:og:url 和 canonical 完全一致,都指向标准地址,两套数据共用同一份来源,符合第一章「SEO 与 Open Graph 共用同一份文章数据」的建议。此外它还额外输出了给字节系(头条)的 bytedance:published_time、bytedance:updated_time 等标签。
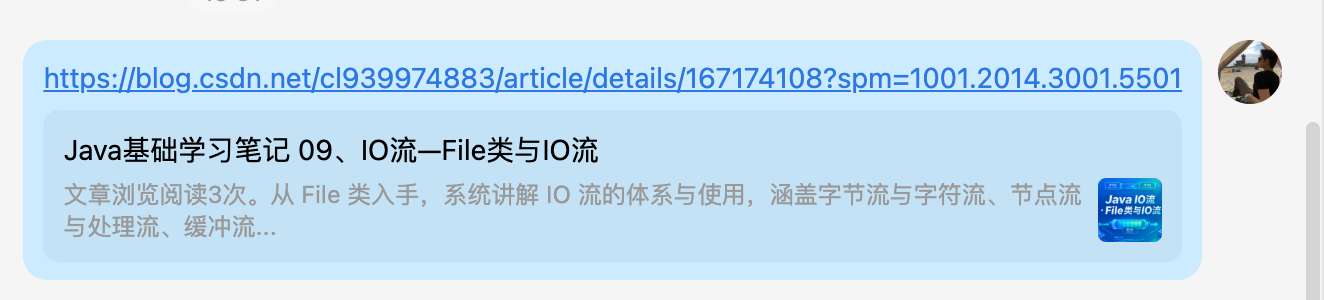
示范在qql中进行转发截图:
2.1.7、GEO 优化:面向 AI 搜索引擎的元信息(重点)
这是 CSDN 近期很典型、也很值得学习的一组优化。它用一批自定义 <meta>,把文章整理成「AI 可以直接引用的事实」。所谓 GEO,可以理解为 Generative Engine Optimization(生成式引擎优化)——让 ChatGPT、豆包、文心一言这类问答引擎在回答时更愿意引用你的内容。
<meta name="geo:keywords" content="Java,IO流,File,字节流,字符流">
<meta name="geo:summary" content="从 File 类入手,系统讲解 IO 流的体系与使用……">
<meta name="geo:entity_type" content="Article">
<meta name="geo:subject" content="Java基础学习笔记 09、IO流—File类与IO流">
<meta name="geo:key_points" content="Java|IO流|File|字节流|字符流">
<meta name="geo:citation_ready" content="true">

<meta name="description:direct_answer" content="从 File 类入手,系统讲解 IO 流的体系与使用……">
<meta name="author:credentials" content="长路ㅤ  ">
<meta name="author:affiliation" content="csdn">
<meta name="geo:source_type" content="original">
<meta name="geo:fact_checked" content="true">
<meta name="geo:editorial_policy" content="https://passport.csdn.net/service">
<meta name="geo:update_frequency" content="daily">
<meta name="geo:maintenance_status" content="active">
逐个解释:
| 元信息 | 含义 | 对 AI 引擎的作用 |
|---|---|---|
geo:summary | 内容摘要 | 给 AI 一段可直接摘取的概述 |
description:direct_answer | 直接答案 | 明确告诉 AI「这段就是问题答案」 |
geo:entity_type | 实体类型 Article | 帮助 AI 判断这是文章而非问答/商品 |
geo:subject | 主题 | 内容主旨 |
geo:key_points | 关键点(用 ` | ` 分隔) |
geo:citation_ready | 是否“引用就绪” | 声明可被直接引用 |
geo:source_type | 来源类型 original | 强调原创,提高可信度 |
geo:fact_checked | 是否已核验 | 声明内容经过事实核查 |
author:credentials / author:affiliation | 作者身份与机构 | 提供作者权威性(E-E-A-T) |
geo:editorial_policy | 编辑政策链接 | 让 AI 知道内容的编辑规范来源 |
geo:update_frequency | 更新频率 daily | 声明内容保持更新 |
geo:maintenance_status | 维护状态 active | 声明内容仍在维护 |
此外,文章标题区还有一个可见的 「GEO检测」按钮,链接到 https://mp.csdn.net/geo,说明 CSDN 已经把 GEO 做成了一个面向作者的产品功能:
<a class="geo-detection-btn"
   href="https://mp.csdn.net/geo?title=...&url=https%3A%2F%2Fchanglu.blog.csdn.net%2Farticle%2Fdetails%2F167174108&utm_source=blog_geo"
   data-report-view='{"spm":"3001.11779"}'>
  <span class="geo-detection-text">GEO检测</span>
</a>
归纳:CSDN 的 GEO 做法 = 在普通 SEO 元信息之外,再用
geo:*、description:direct_answer、author:credentials、citation_ready等字段,主动向 AI 引擎声明「这是什么内容、是否可信、能否直接引用」。 这套思路完全可以迁移到 BlogLoom。
2.1.7.1、考证:GEO 到底有没有「官方标准」?CSDN 是不是在照抄某个平台?
结论先说:CSDN 的 geo:* 并不是 W3C、IETF、Schema.org 这类正式标准定义的标签,而是 CSDN 平台自研的一套命名。 它对齐的是 2026 年快速兴起的 GEO 行业理念(尤其国内 CAAC 团体标准的「可信语料」原则),但没有任何搜索引擎官方承认会读取 geo:* 元信息。把 GEO 的来源分成四层来看更清楚:
| 层级 | 来源 | 时间 | 性质 | 与 CSDN geo:* 的关系 |
|---|---|---|---|---|
| 学术源头 | Aggarwal 等《GEO: Generative Engine Optimization》(Princeton,KDD 2024,arXiv:2311.09735) | 2023 论文 / 2024 会议 | 学术论文,首次提出 GEO 术语与定义 | 提供「GEO」这个概念本身,但不定义任何 HTML 标签 |
| 国内行业团体标准 | 中国商务广告协会 CAAC《生成式引擎优化(GEO)》五项团体标准 T/CAACCHINA 001~005-2026 | 2026-09-14 发布 | 团体标准(推荐性,非国标) | CSDN 的 original / fact_checked / update_frequency / author:credentials / editorial_policy 等,明显对齐其「可信语料」要求 |
| 开放提案 | llms.txt(Jeremy Howard / Answer.AI 提出)、llms-meta-tags(社区,用的是 llms: 前缀) | 2024 起 | 社区提案,未被主流采用 | CSDN 没有用 llms:,而是自造 geo: 前缀 |
| 搜索引擎官方 | Google《针对生成式 AI 功能优化》指南(2026)、Bing Webmaster 指南、Microsoft Advertising 指南 | 2026 | 官方文档 | Google 明确表示不需要这类特殊标记;Bing 把 GEO 写进文档但强调 SEO 基础 |
几个关键事实:
-
CAAC 五项团体标准是国内目前最接近「官方依据」的 GEO 文件,分别是:通论及术语定义、服务商评估规范、计价评估与测量规范、可信语料规范、服务流程合规与安全。其中「可信语料」提出六大原则——真实、权威、专业、可追溯、动态更新、中立。CSDN 的
geo:source_type=original、geo:fact_checked、geo:update_frequency=daily、geo:maintenance_status=active、author:credentials、geo:editorial_policy正是这套原则在页面元信息上的映射。但要注意:这是「服务与语料」标准,不是「HTML 元标签」标准。 -
Google 官方在 2026 年的 AI 优化指南中明确「泼冷水」:AEO/GEO 这些词在网上很热,但很多所谓捷径无效;Google 直接写道——「LLMS.txt 文件和其他特殊标记」Google 搜索并不使用,生成式 AI 搜索不需要结构化数据,也不需要专门为 AI 改写或分块内容。也就是说,
llms.txt、geo:*这类「专门喂 AI 的标记」,Google 并不采纳。 -
geo:这个前缀本身另有含义:在 HTML 中,geo.position、geo.placename、geo.region是历史上表示地理位置的元标签约定,与 CSDN 用来表示「生成式引擎优化」的geo:同名但含义完全不同。这属于命名复用,并非标准继承。 -
CSDN 把它做成了自家产品:文章页的「GEO检测」按钮跳转
https://mp.csdn.net/geo,说明geo:*更多是服务 CSDN 自己的 GEO 检测/优化功能,而不是给外部 AI 引擎的通用协议。
所以对 BlogLoom 的结论:
GEO 元信息(geo:*)
├── 不是正式标准:W3C / IETF / Schema.org 均未定义
├── 有行业参考:CAAC 五项团体标准(可信语料:真实/权威/专业/可追溯/动态更新/中立)
├── Google 官方态度:不需要特殊标记、不需要专门为 AI 写内容(仍属 SEO)
└── 平台自研:CSDN 用它服务自家 GEO 检测功能

BlogLoom 落地建议
├── 主线仍是标准 SEO:title / description / canonical / Schema.org / Sitemap / 正文直出
├── geo:* 元信息可选:可作为「增强信号」补充,但不能保证被任何 AI 引擎采用
└── 真正有效的是内容本身:原创、有权威来源、标注数据出处、持续更新
    (这恰好与 CAAC 可信语料六原则一致)
一句话:CSDN 的 GEO 不是抄某条官方协议,而是「行业 GEO 理念 + CAAC 可信语料原则」的平台化实现;它的价值不在标签本身,而在标签背后的内容可信度。BlogLoom 应优先把标准 SEO 与内容质量做扎实,
geo:*作为锦上添花。
来源:
- Aggarwal, P. et al. GEO: Generative Engine Optimization, KDD 2024,arXiv:2311.09735 — https://arxiv.org/abs/2311.09735
- 中国商务广告协会(CAAC)《生成式引擎优化(GEO)》五项团体标准 T/CAACCHINA 001~005-2026(2026-09-14):见《2026年中国生成式引擎优化(GEO)产业白皮书》— http://www.enet.com.cn/article/2026/1004/A202610041277817.html
- Google 搜索中心《针对 Google 搜索中的生成式 AI 功能进行优化》— https://developers.google.com/search/docs/fundamentals/ai-optimization-guide
- Wikipedia, Generative engine optimization — https://en.wikipedia.org/wiki/Generative_engine_optimization
llms.txt提案 — https://llmstxt.orgllms-meta-tags(社区提案,使用llms:前缀)— https://github.com/universokobana/llms-meta-tags
2.1.8、正文直接渲染(服务端直出)
正文没有靠 JavaScript 异步加载,而是直接写在返回的 HTML 里:
<article class="baidu_pl">
  <div id="article_content" class="article_content clearfix">
    <div id="content_views" class="markdown_views prism-tomorrow-night">
      <div class="toc">
        <h4>文章目录</h4>
        <ul>
          <li><a href="#_4">前言</a></li>
          <li><a href="#File_16">一、File类</a></li>
          ...
        </ul>
      </div>

      <h2><a id="_4"></a>前言</h2>
      ...
      <h2><a id="File_16"></a>一、File类</h2>
      ...
    </div>
  </div>
</article>
关键点:
- 标题用唯一的
<h1>,章节用<h2>/<h3>,层级清晰(本次抓取到 1 个<h1>、2 个<h2>、9 个<h3>)。 - 每个标题都带
id锚点(如id="File_16"),并生成顶部目录(TOC),既方便读者跳转,也让搜索引擎理解文章结构。 - 正文、代码块、图片都在首屏 HTML 中,符合第一章「首次 HTML 直接包含正文」的性能/收录要求。
2.1.9、分类与标签入口
文章通过 article:section 声明分类,正文底部和头部都有标签,且标签链接指向站内搜索聚合页:
<meta property="article:section" content="Java">
<meta property="article:tag" content="Java,IO流,File,字节流,字符流">

<a class="tag-link-new" rel="nofollow"
   href="https://so.csdn.net/so/search/s.do?q=IO%E6%B5%81&...">#IO流</a>

<a class="item-target"
   href="https://blog.csdn.net/cl939974883/category_13215351.html"
   title="Java后端开发从入门到进阶">专栏:Java后端开发从入门到进阶</a>
| 入口 | 作用 |
|---|---|
标签页 so.csdn.net/...?q=IO流 | 把同主题文章聚合成可抓取的列表页,形成内链 |
专栏/分类页 category_13215351.html | 文章归类入口,帮助爬虫发现同系列其它文章 |
rel="nofollow" | 对标签这类聚合链接声明不传递权重,避免链接被滥用 |
2.1.10、站内互链与内容发现
CSDN 在详情页里铺设了大量相关链接,帮助爬虫持续发现内容,也提升读者停留:
| 位置 | 形式 | 源码示例 |
|---|---|---|
| 上一篇/下一篇 | 同系列顺序链接 | <a href=".../167174099">Java基础学习笔记 08、异常处理</a> |
| 相关推荐 | 基于 ElasticSearch 的语义相关 | recommend-item-box type_blog,带 distribute.pc_relevant... |
| 大家在看 | 站内热门文章 | #asideHotArticle 下的 hotArticle-list |
| 专栏入口 | 系列聚合页 | category_13215351.html |
其中「相关推荐」的链接是服务端按相关度排序后直出的,不是纯前端渲染,这一点对爬虫很友好。
2.1.11、抓取提交与站点验证(站点级,但文章页可见痕迹)
详情页源码里能看到 CSDN 为各家搜索引擎配置的推送和验证脚本:
| 平台 | 痕迹 | 作用 |
|---|---|---|
| 神马搜索(UC) | <meta name="shenma-site-verification" content="..."> | 站点所有权验证 |
| 百度 | <script src="https://zz.bdstatic.com/linksubmit/push.js"> | 百度主动推送新文章 |
| 头条/字节 | lf1-cdn-tos.bytegoofy.com/goofy/ttzz/push.js | 头条搜索主动推送 |
| 百度 | 上一节提到的 Cambrian JSON-LD | 告诉百度时间信息 |
这正是第一章「配置 Sitemap 的三件事」里“告知搜索引擎”的工程化做法:除了 Sitemap,CSDN 还叠加了多家搜索引擎的主动推送 API,加速收录。
2.1.12、RSS 自动发现
页面里声明了博客的 RSS 地址,阅读器可自动发现:
<link rel="alternate" type="application/rss+xml"
      title="长路ㅤ  "
      href="https://blog.csdn.net/cl939974883/rss/map">
对应第一章的「RSS 自动发现」——文章页只负责声明 Feed 地址,Feed 本身由博客主页维护。
2.1.13、阅读页性能(部分实现)
| 第一章要求 | CSDN 做法 | 评价 |
|---|---|---|
| 正文直出 | #content_views 服务端渲染 | ✅ 好 |
| 图片优化 | 图片走 i-blog.csdnimg.cn,可用 ?x-oss-process=image/resize,... 压缩/resize | ✅ 好 |
| 图片懒加载 | 正文图片未看到 loading="lazy" / data-src 懒加载属性 | ⚠️ 有优化空间 |
| 减少阻塞脚本 | 引用了 jQuery、MathJax、多处第三方统计/推送脚本 | ⚠️ 第三方脚本较多,需靠异步加载缓解 |
对自建平台 BlogLoom 来说,CSDN 的性能并不算完美,图片懒加载 + 控制第三方脚本是我们可以做得更好的地方。
2.1.14、小结:CSDN 文章详情页优化清单
基础
├── <html lang="zh-CN">
├── 独立 <title>(文章标题 + 站点名)
├── <meta description> / keywords
└── viewport / referrer / favicon

搜索引擎
├── canonical(收敛子域名 + 追踪参数)
├── 结构化数据:Schema.org Article
├── 结构化数据:百度 Cambrian
├── 主动推送:百度 push.js / 头条 push.js
└── 站点验证:shenma-site-verification

内容传播
├── Open Graph(og:* + article:*)
├── 字节系元信息(bytedance:*)
└── RSS 自动发现(<link rel="alternate" type="application/rss+xml">)

GEO(面向 AI 引擎)
├── geo:summary / geo:subject / geo:key_points
├── geo:entity_type / geo:source_type / geo:citation_ready
├── description:direct_answer
├── author:credentials / author:affiliation
├── geo:fact_checked / geo:update_frequency / geo:maintenance_status
└── geoSummary(写在 JSON-LD 内)+ GEO检测入口

页面与内容
├── 正文服务端直出(#content_views)
├── h1/h2/h3 + 标题 id 锚点 + TOC
├── 分类 / 标签聚合入口
└── 站内互链(上一篇、相关推荐、热门、专栏)

性能
├── 图片 CDN + resize 参数
└── 正文直出(第三方脚本偏多,懒加载缺失)
一句话总结:CSDN 在「标准 SEO(title/description/canonical/结构化数据/OG/RSS)」之上,又叠加了一整套「GEO(geo: 元信息 + direct answer + 可引用性声明)」,并把找来的 8 项能力几乎全部落地。BlogLoom 可以按这套清单逐项对齐,其中 geo:* 元信息和结构化数据里的 geoSummary 是最值得我们优先补齐的差异化点。*
三、数据指标监测
整体网站不同数据监测区分为:访问数据、收录情况、收入情况平台。
3.1、Google平台汇总
| 你想知道什么 | 官方平台及入口 | 能看到的数据 |
|---|---|---|
| Google 有没有收录?哪些关键词带来了访问? | Google Search Console | 收录状态、抓取问题、搜索关键词、展示次数、点击次数、平均排名。Search Console Help |
| 网站来了多少人?看了哪些文章?从哪里来? | Google Analytics(GA4) | 用户数、浏览量、访问来源、热门页面、互动和事件。support.google.com |
| 网站展示 Google 广告,赚了多少钱? | Google AdSense | 预估收益、余额、付款,以及广告展示和点击等数据。Google AdSense Help |
Google Search Console(收录情况)
支持获取数据:收录状态、抓取问题、搜索关键词、展示次数、点击次数、平均排名。
举例:例如你发布一篇《Spring Boot 接入大模型》,它能帮助你回答:
- 这篇文章有没有被 Google 收录?
- 没收录时,报告显示什么原因?
- 用户搜索哪些词时,看到了这篇文章?
- 看到了多少次,最终点击进来了多少次?
- 修改标题、摘要后,搜索表现有没有变化?
其中几个指标很好理解:
| 指标 | 含义 |
|---|---|
| 展示次数 | 你的页面在 Google 搜索结果中被展示的次数 |
| 点击次数 | 用户从 Google 搜索结果点击到你网站的次数 |
| 点击率 CTR | 点击次数 ÷ 展示次数 |
| 平均排名 | 一段时间内的平均搜索位置,并非固定排名 |
GA4(Google Analytics,浏览分析)
**GA4:**获取网站整体的浏览数据。
它能把 Google 搜索、其他网站链接、推广活动等来源放在一起分析,也能查看各页面的访问和互动情况。比如“从 CSDN 文章链接过来了多少访问”,主要在这类流量分析平台中观察。Analytics Help
对于自建平台,建议关注这几项:
| 指标 | 你可以用它判断什么 |
|---|---|
| 用户数/访客数 | 网站的读者规模 |
| 浏览量 PV | 页面被浏览了多少次 |
| 访问来源 | 哪些渠道正在带来读者 |
| 热门文章 | 哪类内容最受欢迎 |
| 平均互动时长 | 用户是否在页面上持续互动 |
| GitHub、文档、订阅入口的点击 | 博客是否为你的开源项目带来进一步行动 |
最后一项需要配置对应的事件统计;购买、注册等业务行为也需要按要求上报,不能默认都会自动识别。
Google AdSense(Google 广告)
收入方面,需要看你采用哪种变现方式。
- 展示 Google 广告:接入 AdSense,网站通过审核后才能开始展示广告;收益、余额和付款看 AdSense,最终收入以核定数据为准。Google AdSense Help
- 卖资料、会员或订阅:实际到账以自己的订单和支付账单为准;GA4 可以通过配置购买、退款事件,分析哪些渠道带来了订单。Google Analytics(分析)帮助
仅仅接入之前两个统计平台不会产生收入,浏览量也没有固定的收益换算比例。
3.2、国内 & 自建数据平台指标
| 平台 | 适合什么需求 | 我的建议 |
|---|---|---|
| 百度统计 | 中文网站的访问、来源和行为分析 | 想使用国内厂商的统计平台,可以考虑。tongji.baidu.com |
| Umami | 访问量、来源、事件等分析,支持开源自部署 | 适合你这种有服务器、愿意自己维护的开发者,统计数据可以放在自己的基础设施上。umami |
Umami、百度统计可以承担网站访问分析,但 Google 的搜索收录和搜索关键词数据,仍然要看 Search Console。
四、案例实践:拿 BlogLoom 当例子,把 SEO 从 0 落地
前面三章偏"教科书":SEO 有哪些能力、CSDN 怎么做、数据去哪儿看。这一章换个画风——直接拿我自己的开源项目 BlogLoom 开刀,讲讲它现在卡在哪、我打算怎么一步步解决、最后想达到什么效果。
4.1、背景与现状:BlogLoom 是什么,现在卡在哪
先说说 BlogLoom 是什么
先把背景说清楚,不然后面直接讲"爬虫读不到"会很突兀。
BlogLoom 是我做的一套开源博客平台:
- 开源地址:https://github.com/changluya/BlogLoom
- 技术栈:Spring Boot 2.2.7 + MyBatis + Vue 2.6 + Vite
- 定位:给个人开发者 / 内容创作者自己搭博客用,也方便二次开发
它由三块组成:
| 模块 | 干嘛的 |
|---|---|
blog-view-ui | 博客前台(Vue2 单页应用),读者看文章的地方 |
blog-cms-ui | 管理后台(Vue 单页应用),作者写文章的地方 |
blog-backend | 后端服务(Spring Boot 接口 + MyBatis),负责提供数据 |
功能其实已经挺全了:Markdown 写作、分类标签专栏、评论、站点配置、访问统计、Docker 一键部署……唯独"搜索引擎收录"这块,几乎是空白。
顺便说一句:我自己的博客 https://blog.changlu.cloud/ 就跑在 BlogLoom 上。下文的"实测结果",都是直接访问这个线上站得到的。
实测一下:现在爬虫来了,能看到啥?
光说"没有 SEO"太虚,咱直接跑一下看结果。
| 请求 | 返回结果 | 说明 |
|---|---|---|
GET https://blog.changlu.cloud/ | 200,但只有一个空壳 | 源码里只有 <title>BlogLoom</title> 和一个空的 <div id="app">,正文一个字都没有 |
GET /robots.txt | 404 | 没有抓取规则文件 |
GET /sitemap.xml | 404 | 没有站点地图 |
GET /rss.xml | 404 | 没有订阅源 |
GET /blog/513(文章链接) | 404 | 直接打开文章链接,竟然是 404 |
GET /blog?id=513(接口) | 200,有完整正文 | 内容都在,只是没渲染到页面上 |
这里有两个扎心的点:
- 爬虫拿到的是空壳。 正文是浏览器执行 JS 后、再用 axios 调接口渲染出来的;爬虫不执行 JS,自然啥也读不到。
- 连直接打开文章链接都 404。 前台是 history 路由,但服务器没做 fallback——从首页点进去没问题,可一复制链接发给别人、或者刷新页面,就 404 了。
请求链路大概是这样的:
浏览器 / 爬虫
   ↓
blog-view-ui 的 index.html(空壳,<title>BlogLoom</title>)
   ↓ 浏览器执行 JS
axios 调 blog-backend 的 /blog 接口
   ↓
Vue 在浏览器里渲染正文,用 document.title 改标题
结果就是,爬虫和真实用户看到的完全是两个世界:
| 谁在看 | 看到的东西 |
|---|---|
| 爬虫(不执行 JS) | <title>BlogLoom</title> + 空 div,没有正文,也没有描述 |
| 用户(浏览器) | 正文、标题、评论,全都正常显示 |
说白了:不是内容不够好,是搜索引擎根本读不到。 这就是眼下最大的困局,也是必须第一个解决的地方。
4.2、目标:能被收录、做好 SEO、能看数据
改 SEO 也得有个盼头。我要的其实就三件事,而且有先后顺序:
| 优先级 | 目标 | 怎么判断做到了 |
|---|---|---|
| ① | 能被收录 | 在 Google / Bing / 百度搜 site:blog.changlu.cloud,能看到我的文章 |
| ② | 做好 SEO | 每篇文章有独立的标题、摘要、canonical、结构化数据;站点有 sitemap / robots / rss / 分享卡片 |
| ③ | 能看数据 | Search Console 看收录和搜索词,GA4 / Umami 看流量来源,形成每周复盘的习惯 |
一句话:先能被抓,才谈得上收录;先被收录,数据才有得看。
接下来的路线大概是这样:
① 让详情页能“服务端直出”        ← 当前最大的卡点
② 补齐数据字段                   ← 其实 API 里已经有了
③ 补站点级文件:sitemap / robots / rss
④ 接数据监控:Search Console + GA4(或 Umami)
⑤ 变现与 GEO:等内容和流量稳定了再说
4.3、第一步:让详情页能「服务端直出」
目标:爬虫执行 curl https://你的域名/blog/{id} 就能拿到完整正文和正确的 <title>/description。 有三条路线:
| 路线 | 做法 | 优点 | 代价 | 适合 |
|---|---|---|---|---|
| A. 后端直出详情页 | 后端用 Thymeleaf 渲染 /blog/{id},返回带正文与 meta 的 HTML | 最贴合现有 Spring Boot(项目已依赖 thymeleaf);收录效果最好、最稳 | 详情/列表页要从 SPA 分出来,改后端模板 | 推荐主路线 |
| B. 预渲染 / 动态渲染 | 部署时或对爬虫 UA 用无头浏览器渲染后返回 HTML | 前端基本不改,能当过渡 | 需额外服务;内容更新要重渲染 | 短期过渡 |
| C. 迁移 SSR 框架 | 改用 Nuxt / Next 等 SSR 框架 | 体验与 SEO 兼顾 | Vue2 迁移成本大 | 长期重构时 |
建议:主路线用 A——把「文章详情页 + 文章列表/标签/分类页」这类需要被收录的页面交给后端 Thymeleaf 直出;后台管理(blog-cms-ui)、登录等页面继续用 SPA 即可。若短时间改不动后端,可先用 B 过渡。
注意:Google 已明确动态渲染只是过渡方案,长期仍应使用服务端渲染或静态生成(见 4.4)。
数据字段:其实你 API 里已经有了
好消息是:我去翻了线上接口,GET /blog?id=513 返回的数据里,标题、正文、封面、描述、时间、标签、分类基本都有了。也就是说数据层不用大改,缺的只是「把它渲染成给爬虫看的 HTML」。为了后面 Sitemap、RSS、OG、结构化数据都能复用,建议再确认/补齐下面这些字段(字段名按实际调整):
文章表至少要有这些字段(字段名可按实际调整):
| 字段 | 示例 | 会被哪些 meta 复用 |
|---|---|---|
id | 167174108 | 内部关联 |
slug | java-io-file | 文章 URL / canonical / og:url / Sitemap |
title | Java基础学习笔记 09、IO流 | <title> / og:title / JSON-LD headline |
summary | 从 File 类入手…… | description / og:description / geo:summary |
cover | https://.../cover.png | og:image / JSON-LD image |
content | 正文 HTML | 正文直出 |
author_name / author_url | 长路 / /u/1 | article:author / JSON-LD author / author:credentials |
published_at | 2026-10-06T15:09:17+08:00 | article:published_time / datePublished |
updated_at | 2026-10-06T15:09:34+08:00 | article:modified_time / dateModified |
tags | Java,IO流,File | article:tag / 标签聚合页 |
category | Java | article:section / 分类聚合页 |
status | published / draft / private | 是否进 Sitemap、是否可被索引 |
locale | zh-CN | <html lang> / og:locale / inLanguage |
一份数据,展开成全站 meta:
article.title       → <title> / og:title / JSON-LD headline
article.summary     → meta description / og:description / geo:summary
article.cover       → og:image / JSON-LD image
article.slug        → canonical / og:url / Sitemap
article.author       → article:author / JSON-LD author / author:credentials
article.published_at → article:published_time / datePublished
article.updated_at   → article:modified_time / dateModified
article.tags         → article:tag / 标签聚合页
article.category     → article:section / 分类聚合页
article.status       → 是否进 Sitemap、是否可被索引
顺手把路由也对齐现状(BlogLoom 现有路由):
/                        首页
/blog/:id                文章详情(canonical 指向这个地址)
/tag/:name               标签聚合页
/category/:name          分类聚合页
/column/:id              专栏页
/sitemap.xml             动态生成(后端)
/rss.xml                 订阅源(后端)
/robots.txt              抓取规则
/api/**  /admin/**       禁止抓取
用数字
id做路径对 SEO 没问题(稳定即可);若能加可读slug(如/blog/java-io-file)更好。
三条原则(贯穿全章):
- 数据驱动模板:文章数据 → 一个公共模板片段 → 生成全部 meta,不硬编码、不落字段。
- 服务端直出:正文和 meta 都在首屏 HTML 里,不依赖 JavaScript。
- 一次建模、全站复用:
title / summary / cover / 时间 / 标签在数据库定一次,详情页、Sitemap、RSS、OG 共用。
动后端:用 Thymeleaf 把详情页直出
**这一步要做的,就是把上面那批字段,渲染成爬虫能直接读到的 HTML。**每篇文章都有独立网址、独立标题,正文能被直接读取,结构清晰。
| 能力 | BlogLoom 要做什么 | 验收标准 |
|---|---|---|
| 独立 URL | 每篇文章一个稳定路径,如 /posts/{id} 或 /posts/{slug} | 打开任一文章的 URL 都能独立访问 |
| 标题 | 每页输出唯一的 <title>(文章标题 + 站点名) | 查看源码只有一个 <title> |
| 摘要 | 输出 <meta name="description"> | 内容与文章一致,不空、不堆关键词 |
| canonical | 每篇文章输出自己的标准 URL | 站内链接、Sitemap、canonical 三者一致 |
| 正文直出 | 正文由 Thymeleaf 服务端渲染进首屏 HTML | 禁用 JS 后正文仍可见(curl 即可看到) |
| 标题层级 | 单 h1,章节用 h2/h3,可加锚点 | 每页只有一个 h1,层级不乱跳 |
| 结构化数据 | 输出 Article / BlogPosting 的 JSON-LD | 用 Google 富媒体测试工具校验通过 |
| 图片 | CDN 化、给定尺寸、正文下方图片懒加载 | 图片不撑破布局、首图不过大 |
最小可做:先把「独立 title + description + canonical + 正文直出」四件做掉,收益最大。
BlogLoom 落地示例(Thymeleaf 公共片段):
<!-- templates/fragments/seo.html -->
<head th:fragment="seoHead(article)">
  <title th:text="${article.title} + ' - BlogLoom'">标题 - BlogLoom</title>
  <meta name="description" th:content="${article.summary}">
  <link rel="canonical" th:href="${article.canonicalUrl}">

  <meta property="og:type" content="article">
  <meta property="og:title" th:content="${article.title}">
  <meta property="og:description" th:content="${article.summary}">
  <meta property="og:image" th:content="${article.cover}">
  <meta property="og:url" th:content="${article.canonicalUrl}">
</head>
文章页只需引入这个片段,JSON-LD 也在同一片段里输出(结构见 1.2)。所有 meta 都来自文章对象,模板里不写死任何标题或描述。
4.4、第二步:补齐站点级文件(sitemap / robots / rss)
前面实测时,robots.txt、sitemap.xml、rss.xml 全都是 404。这一步就是把它们补上——让搜索引擎找得到、读者订阅得到、链接分享出去也好看。
| 能力 | BlogLoom 要做什么 | 验收标准 |
|---|---|---|
| robots.txt | 根目录提供,禁止 /admin/、/api/ 等,并声明 Sitemap | 访问 /robots.txt 能看到规则 |
| Sitemap | 程序自动生成,只含公开已发布文章,发布/修改/删除后同步 | 访问 /sitemap.xml 内容正确;后台/草稿不出现 |
| RSS / Atom | 发布文章时自动更新(只输出最近几十篇公开文章) | 阅读器能订阅;<link rel="alternate"> 声明 Feed |
| Open Graph | 文章模板统一输出 og:title/description/image/url | 分享链接能生成正确卡片;og:image 用完整 URL |
| 站内互链 | 上一篇/下一篇、相关文章、分类与标签页 | 标签/分类是可抓取的列表页,不是空壳 |
| 主动推送(可选) | 接百度/必应等「主动推送」接口加速收录 | 推送后台能看到成功记录 |
注意:robots.txt 是抓取规则,不是权限控制;私密内容仍需登录鉴权(见 1.2)。
4.5、第三步:接上数据监控
页面能被抓到了,还不够——你得知道「到底有没有被收录」「人是从哪来的」「哪篇最受欢迎」。这一步就是把这些数据接进来。
接入顺序(从易到难):
- 开通 Search Console:添加博客域名,用 DNS 等方式验证所有权,提交
sitemap.xml。这一步可以现在就做,不必等 Thymeleaf 改造完成。Search Console 帮助 - 接入一种访问统计:省维护成本用 GA4;想把数据握在自己手里用 Umami。GA4 通常要创建网站数据流,再把统计代码放进公共模板。Analytics Help
- 每周看一次趋势:重点看「搜索点击、访客数、热门文章、来源渠道、GitHub 点击」五项。
三组数据分开看(对应 1.3、3.1):
| 想看什么 | 主要看哪里 |
|---|---|
| 收录、搜索关键词、展示/点击/排名 | Search Console |
| 用户数、浏览量、来源、热门文章 | GA4 或 Umami / 百度统计 |
| 广告展示、预估收益、最终结算 | 广告联盟后台(如 AdSense) |
| 推广关联、有效订单、佣金 | 返佣平台后台 |
建议:先用 Search Console + GA4,不需要一开始自己开发统计后台。
4.6、变现与 GEO:等内容稳定了再说
变现:先别急
**前提:先有稳定内容与访问,再谈变现。**仅接入统计平台不会产生收入,浏览量也没有固定收益换算比例(见 1.3)。
| 方式 | 什么时候做 | 看什么数据 |
|---|---|---|
| 推广返佣(CPS) | 有部署/云服务器/开发工具类内容时最适合 | 返佣后台的关联、有效订单、佣金 |
| Google AdSense | 内容和访问稳定、通过审核后 | AdSense 的展示、预估收益、结算 |
| 直接赞助 | 有明确定位和读者群后自行洽谈 | 合同约定的周期/效果 |
红线:不要自己或让朋友点广告。Google 明确禁止人工抬高展示、点击等无效流量。
GEO:锦上添花(可选)
**前提:阶段一~三基本完成,且文章内容真实可信。**GEO 的 geo:* 元信息只是增强信号(见 2.1.7、2.1.7.1),真正决定能否被 AI 引用的是内容质量。
| 动作 | 说明 |
|---|---|
输出 geo:* 元信息 | geo:summary、geo:entity_type、description:direct_answer 等 |
| 声明可信属性 | author:credentials、geo:source_type=original、geo:fact_checked、geo:update_frequency |
结构化数据加 geoSummary | 在 JSON-LD 内补充摘要、要点、可引用性 |
| 内容建设 | 原创、有权威来源、标注数据出处、持续更新(对齐 CAAC「可信语料」六原则) |
提醒:Google 官方明确表示不需要这类特殊标记,llms.txt/geo:* 不保证被采用。优先把标准 SEO 和内容做好,GEO 作为锦上添花。
4.7、上线验收清单
| 阶段 | 项目 | 完成 |
|---|---|---|
| 一 | 独立 URL / title / description / canonical | ☐ |
| 一 | 正文服务端直出,单 h1,标题层级清晰 | ☐ |
| 一 | Article JSON-LD 通过校验 | ☐ |
| 一 | 图片 CDN + 尺寸 + 懒加载 | ☐ |
| 二 | /robots.txt 正确并声明 Sitemap | ☐ |
| 二 | /sitemap.xml 自动生成、只含公开文章 | ☐ |
| 二 | RSS/Atom 自动更新并有 <link rel="alternate"> | ☐ |
| 二 | Open Graph 输出完整、og:url 与 canonical 一致 | ☐ |
| 二 | 标签/分类/相关文章等站内互链 | ☐ |
| 三 | Search Console 验证并提交 Sitemap | ☐ |
| 三 | GA4 或 Umami 接入,GitHub/订阅点击配置事件 | ☐ |
| 三 | 建立每周看趋势的习惯(5 项指标) | ☐ |
| 四 | 内容和访问稳定后再接 AdSense/CPS/赞助 | ☐ |
| 五 | geo:* 元信息 + 内容可信度建设(可选) | ☐ |
每周花五分钟看一眼
固定看这五项即可,避免被海量指标淹没:
① 搜索点击(Search Console)
② 访客数(GA4 / Umami)
③ 热门文章(GA4 / Umami)
④ 来源渠道(GA4 / Umami)
⑤ GitHub / 订阅入口点击(配置事件后看)
一句话总结:先把阶段一、二的技术底座做扎实,再接阶段三的数据看趋势;变现和 GEO 都建立在前面的内容与流量之上,不必颠倒顺序。
参考资料
[1]. Sitemaps XML 协议(Sitemaps.org)
[2]. RFC 9309:Robots Exclusion Protocol
[3]. RFC 6596:The Canonical Link Relation
[4]. Schema.org
[5]. JSON-LD 1.1(W3C)
[6]. RSS 2.0 Specification(RSS Advisory Board)
[7]. Web Vitals(web.dev)
[8]. Google Search Console
[9]. Search Console 帮助:验证网站所有权
[10]. Search Console 帮助:效果报告指标
[11]. Google Analytics(GA4)
[12]. Analytics 帮助:创建 GA4 数据流
[13]. Google AdSense
[14]. Google AdSense 帮助:资格要求
[15]. Google AdSense 帮助:无效流量
[16]. 百度统计
[17]. 百度搜索资源平台(Cambrian 结构化数据)
[18]. Umami / Umami Docs
[19]. 腾讯云推广大使(CPS)
[20]. EthicalAds(Publisher Guide)
[21]. Aggarwal et al.《GEO: Generative Engine Optimization》(KDD 2024,arXiv:2311.09735)
[22]. 2026年中国生成式引擎优化(GEO)产业白皮书(CAAC 团体标准)
[23]. Google 搜索中心:针对生成式 AI 功能优化网站
[24]. Wikipedia:Generative engine optimization
[25]. llms.txt 提案
[26]. llms-meta-tags(GitHub)
[27]. BlogLoom 开源项目(GitHub)
[28]. BlogLoom 线上站点
[29]. CSDN 参考文章(本文拆解对象)
整理者:长路 创建时间:2026.10.6 更新时间:2026.10.6
转载自 CSDN-专业IT技术社区
原文链接:https://blog.csdn.net/cl939974883/article/details/167174925

