

9月30日,HPE宣布获得其首笔AMD Helios AI机架系统订单,客户为云服务商Vultr。这笔订单标志着Helios从2025年OCP峰会上的参考设计,正式走向规模化商业部署。对AI算力基础设施而言,这不是又一台新服务器的发布,而是机架级AI算力从单一供应商主导走向多供应商竞争的关键节点。
本文从MI455X芯片架构、Helios机架系统设计、UALink互联体系、与GB300 NVL72及华为昇腾960超节点的三方对比四个维度,拆解这套72 GPU scale-up方案的技术逻辑,并分析其对AI算力产业格局的影响。
一、AMD Helios从参考设计走向规模部署
Helios的推进节奏清晰。2025年10月OCP全球峰会上,AMD首次公开展示Helios机架级AI平台原型,采用Meta主导的Open Rack Wide开放机架标准。2025年12月,HPE宣布与Broadcom合作推出首款基于Helios架构的商用机架,集成开放scale-up网络。2026年7月23日,AMD正式发布MI455X GPU和Helios rackscale方案,公布完整规格。2026年9月30日,HPE宣布首笔商用订单,客户Vultr。
Vultr选择Helios的背景值得关注。作为独立云服务商,Vultr此前已在其平台上提供AMD MI355X GPU实例。此次采购Helios机架,意味着其AI算力基础设施从单卡/单机部署升级到机架级scale-up域。对AMD而言,这是MI400系列GPU首次以完整机架形态进入公开云服务市场。
OEM层面,Helios的合作伙伴包括HPE、Lenovo、Supermicro、Bull等。Oracle此前已宣布将在2026年第三季度成为首个提供5万颗MI450系列GPU的超大规模云厂商。Vultr订单与Oracle部署共同构成AMD在AI训练基础设施领域的实质性客户基础。
二、MI455X GPU:CDNA5架构的技术拆解
MI455X是Helios机架的计算核心,也是AMD首款基于CDNA 5架构的产品。理解Helios的性能,必须先拆解这颗芯片。
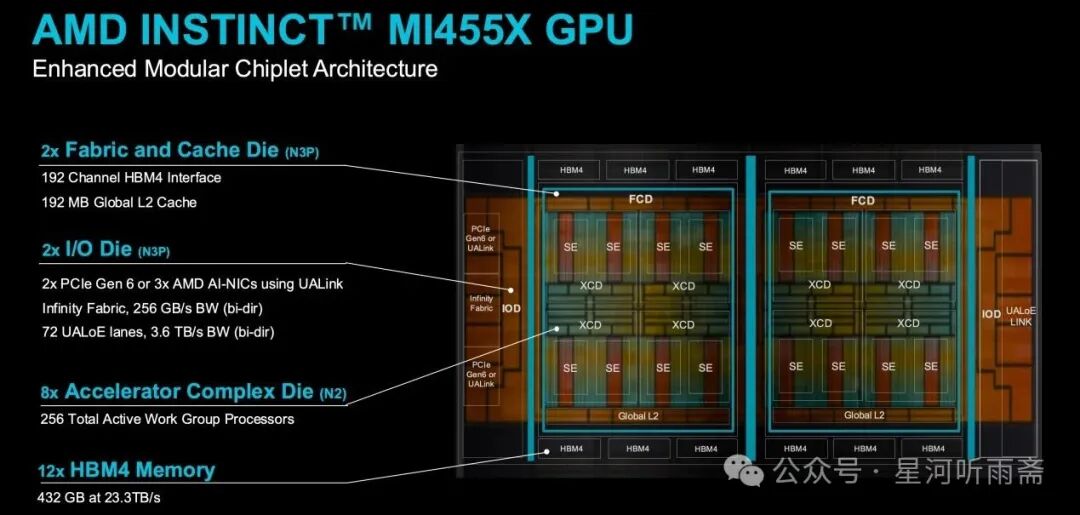
制程与Chiplet架构。 MI455X采用异构制程设计:计算核心die使用TSMC 2nm工艺,I/O与缓存die使用TSMC 3nm FinFET工艺。整颗芯片集成约3200亿晶体管,由24个chiplet组成,具体包括8个加速计算复杂die(Accelerator Complex Die)、2个I/O die、2个互联与缓存die(Fabric and Cache Die),以及12组HBM4显存堆叠。计算die之间采用3D混合键合(3D Hybrid Bonding)实现高密度互连,这是AMD首次在数据中心GPU中引入这项先进封装技术。
这种模块化设计的逻辑在于:计算、缓存、I/O、显存四类功能对制程和优化目标的要求不同。计算die追求极致晶体管密度和频率,用最先进的2nm;I/O die需要大量模拟电路和高速接口,3nm更成熟且成本更优;缓存die对密度敏感但不需要最高频率;HBM4则通过独立堆叠最大化容量和带宽。各模块独立优化,比单片大芯片更灵活,也更利于良率控制。
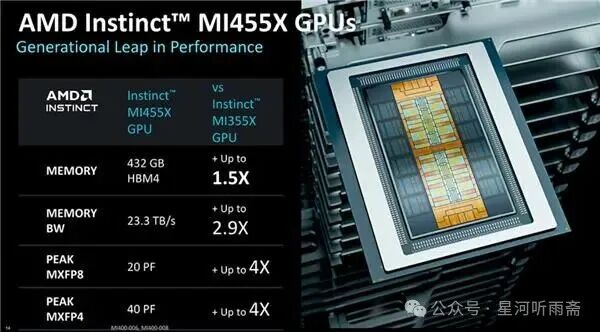
计算单元与算力。 MI455X集成256个Work Group Processor,采用Wave32执行模式,峰值引擎频率2400 MHz。低精度算力方面,OCP MXFP4峰值40.3 PFLOPS,MXFP6和MXFP8均为20.1 PFLOPS,OCP FP8为20.1 PFLOPS。半精度FP16矩阵算力315 TFLOPS,单精度FP32矩阵算力5 PFLOPS,双精度FP64矩阵算力5 TFLOPS。支持结构化稀疏(Structured Sparsity),稀疏下FP8算力翻倍。
MXFP4和MXFP6是AMD主推的微缩放(Microscaling)数据格式,通过对权重和激活分别使用不同位宽,在保持模型精度的同时显著提升算力密度。MI455X在MXFP4下单卡40 PFLOPS,72卡机架合计约2.9 EFLOPS,这是Helios标称FP4算力的来源。
显存子系统。 MI455X集成432GB HBM4显存,共12个堆叠,峰值理论显存带宽23.3 TB/s。HBM4相对HBM3e的代际提升在于更高的单堆叠容量和带宽密度。432GB单卡显存意味着72卡机架合计31TB HBM4显存,这一容量对超大模型训练和长上下文推理具有直接价值。此外,MI455X配备192MB Infinity Cache,用于减少对外部显存的访问频次,降低数据搬运能耗。
封装与散热。 MI455X采用增强加速模块(Enhanced Accelerator Module,EAM)封装形态,散热方式为直接液冷(Direct Liquid Cooling,DLC)。在72卡密集部署的机架中,单卡功耗较高,风冷已无法满足散热密度要求,直接液冷是必然选择。EAM封装将GPU die、HBM4堆叠和中介层集成在单一模块内,便于机架级液冷冷板的统一部署。
互联接口。 每颗MI455X提供3.6 TB/s的scale-up带宽(机架内GPU间互联)和600 GB/s的scale-out带宽(机架间互联)。scale-up采用UALink协议,scale-out采用UALoE(UALink over Ethernet)。这一互联体系是Helios与NVIDIA NVLink/NVSwitch方案最根本的架构差异,后文详述。
三、Helios机架:72 GPU scale-up域的系统设计
Helios不是把72张GPU卡简单塞进一个机柜,而是从机架层面重新设计了计算、存储、网络和散热的协同架构。
计算与CPU配置。 每个Helios机架集成72颗MI455X GPU和18颗AMD EPYC "Venice" 9006系列服务器CPU。每颗CPU最高256核,18颗合计最高4608核。CPU与GPU的比例为1:4,即每颗EPYC CPU对应4颗MI455X GPU。这一比例与GB300 NVL72的1:2(36颗Grace CPU对应72颗Blackwell Ultra GPU)不同,反映了两种架构对CPU角色的不同定位:AMD方案中CPU更多承担主机管理和数据预处理,GPU间直接通过UALink互联;NVIDIA方案中Grace CPU与Blackwell GPU通过NVLink-C2C紧密耦合,CPU深度参与数据移动。
内存层级。 机架内GPU侧合计31TB HBM4显存,CPU侧最高36TB DDR5系统内存。两层内存构成异构存储层级:HBM4负责模型参数、KV缓存和激活值的高速访问,DDR5负责数据集缓存、检查点和系统级数据。对万亿参数模型训练而言,31TB HBM4意味着更大比例的模型参数可以驻留在高带宽显存中,减少跨节点通信。
Scale-up互联。 72颗GPU通过UALink组成单一scale-up域,聚合带宽260 TB/s。这是Helios机架最核心的系统指标。260 TB/s意味着机架内任意GPU之间的全互联带宽足以支撑数据并行和张量并行训练,不需要在机架内引入额外的交换芯片。作为对比,GB300 NVL72的NVLink域聚合带宽为130 TB/s。Helios在scale-up带宽上约为2倍。
网络与Scale-out。 机架内集成AMD Pensando Vulcano AI NIC,负责scale-out网络,即机架之间的互联。scale-out采用开放以太网,通过UALoE协议将UALink的语义映射到以太网上,使机架间通信可以复用标准以太网交换机和光纤基础设施。这与NVIDIA的NVLink Domain(机架内)加InfiniBand或Spectrum-X以太网(机架间)的双层网络形成对比。
机架标准与可维护性。 Helios基于OCP Open Rack Wide(ORW)开放机架标准设计,采用双宽机架形态。中间为主要计算区,两侧配置维护通道。GPU以托盘(Tray)形式部署,支持托盘级维护,即可以在不中断整个机架运行的情况下更换故障托盘。机架级管理软件提供遥测、故障诊断和功耗管理功能。
散热。 整个机架采用直接液冷,GPU和CPU均通过冷板散热。液冷分配单元(CDU)集成在机架内或邻近部署。在72卡满载情况下,机架功耗极高,液冷是维持长期稳定运行的必要条件,也是当前所有机架级AI方案的共同选择。
四、互联架构:UALink开放标准与NVLink封闭生态的路线分野
Helios与GB300 NVL72最本质的差异不在单卡算力,而在互联体系的开放与封闭。
UALink联盟。 UALink是由AMD、Broadcom、Cisco、Google、HPE、Intel、Meta、Microsoft等厂商共同推动的开放加速器互联标准。其目标是定义一个开放、可互操作的chip-to-chip和rack-to-rack互联协议,使不同厂商的加速器、CPU和网络设备能够在同一scale-up域中协同工作。UALink 1.0规范已于2025年发布,定义了每链路112G PAM4信号、低延迟一致性协议和内存语义。
MI455X的scale-up接口原生支持UALink,每卡3.6 TB/s带宽。Helios机架内72卡通过UALink交换机(由Broadcom等提供)组成全互联拓扑。关键在于,UALink交换机不绑定AMD,任何符合UALink标准的加速器理论上都可以接入同一scale-up域。
UALoE。 UALoE(UALink over Ethernet)是UALink在以太网物理层上的映射,用于机架间scale-out通信。它使机架间通信可以使用标准以太网交换机和光模块,不需要专用的InfiniBand或NVLink网络设备。这对已有大规模以太网基础设施的云厂商具有直接吸引力。
NVLink生态。 NVIDIA的NVLink和NVSwitch是专有协议,仅支持NVIDIA自家GPU和Grace CPU。GB300 NVL72通过NVLink实现72卡全互联,单卡3.6 TB/s NVLink带宽,机架聚合130 TB/s。机架间通过InfiniBand或NVIDIA Spectrum-X以太网连接。NVLink的优势在于软硬件深度协同,CUDA生态对NVLink的优化已经非常成熟;劣势在于供应商锁定,客户无法在同一scale-up域中混合使用其他厂商的加速器。
路线差异的产业含义。 UALink代表的开放路线,核心价值在于降低云厂商的供应商锁定风险,使多供应商混合部署成为可能。对Vultr这类独立云厂商而言,选择Helios意味着其AI算力基础设施不依赖单一供应商的专有互联协议,未来可以在同一机架架构中引入其他符合UALink标准的加速器。对AMD而言,开放标准是其在AI算力市场挑战NVIDIA主导地位的关键杠杆,因为单靠产品性能很难短期撼动CUDA生态,而开放互联可以降低客户的切换成本。
五、三方架构对比:Helios、GB300 NVL72与昇腾960超节点
将Helios与NVIDIA当前最新的GB300 NVL72、华为2026年9月发布的昇腾960超节点放在同一维度对比,可以看到全球三大AI算力架构的路线分野。需要先说明规模差异:Helios和GB300 NVL72是72卡单机架方案,昇腾960超节点是4096卡SuperPod级集群。
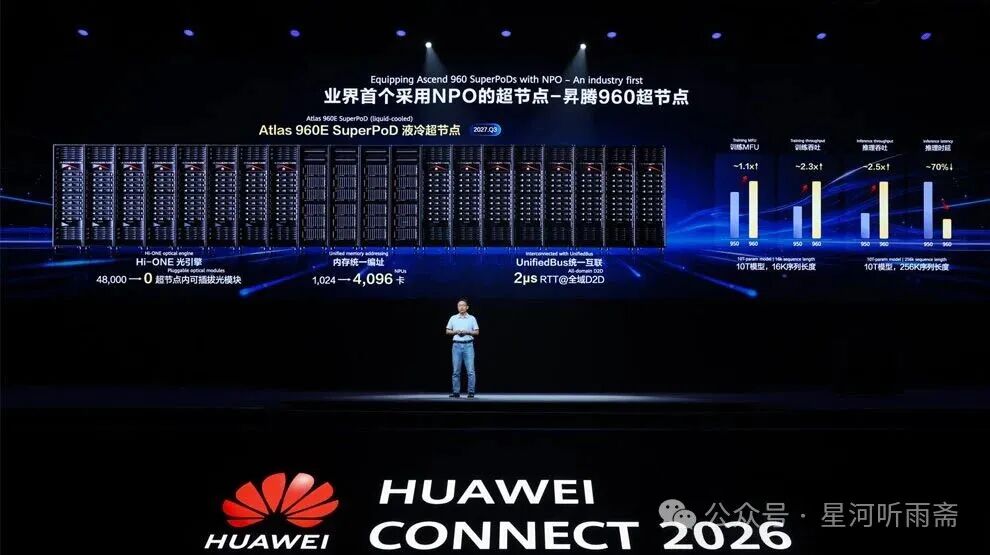
规模与定位。 Helios单机架72卡,定位训练与推理通用;GB300 NVL72单机架72卡,定位偏向test-time scaling推理与AI推理;昇腾960超节点单集群4096卡,定位10万亿参数大模型的大规模训练与推理。昇腾960的规模约为57个Helios机架,其设计目标从一开始就是万卡级统一计算域,而非单机架堆叠。
算力。 Helios机架标称1.4 EFLOPS FP8、2.9 EFLOPS FP4;GB300 NVL72采用Blackwell Ultra GPU,稠密FP4较上一代Blackwell提升1.5倍,定位推理;昇腾960超节点标称8 EFLOPS FP8、16 EFLOPS FP4。三者使用的低精度格式不同(MXFP4、NVFP4、华为自定义格式HiF4),昇腾960在总算力上因规模优势显著领先。
显存。 Helios机架合计31TB HBM4;GB300 NVL72机架GPU内存最高20TB HBM3e,另有17TB LPDDR5X CPU内存,合计Fast Memory 37TB;昇腾960超节点配备1PB HBM。昇腾960的1PB HBM约为Helios的32倍,这是4096卡规模的直接结果,也意味着更大比例的万亿参数模型可以驻留在高带宽显存中。单卡口径下,MI455X的432GB HBM4在三者中单卡显存容量最高。
互联架构。 Helios采用UALink开放标准,机架内260 TB/s聚合带宽,机架间UALoE开放以太网;GB300采用NVLink专有协议,机架内130 TB/s,机架间InfiniBand或Spectrum-X;昇腾960采用灵衢(Peerium)UnifiedBus协议,实现4096卡统一内存编址,RTT最低2微秒。灵衢的核心特征是"平等互联",打破传统机箱内外两套协议的壁垒,让计算芯片、内存、存储之间用同一套协议通信,这是昇腾960能够实现4096卡单一逻辑计算域的关键。
光互联技术。 这是三者最具差异化的维度。Helios机架间使用标准以太网光模块,走开放路线;GB300机架间使用InfiniBand或Spectrum-X以太网,NVIDIA在CPO方向已有Spectrum-X硅光交换机量产;昇腾960超节点则是全球首个采用NPO(近封装光学)技术的超节点,用5500个Hi-ONE光引擎替代原本需要的4.8万颗800G光模块,功耗降低超550千瓦,系统无故障运行时间提升一倍,系统可用度达99.8%。NPO把光引擎从面板移到交换芯片附近,缩短电信号路径,是光互联从可插拔向集成化演进的关键一步,昇腾960是首个在万卡级集群中规模落地NPO的方案。
CPU与系统架构。 Helios使用18颗独立EPYC Venice x86 CPU,CPU与GPU解耦;GB300使用36颗Grace ARM CPU,与Blackwell Ultra通过NVLink-C2C芯片级耦合;昇腾960超节点基于鲲鹏CPU和昇腾NPU的全栈自研体系,灵衢架构覆盖计算、互联、存储、管理全链路。三者代表了三种系统集成哲学:AMD走开放解耦路线,NVIDIA走芯片级紧密耦合路线,华为走全栈垂直整合路线。
散热与部署。 三者均采用全液冷。Helios基于OCP开放机架标准,GB300有自有规格,昇腾960采用正交架构和全液冷设计。对已有OCP基础设施的数据中心,Helios兼容性更好;对已有NVIDIA部署的客户,GB300迁移成本最低;昇腾960则需要完整的华为数据中心生态配套。
产品阶段与生态。 Helios刚获首笔商用订单,ROCm生态持续完善中;GB300已规模量产,CUDA生态成熟度最高;昇腾960超节点液冷版计划2027年第三季度上市,CANN和MindSpore生态在国内快速发展,但国际化程度仍有限。软件生态成熟度是决定三者长期竞争力的关键变量,目前CUDA仍具压倒性优势,ROCm和CANN都在快速追赶。
六、产业格局判断
Helios首单的产业意义,体现在三个层面。
第一,AMD在AI训练基础设施领域完成了从"有产品"到"有规模部署"的跨越。 过去几代MI系列GPU的问题不在于单卡规格,而在于缺乏完整的机架级方案和规模客户验证。Helios把GPU、CPU、互联、网络、散热和管理软件整合为一个交钥匙机架,Vultr订单证明这套方案已经通过云厂商的工程验证。Oracle的5万颗GPU部署则提供了超大规模客户的背书。
第二,开放标准正在成为AI算力基础设施的第二极。 NVIDIA的NVLink加CUDA封闭生态在过去几年几乎没有对手,但随着模型规模增长和算力需求多元化,云厂商对供应商锁定的担忧在上升。UALink联盟集结了几乎所有非NVIDIA的主要算力厂商,Helios是第一个基于UALink的完整机架产品。如果UALink生态能够持续扩大,未来AI数据中心可能出现NVIDIA专有域和UALink开放域并存的格局。
第三,万卡级统一计算域和光互联集成化正在成为下一代AI算力的竞争焦点。 昇腾960超节点用灵衢架构实现4096卡统一内存编址,用NPO替代数万光模块,代表了从"机架堆叠"走向"超节点统一计算域"的架构方向。Helios和GB300当前仍是72卡机架规模,未来向万卡级扩展时,互联协议和光互联技术将成为决定性变量。显存容量、互联带宽和光集成度,正在取代单卡算力峰值,成为机架级AI算力的核心竞争维度。
对AI算力产业而言,Helios首单不是终点,而是多供应商竞争格局正式形成的起点。AMD的开放解耦、NVIDIA的芯片级耦合、华为的全栈垂直整合,三条路线将在未来两到三年内展开直接竞争。真正的考验在于各自软件生态能否跟上硬件步伐,以及互联标准能否吸引足够多的第三方加入。硬件架构的差距可以在一到两代产品内缩小,但生态的构建需要更长时间。
——————
免责声明:本文仅用于AI算力基础设施与半导体技术研究,不构成任何投资、证券或金融产品相关建议,不作为投资参考。文中数据以各企业官方披露及权威机构公开资料为准。
张星河
每天一份高质量研报,持续聚焦芯片半导体、AI基础设施、AI智能硬件、具身智能、光通信等硬科技方面的行业研究、产业链分析与技术拆解。欢迎您的关注!
转载自 CSDN-专业IT技术社区
原文链接:https://blog.csdn.net/duke_zhang2024/article/details/167270365

