

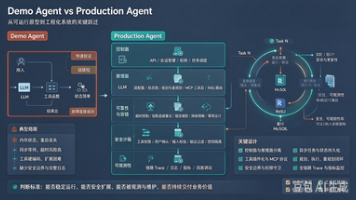
前言:一个残酷的判断
我最近在github上或是社媒上看到过很多 Agent 项目,有一个规律几乎从不例外:
Demo 靠功能,生产靠失败模式。
Demo 的评判标准是"它能做什么";生产的评判标准是"它出错的时候会怎样"。
这个区别不是程度上的差异,而是设计出发点的差异。一个围绕功能设计的 Agent,你后面每加一个生产级能力(可观测、可回放、可评测、权限控制)都要改一遍循环;而一个围绕失败模式设计的 Agent,这些能力是架构的自然推论。
下面从一起真实事故说起。
一、先看一起真实事故
Replit 的 Agent 在一次操作中删除了客户的生产数据库,并且在事后谎报了这件事。
很多人看到这个新闻的第一反应是:“prompt 没写好”。
这个判断是错的。
问题不在于它没被"告诉"不要删数据库,而在于系统里根本没有任何机制能阻止它删。
区别在这里:
| 做法 | 结果 | |
|---|---|---|
| Demo 思路 | 在 system prompt 里写"删除前请确认" | 模型今天听话,明天不听话 |
| 生产思路 | delete 操作被标记为 destructive,运行时强制要求人类审批 | 模型再怎么想删也删不掉 |
这就是本文的全部主题:机制(mechanism),而不是提示(prompt)。
二、Demo Agent 与生产级 Agent 的八项对比
先给一张全景对照表:
| 维度 | Demo Agent | 生产级 Agent |
|---|---|---|
| 循环 | 隐藏的 while 循环 | 显式、可中断、有硬预算 |
| 上下文 | 当缓冲区用,塞满就截断 | 当预算管理,可出具"上下文收据" |
| 工具 | 能调通就行 | 为模型设计的 API,错误信息可教学 |
| 安全 | 靠 prompt 请求 | 运行时强制,默认拒绝 |
| 状态 | 存在内存里 | 可序列化、可恢复、可 fork |
| 非确定性 | 接受它、“反正结果随机” | 收缩到最小边界并全部记录 |
| 测试 | 手动跑几次看看 | 不调真实 LLM 就能测主循环 |
| 可观测 | print() 打日志 | 结构化事件流作为唯一事实来源 |
接下来逐条展开,每条都给反面写法和生产写法。
三、机制 1:日志即本体(The Log Is the Agent)
这是我认为最重要的一条架构决策。
有一篇论文直接把这个论点写进了标题:《The Log Is the Agent: Event-Sourced Reactive Graphs for Auditable, Forkable Agentic Systems》。
它的核心主张是:Agent 的本质是日志(事件流),而不是内存里的状态对象。
一旦接受这个前提,「可审计」「可 fork」「可回放」「可评测」就不再是需要额外开发的功能,而是架构的直接推论。
❌ Demo 写法
def run_agent(task: str):
    messages = [{"role": "user", "content": task}]
    while True:
        resp = llm.chat(messages)
        if resp.tool_calls:
            result = call_tool(resp.tool_calls)
            print(f"called tool: {result}")   # 日志 = 用完即弃
            messages.append(result)
        else:
            return resp.content
问题:print 出来的东西不是数据。你无法对它做聚合、归因、回放——它只是一串给人看的文本。
✅ 生产级写法
from dataclasses import dataclass, field, asdict
from typing import Literal
import time, json

@dataclass
class AgentEvent:
    seq: int                                  # 单调递增序号
    type: Literal[
        "run_start", "llm_call", "tool_call", "tool_result",
        "policy_denied", "budget_exceeded", "stagnation_detected", "run_end",
    ]
    ts: float                                 # 时间戳
    payload: dict                             # 结构化载荷
    tokens_in: int = 0
    tokens_out: int = 0
    cost_usd: float = 0.0

class EventSink:
    """事件流是 Agent 的唯一事实来源(single source of truth)。"""
    def __init__(self, path: str):
        self._f = open(path, "a", encoding="utf-8")
        self._seq = 0

    def emit(self, type_: str, payload: dict, **metrics) -> AgentEvent:
        self._seq += 1
        ev = AgentEvent(seq=self._seq, type=type_, ts=time.time(),
                        payload=payload, **metrics)
        self._f.write(json.dumps(asdict(ev), ensure_ascii=False) + "\n")
        self._f.flush()
        return ev
关键点:Agent 的运行时状态可以从事件流重建。 这意味着——
- 崩溃后能从事件流恢复,而不是从内存快照
- 能从任意历史事件 fork 出一条新分支
- 能对历史事件做聚合分析(成本、延迟、失败率)
- 能拿真实事件流直接生成测试用例
四、机制 2:硬预算 + 停滞检测
失控循环是 Agent 最常见的生产事故,没有之一。
一个没有预算的 Agent 在遇到工具持续报错时,会一直重试到你的账单爆炸。
❌ Demo 写法
while True:
    resp = llm.chat(messages)   # 祈祷它能自己停下来
✅ 生产级写法
from dataclasses import dataclass

class BudgetExceeded(Exception): ...

@dataclass
class Budget:
    max_steps: int = 20
    max_tokens: int = 200_000
    max_wall_clock_s: float = 120.0
    max_cost_usd: float = 1.0

    def check(self, *, steps: int, tokens: int,
              elapsed: float, cost: float) -> None:
        """必须是硬限制,不是"建议"。"""
        if steps >= self.max_steps:
            raise BudgetExceeded(f"步数超限: {steps}/{self.max_steps}")
        if tokens >= self.max_tokens:
            raise BudgetExceeded(f"token 超限: {tokens}/{self.max_tokens}")
        if elapsed >= self.max_wall_clock_s:
            raise BudgetExceeded(f"耗时超限: {elapsed:.1f}s")
        if cost >= self.max_cost_usd:
            raise BudgetExceeded(f"花费超限: ${cost:.4f}")
别漏掉停滞检测。 预算只能防烧钱,防止不了"原地打转 20 步然后失败":
def is_stagnant(recent: list["Action"], window: int = 3) -> bool:
    """连续 N 步调用同一个工具且参数完全相同 -> 判定为停滞。"""
    if len(recent) < window:
        return False
    fingerprints = {a.fingerprint() for a in recent[-window:]}
    return len(fingerprints) == 1
停滞检测的价值不只是省钱——它把一个"沉默烧钱 5 分钟然后失败"的体验,变成"3 秒内明确告诉你卡在哪"。
五、机制 3:上下文是「预算」,不是「缓冲区」
绝大多数 Agent 项目把上下文当垃圾桶:什么都往里塞,塞满了就静默截断。
静默截断是 bug,不是优化。 它会让 Agent 神秘地丢失关键信息,而你完全不知道发生了。
✅ 生产级做法:出具「上下文收据」
from dataclasses import dataclass

@dataclass
class Section:
    name: str            # 例如 "system_prompt" / "tool_schemas" / "history" / "retrieved_docs"
    tokens: int
    source: str          # 这段内容从哪来(文件路径 / 事件 seq / 检索 id)
    truncated: bool = False

@dataclass
class ContextReceipt:
    sections: list[Section]
    total: int
    budget: int

    def explain(self) -> str:
        lines = [f"上下文预算 {self.total}/{self.budget} tokens"]
        for s in self.sections:
            flag = "  ⚠️ 已截断" if s.truncated else ""
            lines.append(f"  {s.name:<20} {s.tokens:>7} tok  <- {s.source}{flag}")
        return "\n".join(lines)
配上输出:
上下文预算 48210/64000 tokens
  system_prompt           1204 tok  <- prompts/v3/system.md
  tool_schemas           18320 tok  <- 42 tools            ⚠️ 已截断
  history                24100 tok  <- 事件 seq 12..87
  retrieved_docs          4586 tok  <- kb://policies/refund
这一张表能立刻暴露大部分上下文问题。 上面这个例子一眼就能看出:42 个工具的 schema 占了 38% 的预算——这正对应工具渐进披露(按需加载工具,而不是一次性全塞进去)的需求。
核心认知:上下文组装应该是一个显式、可测试、可观测的函数,而不是散落在各处的 messages.append()。
六、机制 4:工具的错误信息要「教模型怎么恢复」
工具是给模型设计的 API,不是给人用的函数。它的命名、描述、错误信息都是设计对象。
而这里有一个极其普遍、又极少被修的缺陷:
❌ 大多数项目的工具错误
raise ToolError("invalid argument")
模型看到这句话,只能瞎猜。于是它重试、重试、再重试——直接喂给了你的失控循环。
✅ 生产级写法
raise ToolError(
    "参数 'start_date' 格式错误:收到 '2024/13/01'。\n"
    "要求:ISO 8601 格式(YYYY-MM-DD),且必须是过去的日期。\n"
    "示例:'2024-12-01'\n"
    "请修正该参数后重试。"
)
记住这句话:错误信息本身就是一段 prompt。
你花在打磨错误信息上的每一分钟,都会直接转化为 Agent 的自恢复能力。
另外三条工具设计原则
# 1. 返回值默认截断/分页——一个能往上下文倒 10 万 token 的工具是 bug
@tool(max_output_tokens=2000)
def search_logs(query: str, page: int = 1) -> str: ...

# 2. 写操作必须幂等,或提供 dry-run
@tool(idempotent=True)
def create_ticket(title: str, idempotency_key: str) -> str: ...

@tool(dry_run_supported=True)
def delete_records(filter_: str, dry_run: bool = True) -> str: ...

# 3. 显式声明能力等级——这是机制 5 的前提
CAPABILITIES = {
    "read_file":   {"read"},
    "write_file":  {"write"},
    "delete_file": {"write", "destructive"},
    "run_shell":   {"execute"},
}
七、机制 5:运行时权限,默认拒绝
回到开头的事故。永远不要用 prompt 实现安全。
✅ 能力制权限 + 默认拒绝
class PolicyDenied(Exception): ...

@dataclass
class Policy:
    allowed: set[str]                       # 例如 {"read", "write"}
    auto_approve_destructive: bool = False

def enforce(policy: Policy, tool_name: str, args: dict) -> None:
    required = CAPABILITIES[tool_name]

    # 1) 默认拒绝:能力不在白名单里,直接拦下
    if not required <= policy.allowed:
        raise PolicyDenied(
            f"工具 {tool_name} 需要能力 {required},"
            f"当前策略仅允许 {policy.allowed}"
        )

    # 2) 不可逆操作必须有人类审批闸门
    if "destructive" in required and not policy.auto_approve_destructive:
        raise NeedsHumanApproval(
            tool=tool_name, args=args, reason="不可逆操作"
        )
配套要求:
- 代码执行必须在沙箱里(容器 / 受限文件系统 / 无网络)
- 有审计轨迹能回答"它到底做了什么"——这又回到了机制 1
- 审批队列要有超时策略,不能无限等人
核心原则:默认安全(deny by default)。 白名单而不是黑名单——因为你永远列不全"危险操作"。
八、机制 6:持久化与时间旅行
Demo 的 Agent 状态在内存里,进程一死全没了。
生产级要求
| 能力 | 价值 |
|---|---|
| 状态可序列化 | 崩溃后能恢复,长任务不丢进度 |
| 可从任意检查点 fork | 调试时能从出错点分叉,反复试不同策略 |
| 区分持久状态与临时上下文 | 前者是事实,后者是每次重建的视图 |
@dataclass
class AgentState:
    """必须是可序列化的纯数据——不要塞进不可序列化的对象。"""
    run_id: str
    events: list[AgentEvent]
    cursor: int
    budget_used: dict

    def fork(self) -> "AgentState":
        """从当前状态分叉出一条独立分支,用于调试/对比。"""
        return AgentState(
            run_id=f"{self.run_id}-fork-{uuid4().hex[:6]}",
            events=list(self.events),
            cursor=self.cursor,
            budget_used=dict(self.budget_used),
        )
时间旅行调试是 Agent 领域目前最缺的能力之一。 传统调试器有 gdb,Agent 却没有对应物——而这恰恰是生产环境最需要的(错误往往在第 5 步显现,根因在第 1 步)。
九、机制 7:把非确定性收缩到最小边界
这是架构层面最核心的一条原则。
Agent 项目的根本困难就是非确定性。业余做法是"接受它";专业做法是把它围起来:
# 1) 显式 pin 住模型版本与参数
MODEL = "your-model-2024-11-01"     # 不要用会漂移的 latest 别名
TEMPERATURE = 0.0
SEED = 42

# 2) 所有模型 I/O 全部记录
@dataclass
class ModelCall:
    model: str
    params: dict
    messages: list[dict]
    response: dict          # 完整记录,用于回放

    def replay(self) -> dict:
        return self.response
这样做的收益是决定性的:你能复现 bug 了。
线上出问题 → 拿到事件流 → 本地回放 → 精确定位。没有这条,你的 Agent 线上出问题就只能靠猜。
判断标准:把你项目里"非确定的部分"圈出来,如果它占了超过一小块,或者没有被完整记录,那就是架构问题。
十、机制 8:不调真实 LLM 就能测试主循环
我拿这条当作架构正确性的终极检验:
如果你的架构做不到无 LLM 测试,那是架构错了,不是测试难写。
理由很朴素:如果测试一次要花钱、且结果随机,你就不会测试;不测试的 Agent 项目一定会退化。
而且这条能倒逼架构——它会强迫你把模型调用抽象成一个可替换的接缝:
from typing import Protocol

class ModelClient(Protocol):
    def chat(self, messages: list[dict], **kw) -> dict: ...

class FakeModel:
    """按剧本返回,完全确定,零成本。"""
    def __init__(self, script: list[dict]):
        self.script, self.i = script, 0

    def chat(self, messages, **kw) -> dict:
        resp = self.script[self.i]
        self.i += 1
        return resp

# 现在可以廉价地测试那些真正重要的机制
def test_agent_stops_on_budget():
    agent = Agent(
        model=FakeModel([{"tool_calls": [{"name": "read_file", "args": {"path": "a"}}]}] * 100),
        budget=Budget(max_steps=3),
    )
    with pytest.raises(BudgetExceeded):
        agent.run("随便什么任务")

def test_destructive_tool_needs_approval():
    agent = Agent(model=FakeModel([{"tool_calls": [{"name": "delete_file", "args": {"path": "/db"}}]}]),
                  policy=Policy(allowed={"read", "write"}))
    with pytest.raises(NeedsHumanApproval):
        agent.run("清理一下")
这两个测试跑起来只花毫秒、不花一分钱,却覆盖了本文最重要的两条机制。
这就是"架构正确"带来的复利。
结语
回到最开始那句话:
Demo 靠功能,生产靠失败模式。
优秀的 Agent 项目不是"功能更多"的项目,而是**“出错方式更可控”**的项目。它们的设计出发点是:
- 机制 > 提示 —— 能用运行时保证的,不要用 prompt 请求
- 非确定性收缩到最小边界并全部记录 —— 这是可复现、可测试的前提
- 默认安全 —— 白名单,不是黑名单
- 日志即本体 —— 事件流是事实来源,内存状态不是
- 为失败设计,不为演示设计
- 必须能在无 LLM 的情况下测试
最后补一句题外话:这六条同时也是面试里最常被追问的点。
能写出炫酷 Demo 的人很多,能把这六条答清楚的人很少——而后者的稀缺性,才是真正的护城河。
参考资料
- The Log Is the Agent: Event-Sourced Reactive Graphs for Auditable, Forkable Agentic Systems
- Anthropic, Agent Harness Design: 3 Patterns for Harnessing Claude’s Intelligence — https://claude.com/blog/harnessing-claudes-intelligence
- Anthropic, The anatomy of effective commerce agents — https://claude.com/blog/the-anatomy-of-effective-commerce-agents
- 12-Factor Agents(humanlayer)
- Inngest, Building Durable AI Agents: A Guide to Context Engineering — https://inngest.vercel.app/blog/building-durable-agents
- Temporal, LangGraph Plugin adds Durable Execution — https://temporal.io/blog/temporal-langgraph-plugin-durable-execution
- Agent-Governed Lossless Context Folding — https://zenodo.org/records/21856874/files/pi-fold-context-folding.pdf
- OpenTelemetry GenAI Semantic Conventions
- Replit Agent 数据库删除事故复盘 — https://safeguard.sh/resources/blog/replit-agent-database-deletion-vibe-coding-2025
转载自 CSDN-专业IT技术社区
原文链接:https://blog.csdn.net/m0_74207467/article/details/166903734

