

每一个用过不止一个 AI 提供方的开发者,都懂这种痛苦:
- OpenAI 有自己的 API key
- Anthropic 有自己的计费面板
- Google 有自己的 SDK
- DeepSeek 有自己的速率限制
如果你想用 4 个不同的模型,就得管理 4 个账号、4 张发票和 4 套文档。这不只是烦人——这是一个瓶颈,它阻碍开发者去尝试新模型。
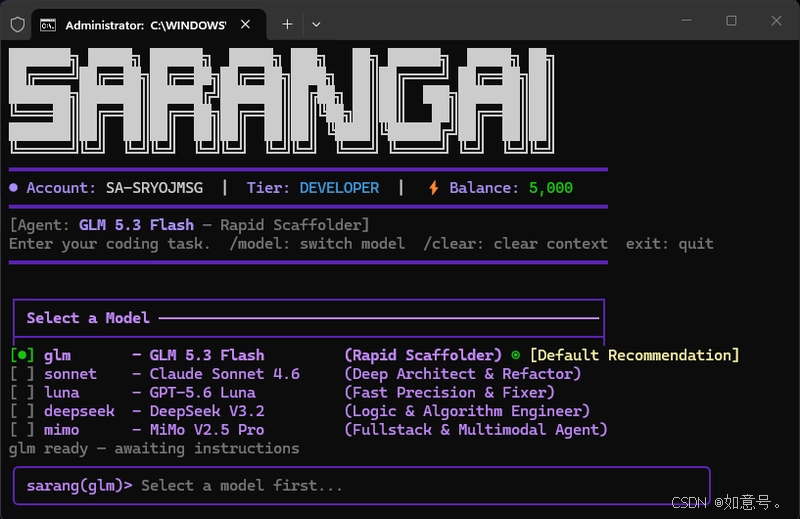
我构建了 SarangAI 来解决这个问题。它是一个统一的 AI 网关,把所有请求路由到 200+ 个模型,全部通过一个兼容 OpenAI 的端点。
在这篇文章里,我会带你过一遍它背后的架构、我做的设计决策,以及遇到的技术挑战。
高层架构
在高层面上,SarangAI 由 4 个主要组件组成:
- API 网关(API Gateway) — 接收来自客户端(CLI、IDE 或任何应用)的请求
- 路由器(Router) — 决定哪个模型来处理请求
- 提供商适配器(Provider Adapters) — 把 OpenAI 兼容格式翻译成每个提供商的格式
- 计费与速率限制器(Billing & Rate Limiter) — 管理预付费余额和按用户速率限制
流程很简单:
客户端 → API 网关 → 路由器 → 提供商适配器 → AI 提供商
                    ↓
            计费与速率限制器
为什么要兼容 OpenAI?
这是我做过的最重要的设计决策。
当我开始构建 SarangAI 时,有两个选项:
选项 1: 构建我自己的 API 格式、我自己的文档、我自己的 SDK。
选项 2: 使用 OpenAI 格式,它已经成为事实上的标准。
我选择了选项 2。原因如下:
- 零迁移 — 如果你的代码已经在用 OpenAI SDK,只需要改 base URL 和 API key。搞定。
- 庞大的生态 — 成千上万的库和工具已经支持 OpenAI 格式。
- 熟悉 — 开发者不需要学习新的 API。
这就是让 SarangAI 能在几分钟内(而不是几小时内)上手的原因。
技术挑战 #1:归一化响应
每个提供商的响应格式都不一样。OpenAI 用 choices[0].message.content,Anthropic 用 content[0].text,Google 又是另一种结构。
解决方案:适配器模式。每个提供商都有一个适配器,它负责:
- 把请求从 OpenAI 格式翻译成该提供商的格式
- 把响应从该提供商的格式翻译回 OpenAI 格式
- 处理错误和重试逻辑
这让客户端代码保持干净——他们不需要知道正在使用哪个提供商。
技术挑战 #2:流式传输
流式响应很棘手。每个提供商发送分块的方式都不一样:
- OpenAI 使用带
data: {...}的服务端事件(SSE) - Anthropic 有自己的事件类型(
content_block_delta等) - Google 又有另一种流式格式
在 SarangAI 中,我把所有流式传输都归一化成与 OpenAI 相同的 SSE 格式。这样客户端只需要处理一种流式格式。
技术挑战 #3:速率限制与计费
由于 SarangAI 使用预付费 IDR 充值模式,我需要:
- 跟踪每一个请求,并基于 token 用量计算成本
- 实时从用户余额中扣减
- 处理并发请求时的竞态条件
为此,我使用了 Redis(用于快速余额检查)和数据库(用于审计追踪)的组合。
技术挑战 #4:模型路由
SarangAI 的主要特性之一是即时切换模型。用户可以不用重启应用就更换模型。
这意味着路由器必须:
- 从请求中读取模型配置
- 校验该模型是否可用
- 路由到正确的适配器
- 在提供商宕机时处理回退
我把这个路由器设计成无状态的,这样它就可以无问题地水平扩展。
CLI 工具:sarangai-cli
除了 API 网关,我还构建了一个可以直接在终端使用的 CLI 工具:
npm install -g sarangai-cli
sarang
这个 CLI 连接到 SarangAI 端点,给你一个交互式工作空间。你可以:
- 用一条命令切换模型
- 查看 token 用量
- 查看你的余额
这对那些"活在终端里"的开发者尤其有用。
学到的经验
1. 标准很重要。
选择 OpenAI 兼容格式是我做过的最好的决定。它让采用变得飞快。
2. 适配器模式救命。
没有干净的适配器,每新增一个提供商都是一场噩梦。
3. 对开发者工具来说,预付费 > 订阅。
开发者讨厌月度订阅。预付费给他们一种完全掌控的感觉。
4. 文档本身就是一种功能。
无论你的架构多好,如果文档很烂,没人会用。
自己试一试
如果你经常使用多个 AI 模型,试试 SarangAI:
https://sarangai.id
安装 CLI:
npm install -g sarangai-cli我很好奇:你目前是怎么处理多个 AI 提供商的? 你用库吗?还是一个一个管理?
欢迎在评论区分享——我很想听听其他开发者是怎么处理的。
相关阅读(延伸外链)
以下为推荐的相关技术教程,来自致知笔记:
转载自 CSDN-专业IT技术社区
原文链接:https://blog.csdn.net/weixin_47967031/article/details/167210920

