

🌈个人主页:一条泥憨鱼(欢迎各位大佬莅临)
❄️《数据结构》 ❄️《AI与Agent那些事》
❄️《从0开始学计算机网络》 ❄️《后端开发》
前言:
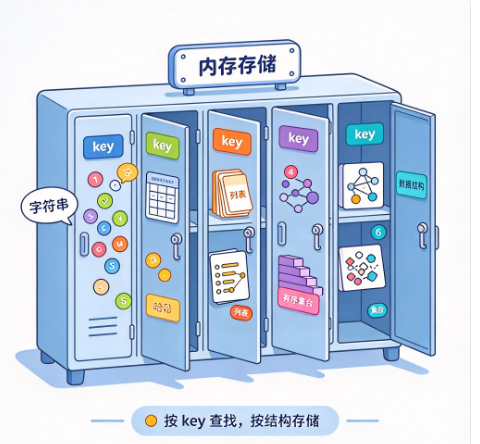
想象你走进一个公共储物柜大厅。每个柜子有编号,你凭编号打开柜子,往里放东西或者取东西。Redis 差不多就是这个意思:一个放在内存里的储物柜仓库,你通过 key 这个编号,去存取对应的 value。
第一次接触 Redis 的话,不用一上来就搞懂集群、持久化、哨兵这些东西。先把最基础的问题弄清楚:怎么开门,怎么存东西,怎么找东西,怎么分类管理。
Redis入门
Redis 是一个键值数据库。
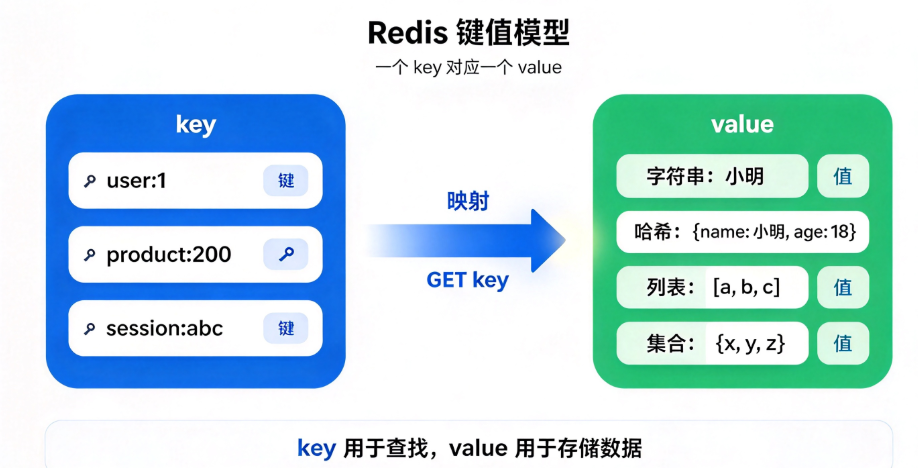
"键值"是什么意思?它存数据的方式特别简单,一个"名字"对应一份"内容"。名字叫 key,内容叫 value。你给 Redis 一个 key,它就还你对应的 value;反过来,你给它一个 key 加一个 value,它就存进去了。
储物柜上贴着标签,标签写"张三的雨伞",柜子里放的就是那把雨伞。这里"张三的雨伞"就是 key,雨伞就是 value。Redis 里也一样:
- key:一个字符串,比如 `user:1:name`
- value:可以是字符串、数字、列表、集合等等(下面会一种一种讲)
那为什么大家都用 Redis?一个字:快。
传统数据库(比如 MySQL)把数据存在硬盘上,每次读写都要跟硬盘打交道,硬盘的速度和内存比差了好几个数量级。Redis 把数据放在内存里,读写几乎就是瞬间的事。代价是内存比硬盘贵,而且断电后内存里的东西会丢——不过 Redis 有持久化机制,那是后话。
现在你只需要记住一件事:Redis 就是一个用 key 找 value 的超高速储物柜。
通用命令——不管什么类型都能用的“万能钥匙”
Redis 的命令有几百个,但有一部分命令不管你存的是什么类型的数据,都能用。这些就是通用命令。先学会它们,你就能开始操作 Redis 了。
KEYS:列出所有 key
KEYS pattern把所有匹配某个模式的 key 列出来。
# 列出所有 key(危险!后面会说为什么)

KEYS *


# 列出所有以 user: 开头的 key

KEYS user:*

```
踩坑警告:`KEYS *` 在生产环境千万不要用。Redis 是单线程处理命令的,`KEYS *` 会遍历所有 key,如果数据量大了(几十万上百万),这条命令会卡住整个 Redis,其他请求全部排队等着。后面讲 `SCAN` 的时候会给替代方案。
EXISTS:判断 key 存不存在
EXISTS key [key ...]
EXISTS user:1:name

# 返回 1 表示存在,返回 0 表示不存在
DEL:删除 key
DEL key [key ...]
DEL user:1:name

# 返回被删除的 key 数量
EXPIRE 和 TTL:设置过期时间和查看剩余时间
这两个命令经常配对使用。`EXPIRE` 给一个 key 设置"存活时间",到点了 Redis 自动删掉它。`TTL` 用来查看还剩多少时间。
# 设置 user:1:token 这个 key 在 3600 秒后自动删除

EXPIRE user:1:token 3600


# 查看还剩多少秒

TTL user:1:token

# 返回 3595 表示还剩 3595 秒

# 返回 -1 表示没设置过期时间

# 返回 -2 表示 key 已经不存在了
存验证码、临时 token 这类"过一段时间就没用"的数据,用这个功能特别合适。
TYPE:查看 key 是什么类型
TYPE key
TYPE user:1:name

# 返回 string

TYPE user:1

# 可能返回 hash
当你忘了某个 key 存的是什么类型的数据时,`TYPE` 能帮你确认。
Key 的层级格式——用冒号给数据“分文件夹”
Redis 的 key 本质上就是一个字符串,没有真正的目录结构。它不像你电脑里的文件夹可以一层套一层,Redis 里所有 key 都是平铺的。
但大家慢慢形成了一种约定:用冒号 `:` 分隔,模拟出层级的感觉。
比如你要存用户 1 的名字、年龄、邮箱:
user:1:name -> "张三"
user:1:age -> "28"
user:1:email -> "[email protected]"
再比如订单数据:
order:100:status -> "paid"
order:100:amount -> "199.00"
order:101:status -> "pending"
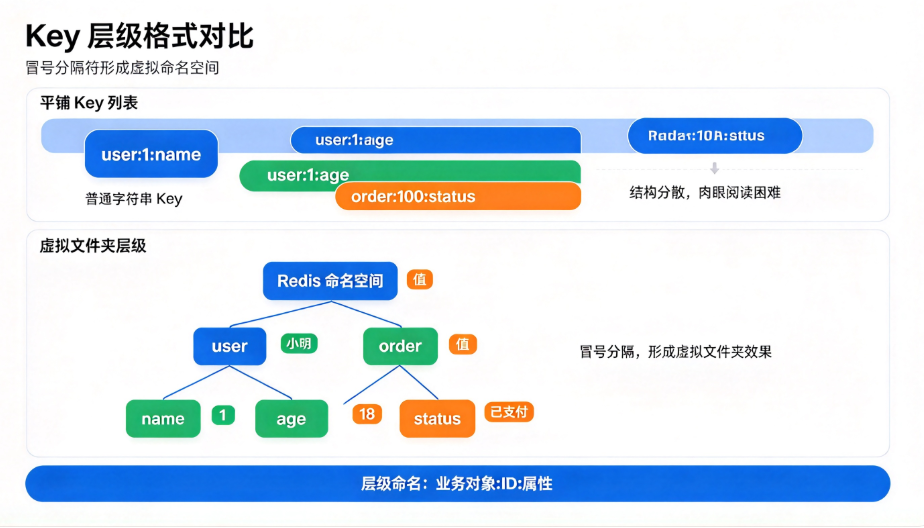
这么做有几个好处。可读性强,你一眼就能看出这个 key 属于哪个业务、哪条记录、哪个字段。要找用户 1 的所有信息,匹配 `user:1:*`;要找所有订单,匹配 `order:*`。不同业务用不同前缀,`user:`、`order:`、`product:`,也不会互相打架。
常见的命名规范大概是这样的:
业务名:对象ID:字段名
或者更细一点:
业务名:对象类型:对象ID:字段名
比如 `shop:product:888:price`。
用 SCAN 代替 KEYS
前面说了 `KEYS *` 在生产环境是禁忌。那怎么安全地找出某一类 key?用 `SCAN`。
`SCAN` 不会一次性返回所有结果,而是分批次返回,每次只返回一小部分。这样就不会长时间阻塞 Redis。
# 从游标 0 开始扫描,每次返回大约 10 个 key,匹配 user:1:*
SCAN 0 MATCH user:1:* COUNT 10
返回结果类似:
1) "17"          <- 下一次扫描的游标

2) 1) "user:1:name"

   2) "user:1:age"
拿到游标 `17` 后,继续用 `SCAN 17 MATCH user:1:* COUNT 10`,直到游标回到 `0`,表示扫完了。
一开始你可能觉得这很麻烦,但记住一点就行:生产环境永远用 SCAN,不用 KEYS。
String 类型——最基础也最万能的“单格储物格”
String 是 Redis 里最简单的类型。一个 key 对应一个字符串值,就像储物柜里只有一个格子,里面放一样东西。
基本存取:SET 和 GET
# 存一个值

SET user:1:name "张三"


# 取出来

GET user:1:name

# 返回 "张三"
就这么简单。存进去什么,取出来就是什么。
SETNX:不存在才设置
SETNX lock:order:100 "1"

# 如果 lock:order:100 不存在,设置成功,返回 1

# 如果已经存在,设置失败,返回 0
`SETNX` 是 "SET if Not eXists" 的缩写。这个命令看起来不起眼,但它能用来做分布式锁的入门版:多个服务同时抢一个锁,谁先 `SETNX` 成功谁就拿到锁,其他人返回 0 就等着。
当然,真正的分布式锁还要考虑过期时间、误删等问题,但 `SETNX` 是理解这件事的起点。
INCR 和 DECR:数字加减
SET page:view:1001 0


INCR page:view:1001

# 返回 1


INCR page:view:1001

# 返回 2


DECR page:view:1001

# 返回 1

```


`INCR` 把值加 1,`DECR` 减 1。这里有个很重要的点:INCR 是原子操作。意思是,哪怕有一万个请求同时执行 `INCR page:view:1001`,结果也一定是准确的,不会出现两个请求读到同一个值然后各自加 1 导致少算的情况。
这就是为什么 Redis 的 `INCR` 特别适合做计数器——文章阅读量、点赞数、接口调用次数,都可以用它。
MSET 和 MGET:批量存取
# 一次存多个

MSET user:1:name "张三" user:1:age "28" user:1:email "[email protected]"

# 一次取多个

MGET user:1:name user:1:age user:1:email

# 返回:

# 1) "张三"

# 2) "28"

# 3) "[email protected]"
批量操作的好处是减少网络往返次数。存三个值,用 `SET` 要发三次命令,用 `MSET` 只发一次。
Hash 类型——像一个“带多个小格子的抽屉”
String 存一个对象的时候,你得把整个对象序列化成字符串(比如 JSON),改一个字段也要把整个对象读出来、改完再写回去。Hash 解决了这个问题。
Hash 的结构是:一个 key 下面挂多个 field-value 对。就像一个大抽屉里面分了小格子,每个小格子放一个字段。
# 返回:

# 1) "name"

# 2) "张三"

# 3) "age"

# 4) "28"

# 5) "email"

# 6) "[email protected]"


# 删除某个字段

HDEL user:1 email


# 给某个数字字段加值

HINCRBY user:1 age 1

# 返回 29
对比一下:如果用 String 存用户信息,你得 `SET user:1 '{"name":"张三","age":28}'`,改年龄要把整个 JSON 解析出来改完再写回去。用 Hash 直接 `HINCRBY user:1 age 1` 就完事了。
Hash 适合存对象的多个字段,尤其是你经常只读写其中某几个字段的场景。
List 类型——有序、可重复的“排队通道”
List 就是一个有序列表,像排队一样,有头有尾,元素可以重复。
# 从左边塞入

LPUSH queue:task "task1"

LPUSH queue:task "task2"

# 现在列表是:task2, task1


# 从右边塞入

RPUSH queue:task "task3"

# 现在列表是:task2, task1, task3


# 从左边弹出

LPOP queue:task

# 返回 "task2"


# 从右边弹出

RPOP queue:task

# 返回 "task3"


# 查看列表范围(0 到 -1 表示全部)

LRANGE queue:task 0 -1


# 查看长度

LLEN queue:task
List 最典型的用法是消息队列:生产者用 `LPUSH` 从左边塞任务,消费者用 `RPOP` 从右边取任务,先进先出。真正的消息队列要考虑更多东西(确认机制、重试等),但入门级场景完全够用。
另一个常见用法是最新列表。比如"最新 10 条评论",每次来新评论用 `LPUSH` 塞进去,再用 `LTRIM` 保留前 10 个。
Set 类型——无序、不重复的“标签集合”
Set 和 List 最大的区别有两个:无序、不重复。你往里塞重复的元素,它只会保留一个。
# 添加标签

SADD article:1:tags "redis" "database" "cache"


# 再加一个重复的,不会生效

SADD article:1:tags "redis"

# 返回 0,表示没添加新元素


# 查看所有元素

SMEMBERS article:1:tags

# 返回 redis, database, cache(顺序不保证)


# 判断某个元素在不在

SISMEMBER article:1:tags "redis"

# 返回 1


# 删除元素

SREM article:1:tags "cache"

```


Set 真正好用的地方在于集合运算。


```bash

# 用户 1 关注的人

SADD user:1:follows "u2" "u3" "u4"


# 用户 2 关注的人

SADD user:2:follows "u3" "u4" "u5"


# 共同关注(交集)

SINTER user:1:follows user:2:follows

# 返回 u3, u4


# 所有关注(并集)

SUNION user:1:follows user:2:follows

# 返回 u2, u3, u4, u5
共同好友、共同兴趣标签、去重统计,这些场景用 Set 非常自然。
Sorted Set 类型——带排名的“排行榜”
Sorted Set(有序集合)是在 Set 的基础上,给每个元素额外绑了一个分数(score)。Redis 会根据分数自动给元素排序。
# 添加玩家分数

ZADD rank:game 100 "player1"

ZADD rank:game 250 "player2"

ZADD rank:game 180 "player3"


# 按分数从低到高查看(带分数)

ZRANGE rank:game 0 -1 WITHSCORES

# 返回:

# player1, 100

# player3, 180

# player2, 250


# 按分数从高到低查看(排行榜最常用)

ZREVRANGE rank:game 0 -1 WITHSCORES

# 返回:

# player2, 250

# player3, 180

# player1, 100


# 查看某个玩家的分数

ZSCORE rank:game "player2"

# 返回 250


# 查看某个玩家的排名(从低到高,从 0 开始)

ZRANK rank:game "player2"

# 返回 2


# 给某个玩家加分

ZINCRBY rank:game 50 "player1"

# 返回 150
Sorted Set 最经典的用途就是排行榜:游戏得分排名、热搜榜、销量排行。`ZREVRANGE rank:game 0 9` 就能拿到前十名。
它还能用来做延时队列:把任务的执行时间戳作为 score,然后用 `ZRANGEBYSCORE` 取出到时间的任务。
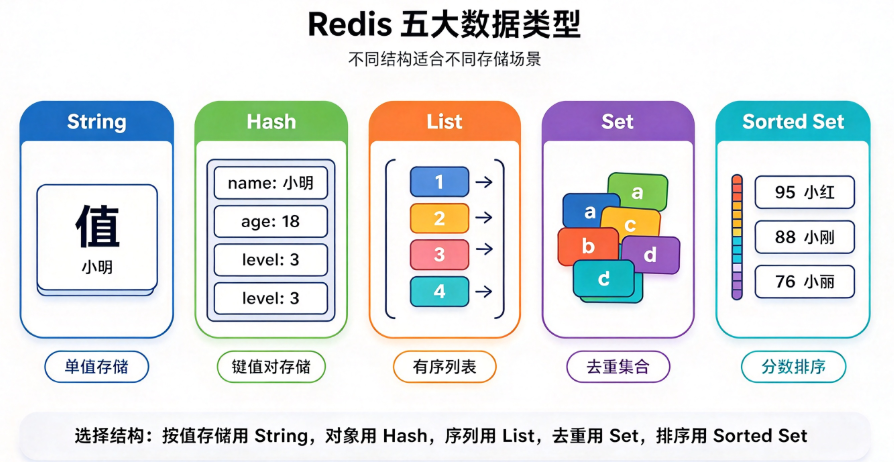
到这里,Redis 最基础的部分过完了。通用命令管理 key,冒号分层组织 key,五种数据类型应付不同的存储需求。
初学把文中的命令挨个敲一遍。敲完之后再去了解过期策略和持久化——那是保证数据不丢的关键,但得先把基础操作练熟了再说。
转载自 CSDN-专业IT技术社区
原文链接:https://blog.csdn.net/2503_94545876/article/details/167085432

