

【Linux】进程(下)上下文、运行队列与调度器的更替
概览
- 从串行到并发假象
- 上下文清单、内核栈与一次切换
- 0.11 的 schedule、tss_struct 与 switch_to
- O(1) 调度器的运行队列与 prio_array
- 优先级体系、时间片耗尽与指针交换
- nice 的两次映射、动态优先级与 CPU 份额
- 负载因子与负载均衡
- 从 O(1) 到 CFS 再到 EEVDF
核心知识
一、从串行到并发假象
最早的计算机一次只运行一个程序,程序从开头执行到结束,中途不会更换执行对象。这种运行方式的缺陷十分明显:程序等待磁盘、等待键盘的这段时间里,CPU 只能空转,而这台每秒钟可以执行几百万乃至上亿次运算的机器,等待的时间往往比计算的时间长得多。
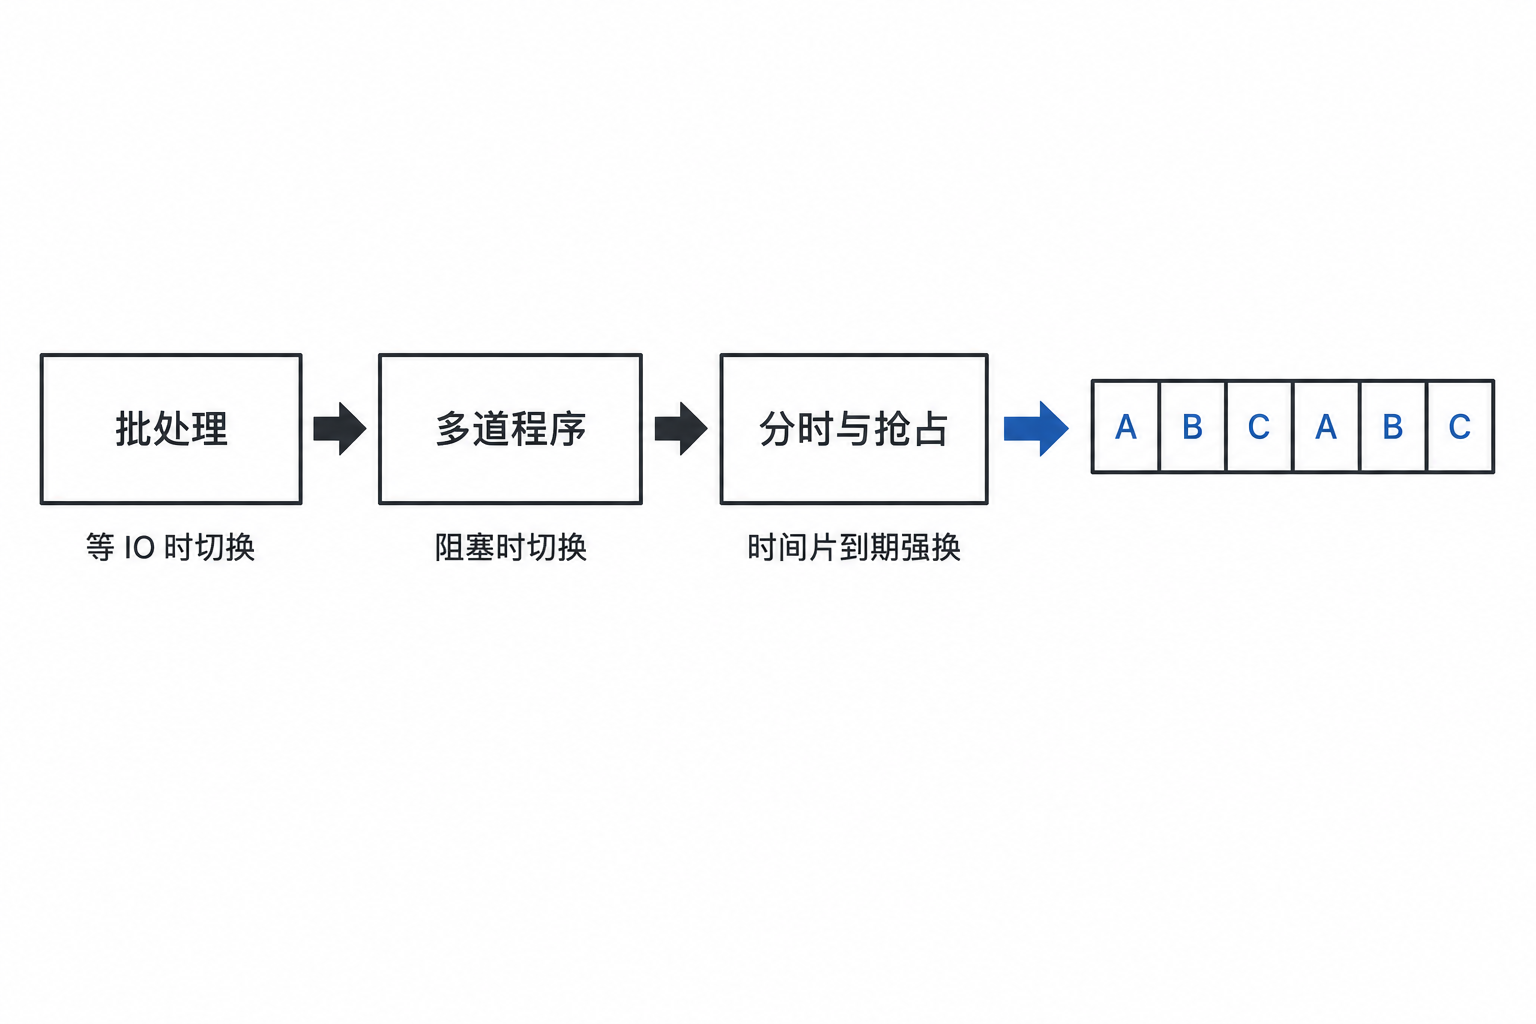
图 1 三个台阶:从串行到并发假象
第一个台阶是批处理。作业一个接一个地排队,CPU 不为等待停留,前一个作业的输出交给慢速设备处理,自己立刻开始下一个作业。程序的执行顺序仍然是一条直线,批处理所做的只是把等待的时间填补起来。
第二个台阶是多道程序。内存中同时存放着好几道程序,当前这道因为等待 I/O 而停下时,操作系统并不空转,而是直接换上另一道程序继续运行。切换的时机是当前程序主动停止运行,也就是后文所说的自愿切换。
第三个台阶是分时与抢占。操作系统给每个任务分配一小段时间,时间用完就强行更换执行对象,不论当前任务是否愿意让出。到了这一步,同时运行的观感才真正出现:一个终端正在编译,另一个终端仍然可以响应输入,用户会觉得有两台机器同时在为自己服务。
这种假象是这样产生的:CPU 只有一套执行部件,任何时刻真正运行的任务只有一个。所谓的并发,指的是切换速度足够快,快到人的眼睛分辨不出中间的空隙。
三个台阶之间的差别列在下表。
| 阶段 | 切换由谁发起 | 切换时机 | 解决的问题 | 带来的代价 |
|---|---|---|---|---|
| 批处理 | 作业自己 | 前一个作业主动交出 CPU | 把等待 I/O 的时间填上 | 一道作业卡住,整台机器跟着等 |
| 多道程序 | 内核 | 当前任务请求的资源没到位 | 等待期间让别的任务跑起来 | 任务之间的数据开始互相干扰 |
| 分时与抢占 | 内核 | 时间片到期,不看任务愿不愿意 | 交互式任务得到及时响应 | 切换频率高,调度开销变成常项 |
从第二行到第三行,主动权由任务手中转移到内核手中。批处理与多道程序都依赖任务自己停止运行,一个不肯停止的任务足以把 CPU 一直占住;分时系统为每个任务划出一小段时间,时间一到内核便强行更换执行对象,主动权至此才真正落到操作系统手里。
代价也随之出现:切换本身需要耗费时间,切换越频繁,用于更换执行对象的时间就越多。任务的执行片段被切割并相互穿插之后,程序中那些依赖执行顺序的假设也开始失效。
图 2 单核 CPU 的并发假象(时间片轮转)

   时间轴 ──────────────────────────────────────────────►

   CPU   │ A │ B │ C │ A │ B │ C │ A │ B │ C │ ...
         └─┬─┴─┬─┴─┬─┴─┬─┴─┬─┴─┬─┴─┬─┴─┬─┴─┬─┘
         一个时间片换一次,每个任务都觉得自己在独占 CPU

   A 视角:我一直在跑(中间的那些空白,A 根本不知道)
   B 视角:我一直在跑
   C 视角:我一直在跑
图 2 单核 CPU 的并发假象
三个任务轮流占用 CPU,每个任务得到的都是一段一段的时间,各段之间隔着其他任务的执行片段。这些间隔对于任务自身而言是不可见的,任务只知道从被换下到被换回之间经过了一段时间。
支撑这一切的硬件前提在于寄存器只有一套。
图 3 寄存器只有一套,上下文却可以有很多份

    CPU 内部(只有一套)                内存里(每个任务一份)
   ┌────────────────────┐           ┌──────────────────────┐
   │  rip  下一条指令    │  ◄──────  │ A 的现场:一份快照    │
   │  rsp  栈顶          │  ──────►  ├──────────────────────┤
   │  rax  返回值        │           │ B 的现场:一份快照    │
   │  ...  十几个寄存器  │           ├──────────────────────┤
   └────────────────────┘           │ C 的现场:一份快照    │
                                     └──────────────────────┘
   换人 = 把当前这套寄存器的值搬到内存里,再把下一个任务的那份搬回来
图 3 寄存器只有一套,上下文却可以有很多份
CPU 内部没有第二套寄存器可以供其他任务使用。操作系统能够做的只有一件事:在更换执行对象之前,把当前任务留在寄存器里的中间结果写入内存;等到换回来的时候,再从内存中把这些值读回寄存器。这一存一取,就是上下文切换这个名称的由来。
二、交替执行的两个死结
切换解决了 CPU 空转的问题,同时也引入了一类新的错误。两个任务的执行片段相互穿插,而穿插的顺序由调度器决定,并不由程序决定,程序中那些先做 A 再做 B的假设因此可能落空。
第一个死结出在共享数据上。两个任务同时读写同一个变量时,一方的修改会被另一方覆盖。下面这个最小的例子中,两个线程各自把同一个全局变量累加两千万次。
#include <stdio.h>
#include <pthread.h>

static long counter = 0;

static void *worker(void *arg)
{
    long i;

    (void)arg;
    for (i = 0; i < 20000000L; i++) {
        counter++;
    }
    return NULL;
}

int main(void)
{
    pthread_t a, b;

    pthread_create(&a, NULL, worker, NULL);
    pthread_create(&b, NULL, worker, NULL);
    pthread_join(a, NULL);
    pthread_join(b, NULL);
    printf("两个线程各加两千万次,counter = %ld,期望值 40000000\n", counter);
    return 0;
}
不加任何同步手段,编译时关闭优化,连续运行六次得到的输出如下。
[cocatrice@hcss-ecs-4cd1 lab10sched]$ gcc -O0 -o race_o0 race.c -lpthread
[cocatrice@hcss-ecs-4cd1 lab10sched]$ for i in 1 2 3 4 5 6; do ./race_o0; done
两个线程各加两千万次,counter = 20586108,期望值 40000000
两个线程各加两千万次,counter = 20299313,期望值 40000000
两个线程各加两千万次,counter = 22034235,期望值 40000000
两个线程各加两千万次,counter = 20882970,期望值 40000000
两个线程各加两千万次,counter = 20412076,期望值 40000000
两个线程各加两千万次,counter = 20342212,期望值 40000000
六次的结果没有一个相同,数值都落在两千万到两千二百万之间,丢失的部分正是两个线程相互覆盖掉的更新。counter++ 在机器层面是三条指令:把值从内存读入寄存器,寄存器加一,再把值写回内存。两个线程的这三条指令一旦发生穿插,就会读到同一个旧值、写回同一个新值,其中一次累加便凭空消失。
同样一份代码,换用加锁的版本之后,结果就稳定下来。
static pthread_mutex_t lock = PTHREAD_MUTEX_INITIALIZER;

static void *worker(void *arg)
{
    long i;

    (void)arg;
    for (i = 0; i < 20000000L; i++) {
        pthread_mutex_lock(&lock);
        counter++;
        pthread_mutex_unlock(&lock);
    }
    return NULL;
}
[cocatrice@hcss-ecs-4cd1 lab10sched]$ for i in 1 2 3; do ./race_lock; done
加锁之后 counter = 40000000,期望值 40000000
加锁之后 counter = 40000000,期望值 40000000
加锁之后 counter = 40000000,期望值 40000000
第二个死结出在时序上。任务之间如果需要按照某个先后顺序配合,例如生产者必须先放入数据、消费者才能取走数据,那么一旦调度器把顺序颠倒过来,程序逻辑就会失效。这类问题不会算错数字,它的表现是卡死、超时或者偶发的错误结果,复现难度比第一种更高。
这两个死结对应的解法是互斥与同步。两者经常被放在一起讨论,约束的却是两件不同的事情:互斥约束的是同一时刻只能有一个执行流访问这份数据,使用的工具是锁;同步约束的是 A 完成之后 B 才能开始,使用的工具是条件变量、信号量这一类。一个程序可能只需要其中一种:两个任务同时写一份日志需要互斥,生产者与消费者之间需要同步,而两者共享的那条队列则两种都需要。
调度器更换执行对象的时机由内核决定,因此程序中任何依赖执行顺序的假设,都必须由程序自己用同步手段建立起来。
三、上下文
更换执行对象的动作称为上下文切换,这里需要先弄清楚上下文这个说法包含了哪些内容。
| 类别 | 典型成员 | 不保存的后果 |
|---|---|---|
| 执行位置 | rip(下一条指令地址)、eflags(标志位) | 回来时不知道执行到哪,条件判断的结果错乱 |
| 栈 | rsp、rbp | 函数返回时找不到返回地址,程序直接崩 |
| 通用寄存器 | rax、rbx、rcx、rdx、rsi、rdi、r8 到 r15 | 中间结果与循环计数丢失 |
| 段寄存器 | cs、ss、ds、es、fs、gs | 内存寻址错乱,段基址不对 |
| 内存映射 | cr3(页表基址) | 两个进程的虚拟地址互相串台 |
| 浮点与向量状态 | x87 寄存器、SSE 与 AVX 寄存器 | 浮点计算结果损坏 |
| 内核自己的状态 | 内核栈指针、内核路径上用到的寄存器 | 内核自己回不到被打断的那一步 |
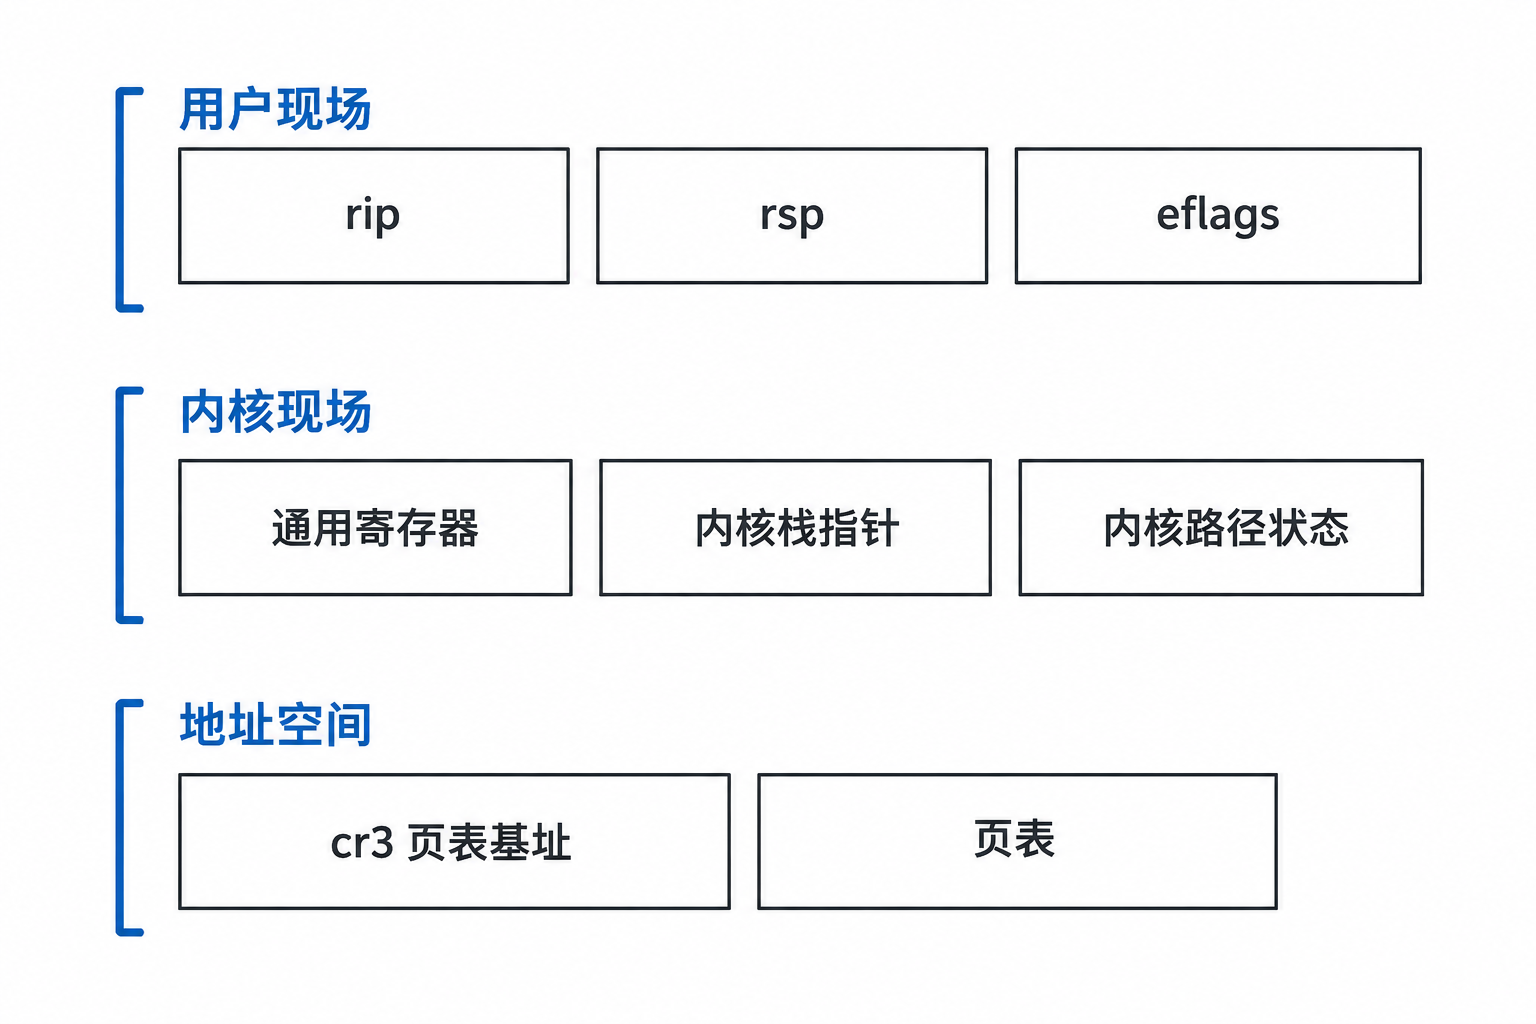
图 4 上下文清单
表中需要单独说明的只有 cr3。cr3 中存放的是页表基址,更换它之后,同一个虚拟地址就会翻译到另一块物理内存上,一个进程的地址空间正是依靠这一点与另一个进程区分开来。线程共享同一个地址空间,它们的 cr3 完全相同,切换时不需要改动 cr3;两个进程之间切换时,cr3 必须跟着更换,进程切换与线程切换之间的差别有很大一部分就集中在这一个寄存器上。
每次切换并不需要把整张表全部存入再全部取出。硬件任务切换会把所有能够保存的内容都保存一遍,软件切换只保存真正需要的部分,这一差别是 2.6 内核放弃硬件切换的原因之一,第八节将展开说明。
保存的位置同样需要分清。从用户态进入内核的那一刻,CPU 的现场先被压入内核栈,这部分内容称为用户现场;等到内核决定更换执行对象时,需要保存的是内核这一路执行下来的现场,其中包含内核栈指针本身,这部分内容称为内核现场。两者保存的位置不同,恢复的路径也不同。
用户现场的保存由硬件完成。系统调用或者中断发生时,CPU 自动把用户态的 rip、cs、eflags、rsp、ss 压入当前任务的内核栈,一共五个值,不需要内核执行任何指令。内核现场则必须由内核自己保存,保存哪些寄存器、存放在什么位置,都由软件决定。
用户现场只压栈一次,此后无论这个任务被换下多少次、换回来多少次,它都留在内核栈上,直到最后由 iret 把它装回寄存器。切换过程中反复保存与恢复的只有内核现场这一部分,因此一次切换的开销可以控制在微秒级,不需要搬运整张上下文清单。
| 现场 | 保存者 | 保存时机 | 存放位置 | 恢复方式 |
|---|---|---|---|---|
| 用户现场 | CPU 硬件 | 进内核的一瞬间 | 当前任务的内核栈顶 | iret 返回用户态时 |
| 内核现场 | 内核软件 | 决定换人的那一刻 | 0.11 存进 TSS,现代存进内核栈与 thread_struct | switch_to 恢复 |
四、一次完整切换
一次切换从 A 被换下到 B 开始运行,中间经过七个动作。
图 5 一次完整切换的全过程

  ┌──────────────────────────────────────────────────────────────┐
  │ ① 用户态:A 正在跑。寄存器里全是 A 的中间数据。              │
  └──────────────────────────┬───────────────────────────────────┘
                             ▼
  ┌──────────────────────────────────────────────────────────────┐
  │ ② 中断/系统调用:CPU 切到内核态,把【用户现场】压到          │
  │    A 的"内核栈"上(eip/eflags 等由硬件压,其余入口代码压)   │
  └──────────────────────────┬───────────────────────────────────┘
                             ▼
  ┌──────────────────────────────────────────────────────────────┐
  │ ③ 内核逻辑:发现"A 的时间片到了"(比如 counter 减到 0),     │
  │    调用 schedule() —— 按调度算法挑下一个任务 B               │
  └──────────────────────────┬───────────────────────────────────┘
                             ▼
  ┌──────────────────────────────────────────────────────────────┐
  │ ④ 切换核心 switch_to:                                       │
  │      保存 A 的【内核态现场】 ─────► 写进 A 的"存档点"        │
  │      恢复 B 的【内核态现场】 ◄───── 从 B 的"存档点"读入      │
  │   (存档点:0.11 = TSS;现代 = 内核栈 + task_struct)        │
  └──────────────────────────┬───────────────────────────────────┘
                             ▼
  ┌──────────────────────────────────────────────────────────────┐
  │ ⑤ B 接着跑它自己的内核路径(B 上次也是在内核里被打断的)     │
  └──────────────────────────┬───────────────────────────────────┘
                             ▼
  ┌──────────────────────────────────────────────────────────────┐
  │ ⑥ 中断返回(iret):从 B 的内核栈上恢复 B 的【用户现场】     │
  └──────────────────────────┬───────────────────────────────────┘
                             ▼
  ┌──────────────────────────────────────────────────────────────┐
  │ ⑦ 用户态:B 继续跑。中间发生的"换人",B 完全不知情。         │
  │    (透明性 —— 上下文切换最漂亮的目标)                      │
  └──────────────────────────────────────────────────────────────┘
图 5 一次完整切换的全过程
第一步发生在用户态。A 正在执行自己的代码,十几个寄存器与栈指针中保存的全部是 A 的中间结果。
第二步进入内核。系统调用、中断或者异常都会让 CPU 从用户态切换到内核态,硬件先把一部分现场压入内核栈,其中包括用户态的 rip、cs、eflags、rsp 与 ss。这几项由硬件自动完成,不需要内核执行任何指令,因此进入内核这一动作的开销很小。
第三步是内核逻辑作出判断。时钟中断处理程序发现 A 的时间片已经用完,或者 A 自己调用了会进入睡眠的系统调用,内核于是决定更换执行对象,进入调度函数挑选下一个任务。
第四步是保存与恢复内核现场:A 停在什么位置、内核栈指针指向哪里、内核路径上用到了哪些寄存器,这些内容全部记录下来,然后恢复 B 上次被换下时保存的那一份。保存与恢复的具体位置取决于内核版本,0.11 写入 TSS,现代内核写入 B 自己的内核栈与 thread_struct。
第五步,B 从自己上次被打断的内核位置继续向下执行。B 上次同样是在进入内核之后被换下的,因此它恢复之后的第一件事是走完内核中剩下的那一段路径。
第六步是返回用户态。iret 指令把内核栈上保存的用户现场重新装入寄存器,CPU 的特权级回到 3,执行流回到 B 的用户代码。
第七步,B 在自己上次所处的用户态位置继续运行。中间发生的更换执行对象的过程,B 完全感知不到,它不会知道自己曾经被换下过。
七个动作按照执行主体可以分成三类。
| 步骤 | 执行主体 | 做的事 | 谁看不见 |
|---|---|---|---|
| ①② | CPU 硬件 | 进内核,压用户现场 | 用户程序察觉不到自己进了内核 |
| ③④ | 内核软件 | 判断该换谁,保存与恢复内核现场 | 两个任务都不知道换人的发生 |
| ⑤⑥⑦ | 内核再交回硬件 | 走完内核路径,iret 回用户态 | 换回来的任务以为一直在跑 |
这七个步骤体现出两条规律。
切换只发生在内核态。 第二到第六步全部在内核中完成,用户程序既不能发起切换,也看不到切换,它能够做的只是通过系统调用把自己阻塞,其余工作交给内核处理。
被换下的任务都停在「内核的某处」。 A 和 B 各自的暂停点都位于内核路径上,恢复时也从那里继续,最后各自用 iret 回到用户态。这意味着一个任务被换下时,它的内核栈上一定保留着一条完整的、可以继续执行的路径。
五、栈不搬,只换 esp
第四步所说的保存与恢复,落到内存上其实只做了一件事:更换栈指针。
图 6 切换不是搬运栈,而是换 esp

   A 的内核栈(在内存里原地不动)      B 的内核栈(同样原地不动)
   ┌───────────────────┐          ┌───────────────────┐
   │  ……               │          │  ……               │
   │  A 的现场快照      │          │  B 的现场快照      │
   │  (包括上面那些    │          │                   │
   │    寄存器、断点)  │          │                   │
   └───────────────────┘          └───────────────────┘
            ▲                              ▲
            │ esp 指向 A 的栈               │ esp 换到 B 的栈
          切换前                          切换后

   —— 内存里的内容一个字节都没搬,只是"栈指针 esp"换了指向。
图 6 切换不是搬运栈,而是换 esp
内存中的那两块栈一个字节都没有移动,A 的现场仍然留在 A 的栈上,B 的现场也仍然留在 B 的栈上,改变的只是 esp 这个寄存器指向的对象。恢复上下文的大部分工作都可以归结为把一组寄存器值从存档点装回寄存器,装回之后 CPU 自然从 B 的断点继续执行。
这里所说的栈是内核栈。每个任务都拥有一条自己的内核栈,这是内核对任务提出的最低要求之一。
图 7 进程 A 的内核栈

   高地址(栈底)
   ┌─────────────────────────┐
   │  (内核栈的起点)         │
   ├─────────────────────────┤
   │ ss、esp(A 的用户栈位置) │ ← 硬件压入(跨特权级进入时才有)
   │ eflags                   │ ← 硬件压入
   │ cs、eip(A 的用户断点)   │ ← 硬件压入
   ├─────────────────────────┤
   │ ds/es/fs 等段寄存器       │ ← 内核入口代码压入
   │ 部分通用寄存器            │ ← 内核入口代码压入
   ├─────────────────────────┤
   │ 内核函数们的局部变量……    │
   │        ↑ 栈向低地址生长   │
   │  esp(当前栈顶)          │
   └─────────────────────────┘
   低地址
图 7 进程 A 的内核栈
每个任务必须拥有一条自己的内核栈,原因在于内核代码随时可能在任意位置被打断。A 在内核中执行到一半时来了一个中断,CPU 用 A 的内核栈保存现场;如果所有任务共用一条内核栈,那么下一次更换执行对象时,B 的现场就会压在同一块内存上,把 A 留下的返回地址与局部变量全部覆盖。A 再被换回来时,它将沿着一条已经被写坏的内核路径继续执行,结果就是内核崩溃。
内核栈上存放着三类内容:中断与系统调用入口处压入的用户现场,内核函数自身的局部变量与返回地址,以及切换时保存的内核寄存器现场。这三类内容合在一起,就是恢复一个任务所需要的全部信息。
16 KB 这个尺寸之所以能够成立,原因在于内核中的调用层次比用户程序浅得多。用户程序可以递归几百层,每一层都带有自己的局部变量;内核的调用路径通常是固定的几条,中断处理、系统调用、调度三条线各自的深度都可以数出来,深递归在内核中是要极力避免的写法。内核栈一旦溢出,被写坏的是紧邻的内存,后果往往是一次没有线索的崩溃,因此内核代码中很少出现大的栈上数组。
有一点容易混淆:内核栈是每个任务一块,用户栈也是每个任务一块,两者互不相干。切换时更换的是内核栈指针,用户栈指针留在内核栈上那份用户现场里,等到 iret 执行时才被装回寄存器。
本机 3.10 内核中的相关定义可以直接读取,其中几个数字如下。
/* arch/x86/include/asm/page_64_types.h */
#define THREAD_SIZE_ORDER	2
#define THREAD_SIZE  (PAGE_SIZE << THREAD_SIZE_ORDER)

/* arch/x86/include/asm/thread_info.h */
struct thread_info {
	struct task_struct	*task;		/* main task structure */
	struct exec_domain	*exec_domain;	/* execution domain */
	__u32			flags;		/* low level flags */
	__u32			status;		/* thread synchronous flags */
	__u32			cpu;		/* current CPU */
	int			preempt_count;	/* 0 => preemptable, <0 => BUG */
	mm_segment_t		addr_limit;
	struct restart_block    restart_block;
	void __user		*sysenter_return;
};

#define TIF_NEED_RESCHED	3	/* rescheduling necessary */
#define _TIF_NEED_RESCHED	(1 << TIF_NEED_RESCHED)
页大小是 4 KB,THREAD_SIZE_ORDER 是 2,因此每个任务的内核栈是 16 KB。thread_info 放在这块栈的底部,取得它的办法是把栈指针向下按 16 KB 对齐,或者从 per-CPU 的 kernel_stack 变量直接算出。结构体中的 flags 就是后文反复出现的那个标记位所在的字段,TIF_NEED_RESCHED 是第 3 位,把它置上去表示有任务需要重新调度。
内核栈指针本身记录在 task_struct 的 thread 成员中,也就是 thread_struct 的 sp 字段。
/* arch/x86/include/asm/processor.h */
struct thread_struct {
	/* Cached TLS descriptors: */
	struct desc_struct	tls_array[GDT_ENTRY_TLS_ENTRIES];
	unsigned long		sp0;
	unsigned long		sp;
	/* ... */
};
sp0 是进入内核时切换到的那条栈的指针,sp 是保存下来的当前内核栈指针,切换时存入 sp、恢复时从 sp 装回,就是前面那两张图所描述的动作。用户栈与内核栈是两条完全独立的栈,切换更换的是后者。
这两个字段在现代内核中依然存在,只是位置发生了变化。0.11 把它们放在 TSS 中由硬件使用,3.10 把它们放在 task_struct 的 thread 成员中由软件使用,名字从 esp 改成 sp,用途完全相同。硬件任务切换退场之后,存档点并没有消失,只是更换了存放的位置。
0.11 的 TSS 中存放着完整的寄存器现场,现代的 thread_struct 中只保存一个栈指针。差别在于现代内核把其余的寄存器现场压在内核栈上,栈指针指向哪里,那份现场就位于哪里。两者都满足「每个任务一份现场」这条要求。
六、0.11 :task_struct、tss_struct 与 switch_to
在 Linux 0.11 的时代,硬件的任务切换机制仍在使用,代码篇幅短到可以整段读完。本节按顺序阅读 task_struct、tss_struct 与 switch_to 这三处源码。
进程结构体中,与时间片、切换直接相关的是最前面几个字段。下面这份是摘录,只保留了与调度相关的部分。
struct task_struct {
/* these are hardcoded - don't touch */
    long state;                 /* 进程状态:-1 不可运行, 0 可运行, >0 已停止 */
    long counter;               /* 时间片余量 */
    long priority;              /* 优先级:每轮补时间片的基数 */
    long signal;
    struct sigaction sigaction[32];
    long blocked;               /* 被屏蔽信号位图 */
/* various fields */
    int exit_code;
    unsigned long start_code,end_code,end_data,brk,start_stack;
    long pid,father,pgrp,session,leader;
    long alarm;
    long utime,stime,cutime,cstime,start_time;
/* file system info */
    int tty;
    unsigned short umask;
    struct m_inode * pwd;
    struct m_inode * root;
    struct m_inode * executable;
    unsigned long close_on_exec;
    struct file * filp[NR_OPEN];
/* ldt for this task 0 - zero 1 - cs 2 - ds&ss */
    struct desc_struct ldt[3];
/* tss for this task */
    struct tss_struct tss;
};
三个字段决定了调度行为。state 是任务状态,counter 是剩余的时间片,priority 是下一轮补充时间片时的基数。时间片耗尽之后补充多少,补充的就是 priority 这个数值。 结构体最后两个成员是 ldt[3] 和 tss,它们直接嵌在 task_struct 内部,因此每个任务的局部描述符表与硬件存档点,都是它自己结构体的一部分。
结构体中 ldt[3] 那三个表项分别对应零号段、代码段与数据段,构成每个任务自己的局部描述符表。
tss_struct 是硬件任务切换的存档点,CPU 在执行任务切换时会自动读写这个结构。
struct tss_struct {
    long back_link;     /* 16 high bits zero */
    long esp0;          /* 特权级 0(内核)的栈指针:进内核时用这条栈 */
    long ss0;           /* 特权级 0 的栈段 */
    long esp1;          /* 特权级 1 的栈(Linux 不用) */
    long ss1;
    long esp2;          /* 特权级 2 的栈(Linux 不用) */
    long ss2;
    long cr3;           /* 页目录物理地址:一换它,整个地址空间都换了 */
    long eip;           /* 任务恢复后从哪条指令继续 */
    long eflags;        /* 标志位 */
    long eax,ecx,edx,ebx;   /* 通用寄存器 */
    long esp;           /* 内核栈指针 */
    long ebp;
    long esi;
    long edi;
    long es;            /* 段寄存器 */
    long cs;
    long ss;
    long ds;
    long fs;
    long gs;
    long ldt;           /* 本任务的 LDT 选择子 */
    long trace_bitmap;  /* 调试用 */
    struct i387_struct i387;  /* 浮点寄存器组 */
};
存档点的字段排布与一个任务的完整现场一一对应。最上面的 back_link 用于任务嵌套,Linux 并不使用它;esp0 与 ss0 是进入内核时使用的栈,每次进入内核 CPU 都从这里取栈指针,因此这个字段在现代内核中依然存在,只不过改名为 sp0。
前二十来行正是第三节那张上下文清单的逐项对应:eip 与 eflags 负责执行位置,esp 与 ebp 负责栈,eax 到 edi 是通用寄存器,六个段寄存器各占一行,cr3 负责地址空间,最后还有一个 i387 专门存放浮点寄存器组。
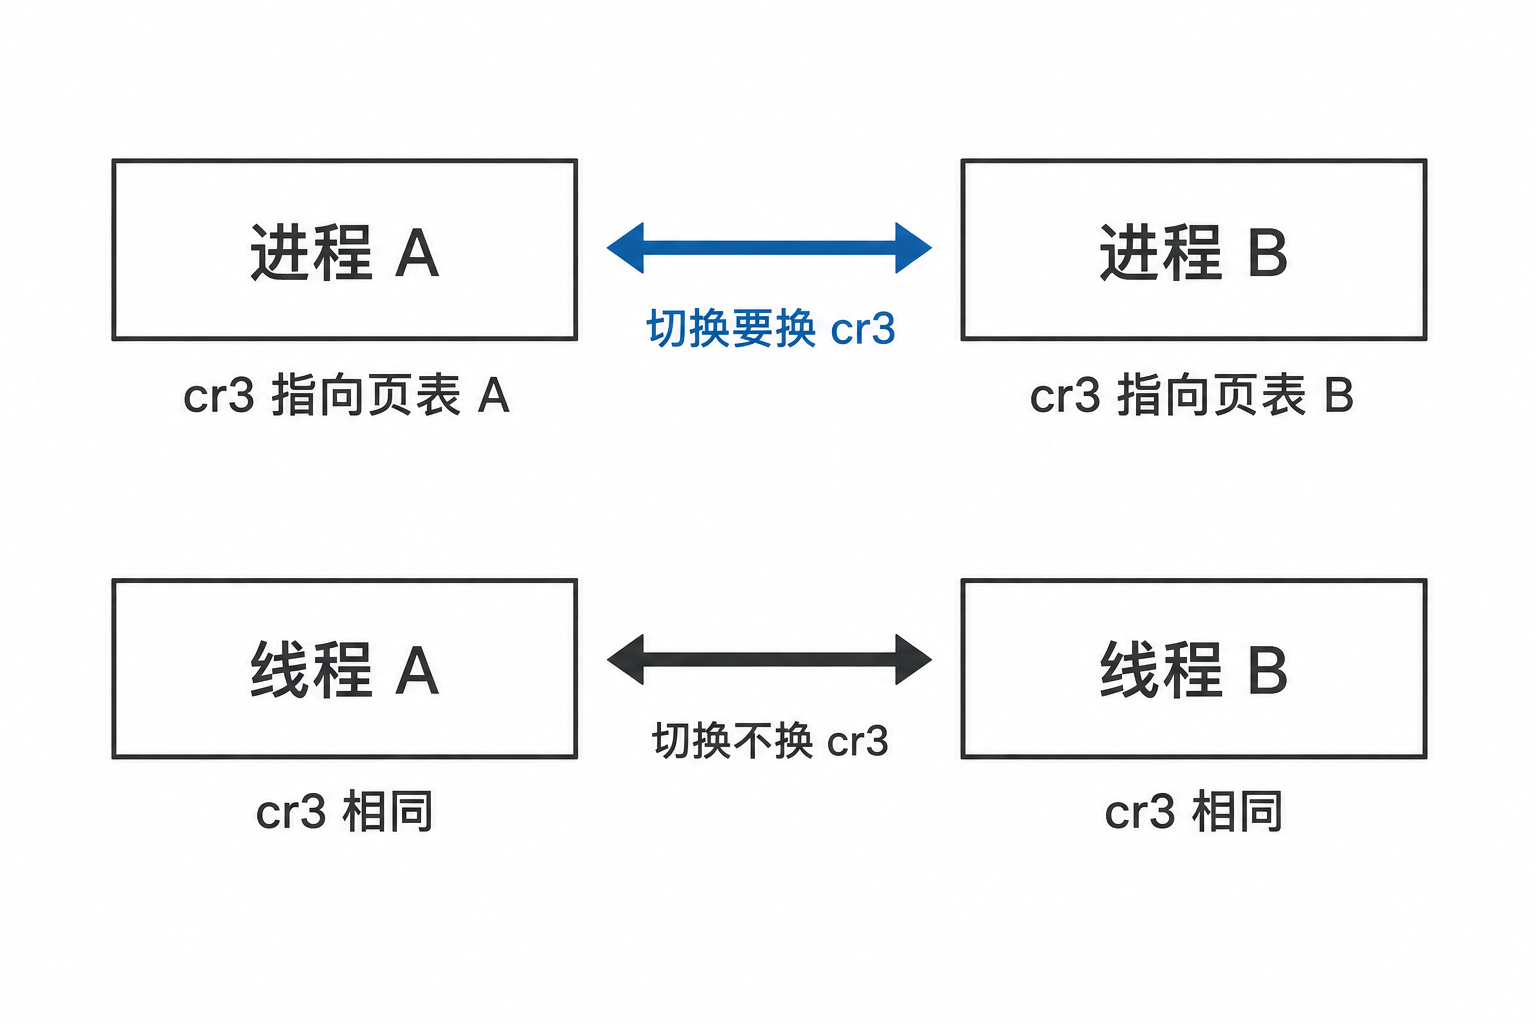
图 8 进程切换与线程切换的差别
cr3 那一行正是进程切换与线程切换的差别所在。两个进程各有各的 cr3,切换时必须更换,更换之后整个地址空间的翻译规则都随之改变,页表缓存也要跟着处理。同一个进程中的两个线程共用一份地址空间,cr3 完全相同,切换时不需要改动,线程切换的开销低于进程切换,主要差别正是这一项。
硬件任务切换依靠一条指令触发,这条指令读取的是 GDT 中的任务门。每个任务在 GDT 中占用两个表项,一个存放 TSS,一个存放 LDT。
图 9 GDT 布局

 索引:   [0]   [1]     [2]     [3]     [4]     [5]     [6]     [7]    ...
       ┌────┬───────┬───────┬───────┬───────┬───────┬───────┬───────┐
       │ 空 │内核代码│内核数据│(临时) │ TSS0  │ LDT0  │ TSS1  │ LDT1  │ ...
       └────┴───────┴───────┴───────┴───────┴───────┴───────┴───────┘
                                      └── 任务0 ──┘ └── 任务1 ──┘
                                        两个表项      两个表项

  选择子换算(选择子 = 索引 × 8):
    任务 n 的 TSS 选择子 = 0x20 + n×16      (0x20=32=4×8,从索引4开始)
    任务 n 的 LDT 选择子 = 0x28 + n×16      (0x28=40=5×8)
图 9 GDT 布局
TSS 的段选择子放在 GDT 的偶数项上,LDT 放在紧随其后的奇数项上。访问 TSS 时用选择子加偏移取得具体字段,而任务切换指令只需要一个指向任务门的选择子。
真正执行更换的代码只有下面这几行。
图 10 硬件任务切换:一条 ljmp

  ① 把【当前寄存器现场】写进"当前任务的 TSS"
     (eip、eflags、eax~edi、esp、段寄存器、cr3、ldt ……)
        —— TR 寄存器指向的就是它
  ② 把 TR 换成"新任务的 TSS"
  ③ 从【新任务的 TSS】里把现场装回寄存器
  ④ 从新任务保存的 eip 处继续执行

  全过程一条指令,中间步骤内核"看不见"。
  这就是"硬件任务切换"——省事,但完全不受内核控制。
图 10 硬件任务切换:一条 ljmp
#define switch_to(n) {\
struct {long a,b;} __tmp; \
__asm__("cmpl %%ecx,current\n\t" \
    "je 1f\n\t" \
    "movw %%dx,%1\n\t" \
    "xchgl %%ecx,current\n\t" \
    "ljmp *%0\n\t" \
    "cmpl %%ecx,last_task_used_math\n\t" \
    "jne 1f\n\t" \
    "clts\n" \
    "1:" \
    ::"m" (*&__tmp.a),"m" (*&__tmp.b), \
    "d" (_TSS(n)),"c" ((long) task[n])); \
}
这段代码需要拆开来看。前两行检查要切换到的任务是不是当前任务,如果是就直接跳走,不执行任何操作。接下来把目标任务的 TSS 选择子写入一个临时结构体的低两个字节,这个结构体就是 ljmp 指令要读取的操作数。xchgl 把全局变量 current 换成新任务。真正执行保存与恢复的是 ljmp *%0 这一条指令:它带着任务门的操作数执行长跳转,CPU 收到之后自动完成一整套动作,把当前所有寄存器的值写进旧任务的 TSS,再从新任务的 TSS 中把寄存器全部装回,然后从新任务的 eip 继续执行。
全部保存与恢复由一行汇编指令完成,这既是硬件任务切换设计上最简洁的一处,也构成了它后来被放弃的原因之一。
七、0.11 :schedule 与时间片
接下来看内核如何决定换成哪一个任务。0.11 的调度函数一共只有三十多行。
void schedule(void)
{
    int i, next, c;
    struct task_struct ** p;

    /* 先处理闹钟与可中断睡眠的进程:该唤醒的唤醒 */
    for (p = &LAST_TASK ; p > &FIRST_TASK ; --p)
        if (*p) {
            if ((*p)->alarm && (*p)->alarm < jiffies) {
                (*p)->signal |= (1<<(SIGALRM-1));
                (*p)->alarm = 0;
            }
            if (((*p)->signal & ~(_BLOCKABLE & (*p)->blocked)) &&
                 (*p)->state == TASK_INTERRUPTIBLE)
                (*p)->state = TASK_RUNNING;
        }

    /* 调度器本体 */
    while (1) {
        c = -1;  next = 0;
        i = NR_TASKS;  p = &task[NR_TASKS];
        while (--i) {
            if (!*--p) continue;
            if ((*p)->state == TASK_RUNNING && (*p)->counter > c)
                c = (*p)->counter, next = i;
        }
        if (c) break;
        for (p = &LAST_TASK ; p > &FIRST_TASK ; --p)
            if (*p)
                (*p)->counter = ((*p)->counter >> 1) + (*p)->priority;
    }
    switch_to(next);
}
第一个循环处理的是「该唤醒的进程」。闹钟到期就把 SIGALRM 置入信号位图,收到信号并且处于可中断睡眠的进程被改回可运行状态,这样它们才有机会参与后面的挑选。
第二个循环是调度器本体。它把任务数组从头到尾扫描一遍,在可运行的任务中挑出 counter 最大的那一个。counter 是剩余的时间片,剩余越多越先运行,这条规则保证了时间片长的任务能够获得更多的 CPU 时间。
如果扫描一遍之后发现所有可运行任务的 counter 都是 0,就进入补充时间片的那一行。
(*p)->counter = ((*p)->counter >> 1) + (*p)->priority;
每个任务的 counter 被更新为「自己的一半加上 priority」。已经耗尽的任务 counter 是 0,补充之后正好拿到 priority 那么多;如果某个任务还剩下一点没有用完的 counter,它会保留其中的一半,同时再加一份 priority。这一步让睡眠多、占用少的任务在下一轮拿到更多时间片,属于内核对交互式任务的一种照顾。2.6 的 O(1) 调度器中的动态优先级,正是这条思路的延续。
时间片在时钟中断中被消耗,处理逻辑只有四行。
if ((--current->counter) > 0) return;   /* 时间片还有:继续跑 */
current->counter = 0;
if (!cpl) return;   /* 刚才在内核态被打断:这次先不切 */
schedule();         /* 时间片到,换人 */
这段逻辑在 0.11 中写在 do_timer 函数里,由时钟中断按固定频率调用,0.11 的 HZ 是 100,也就是每 10 毫秒进入一次。每来一次时钟中断,当前任务的 counter 就减一。减到 0 之后并不会立刻更换执行对象,中间还有一道 cpl 判断:如果被打断的时候 CPU 正处于内核态,这一次就先不切换。原因在于 0.11 的内核不可抢占,内核代码执行到一半被换下时,许多共享数据结构会停留在中间状态。这也是抢占这一概念在早期内核中的边界:用户态可以被抢占,内核态不行。
0.11 的调度器有两个明显特征。挑选任务时需要遍历整个任务数组,任务数量增加之后,调度本身的开销随之增长,复杂度是 O(n)。它按照 counter 的比例分配 CPU 时间,比例公平,但切换频繁,任务越多,花费在挑选任务上的时间就越可观。
这笔开销可以拆开计算。假设机器上有一百个任务,每次调度的第一步是扫描整个数组挑出 counter 最大者,这一百次比较无法避免;补充时间片的分支同样要扫描一遍;扫描的代价还随着任务数量线性增长。在一百个任务的场合,一次调度要做的比较就达到上百次,而调度本身每秒钟可能被触发上千次。2.6 的 O(1) 调度器针对的正是这笔开销。
| 对比项 | 0.11 的调度器 | 2.6 的 O(1) 调度器 |
|---|---|---|
| 挑选方式 | 遍历任务数组找 counter 最大者 | 位图定位加队列取队首 |
| 复杂度 | O(n),n 是任务数 | O(1),最多查 5 个机器字 |
| 任务的存放 | 一个全局任务数组 | 每个 CPU 一个运行队列,140 条优先级队列 |
| 时间片分配 | 按 counter 与 priority 的比例 | 查表得到,随优先级变化 |
| 数据如何组织 | 数组加链表 | 位图加双向链表 |
八、为什么放弃硬件任务切换
一条 ljmp 完成全部保存与恢复,看上去十分简洁,但硬件任务切换存在几个无法回避的缺点。
全存全取,浪费明显。 从 tss_struct 的字段就可以看出这一点,六个段寄存器、一整组浮点寄存器,每次切换都要先写一遍再读一遍,而被换下的任务往往只用到其中一小部分。
绑定在段式内存管理上。 硬件任务切换要使用 TSS 与 GDT 这套机制,而 x86-64 上段机制已经被废弃,平坦模型成为主流,这套设计因此失去了硬件基础。
一个任务一份 TSS,支持不了线程。 同一地址空间中的多个执行流共享地址空间,硬件切换却要连 cr3 一起更换,与线程模型存在天然的冲突。
开销固定,没有优化余地。 保存什么、恢复什么由硬件决定,内核无法介入。
软件切换的思路是把这项工作收回内核自己做。
图 11 软件切换

   进程 A 的内核栈                     进程 B 的内核栈
   ┌──────────────┐                 ┌──────────────┐
   │ ……           │                 │ ……           │
   │ 保存的少量寄存器│                 │ 保存的少量寄存器│
   │ 返回地址      │                 │ 返回地址      │
   └──────────────┘                 └──────────────┘
         ▲                                ▲
         │ A 的栈指针存进 A 的             │ B 的栈指针从 B 的
         │ task_struct(thread_struct)    │ task_struct 里取出
         └──────────  __switch_to  ────────┘
                (保存/恢复是"按需的",不是"全量的")
图 11 软件切换
改成软件实现之后,保存清单由内核自己拟定,切换时真正需要保存的内容只剩下两类:进入内核时已经压在内核栈上的用户现场,以及内核路径上用到的寄存器与内核栈指针。其余的寄存器都留在原地不动,内核路径上用不到的就不保存,浮点寄存器在没有用到的时候不去触碰,段寄存器在平坦模型下大部分是常量。用户现场与内核现场分开之后,前者在进入内核时已经由硬件压好,切换时不必再改动。更换页表这一动作也被单独摘了出来,只有进程之间切换才需要,线程切换直接跳过。
本机 3.10 内核中的 switch_to 采用的正是这个思路,代码可以直接阅读。
/* arch/x86/include/asm/switch_to.h */
#define SAVE_CONTEXT    "pushf ; pushq %%rbp ; movq %%rsi,%%rbp\n\t"
#define RESTORE_CONTEXT "movq %%rbp,%%rsi ; popq %%rbp ; popf\t"

#define switch_to(prev, next, last) \
	asm volatile(SAVE_CONTEXT					  \
	     "movq %%rsp,%P[threadrsp](%[prev])\n\t" /* save RSP */	  \
	     "movq %P[threadrsp](%[next]),%%rsp\n\t" /* restore RSP */	  \
	     "call __switch_to\n\t"					  \
	     "movq "__percpu_arg([current_task])",%%rsi\n\t"		  \
	     "movq %P[thread_info](%%rsi),%%r8\n\t"			  \
	     "testl  %[_tif_fork],%P[ti_flags](%%r8)\n\t"		  \
	     "jnz   ret_from_fork\n\t"					  \
	     RESTORE_CONTEXT						  \
	     : "=a" (last)					  	  \
	     : [next] "S" (next), [prev] "D" (prev),			  \
	       [threadrsp] "i" (offsetof(struct task_struct, thread.sp)), \
	       [ti_flags] "i" (offsetof(struct thread_info, flags)),	  \
	       [_tif_fork] "i" (_TIF_FORK),			  	  \
	       [thread_info] "i" (offsetof(struct task_struct, stack)),   \
	       [current_task] "m" (current_task)			  \
	     : "memory", "cc"						\
	       , "rcx", "rbx", "rdx", "r8", "r9", "r10", "r11",	  \
	         "r12", "r13", "r14", "r15")
整段代码只做四件事。SAVE_CONTEXT 把标志寄存器与 rbp 压入当前的内核栈,同时把 rsi 存入 rbp。紧接着的两条 movq 是核心:第一条把当前的 rsp 写进旧任务的 thread.sp,第二条从新任务的 thread.sp 中读回 rsp。切换在内核这一层的本质,就是这两条指令。 之后 call __switch_to 去处理那些必须由 C 代码完成的工作,主要是 FPU 状态、TLS 描述符与调试寄存器,最后 RESTORE_CONTEXT 把 rbp 与标志寄存器恢复回来。
把这段代码与 0.11 的 switch_to 对照,差别十分明显。0.11 是一行 ljmp,把全部寄存器的保存与恢复交给 CPU 完成;3.10 是两条 movq 加一次函数调用,保存什么由内核自己决定。所谓软件切换,指的是切换的核心动作由内核自己编写的汇编完成,不再交给硬件指令。
| 对比项 | 硬件任务切换(0.11) | 软件切换(现代) |
|---|---|---|
| 触发方式 | ljmp 一条指令,走 GDT 任务门 | 直接改内核栈指针,函数调用 |
| 保存内容 | TSS 里全部字段,含六个段寄存器和 i387 | 内核栈上的用户现场加少数寄存器 |
| 存档位置 | task_struct 里的 tss 成员 | 内核栈加 thread_struct.sp |
| 地址空间 | 硬件连 cr3 一起换 | 由内核决定换不换,线程切换不换 |
| 支持线程 | 不友好 | 天然支持 |
| 内核的插手余地 | 没有 | 保存清单自己定 |
九、一个 CPU 一个运行队列
2.6 内核把调度器重新设计了一遍,设计目标写得很直白:挑选下一个任务的开销与任务数量无关。这个设计称为 O(1) 调度器,它的骨架是运行队列(runqueue)。
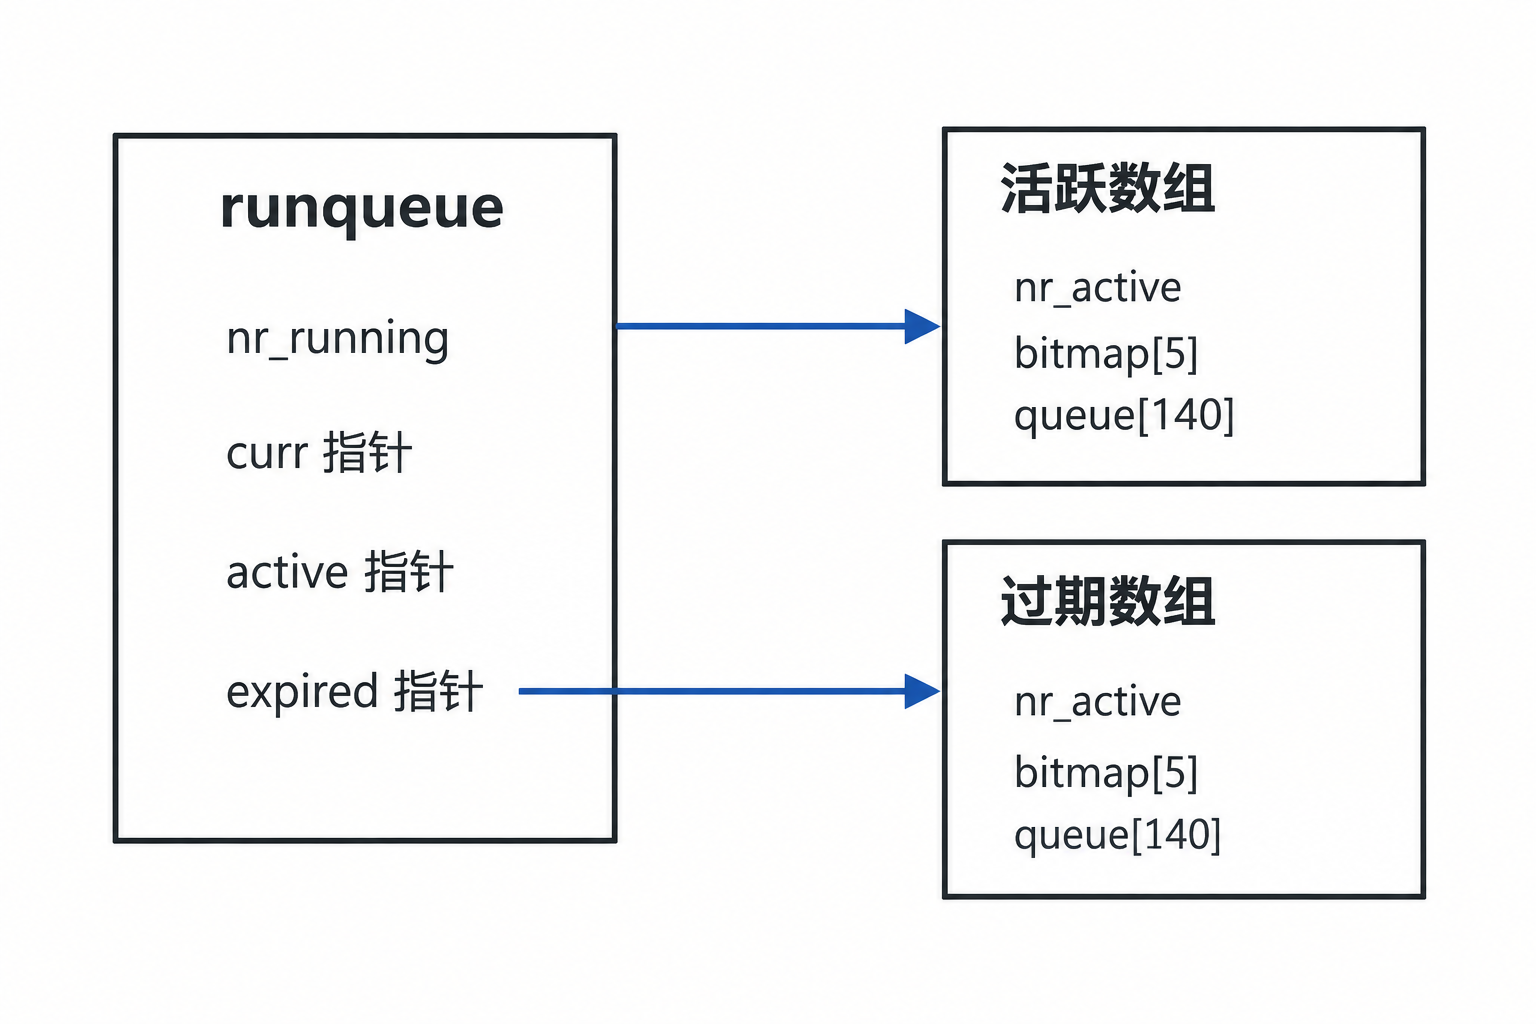
图 12 运行队列与优先级数组
每个 CPU 拥有自己的运行队列,队列中存放的是这个 CPU 上所有可运行的任务。这种划分带来两个好处:CPU 之间的竞争消失了,每个 CPU 只管理自己的队列;锁的粒度也随之变小,一个 CPU 操作自己的队列不会阻塞其他 CPU。
代价也随之出现:任务被分配到各个 CPU 之后,分布可能很不均匀,一个 CPU 上排着五个任务,另一个 CPU 上一个也没有,因此必须有专门的机制负责把任务从繁忙的队列搬到空闲的队列上,这就是负载均衡要做的事情。搬迁本身同样需要付出代价:任务在原来的 CPU 上运行了一段时间,缓存中存放着它刚刚用过的数据,搬到另一个 CPU 上之后这些数据全部失效,需要重新预热。
调度器因此需要作出取舍。不搬迁,两个 CPU 的忙闲差距会不断拉大,整体吞吐量下降;频繁搬迁,缓存一次又一次失效,单个任务的执行速度变慢。2.6 的做法是把负载记录为一段时间的平均值,只有差距超过阈值才执行搬迁,并且交给专门的迁移线程在合适的时机执行。
运行队列的字段列出如下。
/* kernel/sched.c,2.6 内核,节选 */
struct runqueue {
    spinlock_t lock;                        /* 每个队列自己的锁 */

    unsigned long nr_running;               /* 可运行任务数 */
    unsigned long cpu_load;                 /* 平均负载(负载均衡用) */
    unsigned long long nr_switches;         /* 切换计数 */
    unsigned long nr_uninterruptible;       /* 不可中断睡眠计数 */
    unsigned long expired_timestamp;        /* 过期队列开始积压的时间 */
    unsigned long timestamp_last_tick;      /* 上次 tick 时间 */

    task_t *curr, *idle;                    /* 当前任务 / 空闲任务 */
    struct mm_struct *prev_mm;              /* 上一个任务的地址空间 */

    prio_array_t *active, *expired, arrays[2];  /* 两个数组 + 两个指针 */
    int best_expired_prio;                  /* 过期队列最高优先级 */
    atomic_t nr_iowait;                     /* 等 IO 的任务数 */

    /* SMP 相关字段,单核时不存在 */
    unsigned long active_balance;
    int push_cpu;
    task_t *migration_thread;               /* 迁移线程 */
    struct list_head migration_queue;       /* 待迁移清单 */
    struct sched_domain *sd;                /* 调度域 */
};
这些字段按照用途可以分成四组。
curr 与 idle 记录当前正在运行的任务与空闲任务,切换在这个队列上完成。nr_running 是可运行任务的个数,nr_switches 是累计切换次数,这两个字段属于统计量。nr_uninterruptible 与 nr_iowait 统计处于睡眠状态的任务,负载计算会用到它们。
active、expired 与 arrays[2] 是这一节的重点。arrays 是一个长度为 2 的数组,内部装着两个优先级数组;active 和 expired 分别指向其中一个。两个数组加上两个指针,构成了调度器的全部候选任务。
expired_timestamp 与 best_expired_prio 是两个不显眼但很关键的字段。前者记录过期队列开始积压的时刻,用来防止任务在过期队列中等待过久;后者记录过期队列中当前最高的优先级,交换指针之后马上就可以使用,不必重新扫描一遍。
最后几行是 SMP 才有的字段,负责把一个 CPU 上的任务搬到另一个 CPU 上,属于负载均衡的内容。这台机器有两个核,本机运行的内核中这些字段是存在的,只是不再呈现为这个结构体的形式。
十、prio_array
运行队列中真正装任务的是优先级数组,类型是 prio_array_t。整个 O(1) 调度器的核心就是它,三个成员各负责一件事。
图 13 prio_array 三件套速览

      ┌──────────────────── prio_array ────────────────────┐
      │                                                    │
      │  nr_active = 5      ← 闸门:一共几个任务挂在我这    │
      │                                                    │
      │  bitmap[5]          ← 探照灯:哪几条队列"有人"      │
      │    (5 个机器字 × 32 位 = 160 位,实际用 140 位)   │
      │                                                    │
      │  queue[140]         ← 货架:140 条链表              │
      │    queue[100] → [T1] → [T2]                        │
      │    queue[101] →(空)                               │
      │    queue[102] → [T3]                               │
      │    ……                                              │
      │    queue[139] →(空)                               │
      └────────────────────────────────────────────────────┘
图 13 prio_array 三件套速览
nr_active 表示这个数组中挂着多少个可运行任务,用来判断数组是否为空。活跃数组一旦为空,说明这一批任务已经全部跑完一轮,该换上下一批了。有了这个计数,判断数组是否为空只需要读取一个数字,不需要去数 140 条队列。
bitmap[5] 是一张位图,为 140 条队列各配一位标记。第 i 位是 1 表示 queue[i] 中有任务,是 0 表示这条队列为空。140 位需要几个机器字可以直接计算:一个字 32 位,140 除以 32 等于 4.375,向上取整得到 5,5 乘 32 是 160 位,多出来的 20 位闲置不用。
queue[140] 是 140 条优先级队列,每一条都是一个双向链表,链上挂着同一个优先级的任务。
除了这三个成员,还有一条对应关系:下标越小,优先级越高。于是「寻找优先级最高、同时有任务排队的队列」这一操作,就转化为「在位图中寻找最低位的那个 1」。
三个成员的分工列在下表。
| 成员 | 承担的角色 | 谁维护它 | 什么时候被读 |
|---|---|---|---|
| nr_active | 这一批还剩几个任务 | 入队加一、出队减一 | 判断活跃数组是否已空 |
| bitmap[5] | 哪几条队列非空 | 队列由空变满时置位、由满变空时清位 | 每次挑下一个任务 |
| queue[140] | 任务具体排在哪里 | 入队挂到队尾、出队从链表摘除 | 定位到具体队列后取队首 |
用 140 条独立的队列代替一条长链,好处是把排序这一步提前完成。任务的优先级决定它挂在哪条队列上,挑选时只需要知道哪条队列非空,不必比较任何两个任务的优先级。这种做法用空间换取时间,代价是 140 个链表头加上 5 个字的位图,连一页内存都用不满。
图 14 位图与队列的一一映射

  bitmap:5 个机器字(word0 ~ word4),每个字 32 位
  第 i 位 ↔ queue[i]     (i = 0 ~ 139;140~159 位永远为 0,属于浪费的"边角料")

  word0    全 0        (优先级 0 ~ 31    :没人)
  word1    全 0        (优先级 32 ~ 63   :没人)
  word2    全 0        (优先级 64 ~ 95   :没人)
  word3    …… 位 0 0 0 0 [1] 0 … 0 [1] … 0 [1] 0 … 0
                         ▲           ▲          ▲
                     bit100       bit110     bit117    ← 三个 1
  word4    (优先级 128 ~ 159:没人)

  同一个数组的 queue[] 侧:
    queue[100] → [T1] → [T2]
    queue[110] → [T3]
    queue[117] → [T4]

  ★ "位图里的 1" 和 "队列非空" 永远一一对应:
     入队 → __set_bit 置 1;队列空了 → __clear_bit 清 0(见上一节源码)
图 14 位图与队列的一一映射
在这一步上,位图把查找的开销降低了一个数量级。顺着 140 条队列逐个查看,最坏情况要看 140 次;在位图中查找最低位的 1,最坏情况只看 5 个字,硬件上还有专门的指令可以一次完成定位。
/* 2.6 内核里挑人的那三行 */
idx = sched_find_first_bit(array->bitmap);        /* 找到最高优先级的非空队列 */
queue = array->queue + idx;                       /* 定位到那条队列 */
next = list_entry(queue->next, task_t, run_list); /* 队首就是下一个任务 */
sched_find_first_bit 在 x86 上的做法是从 5 个机器字中找出第一个非零字,再用 bsf 指令取出这个字中最低的 1 位。判断是否为空加上定位一共查找 5 次,与任务数量无关,O(1) 指的就是这样的常数次查找。
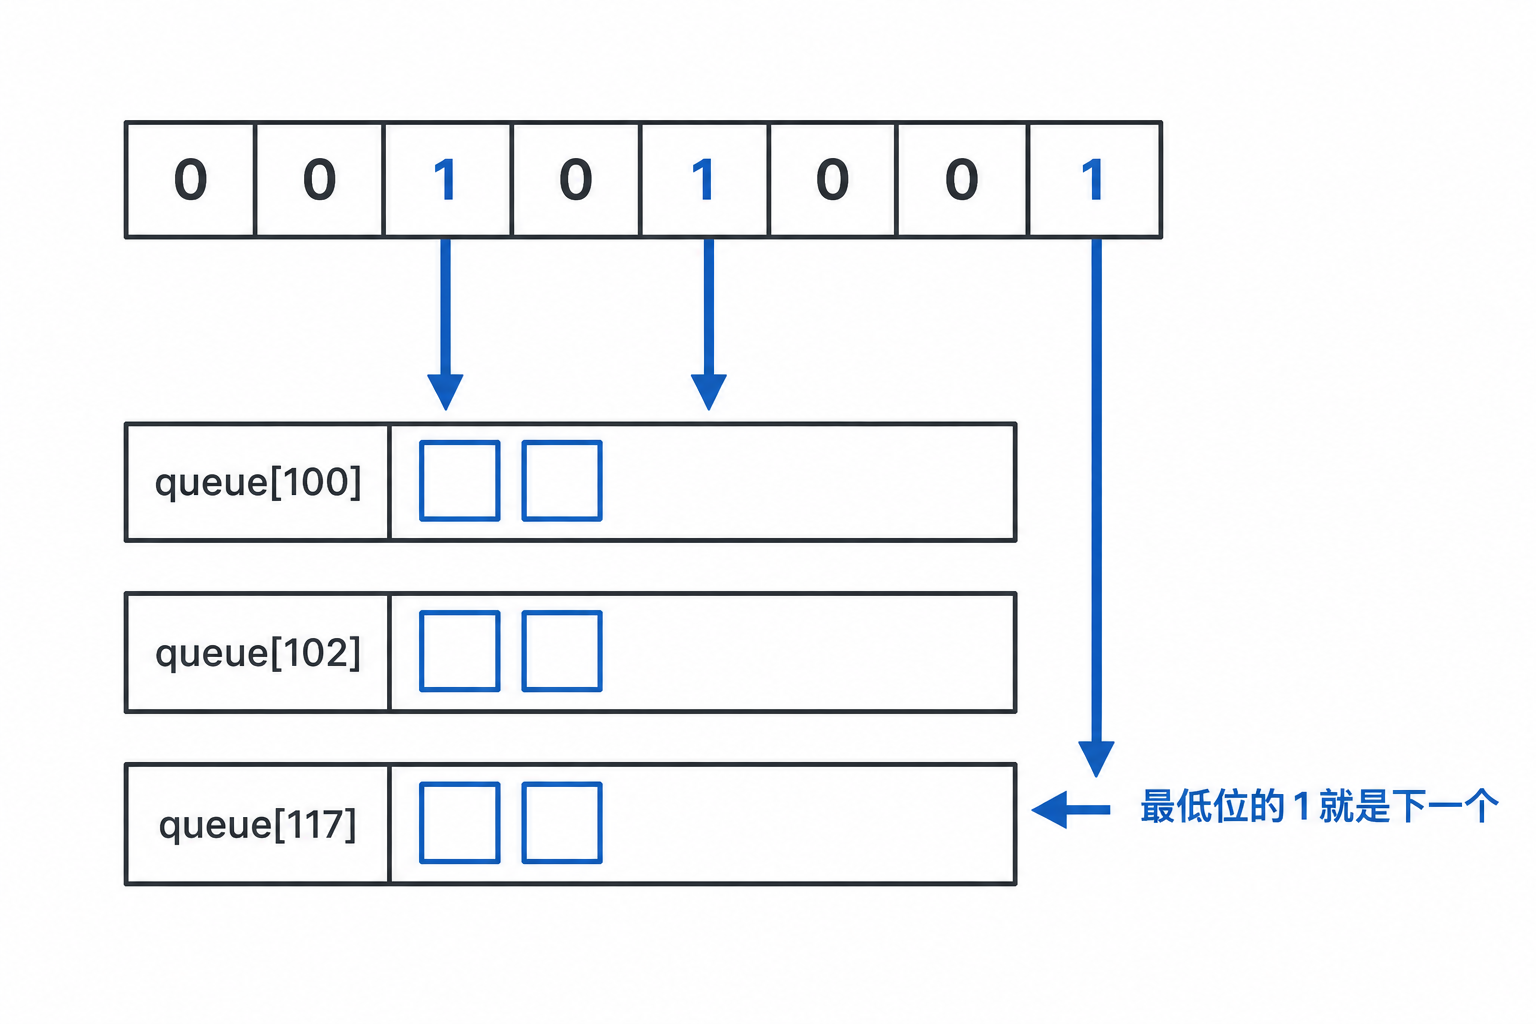
图 15 位图定位优先级
三件套由两个函数负责维护,一个负责入队,一个负责出队。
/* 入队 */
static void enqueue_task(struct task_struct *p, prio_array_t *array)
{
    list_add_tail(&p->run_list, array->queue + p->prio); /* 挂到对应优先级队列的队尾 */
    __set_bit(p->prio, array->bitmap);                   /* 位图置 1:这条队列有人了 */
    array->nr_active++;                                  /* 闸门计数加一 */
    p->array = array;                                    /* 记下挂在哪个数组 */
}

/* 出队 */
static void dequeue_task(struct task_struct *p, prio_array_t *array)
{
    list_del(&p->run_list);                              /* 从链表上摘下来 */
    if (list_empty(array->queue + p->prio))
        __clear_bit(p->prio, array->bitmap);             /* 这条队列空了,位图清 0 */
    array->nr_active--;                                  /* 闸门计数减一 */
    p->array = NULL;
}
这两个函数说明了三件套之间的配合关系:入队时先挂链表,再置位,最后增加计数;出队时先摘链表,判断整条队列是否为空,为空才清位,最后减少计数。
有两处细节容易被看漏。清位之前必须先判断整条队列是否为空,因为同一个优先级上可能排着好几个任务,只有当最后一个任务离开时,这条队列对应的位才应该清零。p->array 这个成员记录任务当前挂在哪个数组上,出队时被置空,出队之后再想摘下它就会出错。
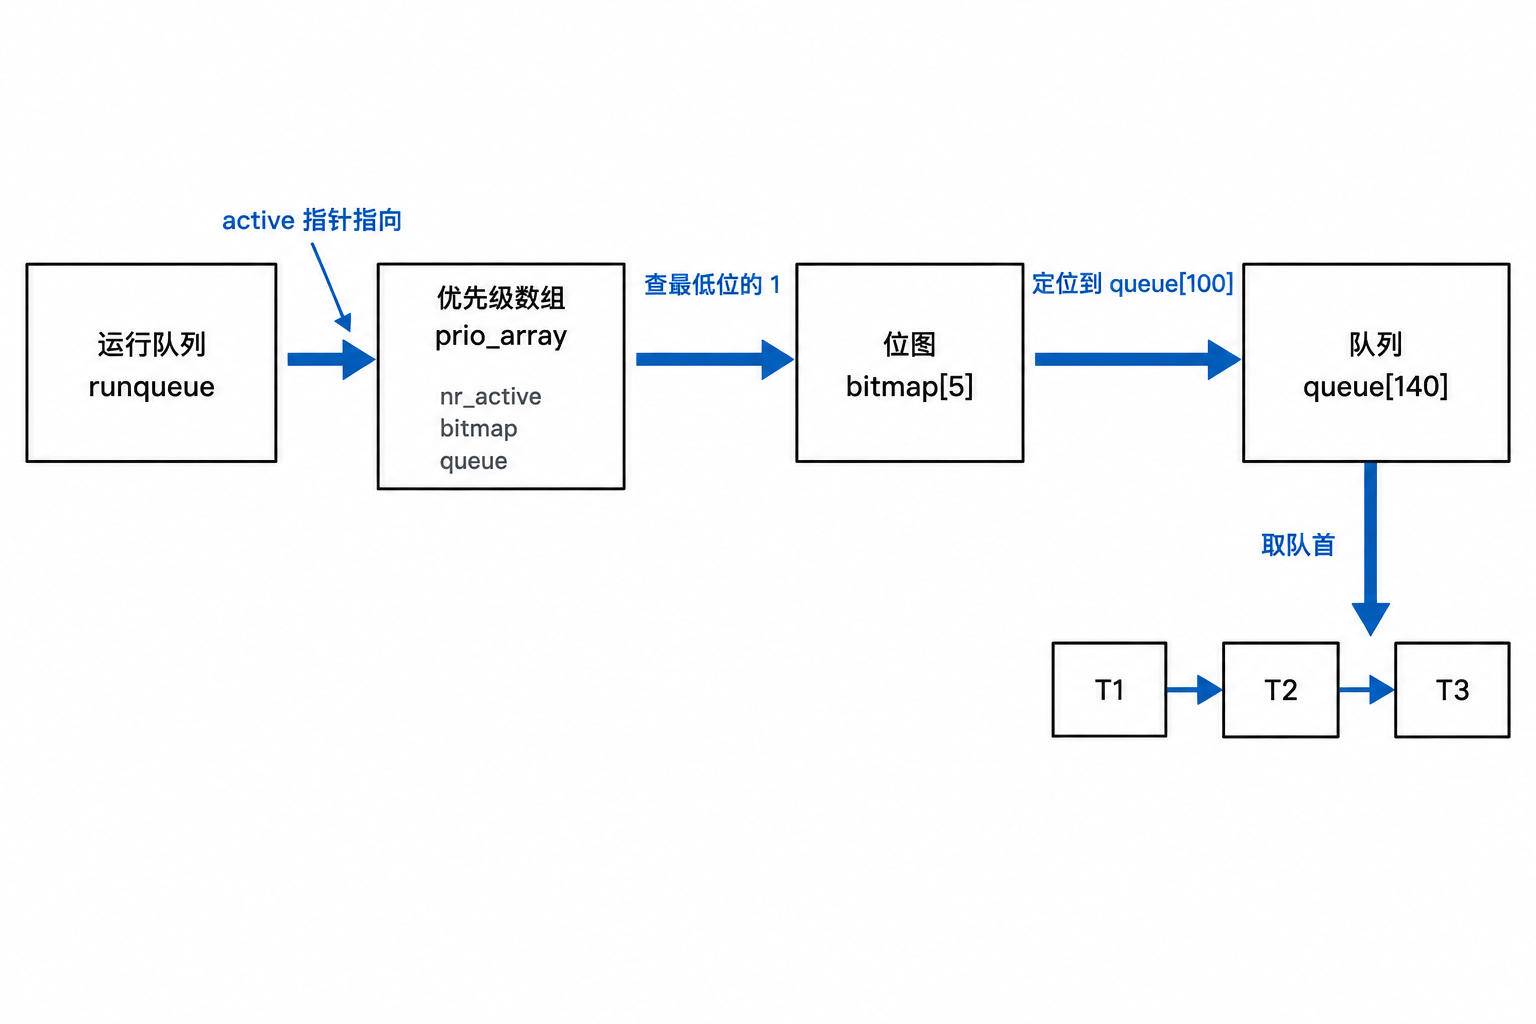
图 16 调度器找下一个任务的完整路径
十一、优先级体系:0 到 139
三件套中的下标是优先级,这个下标的取值范围是 0 到 139,一共 140 个。
图 17 优先级数轴

  0                99 │ 100            120            139
  ├──────────────────┼┼───────────────┼──────────────┤
      实时优先级        │        普通优先级(我们研究的重点)
      (0 ~ 99)        │   nice -20 → 100   (最急)
                        │   nice   0 → 120   (默认)
                        │   nice  19 → 139   (最佛系)
      ← 不做特殊说明时,只研究普通进程的调度
图 17 优先级数轴
前一半 0 到 99 留给实时任务,后一半 100 到 139 留给普通任务。实时任务的优先级是静态的,内核不会调整它;普通任务存在自己的修正空间,修正值就是 nice。
nice 的取值范围是 -20 到 19,一共 40 个值,正好对应 100 到 139 这 40 条队列。换算关系如下:
static_prio = MAX_RT_PRIO + (nice + 20); /* MAX_RT_PRIO = 100 */
nice 等于 -20 时静态优先级是 100,等于 19 时是 139。nice 越小,优先级数值越小,队列下标越小,被挑中的时间越早。
这个数组结构还有一个好处:挑选下一个任务时不需要比较,最低的非空下标对应的就是优先级最高的任务。
0 到 99 与 100 到 139 这两段的待遇并不相同。前一段留给实时任务,优先级由用户指定,内核不做调整,调度上更接近数字小者先运行;后一段是普通任务,静态优先级之外还有一层动态调整,最终排进哪条队列由动态优先级决定。两段合并在一个数组中,挑选时不必先判断任务属于哪一类,位图从最低位开始查找,实时任务天然排在普通任务前面。
同一个优先级上排着多个任务时,队列内部按照先来后到的顺序排队,新任务挂在队尾,挑选时取队首。同优先级的任务之间不会因为谁先醒来就抢到前面,先进入队列的任务先获得 CPU。
十二、时间片耗尽
接下来的问题是任务如何在队列之间移动。时间片在时钟中断中被消耗,减到 0 的那一刻,下面这一段代码被执行。
/* kernel/sched.c:scheduler_tick() 的关键片段,节选 */
if (!--p->time_slice) {                    /* 时间片减到 0 */
    dequeue_task(p, rq->active);           /* ① 从活跃数组把它摘下来 */
    set_tsk_need_resched(p);               /* ② 打标记:马上要重新调度 */
    p->prio = effective_prio(p);           /* ③ 重算动态优先级 */
    p->time_slice = task_timeslice(p);     /* ④ 重算时间片 */
    p->first_time_slice = 0;

    if (!TASK_INTERACTIVE(p) || EXPIRED_STARVING(rq))
        enqueue_task(p, rq->expired);      /* ⑤ 普通情况:进过期队列候场 */
    else
        enqueue_task(p, rq->active);       /* ⑤ 交互式任务:留在活跃队列 */
}
图 18 时间片耗尽的全部动作

   tick 来一次:p->time_slice--
        │
        ▼
   time_slice 减到 0 ?
        │是
        ▼
   ① dequeue_task:从活跃数组摘下
        │   (链表摘掉 + 位图可能清 0 + nr_active--)★ 还记得三件套吗?
        ▼
   ② 打标记 need_resched(提醒:该去调度了)
        │
        ▼
   ③ p->prio = effective_prio(p)      ← 重算动态优先级
   ④ p->time_slice = task_timeslice(p) ← 重算时间片(下轮的"粮草")
        │
        ▼
   ⑤ 进哪个队列?
        ├─ 普通进程 → enqueue_task到 expired(过期队列)
        │      (入队:挂链 + 位置位 + nr_active++)
        └─ 交互式进程 → 优待,回 active(给它"再来一轮"的机会)
图 18 时间片耗尽的全部动作
第 ① 步把任务从活跃数组上摘下,摘下的过程就是出队那三件事:链表摘掉、位图可能清 0、nr_active 减一。
第 ② 步不是切换,只是打一个标记。标记写在 thread_info 的 flags 字段里,就是第五节读到的那一位 _TIF_NEED_RESCHED。打标记与真正更换执行对象是两件事:标记告诉内核「等到可以更换的时机再更换」,而那个时机通常出现在返回用户态之前。
第 ③④ 步在任务下场的那一刻完成:内核把任务下一轮的动态优先级与时间片全部算好。这样做的目的是让后面交换指针那一步足够快,等到交换发生时,候选任务的时间片已经准备完毕,交换本身只剩下指针操作。
如果把时间片的计算挪到任务上场时进行,那么每一次从队列中取任务都要先算一遍,而挑选任务这一步在系统空闲时也会被频繁调用;放在下场时计算,计算次数正好等于任务被换下的次数,并且集中在一次调度即将结束的时刻。同一个动作放在哪个时间点执行,开销可以相差不少。
第 ⑤ 步是分岔口。普通任务进入过期队列候场,交互式任务被允许留在活跃队列中再运行一会儿。终端中等待输入的 shell 属于后者,它的睡眠时间多,每次醒来只运行一小段时间,留在活跃队列可以让它的响应更快。
这种优待必须有约束:交互式任务留在活跃队列,意味着它这一轮用完时间片之后不必重新排队,下一次仍然能够拿到 CPU,代价是活跃队列的总时间片被拉长,指针交换迟迟不发生,过期队列中的任务要多等待一段时间。如果没有约束,一批享有优待的任务长期留在活跃队列中不离开,活跃队列迟迟无法清空,过期队列中的任务就一直等不到 CPU,因此还需要防饿死闸门这一道限制。
/* 防饿死闸门:过期队列积压太久,特权暂停 */
#define EXPIRED_STARVING(rq) \
    ((rq)->expired_timestamp && \
     (jiffies - (rq)->expired_timestamp > STARVATION_LIMIT))
expired_timestamp 记录过期队列开始积压的时刻。一旦积压时间超过 STARVATION_LIMIT,所有用完时间片的任务一律进入过期队列,活跃队列被迫尽快清空,从而触发下一节要讲的指针交换。
十三、交换时机与指针互指
交换发生在调度器挑选任务之前,相关代码位于 schedule() 中。
array = rq->active;
if (unlikely(!array->nr_active)) {         /* 活跃数组空了 */
    rq->active  = rq->expired;             /* 换名牌:active 指向原过期数组 */
    rq->expired = array;                   /* 原活跃数组转为新的过期数组 */
    array = rq->active;
    rq->expired_timestamp = 0;             /* 清空积压计时器 */
    rq->best_expired_prio = MAX_PRIO;      /* 重置最高优先级记录 */
}
idx = sched_find_first_bit(array->bitmap);
queue = array->queue + idx;
next = list_entry(queue->next, task_t, run_list);
触发条件是活跃数组为空,判断依据就是 nr_active 归零。交换的动作只有两行赋值:active 改为指向原来的过期数组,expired 改为指向原来那个已经空掉的活跃数组。两个数组没有搬运任何一块内存,两条链表没有移动任何一个结点,改变的只是两个指针的指向。
交换前后指针的指向画在下面几张图中。
图 19 交换前:指针、数组、队列与任务

   runqueue(当前 CPU)
     │
     │   prio_array_t *active;   ─────────────┐
     │   prio_array_t *expired;  ───────┐     │
     │   prio_array_t arrays[2];        │     │
     │                                  │     │
     │                                  ▼     ▼
     │                        ┌──────────────────┐   ┌──────────────────┐
     │                        │   arrays[0]      │   │   arrays[1]      │
     │                        │   「房间0」       │   │   「房间1」       │
     │                        │                  │   │                  │
     │                        │ nr_active = 2    │   │ nr_active = 2    │
     │                        │ bitmap[5]        │   │ bitmap[5]        │
     │                        │ queue[140]       │   │ queue[140]       │
     │                        │   ├ queue[100] → [T1] → [T2]              │
     │                        │   └ queue[110] → [T3]                     │
     │                        │                  │   │   ├ queue[100] → [T4]   │
     │                        │                  │   │   └ queue[120] → [T5]   │
     │                        └──────────────────┘   └──────────────────┘
     │                           ↑                      ↑
     │              此时由 active 指针指向      此时由 expired 指针指向
     │                (角色:活跃队列)           (角色:过期队列)
图 19 交换前:指针、数组、队列与任务
图 20 交换后:只改了两个指针

   runqueue
     │   prio_array_t *active;   ───────────────┐
     │   prio_array_t *expired;  ───────┐       │
     │                                  │       │
     │                                  ▼       ▼
     │                        ┌──────────────────┐   ┌──────────────────┐
     │                        │   arrays[0]      │   │   arrays[1]      │
     │                        │   (房间0没动)   │   │   (房间1没动)   │
     │                        │                  │   │                  │
     │                        │ nr_active = 0    │   │ nr_active = 2    │
     │                        │ (空的,候场)    │   │ [T4] [T5]……      │
     │                        └──────────────────┘   └──────────────────┘
     │                           ↑                      ↑
     │              现在由 expired 指针指向      现在由 active 指针指向
     │                (角色:过期队列)           (角色:活跃队列)★
     │
     └─ 对比两张图:房间(数组)一个字节没动、任务一个没搬;
        变的只有两行代码:rq->active / rq->expired 两个指针的指向。
图 20 交换后:只改了两个指针
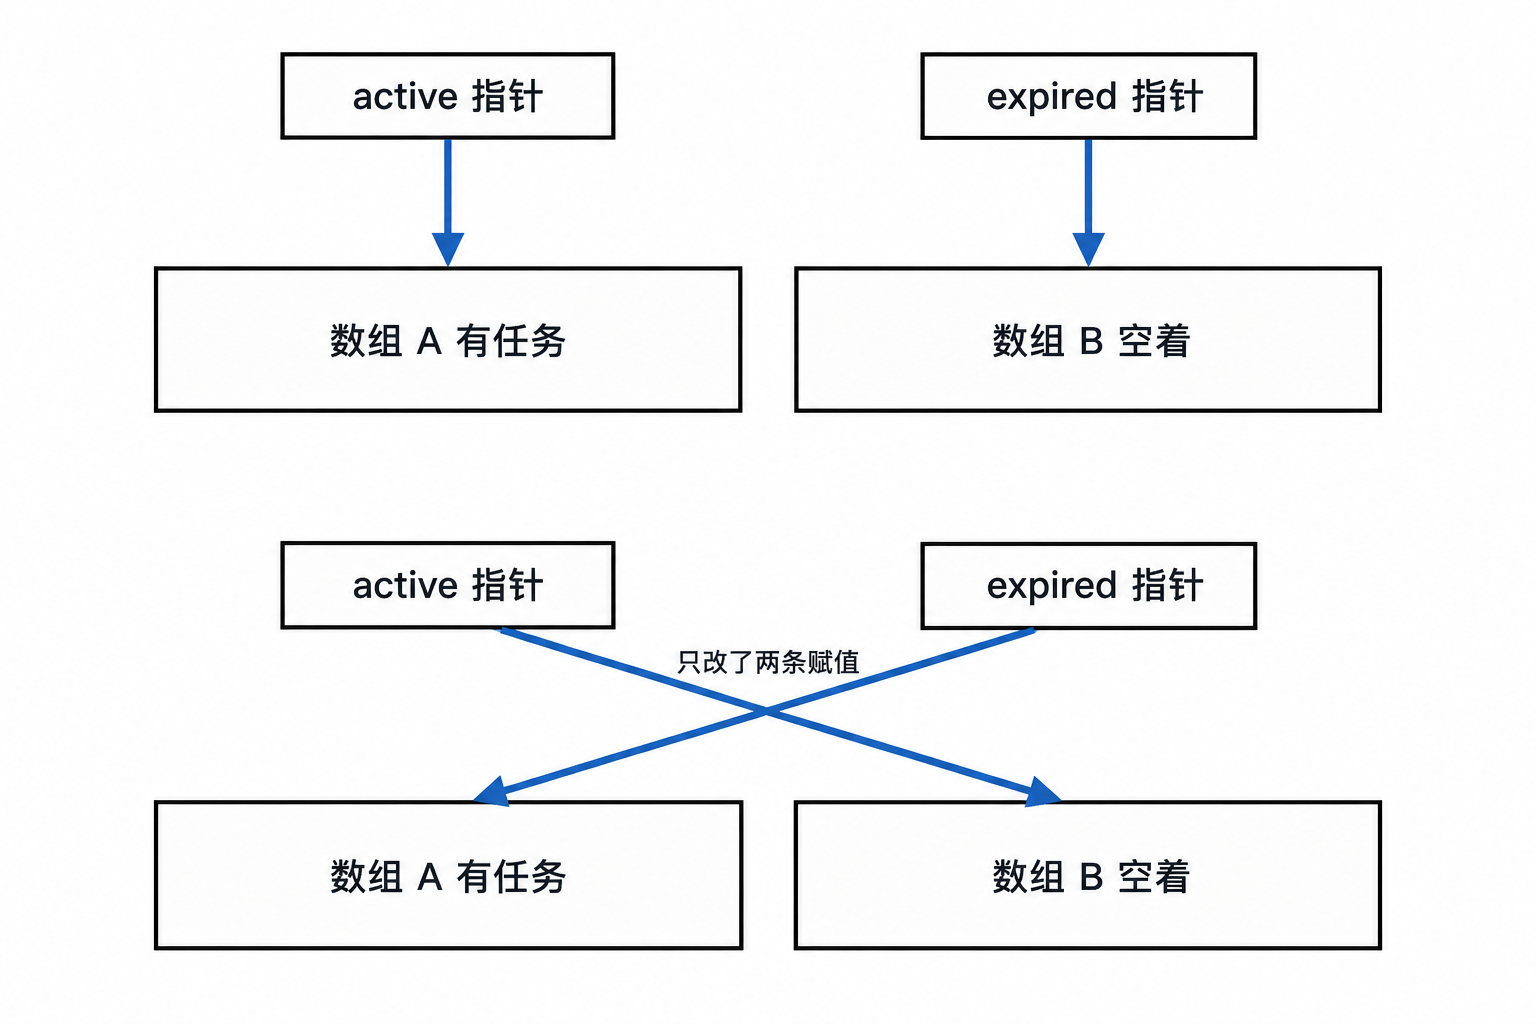
图 21 指针交换前后
对照图 19 与图 20 可以看出两点。任务一直挂在原来的链表结点上,从始至终没有被移动过,任务的运行队列成员 run_list 是指向链表中前后结点的指针,指针交换与它无关。活跃与过期是两块对等的存储区,任何时刻都有一块在服务、另一块在积压,这个做法在工程上称为双缓冲:写的一边与读的一边分开,写满了再交换角色。调度器用它来保证任务的时间片在「下场」那一刻就算好,而不是等到「上场」再算。
双缓冲这种做法同样存在约束。两块存储区必须一直存在,同一时刻只有一块在服务、另一块在积压,从利用率上看有一半的队列空间处于闲置状态。交换的时机必须由活跃队列是否清空来触发,触发得过早会把还有时间片的任务赶进过期队列,触发得过晚则过期队列中的任务等待过久,防饿死闸门正是为这个时机准备的。
还有一处容易被忽略:交换完成之后,过期队列变成空的,但它的位图与 nr_active 必须已经是干净的状态。这正是出队时那句「队列空了才清位」的意义所在,如果位图中残留着一个 1,下一轮挑选任务时会定位到一条空队列,取出来的队首是一个空指针。
十四、两个后勤字段与一个完整轮次
最后交代两个不显眼的字段。
best_expired_prio 记录过期队列中当前最高的优先级。它的价值在交换之后体现出来:交换一旦发生,原过期队列变成活跃队列,调度器马上需要知道从哪条队列开始挑选任务。有这个记录,答案立刻就可以得到;没有它,就必须把 140 条队列重新扫描一遍,省下来的 O(1) 又回到 O(n)。
expired_timestamp 记录过期队列开始积压的时刻,用途在上一节已经讲过,是防饿死闸门的判据。交换发生时它被清零,下一轮的积压从零开始计时。
图 22 O(1) 调度器的一个完整轮次

  ── 阶段一:活跃队列干活 ──────────────────────────────────────
   [任务T4跑] ──时间片到──► 摘链、算新时间片、进过期队列
   [任务T5跑] ──时间片到──► 同上
   [任务T6醒来] ──────────► 进活跃队列(带一份新时间片)
   ……(活跃队列:越跑越少 / 过期队列:越攒越多)
        │
        ▼
  ── 阶段二:最后一刻 ─────────────────────────────────────────
   活跃队列最后一个任务也下场(num_active 归零)
        │
        ▼
  ── 阶段三:交换(一条 if 的瞬间)────────────────────────────
   rq->active  ⇄  rq->expired   (两个指针互换;任务不动)
        │
        ▼
  ── 阶段四:新一批上场 ───────────────────────────────────────
   原过期队列(时间片早算好)→ 成为活跃队列
   调度器从它的 bitmap 里找最高优先级 → 取队首 → 跑!
   原活跃队列(空)→ 成为新的过期队列,开始接收下一批
        │
        ▼
   …… 循环往复(回到阶段一)
图 22 O(1) 调度器的一个完整轮次
一个完整轮次的过程如下:任务按照优先级挂进活跃数组的 140 条队列,位图标出哪几条队列中有任务,调度器用位图找到最低的非空下标,从那条队列的队首取走任务;时间片用完的任务被摘下,算好下一轮的优先级与时间片,放进过期数组;活跃数组为空之后交换两个指针,原过期数组成为新的活跃数组。整个过程中,挑选任务只查 5 个机器字,入队与出队都是常数次操作,时间片的计算在任务下场时完成,2.6 所说的调度开销与任务数量无关指的正是这一点。
十五、nice 与它的两次映射
nice 是普通进程身上唯一一个由用户直接设置的调度参数。它的取值是 -20 到 19,一共 40 个档次,数值越小表示越优先,默认值是 0。这个名称来自早期 Unix 的多人分时场景:一台机器同时坐着好几个人,谁把自己的任务往数值大的方向调,谁就是在把 CPU 时间让给别人,因此 nice 描述的是对同机用户的客气程度,与内核对任务的评价没有关系。
权限规则与这层含义配套。普通进程只能把自己的 nice 往大调,也就是主动降低优先级;只有 root 以及带有 CAP_SYS_NICE 能力的程序才能把它调小到负值。这条限制的目的很直接,如果任何进程都能把自己调到 -20,这个旋钮对其他人就不再有约束力。可用的接口分两层,命令行上有 nice 与 renice 两个命令,前者在启动进程时指定 nice 值,后者修改一个已经运行起来的进程;编程接口是 setpriority 与 getpriority 这一对函数。
在终端里对一个正在运行的进程改 nice 值,前后各看一次状态:
# 所属目录:/home/cocatrice/lab10sched
  PID  NI PRI PSR COMMAND
 4976   0  19   0 hog
4976 (process ID) old priority 0, new priority 10
  PID  NI PRI PSR COMMAND
 4976  10   9   1 hog
  PID  NI PRI PSR COMMAND
 4982   5  14   0 hog
三行输出的含义各不相同。NI 列是 nice 值本身,中间那一行是 renice 命令的回应,说明这个进程的优先级从 0 改成了 10。PRI 列是 ps 折算出来的优先级显示值,三行的数值分别是 19、14、9,与同一行的 nice 值相加都等于 19,也就是说在这一段区间里 PRI 的方向与 nice 相反,数值越大表示越优先。PSR 列记录进程当前在哪个核上,改过 nice 的那个进程从 CPU0 换到了 CPU1,它没有绑定核,被迁移到另一个核上属于正常现象。
编程接口的行为在同一台机器上量过一遍。程序把三段调用连在一起:先读自己的 nice,再调大,然后调小,最后拿一个不存在的进程号去查一次。
# 文件:/home/cocatrice/lab10sched/prio.c
#include <stdio.h>
#include <errno.h>
#include <string.h>
#include <unistd.h>
#include <sys/resource.h>

int main(void)
{
    int n;

    errno = 0;
    n = getpriority(PRIO_PROCESS, 0);
    printf("自己当前的 nice = %d,errno = %d\n", n, errno);

    if (setpriority(PRIO_PROCESS, 0, 5) == -1) {
        printf("setpriority 到 5 失败:%s\n", strerror(errno));
    } else {
        printf("setpriority 到 5 成功,现在 nice = %d\n", getpriority(PRIO_PROCESS, 0));
    }

    if (setpriority(PRIO_PROCESS, 0, -5) == -1) {
        printf("setpriority 到 -5 失败:%s (errno = %d)\n", strerror(errno), errno);
    } else {
        printf("setpriority 到 -5 成功,现在 nice = %d\n", getpriority(PRIO_PROCESS, 0));
    }

    errno = 0;
    n = getpriority(PRIO_PROCESS, 999999);
    printf("查一个不存在的进程:返回值 %d,errno = %d (%s)\n", n, errno, strerror(errno));
    return 0;
}
# 所属目录:/home/cocatrice/lab10sched
自己当前的 nice = 0,errno = 0
setpriority 到 5 成功,现在 nice = 5
setpriority 到 -5 失败:Permission denied (errno = 13)
查一个不存在的进程:返回值 -1,errno = 3 (No such process)
把 nice 从 0 调到 5 成功,从 5 调到 -5 失败,errno 是 13,也就是 EPERM。这一对结果把前面那条权限规则落在了实处:调大 nice 是进程对自己的处置,任何时候都允许;调小 nice 会挤占同机其他任务的份额,只有特权进程才被放行。最后一行还牵出一个接口上的细节,getpriority 在出错时同样返回 -1,调用方无法只凭返回值判断成功与否,必须在调用之前把 errno 清零,调用之后再检查它,程序开头那句 errno = 0 就是为这一步准备的。
nice 本身只是用户侧的刻度,内核内部使用的是第十一节给出的那个 0 到 139 的优先级空间,两者之间的映射是一条直线。图 23 把刻度与公式放在一处。
图 23 nice 与优先级的对应

   nice:  -20  -10    0     10    19
           │    │     │     │     │
           ▼    ▼     ▼     ▼     ▼
   prio:  100  110   120   130   139
   (0~99 留给实时任务,普通进程从 100 起步)

   核心公式:
       优先级 = 120 + nice          (nice = 优先级 - 120)
图 23 nice 与优先级的对应
换算关系是静态优先级(static priority)等于 120 加 nice,反过来就是 nice 等于静态优先级减 120。nice 取 -20 时落在 100,正好是普通进程区间的下界;取 19 时落在 139,是区间的上界。这 40 个取值与 100 到 139 这 40 条队列一一对应,nice 每减一,队列下标减一,被位图选中的次序就往前提一位。
这个优先级之所以叫静态,原因在于它的变化条件很有限:进程创建时从父进程继承,此后只有显式调用 setpriority 或者执行 renice 才会改变。调度器平时排队所用的那个值叫 prio,它是静态优先级经过动态调整之后的结果,与静态优先级不是一回事。静态优先级是基准线,动态调整在它上面做加减,这一层留到下一节展开;这里要看的是一份时间片是怎么从静态优先级算出来的。
O(1) 调度器里的时间片不是固定值。每个任务每轮能连续运行多久,由 task_timeslice 按静态优先级算出来,函数的形状大致如下。
/* 2.6 内核里时间片的计算,函数形状示意,区间常数随小版本调整 */
static unsigned int task_timeslice(task_t *p)
{
    if (p->static_prio < NICE_TO_PRIO(0))
        return SCALE(...);      /* nice 为负:映射到区间的上半段 */
    else
        return SCALE(...);      /* nice 为正:映射到区间的下半段 */
}
插值的做法是以 nice 0 对应的那个静态优先级为分界,把 100 到 119 与 121 到 139 这两段分别线性映射到时间片区间的上下两半。映射的斜率是正的,静态优先级数值越小,算出来的时间片越长。区间的两端各有一个常数兜底,最短不小于 MIN_TIMESLICE,最长不超过 MAX_TIMESLICE。上限防止一个高优先级任务一次运行过久,把同队的其他任务挤到一边;下限防止一个低优先级任务刚刚拿到 CPU 就被时钟中断赶下去,切换开销在它那一轮里的占比会因此高得离谱。
需要先说清一条界线。这台机器跑的是 3.10 内核,调度器是 CFS,task_timeslice 这个函数在 3.10 里已经不存在,上面这段只能按源码来讲,本机跑不出 O(1) 时代的时间片。下面那些份额数字来自本机的 CFS,它们证明的是权重与 CPU 份额之间的对应关系,不能当成 O(1) 时间片的实测结果。
CFS 把发时间片这一步换掉了。时间片不再由静态优先级线性插值得到,而是由权重在运行队列总权重里占多大比例决定。内核给每个可运行任务划出一个周期,也就是目标延迟(sched_latency_ns),要求每个任务在这段时间里至少被轮到一次;某个任务能连续运行多久,等于周期乘以它的权重占队列总权重的比例。可运行任务的数量超过一个固定的门槛之后,周期本身会按最小粒度(sched_min_granularity_ns)乘以任务数增长,这样任务多的时候单个任务分到的时间不至于被压到切换开销以下。本机这几个参数的取值可以直接读出来。
# 所属目录:/home/cocatrice/lab10sched
sched_latency_ns = 12000000
sched_min_granularity_ns = 10000000
sched_wakeup_granularity_ns = 15000000
sched_nr_migrate = 32
sched_migration_cost_ns = 500000
/proc/sched_debug 导出的是同一组参数,单位换算成毫秒,末尾几位小数来自打印格式。
sysctl_sched
  .sysctl_sched_latency                    : 12.000000
  .sysctl_sched_min_granularity            : 10.000000
  .sysctl_sched_wakeup_granularity         : 15.000000
  .sysctl_sched_child_runs_first           : 0
  .sysctl_sched_features                   : 40571
  .sysctl_sched_tunable_scaling            : 1 (logaritmic)
最后一行括号里的那个拼写来自内核自己的输出,不是抄错了。
要把周期折算成每个任务的份额,还需要一张把 nice 换算成权重的常量表。本机用到的四个取值如下。
| nice | 权重 | 与 nice 0 的比值 |
|---|---|---|
| 0 | 1024 | 1 |
| 5 | 335 | 3.06 比 1 |
| 10 | 110 | 9.31 比 1 |
| 19 | 15 | 68.3 比 1 |
相邻两个档次的权重相差大约 1.25 倍,把 1024 除以 335 再开五次方,结果就在 1.25 附近。一路从 0 调到 19 是十九次连乘,累积出来的差距是 68 倍。CPU 份额跟着权重走,因此调 nice 的效果在数值小的地方并不显眼,越往后每一档的影响越大。
份额的测量方法是这样的:三个纯计算进程用 taskset 绑在 CPU0 上,nice 分别设为 0、10、19,同时运行 10 秒,取每个进程在这段时间里累计的时钟滴答数。时钟滴答来自 /proc/PID/stat 的 utime 与 stime 两个字段之和,是内核记给进程的 CPU 时间。三个进程跑的是同一个程序。
# 文件:/home/cocatrice/lab10sched/hog.c
#include <stdio.h>
#include <unistd.h>
#include <sys/resource.h>

int main(void)
{
    volatile unsigned long x = 0;

    printf("pid %d, nice %d\n", (int)getpid(), (int)getpriority(PRIO_PROCESS, 0));
    fflush(stdout);
    while (1) {
        x++;
    }
    return 0;
}
循环变量加了 volatile,编译器无法把这个自增循环优化掉,程序才会一直占用 CPU。
第一组数字是三个进程分别以 nice 0、10、19 运行十秒的结果。
# 所属目录:/home/cocatrice/lab10sched
nice 0  获得 891 个时钟滴答
nice 10 获得 96 个时钟滴答
nice 19 获得 13 个时钟滴答
三个数字相加是 1000,各自的份额是 89.1%、9.6%、1.3%。三个进程的权重是 1024、110、15,相加是 1149,各自的占比同样是 89.1%、9.6%、1.3%。两边的比例完全重合。三者的权重比是 68.3 比 7.3 比 1,实测的时钟滴答比是 68.5 比 7.4 比 1,差在测量窗口的取整上。
| 进程 | nice | 权重 | 时钟滴答 | 实测份额 | 权重占比 |
|---|---|---|---|---|---|
| 第一个 | 0 | 1024 | 891 | 89.1% | 89.1% |
| 第二个 | 10 | 110 | 96 | 9.6% | 9.6% |
| 第三个 | 19 | 15 | 13 | 1.3% | 1.3% |
第二组把差距拉小一些,让 nice 0 与 nice 5 的两个进程同核竞争十秒。
# 所属目录:/home/cocatrice/lab10sched
nice 0 获得 754 个时钟滴答
nice 5 获得 247 个时钟滴答
两个进程的权重是 1024 与 335,比值是 3.06;实测的时钟滴答是 754 与 247,比值是 3.05。两个进程平分时各自的份额是 50%,权重拉开之后 nice 5 那一方拿到的是 24.7%。把第一组与第二组放在一起看,三个进程平分时各自的份额是 33.3%,nice 10 只拿到 9.6%,nice 19 只拿到 1.3%,与权重表推算出来的比例一一对应。
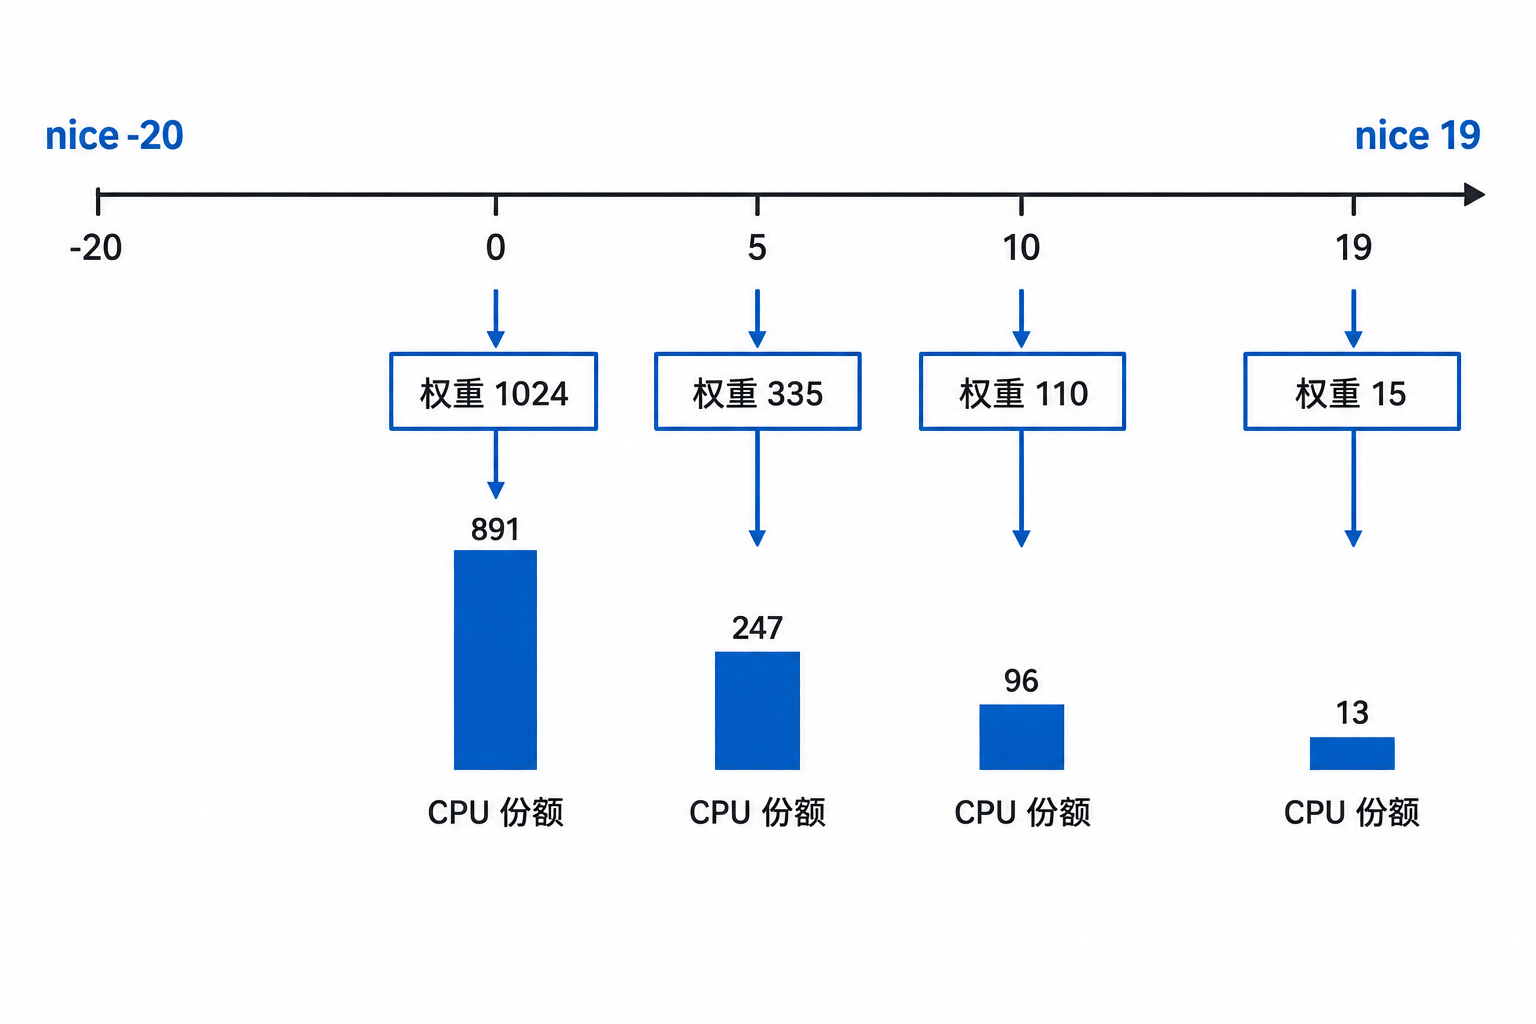
图 24 nice 与 CPU 份额的对应关系
权重表是静态的,进程的份额也是静态的,两者之间隔着的是运行队列上的一次次挑选。至于这个挑选按什么顺序发生、份额又在哪一步被固定下来,是第十七节的事。
十六、动态优先级
静态优先级只反映用户设定的那一个数值,反映不了进程的实际行为。一个终端里等待输入的进程和一个后台编译进程可以有相同的 nice 值,两者的行为差别却很大:前者大部分时间在睡眠,每次醒来只运行很短的一段时间;后者只要 CPU 有空就一直运行下去。如果只按静态优先级排队,两者的待遇完全一样,用户敲下的一个键要等到后台编译跑完它那一轮才可能被处理。
O(1) 调度器为此在静态优先级之上加了一层修正,修正的依据是进程过去的睡眠表现。这条思路并不新,第七节讲过的 0.11 补时间片的写法里就有它的朴素版本,那时候照顾交互式任务靠的是把没用完的剩余时间片攒下来;到了 2.6,照顾的方式变成了给睡眠多的进程发一笔奖金。两代照顾方式落在不同的位置上:0.11 那句 counter = counter/2 + priority 加的是下一轮的配额,睡得多就多给时间;2.6 的 bonus 动的是排队的档位,睡得多就往前排。前者影响一次能跑多久,后者影响要等多久才轮到自己。
记录睡眠表现的字段叫 sleep_avg,也就是睡眠平均值(sleep average)。它的记账规则是睡的时候增长、跑的时候衰减:进程进入睡眠,这个值往上走,但有一个封顶;进程占用 CPU,这个值按固定的步长缓慢回落。负责更新它的是 recalc_task_prio(),进程睡下和醒来时都会经过这个函数。sleep_avg 衡量的是最近一段时间里睡眠占多大比例,不是一个从开机累计到现在的总量,进程的行为方式改变之后,这个值会跟着改变。
奖金由 sleep_avg 换算而来,换算与叠加都写在下面这段源码里。
/* 2.6 内核里动态优先级的计算,节选 */
#define MAX_BONUS 10

#define CURRENT_BONUS(p) \
    (NS_TO_JIFFIES((p)->sleep_avg) * MAX_BONUS / MAX_SLEEP_AVG)

static int effective_prio(task_t *p)
{
    int bonus, prio;

    bonus = CURRENT_BONUS(p) - MAX_BONUS / 2;       /* 换算成 -5 ~ +5 */
    prio  = p->static_prio - bonus;                 /* 用奖金抵扣优先级数值 */
    /* 再做一手边界保护:别越进实时区,也别超出数组上界 */
    if (prio < MAX_RT_PRIO)  prio = MAX_RT_PRIO;
    if (prio > MAX_PRIO-1)   prio = MAX_PRIO-1;
    return prio;
}
CURRENT_BONUS 这个宏做了三件事。sleep_avg 以纳秒为单位存放,先用 NS_TO_JIFFIES 换算成时钟滴答;乘以 MAX_BONUS 再除以 MAX_SLEEP_AVG,是把 0 到 MAX_SLEEP_AVG 这一段线性映射到 0 到 10;最后减掉 MAX_BONUS 的一半,结果落在 -5 到 +5 之间。一整个记账周期都睡着的进程拿到 +5,一点都不睡的进程拿到 -5。MAX_SLEEP_AVG 既是换算的分母,也是 sleep_avg 增长的上限,攒到这个数值之后不再往上涨,换算出来的奖金就封在 +5。封顶的意义在于防止一个睡眠时间很长的进程无限积累奖金,把自己的优先级永久固定在最前面,让同队的其他任务没有插进来的机会。
奖金的跨度是 10,正好覆盖 40 个 nice 档次里的 10 档。两个 nice 值相同的进程,一个长期睡眠,一个一直占用 CPU,落到队列上可以差出 10 个档次,这正是这套机制想要的差别:它把用户能直接感知到的延迟放在前面,把感知不到的后台计算往后放。公平在这里是按体感定义的,不是按份额定义的,代价是负载较重的时候,后台批处理任务被推后的幅度会明显超过它在静态优先级下应得的待遇。
叠加的方式值得单独看一眼。effective_prio 做的是减法而不是加法:bonus 为正时优先级数值变小,任务排进更靠前的队列;bonus 为负时优先级数值变大,任务排到后面去。奖金的正负号与优先级的方向刚好相反,读这段代码时容易看反。两个 if 是边界保护,100 是普通进程区间的下界,再往前就是实时任务的地盘,一个睡得很足的进程不会被奖励进实时区;139 是优先级数组的上界,无论怎么调整都不会越出 queue[140] 的下标范围。effective_prio 的结果直接当作队列下标使用,bonus 为 +5 时下标减 5,为 -5 时下标加 5,与静态优先级处在同一套刻度上,两者可以直接加减,不需要额外的换算。
把睡眠、衰减与换算连成一条链,形状如下。
图 25 动态优先级的机制链

   睡眠时:sleep_avg 越攒越多(但有封顶)
        │
        ▼
   sleep_avg  ──换算──►  bonus ∈ [-5, +5]
        ▲                  │
        │运行中缓慢衰减      ▼
        │            effective_prio = static_prio - bonus
        │                  │
        │                  ├─ bonus 为正(睡得多)→ 有效优先级变小 → 排前面的队
        └───────────────►  └─ bonus 为负(CPU 密集型)→ 有效优先级变大 → 排后面的队

   另外:bonus 达到门槛的进程会被打上 TASK_INTERACTIVE 标记
        → 享有第十二节讲过的特权:时间片用完仍然留在活跃队列
图 25 动态优先级的机制链
图里最后那两行是奖金的附加效果。bonus 够高的进程会被打上 TASK_INTERACTIVE 标记,这个标记只在第十二节那段代码的最后一个分支里被读到。没有标记的任务在时间片耗尽之后进入过期队列等待,带标记的任务被允许留在活跃队列,等于多拿一轮时间片。终端里等待输入的 shell 就是前者照顾的对象,它每一次醒来只运行很短的时间,被留在活跃队列可以让响应更快。
奖金真正兑现的时刻也在唤醒路径上:一个睡着的进程被唤醒时,recalc_task_prio() 先把这一觉的时间记进 sleep_avg,effective_prio 随即算出新的排队档位,任务带着一份时间片挂进对应的队列,第十四节那张轮次图里的 T6 走的就是这条路。排得越靠前,它下一次被挑中之前的等待时间越短。需要分清的是,bonus 改的是排队的位置,与下一轮能跑多久无关,时间片仍然按静态优先级计算,这件事在下一节收束。
这项特权必须有约束。带标记的任务留在活跃队列,意味着活跃队列被清空的时间被拉长,指针交换推迟,过期队列里的任务要多等一段时间。约束来自第十四节讲过的 expired_timestamp:过期队列开始积压之后这个时间戳开始计时,超过限定值以后,所有用完时间片的任务一律进过期队列,特权暂时停止,活跃队列被强制清空。
到这里为止的内容在本机都跑不出来。这台机器是 3.10 内核,调度器是 CFS,sleep_avg、bonus、TASK_INTERACTIVE 这套东西在 CFS 里已经整体删除。在内核导出的调度调试信息里搜索这三个名字,命中数是零。
# 所属目录:/home/cocatrice/lab10sched
grep -c 'sleep_avg|TASK_INTERACTIVE|expired_timestamp' /proc/sched_debug
0
3.10 头文件里的调度实体(scheduling entity,sched_entity)只剩下面这些成员。
/* include/linux/sched.h,3.10.0 内核,第 1218 行起,节选 */
struct sched_entity {
	struct load_weight	load;		/* for load-balancing */
	struct rb_node		run_node;
	struct list_head	group_node;
	unsigned int		on_rq;

	u64			exec_start;
	u64			sum_exec_runtime;
	u64			vruntime;
	u64			prev_sum_exec_runtime;

	u64			nr_migrations;
	/* ... */
};
这份结构里只有权重与几种时间记账,与睡眠时长有关的打分字段一个也没有。一个任务睡得多不多,内核不再为它单独留一个字段,也就谈不上按睡眠表现发奖金。所以动态优先级这一段只能按源码来读,本机没有对应的实测数据,本章里凡是带 bonus 的结论都不适合搬到这台机器上验证。
这套启发式最后被换掉,原因有三处出在它自己的设计上。
参数太多是最直接的一处。sleep_avg 的增长上限、运行时的衰减步长、bonus 的换算比例、TASK_INTERACTIVE 的门槛、防饿死闸门的时限,这些常数都需要人来定,而它们的效果彼此牵连。工作负载换一种形态之后,原来调好的一组参数往往不再合适,服务器与桌面这两类场景对同一组参数的评价甚至相反:服务器嫌它偏袒交互式任务,桌面嫌它偏袒吞吐。
统计量还有一个绕不开的弱点,它可以被伪装。判定依据既然是睡眠的多少,那么一个刻意在运行中间插入短睡眠的进程就能把 sleep_avg 刷上去,从而拿到更高的优先级。内核在这里判断的是行为统计,不是任务的真实意图,凡是靠统计量做出的判断都会遇到这类问题,而调度的结果直接体现为份额,伪装的收益足够大。
CFS 之所以能把这套东西整体删掉,原因在于它换了一个衡量标准:不再判断一个任务是不是交互式,只看它已经拿到了多少 CPU 时间。睡得多的任务消耗得少,虚拟时间落在后面,下一次自然先被挑中,照顾交互式的效果由记账方式本身给出,不再需要额外一条规则和一组阈值。
剩下的一处与公平的定义有关。O(1) 调度器按时间片分配 CPU,多轮累计之后大体按 nice 拉开,某一个短窗口里谁多谁少却很不讲究。对延迟敏感的任务,等待时间可能被拉长到几十毫秒这个量级,而调度器里没有任何一处能给出一个上限承诺。这套机制照顾的是体感上的平均值,不是每一个具体时刻的公平。
CFS 的选择是把整套打分系统拿掉:不再猜谁是交互式,改为给每个任务记一本消耗账,谁欠得多就先补谁。nice 在这个新方案里仍然存在,作用的方式与 O(1) 时代不同,这件事在下一节收尾。
十七、nice 落在过期队列
前面两节分别讲了 nice 的取值与它的两次换算,以及动态优先级在排队顺序上的修正。把这几件事按时间顺序排开,nice 真正起作用的位置只有一个。
图 26 nice 值发挥作用的时间轴

  ① 你设置 nice(-20 ~ 19)
        │
        ▼
  ② 内核换算:static_prio = 120 + nice      (基准线定下)
        │
        ▼
  ③ 平时排队:effective_prio = static_prio - bonus
        │        (bonus 由睡觉表现决定)
        │
        ▼
  ④ 轮到它跑:按时间片跑 ──► 时间片耗尽
        │
        ▼
  ⑤ 关键时刻:进过期队列的那一瞬间
        │    内核调用 p->time_slice = task_timeslice(p)
        │    → 用 static_prio(也就是 nice 的换算结果)算好下一轮的时间片
        │    → 它带着这份时间片在过期队列里等待
        ▼
  ⑥ 指针交换:它进入新的活跃队列
        │
        ▼
  ⑦ 下一轮开跑:运行时长就是按 nice 算出来的那份时间片
        │
        └──► 循环往复:多轮累计 → CPU 时间的分配比例由 nice 决定
图 26 nice 值发挥作用的时间轴
时间轴上的前四步都已经讲过。① 是用户设定的值,② 是第一次映射,把 nice 换成静态优先级,③ 是动态优先级在排队顺序上的修正,④ 是任务拿到 CPU 之后按时间片运行。需要停下来看的是第 ⑤ 步。
第 ⑤ 步的动作写在第十二节那段代码里。时间片减到零之后,内核先调用 effective_prio 重算动态优先级,紧接着调用 task_timeslice 重算时间片,两个调用挨在一起,读进去的参数却不是同一个。effective_prio 读的是静态优先级与 bonus,结果写进 p->prio,用途是决定这个任务下一轮排进哪条队列;task_timeslice 读的是静态优先级,结果写进 p->time_slice,用途是决定这个任务下一轮能连续运行多久。bonus 不参与时间片的计算,第十六节讲的这笔奖金,只影响排队的位置,不影响每轮领到的配额。
第 ⑤ 步也是 nice 在整个调度循环里唯一一次被翻出来算账的时刻。任务的 nice 值设定之后就不再变化,它对时间片的影响却要等到任务下场进过期队列的那一瞬间才被兑现。结果算出来之后,任务带着下一轮的时间片在过期队列里等待,指针交换发生时它进入新的活跃队列,等到再次被挑中上场,能跑多久在一轮开始之前就已经确定了。
把这条链收成一句结论:nice 的作用点落在进程进入过期队列的那一刻,它决定的是下一轮的时间片长度,多轮累计之后,这个长度就是 CPU 时间的分配比例。
这句话能站住,靠的是三件事实。时间片的重新计算只有这一个触发点,任务在场上的时候时间片只减不增,重新发放一律发生在下场的那一瞬间,中途醒来入队也不会拿到新的一份。时间片就是每轮的配额,一个任务在一轮里能连续运行多久,直接等于它在那一轮里能从 CPU 拿到多少时间。活跃队列清空之后的指针交换保证了轮转,所有任务带着各自的时间片重新上场,一轮接着一轮,每轮配额上的差别就这样累加成了长期比例上的差别。用一个不带数字的例子走一遍:两个 nice 不同的纯计算进程挂在同一条运行队列上,第一轮里各自跑完自己那份时间片,然后一起进过期队列;指针交换之后它们同时上场,时间片长的那一个在这一轮里运行得更久。轮数增加之后,两者累计运行时间的比值收敛到时间片的比值,中间每一轮的先后顺序如何波动都不影响这个结果。
三个机制在这条链上的分工可以列成一张表。
| 机制 | 决定什么 | 作用的位置 |
|---|---|---|
| nice(静态优先级) | 排队档位的基准,以及每轮时间片的长度 | 换算成基准档位,并在进入过期队列时参与时间片的计算 |
| 动态优先级(bonus) | 在基准档位上做上下 5 档的偏移,也就是上场的顺序 | 每次下场重算 p->prio,以及唤醒入队时 |
| 交互式特权(TASK_INTERACTIVE) | 时间片用完之后还能不能留在活跃队列,也就是响应延迟 | 时间片耗尽之后的分岔口 |
三者各管一段:nice 管配额,动态优先级管顺序,交互式特权管边缘情况。配额决定长期的份额,顺序决定短期谁先谁后,特权决定极端情况下一个进程会不会被卡住,这三件事互相独立,改动其中一个不会直接改到另外两个。档位与配额的关系还需要补一句:静态优先级既是队列下标的基准,又是时间片计算的输入,同一个数值出现在两个地方,bonus 只在前一个地方做偏移。因此一个进程排得靠前,并不代表它这一轮能跑得更久。
本机跑的 CFS 里没有过期队列,也没有任务下场重算配额这一步,上面那条结论不能按字面搬过来。结论的内核没有变,nice 仍然是分配比例的决定者,变的只是这本账记在哪一步。
CFS 给每个调度实体记一个虚拟运行时间(vruntime),记账的方式按权重折算:任务每运行一段时间,虚拟时间增加的量等于实际运行时间乘以 nice 0 的权重 1024,再除以这个任务自己的权重。权重大的任务,虚拟时间走得慢;权重小的任务,同样长的一段实际运行时间会让虚拟时间涨得更快。挑下一个任务时,调度器取红黑树(red-black tree)上 vruntime 最小的那个,也就是账欠得最多的那个。权重在 CFS 里直接由 nice 换算而来,中间不再有 bonus 这一层。
两代调度器的结算方式也不一样:O(1) 调度器是批量结算,配额在任务下场的那一刻一次性算好并写进 time_slice;CFS 是连续记账,每运行一小段时间就把这段实际时间按权重折算一次,累加进 vruntime。前者的结算动作只发生在一处,后者的结算动作分散在每一次时钟记账里,结果落在同一个比例上。
把两个进程放在同一个核上竞争,运行一段时间之后读它们各自的调度数据:
# 所属目录:/home/cocatrice/lab10sched
--- nice 0 ---
se.vruntime                                  :     182490385.714378
se.sum_exec_runtime                          :          5417.116061
se.load.weight                               :                 1024
--- nice 10 ---
se.vruntime                                  :     182490403.188549
se.sum_exec_runtime                          :           584.470989
se.load.weight                               :                  110
两组数据合起来读,结论很直接。nice 0 的权重是 1024,nice 10 的权重是 110,相加是 1134,占比是 90.3% 与 9.7%;实测的实际运行时间是 5417.116061 与 584.470989,相加是 6001.58705,占比同样是 90.3% 与 9.7%。权重占比与实测份额在这里是同一个数。
从第十六节那份调度实体里还能看出另一件事:结构体里有 load.weight、vruntime、sum_exec_runtime 三个字段,正好是 CFS 记账需要的三项,却没有一个字段与每轮配额对应。O(1) 时代的 time_slice 在这份结构里根本没有位置,配额这个概念在 CFS 里不再单独存放,它是每次记账时现算出来的。
再看虚拟时间。nice 0 那一段运行时间按 1 倍计入虚拟时间,增量就是 5417.116061;nice 10 那一段要按 1024 除以 110 这个系数放大之后计入,584.470989 乘上去约等于 5440。两者的虚拟时间增量因此落在几乎相同的位置,这也是两条 vruntime 如此接近的原因。vruntime 的绝对值由运行队列建立以来的历史累积而成,两条 vruntime 之间的差值才是这里要看的量,两次读取不在同一瞬间,折算值与实测差值之间会有这个量级的出入。
CFS 里 nice 的作用方式至此就清楚了。任务排队的位置由 vruntime 决定,vruntime 的增长速度由权重决定,权重由 nice 换算而来。nice 越小的任务,虚拟时间涨得越慢,在红黑树上的位置越靠左,被挑中的次数越多,最终占到的 CPU 比例越大。O(1) 时代是在任务下场的那一刻算好一份时间片,CFS 是在每一次记账时按权重折算一段虚拟时间,两套实现把同一件事放在了不同的位置,结果落在同一个比例上。
把这条分工放到唤醒路径上看会更清楚:一个进程睡下去的时候,它手里的时间片是上一次下场时算好的那一份,睡着期间这个数值不发生变化;被唤醒之后,优先级变高让它排进更靠前的队列,能跑多久却仍然是那一份旧配额。排队位置的修正买不到新的一份时间。
这里还有一个容易混淆的地方。O(1) 时代的时间片是一个绝对时长,输入只有静态优先级,同一个 nice 值在任何负载下算出来的时间片都一样。CFS 里的一次运行时长先是一个比例,要乘上周期才变成绝对时长,而周期会随可运行任务的数量变化。同一个 nice 值在只有两个可运行任务的队列上与在有十几个任务的队列上,单次运行的绝对时长并不相同,占到的比例却相同。nice 在两代调度器里决定的都是比例,绝对时长由别的参数负责。
两代调度器量出来的份额是同一个形状。第十五节那三组数字里,nice 0、10、19 拿到的份额是 89.1%、9.6%、1.3%,与 1024、110、15 这三个权重在总量中的占比一致;本节的两个进程拿到的份额也正好落在权重比例上。nice 这个从早期 Unix 就存在的旋钮,在两套差别很大的实现里指向同一件事:每个进程能分到多少 CPU 时间。
十八、单核与多核
单核机器上的调度是一个闭环。整台机器只有一条运行队列,第九节讲过的那个结构就是全部家当,挑人、入队、出队都在这一条队列上完成,队列里没有可运行的任务时切到 idle 任务上空转。这条路径上不存在需要协商的对象,也不存在第二个可以比较的样本,忙与闲只是这条队列自己的状态。负载因子这类字段在单核机器上没有用武之地,它被设计出来是为了在多个 CPU 之间做比较。
图 27 单核:一个 runqueue 的闭环

   ┌─────────────────────────────────────────────────┐
   │                                                 │
   │   runqueue(唯一一个)                           │
   │    ├ active 数组:这一批                       │
   │    └ expired 数组:下一批                      │
   │                                                 │
   │   调度循环:                                    │
   │    挑人(bitmap 找最高优先级)→ 上 CPU 跑       │
   │         ↑                            │          │
   │         │      时间片到 / 睡觉 / 醒来  │          │
   │         └────────────────────────────┘          │
   └─────────────────────────────────────────────────┘

   队列只有一条,没有需要协商的对象:
   - 挑谁:在自己这条队列里挑,用的就是第九节到第十四节的那套机制。
   - 队列空了:切到 idle 任务空转。
   - 负载:只有自己这一摊,没有第二个样本可以比较。
图 27 单核:一个 runqueue 的闭环
图里画的是 O(1) 调度器的运行队列形态。本机跑的是 CFS,队列里装的东西换成了按 vruntime 排序的红黑树,每个 CPU 一条队列、队列之间靠均衡来协调,这两层结构没有变,第二十节会把 CFS 的样子补上。
单核这套闭环有一个前提:整台机器只有一份执行资源,谁在运行谁就占住了全部的计算能力,调度要解决的问题只有排队。多核打破了这个前提,两个任务可以在两个核上真正同时运行,调度器要处理的事情从排队扩展到分配:每个核分到多少个任务,某个任务在哪个核上跑,哪一个核该多担一点。
进入多核以后,第一个要回答的设计问题是运行队列的数量。O(1) 调度器给出的答案是每个 CPU 各持有一条运行队列,而不是所有 CPU 共用一条。
最先受益的是锁。挑人、入队、出队都只碰自己这条队列的锁,竞争被限制在本地。假如所有 CPU 共用一条队列,每一次调度都要先抢一把全局锁,核数越多,等锁的时间越长,挑选本身省下来的那点开销会被锁的开销抵消掉。
缓存是第二个受益者。一个任务上一次在哪个核上运行,它的代码和数据有相当大的概率还留在那个核的缓存里,每条队列只服务一个 CPU,调度器就有条件把任务放回原来的核上继续跑,TLB 里的页表项与分支预测器里的历史同样如此。
扩展性随其后。调度路径的开销不随 CPU 个数增长,加核不会让挑选变慢,新的 CPU 上线时只需要给它准备一条自己的队列。
共享一条队列还有一笔不容易看见的开销。队列头部的那几个计数字段会被所有 CPU 反复读写,它们所在的缓存行在不同核之间来回弹跳,每个核都要把这一行重新取回自己手里。按 CPU 拆开之后,每条队列的热点只落在自己的核上,这类弹跳随之消失。
挑选动作始终是本地行为。每个 CPU 在自己的队列上运行调度器,用自己队列上的信息做决定,不为了挑人而读别人的队列。跨核的信息只在均衡这一层被用到,均衡关心的不是谁下一个运行,而是每个核上积压了多少待办。
代价出现在队列之间。每条队列只根据自己的情况做决定,全局的均匀不再是自动结果。任务的落脚点由几个局部因素决定:上一次在哪个核上运行、被哪个核上的任务唤醒、当前哪个核正好空闲。这些因素凑出来的分布没有任何机制保证均匀,一条队列上排着好几个任务、另一条队列空着的情形因此是常态。
多核之间还有一层单核上不存在的互动。一个任务在某个核上运行,而唤醒它的动作往往发生在另一个核上,内核必须在那一刻决定刚醒来的任务放进哪一条队列,这个决定会同时影响两个核接下来一段时间的负载。单核机器上没有这类跨核的即时决策,任务只有一个去处。
双核机器上连续启动五个计算进程,最开始的分布几乎一定偏向一边。启动进程的操作是一个接一个做下来的,新任务通常被放在创建它的那个 CPU 上,等到第二个核参与进来,要依靠均衡器把积压的任务分出去。人手敲命令的节奏越慢,这个偏向越明显。
图 28 双核:两个 runqueue 各自为政

   ┌─────────────────────┐        ┌─────────────────────┐
   │        CPU 0        │        │        CPU 1        │
   │  ┌───────────────┐  │        │  ┌───────────────┐  │
   │  │  runqueue #0  │  │        │  │  runqueue #1  │  │
   │  │  当前任务:A   │  │        │  │  当前任务:D   │  │
   │  │  等着的:B C   │  │        │  │  等着的:       │  │
   │  └───────────────┘  │        │  └───────────────┘  │
   └──────────┬──────────┘        └──────────┬──────────┘
              │                              │
              └──────── 但整台机器是一个整体 ──────┘
                 一边排到队尾,一边没有任务可跑
                          ↓
                     负载均衡要处理的就是这个情形
图 28 双核:两个 runqueue 各自为政
均衡器到底有没有在做事,可以用四份计算程序量出来。程序体内是一个死循环,只做自增,既不睡觉也不等 I/O,每一份都在抢 CPU。计时口径是 /proc 里统计用户态时间与内核态时间的那个滴答,固定每秒一百个,与内核内部的时钟频率无关。八秒的窗口里,一个核最多发出八百个滴答。
两组条件用同一个程序、同一个窗口长度,区别只在允许运行的核。程序是纯计算,没有系统调用,没有锁,也没有 I/O,因此时间去了哪里只有一个去处,就是运行队列。这样量出来的滴答数可以直接读成 CPU 时间的分配结果,中间不需要再做扣除。
# 所属目录:/home/cocatrice/lab10sched
--- 都绑在 CPU0 ---
  进程 1 获得 201 个时钟滴答
  进程 2 获得 199 个时钟滴答
  进程 3 获得 201 个时钟滴答
  进程 4 获得 200 个时钟滴答
  负载:0.95 0.28 0.15

--- 可用 CPU0 与 CPU1 ---
  进程 1 获得 409 个时钟滴答
  进程 2 获得 426 个时钟滴答
  进程 3 获得 413 个时钟滴答
  进程 4 获得 424 个时钟滴答
  负载:1.50 0.42 0.20
第一组把四个进程用 taskset 钉在 CPU0 上,每个进程拿到两百上下的滴答,接近八百的四分之一。四份程序的权重相同,运行队列上始终有四个同权重的任务在争同一份 CPU 时间,等分是 CFS 按权重比例分配的直接结果。
第二组允许两个核参与,每个进程的数字翻到四百上下。可用的 CPU 时间从八百个滴答变成一千六百个,四份程序仍然等分,各自拿到半个核的时间。这里可以做一个反证:如果均衡器没有动作,四份程序全挤在 CPU0 上,每个进程拿到的还会是两百个滴答,CPU1 的八百个滴答会被整块空掉。数字整体翻倍,说明四个进程被分到了两个核上,每个核两个。
均衡改变的不只是总吞吐,还有单个进程等待的长度。绑一个核时,每个进程跑一小段就要把 CPU 让给另外三份程序,轮到自己的间隔很长;放开到两个核之后,同一个核上的竞争者从三份减到一份,等待的间隔随之缩短。总吞吐翻倍与单个进程拿到的时间翻倍,是同一个变化的两面。
这个测量的分辨率由窗口长度与滴答粒度共同决定。一个滴答就是百分之一的核容量,四份程序之间百分之二以内的差距落在计时误差的范围里,不足以推出别的结论,能站住的结论是两组数字之间的倍数关系。
这个测量回答的问题也只到分布这一层。均衡在什么时候被触发、一共搬了几次、每次搬走的是哪个进程,这些过程从滴答数字里看不出来,要记录下来得在运行期间反复读运行队列的快照。四份程序的滴答数只能回答一个问题:均衡有没有把它们摊到两个核上。
一个核没有可运行任务时也并没有停下来。每个 CPU 在启动阶段都有自己的 idle 任务,队列空了就把执行权交给它,直到有任务入队再切换出来。idle 任务占用的时间不计入任何用户进程,这段空转在滴答统计里直接表现为这个核没有被使用。
每组末尾的三个数字是同一时刻的机器平均负载,对应三个长度不同的统计窗口,窗口越长,数值变化越慢。第一个条件下是 0.95、0.28、0.15,两个核都用上以后变成 1.50、0.42、0.20。平均负载把可运行的任务与处于不可中断睡眠的任务一起计入,是一个整机指标,读数还受统计窗口与机器上其它活动的影响,要判断某一个核忙不忙,不能只看这三个数字。
第二个测量直接读运行队列。
# 所属目录:/home/cocatrice/lab10sched
cpu#0, 2600.000 MHz
  .nr_running                    : 2
  .load                          : 2048
  .cpu_load[0]                   : 2048
  .nr_switches                   : 3949666874
nr_running 是这条队列上当前可运行的任务数,它是一个瞬时值,有任务入队或者睡下,这个数字立刻跟着变。load 是同一条队列上这些任务的权重之和,两个 nice 值为 0 的任务各计 1024,加起来 2048,与输出的数字对得上。cpu_load[0] 记录的是平滑之后的负载,这一行里它与瞬时权重和相等。nr_switches 是这条 CPU 从开机到现在的累计切换次数,三十九亿这个量级说明机器已经运行了很久。
这三个字段在结构体里的位置也有讲究。nr_running 与 cpu_load 被放在相邻的位置,原因在于别的 CPU 做负载比较时会同时读这两个值,放在同一个缓存行里可以少一次内存访问。
cpu_load 在不同年份的内核里长得不一样,读源码时这一点要先确认。它最早是一个单独的数值,含义是这台 CPU 上待办数量的平滑平均;后来被改成数组,同时保存几个时间尺度上的平滑值,中间出现过三个元素的形式;本机 3.10 上是 cpu_load[5],五个元素,下标越大窗口越长。数组的好处是比较时可以按场合挑尺度,判断眼前要不要搬用短窗口,判断长期趋势用长窗口。两边比较的时候要用同一个下标,拿自己短窗口的读数去比对方长窗口的读数,差值里混进了统计口径的差别,据此做出的判断会偏。同一个结构的名字也换过:O(1) 时期的运行队列结构体叫 runqueue,后来的内核里统一叫 struct rq,字段的构成跟着调整过。拿一个版本的结构去对另一个版本的字段,会对不上。
队列的分布还会被另一件事限制,就是每个任务的 CPU 亲和性。
# 所属目录:/home/cocatrice/lab10sched
Cpus_allowed_list:	0-1
Cpus_allowed_list:	0     (taskset -c 0 之后)
这个字段出现在进程的状态信息里。内核用位掩码保存每个任务允许在哪些 CPU 上运行,打印的时候压缩成区间。新建的进程继承父进程的名单,这台机器上默认是 0-1,两个核都允许;用 taskset -c 0 之后名单缩成 0,表示这个任务只能在 CPU0 上跑。
名单对调度器来说是一道硬约束。挑落点的时候只能在这个范围里挑,均衡器挑选搬迁对象时也会跳过名单里没有目标 CPU 的任务。一个名单里只剩一个核的任务,对均衡器来说是不可搬的,别的核再空闲也轮不到它。
nice 与亲和性调节的是两件不同的事。nice 决定一个任务能分到多少 CPU 时间,亲和性决定这份时间在哪个核上分到,作用互不干涉:要让一个任务跑得更快,动的是 nice;要让它固定在某个核上,动的是亲和性名单。
均衡器搬运任务时看的不是任务的优先级,而是它能不能搬、搬过去值不值得。一个高优先级的任务如果缓存还热,同样可能被留在原地;一个低优先级的任务如果已经很久没运行,反而更可能被选中。优先级决定任务在队列里排第几,均衡决定它排在哪条队列里。
前面几组测量用 taskset 把进程钉在一个核上,为的就是排除核间迁移带来的差别,这样量到的是同一个核上的切换开销。长时间运行的服务也会用这一手把关键线程固定在某个核上,让它的缓存一直有效。代价是均衡器在这台机器上少了一个选项,被绑住的核一旦积压,另一个核帮不上忙。
把两种情形并排放一次。
| 维度 | 单核 | 多核 |
|---|---|---|
| 运行队列 | 一条 | 每个 CPU 各一条 |
| 锁 | 一条队列一把锁,没有竞争者 | 每条队列各一把锁 |
| 负载判断 | 没有比较对象 | 比较各 CPU 的平滑负载 |
| 任务搬迁 | 不存在 | 迁移线程、待搬清单、调度域 |
| 缓存 | 没有迁移带来的损耗 | 迁移之后缓存与 TLB 重新积累 |
多核带来的这一堆问题,在一条队列上都不存在,而它们的解决办法集中在负载均衡这一层里。
十九、负载因子与负载均衡
每个 CPU 各有一条运行队列之后,调度器多了一项职责:把任务在队列之间挪动。挪动之前要有判据,判据要稳,动手要克制。
判据是负载因子(cpu_load),它不用瞬时值。队列上的可运行任务数是最直接的忙闲读数,可是这个数字在毫秒尺度上就会变:一个任务被唤醒,另一个正好睡下,同一条队列的读数可能从三跳到零再跳回二。拿这种数字做搬迁决策,均衡器会跟着它来回搬,刚把任务挪到 CPU1,CPU1 上又醒来几个,于是再挪回去,几个来回之后,切换的开销、锁的开销、缓存失效的代价都花在了搬运上,整机的实际吞吐反而下降。这种现象叫搬迁震荡(thrashing)。
平滑的做法是指数平滑。新的平滑值由旧的平滑值和当前这一次采样按固定比例相加得到,旧值占的比例大。这样一来,时间越久远的样本影响越小,最近的样本被记进来,却不会立刻把判断带偏。平滑的目的是让判断稳,不是让判断灵敏。多核调度里,稳比灵更重要:一次搬错的代价要好几个周期才能补回来。
换成算术平均也能压掉抖动,代价是要把历史样本存下来。指数平滑只需要一个变量,每来一个样本更新一次,旧样本的影响按几何级数衰减,占用的内存是常数。判断谁忙谁闲这件事,答案不需要很精确,需要的是随时可得。
平滑值只用于跨 CPU 的比较。同一条队列上挑人,调度器直接看即时信息,O(1) 时期看位图与优先级数组,CFS 里看红黑树,都不需要等一个平均数出来。
均衡不在后台常驻一个循环,它在三个时机被触发。
第一个时机是周期性检查。每个 CPU 的运行队列里记着一个下一次平衡的时刻,到点之后触发一次检查,把同一个调度域内各 CPU 的平滑负载放在一起比较。在 O(1) 调度器里,这个时刻记在运行队列结构体的 next_balance 字段上,读 /proc/sched_debug 时能看到它,实测数据那一组输出里就有一行。
第二个时机是空闲的 CPU 主动去找活。一条队列空了、马上要切到 idle 任务时,这个 CPU 会先到别的 CPU 上看一圈,看有没有任务可以拉过来。这一步把空转的时间利用起来,不必等到下一次周期检查。一个核闲着而另一个核上排着队,是整机吞吐最直接的损失。
第三个时机出现在任务被创建或者从睡眠中被唤醒的时候。内核要在这个时刻给任务挑一个落脚点:先看唤醒它的任务在哪个 CPU 上,再看那个 CPU 忙不忙,能就近放下就就近放下。在源头把任务放对位置,比事后搬迁便宜得多。这一层判断还要过一遍亲和性名单,名单里没有的 CPU 不会被选中。
三个时机的分工不一样。周期检查是兜底,积压到一定程度一定会被处理;空闲拉活是机会主义的,核空闲下来的那一刻先去看一圈有没有可拉的任务;唤醒投递在事前生效,前两个时机处理的都是已经形成的积压,只有它能在任务排队之前就把位置安排好。
唤醒投递之所以有效,是因为它挑的时刻代价最低。新建的任务还没有形成缓存历史,落在哪个核上都不损失什么;沉睡了很久才被唤醒的任务,原先的缓存也大多失效了。在这两个时刻决定落点,等于把搬家的代价省掉。
比较的范围限于同一个调度域内的 CPU,差距还要超过一定的比例才会动手。设这道门槛的原因在搬迁的代价上,这一节后面会把代价的具体数量摆出来。
常规路径以拉为主。一条队列发现自己闲下来,或者周期检查时发现自己这边的待办偏少,就主动到别的 CPU 上取任务,搬运的方向朝自己这边来。推是另一条路径:源队列上的任务排得太久,常规的拉取没能把它取走,于是由源这一侧发起一次强行搬运。图 29 画的是后面这一种,它的流程更长,用到的字段也更多。
搬迁这件事不是直接伸手把任务从一条队列摘下来挂到另一条队列上。任务的字段可能正在被原 CPU 在锁的保护下修改,另一个 CPU 伸手过去改就会形成竞态。内核的做法是多绕一步,引入两个角色:发现不平衡的 CPU 把候选任务挂到待搬清单上,再由目标 CPU 自己的线程完成接收。
图 29 负载均衡的搬家流程

   发现不平衡的 CPU(例如 CPU0 上的待办远超 CPU1)
        │
        │ ① 挑一个可以搬的任务(优先挑缓存已经失效的)
        │ ② 把它挂进【migration_queue】(待搬清单)
        │ ③ 设置 active_balance 标记,并指明 push_cpu = 目标 CPU
        ▼
   唤醒目标 CPU 的【migration_thread】,每个 CPU 各有一个专职迁移线程
        │
        │ ④ 迁移线程在目标 CPU 上把任务从清单里取出
        │ ⑤ 插进目标 CPU 的 runqueue(enqueue_task 走一遍:挂链、置位、计数)
        ▼
   任务在 CPU1 上重新开始积累缓存
图 29 负载均衡的搬家流程
这一套流程用到的字段各有分工。
| 字段 | 作用 |
|---|---|
| migration_thread | 每个 CPU 一个专职迁移线程 |
| migration_queue | 待搬任务的清单 |
| active_balance | 标记这条队列需要外部来平衡 |
| push_cpu | 搬运的目标 CPU |
| sd | 调度域,描述 CPU 之间的亲疏关系 |
迁移线程安排在实时优先级上,它被唤醒之后能立刻在目标 CPU 上取得执行机会,不会排在一批普通任务后面等。这一条很关键:搬运请求是别的 CPU 提出来的,如果接收方要等很久才能运行,期间源队列的锁会一直被持有,别的 CPU 只能排队等着。
调度域(scheduling domain,结构体里记作 sd)描述的是 CPU 之间的亲疏关系,这层关系由硬件拓扑决定。同一个物理核上的两个超线程共享执行部件与一级、二级缓存,彼此最近;同一个插槽内的核共享末级缓存,距离次之;跨插槽更远;跨 NUMA 节点还要额外考虑内存访问速度的差别。
均衡从最内层开始找机会,内层解决不了再往外层走。这样安排的依据是同一件事:近处搬动的代价小,值得先试。核数越多的机器,这层结构的层数越多,均衡逻辑也越复杂;这台机器只有两个核,能比较的对象只有两个。
检查本身也有开销。均衡器要读别的 CPU 的队列状态,还要取对方的锁,核多的机器上这些动作加起来不是小数目。因此每个调度域都带着自己的平衡间隔,检查按各自的节奏进行,越靠外层的域间隔越长;域内正忙的时候,间隔还会按一个系数放大。间隔的设定本身就是一笔取舍:密了,检查的开销变大;疏了,积压要等更久才被处理。
搬迁的代价集中在缓存上。一个任务在旧核上积累起来的东西,有一部分会随着搬迁作废:它读写过的数据所在的缓存行要重新装载,页表项要重新填进新核的 TLB,分支预测器里属于它的历史也帮不上忙。迁移刚完成的一段时间里,这个任务基本处在冷启动的状态。
因此均衡器的原则是三句话:必要才搬、尽量少搬、优先近处搬。它们分别对应三个判断,差距够不够大、这一次搬几个、往哪一层搬。
这台机器上能看到承担搬运的线程。
# 所属目录:/home/cocatrice/lab10sched
    7 migration/0
   13 migration/1
两个核各有一个迁移线程,名字里的编号对应 CPU 编号。它们是内核线程,没有用户态地址空间,平时睡在等待队列里,被唤醒之后才运行,一次唤醒对应一次搬运请求。进程号本身没有含义,它取决于内核线程的创建顺序,每次启动都可能不同,能对上的只有名字。核数更多的机器上,这个列表按核数逐行出现。
这里要把界线划出来。把任务挂进 migration_queue、设置 active_balance 与 push_cpu、再由目标 CPU 的迁移线程接收,这一整套流程属于 2.6 时期的源码范围,本机跑不出来。这台 3.10 机器上能够验证的是线程本身:每个 CPU 一个,负载均衡需要把某个 CPU 上的任务接走时,接手的动作就发生在这些线程上,唤醒一次处理一次。
均衡器的行为有两个可以调的量。
# 所属目录:/home/cocatrice/lab10sched
sched_nr_migrate = 32
sched_migration_cost_ns = 500000
sched_nr_migrate 是一次平衡操作最多从一条队列上搬走多少个任务,这台机器上配的是 32。设这个上限是为了控制单次平衡的时间:搬运的过程中源队列与目标队列的锁都要持有,一次搬走几十个任务会把锁占住很久,其它 CPU 等锁的时间跟着变长。上限还有第二个作用,避免把一个核上的积压整块倒给另一个核,让目标队列当场变成新的瓶颈。
sched_migration_cost_ns 是内核对搬一个任务要付出多少代价的估计,单位是纳秒,五十万纳秒等于五百微秒。均衡器用它判断候选任务是不是还热:任务上一次拿到 CPU 之后,到这次检查为止的时间如果短于这个值,就认为它的缓存还有效,搬走要付代价,先不动它;如果长于这个值,说明它已经有一段时间没运行,缓存大概率已经失效,可以搬。任务热不热是挑搬迁对象的第一个筛子。
把两个代价放在一起看会更清楚。后面实测数据那一组里量到的单次切换在六微秒上下,而这里给出的迁移代价估计是五百微秒,两者差了两个数量级。原因在于搬迁不只是换一次上下文:被搬走的任务在新核上要从冷缓存开始,它用到的数据和页表都要重新装载,这笔开销远大于一次切换本身。均衡器宁可容忍一段时间的负载不均,也不愿意频繁付出这笔开销。
这两个值都可以在运行中通过 /proc/sys/kernel 下的同名文件调整。把 sched_migration_cost_ns 调大,均衡器会更保守,倾向于让任务待在原地;调小则更愿意搬。负载形态差别大的机器上,运维会按自己的情况改这两个数。两个参数作用在不同环节:sched_migration_cost_ns 决定哪些任务值得搬,sched_nr_migrate 决定一次搬多少。前者调大,候选对象变少;后者调小,单次动作的规模变小,积压要靠更多轮平衡才能抹平。
挑选与均衡是两套判据。挑选在本地进行,依据是可运行任务的权重与虚拟时间,目标是让这个核上的任务按规则轮流运行;均衡跨核进行,依据是平滑之后的负载与迁移代价,目标是让每个核上的待办量保持在大致相当的水平。两套判据用的信息不同,更新的频率也不同,各自解决各自的问题。
均衡器追求的不是任意时刻两条队列一样长。判据里有阈值,有代价估计,被搬的任务要重新积累缓存,这些都是刻意留下的余量。检查发现差距不小时,均衡器也只取走一部分任务,取多少由两边的负载差和单次搬运的规模共同决定。目标是让搬完之后的差值落进阈值之内,而不是把两边抹平。留下来的那点差值,正是均衡器为了让任务待在原地而刻意保留的。
一个反复被搬动的任务,缓存始终处在重新积累的状态,队列长度看起来很整齐,整机的吞吐却在往下掉。
二十、从 O(1) 到 CFS 再到 EEVDF
O(1) 调度器在 2002 年前后进入 2.5 开发系列,2003 年随 2.6.0 上线,一直服役到 2.6.22,前后四年多,2.6.23 换上了 CFS。它退役不是因为它把该做的事情做错了,而是它面对的负载形态变了:Linux 从服务器走进了桌面、手机、虚拟机和容器,负载从几十个行为安分的服务器进程变成几百个上蹿下跳、难以预测的进程,对公平性和可预测性的要求盖过了对极限吞吐的要求。
先把界线交代清楚。本机是 3.10 内核,跑的是 CFS。这一节里 O(1) 调度器的内容按源码讲,本机跑不出来;CFS 的部分可以在本机读到真实的字段和数字;EEVDF 属于更新的内核,本机同样看不到,只作交代。
O(1) 调度器的功劳要分开算。它兑现了承诺:挑选下一个任务的开销与队列长度无关,几千个任务的机器上,挑选依然是几次位运算。它把每条运行队列绑到一个 CPU 上,再把负载均衡作为独立的一层加在上面,这套结构在今天的 CFS 里仍然成立。它留下的双队列加位图的组合,把优先级调度的常数时间实现讲得清清楚楚,后来很多调度器的设计都从这套结构里取过经。
它的问题也在同一份清单上,而且是由它的设计方式带来的。
判断一个任务是否属于交互式负载,O(1) 调度器用的是一整套启发式:睡眠时间平均值 sleep_avg、由它换算出来的补偿值 bonus、交互式任务的标记 TASK_INTERACTIVE,以及围绕它们的一圈阈值。旋钮多带来两个后果。负载形态一换,参数就要重新配,而参数之间互相牵制,调好一个往往弄坏另一个;同一套参数在不同场景下表现相反,服务器负载嫌它给交互式任务的好处太多,桌面负载嫌它太看重吞吐。
公平只是近似的。时间片与优先级配合,让 CPU 时间在多轮累计之后大体按 nice 值拉开,可是某一个短窗口里谁多谁少并不受约束。一个对延迟敏感的任务可能一等就是几十毫秒,而这几十毫秒在音频或者交互场景里是能感觉出来的。
原因在于分配是一次性算好的。时间片在任务下场的那一刻按 nice 计算出来,此后整个时间片之内不再调整;队列长度、权重分布、有多少任务正在睡觉,这些信息变了也不影响已经发出去的那一份。比例关系要在多轮之后才看得出来。
启发式还可以被绕过。判断的依据是睡得多就加分,那么一个故意睡一下再醒来的任务,就能拿到一份与它实际需求无关的加分。
代码也在变重。规则一条条加上去,调度器里堆着越来越多的特例,改一处阈值要连带考虑好几处判断,理解和维护的成本跟着上涨。
这段历史里还有一次路线分歧。2000 年代中期,Con Kolivas 提出过几套更强调公平的调度方案,RSDL 与 SD 是其中的代表,在桌面用户中间反响很好,最终没有进入主线;Ingo Molnar 写的 CFS 成了主线的选择。这段分歧的细节在不同记载里有些出入,当作两种设计取向的对照即可。
CFS 的做法是不再发放时间片,改成记流水账。
每个可运行的任务记一个虚拟运行时间(vruntime)。任务每占用一段 CPU,它对应的 vruntime 就往前推进一段;挑下一个任务时取 vruntime 最小的那个,也就是到这一刻为止被补偿得最少的那个。
推进的速度由权重决定。权重由 nice 值换算而来,nice 越小权重越大。权重大的任务,同样的实际运行时间对应的 vruntime 增量更小,它的虚拟时间增长得慢,于是可以连续运行更久才轮到别人,最终分到的 CPU 份额更大。份额的比例就是权重除以这条队列上所有可运行任务的权重之和。
所有可运行任务按 vruntime 挂在一棵红黑树上,取最小值就是取树中最左的那个节点。挑选的复杂度从 O(1) 变成 O(log n),换来的是公平可以被直接表达:谁欠得多,下一个就挑谁。
图 30 CFS 的两条主线

① vruntime 时间线:公平的判据就是挑最落后的那个

   vruntime(虚拟时间,越小表示越该被补偿)
   ▲
   │        ● A(vruntime=120)
   │              ● C(vruntime=150)
   │   ● B(vruntime=100) ← 最落后,下一个挑它
   └──────────────────────────────────────► 时间
       欠得最多的先补

② 红黑树:按 vruntime 排好序的待跑队列

              (150)
             ╱     ╲
         (120)      (180)
         ╱   ╲
      (100)  (130)     ← 最左的 (100) 就是下一个
     (取最左 = 找最小值 = O(log n))
图 30 CFS 的两条主线
权重对 vruntime 增速的影响可以用一个例子摆出来:两个任务在同一个核上,权重相差一倍,那么同样跑一毫秒,权重小的那个任务 vruntime 推进的量是权重大的那个的两倍。它先跑到前面去,也就先被换下来,让位给落后的那个。
CFS 里也留了一点倾斜,只是这点倾斜没法被利用。一个睡了很久的任务醒来时,它的 vruntime 会被放在基准线稍微靠前的位置,算是对等待时间的一点补偿;补偿的量是固定的,与它究竟睡了多久没有关系。故意睡一下再醒来的任务,拿到的补偿与正常睡眠的任务一样多,拿不到额外的优待。O(1) 时代那种靠睡眠时长累积奖金的机制,在 CFS 里被换成了这种定额补偿。
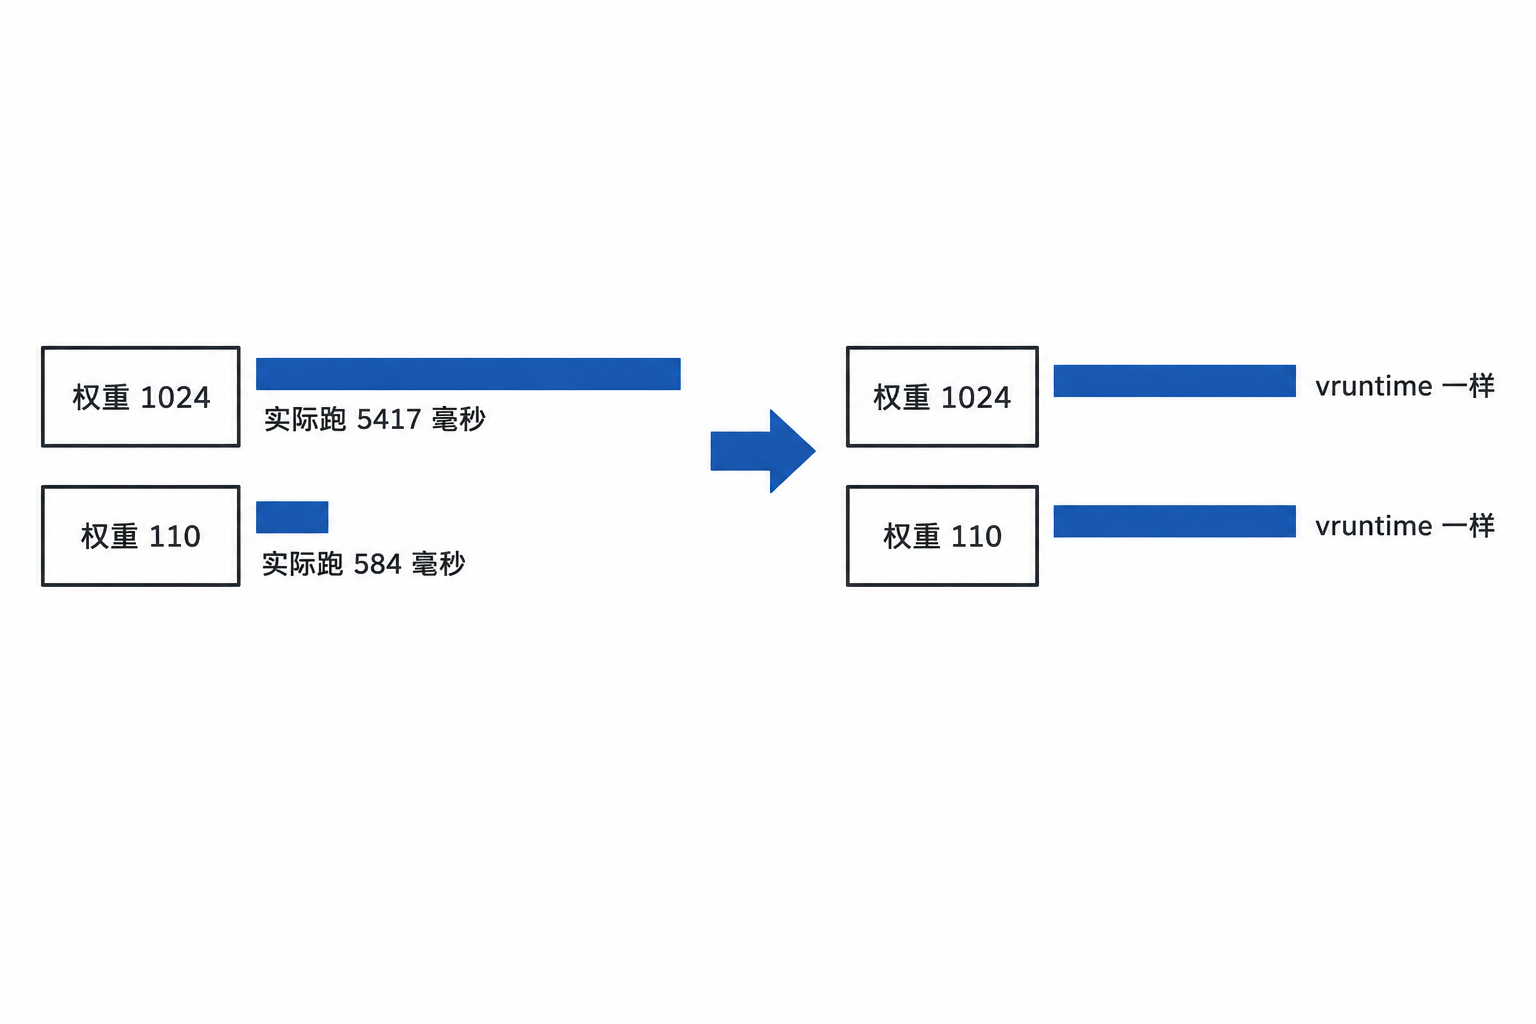
图 31 权重决定 vruntime 的增速
CFS 把 O(1) 时代的一批概念直接取消了。
| O(1) 时代的结构 | CFS 里的下场 |
|---|---|
| active 与 expired 两个数组 | 取消,改用一棵红黑树 |
| bitmap 与 queue[140] | 取消,红黑树本身有序 |
| 时间片 time_slice 发牌 | 改为目标延迟约束 |
| sleep_avg 与 bonus 启发式 | 取消,不再去猜谁是交互式 |
| 静态优先级与动态优先级 | 简化为权重,nice 只影响权重比例 |
前两行在第十节与第十二节已经讲过,它们在 CFS 里没有对应物。第三行的位置被 sched_latency 接了过去:内核不再给每个任务预先算好一份时间片,改为在一个目标窗口里保证每个任务至少轮到一次,具体每次跑多久由权重占比现算。
下面几组读数都来自这台机器上运行中的 CFS,从调度实体开始看。
/* include/linux/sched.h,3.10 内核,节选 */
struct sched_entity {
	struct load_weight	load;		/* for load-balancing */
	struct rb_node		run_node;
	struct list_head	group_node;
	unsigned int		on_rq;

	u64			exec_start;
	u64			sum_exec_runtime;
	u64			vruntime;
	u64			prev_sum_exec_runtime;

	u64			nr_migrations;
	/* ... */
};
O(1) 时期用于调度的字段直接长在任务结构体里,任务通过 run_list 挂在优先级数组的某一条队列上。CFS 把参与调度的字段单独抽成一个结构体,叫调度实体(sched_entity),任务通过内嵌的实体参与调度。
load 是权重,供负载均衡计算使用。run_node 是红黑树节点,实体就是通过它挂在队列的红黑树上。group_node 与 on_rq 分别服务于组调度与在队标记,on_rq 表示这个实体当前是否挂在运行队列上。exec_start 记录本次开始占用 CPU 的时刻,sum_exec_runtime 是累计占用的 CPU 时间。vruntime 就是挑选的依据。prev_sum_exec_runtime 保存上一次被换下时的累计值,唤醒时的补偿计算要用到它。nr_migrations 统计这个实体被迁移过多少次,读 /proc/PID/sched 时能看到同一项。
一个实体可以代表一个任务,也可以代表一整组任务。一个 cgroup 对应一条自己的 cfs_rq,组与组之间先按各自的权重分一次,组内部的可运行任务再按权重分一次,两层的规则完全一样。按组限制 CPU 用量、给某类服务划定配额,用的就是这层结构。
运行队列这一侧也有可以读的东西。
# 所属目录:/home/cocatrice/lab10sched
cfs_rq[0]:/hostguard
  .min_vruntime                  : 6491905.996159
  .nr_running                    : 0
  .load                          : 0
  .se->vruntime                  : 182484280.103827
  .se->sum_exec_runtime          : 18388194.041613
  .se->load.weight               : 2
min_vruntime 是这条队列的基准时间,也是红黑树上当前最小的那个 vruntime。它的作用主要体现在新任务入队的时候:一个刚被创建的任务不会带着一个很小的 vruntime 直接插到树的最左边,内核会把它对齐到当前的基准线上,甚至再往后推一份它应得的时间片,防止新任务把 CPU 长时间占住。
输出里 nr_running 与 load 都是 0,说明这条队列上此刻没有可运行的任务,min_vruntime 停在上一次有实体出入队时更新到的位置。带 se-> 前缀的几行对应挂在队列上的调度实体:vruntime 是它的虚拟运行时间,sum_exec_runtime 是它累计占用的 CPU 时间,load.weight 是它的权重。
公平性可以直接从 /proc/PID/sched 里读出来。两个计算任务绑在同一个核上,nice 值分别是 0 与 10,运行中读它们各自的调度实体。
# 所属目录:/home/cocatrice/lab10sched
--- nice 0 ---
se.vruntime                                  :     182490385.714378
se.sum_exec_runtime                          :          5417.116061
se.load.weight                               :                 1024
--- nice 10 ---
se.vruntime                                  :     182490403.188549
se.sum_exec_runtime                          :           584.470989
se.load.weight                               :                  110
两个 vruntime 分别是 182490385.714378 与 182490403.188549,相差 17.474171。这两个字段以毫秒为单位,同一台机器上让一个进程跑满三秒,se.sum_exec_runtime 读出的是 3000.662577。相对于一亿八千多万毫秒的账面值,十七毫秒的差距可以忽略,两者的虚拟时间几乎重合。这是 CFS 每时每刻都在维护的状态:谁跑得多了,虚拟时间就走到别人前面,于是下一个被换下来的就是它,两个任务的虚拟时间因此被拉在同一条线上。
实际占用 CPU 的时间并没有拉平。sum_exec_runtime 是 5417 与 584,比值 9.28;权重是 1024 与 110,比值 9.31。两个比值吻合,说明虚拟时间上的平等换算到实际时间里就是按权重分配:权重大的任务跑的时间长,但虚拟时间推进得慢,两边在虚拟时间这条线上始终并肩。
在 CFS 里,nice 值不再决定时间片的长短,它只决定权重的比例,而权重比例决定 vruntime 的推进速度,最终决定 CPU 份额。
时间片这一侧剩下三个可以调的参数。
# 所属目录:/home/cocatrice/lab10sched
sched_latency_ns = 12000000
sched_min_granularity_ns = 10000000
sched_wakeup_granularity_ns = 15000000
sched_latency_ns 是目标延迟,这台机器上是 12 毫秒。队列上的可运行任务不多时,内核保证每个任务在这个窗口里至少轮到一次,每个任务分到的那一份时间是 12 毫秒乘上它的权重占比。
sched_min_granularity_ns 是最小粒度,10 毫秒。队列上的任务多到一个周期装不下时,周期长度改成任务数乘以这个粒度,每个任务每次至少运行这么久。设这个下限是为了让切换开销在总时间里的占比不至于失控。
sched_wakeup_granularity_ns 是唤醒抢占的门槛,15 毫秒。一个刚醒来的任务想抢占当前任务,它落后的 vruntime 必须超过这个量;达不到就等当前任务跑完这一小段。这道门槛用来减少无谓的抢占和切换。
每个任务一次能连续运行多久,可以用非自愿切换的计数间接量出来。把四个纯计算进程钉在同一个核上,四秒的窗口里每个进程被抢占 91 次,而它在这段时间里实际拿到的 CPU 时间是全部时间的四分之一,也就是 1000 毫秒上下,两者相除得到每次连续运行约 11 毫秒。两个进程的场合用同样的算法得到约 7 毫秒。这两个读数与最小粒度 10 毫秒处在同一个量级,顺序也符合那两个参数的关系:队列上的任务越多,一个周期被摊得越长,每个任务一次运行的时间则不会低于那个下限。
同样的三个值在 /proc/sched_debug 里也能读到,单位换成毫秒。
# 所属目录:/home/cocatrice/lab10sched
sysctl_sched
  .sysctl_sched_latency                    : 12.000000
  .sysctl_sched_min_granularity            : 10.000000
  .sysctl_sched_wakeup_granularity         : 15.000000
  .sysctl_sched_child_runs_first           : 0
  .sysctl_sched_features                   : 40571
  .sysctl_sched_tunable_scaling            : 1 (logaritmic)
sysctl_sched_features 是特性开关的位图,sysctl_sched_child_runs_first 决定 fork 之后子进程是否先运行,这一台机器上它是关着的。sysctl_sched_tunable_scaling 说明这几个参数会按 CPU 个数做对数缩放,因此同一组默认值在不同核数的机器上算出来的周期长度并不相同。
CFS 从 2.6.23 一直用到 6.6,前后十六年。接替它的是 EEVDF(Earliest Eligible Virtual Deadline First,最早符合条件的虚拟截止期优先),2023 年随 6.6 进入主线。
EEVDF 在公平之外加了一个维度:时间承诺。每个任务除了欠账(eligible,表示它是否已经有资格被服务),还有一个虚拟截止期(virtual deadline),表示它这一小份 CPU 最迟应该在什么时刻拿到。挑选的时候,先看哪些任务已经有资格被服务,再在这些任务里挑截止期最近的那个。
这样一来,延迟敏感的负载对自己的等待时间有了比较确定的预期,音视频与交互场景受益,同时总体的份额仍然按权重分配。后续的内核还加了一个专门表达「我在意延迟」的旋钮,叫 latency nice。
EEVDF 与 CFS 之间没有断层。它仍然属于 fair 调度类,可运行任务仍然排在一棵红黑树上,换掉的是排序用的键:CFS 只按 vruntime 排,EEVDF 在资格判断之外再加一个截止期,树的顺序由截止期决定。从 CFS 升级上去的机器,字段名与调试接口基本能对上。本机是 3.10,这一段在内核里找不到任何痕迹,代码层面无法在本机验证。
把五代调度器并排放在一起看。
| 维度 | 0.11(1991) | 2.4(2001) | 2.6 O(1)(2003 到 2007) | CFS(2007 到 2023) | EEVDF(2023 起) |
|---|---|---|---|---|---|
| 挑人方式 | 扫全表比 counter | 扫全表算 goodness | 位图加 140 条队列直取 | 红黑树取最小 vruntime | 资格加虚拟截止期 |
| 挑人复杂度 | O(n) | O(n) | O(1) | O(log n) | O(log n) |
| 核心数据结构 | task[] 数组 | 任务链表 | prio_array 两个加位图 | 红黑树 | 红黑树加期限维度 |
| 分配手段 | counter 时间片加睡眠奖励 | counter 加优先级 | time_slice 按 nice 算,动态优先级与 sleep_avg | 按权重分配 vruntime 份额 | 份额加延迟承诺 |
| 交互式处理 | 朴素,睡醒补发时间片 | 朴素 | 启发式,sleep_avg 与 bonus | 不需要专门猜,公平本身就照顾短任务 | 显式的延迟维度 |
这张表里有一处看起来像退步的地方。挑人的复杂度在 O(1) 这一代触底,到了 CFS 又回到 O(log n),EEVDF 保持在这个量级。这不是能力上的后退,而是把开销花在了更值钱的位置:常数时间的挑选是拿一套固定的优先级和时间片换来的,一旦任务的权重、睡眠的时长、队列的长度这些条件变了,那套固定结构并不跟着变;红黑树每次挑选都按当前的欠账重新排序,代价是对数级的查找,回报是公平不再需要靠启发式去猜。
回到本机。前面这些读数,四个进程的滴答分布、cpu_load[0] 与 nr_running、两个迁移线程、struct sched_entity 的字段、min_vruntime、两个任务的 vruntime 与权重、三个时间参数,全部来自这台 3.10 机器上运行中的 CFS。
O(1) 调度器那一代只存在于源码里。它的 prio_array、位图、active 与 expired 数组在本机内核里已经不存在,能够对照的只有 /proc/sched_debug 里几个同名的字段。第九节到第十四节讲的结构属于 2.6 那个年代,读的时候要把这条界线记在心上;动态优先级那一套启发式同样如此,本机内核里既没有 sleep_avg,也不会有 TASK_INTERACTIVE 这样的标记。
实例代码
工程结构
lab10sched/
├── Makefile           编译规则
├── pingpong.c         三种往返的耗时对比
├── ctxt.c             自愿切换与非自愿切换的计数
├── setjmp_demo.c      用户态的现场保存与恢复
├── race.c             不加同步的共享计数
├── race_lock.c        加锁之后的对照版本
├── bench.sh           把三种往返各跑五遍,输出均值表
├── hog.c              一个纯计算进程,用来量 CPU 份额
└── prio.c             读改自己的 nice,试 getpriority 与 setpriority
编译规则统一写在 Makefile 中。速度测试使用 -O2,演示共享数据的那个程序故意使用 -O0,原因在常见报错那一节说明。
完整代码
详见代码仓库链接:
https://gitee.com/h-fiy/cocatrice_csdn_code.git
正常情况
编译过程中没有出现任何警告。
[cocatrice@hcss-ecs-4cd1 lab10sched]$ make clean
rm -f pingpong ctxt setjmp_demo race race_lock
[cocatrice@hcss-ecs-4cd1 lab10sched]$ make
gcc -O2 -Wall -Wextra -o pingpong pingpong.c -lpthread
gcc -O2 -Wall -Wextra -o ctxt ctxt.c
gcc -O0 -Wall -Wextra -o setjmp_demo setjmp_demo.c
gcc -O0 -Wall -Wextra -o race race.c -lpthread
gcc -O1 -Wall -Wextra -o race_lock race_lock.c -lpthread
三种往返各运行一次,数字的解读放在实测数据那一节。
[cocatrice@hcss-ecs-4cd1 lab10sched]$ ./pingpong self 200000
self    往返 200000 次,总耗时 133.523 ms,每次往返 667.6 ns
[cocatrice@hcss-ecs-4cd1 lab10sched]$ ./pingpong proc 200000
proc    往返 200000 次,总耗时 2521.314 ms,每次往返 12606.6 ns
[cocatrice@hcss-ecs-4cd1 lab10sched]$ ./pingpong thread 200000
thread  往返 200000 次,总耗时 2547.351 ms,每次往返 12736.8 ns
setjmp 那个程序把用户态的现场打印出来,八个槽位中保存的正是第三节那张清单上的寄存器。
[cocatrice@hcss-ecs-4cd1 lab10sched]$ ./setjmp_demo
第一次从 setjmp 返回,返回值 r = 0
指针保护的 guard(从 %fs:0x30 读到)= 0x72031bc62440df18

槽位   保存的原始值            还原之后
rbx    0x0000000000000000   0x0000000000000000
rbp    0xc8754aa97f50e406   0x00007ffc811460b0
r12    0x0000000000400520   0x0000000000400520
r13    0x00007ffc81146190   0x00007ffc81146190
r14    0x0000000000000000   0x0000000000000000
r15    0x0000000000000000   0x0000000000000000
rsp    0xc8754aa97e10e406   0x00007ffc81146010
rip    0x378c4801b360e406   0x00000000004006a8

当前 &env       = 0x601080
当前 &counter   = 0x601148
longjmp 之后又回到 setjmp 这里,这次 r = 1,counter = 42
把还原出来的 rip 交给 addr2line,得到的落点是 main,这说明那个槽位中存放的正是 setjmp 之后要返回的地址。
[cocatrice@hcss-ecs-4cd1 lab10sched]$ addr2line -e setjmp_demo -f 0x4006a8
main
??:?
切换计数那个程序每 0.3 秒采样一次,输出是一串递增的数字。
[cocatrice@hcss-ecs-4cd1 lab10sched]$ ./ctxt sleep
模式 sleep,子进程 pid 1451
  0.3s  自愿切换     30   非自愿切换      0
  0.6s  自愿切换     60   非自愿切换      0
  0.9s  自愿切换     90   非自愿切换      0
  1.2s  自愿切换    120   非自愿切换      0
  1.5s  自愿切换    150   非自愿切换      0
  1.8s  自愿切换    179   非自愿切换      0
  2.1s  自愿切换    201   非自愿切换      0
  2.4s  自愿切换    201   非自愿切换      0
常见报错
一类报错来自漏掉头文件,编译器会给出隐式声明警告。
改前
#include <time.h>
#include <pthread.h>

int main(int argc, char *argv[])
{
    /* ... */
    wait(NULL);
}
gcc -O2 -Wall -Wextra -o pingpong pingpong.c -lpthread
pingpong.c: In function ‘main’:
pingpong.c:72:9: warning: implicit declaration of function ‘wait’ [-Wimplicit-function-declaration]
         wait(NULL);
         ^
改后
#include <time.h>
#include <pthread.h>
#include <sys/wait.h>

int main(int argc, char *argv[])
{
    /* ... */
    wait(NULL);
}
同样的问题在 ctxt.c 中出现过一次,缺少的是 sched.h,报出的信息是 implicit declaration of function ‘sched_yield’。隐式声明在这个编译器上只是警告,函数的返回值被当作 int 处理,参数类型也不再检查,实际运行时可能得到一个完全无法理解的结果。编译时把 -Wall -Wextra 打开,这类问题都会当场报出来。
另一类报错出现在链接阶段,原因是漏掉线程库。
改前
# 所属目录:/home/cocatrice/lab10sched
gcc -O2 -o /tmp/pingpong_bad pingpong.c
[cocatrice@hcss-ecs-4cd1 lab10sched]$ gcc -O2 -o /tmp/pingpong_bad pingpong.c
/tmp/ccxiZDMh.o: In function `main':
pingpong.c:(.text.startup+0x9b): undefined reference to `pthread_create'
pingpong.c:(.text.startup+0xfe): undefined reference to `pthread_join'
collect2: error: ld returned 1 exit status
改后
# 所属目录:/home/cocatrice/lab10sched
gcc -O2 -Wall -Wextra -o pingpong pingpong.c -lpthread
报错出现在链接阶段而不是编译阶段,从措辞上就可以分辨:编译阶段的错误会给出 warning 或者 error 并指出行号,链接阶段的错误给出 undefined reference,报出的是函数名。这台机器的 glibc 是 2.17,线程函数的声明位于 pthread.h,实现位于 libpthread,两者都必须提供。
还有一类情况中,编译优化把一段有问题的代码改成了另一种有问题的代码。同一份 race.c,在三种优化级别下得到三个结果。
[cocatrice@hcss-ecs-4cd1 lab10sched]$ gcc -O0 -o race_o0 race.c -lpthread
[cocatrice@hcss-ecs-4cd1 lab10sched]$ for i in 1 2 3 4 5 6; do ./race_o0; done
两个线程各加两千万次,counter = 20359136,期望值 40000000
两个线程各加两千万次,counter = 21774222,期望值 40000000
两个线程各加两千万次,counter = 20479939,期望值 40000000
两个线程各加两千万次,counter = 20198741,期望值 40000000
两个线程各加两千万次,counter = 22981794,期望值 40000000
两个线程各加两千万次,counter = 20426645,期望值 40000000
[cocatrice@hcss-ecs-4cd1 lab10sched]$ gcc -O1 -o race_o1 race.c -lpthread
[cocatrice@hcss-ecs-4cd1 lab10sched]$ ./race_o1
两个线程各加两千万次,counter = 20000000,期望值 40000000
[cocatrice@hcss-ecs-4cd1 lab10sched]$ gcc -O2 -o race_o2 race.c -lpthread
[cocatrice@hcss-ecs-4cd1 lab10sched]$ ./race_o2
两个线程各加两千万次,counter = 40000000,期望值 40000000
三种结果都可以从汇编中找到原因。-O0 时每次循环都要读内存、加一、写回,两个线程的交错没有规律,六次运行得到六个不同的值。-O1 时编译器把整个循环压缩成一次读改写,两个线程各读一次旧值再各写一次,结果固定丢失一半。-O2 时循环被压缩成一条 addq 指令,两个线程各执行一条读改写指令,撞在同一个时间窗内的概率很小,结果反而常常看起来是正确的。
[cocatrice@hcss-ecs-4cd1 lab10sched]$ gcc -O2 -S -o /tmp/race_o2.s race.c
[cocatrice@hcss-ecs-4cd1 lab10sched]$ awk '/^worker:/,/^\.LFE/' /tmp/race_o2.s
worker:
.LFB14:
	.cfi_startproc
	addq	$20000000, counter(%rip)
	xorl	%eax, %eax
	ret
	.cfi_endproc
这段代码在任何优化级别下都是错的,区别只在于错误的表现形式。 一处没有同步的共享写入,编译器无论怎么处理都不改变这一点,-O2 看起来正确只是因为概率站在了它那边。
边界情况
往返次数太少时,测量出来的数字会偏小。
[cocatrice@hcss-ecs-4cd1 lab10sched]$ for n in 100 1000 10000; do ./pingpong proc $n; done
proc    往返 100 次,总耗时 1.036 ms,每次往返 10355.6 ns
proc    往返 1000 次,总耗时 10.991 ms,每次往返 10991.3 ns
proc    往返 10000 次,总耗时 126.520 ms,每次往返 12652.0 ns
一百次往返的均值比二十万次低了将近两成。前几十次往返处于缓存与分支预测都没有热起来的阶段,单次开销本来就小,次数一少,它们的权重就被放大。测量这类微秒级的开销,循环次数要开到十万级以上,并且多运行几遍取中间值。
把两个进程绑定到同一个核上,往返耗时降到原来的三分之一。
[cocatrice@hcss-ecs-4cd1 lab10sched]$ taskset -c 0 ./pingpong proc 200000
proc    往返 200000 次,总耗时 781.509 ms,每次往返 3907.5 ns
[cocatrice@hcss-ecs-4cd1 lab10sched]$ taskset -c 0,1 ./pingpong proc 200000
proc    往返 200000 次,总耗时 2526.233 ms,每次往返 12631.2 ns
两次的差别在于允许使用的 CPU 数量。绑定到单核之后两个进程都在 CPU0 上,一次唤醒在同一个运行队列中就可以完成;允许使用两个核之后,父进程在 CPU0 上阻塞,子进程在 CPU1 上运行,每次唤醒都要跨 CPU 通知对方,多出来的开销全部落在这条通知路径上。上下文切换的代价不是一个固定数字,它与切换到哪个 CPU 上密切相关。
sched_yield 在系统中只有自己一个可运行任务时不会产生自愿切换。
[cocatrice@hcss-ecs-4cd1 lab10sched]$ ./ctxt yield
模式 yield,子进程 pid 32076
  0.3s  自愿切换      0   非自愿切换      2
  0.6s  自愿切换      0   非自愿切换      3
  0.9s  自愿切换      0   非自愿切换      6
  1.2s  自愿切换      0   非自愿切换      8
  1.5s  自愿切换      0   非自愿切换     11
  1.8s  自愿切换      0   非自愿切换     12
  2.1s  自愿切换      1   非自愿切换     16
  2.4s  自愿切换      1   非自愿切换     16
两秒钟内调用了上万次 sched_yield,自愿切换计数几乎没有变化。原因在于运行队列中没有其他任务,把自己放到队尾之后挑选出来的仍然是自己;内核在 yield_task 中判断出这一点便直接返回,没有真正执行一次切换。自愿切换计数统计的是「让出 CPU 之后换成了别的任务」,而不是「调用过让出 CPU 的函数」。
读取一个已经退出的进程时,得到的是文件不存在的错误。
[cocatrice@hcss-ecs-4cd1 lab10sched]$ cat /proc/999999/status
cat: /proc/999999/status: No such file or directory
进程退出之后,内核会把它在 /proc 下的目录一并删除。抓取运行中进程的数据时,如果采样间隔比进程的存活时间还长,就会遇到这个错误。脚本中要把它当作正常情况处理,不能直接当作失败退出。
实测数据
第一组是三种往返的耗时,每种模式运行两遍。
| 模式 | 往返次数 | 每次往返 |
|---|---|---|
| self,同一进程写读管道 | 200000 | 683.4 ns |
| self | 200000 | 681.1 ns |
| proc,两个进程乒乓 | 200000 | 13070.7 ns |
| proc | 200000 | 13264.9 ns |
| thread,一个进程加一个线程 | 200000 | 13083.4 ns |
| thread | 200000 | 12811.5 ns |
测量口径需要先交代清楚:往返一次指的是「父进程写入一个字节,子进程读走之后再写回一个字节,父进程读回来」这一个完整的来回。计时使用 CLOCK_MONOTONIC,起点在循环之前,终点在循环之后,中间的每一次系统调用、每一次唤醒、每一次切换都计算在内。
三个模式测量到的不是同一件事,这一点决定了数字应该如何使用。self 模式在同一个进程内写管道再读回来,数据已经在管道缓冲区中,读取时不需要等待,因此它测量到的是纯系统调用开销,六百多纳秒。proc 与 thread 模式每次往返都要让出 CPU 再被唤醒,测量到的是系统调用开销加上唤醒与两次切换的开销,一万两千多纳秒。把两者相减再除以 2,一次切换的代价大约在六微秒上下,这个数字中包含唤醒路径上的调度器开销,不能全部计入切换本身。
进程与线程两行的差别很小,两次测量中 thread 一次比 proc 慢、一次比 proc 快,差值在百分之三以内。理论上线程切换不需要更换 cr3,应该更快一些,但在这条测量路径上,耗时的大头是唤醒与调度器本身,地址空间那一项所占的比例被压得很小。要测量出 cr3 的差别,需要把测量路径压缩得更短,用管道往返测量不出来。
第二组是绑核条件下的对照。
| 条件 | 往返次数 | 每次往返 | 折算单次切换 |
|---|---|---|---|
| taskset -c 0,两个进程都在 CPU0 | 200000 | 3907.5 ns | 约 1.6 微秒 |
| taskset -c 0 | 200000 | 3868.1 ns | 约 1.6 微秒 |
| taskset -c 0,1,可用两个核 | 200000 | 12631.2 ns | 约 6.0 微秒 |
| taskset -c 0,1 | 200000 | 12950.2 ns | 约 6.1 微秒 |
折算口径是「往返耗时减去 self 基线再除以二」。同样一次上下文切换,跨 CPU 唤醒的代价接近同一个核上的四倍。核数越多、任务越分散,这个差距就越大,原因在于调度器在唤醒时倾向于把任务放到空闲的 CPU 上,而那些 CPU 与当前 CPU 之间需要发送中断。
第三组是切换计数的四种构造方式。
| 负载 | 自愿切换 | 非自愿切换 | 说明 |
|---|---|---|---|
| usleep 循环两秒 | 201 | 0 | 每次睡醒被唤醒算一次自愿让出 |
| 忙循环两秒 | 1 | 16 | 一直想跑,被时间片抢下来 |
| sched_yield 循环两秒 | 1 | 16 | 队列里只有自己,让不出去 |
| 管道乒乓一秒 | 80163 | 0 | 每次阻塞在 read 上都算自愿让出 |
管道乒乓那一行最能说明这两个计数的含义。两个进程每秒钟各让出八万次,非自愿切换是零,因为它们每一次切换都是由自己阻塞在 read 上引起的。自愿切换来自等不到资源,非自愿切换来自被其他任务抢走,两者的触发方式完全不同。
第四组是机器层面的切换速率,观察的是 vmstat 的 cs 列。
[cocatrice@hcss-ecs-4cd1 lab10sched]$ ./pingpong proc 400000 > /dev/null &
[1] 1586
[cocatrice@hcss-ecs-4cd1 lab10sched]$ ./pingpong proc 400000 > /dev/null &
[2] 1588
[cocatrice@hcss-ecs-4cd1 lab10sched]$ vmstat 1 4
procs -----------memory---------- ---swap-- -----io---- -system-- ------cpu-----
 r  b   swpd   free   buff  cache   si   so    bi    bo   in   cs us sy id wa st
 3  0      0 261368 167248 1249928    0    0     0     6    0    1  0  0 100  0  0
 2  0      0 261416 167248 1249928    0    0     0     0 2099 926096  7 93  0  0  0
 0  0      0 261844 167248 1249928    0    0     0     0 8065 661638  6 66 28  0  0
 0  0      0 260104 167248 1249928    0    0     0     0  239  371  1  1 99  0  0
[cocatrice@hcss-ecs-4cd1 lab10sched]$ wait
[cocatrice@hcss-ecs-4cd1 lab10sched]$ vmstat 1 3
procs -----------memory---------- ---swap-- -----io---- -system-- ------cpu-----
 r  b   swpd   free   buff  cache   si   so    bi    bo   in   cs us sy id wa st
 1  0      0 259444 167248 1249928    0    0     0     6    0    1  0  0 100  0  0
 0  0      0 259460 167248 1249932    0    0     0   464  211  277  0  0 100  0  0
 0  0      0 261328 167248 1249932    0    0     0     0  191  309  0  0 100  0  0
两对乒乓进程把切换速率推到每秒钟九十万次,占满两个核;负载一停,切换速率立刻回落到每秒钟三百次上下,这部分是系统中本来就存在的后台活动。空闲机器上的 cs 不是零,读取这一列时要先测量一个空闲基线再作比较。
第五组是本机的情况,也就是 3.10 内核上运行着的 CFS 的运行队列实况。
[cocatrice@hcss-ecs-4cd1 lab10sched]$ sed -n '/^cpu#0/,/^  .avg_idle/p' /proc/sched_debug
cpu#0, 2600.000 MHz
  .nr_running                    : 1
  .load                          : 1024
  .nr_switches                   : 3939599374
  .nr_load_updates               : 1977290353
  .nr_uninterruptible            : -6635
  .next_balance                  : 29908.379727
  .curr->pid                     : 1599
  .clock                         : 25613689342.128861
  .cpu_load[0]                   : 1024
  .cpu_load[1]                   : 512
  .cpu_load[2]                   : 256
  .cpu_load[3]                   : 128
  .cpu_load[4]                   : 64
  .avg_idle                      : 626169
这份输出中的字段能够与第九节那个 runqueue 结构体对应起来。nr_running 是当前可运行任务数,nr_switches 是从开机到现在的累计切换次数,三十九亿次。cpu_load[0] 到 cpu_load[4] 是五个时间尺度上的平均负载,数值依次减半,说明这台机器最近一段时间越来越空闲。这几个数组元素说明负载是按照一段时间的平均值衡量的,而不是取当前值。
本机运行的是 CFS,运行队列的组织方式与 2.6 那两个优先级数组完全不同,因此第九到十四节讲的结构在这台机器上看不到,它们属于源码阅读的范围。本机能够看到的只有同名概念:同样存在一个 per-CPU 的运行队列,同样存在一个记录当前任务的指针,同样记录切换次数,只是挑选下一个任务使用的是红黑树上的虚拟运行时间,而不是位图加 140 条队列。
第六组是 nice 与 CPU 份额的对应关系,读数留在第十五节,这里把三组数字并排放一次。
| 参与竞争的任务 | nice | 权重 | 实测获得的时钟滴答 | 实测份额 | 权重占比 |
|---|---|---|---|---|---|
| 三个进程抢一个核 | 0 | 1024 | 891 | 89.1% | 89.1% |
| 同上 | 10 | 110 | 96 | 9.6% | 9.6% |
| 同上 | 19 | 15 | 13 | 1.3% | 1.3% |
| 两个进程抢一个核 | 0 | 1024 | 754 | 75.3% | 75.4% |
| 同上 | 5 | 335 | 247 | 24.7% | 24.6% |
第七组是多核分布与 CFS 的运行参数,读数留在第十八到二十节。
| 条件 | 每个进程拿到的时钟滴答 | 折算份额 |
|---|---|---|
| 四个纯计算进程全部钉在 CPU0 | 201、199、201、200 | 各约 25% |
| 四个纯计算进程允许使用两个核 | 409、426、413、424 | 各约 52% |
| 参数 | 本机取值 | 含义 |
|---|---|---|
| sched_latency_ns | 12000000 | 目标延迟,12 毫秒 |
| sched_min_granularity_ns | 10000000 | 最小粒度,10 毫秒 |
| sched_wakeup_granularity_ns | 15000000 | 唤醒抢占门槛,15 毫秒 |
| sched_nr_migrate | 32 | 一次平衡最多搬走多少个任务 |
| sched_migration_cost_ns | 500000 | 判断任务缓存是否还热的门槛 |
汇总脚本
前面几个程序各自输出一行结果,要比较不同条件就必须手动运行好几遍。把这项工作交给一个脚本,它把三种模式各运行五遍,算出平均值之后再输出一张表。
# 文件:/home/cocatrice/lab10sched/bench.sh
#!/bin/bash
# 把三种往返各跑五遍,输出一张均值表
# 用法:./bench.sh [往返次数]

cd "$(dirname "$0")"

ROUNDS=$1
if [ -z "$ROUNDS" ]; then
    ROUNDS=100000
fi

printf "%-8s %10s %14s\n" 模式 往返次数 每次往返
printf "%-8s %10s %14s\n" ---- -------- --------

for mode in self proc thread; do
    total=0
    for i in 1 2 3 4 5; do
        ns=$(./pingpong $mode $ROUNDS | awk '{print $(NF-1)}')
        total=$(echo "$total + $ns" | bc)
    done
    avg=$(echo "scale=1; $total / 5" | bc)
    printf "%-8s %10d %11s ns\n" "$mode" "$ROUNDS" "$avg"
done
前面那个 pingpong 的输出格式是固定的,脚本用 awk '{print $(NF-1)}' 取倒数第二个字段,也就是每次往返的纳秒数。运行五遍取平均值是为了消除单次测量的抖动,脚本本身不做任何性能统计,只是把重复的操作串接起来。
[cocatrice@hcss-ecs-4cd1 lab10sched]$ ./bench.sh 200000
模式   往返次数   每次往返
----       --------       --------
self         200000       664.6 ns
proc         200000     12823.4 ns
thread       200000     12733.5 ns
换一个往返次数再次运行,三行的相对关系保持不变,说明这个测量是稳定的。脚本只依赖 pingpong 与 bc,换一台机器把这两个准备好,就能直接测出那台机器上的数字。自己机器上的切换开销最好自己测量一遍,虚拟机、容器与不同代 CPU 之间的差距可以达到好几倍,此处的数字只能作为参考。
踩坑点
- 切换只发生在内核态。用户程序既不能发起切换,也看不到切换,能够做的只是通过系统调用把自己阻塞。
- 每个可运行的任务都必须拥有一条自己的内核栈。共用一条栈的结果是后一个任务的现场覆盖前一个任务的现场,任务被换回来时沿着已经写坏的路径继续执行。
- cr3 只在进程切换时更换。线程共享地址空间,切换时不需要改动它,这是线程切换开销低于进程切换的主要原因。
- TSS 中的 esp0 是进入内核时使用的栈指针,esp 是保存下来的内核栈指针,两者名字接近但用途不同,前者由内核在建立任务时写好,后者由切换过程读写。
- ljmp 的操作数是一个指向 GDT 任务门的选择子,任务的 TSS 放在偶数项上、LDT 放在随后的奇数项上,选择子的最低两位参与索引计算。
- 0.11 补充时间片的公式是 counter 的一半加上 priority,而不是直接补满 priority,这个设计让睡眠多、占用少的任务在下一轮拿到更多时间片。
- 0.11 在时钟中断中用 cpl 判断刚才是否处于内核态,处于内核态被打断时不立即切换。这是内核不可抢占时代的写法,与现代内核的可抢占设计不是一回事。
- nr_active 归零是交换两个队列的开关,它同时也是一个计数,出队时的减一必须与入队时的加一严格配对,否则交换永远无法触发。
- 位图清位之前必须先判断整条优先级队列是否为空。同一个优先级上可能排着多个任务,只有最后一个任务离开时,对应的位才应该清零。
- best_expired_prio 与 expired_timestamp 两个字段的位置并不显眼,但一个决定交换之后从哪条队列开始挑选任务,一个决定过期队列中的任务会不会被无限期拖延。
- 时间片是在任务下场的那一刻算好的,而不是上场时再算。交换指针那一步必须足够快,因此计算被挪到了前面。
- jmp_buf 中保存的 rbp、rsp、rip 是被 glibc 保护过的值,指针保护对其做了一次异或加循环左移,直接打印出来是混乱的,必须还原之后才能看出真实的地址。
- 同一份没有同步的共享写入代码,在 -O0 下每次结果都不同,在 -O1 下固定丢失一半,在 -O2 下反而常常是正确的。编译优化不改变代码的正确性,只是改变了错误出现的概率。
- sched_yield 在执行队列里没有别的任务时不会真正让出 CPU,自愿切换计数因此不增长,不能用它来验证代码中是否调用过让出函数。
- 上下文切换的开销与切换到哪个 CPU 密切相关,同一核上的往返耗时只有跨核的四分之一。测量这类数据要把绑核条件写清楚,否则数字没有可比性。
- 普通进程只能把 nice 往大调,往小调哪怕只是调回 0 也需要 root,setpriority 设成负值得到的是 Permission denied。
- getpriority 的合法返回值里包含 -1,判断调用是否出错必须配合 errno,只看返回值会把正常的 -1 当成失败。
- 亲和性是一道硬约束,绑核之后负载均衡不会把任务搬到核外,用绑核测出来的份额与不绑核是两回事。
- CFS 里 nice 影响的是权重而不是时间片长度,权重比就是长期 CPU 份额比,这一点与 O(1) 时代按 nice 算时间片长度的做法不同。
- 迁移线程是每个 CPU 一个的内核线程,它平时睡着,只在有任务要搬的时候被唤醒。
本篇总结(模拟面试问题)
问:上下文切换需要保存哪些内容?
核心要点:执行位置(rip、eflags)、栈指针、通用寄存器、段寄存器、地址空间(cr3)、浮点与向量状态,以及内核自身的现场。实际保存哪些内容取决于具体实现,硬件任务切换全存全取,现代内核只保存内核栈与内核路径上用到的寄存器,用户现场在进入内核时已经由硬件压栈。
问:为什么每个进程都需要自己的内核栈?
核心要点:内核代码可能在任意位置被打断,现场需要一块内存保存。多个任务共用一条内核栈时,后一个任务的现场会覆盖前一个任务留下的返回地址与局部变量,任务被换回来时沿着被写坏的路径继续执行,内核随即崩溃。
问:进程切换与线程切换的主要区别是什么?
核心要点:地址空间。进程各有各的页表,切换时 cr3 必须更换,页表缓存也要跟着处理;线程共享地址空间,cr3 相同,切换时不需要改动。其余的内核栈切换与寄存器保存恢复,两者都要执行。
问:Linux 0.11 是如何完成一次切换的?
核心要点:一条 ljmp 指令,操作数是指向 GDT 任务门的选择子。CPU 自动把当前所有寄存器的值写进旧任务的 TSS,再从新任务的 TSS 中装回寄存器,然后从新任务的 eip 处继续执行。switch_to 那段汇编只做了检查、更换 current 与发出指令这三件事。
问:后来的内核为什么放弃了硬件任务切换?
核心要点:四个原因。全存全取造成的浪费十分明显,很多字段根本用不到;它绑定在段式内存管理上,而 x86-64 已经废弃了段机制;一个任务一份 TSS 与线程模型存在冲突;保存内容由硬件决定,内核没有优化余地。
问:O(1) 调度器的 O(1) 体现在哪里?
核心要点:运行队列的优先级数组中,位图的每一位记录一条队列是否有任务。挑选下一个任务就是查找位图中最低位的 1,5 个机器字最多查 5 次,与任务数量无关;入队与出队都是链表操作加位操作,同样属于常数时间。
问:nr_active 这个字段有什么作用?
核心要点:它是优先级数组中任务数量的计数,同时也是交换两个队列的开关。活跃数组的 nr_active 归零意味着这一批任务已经跑完一轮,该交换指针了。有了这一个计数,判断数组是否为空是 O(1) 的操作,不需要去数 140 条队列。
问:bitmap 为什么是 5 个 unsigned long?
核心要点:优先级一共 140 个,每条队列需要一位来表示是否非空,一个机器字 32 位,140 除以 32 等于 4.375,向上取整得到 5,5 乘 32 是 160 位,多出来的 20 位闲置不用。
问:时间片耗尽的那一刻,内核执行了哪些动作?
核心要点:从活跃数组中出队,在链表中摘除、必要时清位图、nr_active 减一;给任务打上需要重新调度的标记;重算动态优先级与下一轮时间片;最后根据任务是否为交互式任务,决定进入过期队列还是留在活跃队列。
问:活跃队列与过期队列之间为什么要交换指针,而不是搬运数据?
核心要点:交换只需要修改两个指针,工作量与任务数量无关。如果搬运数据,每一次轮转都要遍历所有任务,O(1) 的设计就被破坏了。时间片在任务下场时已经算好,交换之后可以直接使用,不需要再做计算。
问:best_expired_prio 与 expired_timestamp 分别负责什么?
核心要点:前者记录过期队列中当前最高的优先级,交换之后马上就知道从哪条队列开始挑选任务,避免重新扫描 140 条队列。后者记录过期队列开始积压的时刻,用来判断是否应当停止对交互式任务的优待,防止过期队列中的任务等待过久。
问:自愿切换与非自愿切换有什么区别?
核心要点:自愿切换是任务自己让出 CPU,通常发生在请求的资源尚未到位、必须进入睡眠的时候;非自愿切换是任务还想继续运行却被调度器夺走了 CPU。前者来自等不到资源,后者来自被抢占,两者在 /proc/PID/status 中分开计数。
问:为什么管道乒乓的两个进程自愿切换计数能够达到每秒八万次?
核心要点:每一次往返中,进程写完数据之后要在 read 上等待对方,等不到就主动进入睡眠,这一次让出被记成自愿切换。整个往返路径上都是这种由「等待」引发的让出,因此两个进程的计数一起增长,非自愿切换保持为零。
问:把两个进程绑定到同一个核上,为什么往返耗时反而更短?
核心要点:唤醒路径变短了。位于同一个核上时,唤醒可以在当前运行队列中直接完成;分处两个核时,唤醒需要跨 CPU 发送中断通知对方,这部分开销占了跨核往返耗时的绝大部分。
问:setjmp 保存下来的 rbp、rsp、rip 为什么打印出来是乱的?
核心要点:glibc 对这三个寄存器做了指针保护,保存时先异或一个存放在 fs:0x30 的随机值,再循环左移 17 位,恢复时执行反向操作。这样做的目的是防止攻击者通过改写 jmp_buf 劫持控制流。要看清真实的地址,需要按照同样的规则还原。
问:nice 的取值范围是多少,谁能改?
核心要点:范围是 -20 到 19,数值越小优先级越高,默认值是 0。普通进程只能往大调,也就是主动让出 CPU;把 nice 调小到负值需要 root 或者带有相应能力的程序,否则 setpriority 返回权限错误。
问:nice 到静态优先级的换算公式是什么?
核心要点:静态优先级等于 120 加上 nice。nice 为 -20 时得到 100,为 19 时得到 139,正好落在普通任务的优先级区间里,与实时任务占用的 0 到 99 分开。
问:动态优先级的奖金从哪里来?
核心要点:来自睡眠平均值。内核记录任务在最近一段时间里有多大比例在睡觉,把它换算成一个 -5 到 +5 的修正值,再用静态优先级减去这个修正值得到有效优先级。睡得多的任务修正值为正,排队位置前移。
问:nice 的落点在过期队列这句话怎么理解?
核心要点:时间片的重新计算发生在任务下场进过期队列的那一刻,用的是由 nice 换算出来的静态优先级。也就是说 nice 决定的是任务每一轮能连续跑多久,多轮累积下来就形成了 CPU 时间的分配比例。
问:单核与多核的调度有什么差别?
核心要点:单核只有一个运行队列,调度器自己跟自己打交道;多核每个 CPU 一个运行队列,各自挑各自的任务,因此多出一件单核没有的事,也就是判断哪个 CPU 忙哪个 CPU 闲,并把任务从忙的队列搬到闲的队列上。
问:负载因子为什么要做平滑?
核心要点:可运行任务的瞬时值跳动很大,直接拿它做搬迁决策会让任务来回搬,搬一次缓存就冷一次。负载因子用指数平滑把历史样本按时间衰减加权,得到的值反映趋势而不是瞬时波动,搬迁决策因此稳定。
问:一个任务是怎么被搬到另一个 CPU 上的?
核心要点:发现不平衡的一方挑出可搬的任务,把它挂进待搬清单,记下目标 CPU,然后唤醒目标 CPU 上的迁移线程;迁移线程在自己这边把任务从清单取出,插入本地的运行队列。整个流程由目标 CPU 执行落地,避免跨 CPU 直接操作别人的队列。
问:CFS 的 vruntime 是什么,它为什么能让 nice 影响份额?
核心要点:vruntime 是任务累计运行时间的加权版本,权重越大增长越慢。调度器永远挑 vruntime 最小的任务,于是权重大的任务可以跑更久才追上别人,长期下来分到的 CPU 时间与权重成正比。nice 通过权重表影响这个过程,不再直接决定时间片长度。
问:O(1) 调度器为什么被 CFS 取代?
核心要点:它的交互式判断依赖一整套启发式参数,负载形态一变就要重新调参,而且这套规则可以被刻意刷分;时间片与优先级的分配只能做到近似公平。CFS 用 vruntime 与红黑树把公平写成了一条可验证的规则,不再需要猜测谁是交互式任务。
参考
- 调度总览,调度策略与调度类都在这一页:https://man7.org/linux/man-pages/man7/sched.7.html
- sched_yield 手册页,让出 CPU 的确切语义:https://man7.org/linux/man-pages/man2/sched_yield.2.html
- sched_setaffinity 手册页,绑核相关的系统调用:https://man7.org/linux/man-pages/man2/sched_setaffinity.2.html
- taskset 命令手册页,本次实测用的绑核工具:https://man7.org/linux/man-pages/man1/taskset.1.html
- pipe 手册页,管道容量与阻塞行为:https://man7.org/linux/man-pages/man2/pipe.2.html
- clone 手册页,进程与线程在系统调用层的分界:https://man7.org/linux/man-pages/man2/clone.2.html
- pthreads 手册页,线程与进程共享资源的总览:https://man7.org/linux/man-pages/man7/pthreads.7.html
- pthread_mutex_lock 手册页,本次对照实验用的互斥锁:https://man7.org/linux/man-pages/man3/pthread_mutex_lock.3.html
- setjmp 手册页,用户态保存与恢复现场的接口:https://man7.org/linux/man-pages/man3/setjmp.3.html
- clock_gettime 手册页,本次计时用的单调时钟:https://man7.org/linux/man-pages/man2/clock_gettime.2.html
- proc 手册页,status 与 sched_debug 的字段说明:https://man7.org/linux/man-pages/man5/proc.5.html
- vmstat 手册页,cs 列与 in 列的含义:https://man7.org/linux/man-pages/man8/vmstat.8.html
- gcc 优化选项,-O1 到 -O3 各自打开了什么:https://gcc.gnu.org/onlinedocs/gcc/Optimize-Options.html
- execve 手册页,进程映像替换时环境的传递:https://man7.org/linux/man-pages/man2/execve.2.html
- setpriority 与 getpriority 手册页,nice 的读写接口与权限错误:https://man7.org/linux/man-pages/man2/setpriority.2.html
- getpriority 手册页,-1 与 errno 的那个坑:https://man7.org/linux/man-pages/man2/getpriority.2.html
- nice 命令手册页,启动进程时指定 nice 值:https://man7.org/linux/man-pages/man1/nice.1.html
- renice 命令手册页,修改已运行进程的 nice 值:https://man7.org/linux/man-pages/man1/renice.1.html
- capabilities 手册页,CAP_SYS_NICE 的定义:https://man7.org/linux/man-pages/man7/capabilities.7.html
转载自 CSDN-专业IT技术社区
原文链接:https://blog.csdn.net/weixin_63897076/article/details/166796733

