

论文题目:UniFault: A Fault Diagnosis Foundation Model from Bearing Data(UniFault:基于轴承数据的故障诊断基础模型)
版本:arXiv:2504.01373v2
摘要:现有故障诊断模型往往针对特定工况设计,跨数据集泛化能力有限;而工业故障数据规模小、来源异构,不同系统的采样频率、通道数量和运行条件差异很大,使得基础模型很难直接套用。本文提出 UniFault,通过统一的数据预处理流程、跨数据集时间融合和基于对比学习的自监督预训练,构建一个可迁移的 Transformer 故障诊断基础模型。UniFault 在超过 690 万个样本上预训练,并通过少量标注样本进行下游微调。实验表明,它在多个真实故障诊断数据集上获得了较强的 few-shot 性能。
一、为什么故障诊断也需要 Foundation Model?
传统故障诊断通常遵循“一个数据集训练一个模型”的范式。问题在于,不同机器的数据分布差异非常明显:传感器数量不同、采样频率不同、信号长度不同、转速和负载不同,即使都是“外圈故障”,频谱和时域形态也可能相差很大。
Foundation Model 的思路则是:
先在大规模、多来源数据上学通用表示,再用极少量目标域标签做适配。
UniFault 正是沿着这条路线设计。作者希望得到一个统一模型 (f_\theta),它能够:
-
接收来自不同数据集的异构振动数据;
-
提取尽量与具体数据集无关、但保留故障信息的表示;
-
到新任务上只用少量标注样本完成 Fine-tuning。
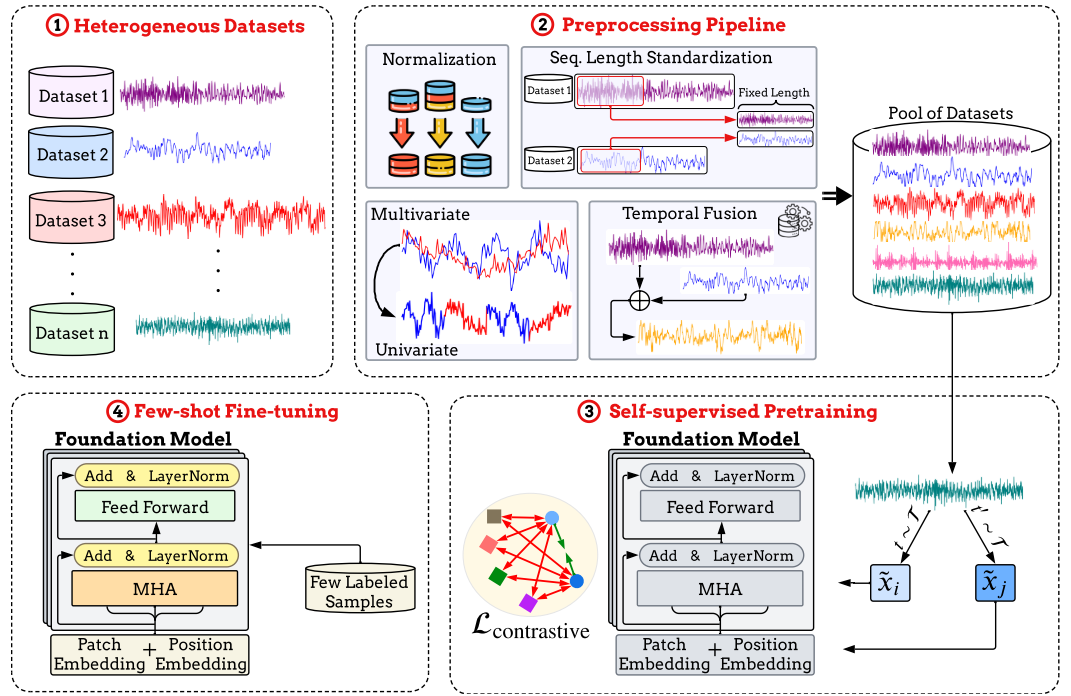
论文 Figure 1:UniFault 整体框架
Figure 1 把整个流程分成四步:
异构数据集收集 → 数据统一 → 自监督预训练 → Few-shot Fine-tuning。
这篇论文真正的核心并不是简单“用了 Transformer”,而是解决两个基础模型在故障诊断里绕不开的问题:
数据如何统一?跨数据集分布差异如何缓解?
二、第一步:把异构故障数据统一到同一种输入格式
UniFault 的预训练数据来自多个轴承故障诊断数据集,包括 IMS、UO、CWRU、PU、Torino、XJTU-SY、MFPT、FEMTO、KAIST、HIT-SM、CNC 等来源,覆盖自然退化、人工故障、不同转速、不同负载和不同采样频率。
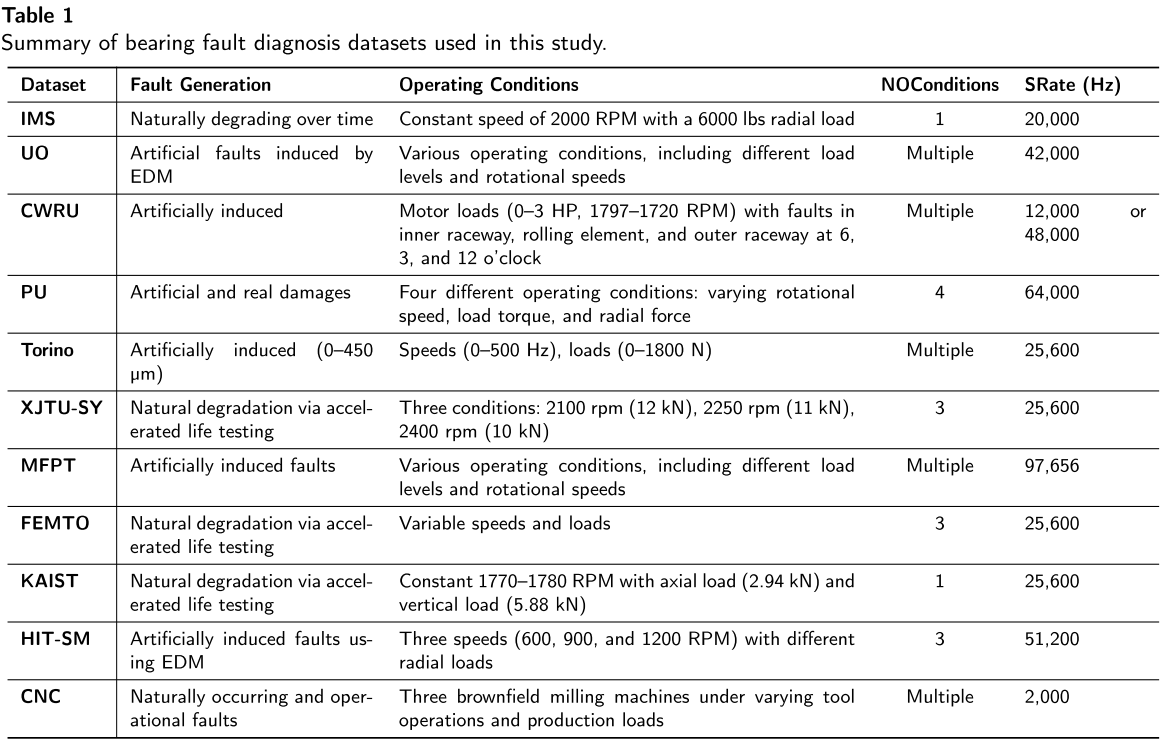
论文 Table 1:用于研究的轴承故障数据集汇总
作者指出,原始数据至少存在五种不一致:采样率不同、序列长度不同、通道数不同、数值尺度不同,以及跨数据集分布不同。因此预处理不是简单 resize,而是分阶段处理。
首先,每个数据集在任何归一化或重采样之前就划分 Train / Validation / Test,避免测试数据的统计量泄漏到训练过程。
接着,将信号统一到固定时间分辨率,并进一步把每条序列下采样到 1024 个时间步,从而给 Transformer 一个固定长度输入。
对于通道数量不一致的问题,UniFault 在预训练阶段采用一种很直接的办法:
把多变量信号的每个通道独立看作一个一维序列。
也就是说,如果某个数据集有 3 个传感器通道,并不要求模型固定接收 3 通道,而是把每个通道都转为:
这样不同数据集就可以共享同一套 Transformer 输入接口。
最后,信号使用仅由训练集统计量计算的 Min-Max 参数做归一化,继续避免 Validation / Test 泄漏。
需要注意的是,论文同时说明:预训练阶段将多通道拆成独立单通道,而 Fine-tuning 时保留目标数据集原始通道结构。因此这里的“channel invariant”主要服务于大规模预训练的数据统一,而不是宣称多通道关系在所有阶段都被完全舍弃。
三、最特别的设计:Cross-Domain Temporal Fusion
如果只把不同数据集全部丢到一起训练,模型仍可能学到很强的数据集身份特征。比如 Dataset A 和 Dataset B 的传感器增益、安装方式和背景频谱差异很大,模型很容易先学会“这是哪个数据集”,而不是“这是什么故障”。
为缓解这种 distribution shift,作者提出 Cross-Domain Temporal Fusion(跨域时间融合)。
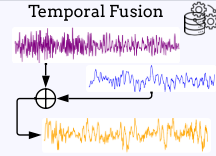
论文 Figure 1 中的 Temporal Fusion 模块
设两个来自不同数据集的一维信号为:
以 () 为主信号时,第 (i) 个时间点的融合结果为:
其中 (),保证主数据集仍然占主要成分;另一数据集不是直接逐点相加,而是通过局部 Moving Average 提供时间邻域信息。
作者还做双向融合:
这样可以构造大量位于两个原始数据域之间的“中间域样本”。
直观理解就是:
Dataset A ──────┐
                ├──→ A 主导的混合域
Dataset B ──────┘

Dataset B ──────┐
                ├──→ B 主导的混合域
Dataset A ──────┘
作者的目标并不是让这些合成信号具有严格的物理故障含义,而是让模型在预训练时看到更连续、更丰富的域变化,从而减少“某个故障只和某个数据集纹理绑定”的风险。
这一点也是 UniFault 与普通“把很多数据集合并起来做预训练”的主要区别。
四、自监督预训练:不是重建,而是 Contrastive Learning
UniFault 的 Backbone 是 Transformer。统一后的一维序列先投影到 (d) 维 Token embedding,再加入可学习的位置编码:
随后经过多层 Transformer,每层包含 Multi-Head Self-Attention、Feed-Forward Network 和 LayerNorm。
作者认为 Transformer 特别适合故障信号,是因为轴承故障常表现为重复冲击、周期或准周期瞬态,而实际工况变化会让这些冲击间隔发生变化。Self-Attention 不受固定卷积感受野限制,更容易建立长距离时间依赖。
UniFault 没有采用 Masked Reconstruction,而采用对比式自监督学习。
对于原始信号 (Xi),生成两个增强视图:
增强方式主要有两种。
第一种是 Temporal Shifting:对序列做循环时间平移,使模型对故障冲击出现的绝对相位不敏感。
第二种是 Scaling with Sensor Jitter:通过幅值缩放加随机噪声模拟传感器增益、标定和背景扰动的变化。
两个增强后的同源信号经过同一个 Encoder:
训练目标是:
同一个原始信号的两个增强视图应该靠近,而 Batch 中其他信号应该远离。
论文使用基于 cosine similarity 和 temperature () 的 Contrastive Loss。作者特别解释了 (
) 的作用:较小的温度会强调细粒度故障差异,较大的温度则鼓励更宽松的跨工况不变性。
UniFault 最终希望学到的不是某一个数据集的分类器,而是:
一个可复用的故障时序表示。
4.1 模型规模
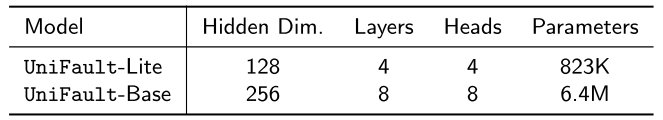
论文 Table 2:UniFault-Lite 与 UniFault-Base
| 模型 | Hidden Dim | Transformer Layers | Heads | 参数量 |
|---|---|---|---|---|
| UniFault-Lite | 128 | 4 | 4 | 823K |
| UniFault-Base | 256 | 8 | 8 | 6.4M |
预训练使用 AdamW,Batch Size = 512,只训练 5 epochs。由于预训练数据量超过 690 万个样本,即使 Epoch 数不高,总训练样本覆盖量依然很大。
五、Few-shot Fine-tuning:到底能少到什么程度?
预训练完成以后,UniFault 并不是直接 Zero-shot 分类,而是进入第二阶段:
用少量目标数据进行监督 Fine-tuning。
论文的问题定义可以理解为:
其中 () 是预训练得到的参数,再使用目标任务少量带标签数据训练分类 Adapter / Head,并对模型进行最小化适配。
主 Few-shot 协议中,作者对 IMS 随机选取 100 个样本进行微调;对 PU 和 CNC 使用约 1% 数据。这些 Few-shot 样本被明确排除在预训练数据之外。Fine-tuning 的 Batch Size 为 64,训练 200 epochs,所有实验重复 3 次并报告 mean ± std。
这里有一点值得注意:论文 Section 4.1 的一处文字称 Fine-tuning 选择 IMS、UO 和 PU,但 Section 4.3 的 Few-shot 描述以及 Table 3 实际报告的是 IMS、PU 和 CNC(M01/M02/M03)。因此阅读结果时应以具体实验表和协议为准,而不要把那一句数据集列表直接当作最终实验设置。
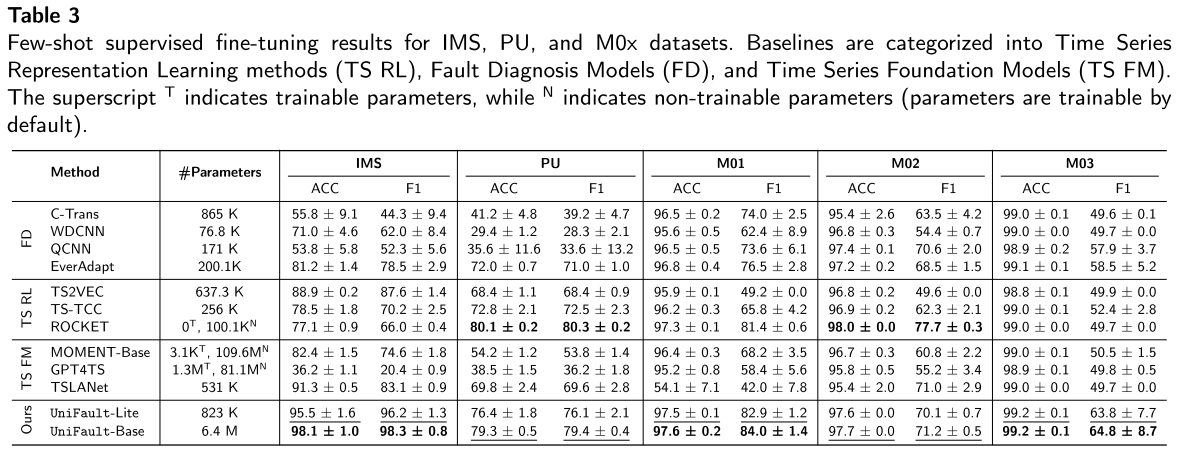
论文 Table 3:Few-shot Fine-tuning 主实验结果
UniFault-Base 在 IMS 上达到:
Accuracy = 98.1 ± 1.0%
F1 = 98.3 ± 0.8%
UniFault-Lite 为 95.5% / 96.2%。
PU 更难,UniFault-Base 达到 79.3% Accuracy / 79.4% F1;Lite 为 76.4% / 76.1%。
在 CNC 的三个机器 M01、M02、M03 上,Accuracy 普遍较高,但 F1 明显比 Accuracy 低,说明类别分布或分类难度存在不均衡,仅看 Accuracy 容易高估真实性能。
整体上,UniFault 在作者比较的传统 FD 模型、Time-Series Representation Learning 方法和通用 Time-Series Foundation Models 之间表现出较强稳定性。
5.1 Temporal Fusion 到底有没有用?
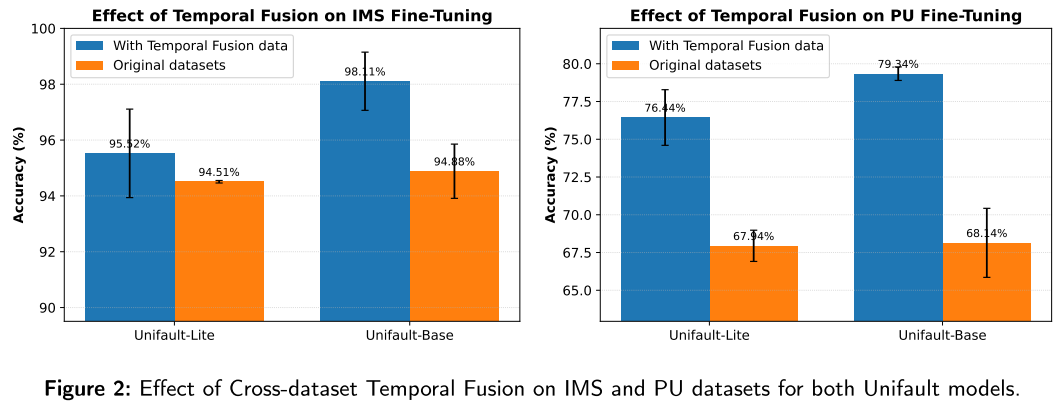
论文 Figure 2:Cross-dataset Temporal Fusion 消融实验
IMS 上:
-
Lite:94.5% → 95.5%
-
Base:94.9% → 98.1%
PU 上提升更加明显:
-
Lite:67.9% → 76.4%
-
Base:68.1% → 79.3%
说明 Cross-Domain Temporal Fusion 对异构程度更高的 PU 数据集帮助尤其明显。作者认为它通过生成中间域样本增强了预训练阶段的域覆盖能力。
5.2 Transformer 是不是越深越好?
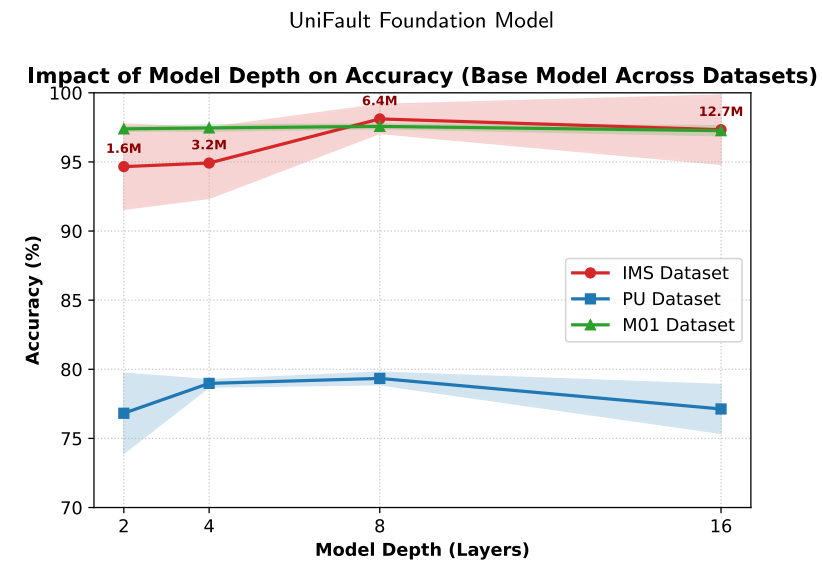
论文 Figure 3:UniFault-Base 深度消融
IMS 从 2 层时约 94.7% 上升到 8 层时 98.1%;PU 从 76.8% 上升到 8 层时 79.3%,但 16 层反而回落到 77.1%;M01 基本稳定在约 97.5%。
因此论文的结论并不是“越大越好”,而是 8 层左右提供较好的性能—效率折中。数据复杂度较低时,继续增加模型深度收益很有限。
5.3 真正的 K-shot:1-shot 能做到多少?
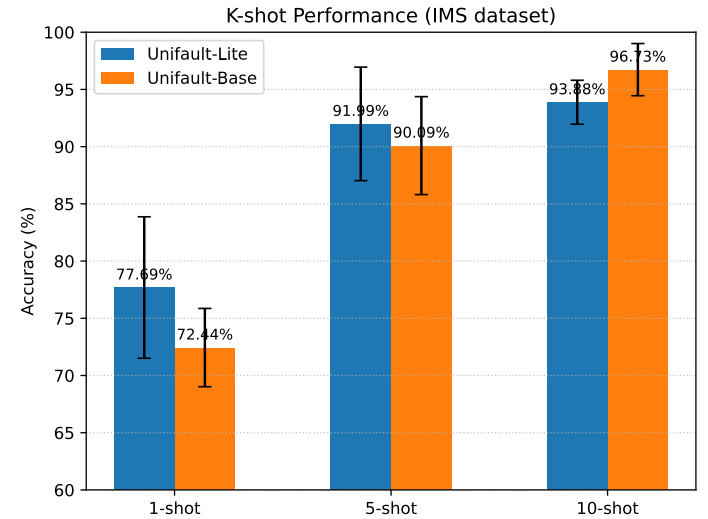
论文 Figure 5:IMS 数据集上的 1-shot / 5-shot / 10-shot
| K-shot | UniFault-Lite | UniFault-Base |
|---|---|---|
| 1-shot | 77.69% | 72.44% |
| 5-shot | 91.99% | 90.09% |
| 10-shot | 93.88% | 96.73% |
一个很有意思的现象是:**1-shot 下 Lite 反而比 Base 更好。**作者认为,小模型在极端低数据条件下更容易适配;当样本增加到 10-shot 后,Base 的容量优势开始显现。
因此 Foundation Model 不意味着“大模型在任何数据量下都更优”,标签预算本身也决定了最合适的模型规模。
5.4 表征空间真的变好了吗?
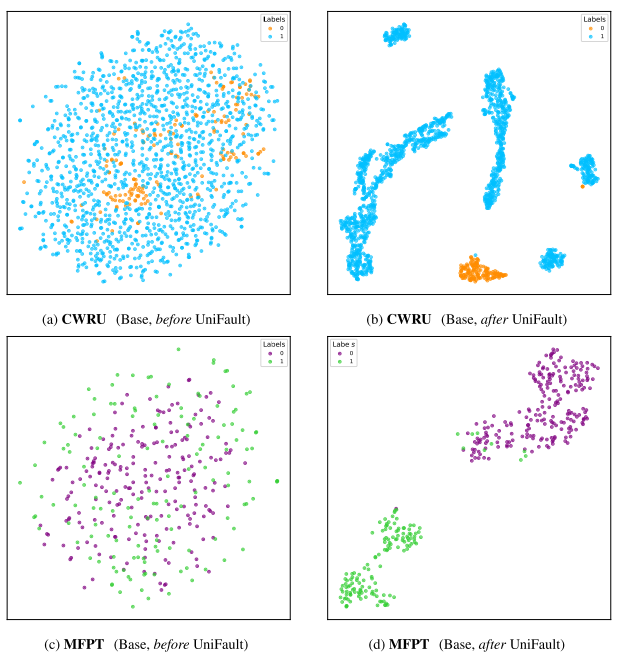
论文 Figure 4:CWRU 与 MFPT 在 UniFault 前后的 t-SNE
作者比较同一个 Base 模型在 UniFault 预训练前后的倒数第二层表示。预训练前,不同类别大量交叠;UniFault 后,类内特征更加紧凑、类间距离更明显。
这只能作为定性证据,因为 t-SNE 会扭曲全局几何结构,但至少说明预训练改变了特征空间,使分类边界更容易形成。
六、总结:UniFault 的价值不只是“大数据 + Transformer”
如果把 UniFault 压缩成一句话:
把大量异构轴承数据先统一,再主动构造跨域中间样本,用对比学习训练一个通用 Transformer Encoder,最后靠极少目标标签完成故障诊断适配。
论文最值得关注的三点分别是:
第一,Channel-Invariant + 固定 1024 长度解决“数据格式不同”;
第二,Cross-Domain Temporal Fusion 解决“数据分布不连续”;
第三,Contrastive SSL 解决“预训练没有足够统一标签”。
从结果来看,UniFault-Base 在 IMS few-shot 主实验达到 98.1% Accuracy,在严格 K-shot 设置下从 1-shot 的 72.44% 提升到 10-shot 的 96.73%;Temporal Fusion 在 PU 上给 Base 带来约 11 个百分点的提升,说明作者提出的数据层策略并非可有可无。
计算成本也不算夸张。论文 Table 4 报告 Lite 训练约 2374 s、0.66 GPU hours、峰值显存 0.82 GB;Base 为 3491 s、0.97 GPU hours、2.06 GB。相比超大语言模型意义上的 Foundation Model,UniFault 实际上更像一个面向故障诊断的中小型预训练通用 Encoder。
这篇论文也有几个值得继续追问的问题。首先,Foundation Model 的“通用性”目前主要通过轴承数据和少数下游数据集验证,还不能等价为跨所有机械设备的统一故障模型。其次,把多通道在预训练时拆成独立单通道虽然方便统一输入,也可能损失真实的跨传感器耦合信息。第三,Cross-Domain Temporal Fusion 在统计意义上确实提高了泛化,但合成信号是否始终具有合理的物理意义,论文并没有给出严格证明。
作者在结论中进一步提出未来方向,包括引入 Stream-of-Quality(SoQ)做在线多模态故障诊断、扩展到长期故障演化预测,并向知识驱动的预测健康管理系统发展。
所以 UniFault 最值得借鉴的并不是单个 Transformer 模块,而是它背后的工程范式:
异构数据统一 → 跨域数据扩展 → 无标签预训练 → 少样本快速适配。
这条路线相比“为每个轴承数据集重新设计一个故障分类网络”,更接近真正可扩展的工业基础模型思路。
转载自 CSDN-专业IT技术社区
原文链接:https://blog.csdn.net/LJ1147517021/article/details/167223021

