

Paperless-ngx部署实战:PostgreSQL、OCR与文档归档完整教程
前言
Paperless-ngx 适合解决一个很具体的问题:纸质文件、扫描 PDF、图片和各类电子资料虽然已经数字化,但如果只是散落在文件夹里,检索、分类和长期归档依然很麻烦。它把 OCR、全文搜索、标签、元数据和文档归档集中到一个 Web 系统中,更适合作为长期文档库使用。
本文按现有实操顺序完整展开:先准备 Docker、PostgreSQL 和 Redis 环境,再创建专用数据库用户,通过 Docker Compose 启动 Paperless-ngx、Tika 和 Gotenberg,并使用 9981 端口访问 Web 界面。
本地服务启动后,会继续完成用户注册、界面调整、文档上传、查看和编辑等实际操作,确认系统不只是“容器在运行”,而是真的能承担文档管理任务。
最后再处理局域网之外的访问需求,让这套文档库可以从其他设备继续使用。整篇重点放在“部署—上传—识别—管理—检索—远程访问”这条完整链路,而不是单纯介绍 Paperless-ngx 有多少功能。
对于第一次部署的人来说,把数据库连接、Redis、OCR 组件和 Web 服务分开理解会更容易。哪一层出问题,就回到哪一层检查,而不是看到页面打不开就把所有组件一起重装。这样也更适合后续做长期维护和备份。更稳。
1. 为什么我会想把文档重新管起来
很多人说“无纸化”,第一反应是把纸质文件扫成 PDF。但我自己真正用下来,最麻烦的从来不是扫描,而是后面怎么找。
文件一多以后,靠文件名和文件夹其实很吃记忆。哪张发票是哪一年的、某份合同到底放在哪个目录、扫描件里有没有某个关键词,这些问题一多,纸虽然没了,混乱还在。
Paperless-ngx 更像是一套文档管理系统,而不是一个普通文件夹。它能把扫描件、PDF、图片等资料经过 OCR 后变成可搜索内容,再配合标签、分类、元数据和规则做长期管理。
1.1 我更看重的几个能力
- OCR,把扫描件和图片里的文字变成可检索内容;
- 标签和分类,让资料不只靠文件名管理;
- 全文搜索,按内容直接找文档;
- 多格式导入,包括 PDF、JPEG、PNG、TIFF;
- 自托管,文件和数据保存在自己的服务器;
- Web 界面,方便多设备使用;
- 自动化工作流,可以继续接邮件、API 和文档转换服务。
Paperless-ngx 的技术架构里还涉及 Django、数据库、Redis、Tesseract、Tika 和 Gotenberg 等组件。
对我来说,这套东西真正有用的地方,是把“文件存在哪里”和“文件里写了什么”这两件事连起来。
2. 部署前先把环境准备好
2.1 硬件和 Docker
原环境要求里,建议至少准备:
| 组件 | 要求 |
|---|---|
| CPU | 2 核以上,建议 4 核 |
| 内存 | ≥ 2 GB,建议 4 GB |
| 存储 | 至少 10 GB 可用空间 |
| 磁盘 | SSD 更适合 OCR 和搜索 |
先检查 Docker 和 Compose:
# 检查 Docker
docker --version        # ≥ 20.10

# 检查 Docker Compose
docker compose version   # ≥ v2.5(或 docker-compose ≥ 1.29)
首次拉取镜像还需要能正常联网,同时要确保 Web 访问端口可用。
2.2 PostgreSQL 和 Redis
这套部署使用 PostgreSQL 和 Redis。
Redis 负责任务队列和缓存,PostgreSQL 用来保存 Paperless-ngx 的业务数据。
我会把这两个基础服务先准备好,再继续启动 Paperless-ngx,这样后面日志里出现连接问题时,也比较容易判断是哪一层出了问题。
3. 先在 PostgreSQL 创建专用用户
不建议所有应用都直接共用 postgres 超级用户,所以这里先单独创建 paperless 用户和数据库。
进入 PostgreSQL 的 psql 后执行:
-- 1. 创建用户(角色)
CREATE USER paperless WITH LOGIN PASSWORD 'Sj***520!';

-- 2. 创建数据库(如果还没建)
CREATE DATABASE paperless OWNER paperless;

-- 3. (可选)授予权限
GRANT ALL PRIVILEGES ON DATABASE paperless TO paperless;
这里最重要的是数据库用户名和密码要和后面的 docker-compose.yml 保持一致。
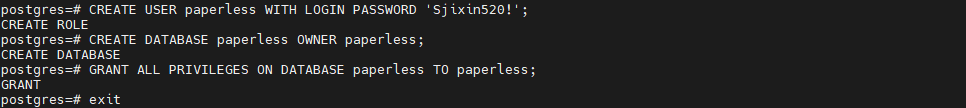
单独给应用建用户的好处很直接:权限边界更清楚,也更方便以后排查和维护。
4. 用 Docker Compose 部署 Paperless-ngx
4.1 检查 Docker
先确认 Docker:
docker --version

4.2 创建目录
执行:
mkdir -p /docker/paperless
chmod -R 777 /paperless
接着创建 docker-compose.yml:
vi docker-compose.yml
Compose 配置如下:
version: "3.6"
services:
  webserver:
    image: ghcr.io/paperless-ngx/paperless-ngx:2.19.6
    restart: unless-stopped
    ports:
      - "9981:8000"
    volumes:
      - ./data:/usr/src/paperless/data
      - ./media:/usr/src/paperless/media
      - ./export:/usr/src/paperless/export
      - ./consume:/usr/src/paperless/consume
    environment:
      # 改为指向内部 redis 容器
      PAPERLESS_REDIS: redis://:my_redis_password@redis:6379
      PAPERLESS_DBHOST: 192.168.42.140   # 数据库仍用外部
      PAPERLESS_DBUSER: paperless        # 输入刚建好的账号密码
      PAPERLESS_DBPASS: Sjixin520!
      PAPERLESS_DBNAME: paperless
      PAPERLESS_TIKA_ENABLED: 1
      PAPERLESS_TIKA_ENDPOINT: http://tika:9998
      PAPERLESS_TIKA_GOTENBERG_ENDPOINT: http://gotenberg:3000

  redis:
    image: redis:7-alpine
    restart: unless-stopped
    command: redis-server --requirepass my_redis_password
    # 如果需要持久化,可加 volume

  tika:
    image: apache/tika:latest
    restart: unless-stopped

  gotenberg:
    image: gotenberg/gotenberg:8.19
    restart: unless-stopped
这套配置里包括:
- Paperless-ngx Web 服务;
- Redis;
- Tika;
- Gotenberg;
- 外部 PostgreSQL 数据库;
9981:8000Web 端口映射;data / media / export / consume四个目录。
我会特别留意数据库地址、用户名和密码,因为这些值只要和前面 PostgreSQL 不一致,容器虽然能启动,应用也未必能正常工作。
4.3 启动容器
执行:
docker-compose up -d

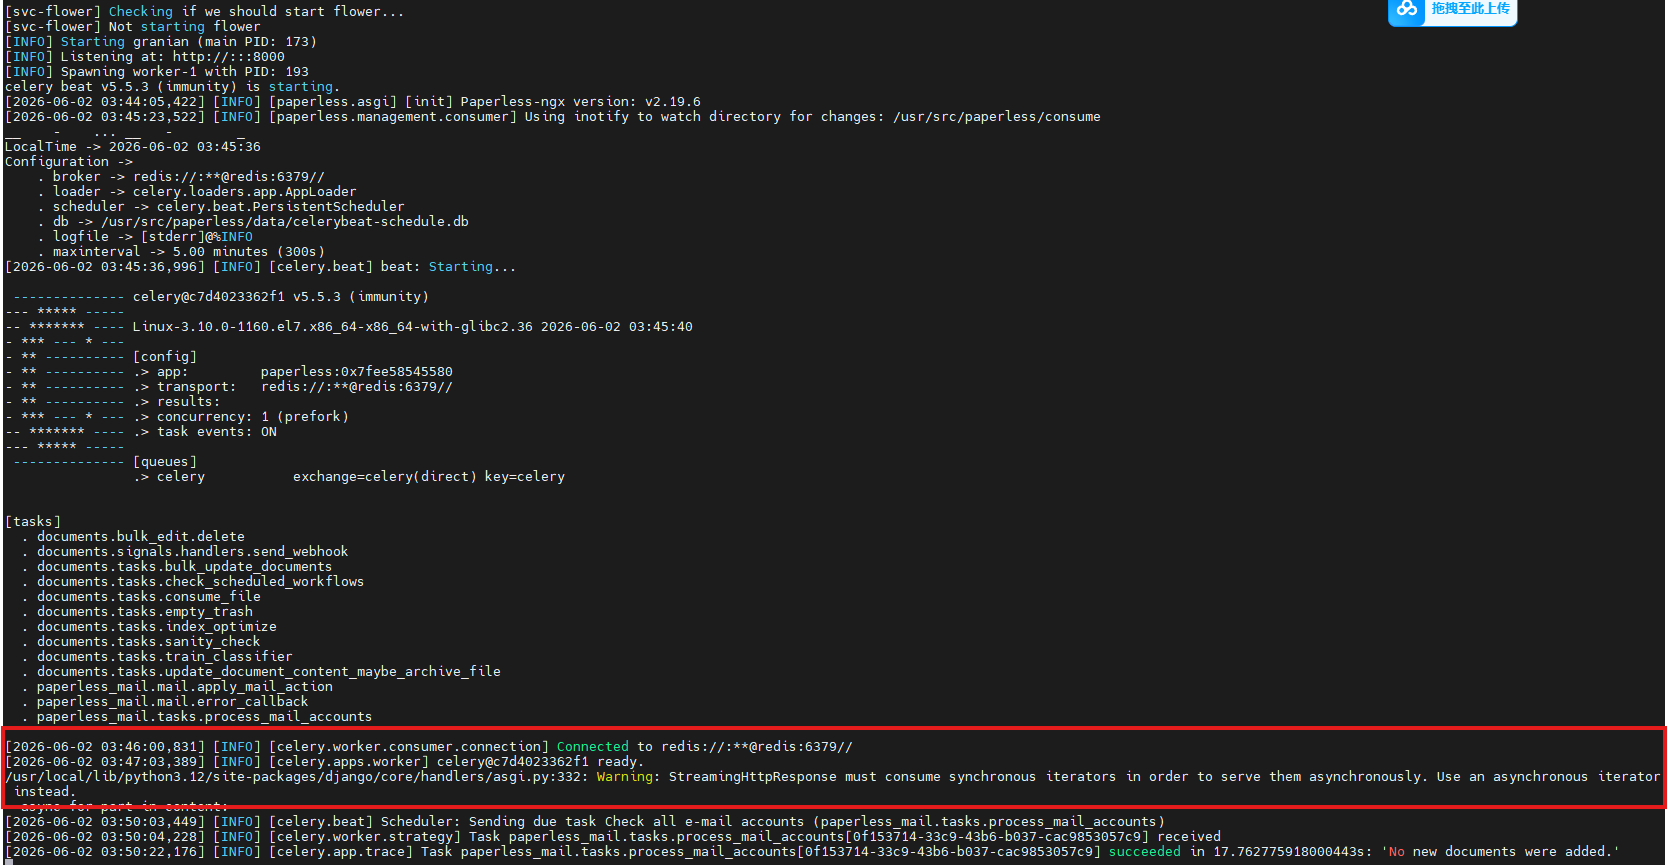
然后看日志:
docker logs -f paperless-webserver-1
如果日志正常,再继续往下:
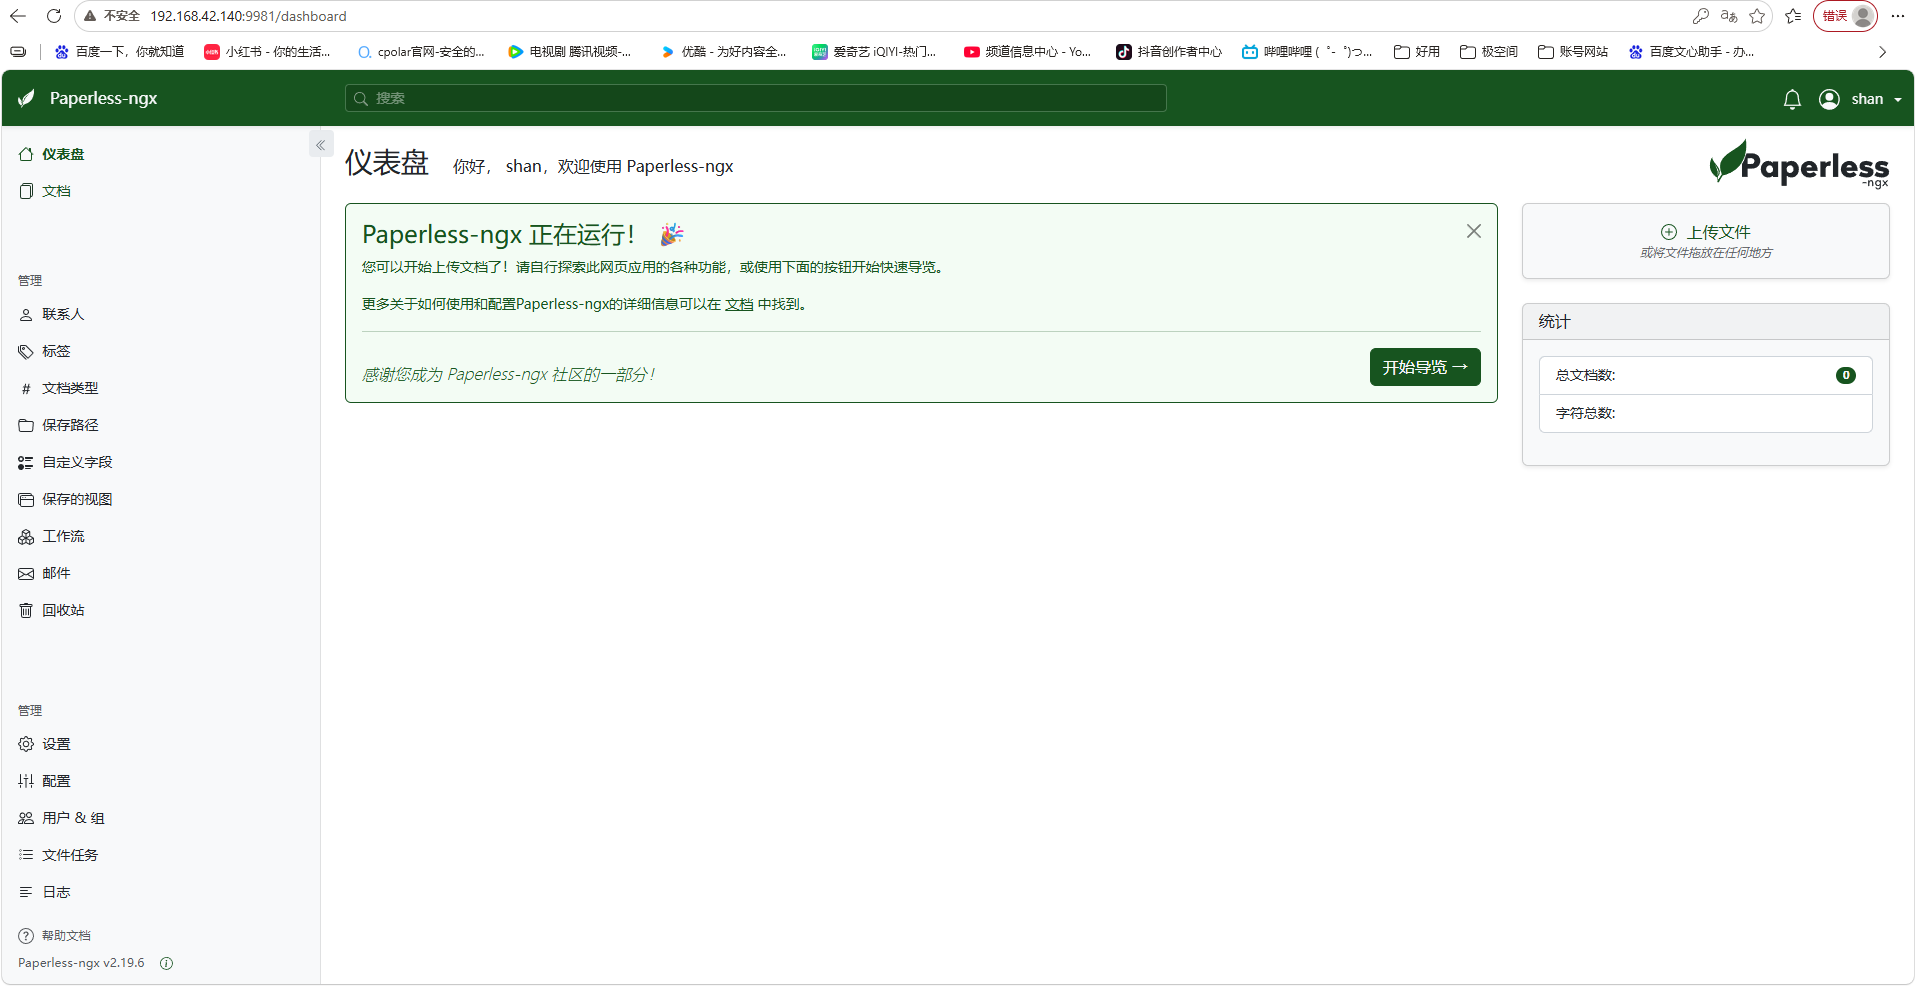
浏览器访问:
http://IP:9981
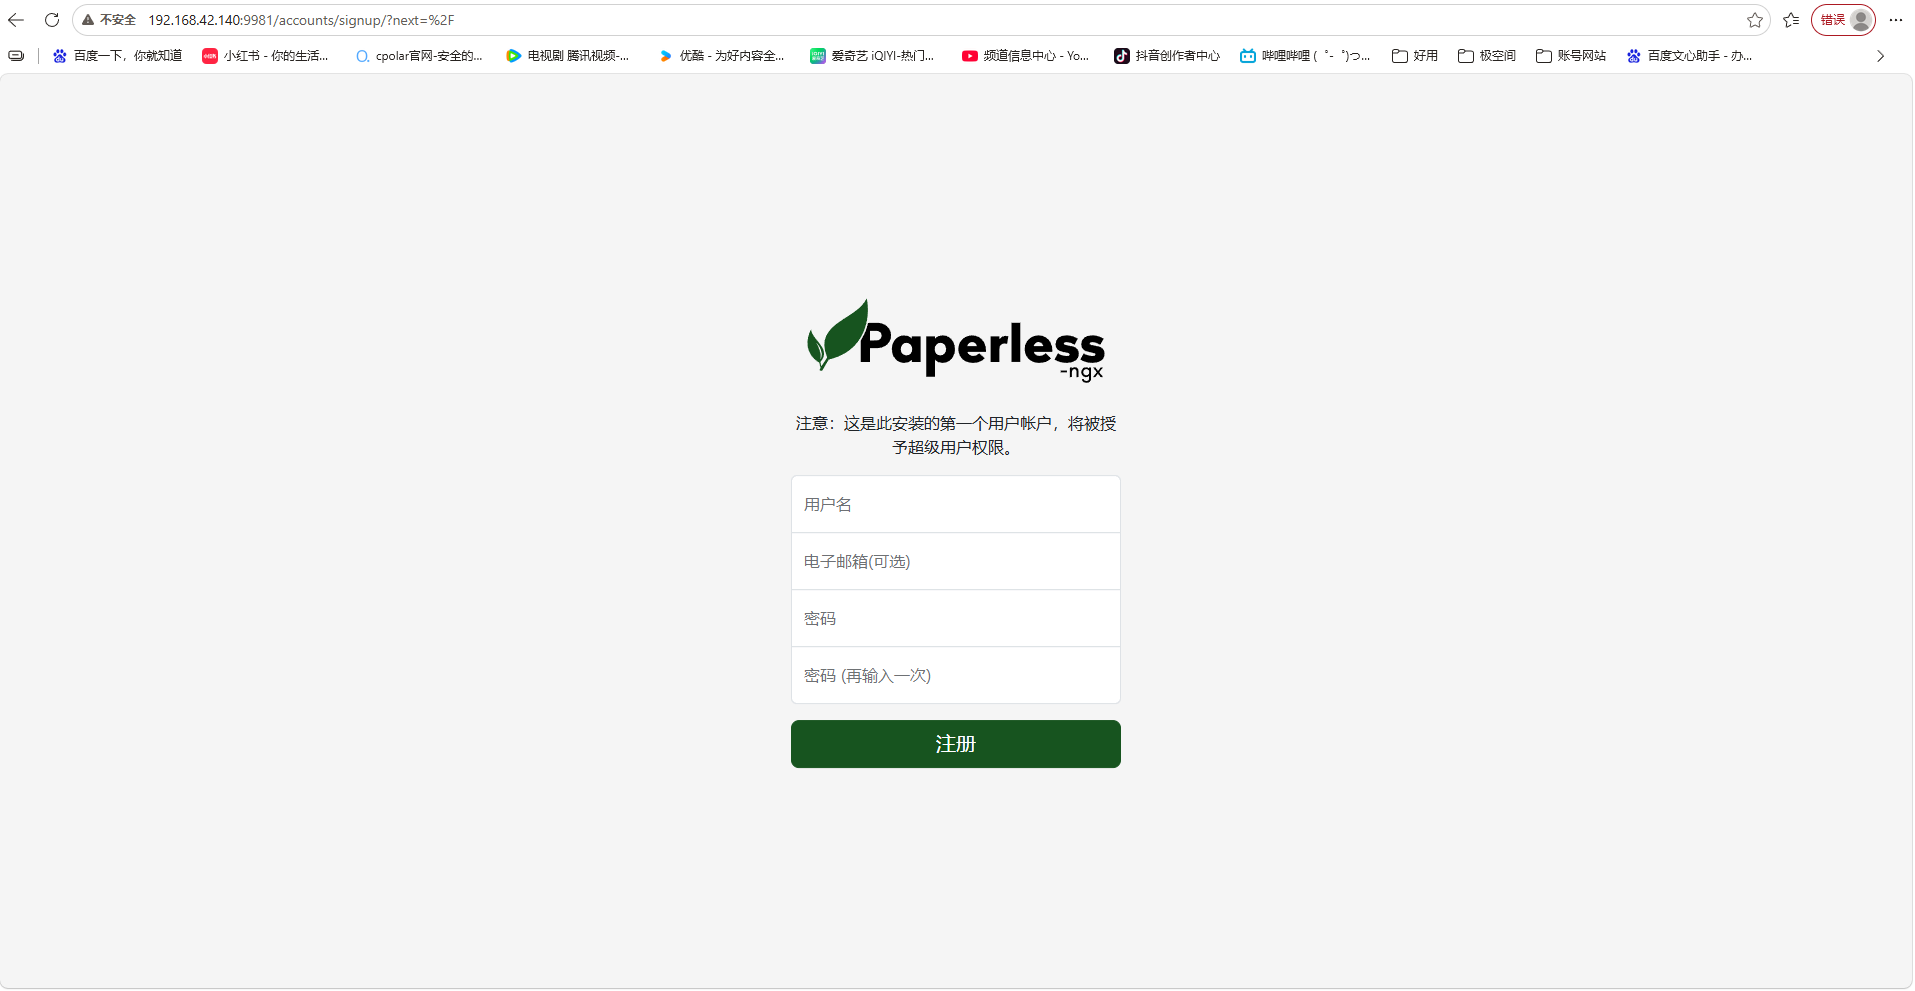
到这里,我只会认为“Paperless-ngx 页面已经能打开”,真正能不能用,还要继续上传文档验证。
5. 实际使用 Paperless-ngx
5.1 注册并登录
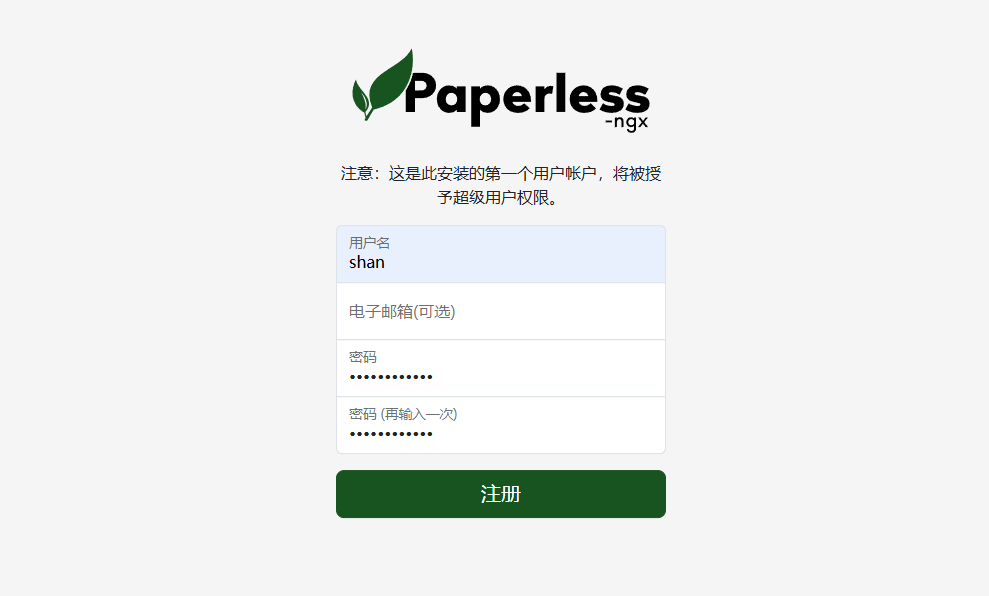
页面打开以后先注册用户:
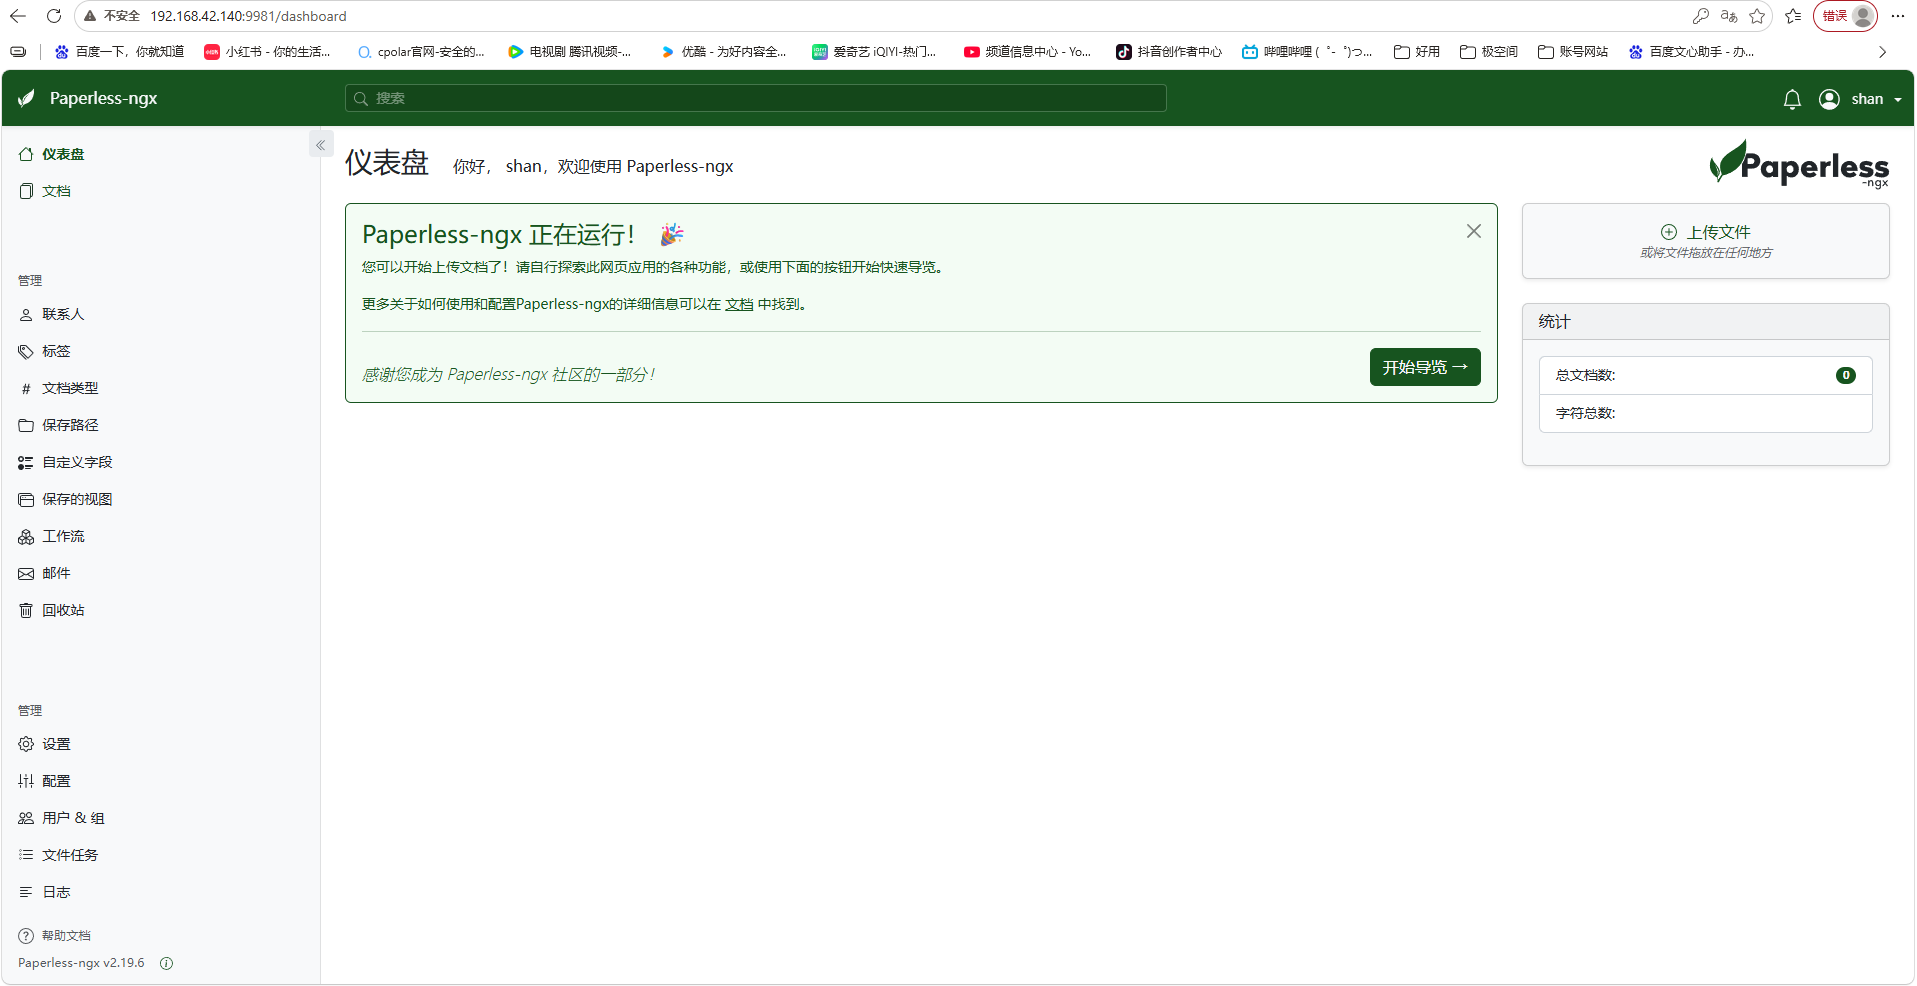
登录成功:
5.2 调整界面
可以根据自己的习惯调整布局:
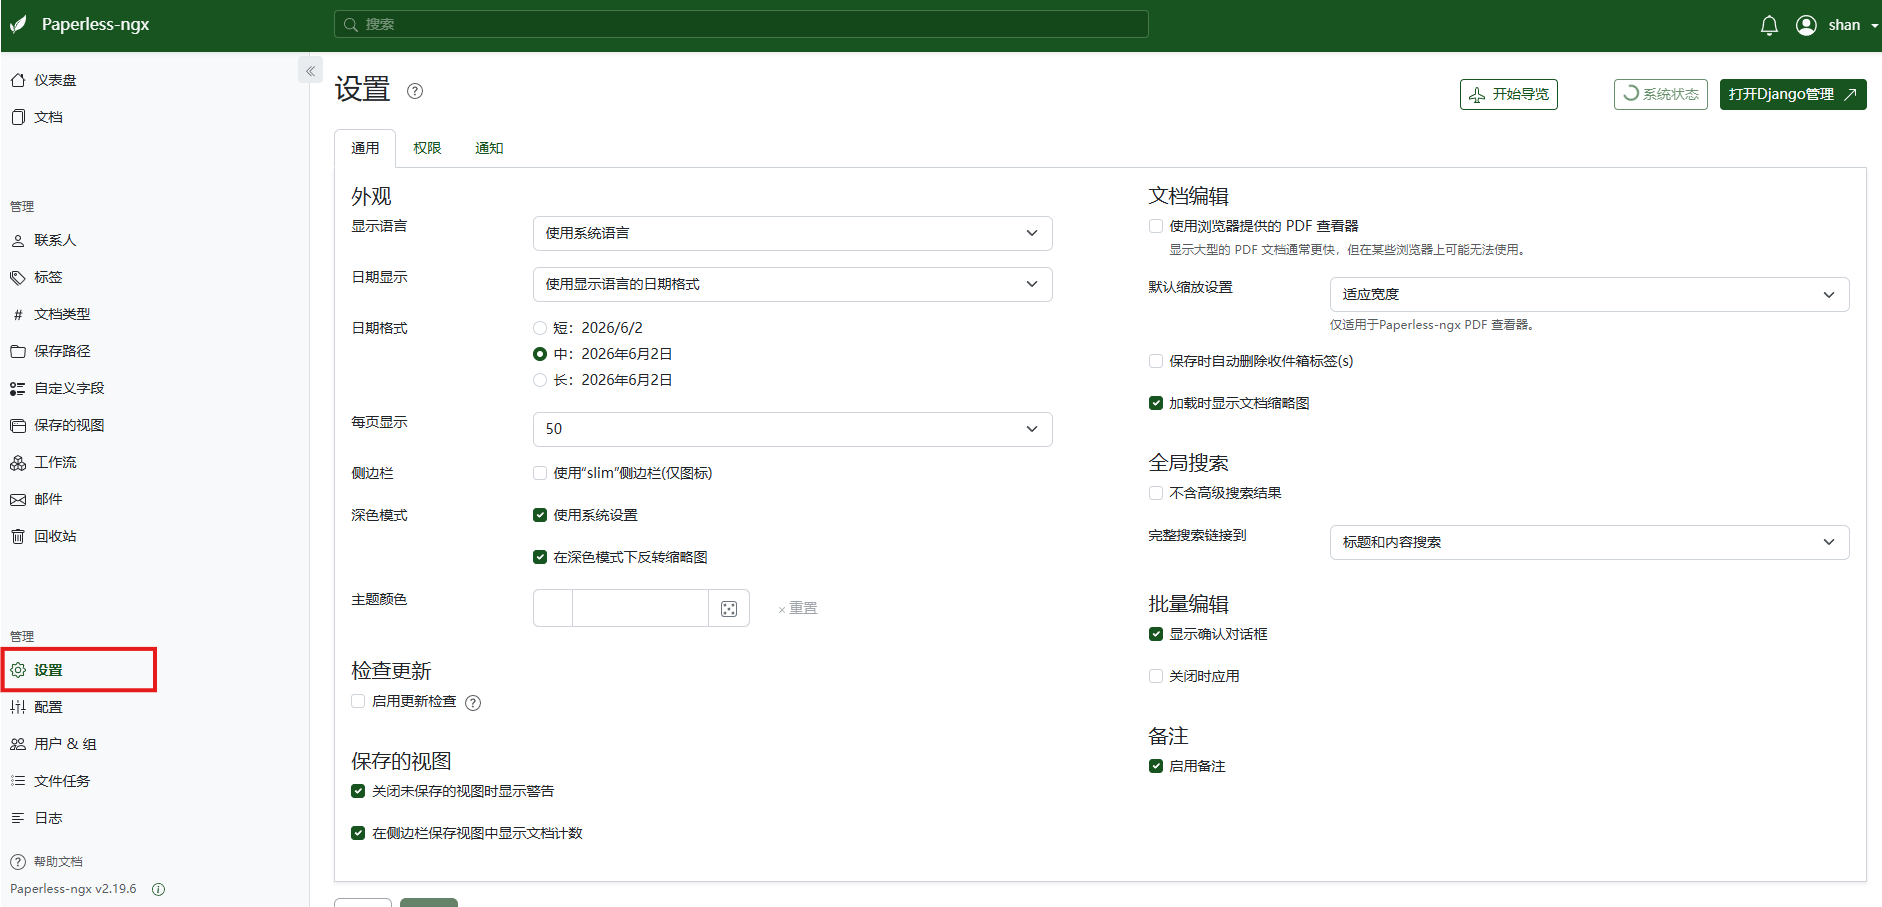
这一步虽然不影响功能,但文档系统是长期用的,界面顺手很重要。
5.3 上传文档
接下来上传一份文档:
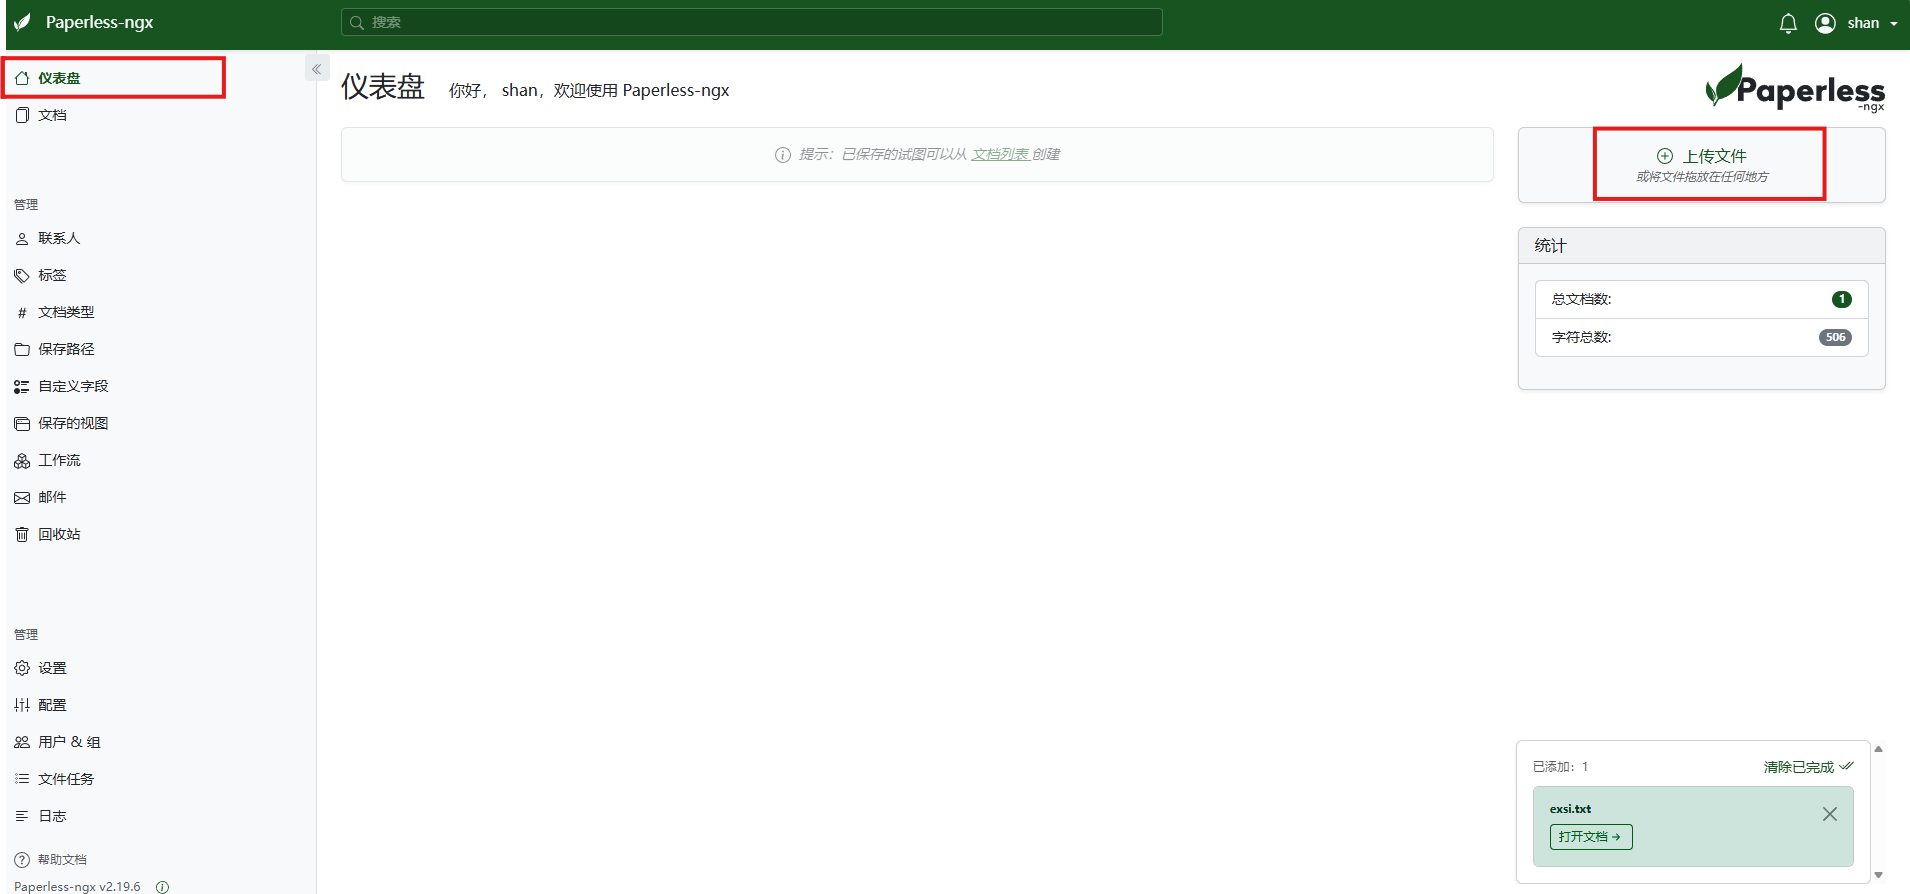
上传成功以后,打开文档查看:
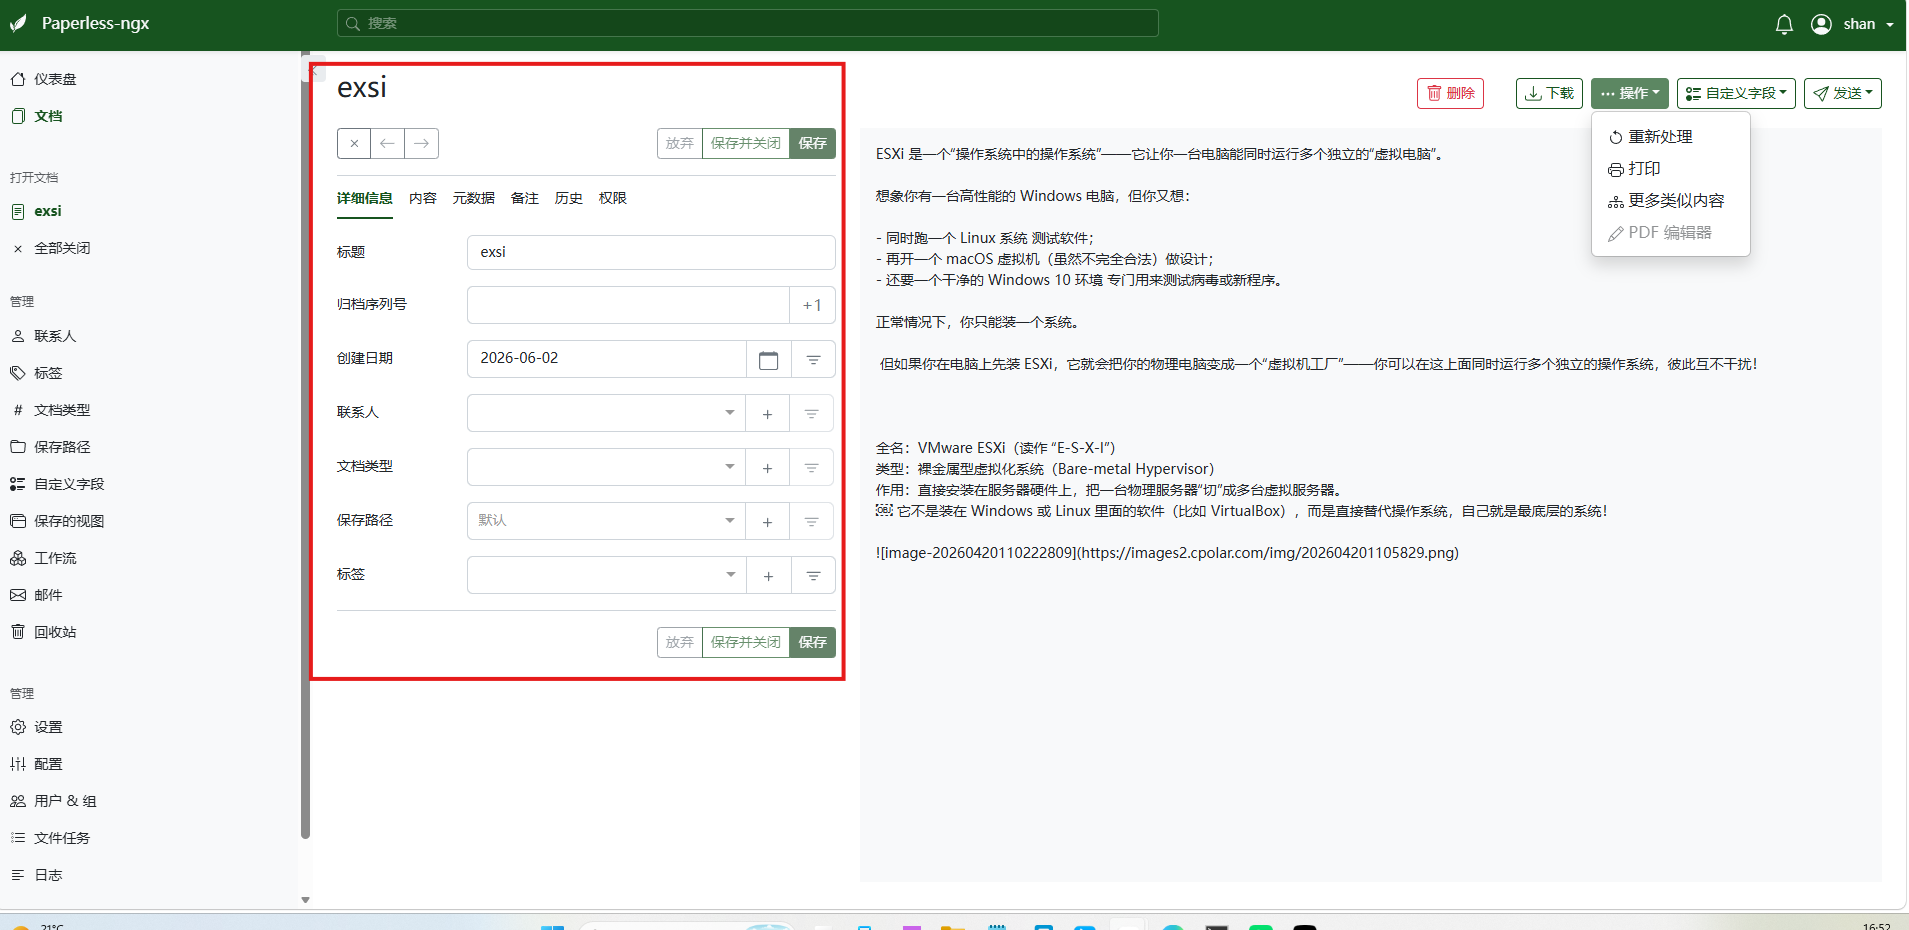
可以继续修改和编辑文档信息。
5.4 联系人和文档管理
还可以创建联系人:
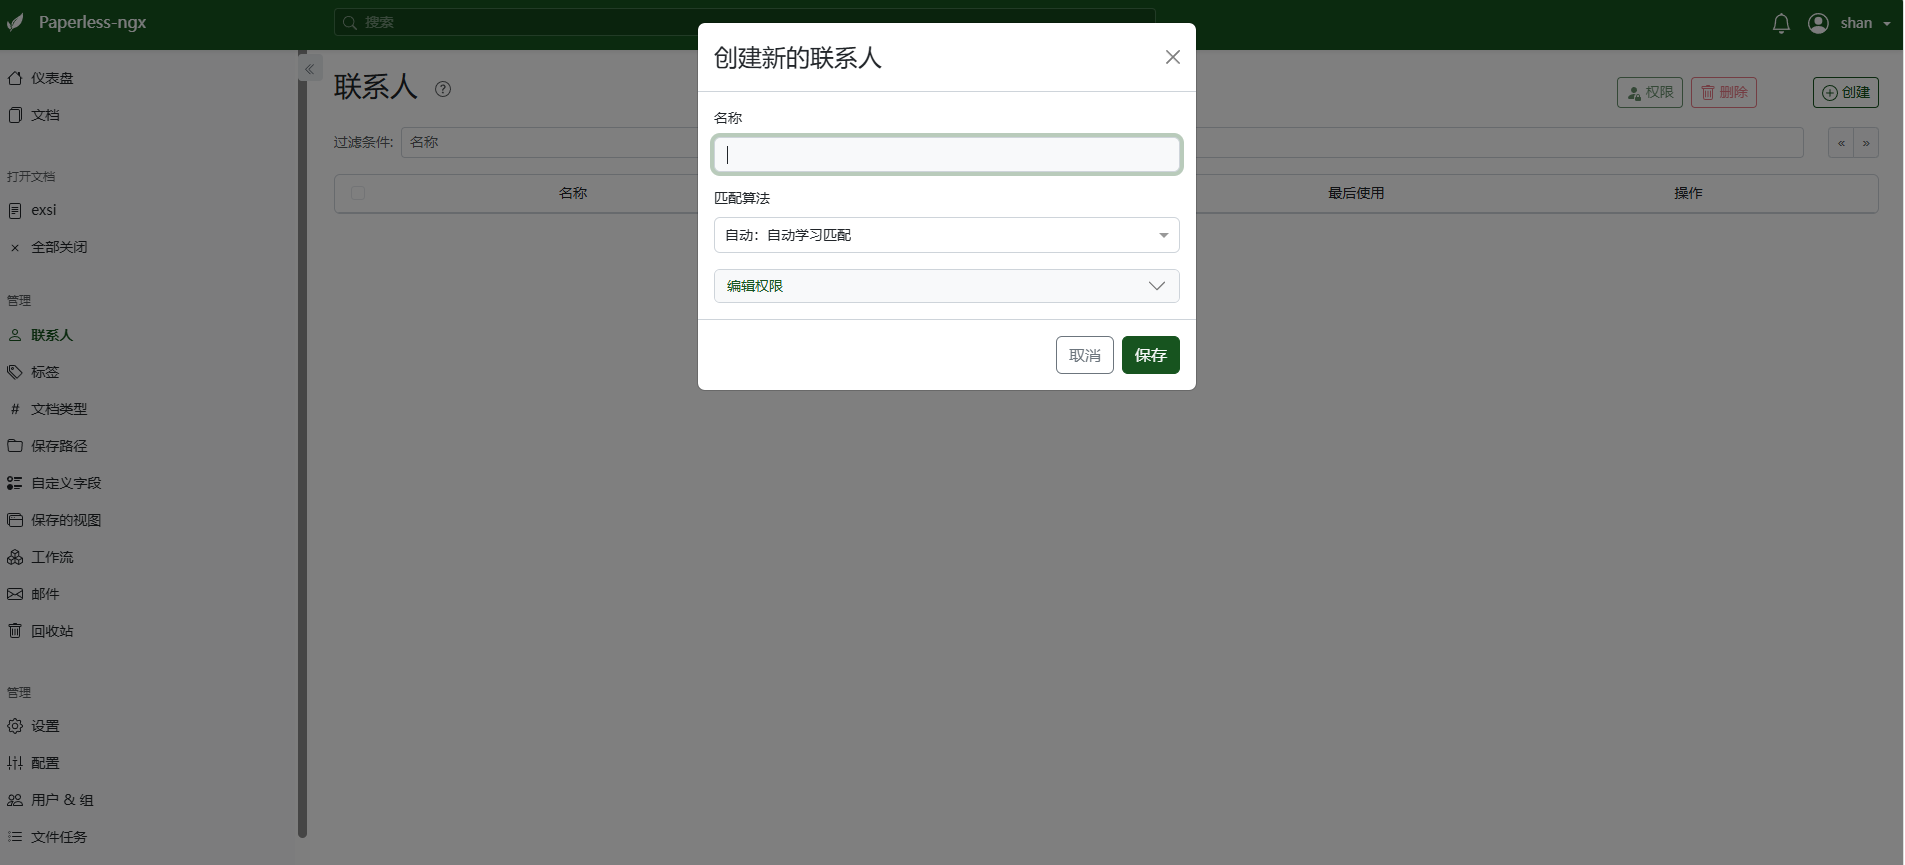
并继续做排序、显示和编辑:
做到这里,我才会觉得 Paperless-ngx 真正开始有用了。因为它已经不只是“把文件放进去”,而是开始围绕文档本身做组织和管理。
6. 本地文档库跑通以后,再处理远程访问
如果 Paperless-ngx 只在局域网使用,其实前面的部分已经够了。
但如果需要在外面继续查看合同、票据或扫描件,就还需要给 9981 这个 Web 服务增加外部访问入口。
这里 cpolar 负责的只是网络访问这一层,Paperless-ngx 仍然负责 OCR、搜索、标签和文档管理。
7. 安装 cpolar
执行安装命令:
sudo curl https://get.cpolar.sh | sh
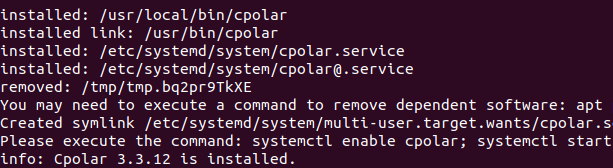
安装完成后查看服务状态:
sudo systemctl status cpolar
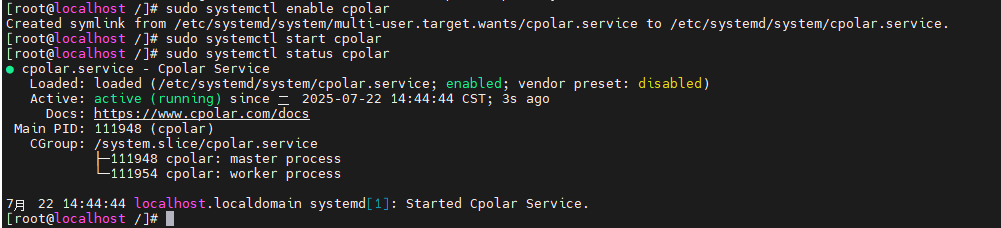
浏览器通过主机 IP 加 9200 进入 cpolar Web UI:
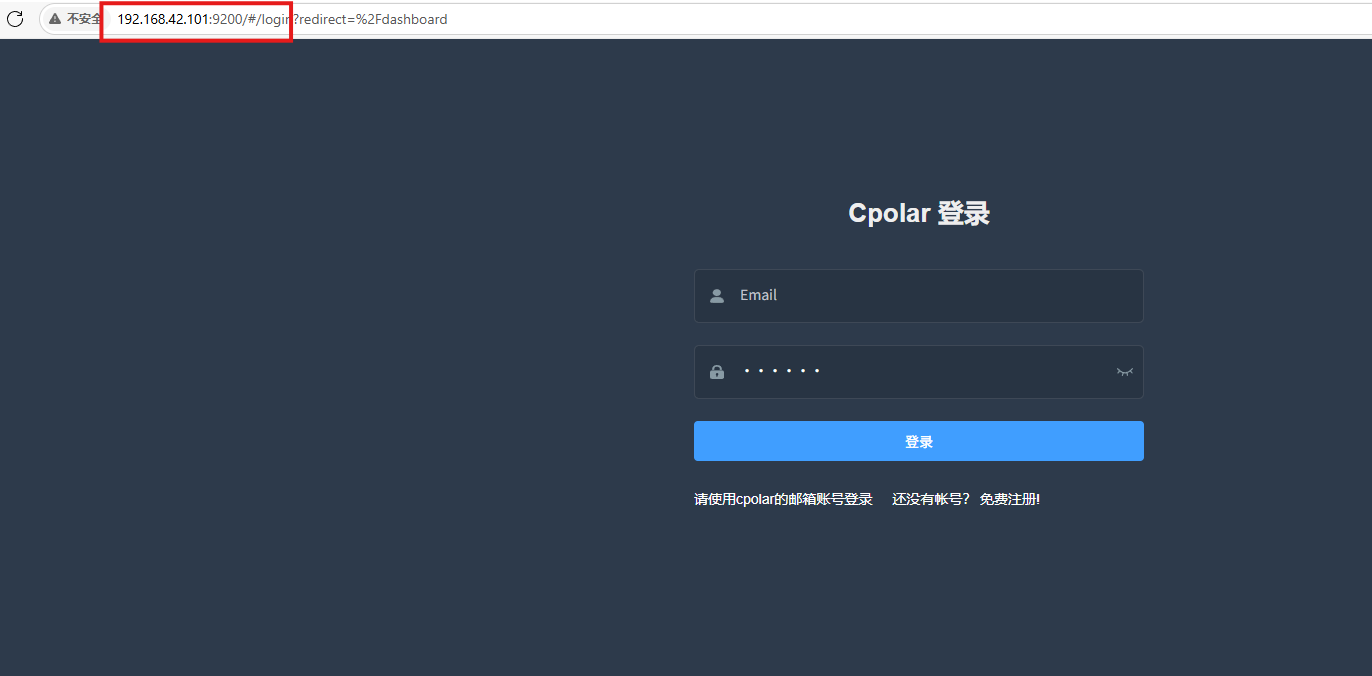
8. 给 Paperless-ngx 创建公网地址
进入 cpolar Web UI 后创建隧道。
参数按原配置:
- 隧道名称:
paperless - 协议:
http - 本地地址:
9981 - 域名类型:随机域名
- 地区:
China Top
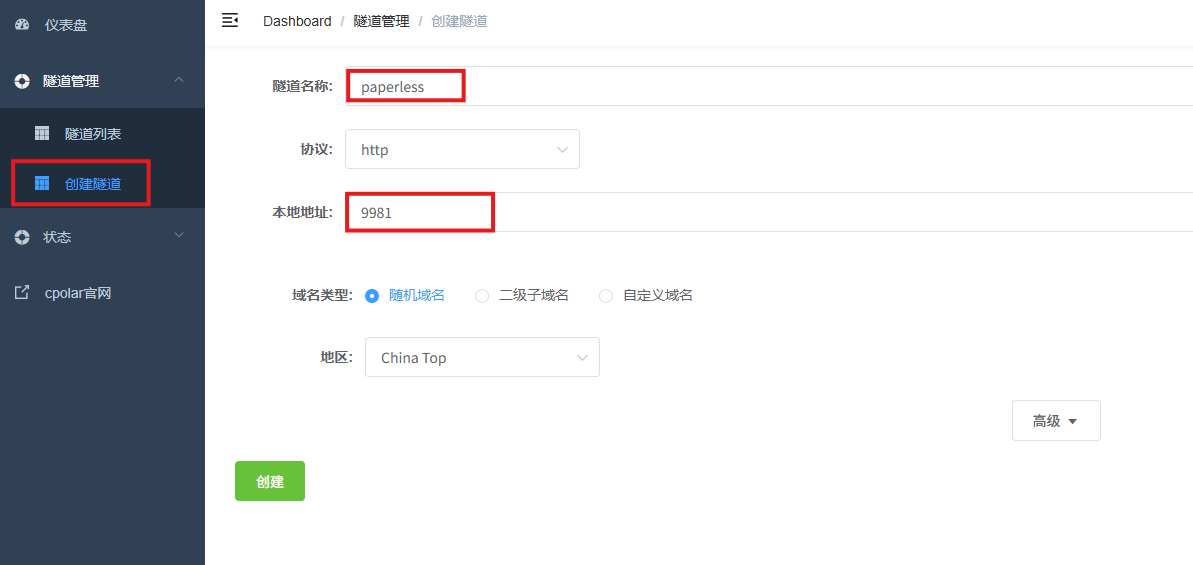
创建以后,在在线隧道列表查看地址:
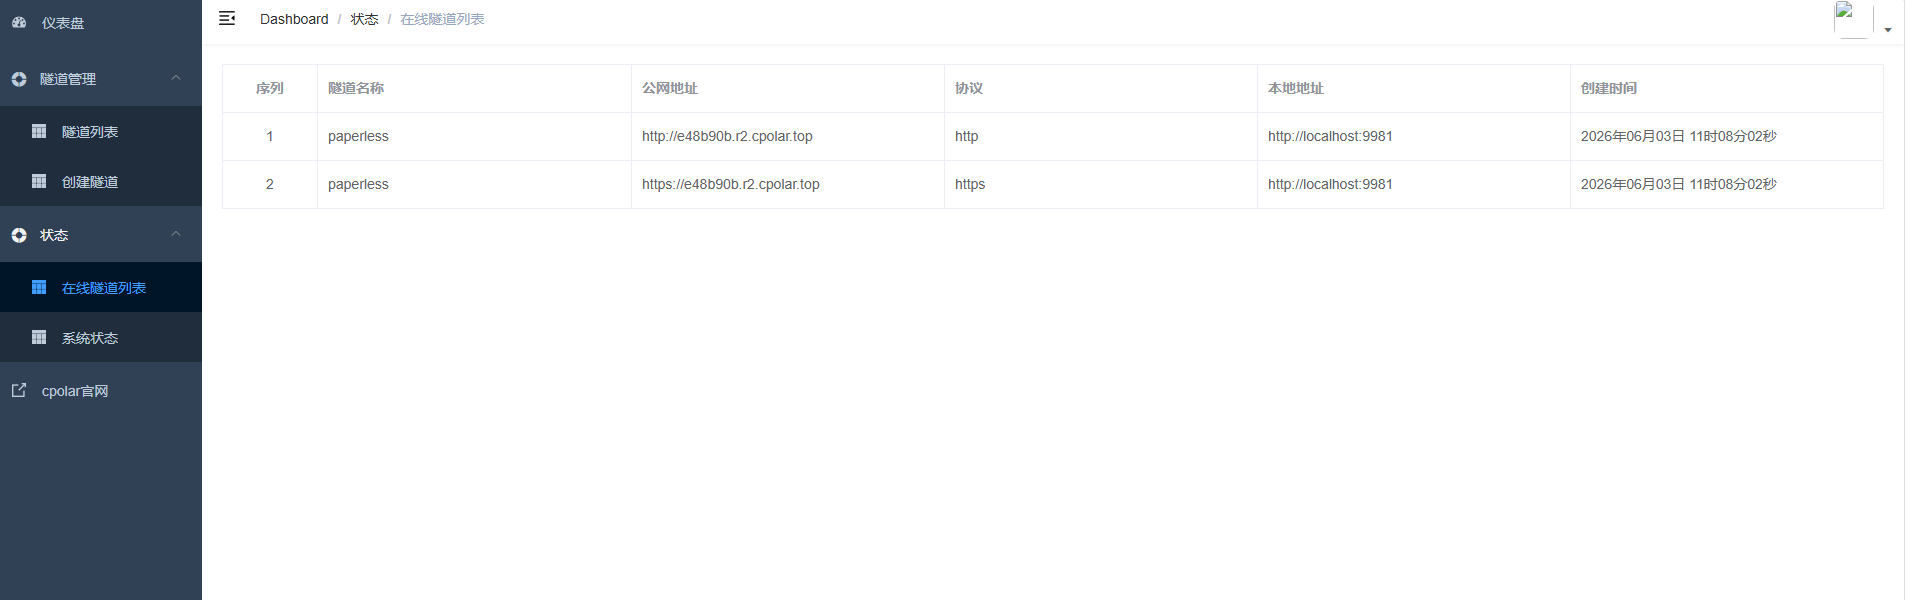
再从其他设备测试访问:
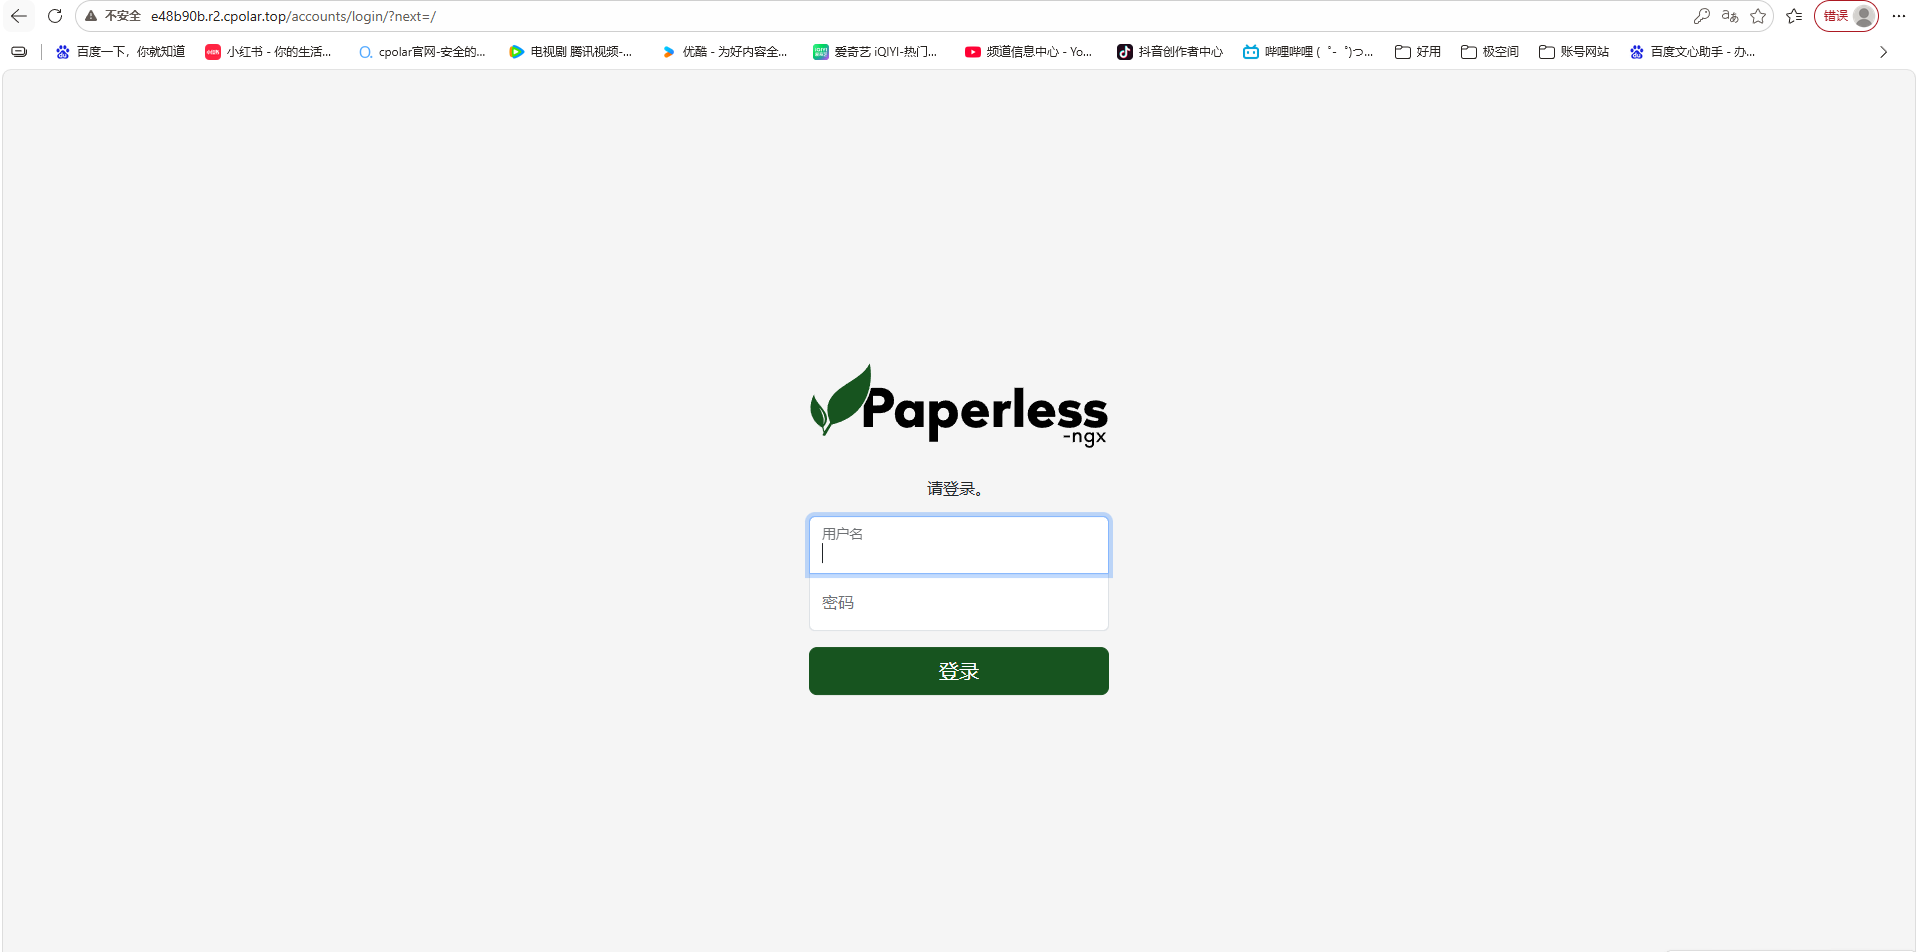
这一步能打开以后,Paperless-ngx 就不再只局限于当前局域网。
9. 配置固定二级子域名
如果准备长期用,再继续配置固定地址。
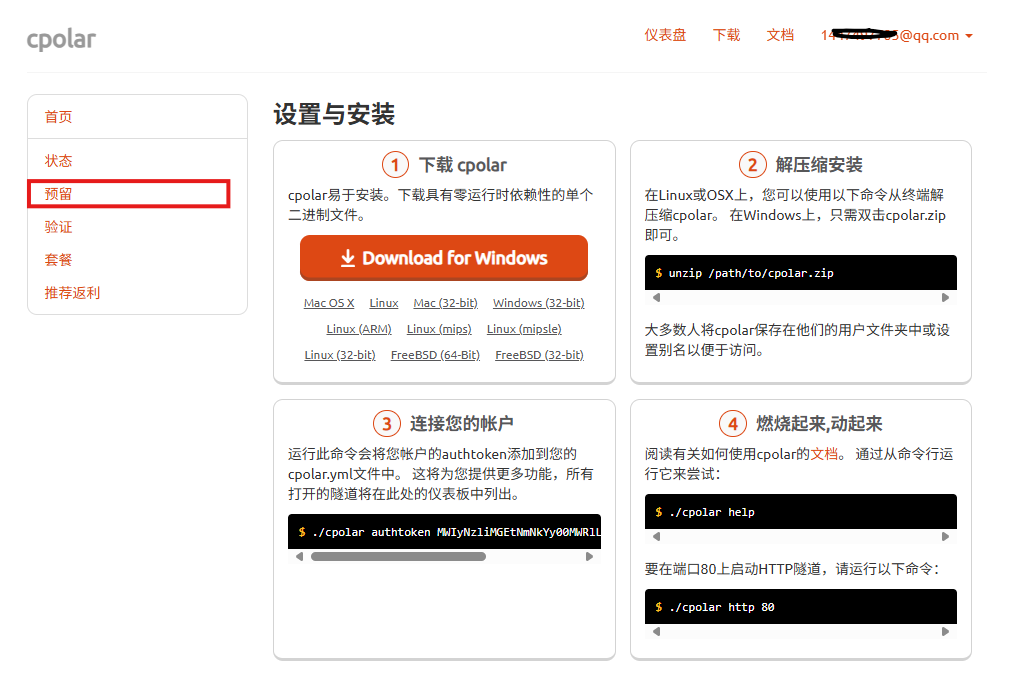
进入预留页面,地区选择 china Top,名称使用 paperless:
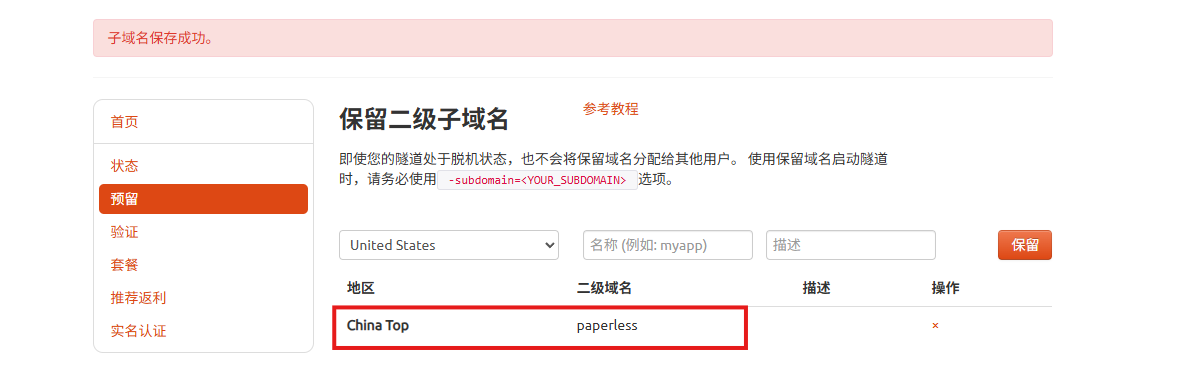
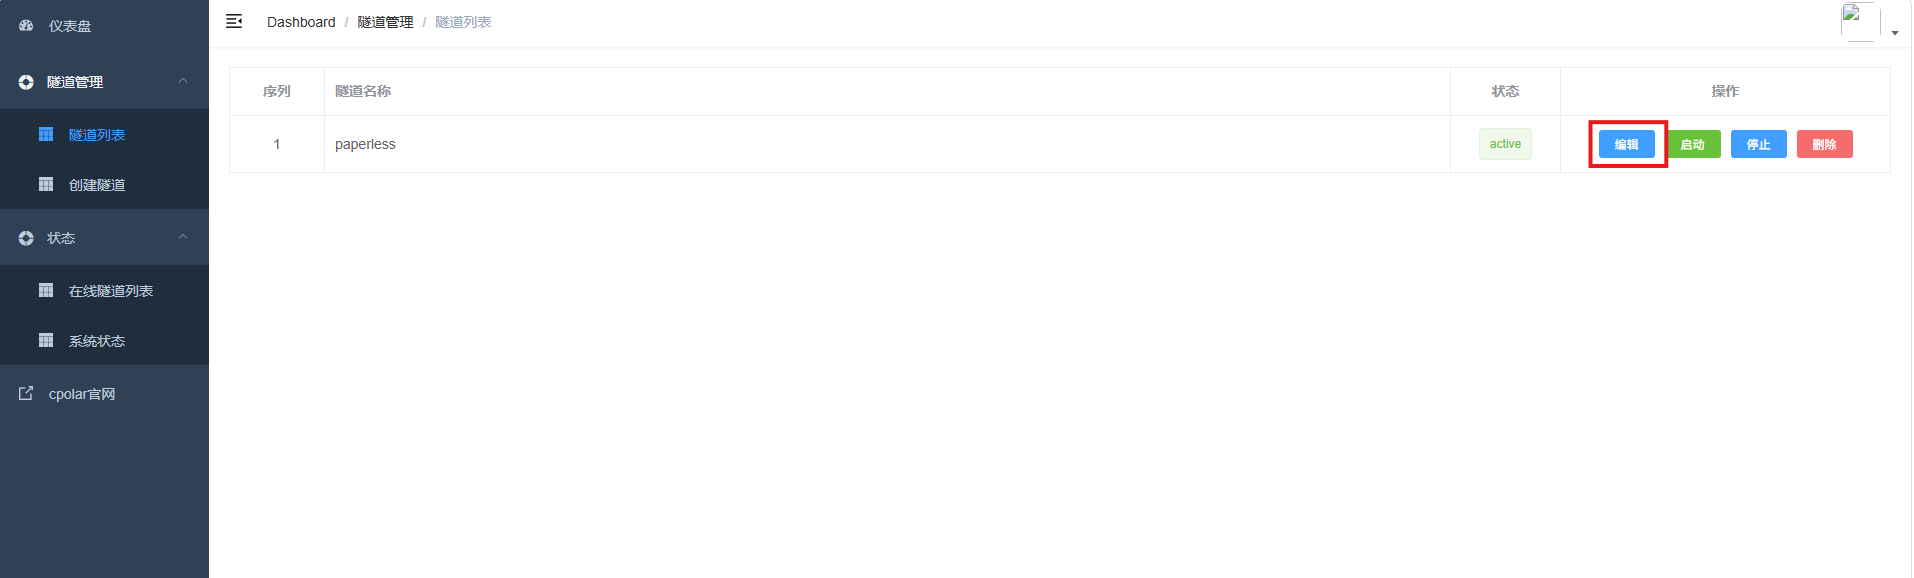
然后回到隧道列表编辑:
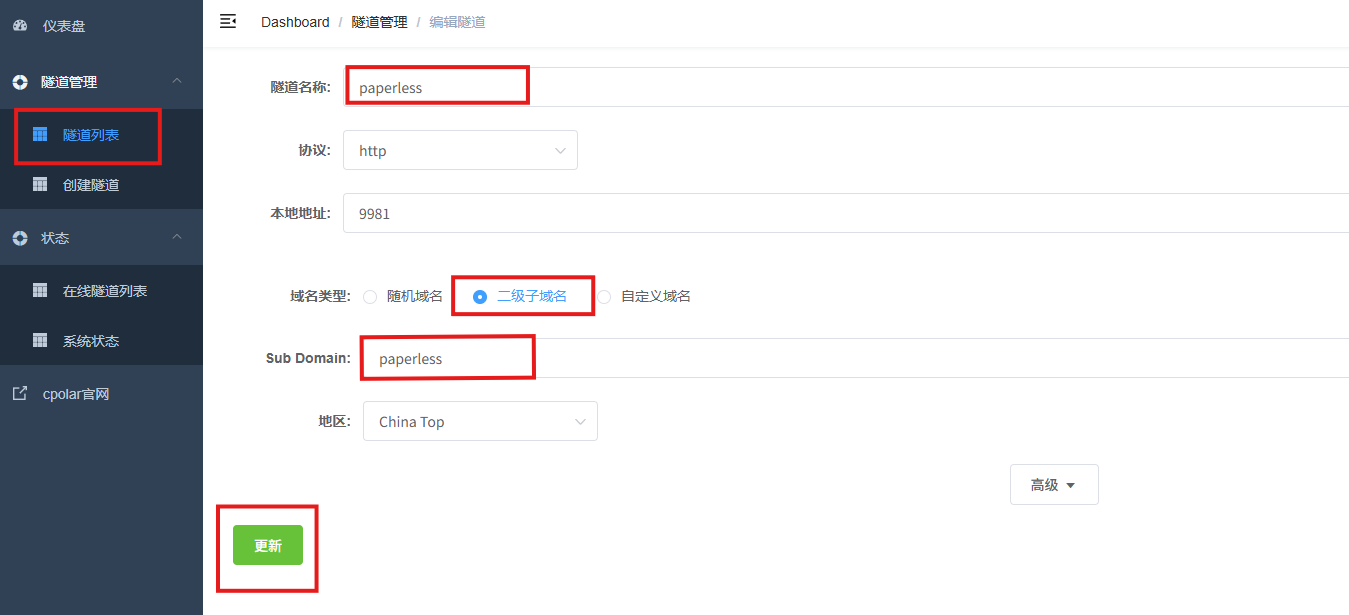
把域名类型改成二级子域名,并填写已经保留成功的名称:
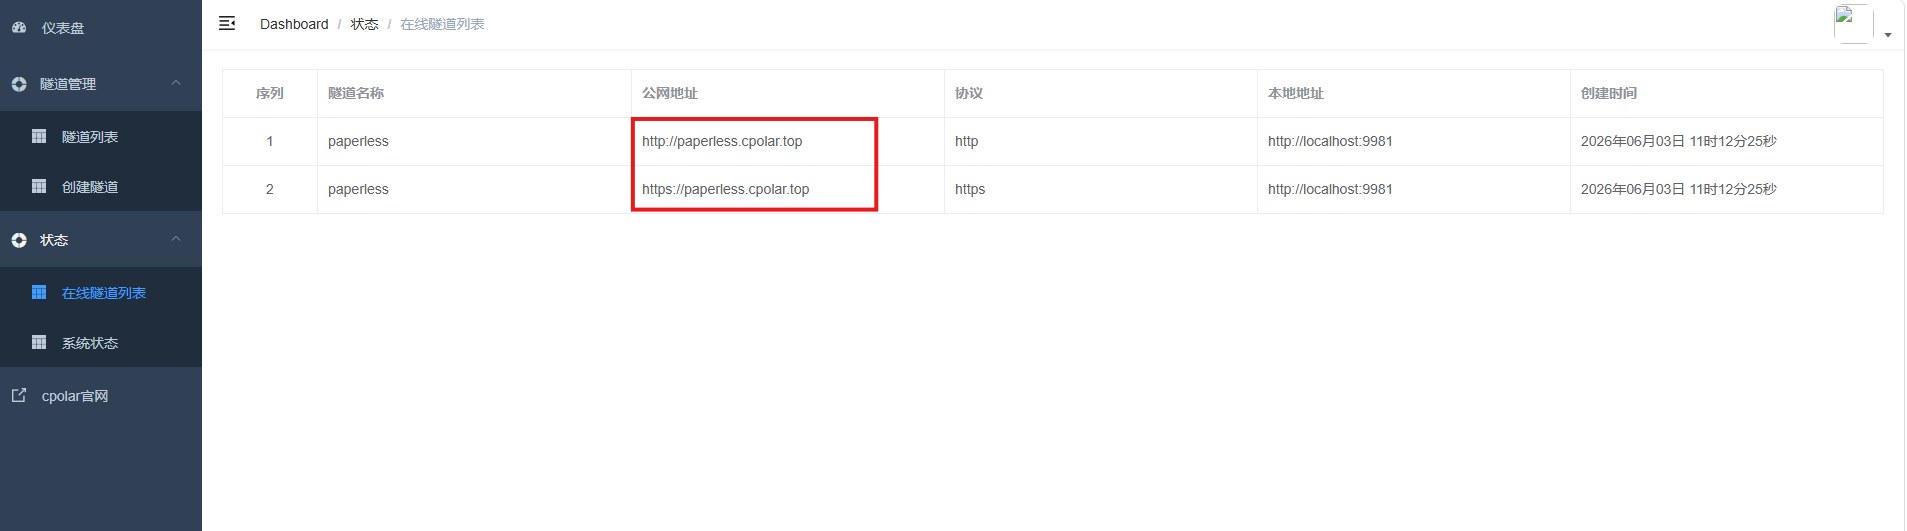
点击更新后,再去在线隧道列表查看:
最后用固定地址测试:
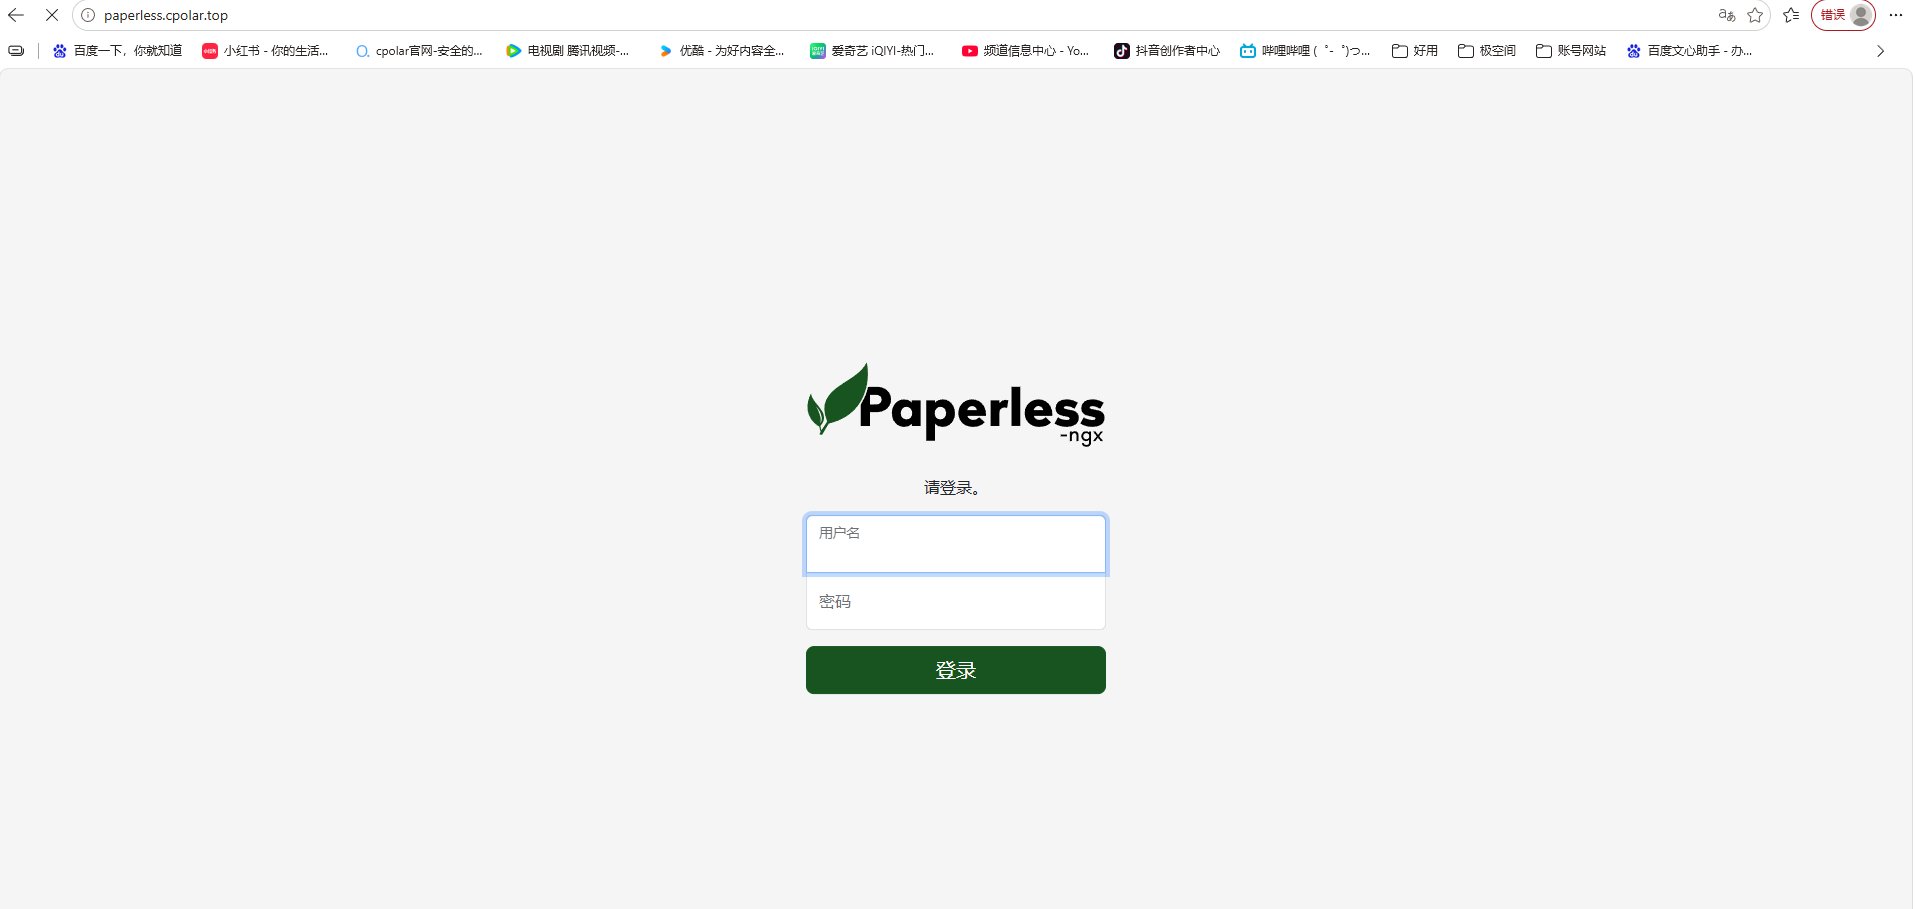
能够正常进入页面以后,固定访问入口就配置完成了。
10. 这套文档系统真正帮我省掉的是什么
我觉得 Paperless-ngx 最有价值的地方,不是“把纸变成电子文件”这么简单。
真正省时间的是,文档进系统以后,可以继续被识别、分类、打标签和搜索。以后要找某份合同、发票或者扫描件,不再完全依赖自己记得它放在哪个文件夹。
这也是我愿意花时间部署它的原因:不是为了搭一个看起来很完整的系统,而是为了以后少翻一点目录、少找一点文件。
总结
整套部署可以拆成三层:PostgreSQL 和 Redis 提供数据与任务基础;Paperless-ngx、Tika 和 Gotenberg 负责文档处理、OCR 与 Web 管理;远程访问部分则负责把已经运行好的 9981 服务带到局域网之外。
本地部署完成以后,还要继续做用户注册、文档上传、打开和编辑等实际验证。只有这些操作跑通,才能说明这套文档管理系统真正可以使用,而不只是容器状态正常。
需要外部访问时,再创建 9981 隧道,并继续配置固定二级子域名。这样从文档导入、管理、检索到远程查看,整个使用链才完整。
如果准备长期使用,我会更关注数据库备份、文档目录和权限管理。Paperless-ngx 的价值不在于“完全消灭纸张”,而在于把已经进入数字系统的资料变得更容易找、更容易管。
转载自 CSDN-专业IT技术社区
原文链接:https://blog.csdn.net/m0_71444338/article/details/167270339

