

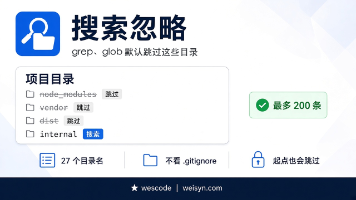
让 AI 在项目里搜一个函数名,最怕结果一大半来自 node_modules、vendor 或者打包产物。这些结果不光占上下文,还容易把它带偏,跑去改第三方库里的同名函数。
WES Code 的 grep 和 glob 往下遍历目录时,会跳过一张固定名单里的目录。这篇讲名单里有哪些、搜索的参数和上限,附一次在模拟项目上的实测,以及几个容易踩的坑。
一、跳过哪些目录
grep(按内容搜)和 glob(按文件名找)往下走目录时,遇到下面这些名字,整个目录跳过:
| 类别 | 目录名 |
|---|---|
| 版本控制 | .git、.hg、.svn |
| 依赖 | node_modules、vendor、.venv、venv、.eggs |
| 构建产物 | dist、build、target、.next、.nuxt、coverage、.gradle、.terraform |
| 缓存 | .cache、__pycache__、.tox、.mypy_cache、.pytest_cache、.ruff_cache |
| 编辑器 | .idea、.vscode |
名单里一共 27 个名字,另外三个是 .DS_Store、*.egg-info 和一个写文件时用的临时前缀,*.egg-info 的情况第四节会说。
比对的是目录名本身,在哪一层都算:src/build、packages/web/dist 一样会被跳过。
二、搜索的参数和上限
grep 的参数,举个例子:
{
  "pattern": "func PlaceOrder",
  "path": "internal",
  "glob": "*.go",
  "case_insensitive": false,
  "context_lines": 2,
  "max_results": 50
}
| 参数 | 作用 |
|---|---|
pattern | 正则表达式,必填 |
path | 从哪个目录或文件开始搜 |
glob | 只搜文件名匹配的,比如 *.go、**/*.md |
case_insensitive | 忽略大小写 |
context_lines | 每条匹配前后各带几行 |
max_results | 最多返回几条,默认 200 |
glob 只有 pattern、path、max_results 三个参数,支持 *、?、**,默认最多返回 200 个路径。
超过上限时,结果末尾会写「output truncated at 200 matches」(glob 写的是 paths),AI 就知道结果不全,可以缩小范围再搜。
三、实测:一个模拟项目
我把这份跳过名单的代码原样拿出来,搭了一个模拟项目,按 grep、glob 的遍历方式走了一遍:
func walk(root, base string) []string {
	var found []string
	filepath.WalkDir(root, func(path string, d fs.DirEntry, err error) error {
		if err != nil {
			return nil
		}
		if d.IsDir() {
			return builtin.ShouldSkipDir(path, d) // WES Code 的跳过规则,原样复制
		}
		rel, _ := filepath.Rel(base, path)
		found = append(found, rel)
		return nil
	})
	return found
}

func main() {
	proj, _ := os.MkdirTemp("", "proj")
	for _, f := range []string{
		"main.go",
		"internal/order/order.go",
		"internal/build/version.go",
		"node_modules/lodash/index.js",
		"node_modules/lodash/dist/lodash.min.js",
		"vendor/foo/foo.go",
		"dist/app.js",
		".venv/lib/site.py",
		".github/workflows/ci.yml",
		"mypkg.egg-info/PKG-INFO",
		".vscode/settings.json",
	} {
		p := filepath.Join(proj, f)
		os.MkdirAll(filepath.Dir(p), 0o755)
		os.WriteFile(p, []byte("x\n"), 0o644)
	}
	fmt.Println("从项目根目录搜:", strings.Join(walk(proj, proj), "  "))
	fmt.Println("指定搜 node_modules:", walk(filepath.Join(proj, "node_modules"), proj))
	fmt.Println("指定搜 node_modules/lodash:", walk(filepath.Join(proj, "node_modules", "lodash"), proj))
}
项目里一共 11 个文件,结果:
| 从哪搜 | 搜到的文件 |
|---|---|
| 项目根目录 | main.go、internal/order/order.go、.github/workflows/ci.yml、mypkg.egg-info/PKG-INFO |
直接指定 node_modules | 一个也没有 |
指定 node_modules/lodash | node_modules/lodash/index.js |
node_modules、vendor、dist、.venv、.vscode 都按预期跳过了。但有几个结果值得单独说:
internal/build/version.go没搜到:这是自己写的代码,只因为目录叫build,整个被跳过.github/workflows/ci.yml搜到了:.github不在名单里。隐藏目录不会因为名字带点就被跳过mypkg.egg-info/PKG-INFO搜到了:名单里写的是*.egg-info,但比对是拿目录名原样去比,mypkg.egg-info对不上- 直接指定
node_modules搜不到:起点目录本身也要过一遍名单,名字对上了就直接跳过。指定到某个包目录就可以,包里的dist照样跳过
四、它不做的事
- 不看 .gitignore:只认这张固定名单,项目自己的
.gitignore不起作用。生成的代码要是放在gen、out这种不在名单里的目录,照样会被搜进来 - 名单改不了:名单写在代码里,目前没有配置项可以增减
- 通用名字会误伤:代码目录叫
build、dist、target、coverage的,会被整个跳过,就像实测里的internal/build *.egg-info实际不生效:Python 项目里的xxx.egg-info目录还是会被搜到- 想搜依赖里的代码,要指到包目录:直接指定
node_modules什么都搜不到,得写到node_modules/某个包 - 一次最多 200 条:结果多了会截断,要用
glob、path缩小范围
小结
- grep、glob 遍历时跳过 27 个固定的目录名,包括依赖、构建产物、缓存、版本控制和编辑器目录
- 按目录名比对,在哪一层都算,起点目录本身也算
- grep 支持正则、文件名过滤、忽略大小写和上下文行;两者默认最多返回 200 条,超了会写明截断
- 不看 .gitignore;叫 build、dist 的代码目录也会被跳过;
.github这类不在名单里的隐藏目录照样会搜
文中的搜索忽略规则是 WES Code 里的功能,官网是 weisyn.com。你们项目里有没有名字容易被误伤的目录,或者希望它也跳过的目录,欢迎评论区聊聊。
觉得有用的朋友,欢迎点赞、收藏、关注,后面会继续分享 AI 编程的实战经验。
转载自 CSDN-专业IT技术社区
原文链接:https://blog.csdn.net/xhy_mmc/article/details/167577617

