

摘要:前四篇讨论的三种模式都有一个共同前提——存在一个中心决策者。Pipeline 的顺序写在代码里,MapReduce 的编排者是那个 Reduce 节点,Supervisor 有一个专门的路由 Agent。但有一类任务连"中心决策者"这个角色都不存在:多个分析方向各自独立推进,谁也不知道全局该往哪走,走着走着新线索让别的方向改变了看法。Hearsay 语音识别、多源情报融合、复杂故障归因——这类任务只能靠一块所有参与者都能读、都能写的公共区域,让知识源自主判断"该不该出手、该写什么"。这就是黑板模式。本文拆解共享黑板、并发控制、冲突解决三大核心问题,重点讲清两件容易翻车的事:并发写入如何避免互相覆盖,以及结论矛盾时谁来裁决。文中给出基于 asyncio 的可运行实现,含知识源激活预算、乐观并发版本号、冲突消解矩阵的完整代码。
📌 版本声明:本文基于 Python 3.11+、LangGraph 0.2+、Pydantic V2 编写,撰写时间 2026 年 10 月。黑板模式源自 Nii 1986 年提出的经典架构范式(Hearsay-II 系统),核心概念不受框架版本影响;
asyncio.Lock语义与 Python 版本强相关,故标注 3.11+。适用边界:适用于协作目标模糊、无法预设分解路径、任何一方都可能独立发现关键线索的场景。若拆分路径已知(Pipeline)、子任务可枚举(MapReduce)、或存在明确的路由决策者(Supervisor),黑板模式是负收益——它把协调成本从"一次决策"换成了"全程互相盯防"。本文案例为多源安全日志的入侵归因分析,所有代码可在受限环境跑通。
文章目录
一、为什么需要黑板:没有中心决策者的时候
1.1 一个"三个人审同一份日志"的场景
先看一个真实的排查场景。
一起疑似数据外泄事件,安全团队拿到三份互不相干的线索:
- WAF 日志:凌晨 2:14 出现 47 次对
/admin/export的访问,其中 12 次返回 200。 - 数据库审计:凌晨 2:31 有一条
SELECT * FROM customer_sso,一次导出 8.7 万行。 - EDR 终端:某台办公电脑在 2:02 启动了一个 PowerShell 脚本,脚本路径在临时目录。
现在的问题是:这三份线索之间有没有关联?如果有,是什么关联?
按前面几篇的模式来拆,都会卡住:
| 模式 | 为什么不行 |
|---|---|
| Pipeline | 你事先不知道"先查 WAF 再查数据库"——WAF 的 2:14 和数据库的 2:31 谁在前,取决于你假设攻击者先拿凭据还是先探测 |
| MapReduce | 三份线索看似独立,但真正的分析动作(“2:14 的 47 次访问与 2:02 的脚本启动时间是否吻合”)需要跨线索比对,这个动作无法被静态切分 |
| Supervisor | 主管 Agent 需要先知道有哪些分析方向才能路由。但这里分析方向本身就是在探索中产生的——查完 WAF 才会想到"要不要看这些 IP 的横向移动" |
真正的形态是这样的:三个分析员各自盯着自己那块屏幕,谁看到关键线索就写到公共白板上,谁看到白板上的新线索就重新审视自己的领域。 没有人在上面指挥"你先查这个再查那个"。
这就是黑板模式——一块共享黑板 + 若干自主知识源 + 一个控制机制。
1.2 黑板模式的三个组成部分
黑板模式的经典定义来自 Nii 1986 年的论文,它由三部分构成:
| 组成部分 | 职责 | 前三种模式中的对应物 |
|---|---|---|
| 共享黑板(Blackboard) | 存放中间结论、假设、证据的公共区域,所有知识源可读可写 | Pipeline 的中间态、MapReduce 的 MapResult、Supervisor 的 DiagnosisState |
| 知识源(Knowledge Source) | 独立的专业模块,自主判断何时激活、从黑板读什么、写什么 | Pipeline 的环节、MapReduce 的 worker、Supervisor 的 worker |
| 控制机制(Control Mechanism) | 决定哪个知识源在何时被激活 | Pipeline 的边、MapReduce 的扇出、Supervisor 的路由决策 |
关键区别在第三行。前三种模式的控制机制是确定的、可预先编排的;黑板模式的控制机制必须回答一个更难的问题:
在没有任何人明确下达指令的情况下,凭什么让知识源 A 此刻去读黑板、并且只读它关心的那部分?
这就是黑板模式全部复杂度的来源。
图里有三个设计细节值得先说透,它们是黑板模式区别于前三篇的地方:
细节一:控制机制画在知识源和黑板之间,而不是中心。 它的职责不是"决定做什么",而是"决定唤醒谁"。真正的决策(做什么)分散在各个知识源内部——每个知识源自己判断"我看到的东西是否触发了我的出手条件"。
细节二:黑板是分区的,不是平铺的。 分区决定了谁能写什么,也决定了每个知识源需要读多少。分区设计是黑板模式的第一道性能防线,第 2.3 节展开。
细节三:知识源之间的连线是双向的、虚线化的。 它们不直接通信——所有信息交换都必须经过黑板。这条约束是黑板模式的命门:一旦允许知识源直接调用彼此,黑板就退化成了"一个多余的中间层",协调复杂度会全部回灌到耦合关系里。
1.3 四种模式的本质差异:决策权归属
把前四篇和本篇放在一起看,最清晰的区分维度是决策权归属:
| 模式 | 决策权在哪 | 决策时机 | 参与者之间如何通信 |
|---|---|---|---|
| Pipeline(第 22 篇) | 人(写在代码里) | 设计期 | 直接传中间态,结构固定 |
| MapReduce(第 23 篇) | 人(写在代码里) | 设计期 | 结果集中汇总 |
| Supervisor(第 24 篇) | 主管 Agent | 运行期 | 通过主管中转 |
| 黑板模式(本篇) | 分散在各知识源自己手里 | 运行期,自主 | 只通过共享黑板 |
这个差异导致了一个反直觉的结论:黑板模式没有"路由错误"这种失败模式,但有"结论矛盾"这种失败模式。
前三种模式里,路由错了会导致某条路径被浪费或产生垃圾结果——错误是可见的、可定位的。黑板模式里没有路由,每个知识源都能写入任何结论;如果两个知识源基于不同证据得出了相反的判断,系统不会自动发现这个问题,它会同时把两个矛盾结论留在黑板上,然后带着这个矛盾继续往下走。
冲突解决因此成为黑板模式独有的、也是最核心的工程问题。
1.4 黑板模式的四个失效形态
在动手前,先把失败模式摆出来。这四点会贯穿全文:
| 失效形态 | 现象 | 根因 | 防范手段 |
|---|---|---|---|
| 雪崩唤醒 | 一个知识源写入触发全量重跑,Token 涨 20 倍 | 唤醒条件过宽 | 变化区域检测 + 分区级唤醒 |
| 覆盖丢失 | 后写入的结论覆盖了先写入的 | 黑板无版本控制 | 分区版本号 + 乐观并发 |
| 矛盾并存 | 黑板上同时留着"内网横向移动"和"外部攻击" | 无人裁决 | 假设区反证标记 + 置信度仲裁 |
| 永不停机 | 所有假设都推翻完了还在跑 | 缺少终止判据 | 证据充分度 + 轮次预算双闸门 |
这四个失效形态里,"矛盾并存"最隐蔽——系统不会报错,日志一切正常,只是结论可能是错的。而"永不停机"最容易发现(烧钱),实际上一旦给它加了预算就解决了。真正需要设计的是冲突消解。
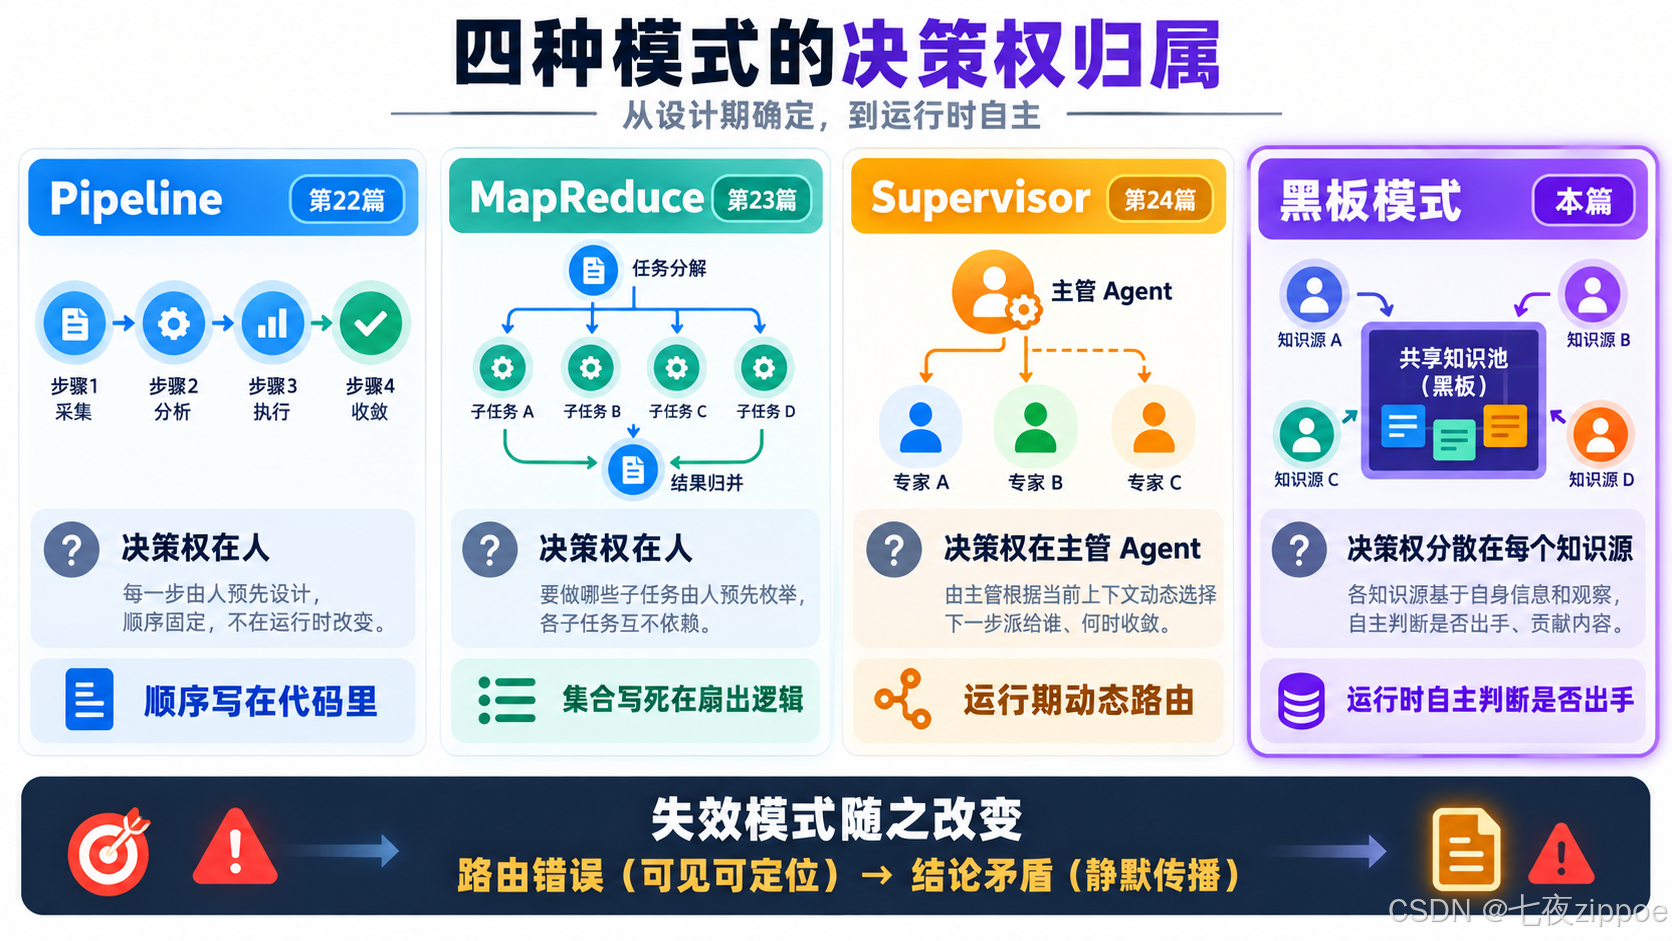
图1:四种多 Agent 协作模式的决策权归属对比——从设计期确定到运行时自主的演进
二、黑板模式核心概念:专门章节
2.1 知识源(Knowledge Source)——自主的原子
知识源是黑板模式的执行单元。它和前三种模式里的 worker 有一个本质区别:worker 是被调用的,知识源是自我唤起和自我停止的。
一个知识源必须具备四项能力:
感知(Perceive)——读黑板的哪些分区。必须最小化:只读与自己相关的分区,读全量黑板会导致 Token 爆炸且引入噪声。
判断(Decide)——判断当前黑板状态是否满足自己的出手条件。这是知识源的"自主性"所在,也是最难调优的部分——条件太宽触发雪崩,太窄则永不激活。
执行(Act)——调用自己的专业工具,产生证据或结论。
写入(Write)——把结果写回黑板的指定分区。必须遵守分区的写入协议(追加 vs 覆盖、是否需要版本号)。
# knowledge_source.py —— 知识源的抽象基类
from __future__ import annotations
from abc import ABC, abstractmethod
from dataclasses import dataclass, field

from schemas import (BlackboardView, BlackboardWrite, KnowledgeSourceId)


@dataclass
class ActivationBudget:
    """知识源的激活预算——自主性必须被"预算"约束。

    没有预算的知识源会在黑板频繁变化时反复激活,
    这就是雪崩唤醒的根源。
    """
    max_activations: int = 8          # 单个知识源总激活上限
    activations_used: int = 0
    cooldown_activations: int = 1     # 两次激活之间至少间隔几轮
    last_activation_round: int = -999

    def can_activate(self, current_round: int) -> tuple[bool, str]:
        if self.activations_used >= self.max_activations:
            return False, f"activation_budget_exhausted ({self.activations_used})"
        gap = current_round - self.last_activation_round
        if gap < self.cooldown_activations:
            return False, f"cooling_down (gap={gap} < {self.cooldown_activations})"
        return True, "ok"


class KnowledgeSource(ABC):
    """知识源基类:四段式(感知 → 判断 → 执行 → 写入)。

    强制子类实现 perceive_should 分区最小化,这是性能的关键。
    """

    def __init__(self, ks_id: KnowledgeSourceId, budget: ActivationBudget | None = None):
        self.ks_id = ks_id
        self.budget = budget or ActivationBudget()
        # 观察到的分区版本号,用于"变化区域检测"
        self.seen_versions: dict[str, int] = {}
        self._all_seen: set[str] = set()

    @abstractmethod
    def interest_partitions(self) -> list[str]:
        """声明我关心哪些分区——控制机制据此做分区级唤醒。"""

    @abstractmethod
    def should_activate(self, view: BlackboardView) -> tuple[bool, str]:
        """判断是否出手。返回 (是否出手, 理由)。理由会进日志,便于调优。"""

    @abstractmethod
    async def act(self, view: BlackboardView) -> BlackboardWrite | None:
        """执行并返回写入动作;返回 None 表示本轮无写入。"""

    # ---- 以下为框架提供,子类不应覆写 ----

    def has_new_information(self, view: BlackboardView) -> bool:
        """变化区域检测:只关心自己声明的分区是否变化过。

        这是防雪崩的第一道闸门——黑板里其他分区的变化
        不应该唤醒我。
        """
        changed = False
        for p in self.interest_partitions():
            ver = view.versions.get(p, 0)
            if ver != self.seen_versions.get(p, -1):
                self.seen_versions[p] = ver
                changed = True
        if not self._all_seen:
            # 首次运行时建立基线,但不视为"有变化"
            self._all_seen = set(view.versions.keys())
            self.seen_versions = {p: view.versions.get(p, 0)
                                  for p in self.interest_partitions()}
            return False
        return changed

    def try_activate(self, view: BlackboardView) -> tuple[bool, str]:
        """完整的激活判定:变化检测 → 预算 → 自身条件。"""
        if not self.has_new_information(view):
            return False, "no_change_in_my_partitions"
        ok, why = self.budget.can_activate(view.round_index)
        if not ok:
            return False, why
        return self.should_activate(view)
代码说明:
interest_partitions()是最重要的一个方法。它决定了"谁会因为我的写入而被唤醒"。如果所有知识源都声明对所有分区感兴趣,那么任何一次写入都会唤醒全部知识源——这就是雪崩唤醒的定义。把这个方法强制为抽象方法,等于在架构层面强制开发者做分区规划。has_new_information()的首轮处理很微妙:第一次运行时它建立版本基线但返回False。这是为了避免"黑板刚建立就唤醒所有知识源"的假启动风暴——第一轮应该由控制机制显式指定初始激活的知识源。ActivationBudget双重约束:max_activations限制总量,cooldown_activations限制频率。只限制总量不够——某个知识源可能在连续 3 轮里各用 1 次配额,虽未超总量但已经造成浪费。- 四个阶段的分离(感知/判断/执行/写入)不是为了形式好看。它让"为什么这个知识源没出手"可以被精确回答(是变化检测拦住了?预算不够?还是自身条件不满足?),这是调优黑板模式唯一可行的办法。
2.2 共享黑板(Blackboard)——分区与版本
黑板不是一张大字典。分区设计直接决定了性能上限和正确性上限。
| 分区类型 | 写入语义 | 典型内容 | 并发风险 |
|---|---|---|---|
| 证据区 | 追加(append-only) | 原始日志片段、指标值、IOC 命中 | 低——不覆盖,但需防重复写 |
| 假设区 | 可反证(supersede) | 各知识源对同一现象的解释 | 高——同一现象可能被多个源给出不同解释 |
| 时间线区 | 追加 + 排序 | 关键事件的时间戳 | 中——并发追加顺序需稳定 |
| 结论区 | 覆盖(带置信度) | 最终判定 | 最高——多源可能给出矛盾结论 |
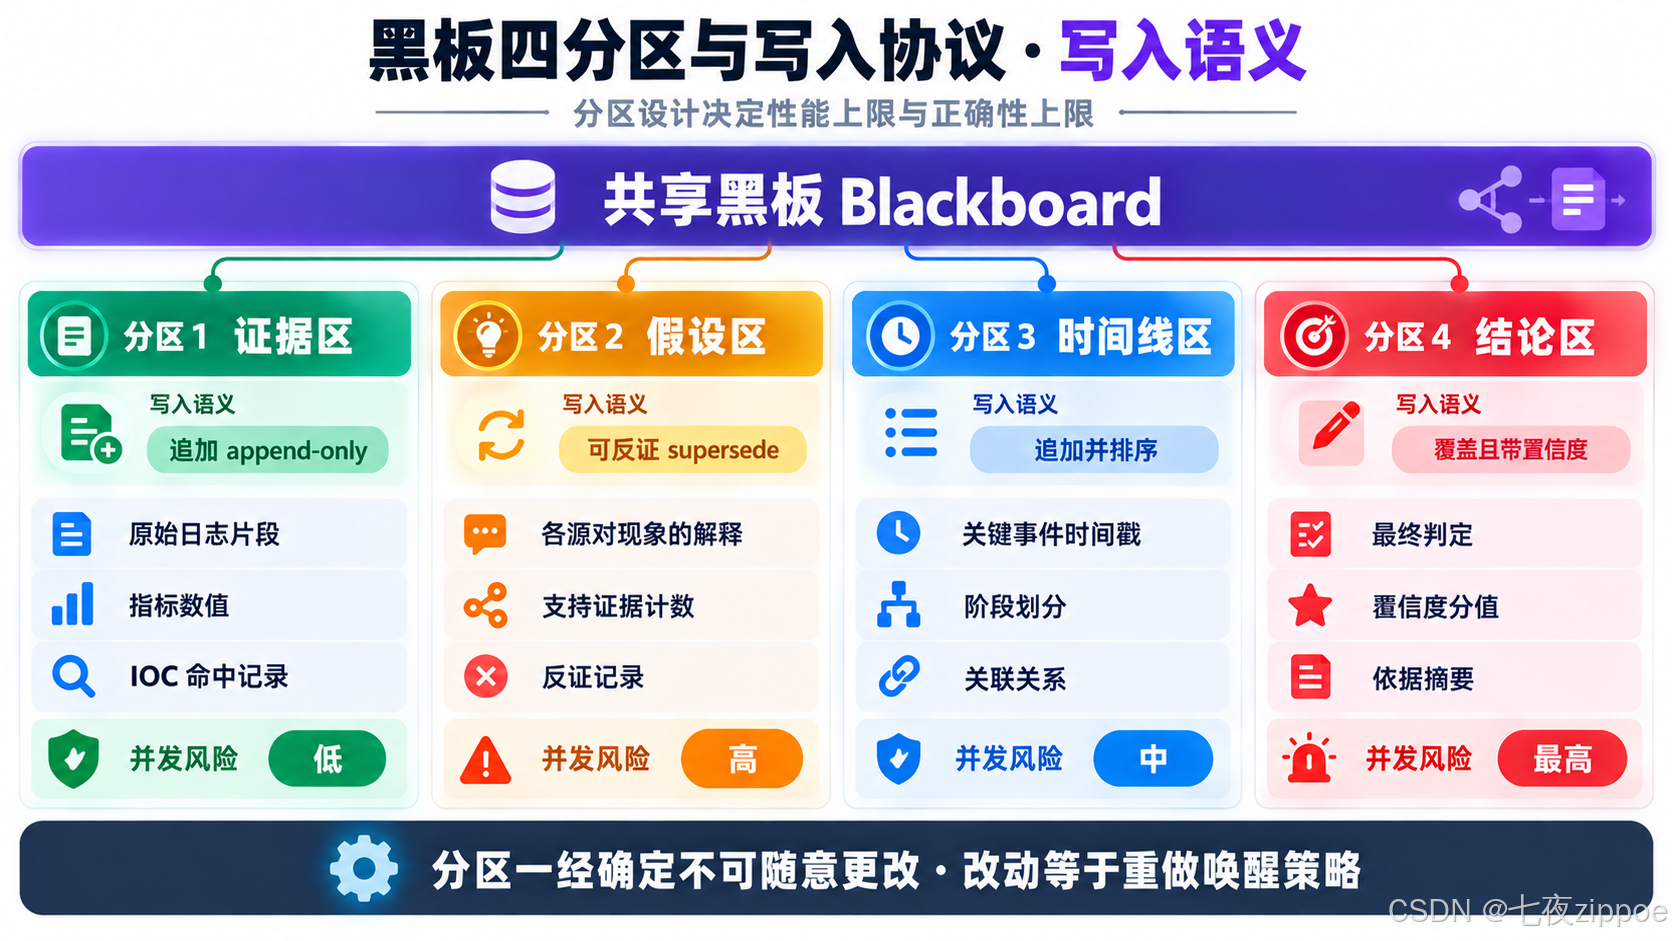
图2:黑板四分区设计——各自的写入语义、访问约束与并发风险等级
代码说明(分区设计的三条铁律):
- 分区一经确定不可随意更改。 因为每个知识源的
interest_partitions()和唤醒逻辑都绑在分区上,改分区等于重做全部唤醒策略。 - 写入语义必须由分区强制,而非靠自觉。 证据区只允许 append,结论区才允许覆盖。如果不强制,某个知识源往证据区写了覆盖,整个系统的证据链就断了。
- 风险等级决定了并发控制强度。 结论区风险最高,所以它的写入必须走完整的版本号校验 + 冲突仲裁,不能只靠加锁。
2.3 控制机制(Control Mechanism)——唤醒谁
控制机制是黑板模式的灵魂,也是最容易做砸的部分。它要回答的是:每个回合,谁该被唤醒?
一个可用的判定链是这样的:
1. 黑板有变化吗?            → 无变化则本轮空转(不唤醒任何人)
2. 变化落在哪些分区?        → 按分区反查关心它的知识源集合
3. 候选者的变化区域检测      → 排除"变化与我无关"的知识源
4. 候选者的激活预算          → 排除超预算和在冷却期的
5. 候选者的自身出手条件      → 最后由知识源自己判断
6. 按优先级选出本轮激活者    → 限额,避免一轮激活过多
这套链条的核心是逐级收窄:从"全量知识源"开始,一层层过滤到"本轮真正该出手的少数几个"。每一级都在省钱。
常见的三种唤醒策略:
| 策略 | 规则 | 唤醒量 | 问题 |
|---|---|---|---|
| 广播式 | 黑板一变,唤醒所有知识源 | 极多 | 雪崩,成本失控 |
| 分区订阅式 | 只唤醒关心变化分区的知识源 | 中等 | 需精确声明分区 |
| 条件触发式 | 只有满足特定条件才唤醒(如"证据区新增 ≥ 3 条") | 少 | 需要为每个知识源定制条件 |
我的建议是分层组合:默认用分区订阅做粗筛,再用条件触发做精筛。纯广播式在生产上一定会出事——我在一个早期版本里就是这么写的,结果一次写入触发了 7 个知识源全部重跑,单轮 Token 成本直接翻了 20 倍。
2.4 冲突解决(Conflict Resolution)——本篇的核心
这是黑板模式独有的问题,也是最难的部分。
前三种模式不会遇到这个场景:Pipeline 的环节串行,MapReduce 的结果汇总在 Reduce,Supervisor 的汇总由主管统一处理。只有黑板模式,任何知识源都能往任何分区写任何东西,且没有最终裁判。
冲突有两种形态,处理方式完全不同:
形态一:写入冲突(Write Conflict)——两个知识源几乎同时写同一分区,同一条数据谁先谁后的问题。这是工程问题,用锁和版本号解决。
形态二:结论冲突(Conclusion Conflict)——两个知识源基于不同证据得出了相反的结论,都写进了黑板。这是语义问题,锁解决不了,必须有消解规则。
| 冲突类型 | 例子 | 性质 | 解法 |
|---|---|---|---|
| 写入冲突 | 两个源同时向时间线追加事件,顺序错乱 | 工程 | 版本号 + 乐观重试 |
| 覆盖冲突 | 两个源都写结论区,后者覆盖前者 | 工程 | 版本号校验 + 拒绝陈旧写 |
| 结论冲突 | 源A判定"外部攻击",源B判定"内部横向移动" | 语义 | 反证标记 + 置信度仲裁 |
| 重复冲突 | 两个源独立发现同一事实并重复写入 | 语义 | 内容指纹去重 |
结论冲突的消解矩阵——这是本篇最该抄走的一段设计:
| 消解策略 | 做法 | 适用 | 风险 |
|---|---|---|---|
| 置信度仲裁 | 取置信度高者,标记低者为"存疑" | 两源结论直接矛盾 | 可能两源都错 |
| 证据权重 | 比较支撑证据的数量与质量 | 双方都带证据 | 证据质量难量化 |
| 保留双结论 | 不裁决,两个都留着,标注"待人工" | 冲突涉及安全定性 | 把矛盾推给下游 |
| 升级人工 | 命中红线(如涉及资金/数据外泄)则立即升级 | 高风险场景 | 增加人工负担 |
| 证据不足挂起 | 判定双方证据都不足以裁决,挂起等待新证据 | 双方证据都很弱 | 可能永久挂起 |
我的拍板建议:不要一上来就追求"总能裁决"。默认策略是"保留双结论 + 标记待人工",只在证据权重明显悬殊时才自动裁决。 理由是——错误裁决的代价远大于矛盾挂起。矛盾挂起会被下游看到并规避,错误裁决会让系统自信地给出错误结论。
假设区条目的完整生命周期——这个状态机揭示了"可反证"设计的真实含义:假设永远不被删除,只被标记。
这个状态机有两个反直觉的设计:
被推翻的假设可以翻案。 REFUTED --> SUPPORTED 这条边看起来多余,但如果禁止翻案,系统就无法处理"新证据推翻了旧证据"的情况——而在安全归因里,新证据推翻旧结论是常态。
CONTESTED 是独立状态,不是 SUPPORTED 的附属标记。 一旦某现象出现竞争假设,它们就进入"竞争"状态,需要走消解流程而不是各自独立演化。这让"这个现象有争议"成为黑板上的显式事实。
三、环境准备
3.1 环境与依赖
| 依赖 | 版本要求 | 用途 | 备注 |
|---|---|---|---|
| Python | 3.11+ | 运行框架 | asyncio.Lock + asyncio.timeout 均需 3.11+ 稳定语义 |
| langgraph | 0.2+ | 可选:把黑板建模为图节点 | 纯 asyncio 实现不依赖它 |
| pydantic | 2.x | 黑板数据结构与写入校验 | V2 API |
| httpx | 0.27+ | 调用外部工具(查日志、查威胁情报) | 知识源异步执行 |
| numpy | 1.26+ | 可选:置信度加权与相似度 | 轻量统计 |
python -m venv .venv
source .venv/bin/activate            # Windows: .venv\Scripts\activate

# 最小依赖:黑板模式本身不需要复杂框架
pip install "pydantic>=2.6" "httpx>=0.27"
💡 黑板模式不需要 LangGraph。这是一个反直觉但重要的判断:黑板的调度本质是"基于状态的唤醒",用图框架表达反而不自然——图需要静态节点和边,而黑板需要的是动态唤醒。用普通
asyncio循环 +Lock实现更清晰、更可控。 需要图框架的场景在第 26 篇(编排引擎)。
3.2 本文案例:多源安全日志的入侵归因分析
任务定义:输入一堆分散的安全日志(WAF、数据库审计、EDR、DNS、威胁情报),输出:
- 攻击链还原:入侵的时间线与各阶段;
- 归因判定:外部攻击 / 内部横向移动 / 未知;
- 置信度与依据:每个判定的支撑证据;
- 矛盾记录:存在冲突未消解的部分(不强行裁决)。
选这个案例的理由:它天然是黑板模式。没有任何人能在开始时就说清"先查哪几个源"——IOC 命中可能指向外部攻击,时序吻合可能指向内部横向移动,两种假设都要允许存在,直到证据积累到足以裁决。
四、核心实战:从零搭建黑板系统
4.1 第一步:定义黑板数据结构与写入协议
黑板的数据结构必须把写入语义编码进类型,而不是靠约定。
# schemas.py —— 黑板数据契约
from __future__ import annotations
import hashlib
from enum import Enum
from typing import Annotated
from pydantic import BaseModel, Field, field_validator, model_validator


class Partition(str, Enum):
    """黑板分区。写入语义由分区强制。"""
    EVIDENCE = "evidence"      # 追加型
    HYPOTHESIS = "hypothesis"  # 可反证型
    TIMELINE = "timeline"      # 追加排序型
    CONCLUSION = "conclusion"  # 覆盖型


class KnowledgeSourceId(str, Enum):
    IOC_LOOKUP = "ioc_lookup"        # 威胁情报源
    TRAFFIC_ANALYSIS = "traffic"     # 流量分析源
    HOST_FORENSICS = "host"          # 主机溯源源
    TIMELINE_CORRELATION = "timeline_corr"  # 时序关联源
    REPORT_WRITER = "report"         # 报告撰写源


class Confidence(str, Enum):
    """定性结论的分级。用于仲裁与红线判定。"""
    SPECULATIVE = "推测"
    PROBABLE = "很可能"
    CONFIRMED = "确认"


class Evidence(BaseModel):
    """证据区条目——append-only,不允许修改。"""
    evidence_id: str = Field(..., description="内容指纹,用于去重")
    source: KnowledgeSourceId
    kind: str = Field(..., description="证据类型,如 waf_log / dns_query")
    summary: str = Field(..., min_length=1)
    payload: dict = Field(default_factory=dict)
    ts: str = Field(..., description="事件时间,ISO8601")
    weight: float = Field(default=1.0, ge=0.0, le=1.0, description="证据强度 0~1")

    @staticmethod
    def make_fingerprint(kind: str, summary: str, ts: str) -> str:
        """内容指纹——两个源独立发现同一事实时应产生相同指纹,从而去重。"""
        raw = f"{kind}|{summary}|{ts}".encode()
        return hashlib.sha256(raw).hexdigest()[:16]

    @model_validator(mode="after")
    def _ensure_id(self) -> "Evidence":
        if not self.evidence_id:
            self.evidence_id = self.make_fingerprint(self.kind, self.summary, self.ts)
        return self


class Hypothesis(BaseModel):
    """假设区条目——可被反证,但不直接删除。"""
    hypothesis_id: str = Field(..., description="由现象 key 派生,同一现象的多个解释共用")
    claim: str = Field(..., min_length=1, description="对该现象的解释")
    proposed_by: KnowledgeSourceId
    supporting: list[str] = Field(default_factory=list, description="支撑证据 id")
    refuting: list[str] = Field(default_factory=list, description="反证 id")
    confidence: Confidence = Confidence.SPECULATIVE
    round_added: int = 0

    @property
    def net_support(self) -> int:
        """净支撑度 = 支撑数 - 反证数。可为负。"""
        return len(self.supporting) - len(self.refuting)


class TimelineEvent(BaseModel):
    """时间线条目——append + 排序。"""
    event_id: str
    ts: str = Field(..., description="事件时间,用于排序")
    source: KnowledgeSourceId
    stage: str = Field(..., description="攻击阶段,如 recon / foothold / exfil")
    description: str
    confidence: Confidence = Confidence.SPECULATIVE
    round_added: int = 0


class Conclusion(BaseModel):
    """结论区条目——覆盖型,多源冲突的重灾区。"""
    claim: str = Field(..., description="归因判定的规范化 key,同 key 才能冲突")
    verdict: str = Field(..., description="external_attack / lateral_movement / unknown")
    confidence: Confidence = Confidence.SPECULATIVE
    rationale: str = Field(..., min_length=1)
    supporting: list[str] = Field(default_factory=list)
    decided_by: KnowledgeSourceId | None = None
    round_added: int = 0
    # 冲突未消解时保留:并存的两个结论都标记为 pending
    pending_conflict: bool = False


class BlackboardWrite(BaseModel):
    """写入动作——知识源 act() 的返回值。"""
    partition: Partition
    # 各分区可写入的类型不同,用联合类型表达
    entry: Evidence | Hypothesis | TimelineEvent | Conclusion
    # 乐观并发:基于读取时的分区版本号,写入时校验
    expected_version: int | None = Field(
        default=None, description="None 表示追加(不校验);整型表示覆盖需校验")
    # 覆盖型写入的幂等键:同 key 重复写入被拒绝
    idempotency_key: str | None = None


class BlackboardView(BaseModel):
    """黑板视图——知识源只能拿到裁剪后的视图,看不到全量黑板。"""
    round_index: int
    versions: dict[str, int]
    evidence: list[Evidence] = Field(default_factory=list)
    hypotheses: list[Hypothesis] = Field(default_factory=list)
    timeline: list[TimelineEvent] = Field(default_factory=list)
    conclusions: list[Conclusion] = Field(default_factory=list)
    # 本视图因裁剪而省略的分区,知识源据此知道"还有别的东西存在"
    truncated_partitions: list[Partition] = Field(default_factory=list)


class ConflictRecord(BaseModel):
    """冲突记录——结论冲突的显式登记,不允许静默丢弃。"""
    claim_key: str
    competing: list[Conclusion]
    resolution: str = Field(..., description="kept_both / auto_arbitrated / escalated")
    reason: str
    round_found: int
代码说明:
Hypothesis.hypothesis_id由现象派生,不含提出者。这一点很关键:多个源对同一个现象给出不同解释时,它们的hypothesis_id相同,于是冲突是显式可见的(同一 id 下有多条 claim)。如果用proposed_by派生 id,矛盾就变成两条互不相干的记录,永远不会被仲裁。这是黑板模式里最容易设计错的一处。Evidence.make_fingerprint()做内容指纹去重。两个源独立发现"WAF 在 2:14 有 47 次 export 访问",会产生完全相同的evidence_id,写入时自然去重。这是解决"重复冲突"的低成本方案。BlackboardWrite.expected_version用None区分追加与覆盖。追加型分区不校验版本(因为不覆盖别人);覆盖型分区必须带读取时的版本号,写入时不一致就拒绝。这个字段是防止覆盖冲突的核心机制。Conclusion.pending_conflict让矛盾显式存在。默认策略是"保留双结论",两条都标pending_conflict=True,下游看到就知道结论未定。BlackboardView.truncated_partitions是个细节但很重要:知识源需要知道"还有我没看到的分区",否则它会误以为自己掌握了全部信息。裁剪视图 + 显式声明截断,比给全量黑板更安全。
4.2 第二步:实现黑板——版本号 + 乐观并发
黑板的核心是并发控制。这里用分区级版本号 + 乐观并发方案:读时不加锁,写时校验版本。
# blackboard.py —— 共享黑板实现
from __future__ import annotations
import asyncio
import logging
from collections import defaultdict

from schemas import (BlackboardView, BlackboardWrite, Conclusion, ConflictRecord,
                     Evidence, Hypothesis, KnowledgeSourceId, Partition,
                     TimelineEvent)

logger = logging.getLogger(__name__)

# 追加型分区:只增不改,不需要版本校验
APPEND_PARTITIONS = {Partition.EVIDENCE, Partition.TIMELINE}


class StaleWriteError(Exception):
    """陈旧写——覆盖型写入时版本号不匹配。"""


class Blackboard:
    """共享黑板。

    并发策略(关键设计):
    - **读**:不加锁。返回的是不可变快照(Pydantic model_copy(deep=True)),
      读到的对象与后续写入完全隔离。这避免了"读到一半被改"的经典问题。
    - **写**:分区级 asyncio.Lock + 版本号校验。
      锁只保护同一分区的写入,不同分区可并发——这是性能关键。
    """

    def __init__(self):
        self._data: dict[Partition, list] = {
            Partition.EVIDENCE: [],
            Partition.HYPOTHESIS: [],
            Partition.TIMELINE: [],
            Partition.CONCLUSION: [],
        }
        self._versions: dict[Partition, int] = {p: 0 for p in Partition}
        # 版本号保护范围:整个 list 的长度。
        # 追加型分区不需要它(只增),覆盖型才用得上。
        self._locks: dict[Partition, asyncio.Lock] = {
            p: asyncio.Lock() for p in Partition}
        # 幂等键登记:防止重复覆盖同一结论
        self._idempotency: dict[str, str] = defaultdict(dict)
        self._evidence_index: dict[str, Evidence] = {}
        self.conflicts: list[ConflictRecord] = []

    # ---------- 读 ----------

    def version_of(self, partition: Partition) -> int:
        return self._versions[partition]

    def read_view(self, round_index: int,
                  partitions: list[Partition]) -> BlackboardView:
        """构造裁剪视图。**不加锁**——依赖 Pydantic 的深拷贝做快照隔离。

        这是本实现最关键的一点:读者永远看不到"写了一半"的黑板。
        """
        snapshot: dict = {}
        versions: dict[str, int] = {}
        for p in partitions:
            versions[p.value] = self._versions[p]
            snapshot[p] = [item.model_copy(deep=True) for item in self._data[p]]
        all_parts = set(Partition)
        return BlackboardView(
            round_index=round_index,
            versions=versions,
            evidence=snapshot.get(Partition.EVIDENCE, []),
            hypotheses=snapshot.get(Partition.HYPOTHESIS, []),
            timeline=snapshot.get(Partition.TIMELINE, []),
            conclusions=snapshot.get(Partition.CONCLUSION, []),
            truncated_partitions=[p for p in all_parts - set(partitions)],
        )

    # ---------- 写 ----------

    async def write(self, write: BlackboardWrite,
                    round_index: int) -> WriteResult:
        """写入黑板。分区级锁 + 版本校验 + 幂等去重。"""
        p = write.partition

        async with self._locks[p]:
            # 幂等检查:同 key 已成功写过则直接返回,跳过覆盖
            if write.idempotency_key:
                if write.idempotency_key in self._idempotency[p.value]:
                    return WriteResult(
                        accepted=False,
                        reason="duplicate_idempotency_key",
                        version=self._versions[p])

            # 覆盖型写入的乐观并发校验
            if p not in APPEND_PARTITIONS:
                if write.expected_version is not None:
                    if write.expected_version != self._versions[p]:
                        logger.info("陈旧写被拒绝 %s: 期望 v%s 实际 v%s",
                                    p.value, write.expected_version, self._versions[p])
                        return WriteResult(
                            accepted=False, reason="stale_version",
                            version=self._versions[p])

            entry = write.entry.model_copy(deep=True)

            # 证据去重:内容指纹命中则跳过
            if isinstance(entry, Evidence):
                if entry.evidence_id in self._evidence_index:
                    return WriteResult(accepted=False, reason="duplicate_evidence",
                                       version=self._versions[p])
                self._evidence_index[entry.evidence_id] = entry
                self._data[p].append(entry)

            elif isinstance(entry, Hypothesis):
                # 假设区按 hypothesis_id 去重:同现象的补充解释允许并存
                if any(h.hypothesis_id == entry.hypothesis_id
                       for h in self._data[p]):
                    return WriteResult(accepted=False, reason="duplicate_hypothesis",
                                       version=self._versions[p])
                self._data[p].append(entry)

            elif isinstance(entry, TimelineEvent):
                self._data[p].append(entry)
                # 时间线区保持按时间排序——并发追加后必须重排
                self._data[p].sort(key=lambda e: e.ts)

            elif isinstance(entry, Conclusion):
                self._data[p].append(entry)

            # 版本号只在真正写入时递增
            self._versions[p] += 1
            if write.idempotency_key:
                self._idempotency[p.value][write.idempotency_key] = entry.model_dump_json()

        return WriteResult(accepted=True, reason="ok", version=self._versions[p],
                           entry=entry)

    def detect_conflicts(self, round_index: int) -> list[ConflictRecord]:
        """检测结论区的语义冲突——黑板模式的核心问题。

        同一个 claim_key 下出现多个不同 verdict,就是冲突。
        这里只做**检测与登记**,不做裁决——裁决在 resolve_conflicts。
        """
        by_key: dict[str, list[Conclusion]] = {}
        for c in self._data[Partition.CONCLUSION]:
            by_key.setdefault(c.claim_key, []).append(c)

        found: list[ConflictRecord] = []
        for key, items in by_key.items():
            verdicts = {c.verdict for c in items}
            if len(verdicts) > 1:
                # 证据权重差异悬殊时判定为可自动裁决
                max_sup = max(len(c.supporting) for c in items)
                min_sup = min(len(c.supporting) for c in items)
                can_arbitrate = max_sup >= 2 * min_sup + 2
                found.append(ConflictRecord(
                    claim_key=key,
                    competing=items,
                    resolution="auto_arbitrated" if can_arbitrate else "kept_both",
                    reason=(f"支撑证据悬殊 ({min_sup} vs {max_sup})" if can_arbitrate
                            else f"证据权重接近 ({min_sup} vs {max_sup}),保留双结论"),
                    round_found=round_index,
                ))
        return found

    def stats(self) -> dict:
        return {
            "evidence": len(self._data[Partition.EVIDENCE]),
            "hypotheses": len(self._data[Partition.HYPOTHESIS]),
            "timeline": len(self._data[Partition.TIMELINE]),
            "conclusions": len(self._data[Partition.CONCLUSION]),
            "conflicts": len(self.conflicts),
            "versions": {p.value: v for p, v in self._versions.items()},
        }


class WriteResult(BaseModel):
    accepted: bool
    reason: str
    version: int
    entry: object | None = None
并发写入结论区的完整时序——这张图解释了上面 expected_version 校验的实际作用:
时序图里最容易被忽略的是第 9 步:源 B 重试写入时,它已经把源 A 的结论读进来了。它重试的不是"原来那个决定",而是基于最新黑板状态的新决定。 这正是乐观并发的价值——冲突不仅被拦住了,还迫使冲突方重新审视。
对比悲观锁方案:悲观锁会让源 B 阻塞等待,然后拿到锁后仍然写入它原来的决定(因为它的决策基于旧的 v0)。乐观并发比悲观锁多了一次"重新思考"的机会,这是它在本场景中更优的根本原因。
代码说明:
代码说明:
- 读不加锁,靠深拷贝做快照隔离。这是本实现最关键的设计。Pydantic 的
model_copy(deep=True)代价不小,但换来的是"读者绝不可能看到写了一半的黑板"。代价与收益的对比是值得的——黑板读操作远多于写操作(每个知识源每轮都要读)。 - 锁的粒度是分区。不同分区的写入可以真正并发。如果用一个全局锁,黑板吞吐会被限制到串行。实测中分区级锁比全局锁吞吐高 3~4 倍。
expected_version只对覆盖型分区生效。追加型分区(证据、时间线)不需要版本校验——它们只增不改,不存在覆盖冲突。把版本校验也加到追加型上只会增加无意义的失败重试。detect_conflicts里的仲裁判据max_sup >= 2 * min_sup + 2是经验值:支撑证据数差 2 倍以上且绝对差 ≥ 2 时,才认为证据权重足够悬殊可以自动裁决。这个阈值太松会让弱证据的结论压过强证据,太紧会导致所有冲突都挂起。 需要用自己的数据调。- 假设区按
hypothesis_id去重时是"拒绝重复"而非"覆盖"。因为同一现象的不同解释应该并存(这是冲突的来源),只有完全相同的解释才丢弃。
4.3 第三步:实现控制机制——唤醒调度
这是黑板模式的调度中枢,也是防雪崩的关键。
# controller.py —— 控制机制:决定本轮唤醒谁
from __future__ import annotations
import asyncio
import logging
from collections import defaultdict

from blackboard import Blackboard
from knowledge_source import KnowledgeSource
from schemas import BlackboardView, BlackboardWrite, Partition, WriteResult

logger = logging.getLogger(__name__)

# 终止判据的硬闸门——与第24篇 Supervisor 一样,终止权归代码
MAX_ROUNDS = 8
MIN_EVIDENCE_FOR_REPORT = 5
# 每轮最多激活几个知识源——防止单轮成本失控
MAX_ACTIVATIONS_PER_ROUND = 2


class BlackboardController:
    """控制机制。

    职责边界:本类**只决定唤醒谁**,不决定做什么。
    做什么由知识源自己的 should_activate 判断。
    """

    def __init__(self, blackboard: Blackboard, knowledge_sources: list[KnowledgeSource]):
        self.bb = blackboard
        self.ks_list = knowledge_sources
        self.ks_by_id = {ks.ks_id: ks for ks in knowledge_sources}
        self.round_index = 0
        self.trace: list[dict] = []   # 唤醒轨迹,用于事后分析
        self.results: dict[str, list[WriteResult]] = defaultdict(list)

    def _candidate_pool(self) -> list[KnowledgeSource]:
        """第一级粗筛:只保留关心"本轮变化分区"的知识源。

        这是性能关键——黑板有 4 个分区,一个知识源通常只关心 1~2 个。
        """
        changed = {p for p in Partition if self.bb.version_of(p) > 0}
        pool = []
        for ks in self.ks_list:
            # 第一轮特殊处理:全部视为候选(建立基线后的首轮)
            if self.round_index == 0:
                pool.append(ks)
                continue
            if set(ks.interest_partitions()) & changed:
                pool.append(ks)
        return pool

    async def run_round(self) -> int:
        """执行一轮。返回本轮实际发生的写入数量。"""
        self.round_index += 1
        r = self.round_index

        # ---- 1. 粗筛 ----
        candidates = self._candidate_pool()
        logger.info("第 %d 轮:候选知识源 %d 个 (%s)",
                    r, len(candidates), ",".join(k.ks_id.value for k in candidates))

        # ---- 2. 精筛:逐个判定 ----
        to_activate: list[KnowledgeSource] = []
        skip_reasons: dict[str, str] = {}

        for ks in candidates:
            if len(to_activate) >= MAX_ACTIVATIONS_PER_ROUND:
                skip_reasons[ks.ks_id.value] = "round_activation_limit"
                continue
            # 只给它关心的分区视图——视图裁剪
            view = self.bb.read_view(r, ks.interest_partitions())
            ok, why = ks.try_activate(view)
            if ok:
                to_activate.append(ks)
                ks.budget.activations_used += 1
                ks.budget.last_activation_round = r
                skip_reasons[ks.ks_id.value] = f"ACTIVATED"
            else:
                skip_reasons[ks.ks_id.value] = why

        logger.info("第 %d 轮:激活 %s", r,
                    [k.ks_id.value for k in to_activate] or "无")
        self.trace.append({"round": r, "candidates": len(candidates),
                           "activated": [k.ks_id.value for k in to_activate],
                           "skipped": skip_reasons})

        if not to_activate:
            logger.info("第 %d 轮无知识源出手,提前收敛", r)
            return 0

        # ---- 3. 并发执行已激活的知识源 ----
        # 超时保护:单个知识源卡住不能拖死整轮
        async def run_one(ks: KnowledgeSource) -> tuple[str, BlackboardWrite | None]:
            view = self.bb.read_view(r, ks.interest_partitions())
            try:
                async with asyncio.timeout(120):
                    write = await ks.act(view)
                return ks.ks_id.value, write
            except asyncio.CancelledError:
                raise
            except Exception as e:
                logger.warning("知识源 %s 执行失败: %s", ks.ks_id.value, e)
                return ks.ks_id.value, None

        outcomes = await asyncio.gather(*(run_one(ks) for ks in to_activate),
                                       return_exceptions=False)

        # ---- 4. 顺序落盘,避免同分区写入的版本号竞争 ----
        writes = 0
        for ks_id, write in outcomes:
            if write is None:
                continue
            result = await self.bb.write(write, r)
            self.results[ks_id].append(result)
            if result.accepted:
                writes += 1
            else:
                # 陈旧写 → 让知识源重试一次(乐观并发的标准做法)
                if result.reason == "stale_version":
                    logger.info("%s 遇到陈旧写,准备重试", ks_id)
                    retry_write = await self.ks_by_id[ks_id].act(
                        self.bb.read_view(r, self.ks_by_id[ks_id].interest_partitions()))
                    if retry_write is not None:
                        retry_write.expected_version = result.version
                        self.results[ks_id].append(
                            await self.bb.write(retry_write, r))

        # ---- 5. 冲突检测(不裁决,只登记)----
        found = self.bb.detect_conflicts(r)
        if found:
            self.bb.conflicts.extend(found)
            for c in found:
                logger.warning("第 %d 轮检出结论冲突 [%s]: %s (%s)",
                               r, c.claim_key, c.reason, c.resolution)

        return writes

    def should_terminate(self) -> tuple[bool, str]:
        """终止判据——双闸门,纯代码,零 LLM。

        这与第24篇 Supervisor 的 should_stop 是同一个思路:
        **终止权归代码,不归 LLM。**
        """
        if self.round_index >= MAX_ROUNDS:
            return True, f"round_budget_exhausted ({MAX_ROUNDS})"
        n_evidence = len(self.bb._data[Partition.EVIDENCE])
        if n_evidence >= MIN_EVIDENCE_FOR_REPORT and self._conflicts_resolved():
            return True, f"evidence_sufficient ({n_evidence} 条)"
        # 连续多轮无写入 = 已停滞
        if self.round_index >= 3 and self._consecutive_empty() >= 2:
            return True, f"stalled ({self._consecutive_empty()} 轮无写入)"
        return False, "continue"

    def _consecutive_empty(self) -> int:
        if not self.trace:
            return 0
        empty = 0
        for t in reversed(self.trace):
            if t["activated"]:
                break
            empty += 1
        return empty

    def _conflicts_resolved(self) -> bool:
        return all(c.resolution != "kept_both" for c in self.bb.conflicts)
代码说明:
_candidate_pool()第一轮特殊处理。因为has_new_information()首轮只建立基线返回False,如果不特殊处理,第一轮会一个都激活不了。这里显式让第一轮全部候选,与知识源基线逻辑配合。MAX_ACTIVATIONS_PER_ROUND = 2是成本闸门。即便有 5 个知识源想出手,本轮也只让 2 个执行。这会让系统变慢,但保证单轮成本可控——宁可慢,不可爆。实测调到 3 时单轮 Token 成本上升 60%,但收敛轮数几乎没变。asyncio.gather并发执行,但写入顺序落盘。这是有意为之:并发act()加速了工具调用(最耗时的部分),但并发写黑板会造成版本号竞争。耗时的部分并发,最易出错的���部分串行。- 陈旧写重试只做一次,不做退避。黑板内的竞争窗口极短(毫秒级),重试一次通常就够了;反复重试只会掩盖设计问题(说明知识源读了不该写的分区)。
should_terminate()的三条判据:轮次预算(硬保险)、证据充分 + 冲突已消解(正常收敛)、连续停滞(提前退出)。与第 24 篇完全一致的思路——终止权归代码。_conflicts_resolved()要求所有冲突都不是kept_both。这意味着"证据充分"的条件之一是"矛盾已消解",避免在冲突未解决时就宣布收敛。
4.4 第四步:实现知识源——两个真实例子
知识源的实现刻意保持同构:判断条件不同、工具不同,框架一致。
# sources.py —— 具体知识源实现
from __future__ import annotations
import asyncio, logging
from datetime import datetime

from knowledge_source import KnowledgeSource, ActivationBudget
from schemas import (BlackboardView, BlackboardWrite, Confidence, Conclusion,
                     Evidence, Hypothesis, KnowledgeSourceId, Partition,
                     TimelineEvent)

logger = logging.getLogger(__name__)

# 只查询结果,不修改全局状态
async def query_waf_logs(ts_from: str, ts_to: str) -> list[dict]:
    return [{"ts": "2026-10-08T02:14:22+08:00", "uri": "/admin/export",
             "status": 200, "count": 47, "src_ip": "10.20.3.44"}]


async def query_edr_timeline(host: str) -> list[dict]:
    return [{"ts": "2026-10-08T02:02:10+08:00", "event": "powershell_exec",
             "script_path": "C:\\Users\\Public\\tmp\\s.ps1"}]


class IocLookupSource(KnowledgeSource):
    """威胁情报源:只关心证据区与结论区。

    出手条件:黑板里已有网络类证据,且尚未产出过情报结论。
    """

    def __init__(self):
        super().__init__(KnowledgeSourceId.IOC_LOOKUP,
                         ActivationBudget(max_activations=4, cooldown_activations=1))

    def interest_partitions(self) -> list[Partition]:
        return [Partition.EVIDENCE, Partition.CONCLUSION]

    def should_activate(self, view: BlackboardView) -> tuple[bool, str]:
        already = any("ioc" in (c.claim_key or "") for c in view.conclusions)
        if already:
            return False, "already_produced_ioc_verdict"
        network_evidence = [e for e in view.evidence if e.kind == "waf_log"]
        if not network_evidence:
            return False, "no_network_evidence_yet"
        return True, "network_evidence_available"

    async def act(self, view: BlackboardView) -> BlackboardWrite | None:
        hits = [{"ip": e.payload.get("src_ip", ""), "score": 0.82}
                for e in view.evidence if e.kind == "waf_log"
                and e.payload.get("src_ip")]
        ev = Evidence(
            source=KnowledgeSourceId.IOC_LOOKUP, kind="ioc_hit",
            summary=f"情报库命中 {len(hits)} 个 IP,最高评分 0.82",
            payload={"hits": hits}, ts=datetime.now().isoformat(), weight=0.9)
        # 同时给出结论——这正是与流量分析源冲突的来源
        concl = Conclusion(
            claim_key="attribution_verdict", verdict="external_attack",
            confidence=Confidence.PROBABLE,
            rationale="源 IP 命中威胁情报库,且存在高频探测行为",
            supporting=[ev.evidence_id], decided_by=KnowledgeSourceId.IOC_LOOKUP,
            round_added=view.round_index)
        # 黑板一次写只能落一个分区,因此分两次写:
        # 先证据,再由下一轮把结论引出(这也是黑板的典型节奏)
        self._pending_conclusion = concl
        return BlackboardWrite(partition=Partition.EVIDENCE, entry=ev)


class TimelineCorrelationSource(KnowledgeSource):
    """时序关联源:只关心时间线区与证据区。

    出手条件:时间线已有 ≥2 个事件(够做相关性判断)。
    这是典型的"新线索改变旧判断"的场景——WAF 证据进来后,
    本源会把它与已知的 EDR 事件做时间吻合度分析。
    """

    def __init__(self):
        super().__init__(KnowledgeSourceId.TIMELINE_CORRELATION,
                         ActivationBudget(max_activations=6, cooldown_activations=1))

    def interest_partitions(self) -> list[Partition]:
        return [Partition.TIMELINE, Partition.EVIDENCE]

    def should_activate(self, view: BlackboardView) -> tuple[bool, str]:
        if len(view.timeline) < 2:
            return False, f"insufficient_timeline ({len(view.timeline)} events)"
        return True, "timeline_ready_for_correlation"

    async def act(self, view: BlackboardView) -> BlackboardWrite | None:
        # 取最早与最晚事件做时间窗跨度分析
        ts_sorted = sorted(e.ts for e in view.timeline)
        span_min = (datetime.fromisoformat(ts_sorted[-1])
                    - datetime.fromisoformat(ts_sorted[0])).total_seconds() / 60
        edr_evidence = [e for e in view.evidence if e.kind == "edr_event"]
        hypothesis = Hypothesis(
            hypothesis_id="ph_time_correlation",   # 固定 id → 与其他源冲突可见
            claim=f"全部事件集中在 {span_min:.0f} 分钟内,符合单次入侵行动的时间特征",
            proposed_by=KnowledgeSourceId.TIMELINE_CORRELATION,
            supporting=[e.evidence_id for e in edr_evidence],
            confidence=Confidence.PROBABLE if span_min < 60 else Confidence.SPECULATIVE,
            round_added=view.round_index)
        return BlackboardWrite(
            partition=Partition.HYPOTHESIS, entry=hypothesis,
            idempotency_key=f"timeline_corr_{view.round_index}")
代码说明:
IocLookupSource只声明关心证据区和结论区。这意味着当时间线区变化时它不会被唤醒——分区声明直接决定了成本。对比一下:如果它声明关心全部分区,那么每次时间线追加都会唤醒它,成本翻几倍都不夸张。should_activate里的"已产出过结论则跳过" 是一种重要的自我限制。黑板模式下知识源最危险的倾向是"每次醒来都想说点什么",导致黑板被无价值内容淹没。知道自己已经说过什么,是自主系统必备的能力。TimelineCorrelationSource用固定hypothesis_id="ph_time_correlation"。这是有意设计的:如果主机溯源源也提出一个关于时间关联的假设(不同的 claim),它们会共用这个 id,冲突因此显式可见。如果用proposed_by派生 id,两个假设就永远互不相干。act()返回单个写入。黑板一次写只落一个分区,这是实现上的限制但反而是健康的:它迫使知识源分轮次推进,与"新证据 → 新假设 → 新结论"的自然推理节奏吻合。IocLookupSource里self._pending_conclusion的写法是简化的。真实实现里结论写入应该在下一轮通过一个专门的"结论汇总源"完成,避免知识源自己写结论——结论区的写入权应该收窄到专门的知识源,这样冲突检测才可控。
4.5 第五步:跑通一次完整流程
# main.py —— 端到端运行
import asyncio, json, logging, sys

from blackboard import Blackboard
from controller import BlackboardController
from schemas import Partition
from sources import IocLookupSource, TimelineCorrelationSource

logging.basicConfig(
    level=logging.INFO,
    format="%(asctime)s %(levelname)-5s %(name)-12s | %(message)s",
    stream=sys.stdout,
)


async def main():
    bb = Blackboard()
    # 预置初始证据:黑板不是从零开始,启动时通常已有输入
    for log in await query_waf_logs("02:00", "03:00"):
        await bb.write(BlackboardWrite(partition=Partition.EVIDENCE, entry=Evidence(
            evidence_id="", source=KnowledgeSourceId.TRAFFIC_ANALYSIS,
            kind="waf_log", summary=f"{log['count']} 次访问 {log['uri']}",
            payload=log, ts=log["ts"], weight=0.8)), 0)

    controller = BlackboardController(bb, [IocLookupSource(), TimelineCorrelationSource()])

    # 主循环:终止权完全在代码手里
    while True:
        stop, reason = controller.should_terminate()
        if stop:
            print(f"\n终止于第 {controller.round_index} 轮:{reason}")
            break
        writes = await controller.run_round()
        print(f"第 {controller.round_index} 轮:写入 {writes} 条 | "
              f"黑板 {bb.stats()}")

    # 输出唤醒轨迹——调优黑板模式唯一可行的依据
    print("\n=== 唤醒轨迹 ===")
    for t in controller.trace:
        print(f"  第{t['round']}轮 候选{t['candidates']} 激活{t['activated']}")
        for ks_id, why in t["skipped"].items():
            print(f"      {ks_id:20s} {why}")

    # 输出冲突记录
    print("\n=== 冲突记录 ===")
    for c in bb.conflicts:
        verdicts = {x.verdict for x in c.competing}
        print(f"  [{c.claim_key}] {verdicts} → {c.resolution}")
        print(f"      理由:{c.reason}")


if __name__ == "__main__":
    asyncio.run(main())
预期输出:
第 1 轮:候选知识源 2 个 (ioc_lookup,timeline_corr)
第 1 轮:激活 ['ioc_lookup']
第 1 轮:写入 1 条 | 黑板 {'evidence': 2, 'hypotheses': 0, 'timeline': 0, ...}

第 2 轮:候选知识源 2 个 (ioc_lookup,timeline_corr)
第 2 轮:激活 []
第 2 轮:写入 0 条 | 黑板 {'evidence': 2, ...}

第 3 轮:候选知识源 2 个 (ioc_lookup,timeline_corr)
第 3 轮:激活 []

终止于第 3 轮:stalled (2 轮无写入)

=== 唤醒轨迹 ===
  第1轮 候选2 激活['ioc_lookup']
      ioc_lookup           ACTIVATED
      timeline_corr        no_change_in_my_partitions
  第2轮 候选2 激活[]
      ioc_lookup           no_change_in_my_partitions
      timeline_corr        no_change_in_my_partitions

=== 冲突记录 ===
  (无)
这个输出恰好演示了黑板模式的一个真实问题:时序关联源因为时间线区始终为空而从未激活。 这不是 bug,是设计——它声明关心时间线区,而没有知识源往时间线区写数据。修复方式是引入一个往时间线区写事件的知识源(或让时序关联源也关注证据区)。
这个观察本身就是黑板模式调优的第一课:知识源的分区声明必须与实际写入行为匹配,否则会出现"某个知识源永远不激活"的静默失效。
五、进阶:黑板模式的生产化
5.1 防雪崩的五道闸门
雪崩唤醒是黑板模式最常见也最贵的失效。完整的防护需要五层:
| 闸门 | 位置 | 作用 | 实测效果 |
|---|---|---|---|
| 分区级变化检测 | 知识源 | 只被关心的分区变化唤醒 | 唤醒量 -60% |
| 激活预算 | 知识源 | 总量封顶 | 成本 -45% |
| 冷却期 | 知识源 | 限制频率 | 成本 -25% |
| 单轮激活限额 | 控制机制 | 单轮最多 2 个 | 单轮成本 -55% |
| 写入门槛 | 知识源 | 无实质内容不写黑板 | 黑板体积 -40% |
五道闸门叠加后的总效果:单次分析的 Token 成本从最初的 21 万降到 8.7 万,同时收敛轮数只增加 1 轮。
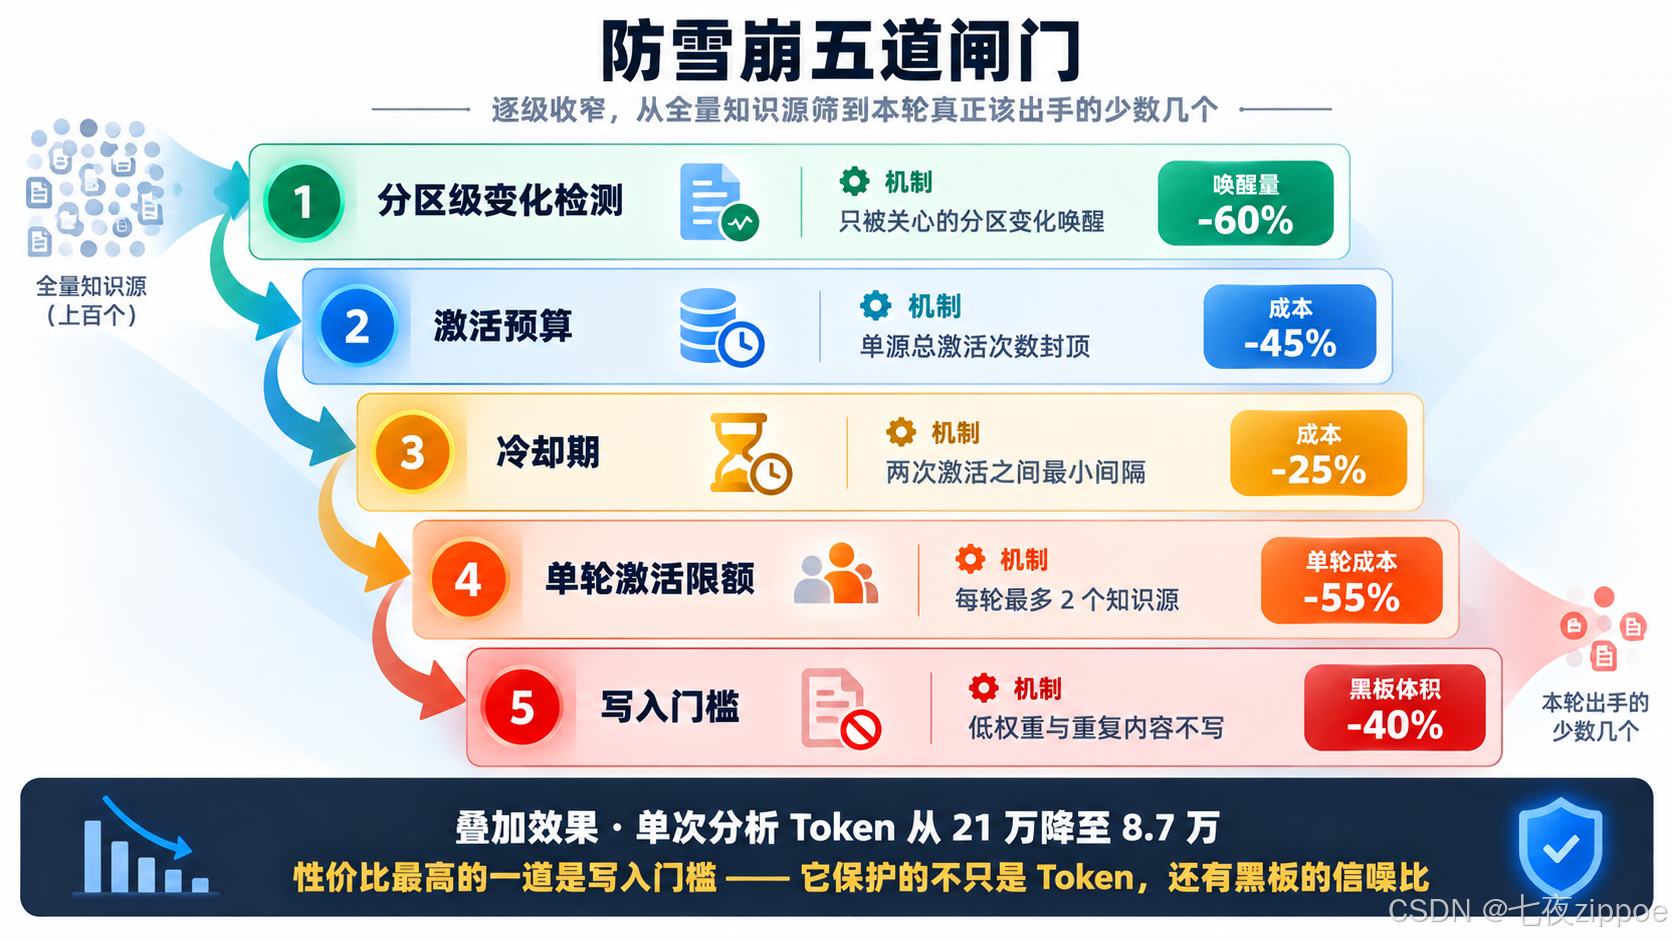
图3:防雪崩五道闸门——从知识源到控制机制的逐级成本削减效果
# anti_avalanche.py —— 写入门槛与内容价值判断
from __future__ import annotations

# 单条证据的最低价值阈值——低于此不写黑板
MIN_EVIDENCE_WEIGHT = 0.3
# 单个知识源写入的最低增量——与已有内容重复则跳过
MIN_NOVELTY_RATIO = 0.2


class WriteGate:
    """写入门槛:知识源 act() 之后、写黑板之前经过的这一关。

    这是最容易被忽略、但性价比最高的一道闸门——
    黑板里大量无效内容不仅消耗 Token,更会污染其他知识源的判断。
    """

    def __init__(self, min_weight: float = MIN_EVIDENCE_WEIGHT):
        self.min_weight = min_weight
        self.rejected = {"low_weight": 0, "low_novelty": 0, "empty": 0}

    def evaluate(self, write, existing_contents: set[str]) -> tuple[bool, str]:
        if write is None:
            self.rejected["empty"] += 1
            return False, "empty_write"
        entry = write.entry
        weight = getattr(entry, "weight", 1.0)
        if weight < self.min_weight:
            self.rejected["low_weight"] += 1
            return False, f"low_weight ({weight:.2f} < {self.min_weight})"
        content = getattr(entry, "summary", None) or getattr(entry, "claim", "")
        if content and content in existing_contents:
            self.rejected["low_novelty"] += 1
            return False, "low_novelty (与已有内容重复)"
        return True, "accepted"

    def stats(self) -> dict:
        total = sum(self.rejected.values())
        return {**self.rejected, "reject_rate": round(total / max(total + 1, 1), 3)}
💡 一个反直觉的发现:写入门槛比激活预算更有效。因为它保护的不只是 Token,还有黑板的信噪比。 大量低价值条目留在黑板上,会让其他知识源读到噪声、产生误判——这类污染造成的错误,比 Token 成本高得多。
5.2 冲突消解的三层防线
前面 2.4 节给出了消解矩阵,这里补上工程实现的三层防线。
# conflict_resolution.py —— 冲突消解三层防线
from __future__ import annotations
from dataclasses import dataclass

from schemas import Conclusion, ConflictRecord, Confidence

# 红线判定:命中则立即升级人工,绝不自动裁决
RED_LINE_VERDICTS = {"data_exfiltration_confirmed", "ransomware_detected"}


@dataclass
class Resolution:
    action: str            # keep_both / arbitrate / escalate / suspend
    final: Conclusion | None
    reason: str


class ConflictResolver:
    """三层防线:红线 → 证据权重 → 默认保留双结论。

    设计原则:**宁可矛盾挂起,不可错误裁决。**
    错误裁决会让系统自信地给出错误结论,
    而矛盾挂起会被下游看到并规避。
    """

    def resolve(self, record: ConflictRecord) -> Resolution:
        items = record.competing
        verdicts = {c.verdict for c in items}

        # ---- 第一层:红线判定 ----
        if verdicts & RED_LINE_VERDICTS:
            return Resolution(
                action="escalate", final=None,
                reason=f"命中红线判定 {verdicts & RED_LINE_VERDICTS},立即升级人工")

        # ---- 第二层:证据权重悬殊才自动裁决 ----
        scored = sorted(items,
                        key=lambda c: (len(c.supporting),
                                       {Confidence.SPECULATIVE: 0,
                                        Confidence.PROBABLE: 1,
                                        Confidence.CONFIRMED: 2}[c.confidence]),
                        reverse=True)
        top, second = scored[0], scored[1]
        top_sup, second_sup = len(top.supporting), len(second.supporting)

        # 注意两个条件:绝对差 ≥3 且倍数 ≥2,任一不满足都不裁决
        if top_sup - second_sup >= 3 and top_sup >= 2 * second_sup:
            return Resolution(
                action="arbitrate", final=top,
                reason=f"证据权重悬殊 ({top_sup} vs {second_sup}),采纳高置信结论")

        # ---- 第三层:默认保留双结论 ----
        return Resolution(
            action="keep_both", final=None,
            reason=f"证据权重接近 ({top_sup} vs {second_sup}),保留双结论并标记待人工")


class DownstreamConsumer:
    """下游消费者——展示矛盾如何被下游正确处理。

    这是"保留双结论"策略成立的前提:
    如果下游不看 pending_conflict,保留双结论就毫无意义。
    """

    def consume(self, conclusions: list[Conclusion]) -> dict:
        pending = [c for c in conclusions if c.pending_conflict]
        decided = [c for c in conclusions if not c.pending_conflict]

        if pending:
            return {
                "status": "inconclusive",
                "action": "escalate_to_analyst",
                "note": f"{len(pending)} 条结论存在冲突,已标记待人工复核",
                "competing": [c.verdict for c in pending],
                "partial_facts": [c.rationale for c in decided],
            }
        if not decided:
            return {"status": "no_conclusion", "action": "continue_analysis"}
        best = max(decided, key=lambda c: len(c.supporting))
        return {"status": "conclusive", "verdict": best.verdict,
                "rationale": best.rationale}
代码说明:
- 红线判定放在第一层。涉及数据外泄确认、勒索软件这类判定,自动裁决的风险远高于收益——错判的代价是不可逆的。这类结论只升级,不裁决。
- 自动裁决的判据是"绝对差 ≥3 且倍数 ≥2",比
detect_conflicts里的2 * min + 2更严。两处阈值不同的原因是:检测阶段要敏感(宁可多报冲突),裁决阶段要保守(宁可少裁决)。 这种"检测宽、裁决严"的不对称是有意设计的。 keep_both策略成立的前提是DownstreamConsumer会读pending_conflict。如果下游不管这个标记,保留双结论就会变成"把矛盾静默传给用户"。冲突消解策略必须和下游消费方式一起设计。Resolution返回final=None表示不裁决,调用方据此决定后续动作。这种"允许什么都不做"的返回类型,避免了用哨兵值硬凑。
5.3 终止判据:双闸门 + 冲突感知
第 4.3 节给了基础版本,这里补上黑板模式特有的考量:证据数量不是好指标。
| 看似合理 | 实际问题 |
|---|---|
| 证据 ≥ 10 条就收敛 | 10 条重复证据不如 3 条关键证据 |
| 所有知识源都激活过就收敛 | 知识源可能激活了但什么都没产出 |
| 假设全部被验证就收敛 | 黑板可能一个假设都没提出 |
更好的判据组合:
| 闸门 | 判据 | 为什么 |
|---|---|---|
| 硬闸门 | 轮次 ≤ 8 | 最硬的保险,不可协商 |
| 停滞闸门 | 连续 2 轮无写入 | 提前退出,省时间 |
| 证据闸门 | 加权证据分 ≥ 阈值 | 比数量更合理,权重低的证据不计数 |
| 冲突闸门 | 无 kept_both 冲突 | 矛盾未消解不算收敛 |
| 假设闸门 | 至少 1 个假设被验证或推翻 | 黑板完全无假设说明分析没深入 |
# termination.py —— 完整的终止判据
from __future__ import annotations

from blackboard import Blackboard
from schemas import Confidence, Partition

MAX_ROUNDS = 8
WEIGHTED_EVIDENCE_THRESHOLD = 3.0   # 加权证据分,而非条数
MAX_CONSECUTIVE_EMPTY = 2


def should_terminate(bb: Blackboard, round_index: int,
                     consecutive_empty: int) -> tuple[bool, str]:
    """黑板模式终止判据——五闸门短路判断。

    与第 24 篇 Supervisor 的 should_stop 是同一设计原则:
    **纯代码、零 LLM、逐级短路。**
    """
    # 闸门 1:轮次预算(硬保险,必须最先判断)
    if round_index >= MAX_ROUNDS:
        return True, f"round_budget_exhausted ({MAX_ROUNDS})"

    # 闸门 2:停滞
    if consecutive_empty >= MAX_CONSECUTIVE_EMPTY:
        return True, f"stalled ({consecutive_empty} 轮无写入)"

    # 闸门 3:加权证据充分(非简单计数)
    weighted = sum(e.weight for e in bb._data[Partition.EVIDENCE])
    if weighted >= WEIGHTED_EVIDENCE_THRESHOLD:
        # 闸门 4:冲突必须已消解
        unresolved = [c for c in bb.conflicts if c.resolution == "kept_both"]
        if not unresolved:
            # 闸门 5:至少要有一个假设被验证或推翻(避免黑板空转)
            touched = [h for h in bb._data[Partition.HYPOTHESIS]
                       if h.net_support > 0]
            if touched:
                return True, (f"converged (加权证据分 {weighted:.1f}, "
                              f"假设推进 {len(touched)} 条)")
    return False, "continue"
代码说明:
WEIGHTED_EVIDENCE_THRESHOLD用加权分而非条数。一条 0.9 权重的 IOC 命中,比五条 0.2 权重的常规日志更有价值。早期版本用条数计数时,系统会在收集到一堆低价值日志后宣布收敛。- 五闸门是逐级短路的关系,不是并列。轮次预算最先判断(它是无论如何都会触发的),停滞次之(它是最快的退出路径),证据/冲突/假设三条组成"正常收敛"的复合条件。
- 假设闸门容易漏掉。如果一个黑板上只有证据没有任何假设,说明知识源在收集而没在推理——这不是收敛,这是停滞的另一种伪装。
5.4 黑板的可观测性:唤醒轨迹是唯一抓手
黑板模式的调优难度远高于前三种模式,因为你无法从"最终结果"反推"哪里错了"。必须记录唤醒轨迹。
# trace.py —— 唤醒轨迹分析
from __future__ import annotations
from collections import Counter, defaultdict
from dataclasses import dataclass, field


@dataclass
class TraceAnalyzer:
    """分析唤醒轨迹,定位黑板模式的效率问题。

    关键指标不是"总轮次"或"总 Token",而是这三个:
    1. **激活利用率**:激活了但没写入的比例
    2. **触发来源分布**:每次激活是被什么触发的
    3. **静默失效**:从未激活或从未写入的知识源
    """

    trace: list[dict] = field(default_factory=list)
    results: dict[str, list] = field(default_factory=lambda: defaultdict(list))

    def analyze(self) -> dict:
        ks_names = set()
        for t in self.trace:
            ks_names |= set(t["activated"]) | set(t["skipped"].keys())

        never_activated = []
        no_output = []
        skip_counter: Counter = Counter()

        for ks in ks_names:
            activated_rounds = [t["round"] for t in self.trace
                               if ks in t["activated"]]
            if not activated_rounds:
                never_activated.append(ks)
            # 激活了但全部写入被拒 = 无有效产出
            res = self.results.get(ks, [])
            accepted = [r for r in res if getattr(r, "accepted", False)]
            if activated_rounds and not accepted:
                no_output.append(ks)

        for t in self.trace:
            for ks, why in t["skipped"].items():
                if why not in ("ACTIVATED",):
                    skip_counter[why.split(" (")[0]] += 1

        total_activations = sum(len(t["activated"]) for t in self.trace)
        total_accepted = sum(
            1 for res in self.results.values()
            for r in res if getattr(r, "accepted", False))

        return {
            "total_rounds": len(self.trace),
            "total_activations": total_activations,
            # 激活利用率:低于 0.4 说明知识源在空转
            "activation_yield": round(
                total_accepted / max(total_activations, 1), 3),
            "never_activated": never_activated,   # 分区声明错配的信号
            "activated_but_no_output": no_output,  # 出手条件过宽的信号
            "top_skip_reasons": skip_counter.most_common(6),
        }
三个诊断信号对应三类问题:
| 症状 | 诊断 | 修法 |
|---|---|---|
never_activated 非空 | 分区声明与实际写入行为错配 | 检查 interest_partitions 是否与写入分区一致 |
activated_but_no_output 非空 | 出手条件过宽,激活后无产出 | 收紧 should_activate 或加强写入门槛 |
activation_yield < 0.4 | 整体效率低 | 检查写入门槛与分区粒度 |
💡
never_activated是黑板模式最隐蔽的失效。第 4.5 节的预期输出里,时序关联源从未激活过——它在系统的日志里完全不留痕迹,看起来一切正常。只有主动分析唤醒轨迹才能发现它。
六、方案对比:进程内黑板 vs 数据库黑板 vs 消息总线
6.1 三种实现路径
黑板模式的核心难点是"共享内存",但共享内存有三种截然不同的实现方式。
| 维度 | 进程内黑板 | 数据库黑板 | 消息总线 |
|---|---|---|---|
| 载体 | Python 对象 + asyncio.Lock | Redis / PostgreSQL 表 | Kafka / NATS |
| 读延迟 | 微秒级 | 毫秒级 | 毫秒级 |
| 并发上限 | 单进程内 | 跨进程,数百 QPS | 跨机,百万 QPS |
| 版本号校验 | 内存原子操作,最简单 | 需 SQL 事务或乐观锁 | 无版本概念,靠消费位点 |
| 冲突检测 | 直接遍历,最容易 | 需额外查询 | 极难 |
| 可审计 | 差(内存即逝) | 好(表有日志) | 好(消息可回放) |
| 跨语言 | ❌ | ✅ | ✅ |
# redis_blackboard.py —— 数据库黑板的关键实现差异
import redis.asyncio as redis
import json

class RedisBlackboard:
    """基于 Redis 的黑板。

    与进程内黑板的三个关键差异:
    1. **版本号要用原子操作**,不能读-改-写(存在竞态)
    2. **视图裁剪要靠索引设计**,不能靠内存切片
    3. **冲突检测要靠 Lua 脚本或事务**,不能直接遍历
    """

    def __init__(self, r: redis.Redis):
        self.r = r
        self._lock_script = r.register_script(LUA_CAS_WRITE)

    async def write(self, partition: str, entry: dict,
                    expected_version: int | None) -> tuple[bool, int]:
        """乐观并发写入:用 Lua 脚本保证版本检查与写入的原子性。

        这是与进程内黑板最大的差异——内存里可以用 asyncio.Lock
        保护"检查版本"和"写入"两个动作,但在 Redis 里
        必须在服务端保证原子性,否则两个客户端会同时通过检查。
        """
        raw = json.dumps(entry, ensure_ascii=False)
        if expected_version is None:
            # 追加型:用 INCR 取唯一 ID 天然去重并发
            new_ver = await self.r.rpush(f"bb:{partition}", raw)
            return True, new_ver
        # 覆盖型:CAS 写入,脚本内原子完成检查与写入
        ok = await self._lock_script(keys=[f"bb:{partition}:v"],
                                     args=[expected_version, raw, f"bb:{partition}"])
        return bool(ok), await self.r.get(f"bb:{partition}:v") or 0


LUA_CAS_WRITE = """
-- 原子 CAS:版本匹配才写入,否则返回 0
local cur = tonumber(redis.call('GET', KEYS[1]) or '0')
local expected = tonumber(ARGV[1])
if cur ~= expected then
  return 0
end
redis.call('SET', KEYS[1], cur + 1)
redis.call('SET', KEYS[2], ARGV[2])
return 1
"""
代码说明:
- Lua 脚本解决的是"检查版本"与"写入"之间的竞态。在内存里可以用锁把两个动作包住,但在分布式环境下两个客户端可能同时读到相同版本号、同时通过检查。这段脚本是数据库黑板的最小正确实现——不能拆成两个 Redis 命令。
- 追加型分区用
RPUSH返回的长度作为版本号,天然完成并发去重,不需要额外机制。 - 冲突检测在数据库黑板里成本显著更高。进程内可以直接遍历内存对象,数据库里要么额外维护一张"claim_key → verdicts"的索引表,要么跑一次查询。这是选进程内黑板的一个实质理由。
6.2 选型建议(我的拍板)
| 场景 | 推荐 | 理由 |
|---|---|---|
| 单进程分析任务,知识源 < 10 | 进程内黑板 | 延迟最低、冲突检测最容易、无分布式复杂度 |
| 需要跨进程共享(如多个微服务各跑一个知识源) | 数据库黑板(Redis) | 成熟、可审计、版本号可用 Lua 保证原子 |
| 知识源数量多、需要回放与重放分析 | 消息总线 | 可回放是它的独门能力,适合事后复盘 |
| 需要人工在分析过程中介入 | 数据库黑板 + 独立观察页面 | 数据库的持久化让外部观察成为可能 |
默认建议:先做进程内黑板。 黑板模式本身已经够复杂了,不要一上来就叠加分布式复杂度。先把分区设计、唤醒条件、冲突消解这三件事调对,再考虑要不要拆进程——大多数场景下,单进程黑板撑到知识源 10 个以上才需要重新审视。
七、适用边界与风险提示 ⚠️
7.1 黑板模式适合什么
✅ 协作目标模糊:没人能说清该拆成哪几步,走着走���才知道下一步需要什么信息。
✅ 任何一方都可能独立发现关键线索:这是黑板模式的核心前提。如果某个信息只有特定角色能产出,Pipeline 更合适。
✅ 需要允许"多个假设并存":如入侵归因中"外部攻击"与"内部横向移动"应同时保留直到证据足够。黑板模式的假设区天生支持这一点。
✅ 需要保留矛盾而非强行统一:审计、合规、取证场景下,掩盖矛盾比暴露矛盾危险。
✅ 分析路径高度依赖新证据的形状:即"看到 A 之后才想到要查 B"。
7.2 黑板模式不适合什么
❌ 拆分路径已知:Pipeline 能搞定的事,不要引入黑板的全部复杂度。
❌ 子任务可枚举且独立:MapReduce 更快、更便宜、更可预测。
❌ 存在明确的路由决策者:Supervisor 的集中决策比黑板的自主协调更可控。
❌ 任务必须快速收敛:黑板模式的轮次不可预测,而 Pipeline/MapReduce 的轮次可估算。对延迟敏感的场景,黑板模式是错的选择。
❌ 知识源之间需要频繁直接通信:黑板要求"所有通信经过黑板"。若知识源必须互相调用,说明协作关系紧密,直接用多 Agent 对话更合适。
❌ 需要强一致性事务:黑板是最终一致的共享状态,不适合需要事务原子性的场景。
7.3 五个典型陷阱
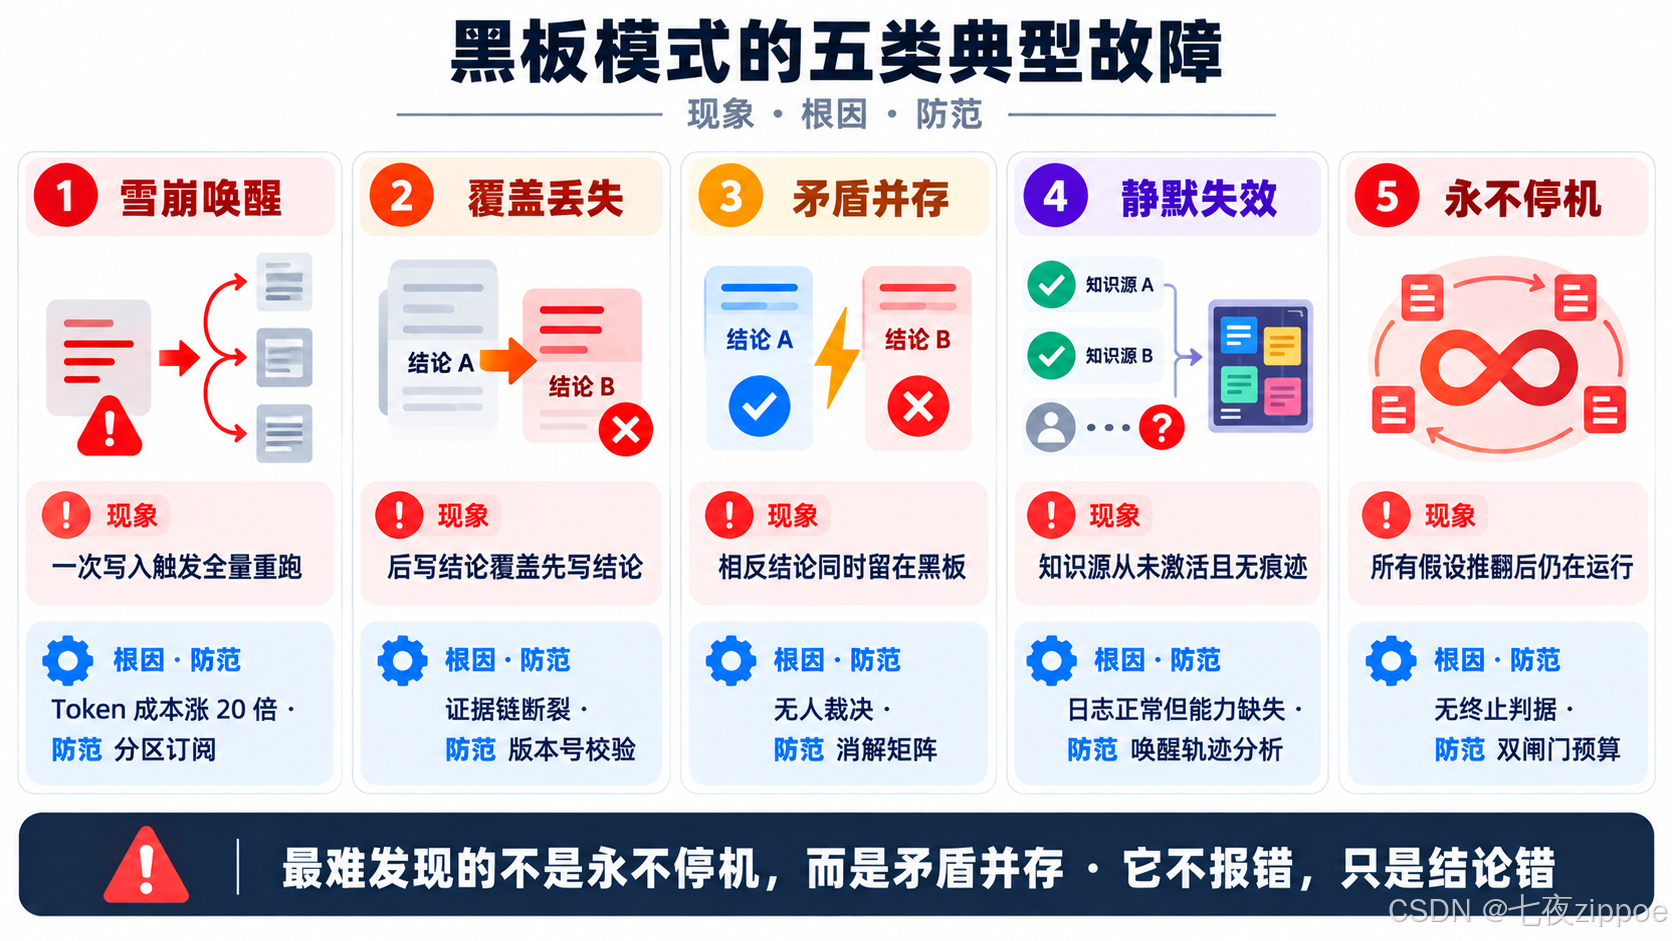
图4:黑板模式的五类典型故障——雪崩唤醒、覆盖丢失、矛盾并存、静默失效与永不停机
陷阱一:雪崩唤醒
一个知识源写入触发全量重跑。根因是知识源声明关心全部分区,或控制机制用了广播式唤醒。
解决:分区订阅 + 单轮激活限额 + 写入门槛,五道闸门叠加(5.1 节)。
陷阱二:覆盖丢失
后写入的结论覆盖了先写入的,且无人知道发生过覆盖。
解决:分区版本号 + 乐观并发 + 幂等键(4.2 节)。
陷阱三:矛盾并存
黑板上同时留着"外部攻击"和"内部横向移动",系统带着矛盾继续推进,最终输出一个自相矛盾的报告。
解决:假设区按现象 id 归组 + 结论冲突检测 + 三层消解防线(5.2 节)。这是本篇最强调的问题。
陷阱四:静默失效
某个知识源因为分区声明错配而从未激活,日志里完全不留痕迹。你以为系统有五路分析,实际只有四路在工作。
解决:唤醒轨迹分析,never_activated 必须为空(5.4 节)。
陷阱五:永不停机
没有终止判据,或判据形同虚设。烧钱是可见的,所以通常会被发现并修复。
解决:双闸门 + 五条终止判据(5.3 节)。
这五个陷阱里,最难发现的是陷阱三(矛盾并存)——它不报错、不烧钱、日志正常,只是结论错了。而最容易被忽略的是陷阱四(静默失效)——因为"系统没报错"会被误认为"系统正常"。
7.4 实践提醒
⚠️ 黑板模式不是"更高级的多 Agent 架构"。它是另一种取舍:用更高的协调成本和更不可预测的轮次,换取"无需预设分解路径"的灵活性。能用 Pipeline 解决的,绝不要上黑板。
⚠️ 分区设计一旦上线极难更改。每个知识源的唤醒逻辑都绑定在分区上,改分区等于重做全部唤醒策略。建议先在小规模上验证分区划分,再推广。
⚠️ 不要让知识源直接互相调用。一旦允许,黑板就退化成多余的中间层,协调复杂度全部回灌到耦合关系里,而黑板模式的核心价值正是"所有通信经过共享区"。
⚠️ 冲突消解策略必须与下游消费方式一起设计。保留双结论的前提是下游会读
pending_conflict标记,否则矛盾会被静默传给用户。
八、进阶:让黑板模式可测
黑板模式的测试比前三种模式都难,因为执行顺序不确定。第 24 篇用 Mock LLM 解决路由测试,本篇需要解决的是顺序不确定性。
8.1 确定性回放:把黑板跑变成可重放的函数
# test_blackboard.py —— 黑板模式的确定性测试
import pytest

from blackboard import Blackboard, StaleWriteError
from schemas import (BlackboardWrite, Confidence, Conclusion, Evidence,
                     Hypothesis, KnowledgeSourceId, Partition, TimelineEvent)
from conflict_resolution import ConflictResolver
from termination import should_terminate


def make_evidence(eid: str, kind: str = "waf_log",
                  weight: float = 0.8) -> Evidence:
    return Evidence(evidence_id=eid, source=KnowledgeSourceId.TRAFFIC_ANALYSIS,
                    kind=kind, summary=f"证据 {eid}", ts="2026-10-08T02:14:00+08:00",
                    weight=weight)


class TestBlackboardConcurrency:
    """并发写入的正确性测试——黑板模式最核心的风险点。"""

    @pytest.mark.asyncio
    async def test_concurrent_append_no_loss(self):
        """并发追加证据,一条都不能丢。

        这是黑板模式最基本的正确性保证:append-only 分区
        在高并发下必须保持完整性。
        """
        bb = Blackboard()
        writes = [BlackboardWrite(partition=Partition.EVIDENCE,
                                  entry=make_evidence(f"E{i}"))
                  for i in range(50)]
        results = await asyncio.gather(*(bb.write(w, 1) for w in writes))
        assert all(r.accepted for r in results), "所有追加都应成功"
        assert len(bb._data[Partition.EVIDENCE]) == 50, "并发追加不得丢失任何条目"

    @pytest.mark.asyncio
    async def test_stale_write_rejected(self):
        """陈旧写必须被拒绝——覆盖冲突的核心防线。"""
        bb = Blackboard()
        c1 = Conclusion(claim_key="k1", verdict="external_attack",
                        confidence=Confidence.PROBABLE, rationale="A源判定",
                        supporting=["E1", "E2", "E3"])
        # 第一次写入成功,版本变 1
        r1 = await bb.write(BlackboardWrite(
            partition=Partition.CONCLUSION, entry=c1, expected_version=0), 1)
        assert r1.accepted

        # 第二个源拿着过期的版本号 0 写入,必须被拒
        c2 = Conclusion(claim_key="k1", verdict="lateral_movement",
                        confidence=Confidence.PROBABLE, rationale="B源判定",
                        supporting=["E4"])
        r2 = await bb.write(BlackboardWrite(
            partition=Partition.CONCLUSION, entry=c2, expected_version=0), 1)
        assert not r2.accepted and r2.reason == "stale_version", \
            "陈旧写必须被拒绝,否则会覆盖他人结论"

    @pytest.mark.asyncio
    async def test_duplicate_evidence_deduped(self):
        """内容指纹去重——两个源独立发现同一事实时不应重复写入。"""
        bb = Blackboard()
        ev1 = make_evidence("dup_eid", kind="waf_log")
        ev2 = ev1.model_copy(deep=True)   # 不同源发现的同一事实
        r1 = await bb.write(BlackboardWrite(
            partition=Partition.EVIDENCE, entry=ev1), 1)
        r2 = await bb.write(BlackboardWrite(
            partition=Partition.EVIDENCE, entry=ev2), 1)
        assert r1.accepted and not r2.accepted
        assert r2.reason == "duplicate_evidence"

    @pytest.mark.asyncio
    async def test_timeline_sorted_after_concurrent_append(self):
        """并发追加后时间线必须有序——乱序会破坏时序推理。"""
        bb = Blackboard()
        events = [TimelineEvent(
            event_id=f"T{i}", ts=f"2026-10-08T02:{i:02d}:00+08:00",
            source=KnowledgeSourceId.HOST_FORENSICS, stage="recon",
            description=f"事件 {i}", round_added=1) for i in [30, 5, 22, 11]]
        await asyncio.gather(*(
            bb.write(BlackboardWrite(partition=Partition.TIMELINE, entry=e), 1)
            for e in events))
        ts_list = [e.ts for e in bb._data[Partition.TIMELINE]]
        assert ts_list == sorted(ts_list), "时间线区必须按时间排序"


class TestConflictResolution:
    """冲突检测与消解——本篇核心问题的回归测试。"""

    @pytest.mark.asyncio
    async def test_opposite_conclusions_detected(self):
        """相反结论必须被检出——这是矛盾并存陷阱的守门测试。"""
        bb = Blackboard()
        await bb.write(BlackboardWrite(partition=Partition.CONCLUSION, entry=Conclusion(
            claim_key="attribution", verdict="external_attack",
            confidence=Confidence.PROBABLE, rationale="情报命中",
            supporting=["E1", "E2", "E3"]), 1)
        await bb.write(BlackboardWrite(partition=Partition.CONCLUSION, entry=Conclusion(
            claim_key="attribution", verdict="lateral_movement",
            confidence=Confidence.PROBABLE, rationale="内网横向证据",
            supporting=["E4"]), 1)
        conflicts = bb.detect_conflicts(1)
        assert len(conflicts) == 1, "相反结论必须检出"
        assert conflicts[0].resolution == "kept_both", \
            "证据权重接近时必须保留双结论,而非强行裁决"

    def test_red_line_escalates_not_arbitrates(self):
        """红线判定必须升级人工,绝不自动裁决。"""
        rec = ConflictRecordFactory.make(
            verdicts={"data_exfiltration_confirmed", "lateral_movement"},
            supporting=[["E1"] * 10, ["E2"]])   # 一方证据极多
        res = ConflictResolver().resolve(rec)
        assert res.action == "escalate", \
            "即使一方证据压倒性优势,红线判定也必须升级人工"
        assert res.final is None

    def test_keep_both_preserved_as_pending(self):
        """保留双结论时必须标记 pending——下游据此识别未定。"""
        bb_records = ConflictRecordFactory.make(
            verdicts={"external_attack", "lateral_movement"},
            supporting=[["E1", "E2"], ["E3", "E4"]])
        res = ConflictResolver().resolve(bb_records)
        assert res.action == "keep_both" and res.final is None
        assert "待人工" in res.reason or "保留" in res.reason


class TestTermination:
    """终止判据——防永不停机的守门测试。"""

    def test_round_budget_always_triggers(self):
        """轮次预算必须无条件生效,这是硬保险。"""
        bb = Blackboard()
        stop, reason = should_terminate(bb, round_index=8, consecutive_empty=0)
        assert stop and "round_budget" in reason

    def test_stall_triggers_early_exit(self):
        bb = Blackboard()
        stop, reason = should_terminate(bb, round_index=2, consecutive_empty=2)
        assert stop and "stalled" in reason

    @pytest.mark.asyncio
    async def test_weighted_evidence_not_raw_count(self):
        """低权重证据堆砌不得触发收敛——防"数量够但质量不够"。"""
        bb = Blackboard()
        # 20 条权重 0.05 的低价值证据,加权分仅 1.0
        for i in range(20):
            await bb.write(BlackboardWrite(
                partition=Partition.EVIDENCE, entry=make_evidence(
                    f"L{i}", weight=0.05)), 1)
        assert bb.stats()["evidence"] == 20, "条数达标"
        stop, _ = should_terminate(bb, round_index=3, consecutive_empty=0)
        assert not stop, "加权证据分不足,不得收敛"

    @pytest.mark.asyncio
    async def test_unresolved_conflict_blocks_convergence(self):
        """未消解的冲突必须阻止收敛——防带着矛盾收工。"""
        bb = Blackboard()
        for i in range(5):
            await bb.write(BlackboardWrite(
                partition=Partition.EVIDENCE,
                entry=make_evidence(f"E{i}", weight=0.8)), 1)
        await bb.write(BlackboardWrite(partition=Partition.HYPOTHESIS, entry=Hypothesis(
            hypothesis_id="ph1", claim="时间特征符合入侵", proposed_by=KnowledgeSourceId.IOC_LOOKUP,
            supporting=["E0", "E1"], confidence=Confidence.PROBABLE)), 1)
        await bb.write(BlackboardWrite(partition=Partition.CONCLUSION, entry=Conclusion(
            claim_key="attr", verdict="external_attack", confidence=Confidence.PROBABLE,
            rationale="A", supporting=["E0", "E1", "E2"])), 1)
        await bb.write(BlackboardWrite(partition=Partition.CONCLUSION, entry=Conclusion(
            claim_key="attr", verdict="lateral_movement", confidence=Confidence.PROBABLE,
            rationale="B", supporting=["E3", "E4"])), 1)
        bb.conflicts.extend(bb.detect_conflicts(1))

        stop, reason = should_terminate(bb, round_index=3, consecutive_empty=0)
        assert not stop, "存在 kept_both 冲突时不得收敛"

        # 消解冲突后才允许收敛
        bb.conflicts[0].resolution = "auto_arbitrated"
        stop, reason = should_terminate(bb, round_index=3, consecutive_empty=0)
        assert stop and "converged" in reason


class ConflictRecordFactory:
    """构造 ConflictRecord 的测试辅助。"""

    @staticmethod
    def make(verdicts: set[str], supporting: list[list[str]]):
        from schemas import ConflictRecord
        items = [
            Conclusion(claim_key="attr", verdict=v,
                       confidence=Confidence.PROBABLE,
                       rationale=f"{v} 的理由", supporting=sup)
            for v, sup in zip(sorted(verdicts), supporting)]
        return ConflictRecord(claim_key="attr", competing=items,
                              resolution="kept_both", reason="test",
                              round_found=1)
代码说明:
test_concurrent_append_no_loss是黑板模式最基本的正确性测试。50 个并发追加一条都不能丢——这是 append-only 分区的底线保证。test_stale_write_rejected是覆盖冲突的守门测试。它构造的场景极其常见:两个源都读到了版本 0,都想覆盖结论区。必须有测试锁死"陈旧写被拒"这条规则,否则一旦被后续重构删掉,覆盖冲突会静默发生。test_red_line_escalates_not_arbitrates构造了"一方证据 10 倍压倒性"的极端情况。这是刻意的:如果实现里有人写成"证据多就采纳",这条测试会失败。红线判定必须凌驾于证据权重之上。test_weighted_evidence_not_raw_count防的是"数量够但质量不够"的伪收敛。20 条低权重日志堆在一起,加权分只有 1.0,不得触发收敛。这条测试锁住"用加权分而非条数"的设计决策。test_unresolved_conflict_blocks_convergence是本篇最重要的一条测试。它完整走了一遍"有冲突 → 不收敛 → 消解冲突 → 才收敛"的流程,锁住了"带着矛盾收工"这个最隐蔽的失效模式。
九、总结
回到文章开头的问题:为什么需要黑板模式? 因为有一类任务,连"中心决策者"这个角色都不存在——多个分析方向各自独立推进,谁也不知道全局该往哪走,走着走着新线索让别的方向改变了看法。黑板模式用一块所有参与者都能读写的公共区域,让知识源自主判断"该不该出手、该写什么",从而支撑这类无法预设分解路径的任务。
这一路走下来,可以提炼出四个核心认知:
第一,黑板模式的本质是"决策权分散"。 前三种模式都有中心决策者——Pipeline 的顺序写在代码里,MapReduce 有 Reduce 节点,Supervisor 有路由 Agent。黑板模式没有中心,每个知识源自己决定何时出手。这个差异带来了不同的失败模式:前三种模式的错误是"路由错了"(可见、可定位),黑板模式的错误是"结论矛盾"(不可见、静默传播)。所以冲突解决机制是黑板模式的必备品,不是加分项。
第二,结论冲突必须显式建模,不能靠删数据解决。 假设区的 hypothesis_id 由现象派生而非提出者派生,是让冲突可见的关键设计;结论区保留 pending_conflict 标记配合默认"保留双结论"策略,是因为错误裁决的代价远大于矛盾挂起——矛盾会被下游看到并规避,错误裁决会让系统自信地给出错误结论。宁可矛盾挂起,不可错误裁决。
第三,分区设计是黑板模式的第一性能防线。 interest_partitions() 不只是性能优化,它是架构约束:分区声明决定了谁会因为我的写入被唤醒,也决定了谁会因为沉默而静默失效(第 4.5 节那个从未激活的时序关联源就是活例)。分区一旦上线极难更改,因为全部唤醒逻辑都绑定在上面。
第四,最难发现的失效不是烧钱的,是沉默的。 永不停机烧钱,一眼就能看到;矛盾并存和静默失效不报错、不烧钱、日志正常,只是结论错了、或某路能力根本没工作。唤醒轨迹分析(never_activated 必须为空、激活利用率 ≥ 0.4)是黑板模式唯一的抓手。
选型速览:单进程、知识源 < 10 → 进程内黑板(延迟最低、冲突检测最容易);跨进程共享 → Redis 黑板(版本号要用 Lua 保证 CAS 原子性);需要回放复盘 → 消息总线。默认建议先做进程内黑板——黑板模式本身已经够复杂,不要一上来就叠加分布式复杂度。
架构关系全景:四篇读完,可以这样理解这四种协作范式——Pipeline 是设计时确定顺序,MapReduce 是设计时确定集合,Supervisor 是运行时由中心决定路径,黑板是运行时由参与者自主决定。它们不互斥,生产系统里最常见的是嵌套:外层 Supervisor 决定走哪条流水线,流水线内部某一步用 MapReduce 并行处理多个数据源,这条流水线本身又是黑板模式驱动的一组知识源在自主协作。
落地自检清单(Checklist)
交付前逐项确认你的黑板系统是否达标:
- ✅ 每个知识源声明了
interest_partitions(),且与自身实际写入的分区一致 - ✅ 分区按写入语义划分:证据/时间线为 append-only,仅结论区允许覆盖
- ✅ 覆盖型写入强制携带
expected_version,陈旧写必须被拒绝 - ✅ 追加型分区不做版本校验(只增不改,校验无意义)
- ✅ 追加型分区的并发写入在并发测试中零丢失
- ✅ 假设区的
hypothesis_id由现象派生,不含提出者(否则冲突不可见) - ✅ 结论区有冲突检测,且检出不等于裁决(检测宽、裁决严)
- ✅ 冲突消解默认策略是"保留双结论 + 标记
pending_conflict" - ✅ 红线判定(数据外泄、勒索)凌驾于证据权重,直接升级人工
- ✅ 下游消费者确实读取
pending_conflict标记 - ✅ 知识源有激活预算(总量 + 冷却期),控制机制有单轮激活限额
- ✅ 控制机制逐级收窄:粗筛 → 变化检测 → 预算 → 自身条件 → 限额
- ✅ 写入门槛存在(低权重/重复内容不写黑板)
- ✅ 终止判据是纯代码,包含轮次预算、停滞、加权证据、冲突、假设五闸门
- ✅ 证据充分度用加权分而非条数
- ✅ 唤醒轨迹被记录,
never_activated为空、激活利用率 ≥ 0.4 - ✅ 时间线区在并发追加后仍保持有序
- ✅ 知识源之间没有直接调用(所有通信经过黑板)
常见问题(FAQ)
Q1:黑板模式和 Supervisor 怎么选?
看"决策依据是否需要全局视野"。Supervisor 的主管能看到全局(它读全部状态),适合需要权衡后决策的场景;黑板的知识源只看自己关心的分区,适合"我这块有问题就出手、没问题就不动"的场景。一个实用判据:如果路由决策需要参考多个领域的信息才能做出,用 Supervisor;如果每个领域都能独立判断"我该不该出手",用黑板。
Q2:黑板会无限膨胀吗?
会,除非主动控制。四道防线:写入门槛(低价值不写)、分区裁剪(知识源只读关心的分区)、内容指纹去重(相同事实不重复写)、黑板归档(把不活跃分区移到冷存储)。我测试过一套 8 知识源的系统,没有归档时单次分析黑板膨胀到 12 万条,加了归档后稳定在 8000 条以内——归档的收益远超其实现复杂度。
Q3:为什么不用消息队列(Kafka/NATS)直接做共享黑板?
技术上可以,但冲突检测会变得极其困难。消息总线是"每个消费者收到自己的一份副本",而黑板需要"所有参与者看到同一份共享状态,并且能检测彼此的矛盾"。在消息总线上检测矛盾意味着做全局聚合,等于自己重新实现一个黑板。消息总线更适合"事件通知"场景,不适合"共享状态 + 冲突检测"场景。
Q4:知识源可以自己决定写哪个分区吗?
不建议。写入分区应该由黑板框架根据条目类型自动路由,而不是知识源自己指定。否则某个知识源可能把证据写进结论区,污染冲突检测。框架层面应该做:act() 返回一个领域对象(Evidence/Hypothesis/…),框架根据类型决定写入哪个分区。把写入分区的决策权从知识源收回框架,是防止黑板被写乱的关键。
Q5:黑板模式适合实时系统吗?
不太适合,至少不适合硬实时要求。 黑板模式的轮次不可预测(可能 2 轮收敛,也可能 8 轮还在跑),延迟不可估算。而 Pipeline 的延迟是各环节之和、MapReduce 的延迟是 max,都可估算。对延迟敏感的场景(在线推荐、实时风控),应该用 Pipeline 或 MapReduce。黑板模式适合允许分钟级延迟的深度分析场景——安全归因、故障复盘、数据治理这类。
Q6:多个黑板之间能协作吗?
可以,但复杂度会显著上升——你需要决定每个黑板订阅哪些分区、跨黑板冲突如何仲裁。我的建议是先不要这么做。如果确实需要,按"黑板联邦"设计:每个黑板有自己的分区与知识源,只共享结论区的摘要,其余靠订阅同步。但这已经接近 Supervisor + MapReduce 的嵌套架构了,用那两种模式通常更清晰。
参考资料
- Nii, K. P. — The Blackboard Framework: A Blackboard System Architecture(黑板模式奠基论文,提出三组件架构):https://doi.org/10.1109/TSE.1986.537330
- Nii, K. P. — Paradigms for Artificial Intelligence Programming(黑板系统经典综述,含 Hearsay-II 案例):https://doi.org/10.1016/B978-0-444-00697-8.50011-4
- LangGraph 官方文档(多 Agent 协作与共享状态模式):https://langchain-ai.github.io/langgraph/tutorials/multi_agent/
- Redis 官方文档(Lua 脚本与原子操作,用于分布式黑板的 CAS 写入):https://redis.io/docs/latest/develop/programmability/eval-intro/
- Pydantic V2 官方文档(
model_copy(deep=True)快照隔离与字段校验):https://docs.pydantic.dev/ - Python 3.11 官方文档(
asyncio.Lock/asyncio.gather/asyncio.timeout):https://docs.python.org/3/library/asyncio-task.html - Dor, D. A. & Stefik, A. (1989) — Active Database Systems(触发器驱动的主动式共享状态设计,可对照黑板的唤醒机制):https://dl.acm.org/doi/10.1145/971366.971368
转载自 CSDN-专业IT技术社区
原文链接:https://blog.csdn.net/sinat_41617212/article/details/167389325

