

文章目录
摘要:Mistral/Mixtral 是学习高效开源模型架构的典型案例。Mistral 类 dense 模型让我们看到 Sliding Window Attention、GQA 等注意力效率设计;Mixtral 类 MoE 模型则展示如何用稀疏激活在总参数容量和每 token 计算之间折中。本文会从长上下文成本讲起,解释滑动窗口注意力、Rolling Buffer、GQA、MoE top-k routing、负载均衡、容量因子和部署压测,并用可运行的小代码帮助你建立“省了什么、贵了什么”的工程直觉。
- 前置知识:专栏一多头注意力、 KV Cache、分布式训练
- 阅读时间:60-75 分钟
- 代码环境:Python 3.10+,示例只依赖标准库
- 读完目标:能解释滑动窗口注意力、GQA 和 MoE 的成本取舍,能判断 Mixtral 类模型部署时应该关注显存、吞吐、路由和通信哪些指标
1. 先把问题讲清楚:高效架构到底在省什么
大模型推理成本主要由几部分组成:
1. 权重显存:模型参数要放进 GPU/CPU/NPU;
2. KV Cache:长上下文和并发生成时快速增长;
3. 每 token 计算量:每生成一个 token 要过很多层;
4. 通信成本:多卡时参数、KV 或专家需要跨设备调度;
5. 调度复杂度:batch、路由、缓存、量化 kernel 都会影响吞吐。
Mistral/Mixtral 的学习价值就在于,它们体现了两类效率思路:
| 方向 | 代表设计 | 主要解决什么 |
|---|---|---|
| Attention 侧 | Sliding Window Attention、GQA | 降低长上下文和 KV Cache 成本 |
| FFN 侧 | MoE 稀疏专家 | 增加总容量,同时控制每 token 激活计算 |
这类设计不是免费提升能力。它们通常是在质量、成本、上下文、部署复杂度之间做交换。开发者要学的不是“某架构一定更好”,而是看懂它把成本从哪里挪到哪里。
2. 标准注意力为什么贵
标准因果自注意力里,第 t t t 个 token 可以关注它前面的所有 token。序列越长,注意力矩阵越大,KV Cache 也越大。
对单层单头来说,注意力大致要计算:
Attention ( Q , K , V ) = softmax ( Q K T d ) V \text{Attention}(Q,K,V)=\text{softmax}\left(\frac{QK^T}{\sqrt{d}}\right)V Attention(Q,K,V)=softmax(dQKT)V
这里:
- Q Q Q:当前 token 的查询向量;
- K , V K,V K,V:历史 token 的 key 和 value;
- Q K T QK^T QKT:计算当前 token 和历史 token 的相关性;
- d d d:head 维度,用于缩放;
- softmax 后乘 V V V:把相关历史信息加权汇总。
问题在于:上下文越长, K , V K,V K,V 越长。prefill 阶段 attention 计算量随序列长度增长很快;生成阶段 KV Cache 也会随历史 token 增长。
3. Sliding Window Attention:每层只看附近历史
Sliding Window Attention(滑动窗口注意力)的直觉是:很多语言依赖是局部的,一个 token 不一定每层都直接看完整历史。可以限制每个 token 主要关注最近 w w w 个 token。
下面用矩阵打印可见范围。1 表示可关注,. 表示不可见。
# Python 3.10+

def sliding_window_mask(seq_len, window):
    rows = []
    for i in range(seq_len):
        row = []
        for j in range(seq_len):
            visible = j <= i and i - j <= window
            row.append("1" if visible else ".")
        rows.append(" ".join(row))
    return rows

for row in sliding_window_mask(seq_len=10, window=3):
    print(row)
输出会看到,每一行只允许看左侧最近几个 token。这种设计降低了每层注意力的范围。
优点:
1. 降低长序列注意力计算;
2. 推理时可以只保留窗口内 KV;
3. 局部任务效率更高;
4. 更适合长文本持续生成。
代价:
1. 远距离信息不能在同一层直接访问;
2. 依赖多层传播或额外机制整合远处信息;
3. 精确长文档引用任务必须额外评估;
4. RAG 和分段策略仍然重要。
4. Rolling Buffer:KV Cache 也可以只保留窗口
如果模型每层只关注最近窗口,推理时就没有必要无限保存所有历史 token 的 KV。Rolling Buffer 可以理解为一个固定长度缓存,只保留最近窗口。
用代码模拟:
# Python 3.10+

class RollingBuffer:
    def __init__(self, size):
        self.size = size
        self.data = []

    def append(self, item):
        self.data.append(item)
        if len(self.data) > self.size:
            self.data.pop(0)

    def get(self):
        return list(self.data)

buf = RollingBuffer(size=4)
for token in ["A", "B", "C", "D", "E", "F"]:
    buf.append(token)
    print(token, "->", buf.get())
这个例子说明窗口缓存如何工作。真实 KV Cache 存的是张量,不是字符;但思想类似:只保留注意力真正会用到的最近历史。
这对长生成和高并发很有意义。但如果任务需要引用 100 页前的一个数字,纯 rolling buffer 不够。此时要靠 RAG、摘要、分段、全局 token 或专门长上下文机制。
5. GQA:减少每个历史 token 存多少 KV
GQA(Grouped Query Attention,分组查询注意力)让多个 Query head 共享较少的 Key/Value head。它主要降低 KV Cache 成本。
普通多头注意力可以近似理解为:每个 query head 都有自己的 key/value head。GQA 则是多个 query head 共用一组 KV。
KV Cache 粗略大小:
# Python 3.10+

def kv_cache_gb(layers, seq_len, kv_heads, head_dim, bytes_per_value=2):
    return layers * seq_len * kv_heads * head_dim * 2 * bytes_per_value / 1024**3

for kv_heads in [32, 16, 8, 4]:
    gb = kv_cache_gb(layers=32, seq_len=32768, kv_heads=kv_heads, head_dim=128)
    print(f"kv_heads={kv_heads:2d} -> {gb:.2f} GB")
这段代码告诉我们:KV heads 越少,KV Cache 越小。GQA 的代价是表达能力和注意力灵活性可能受影响,但在很多模型里它是非常实用的效率折中。
滑动窗口和 GQA 是两个维度:
Sliding Window:减少每层看多少历史 token;
GQA:减少每个历史 token 存多少 KV 信息。
二者都服务推理效率,但解决的是不同账本。
6. Mixtral 的 MoE:专家不是人类领域专家
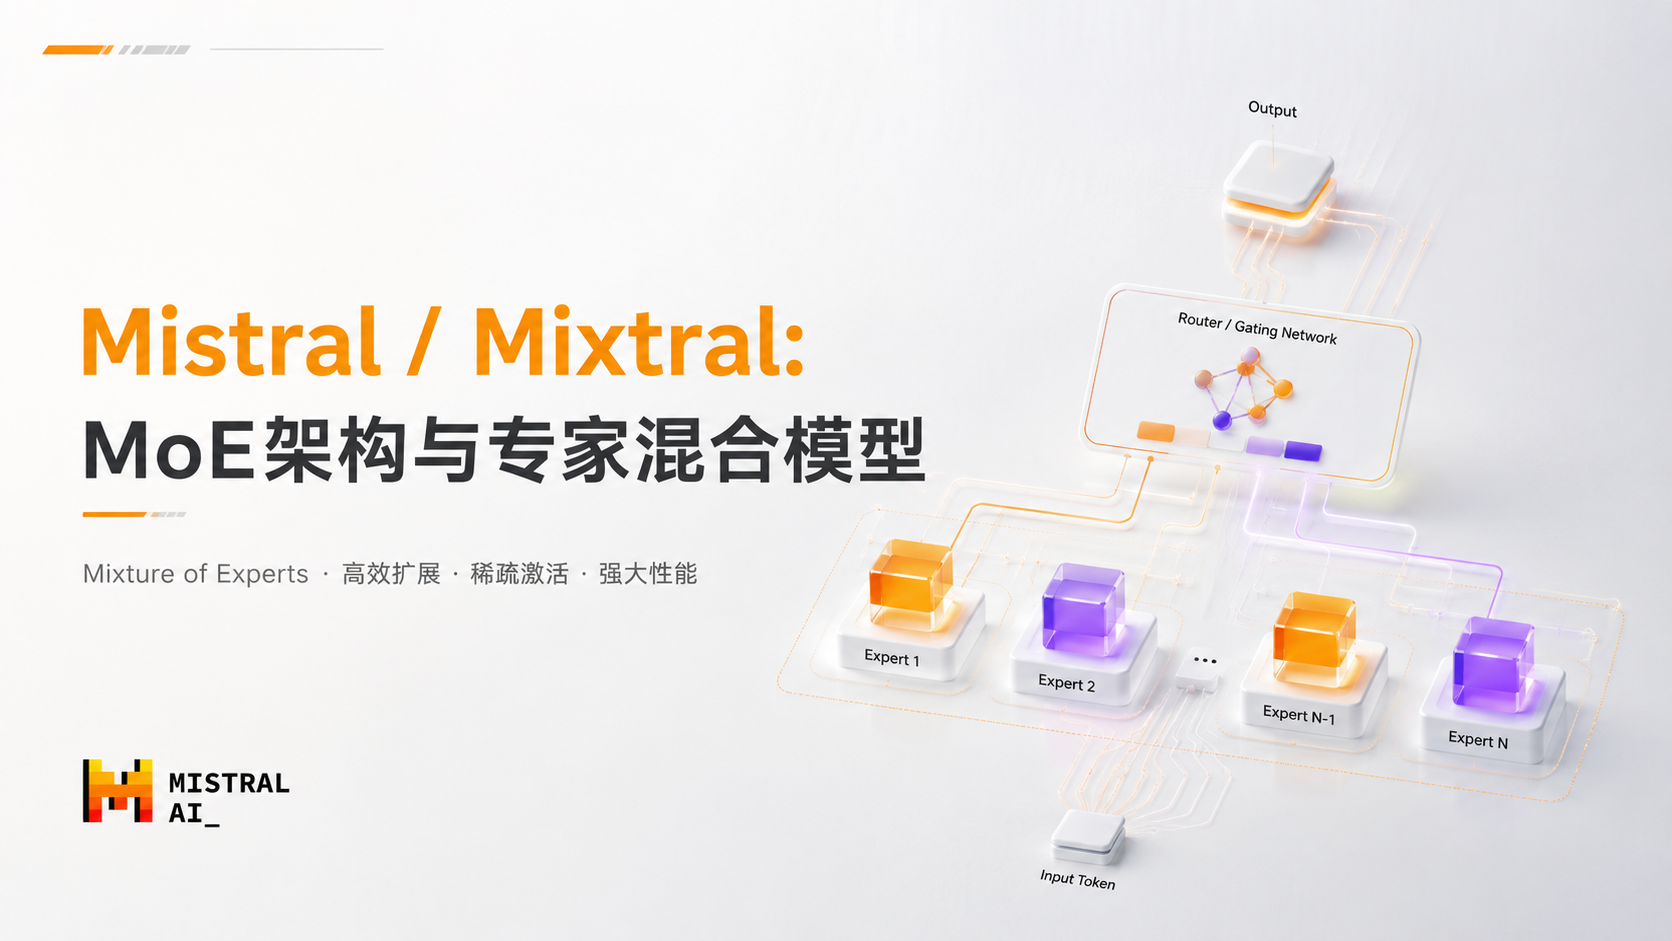
Mixtral 类模型让开发者熟悉了 MoE。MoE 里的专家通常是多个 FFN 分支,不是“法律专家”“医学专家”这种可解释角色。router 会为每个 token 选择少数专家。
简化公式:
y = ∑ i ∈ TopK ( r ( x ) ) p i E i ( x ) y = \sum_{i \in \text{TopK}(r(x))} p_i E_i(x) y=i∈TopK(r(x))∑piEi(x)
逐项解释:
- r ( x ) r(x) r(x):router 给专家打分;
- TopK:选择最高的 k 个专家;
- E i ( x ) E_i(x) Ei(x):第 i i i 个专家处理 token;
- p i p_i pi:专家输出的权重;
- y y y:合并后的输出。
用代码模拟 top-2 routing:
# Python 3.10+
import math


def softmax(scores):
    m = max(scores)
    exps = [math.exp(s - m) for s in scores]
    total = sum(exps)
    return [e / total for e in exps]

scores = [1.2, -0.3, 2.0, 0.7]
probs = softmax(scores)
top2 = sorted(enumerate(probs), key=lambda x: x[1], reverse=True)[:2]
print("probs:", [round(p, 3) for p in probs])
print("top2:", top2)
这个实验说明每个 token 只选少数专家。MoE 的核心价值是增加总参数容量,但控制每 token 激活计算量。
7. Dense 和 MoE 的成本比较
Dense 和 MoE 的差别不能只看总参数。
| 成本项 | Dense | MoE |
|---|---|---|
| 总参数 | 相对直接,所有层都参与 | 专家多,总参数可能很大 |
| 每 token 计算 | 每个 token 都过完整 FFN | 每个 token 只过少数专家 |
| 权重显存 | 存完整 dense 权重 | 通常仍要存所有专家或分片 |
| 通信 | 相对简单 | 多卡专家并行可能 all-to-all |
| 调度 | batch 更稳定 | router 可能导致负载不均 |
| 微调 | 相对直接 | router、专家和共享层要分别决策 |
写个粗略估算:
# Python 3.10+

def dense_ffn_params(hidden, ffn):
    return hidden * ffn + ffn * hidden


def moe_ffn_params(hidden, ffn, experts, active):
    one = dense_ffn_params(hidden, ffn)
    return one * experts, one * active

hidden = 4096
ffn = 14336
print("dense ffn params:", dense_ffn_params(hidden, ffn) / 1e6, "M")
for experts, active in [(8, 2), (16, 2)]:
    total, active_params = moe_ffn_params(hidden, ffn, experts, active)
    print(experts, "experts total=", round(total/1e9, 2), "B active=", round(active_params/1e9, 2), "B")
这不是某个真实模型的参数表,只是帮助你理解:MoE 的“总容量”和“每 token 激活计算”是两件事。
8. 部署 Mixtral 类模型要看负载和通信
MoE 多卡部署时,专家可能分布在不同 GPU。router 决定 token 发给哪个专家,系统要把 token 分发过去、计算后再聚合。这会带来 all-to-all 通信。
简化流程:
batch tokens -> router -> 按专家分桶 -> 发送到专家所在设备 -> 专家计算 -> 聚合回原顺序
如果路由不均衡,某些专家会成为热点;如果网络互联慢,通信会吞掉 MoE 的计算收益。
压测时至少看:
1. 单请求首 token 延迟;
2. 长上下文 prefill 时间;
3. batch 增大时 tokens/s;
4. 不同输入分布下专家负载;
5. 多卡通信等待;
6. 量化后质量和吞吐;
7. 高并发下显存峰值。
单条 demo 流畅,不代表生产高并发稳定。
9. Mistral/Mixtral 类模型适合什么场景
适合:
1. 需要开放权重或私有化部署;
2. 英文、代码、通用任务较多;
3. 团队能做量化、推理框架和压测;
4. 对吞吐和成本敏感;
5. 有明确评估集验证质量;
6. 能接受 MoE 部署复杂度。
谨慎:
1. 中文垂直术语很多,且没有领域评估;
2. 单卡资源很紧张;
3. 极低延迟、高并发但缺乏推理调优能力;
4. 长文档要求精确引用,却只依赖滑动窗口;
5. 需要频繁微调 MoE,但没有路由和专家监控。
这里没有绝对结论。关键是把效率设计和你的任务需求对齐。
10. 常见误区
误区一:滑动窗口一定损失严重。 很多局部依赖任务足够用,但远距离证据任务必须单独评估。
误区二:GQA 只是小优化。 在长上下文和高并发下,KV Cache 是核心成本,GQA 影响很大。
误区三:MoE 专家会自动按人类领域分工。 专家是训练形成的计算分支,不一定可解释为行业专家。
误区四:激活参数少就等于显存少。 权重仍要存储或分片,KV Cache 和通信也要算。
误区五:高效架构可以替代业务评估。 效率和质量是两条线。省成本但答错,对业务没有意义。
11. 小结
Mistral/Mixtral 帮我们理解高效大模型架构的两类核心取舍:注意力侧用滑动窗口、Rolling Buffer、GQA 降低长上下文和 KV Cache 成本;FFN 侧用 MoE 增加总容量,同时控制每 token 激活计算。它们解决了部分成本问题,也引入远距离信息、路由、负载、通信和微调复杂度。
工程选型时,不要只看模型大小或开源热度。要同时评估质量、显存、延迟、吞吐、长上下文、通信和部署团队能力。
大模型视角
从架构演进看,Mistral/Mixtral 代表了 dense scaling 之外的效率路线。未来模型不只是“更大”,还会越来越强调每个 token 的计算是否花在关键位置。理解这些效率设计,能帮助你看懂后续 MoE、长上下文和推理服务优化。
下一篇
下一篇会讲 Claude 系列和 Constitutional AI。关注点会从架构效率转向模型行为:怎样让强模型更有用、更诚实、更安全。
转载自 CSDN-专业IT技术社区
原文链接:https://blog.csdn.net/2302_78391795/article/details/167282585

