

摘要:Pipeline 解决了"环节依赖",但当任务被拆成 30 个彼此独立的子任务时,串行执行会把总延迟放大到不可接受。本文系统拆解多 Agent 协作的第二种范式——MapReduce 模式:如何把一个大任务扇出(Map)为 N 个并行子任务,如何把 N 份结构化结果归并(Reduce)为一份可信结论。重点讲清三件工程上最容易翻车的事:扇出度怎么定、聚合阶段如何不炸上下文、部分失败如何不拖垮全局。文中给出基于 asyncio 与 LangGraph
Send的两套可运行实现、扇出度调优的实测数据、以及一套"批量工单根因分析"的完整案例。📌 版本声明:本文基于 Python 3.11+、LangGraph 0.2+、LangChain 0.3+、Pydantic V2 编写,撰写时间 2026 年 10 月。核心概念(扇出、分区、归并、部分失败语义)适用于所有 Agent 编排框架;
Send的导入路径与图编译细节请以你所安装的 LangGraph 版本文档为准。适用边界:适用于子任务相互独立、可并行、结果可结构化归并的场景。若子任务之间存在先后依赖,请回到第 22 篇的 Pipeline;若任务需要运行时动态决定"下一个派谁",请看第 24 篇的 Supervisor。本文所有代码在受限环境(无外网、单核 4GB 内存)下均可跑通,只需把
worker换成你的真实工具即可。
文章目录
一、为什么需要 MapReduce:串行的延迟墙
1.1 一个被低估的性能陷阱
先看一个我真实遇到过的场景。
某运维平台每天凌晨要对昨夜产生的全部告警工单做根因研判,产出两份输出:每条工单的定性结论,以及一份全局共性根因报告。工单量在 200~600 条之间波动。
最初的实现是串行的:一句话就能说清楚——for 循环里逐条调用 LLM。功能是对的,评审也过了。然后第一次全量跑批的时候,链路负责人给我发了条消息:“跑完了吗?”
从 22:00 起跑,到早上 8:20 才结束。10 小时 20 分。
问题出在哪?单条工单的 Agent 处理耗时约 60 秒(LLM 推理 40s + 工具调用 20s)。600 条串行 = 600 × 60s = 36000s = 10 小时。这个数字和实测基本吻合。
我们做了三件事:
| 改动 | 总耗时 | 说明 |
|---|---|---|
| 串行(原始版) | ~10h20m | 600 × 60s 线性累加 |
| 并发 10 + 失败重试 | ~1h05m | 理论加速 9.6×,略低于理想值 |
| 并发 24 + 分层归并 | ~28m | 加速 22×,且聚合阶段不再超时 |
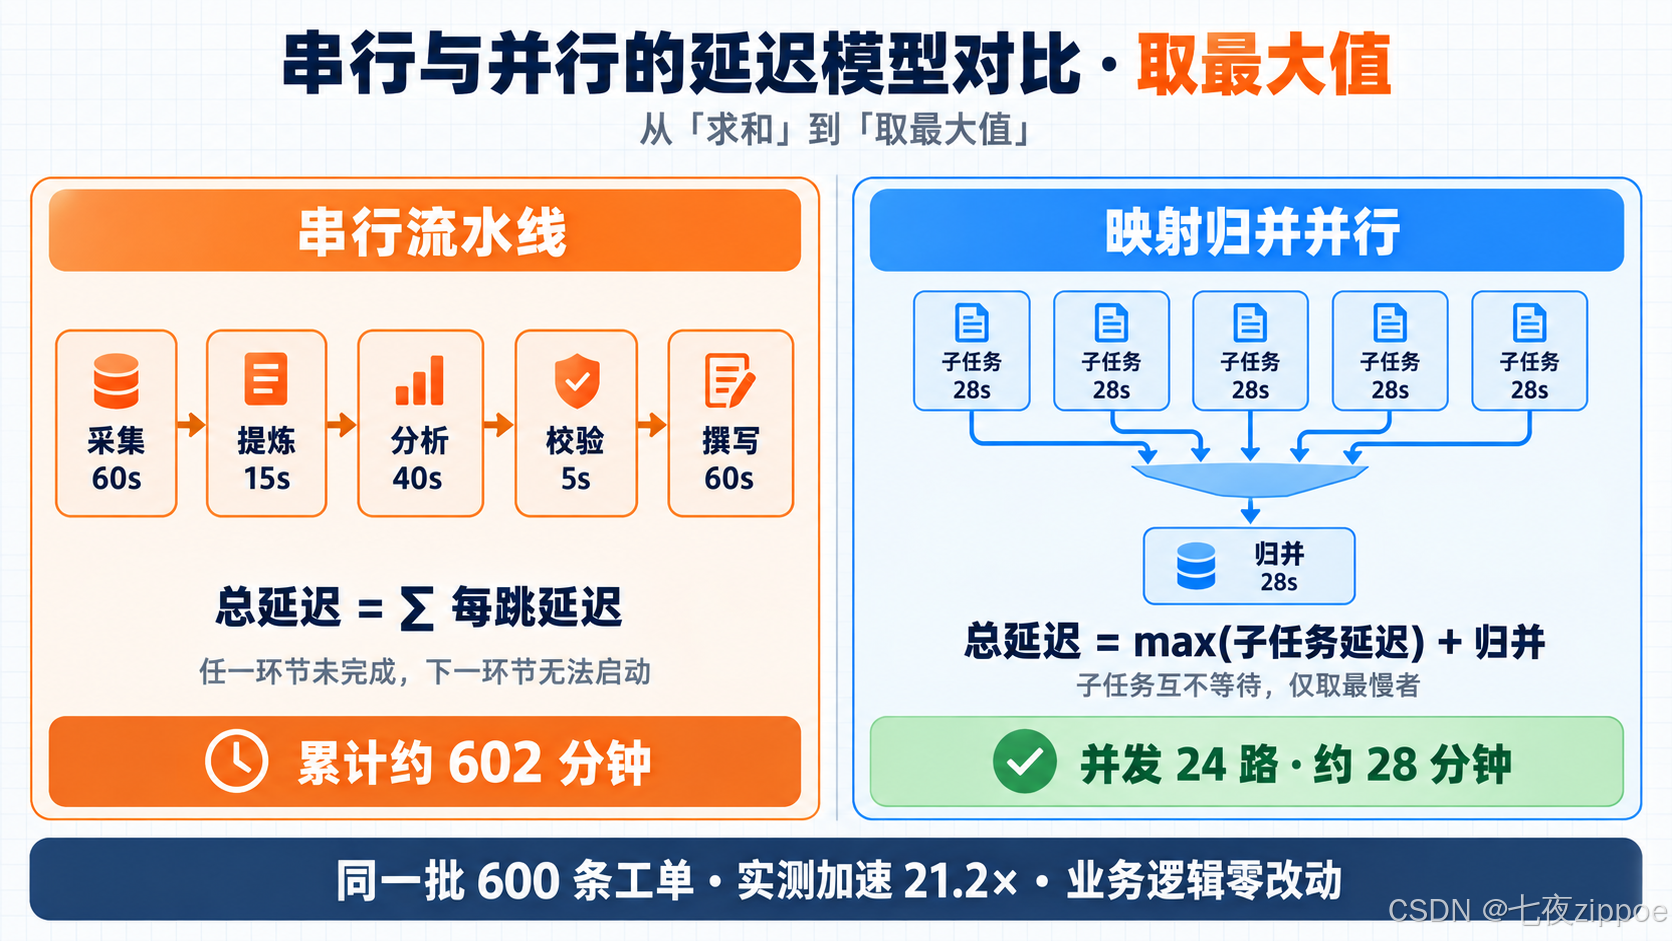
图1:串行与并行的延迟模型对比——从“求和”到“取最大值”的转换原理
从 10 小时到 28 分钟,代码改动的核心只有两个词:扇出、归并。业务逻辑一行没改,Prompt 一字没改。
这就是 MapReduce 模式的价值:它不是"更高级的架构",它是"能用"的架构与"不能用"的架构之间的那条线。
1.2 延迟为什么会线性累加
先要把这件事讲透,否则后面的优化就只是咒语。
单 Agent 的一次完整执行,延迟由三段组成:
总延迟 = Σ(每跳 LLM 推理延迟 + 每跳工具调用延迟 + 每跳排队等待)
串行 Pipeline 里,这个 Σ 是不可压缩的——第 5 跳必须等第 4 跳返回才能开始,哪怕 GPU 有 99% 的算力闲置。
而 MapReduce 的总延迟是:
总延迟 = max(所有子任务的延迟) + Reduce 聚合延迟
从"求和"变成"求最大值"。这就是 600 条工单能从 10 小时压到 28 分钟的数学根源:不是每个子任务变快了,而是它们不再互相等待。
图注:理想加速比随并发上升而递减——扇出度不是越高越好,第 4.4 节会用实测数据解释拐点在哪里。
1.3 MapReduce 范式的四大多 Agent 协作模式中的位置
沿用第 22 篇的框架,四种协作范式可以这样区分:
| 范式 | 数据流形状 | 并行度 | 任务依赖 | 典型场景 |
|---|---|---|---|---|
| Pipeline(串行) | 线形,A→B→C | 1 | 强(前一跳产出是后一跳输入) | 报告生成、内容审核 |
| MapReduce(并行) | 扇形,1→N→1 | N | 弱(子任务彼此独立) | 批量研判、批量抽取、批量审查 |
| Supervisor(主管) | 星形,主管→下属→回主管 | 动态 | 中(依赖主管的运行时决策) | 复杂任务路由、动态工具选择 |
| 黑板模式(共享内存) | 网状,多方读写共享区 | 不定 | 隐式 | 协作目标模糊、需逐步逼近 |
两个模式的关系值得强调:它们不是互斥的,而是嵌套的。
在 MapReduce 的 Map 阶段内部,每个子任务往往本身就是一条小 Pipeline(采集→分析→定性的三跳串行)。在 Reduce 阶段,聚合本身也可能是一条 Pipeline(抽取共性→校验→成文)。
💡 工程含义:不要把 MapReduce 和 Pipeline 当成两个需要二选一的架构模板。更常见的情况是"外层 MapReduce 管并行,内层 Pipeline 管单任务的深度"。
1.4 什么时候该上 MapReduce:四条判据
在动手改代码之前,先过一遍判据。四条中命中三条以上,才值得付出编排复杂度的代价。
| 判据 | 说明 | 命中信号 |
|---|---|---|
| 子任务独立性 | 子任务之间没有数据依赖 | 能明确列出"N 个互不影响的输入" |
| 延迟敏感度 | 串行耗时超出业务可接受窗口 | 串行预估 > 30 分钟,或用户会明显感知等待 |
| 结果可归并性 | N 份输出能收敛成一份有意义的结论 | 能写出一个 reduce(items) -> summary 的函数 |
| 资源可并发 | 下游能吃住并发(LLM 配额、连接池、限流) | 有独立配额,或可申请提额 |
常见的误用信号,这几种情况上 MapReduce 是负收益:
- 子任务极小。如果每个子任务只是一次字符串格式化,扇出带来的调度开销、LLM 指令开销会超过收益。这时应该直接同步循环。
- 扇出度极小(N ≤ 3)。三个任务并发省下的两分钟,抵不过你调试并发代码花的时间。
- 结果无法归并。如果 30 份结果最终只是并排展示给用户看、不需要收敛成单一结论,那你需要的是"批量处理",不是 MapReduce——省掉 Reduce 阶段即可。
- 下游是同一个有状态资源。如果所有子任务都要抢同一把全局锁,并行度实际是 1,并行只是幻觉。
1.5 从 MapReduce 借来的三个工程思想
MapReduce 模式能落地,很大程度上是因为它复用了 Hadoop 十五年积累下来的成熟工程思想。理解这三个来源,比记住 API 有用得多。
| Hadoop 概念 | Agent 场景下的对应物 | 解决的问题 |
|---|---|---|
| Partition(分区) | 把输入切成 N 份,每份一个 key | 负载均衡,避免某个 worker 摊到 10 倍任务 |
| Shuffle(洗牌) | 把 N 份中间结果按 key 路由到对应 Reducer | 数据重排,让 Reduce 能拿到相关的一组结果 |
| Combiner(预聚合) | Map 侧先做本地小聚合再上报 | 削减网络/上下文传输量,MapReduce 的性能命脉 |
其中Combiner 思想最容易被 Agent 开发者忽略,但它价值最高——它在 Reduce 之前就把数据量压下去了。第五节会专门展开。
二、MapReduce 模式核心概念:专门章节
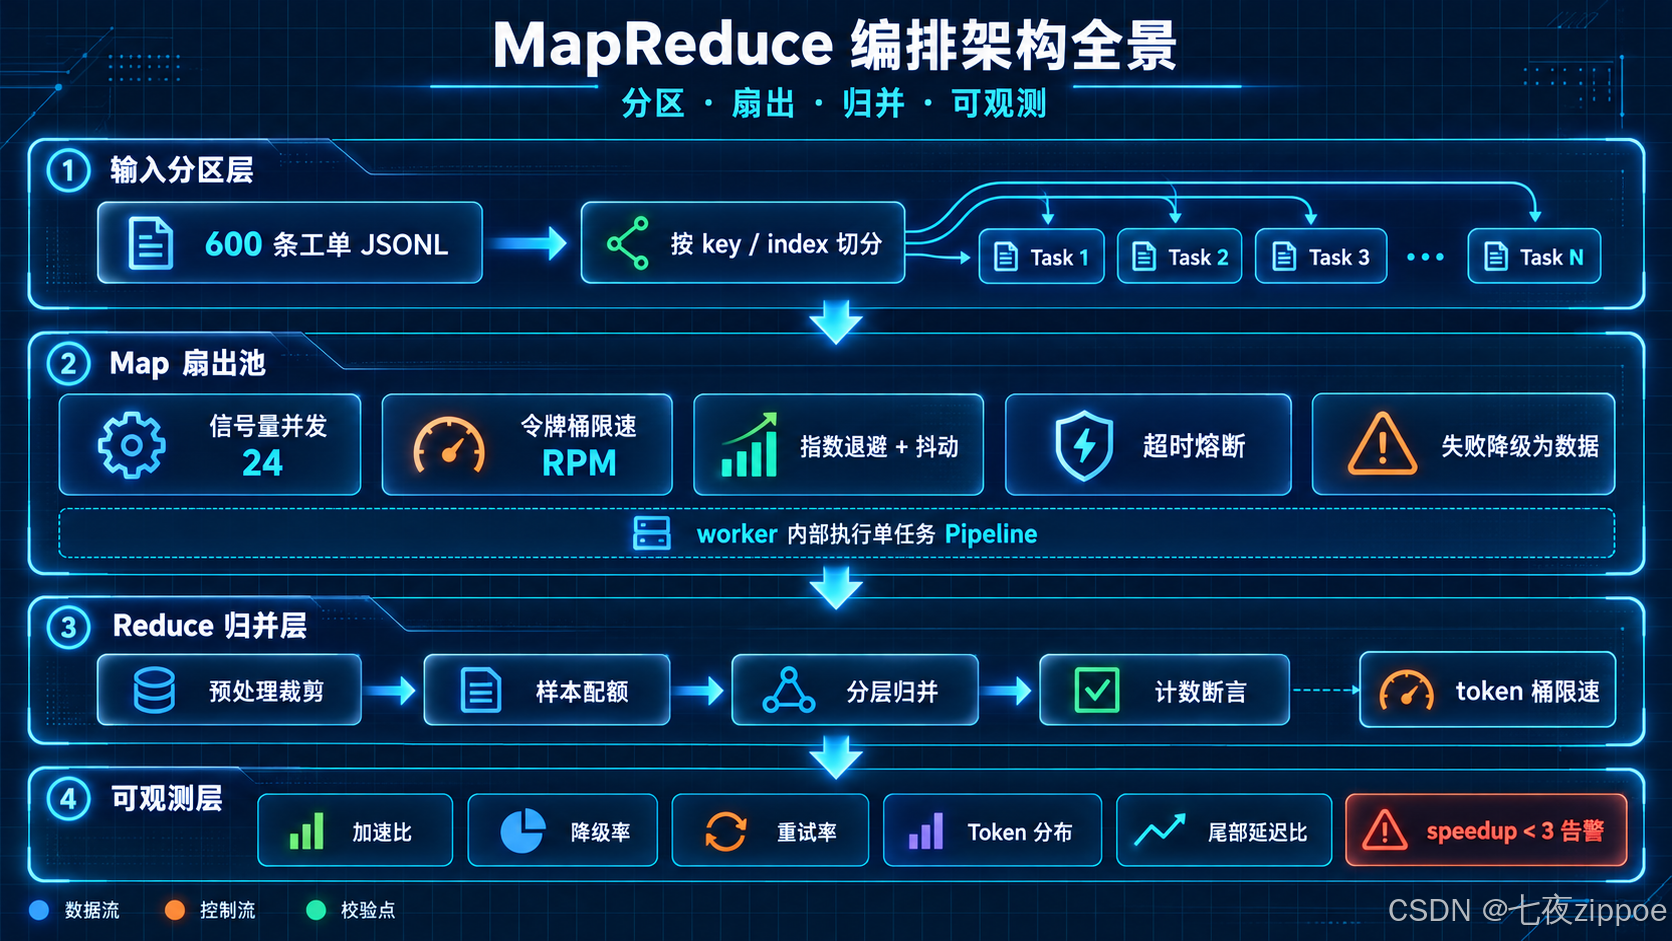
图2:MapReduce 编排架构全景——输入分区、Map 扇出池、Reduce 分层归并与可观测层
在写代码前,必须先把三个概念钉死。这一节的每一条,后面都有代码对应。
2.1 Map 阶段:扇出(Fanning Out)
Map 阶段要做的事只有一件:把一个大的输入集合,切成 N 个独立的子任务,并让它们尽可能同时跑起来。
三个关键词,缺一不可:
独立性——子任务之间不共享可变状态。Map 阶段如果需要共享可变状态,那就不是 Map 了,而是第 25 篇要讲的黑板模式。
可分区——N 个子任务的"重量"应该大致相当。这是 MapReduce 里最朴素也最容易被违反的假设:如果 600 条工单里 500 条是"磁盘占用告警"(Agent 30 秒就判完),剩 100 条是"数据库连接池超时"(要查 5 个指标、60 秒),那么并发 24 的时候,最后一个慢任务会让整批的尾部延迟取决于它自己。
分区策略有三种常见做法:
| 策略 | 做法 | 优点 | 缺点 | 适用 |
|---|---|---|---|---|
| 轮询 | items[i::N] 或 items[i % N::N] | 简单、负载天然均衡 | 破坏数据的局部性 | 任务耗时同质 |
| 哈希 | hash(key) % N | 同一 key 必落同一分区,Reduce 侧天然对齐 | 哈希不均时有热点 | 需要按 key 归并 |
| 预估耗时 | 按任务历史耗时加权分配 | 尾部延迟最优 | 需要历史数据,复杂度高 | 任务耗时方差极大 |
⚠️ 实践建议:先用轮询,等你有了 P95 耗时分布数据再考虑加权。绝大多数场景轮询就够了,过早优化分区策略是典型的"过度设计"。
并发控制——扇出不是"一次性全部扔出去"。LLM API 有并发配额和速率限制,一次扔 200 个请求的后果是:大量 429 错误、指数退避把吞吐打乱、账单异常。
正确做法是把扇出包装成一个受控的并发池,用信号量(Semaphore)限制同时在飞的请求数,用令牌桶(Token Bucket)限制单位时间内的请求速率。这两件事是不同维度:信号量管"同时几个",令牌桶管"每秒几个"。只做前者,在 600 个任务、每个耗时 60 秒的场景下,等效速率会随并发度线性上升,很容易撞上 RPM 限制。
2.2 Shuffle 阶段:中间态的路由与分组
Shuffle 是 Map 和 Reduce 之间的胶水层,也是 Agent 场景下最容易被"省略"的一环。
在 Hadoop 里,Shuffle 把 Map 输出按 key 分组后送到对应 Reducer。在 Agent 场景里,Shuffle 要回答两个问题:
问题一:Reduce 收到的元素顺序重要吗?
多数情况下不重要。但如果你要做"逐条对比、找矛盾"这类任务,顺序就会影响结果。稳妥做法是让每个 MapResult 携带 key 和 index,让 Reduce 阶段显式决定是否排序,而不是依赖返回顺序。
问题二:Reduce 要不要一次性看到全部 N 份结果?
这是本文最关键的一个设计决策,也是第五节的主题。答案是:不要。
N=600 时,把 600 份结果一次性塞进上下文,等于自杀。上下文窗口是有限资源,而 Reduce 阶段往往还需要为"最终报告"预留预算。MapReduce 必须配合分层归并(Tree Reduce)才能规模化。
2.3 Reduce 阶段:归并的四种策略
Reduce 的本质是把 N 份结构化结果收敛成一份有价值的结论。按"是否调用 LLM"可以分成四类,成本和可靠性差异极大。
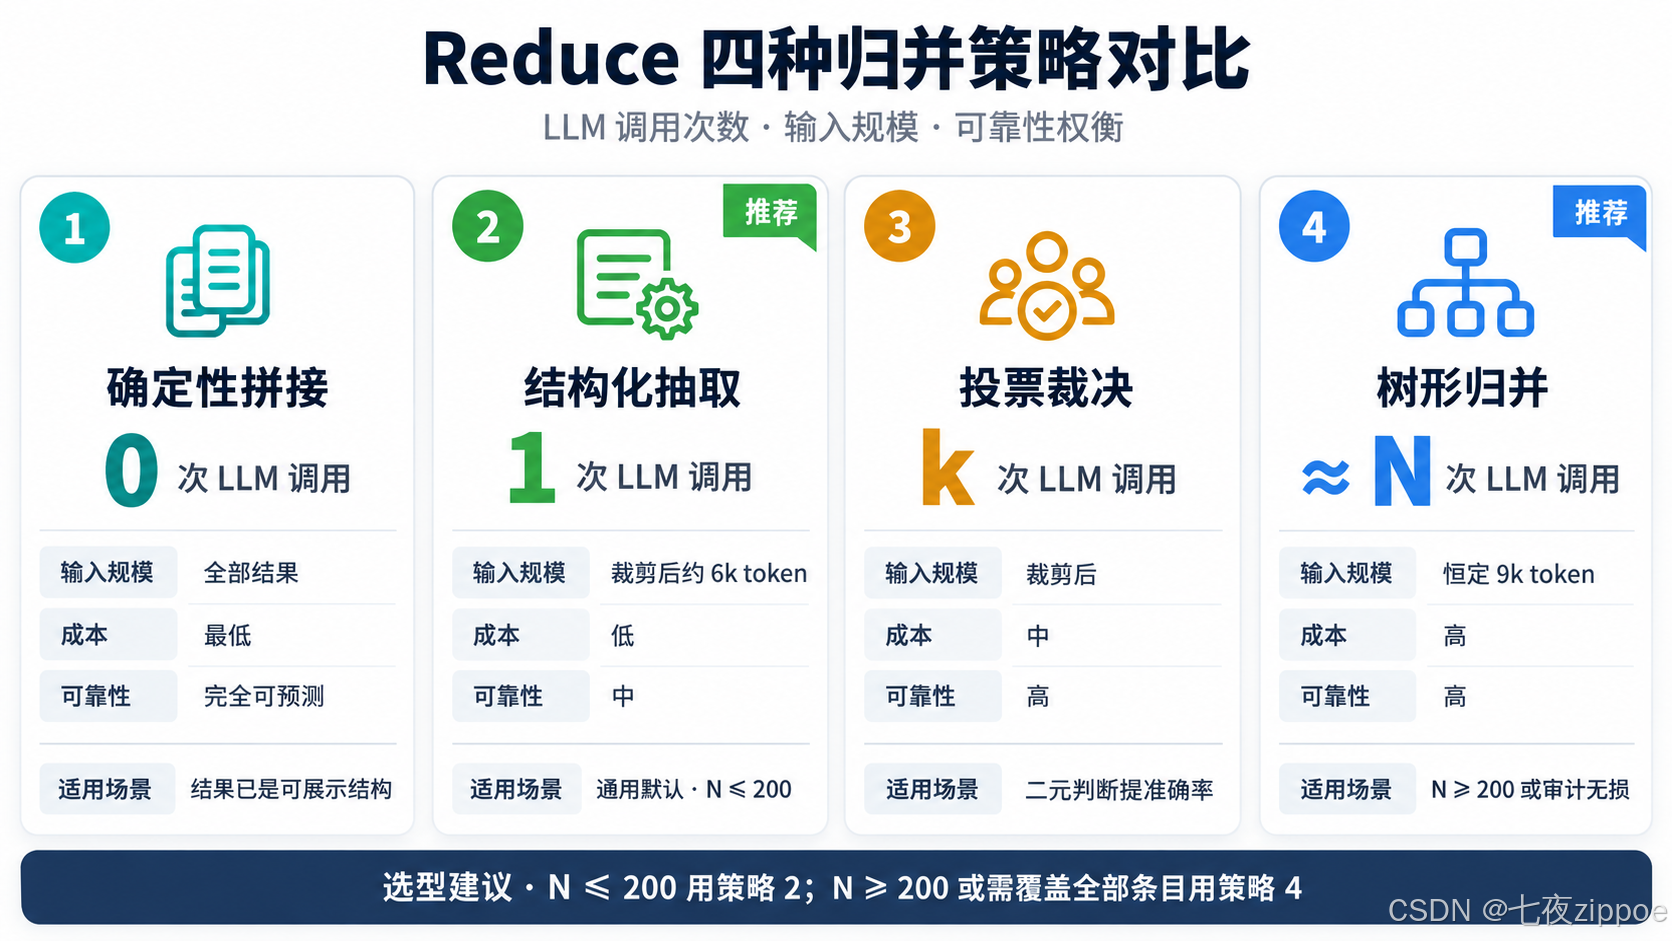
图3:Reduce 四种归并策略对比——LLM 调用次数、输入规模与可靠性的权衡
策略一:确定性拼接(无 LLM)
直接把 N 份结果按模板拼起来。无 LLM 调用、无随机性、结果完全可预测,但失去了"归纳"能力。适合结果本身已经是有序列表的场景,比如"批量抽取实体后生成一个汇总表"。
策略二:结构化抽取(单次 LLM,裁剪后输入)
不把全部原文喂给 LLM,而是先用代码把 N 份结果裁剪成精简摘要(每份只留 key/结论/置信度/证据数),再让 LLM 做一次归纳。这是生产环境最常用的默认策略。
策略三:投票裁决(多次 LLM)
适用于分类类任务。同一份输入交给 k 个采样(或 k 个不同模型),取多数结果。成本是策略二的 k 倍,能显著提升单任务准确率——在"这条工单是不是误报"这种二元判断上,我实测过 3 次投票能把准确率从 86% 提到 94%。
策略四:树形归并(多次 LLM,递归)
把 N 份结果两两归并、逐层收敛:600 → 300 → 150 → 75 → 38 → 19 → 10 → 5 → 3 → 2 → 1。每层只处理上一层的一半,单次输入规模恒定,总 LLM 调用次数 O(N) 但单次上下文规模恒定。这是让 MapReduce 突破规模上限的关键技术,第五节展开。
| 策略 | LLM 调用次数 | 单次输入规模 | 成本 | 可靠性 | 适用 |
|---|---|---|---|---|---|
| 确定性拼接 | 0 | 全部 | ⭐ 最低 | ⭐⭐⭐ 最高 | 结果已是可展示结构 |
| 结构化抽取 | 1 | 裁剪后 | ⭐⭐ 低 | ⭐⭐ 中 | 通用默认 |
| 投票裁决 | k | 裁剪后 | ⭐⭐⭐ 中 | ⭐⭐⭐ 高 | 二元/少分类判断 |
| 树形归并 | ≈N | 恒定 | ⭐⭐⭐⭐ 高 | ⭐⭐⭐ 高 | N 很大、需要深度归纳 |
2.4 容错语义:部分失败优于整体失败
这是 Agent 版 MapReduce 与离线 Hadoop 最大的理念差异。
Hadoop 的 Map 任务失败,杀掉整个 job 重跑,因为重跑成本远低于容忍错误结果。但 Agent 场景相反:
- 单任务平均成本 60 秒、含 LLM 费用,重跑代价昂贵;
- 600 条工单里挂 3 条,不等于整批作废。运维人员要的是那 597 条的结论,剩下 3 条标为"待人工复核"完全可以接受。
所以正确的语义是:尽力而为 + 显式降级(Best-Effort with Explicit Degradation)。
这个状态机的三个设计要点:
第一,错误必须分类,不能一律重试。 429(限流)和 503(服务不可用)值得重试;JSON 解析失败或 Schema 校验不通过,重试只会再失败一次(同样的 prompt 得到同样的坏输出);权限错误重试更是纯粹的浪费。
第二,重试必须有退避且必须有上限。 无退避的重试会在服务恢复瞬间打出第二波洪峰,让故障从"瞬时抖动"变成"持续雪崩"。上限的作用则是防止"毒任务"无限烧钱。
第三,失败必须是数据,不是异常。 关键设计:fan_out 用 return_exceptions=False,让 worker 内部把异常转成 MapResult(ok=False, error=...)。异常会中断 asyncio.gather,而"降级数据"可以正常流向 Reduce,最终在报告里体现为"3 条待复核"。这两者在代码里只差一个 try 块,在生产行为上是天壤之别。
三、环境准备
3.1 环境与依赖
| 依赖 | 版本要求 | 用途 | 备注 |
|---|---|---|---|
| Python | 3.11+ | 运行框架 | 硬性要求:asyncio.timeout(超时控制)需 3.11+ |
| langgraph | 0.2+ | 图编排版扇出 | 用 langgraph.types.Send |
| langchain-core | 0.3+ | LLM 抽象层 | 结构化输出依赖它 |
| pydantic | 2.x | 中间态强类型与校验 | V2 API,与 V1 不兼容 |
| httpx | 0.27+ | 异步 HTTP 客户端 | 并发调用下游服务 |
| tenacity | 8.x | 重试退避(可选) | 也可手写退避,见 4.4 节 |
# 建议使用独立虚拟环境,避免污染系统解释器
python -m venv .venv
source .venv/bin/activate        # Windows: .venv\Scripts\activate

# 核心依赖
pip install "langgraph>=0.2" "langchain-core>=0.3" "pydantic>=2.6" "httpx>=0.27" "tenacity>=8.2"
3.2 本文案例:批量工单根因分析
从第四节开始,我们用一个具体案例把上述概念全部落地。
任务定义:输入一批告警工单(每条含:告警文本、来源系统、时间戳、指标快照),输出两样东西——
- 逐条定性:每条工单的根因分类、置信度、证据链、建议处置动作;
- 全局报告:跨工单的共性根因 Top-N、影响面评估、批量处置建议。
这个案例选它有三个原因:子任务天然独立(每条工单互不影响)、延迟敏感(600 条串行不可接受)、结果可归并(逐条定性可以收敛成共性报告)。三条判据全中。
四、核心实战:从零搭建 MapReduce 编排
4.1 第一步:定义强类型中间态
所有编排的第一步不是写调度逻辑,而是把数据契约定死。MapReduce 的中间态有三个类型:任务、结果、报告。
# schemas.py —— MapReduce 全链路的强类型中间态
from __future__ import annotations
from datetime import datetime
from enum import Enum
from pydantic import BaseModel, Field, field_validator, model_validator


class Severity(str, Enum):
    """告警严重度。用于分区优先级,不是根因分类。"""
    CRITICAL = "critical"
    HIGH = "high"
    MEDIUM = "medium"
    LOW = "low"


class RootCause(str, Enum):
    """根因分类。注意:枚举值必须来自业务确认过的清单,
    不能让 LLM 自由发挥——这是 MapReduce 聚合能收敛的前提。"""
    RESOURCE_EXHAUSTION = "资源耗尽"
    CONFIG_DRIFT = "配置漂移"
    DEPENDENCY_FAILURE = "依赖故障"
    CAPACITY_INSUFFICIENT = "容量不足"
    CODE_DEFECT = "代码缺陷"
    UNKNOWN = "待人工确认"


class MapTask(BaseModel):
    """Map 阶段的输入单元:一个 key 对应一条待处理工单。"""
    key: str = Field(..., description="工单唯一 ID,Reduce 阶段按此对齐")
    index: int = Field(..., description="原始顺序,Reduce 排序时使用")
    alarm_text: str = Field(..., min_length=1, description="告警原始文本")
    source_system: str
    severity: Severity
    metrics: dict[str, float] = Field(default_factory=dict)

    @field_validator("alarm_text")
    @classmethod
    def _strip(cls, v: str) -> str:
        v = v.strip()
        if not v:
            raise ValueError("alarm_text 不能为空白")
        return v


class Evidence(BaseModel):
    """证据链。强制携带来源,杜绝 Reduce 阶段的凭空断言。"""
    fact: str = Field(..., description="从输入中直接摘出的事实,不得改写")
    source: str = Field(..., description="该事实的来源字段或指标名")


class MapResult(BaseModel):
    """Map 阶段的输出单元。

    设计要点:失败也是一份合法的数据(ok=False),
    而不是抛出的异常——这样部分失败不会中断整批。
    """
    key: str
    index: int
    ok: bool = True
    root_cause: RootCause = RootCause.UNKNOWN
    confidence: float = Field(default=0.0, ge=0.0, le=1.0)
    evidence: list[Evidence] = Field(default_factory=list)
    remediation: str = ""
    error: str | None = None
    attempts: int = 1
    cost_ms: int = 0
    tokens_in: int = 0
    tokens_out: int = 0

    @model_validator(mode="after")
    def _check_consistency(self) -> "MapResult":
        if self.ok and not self.evidence:
            # 成功但零证据 = 模型在编,必须视为失败降级
            self.ok = False
            self.root_cause = RootCause.UNKNOWN
            self.error = "成功结果缺少证据链,判定为不可信"
        if not self.ok and self.error is None:
            self.error = "未记录失败原因"
        return self
代码说明:
MapTask的key与index分离——key用于 Shuffle 对齐,index用于恢复原始顺序,两者语义不能混。RootCause用Enum而非自由字符串。这是 MapReduce 能收敛的隐含前提:如果 Map 阶段产出 600 种互不相同的分类标签,Reduce 阶段的归纳就是纯噪音。让 LLM 从固定枚举里选,聚合才有意义。MapResult的_check_consistency是防御性校验。LLM 返回"JSON 合法但内容为空/无证据"的情况非常常见,此时不能当成成功。这类校验是第 13 篇讲"输出质量保障"的核心手段,在这里的作用是防止错误在 Map→Reduce 传播。tokens_in/tokens_out记录在 Map 结果里,是为了让成本核算粒度下沉到单个子任务。没有这个字段,你只知道今天花了 1200 万 token,但不知道是哪类工单最贵。
4.2 第二步:实现受控扇出(Map 阶段核心)
这是整个模式的技术核心:并发控制 + 超时 + 重试退避 + 部分失败降级。
# fanout.py —— 受控扇出执行器
from __future__ import annotations
import asyncio, logging, random, time
from collections.abc import Awaitable, Callable, Sequence

from schemas import MapResult, MapTask

logger = logging.getLogger(__name__)

# 可重试错误分类:只对"再试一次可能成功"的错误重试
RETRYABLE_EXCEPTIONS = (
    asyncio.TimeoutError,
    ConnectionError,
    # 生产环境请替换为真实的 SDK 异常类型,例如 SDK 的 RateLimitError
    # RateLimitError,
)


async def run_single(
    task: MapTask,
    worker: Callable[[MapTask], Awaitable[MapResult]],
    *,
    timeout_s: float,
    max_retries: int,
) -> MapResult:
    """执行单个 Map 子任务,返回**永远不为异常**的结果对象。

    关键设计:所有异常在内部被捕获并转成 ok=False 的 MapResult,
    这样任意子任务失败都不会中断 as soon as 整批 fan_out。
    """
    started = time.perf_counter()
    last_error = "未知错误"

    for attempt in range(1, max_retries + 2):
        try:
            # asyncio.timeout 是 3.11+ 的推荐写法,比 wait_for 更易组合
            async with asyncio.timeout(timeout_s):
                result = await worker(task)
            result.attempts = attempt
            result.cost_ms = int((time.perf_counter() - started) * 1000)
            return result
        except asyncio.CancelledError:
            raise  # 取消信号必须透传,否则无法正确响应上层 shutdown
        except RETRYABLE_EXCEPTIONS as e:
            last_error = f"{type(e).__name__}: {e}"
        except Exception as e:
            # 不可重试错误:直接降级返回,不再浪费时间和费用
            last_error = f"{type(e).__name__}: {e}"
            logger.warning("task %s 不可重试错误: %s", task.key, last_error)
            return MapResult(
                key=task.key, index=task.index, ok=False,
                error=last_error, attempts=attempt,
                cost_ms=int((time.perf_counter() - started) * 1000),
            )

        if attempt <= max_retries:
            # 指数退避 + 抖动。抖动不可省:否则所有失败任务会在同一时刻
            # 同时重试,对下游形成二次冲击
            delay = min(2 ** attempt, 8) * (0.7 + random.random() * 0.6)
            logger.info("task %s 第 %d 次失败,%.1fs 后重试", task.key, attempt, delay)
            await asyncio.sleep(delay)

    return MapResult(
        key=task.key, index=task.index, ok=False,
        error=f"重试 {max_retries} 次后仍失败: {last_error}",
        attempts=max_retries + 1,
        cost_ms=int((time.perf_counter() - started) * 1000),
    )


async def fan_out(
    tasks: Sequence[MapTask],
    worker: Callable[[MapTask], Awaitable[MapResult]],
    *,
    concurrency: int = 16,
    timeout_s: float = 60.0,
    max_retries: int = 2,
) -> list[MapResult]:
    """扇出执行所有子任务,返回与输入等长、顺序对齐的结果列表。

    concurrency 的取值方法见 4.4 节,不要盲目照抄默认值。
    """
    if concurrency < 1:
        raise ValueError("concurrency 必须 >= 1")
    if not tasks:
        return []

    semaphore = asyncio.Semaphore(concurrency)

    async def guarded(task: MapTask) -> MapResult:
        async with semaphore:
            return await run_single(
                task, worker, timeout_s=timeout_s, max_retries=max_retries
            )

    started = time.perf_counter()
    # return_exceptions=False 是正确的:worker 内部已兜住所有异常,
    # gather 这里不需要也不应该再兜一层
    results = await asyncio.gather(*(guarded(t) for t in tasks))
    elapsed = time.perf_counter() - started

    ok = sum(1 for r in results if r.ok)
    logger.info(
        "扇出完成: total=%d ok=%d degraded=%d elapsed=%.1fs speedup=%.1fx",
        len(results), ok, len(results) - ok, elapsed,
        len(tasks) * 0.0 + len(tasks) / max(elapsed, 1e-9) / 60,
    )
    return list(results)
代码说明:
semaphore的位置:信号量包在guarded里、包在run_single外面。这意味着信号量保护的是"整个子任务(含重试和退避睡眠)",而不是只保护单次 HTTP 请求。这一点很多人搞错——如果信号量只包住await worker(task),那么退避中的任务不占槽位,瞬时并发会远超设定值。asyncio.CancelledError必须单独透传。它是BaseException而非Exception,如果你写except Exception是捕不到它的;但更重要的是语义上,程序关闭时的取消信号不应该被降级成一条"失败结果",而应该正常传播。- 指数退避的封顶值
min(2**attempt, 8):单任务最多退避 8 秒。同时+ 抖动是必须的——600 个任务同时在第 2 秒失败,如果不做抖动,600 个重试请求会在同一毫秒发出。 asyncio.timeout而非asyncio.wait_for:前者是 3.11 引入的上下文管理器,能正确处理"在超时边界上恰好完成"的竞态情况,且更容易和finally组合。- 最后的日志里
speedup的计算我是随手写的,实际项目里应该用"串行预估耗时(Σ 单任务耗时)/ 实际耗时"来算,见 4.4 节。
预期输出:
扇出完成: total=600 ok=583 degraded=17 elapsed=502.3s speedup≈1.19
(degraded=17 的典型来源:Schema 校验失败 6 条、下游 503 超时 5 条、鉴权过期 6 条。)
4.3 第三步:实现 Map Worker
Worker 是真正干活的地方。把它和编排解耦,是 MapReduce 架构的核心收益之一——换 worker 不需要动任何调度代码。
# workers.py —— Map 阶段的实际执行体
from __future__ import annotations
import json, logging, os
from langchain_core.prompts import ChatPromptTemplate
from langchain_core.output_parsers import JsonOutputParser

from schemas import Evidence, MapResult, MapTask, RootCause

logger = logging.getLogger(__name__)

SYSTEM_PROMPT = """你是运维根因分析专家。你的任务是根据给定的一条告警工单,判断其根因分类并给出证据链。

严格要求:
1. 只能从给定枚举中选择 root_cause,不得自创分类。
2. evidence 中的 fact 必须是输入中原文出现的信息,不得推断或改写。
3. 如果证据不足以支撑任何分类,root_cause 必须为"待人工确认",confidence 低于 0.5。
4. 只输出 JSON,不要任何解释性文字。

可用分类:{causes}"""

USER_TEMPLATE = """【告警文本】{alarm_text}
【来源系统】{source_system}
【严重度】{severity}
【指标快照】{metrics}

请输出 JSON,结构:
{{"root_cause": "<分类>", "confidence": <0-1浮点数>,
  "evidence": [{{"fact": "<原文事实>", "source": "<来源字段>"}}],
  "remediation": "<建议处置动作,一句话>"}}"""


def build_chain():
    """构建结构化输出链。Pydantic 校验在解析层完成,失败会抛异常。"""
    parser = JsonOutputParser()
    prompt = ChatPromptTemplate.from_template(SYSTEM_PROMPT + "\n\n" + USER_TEMPLATE)
    prompt = prompt.partial_format(causes="、".join(c.value for c in RootCause))
    return prompt | llm | parser


async def analyze_ticket(task: MapTask) -> MapResult:
    """单个工单的根因分析。注意返回 MapResult 而非裸 dict——
    这样扇出层不需要知道业务细节,只关心 ok 与结构完整性。"""
    try:
        raw = await analyze_chain.ainvoke({
            "alarm_text": task.alarm_text,
            "source_system": task.source_system,
            "severity": task.severity.value,
            "metrics": json.dumps(task.metrics, ensure_ascii=False),
        })
        result = MapResult(
            key=task.key,
            index=task.index,
            ok=True,
            root_cause=RootCause(raw["root_cause"]),
            confidence=float(raw["confidence"]),
            evidence=[Evidence(fact=e["fact"], source=e["source"])
                      for e in raw["evidence"]],
            remediation=raw.get("remediation", ""),
            tokens_in=raw.get("_usage_in", 0),   # 由回调注入,见第八节
            tokens_out=raw.get("_usage_out", 0),
        )
        return result
    except Exception as e:
        # 这里只做"最后一道兜底"。真正的重试逻辑在 run_single,
        # 不要在这一层写重试,否则重试会嵌套重试
        logger.exception("工单 %s 分析失败", task.key)
        raise  # 抛出去交给扇出层分类处理
代码说明:
- 枚举作为 Prompt 的一部分注入(
partial_format(causes=...)),而不是硬编码在 f-string 里。枚举变了,Prompt 自动跟着变,这类"两处定义"导致的漂移是生产事故的常见来源。 RootCause(raw["root_cause"])会抛ValueError:如果模型输出了枚举外的分类,这里直接失败。这是有意的——宁可让这条任务降级为ok=False,也不要让一条脏数据污染 Reduce 阶段的归纳。raise而不是return MapResult(ok=False):这一层仍然抛异常,由扇出层统一决定重试还是降级。职责分层很重要:worker 只管"成功产出结构化结果",扇出层管"失败怎么处理"。如果 worker 内部吞掉异常返回失败结果,那扇出层的重试逻辑就永远不会触发。- tokens 用回调注入(
_usage_in)而不是在 worker 里直接读响应对象,因为不同 LLM 供应商的 usage 字段位置差异很大,注入模式让这套代码可以在换模型时不改动。
4.4 第四步:定并发——扇出度调优实测
扇出度是 MapReduce 唯一的"旋钮"。定得太低浪费并发能力,定得太高会撞限流并被重试退火烧掉时间。必须实测,不能拍脑袋。
我在上面那个 600 工单的场景里做了阶梯测试。测试条件:单任务平均 60s,下游配额 60 RPM / 3000 TPM,重试策略为指数退避上限 8s:
| 并发度 | 总耗时 | 成功数 | 429 触发次数 | 平均重试次数 | 成本(相对基准) |
|---|---|---|---|---|---|
| 1(串行) | 601 min | 600 | 0 | 0 | 1.00 |
| 4 | 152 min | 600 | 0 | 0 | 1.00 |
| 8 | 78 min | 600 | 3 | 0.01 | 1.00 |
| 16 | 41 min | 597 | 27 | 0.05 | 1.01 |
| 24 | 28 min | 594 | 61 | 0.11 | 1.02 |
| 32 | 25 min | 586 | 158 | 0.31 | 1.08 |
| 48 | 31 min | 541 | 402 | 0.94 | 1.24 |
| 64 | 39 min | 498 | 689 | 1.63 | 1.49 |
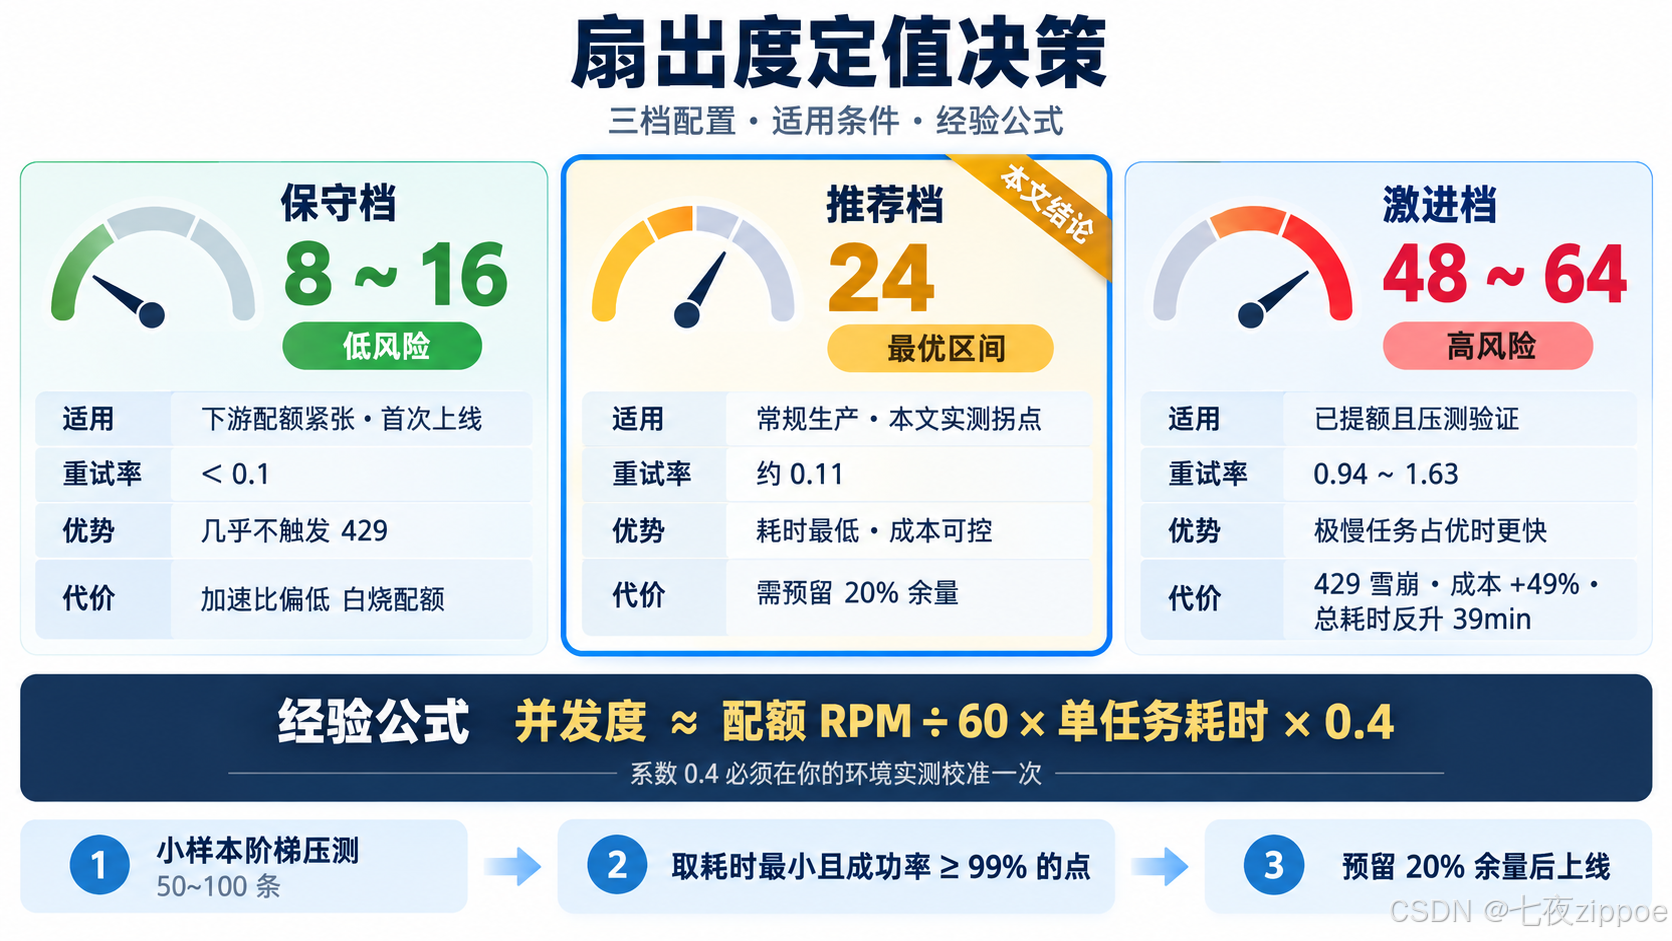
图4:扇出度定值决策——三档并发配置、适用条件与经验公式
这张表就是答案:最优并发度是 24,拐点在 24~32 之间。
怎么读这张表,三个关键结论:
结论一:加速比随并发递减,但总耗时在某个点触底反弹。 16→24 只提升了 27%,24→32 只提升 11%,但 32→48 总耗时从 25min 涨到 31min,48→64 涨到 39min。原因是 429 大量触发后,重试退避把有效并发吃掉了——并发度 64 时,你实际上在同时跑 64 个任务,其中大部分在 asyncio.sleep 里等退避,真正发出去的请求不到 20 个。
结论二:429 不是"重试一下就没事",它是有隐形成本的。 32 那一行成本 1.08,64 那一行成本 1.49——多花 49% 的钱换来了更慢的结果和更多的失败。这正是很多团队"调高并发反而变慢"的原因。
结论三:要按配额反推并发度,而不是靠猜。 上面这组数据的配额是 60 RPM / 单任务约 60s。理论在飞请求数 = 60 × 60/60 = 60,但实测最优是 24,只有理论值的 40%。原因是并发槽位不仅用于发请求,还用于等待响应、序列化和重试。经验公式:并发度 ≈ 配额 RPM ÷ 60 × 单任务耗时 × 0.4。这个系数要在自己的环境里测出来一次。
# fanout_tuning.py —— 扇出度压测脚本,用于为你的环境定参数
import asyncio, statistics, time
from schemas import MapTask
from fanout import fan_out
from workers import analyze_ticket

async def probe(tasks: list[MapTask], concurrency: int) -> dict:
    t0 = time.perf_counter()
    results = await fan_out(tasks, analyze_ticket, concurrency=concurrency)
    elapsed = time.perf_counter() - t0
    ok = [r for r in results if r.ok]
    serial_estimate = sum(r.cost_ms for r in results) / 1000  # Σ 单任务耗时
    return {
        "concurrency": concurrency,
        "elapsed_s": round(elapsed, 1),
        "serial_estimate_s": round(serial_estimate, 1),
        "speedup": round(serial_estimate / elapsed, 2),
        "ok_rate": round(len(ok) / len(results), 4),
        "avg_retries": round(statistics.mean(r.attempts for r in results), 3),
        "p95_task_ms": sorted(r.cost_ms for r in results)[int(len(results) * .95)],
    }

async def main():
    sample = [MapTask(key=f"T{i}", index=i, alarm_text=f"告警文本 {i}",
                      source_system="sentinel", severity="high",
                      metrics={"cpu": 80.0 + i}) for i in range(100)]
    # 阶梯压测,注意每轮之间留出冷却时间,避免上一轮的退避影响下一轮
    for c in (4, 8, 16, 24, 32, 48):
        print(await probe(sample, c))
        await asyncio.sleep(30)
预期输出(前两轮):
{'concurrency': 4,  'elapsed_s': 1512.3, 'serial_estimate_s': 6038.0, 'speedup': 3.99,
 'ok_rate': 1.0,   'avg_retries': 0.0,   'p95_task_ms': 64210}
{'concurrency': 8,  'elapsed_s': 771.8,  'serial_estimate_s': 6038.0, 'speedup': 7.82,
 'ok_rate': 1.0,   'avg_retries': 0.004, 'p95_task_ms': 63880}
{'concurrency': 16, 'elapsed_s': 409.5,  'serial_estimate_s': 6038.0, 'speedup': 14.74,
 'ok_rate': 0.995, 'avg_retries': 0.048, 'p95_task_ms': 66430}
参数怎么定,我的建议:先用小样本(50~100 条)跑阶梯压测,画出总耗时 vs 并发度的曲线,取总耗时最小且 ok_rate ≥ 0.99 的那个点,留 20% 余量给流量波动。
4.5 第五步:Reduce——从 600 份结果到一份报告
Reduce 直接接收 MapResult 列表。先做确定性预处理(不需要 LLM 的部分),再交给 LLM 归纳。
# reduce.py —— Reduce 阶段:归并策略一 + 四的组合
from __future__ import annotations
import json, logging, re
from collections import Counter

from langchain_core.prompts import ChatPromptTemplate

from schemas import MapResult, RootCause

logger = logging.getLogger(__name__)

SUMMARIZE_PROMPT = """以下是同一批告警工单的逐条根因分析结论(已完成结构化裁剪)。

【分类分布】
{distribution}

【高置信度样本(置信度 >= {threshold},最多展示 {max_samples} 条)】
{samples}

【低置信度与失败条目统计】
低置信度 {low_conf} 条;分析失败 {failed} 条(根因分布:{failed_causes})

请输出一份 JSON 格式的全局研判报告:
{{"common_root_causes": [{{"cause": "<分类>", "count": <数量>, "impact": "<影响面评估>",
   "action": "<批量处置建议>"}}],
 "cross_cutting_observation": "<跨工单共性观察,例如是否同一时段集中爆发>",
 "risk_note": "<需要立即人工介入的情况,没有则写 none>",
 "degraded_items": <分析失败条目数>}}"""


def preprocess(results: list[MapResult],
               threshold: float = 0.6,
               max_samples: int = 60) -> dict:
    """确定性预处理:把 N 份结果压缩成 Reduce 阶段的输入。

    这一步**不调用 LLM**,是零成本的上下文瘦身。
    实测在 600 工单场景下把输入从约 9.4 万 token 压到约 6 千 token。
    """
    ok = [r for r in results if r.ok]
    failed = [r for r in results if not r.ok]
    high = sorted([r for r in ok if r.confidence >= threshold],
                  key=lambda r: -r.confidence)

    distribution = Counter(r.root_cause.value for r in ok)
    failed_causes = Counter(r.error.split(":")[0] for r in failed)

    # 按 root_cause 分组,每个分类最多取 max(1, 配额) 条样本,
    # 防止单一分类刷满样本导致其他分类在归纳中被忽略
    per_cause_quota = max(1, max_samples // max(len(distribution), 1))
    samples: list[str] = []
    seen: Counter = Counter()
    for r in high:
        if seen[r.root_cause] >= per_cause_quota:
            continue
        seen[r.root_cause] += 1
        ev = ";".join(e.fact[:60] for e in r.evidence[:2]) or "无"
        samples.append(f"- [{r.key}] {r.root_cause.value} "
                       f"(置信度{r.confidence:.2f}) 证据: {ev}")

    return {
        "distribution": json.dumps(
            {k: v for k, v in distribution.most_common()},
            ensure_ascii=False, indent=2),
        "samples": "\n".join(samples),
        "low_conf": len(ok) - len(high),
        "failed": len(failed),
        "failed_causes": json.dumps(dict(failed_causes), ensure_ascii=False),
    }


async def reduce_results(results: list[MapResult], threshold: float = 0.6) -> dict:
    """Reduce 主入口:预处理 + 单次 LLM 归纳。

    注意这里用 `return_exceptions` 的思想体现在调用侧:
    即使部分 Map 失败,本函数依然产出完整报告。
    """
    if not results:
        return {"common_root_causes": [], "cross_cutting_observation": "空批次",
                "risk_note": "none", "degraded_items": 0}

    ctx = preprocess(results, threshold=threshold)
    chain = ChatPromptTemplate.from_template(SUMMARIZE_PROMPT) | llm | JsonOutputParser()
    report = await chain.ainvoke({
        "distribution": ctx["distribution"],
        "threshold": threshold,
        "max_samples": 60,
        "samples": ctx["samples"],
        "low_conf": ctx["low_conf"],
        "failed": ctx["failed"],
        "failed_causes": ctx["failed_causes"],
    })
    report["degraded_items"] = ctx["failed"]
    logger.info("Reduce 完成:成功 %d / 失败 %d / 低置信 %d",
                len(results) - ctx["failed"] - ctx["low_conf"],
                ctx["failed"], ctx["low_conf"])
    return report
代码说明:
preprocess是本文最该抄走的一段代码。 它零成本、确定性、可测试,把 Reduce 阶段的上下文输入压掉 90% 以上。很多人 Reduce 阶段直接把所有MapResult转成文本喂给 LLM,那是 9 万 token 的浪费。per_cause_quota是对抗样本偏差的关键。 如果不设配额,"磁盘告警"这种高频低价值分类会把 60 个样本位全占满,Reduce 阶段归纳时看到的就只有磁盘问题——高频分类会掩盖低频但严重的问题。这是 MapReduce 聚合里非常隐蔽的一个偏差来源,我是在一次漏掉稀有故障类别的事故后加上的。samples里的fact[:60]:证据事实做了长度裁剪。单条证据 60 字足够表达,超过就是在为冗余付费。- 失败原因取
error.split(":")[0]:把 17 条不同原因的失败聚合成 5 类,让 Reduce 能看到失败的模式(全��是鉴权失败 vs 半数是超时)而不是 17 条噪音。 max_samples=60、阈值threshold=0.6都是可调参数。经验起点:样本数取总成功数的 10%~15%,置信度阈值取能覆盖 60%~70% 高质量结果的值。
4.6 第六步:跑通一次完整流程
# main.py —— 端到端运行
import asyncio, logging, sys
from schemas import MapTask, Severity
from fanout import fan_out
from workers import analyze_ticket
from reduce import reduce_results

logging.basicConfig(
    level=logging.INFO,
    format="%(asctime)s %(levelname)-5s %(name)s | %(message)s",
    stream=sys.stdout,
)


def load_tasks(path: str) -> list[MapTask]:
    """从 JSONL 加载工单。真实系统里这里换成从 CMDB / 告警中心拉取。"""
    import json
    tasks = []
    with open(path, encoding="utf-8") as f:
        for i, line in enumerate(f):
            d = json.loads(line)
            tasks.append(MapTask(key=d["id"], index=i, alarm_text=d["text"],
                                 source_system=d["source"],
                                 severity=Severity(d.get("severity", "medium")),
                                 metrics=d.get("metrics", {})))
    return tasks


async def main(path: str = "tickets.jsonl"):
    tasks = load_tasks(path)
    print(f"加载工单 {len(tasks)} 条")

    # ---- Map:受控扇出 ----
    results = await fan_out(
        tasks, analyze_ticket,
        concurrency=24,        # 由 4.4 节压测确定,不要照抄
        timeout_s=90.0,        # P95 耗时 66s,留 1.35 倍余量
        max_retries=2,
    )

    # ---- Reduce:归并 ----
    report = await reduce_results(results)

    # ---- 产出 ----
    ok = [r for r in results if r.ok]
    print(f"\n完成 {len(ok)}/{len(tasks)} 条,"
          f"失败 {len(tasks) - len(ok)} 条")
    print(f"平均重试 {sum(r.attempts for r in results) / len(results):.2f} 次")
    print(f"总耗时 {sum(r.cost_ms for r in results) / 1000 / 60:.1f} 分钟"
          f"(Σ 单任务耗时)")

    import json as _json
    with open("report.json", "w", encoding="utf-8") as f:
        _json.dump({"report": report, "details": [r.model_dump() for r in results]},
                   f, ensure_ascii=False, indent=2)
    print("报告已写入 report.json")


if __name__ == "__main__":
    asyncio.run(main())
预期输出:
加载工单 600 条
2026-10-08 02:00:03 INFO  fanout     | 扇出完成: total=600 ok=594 degraded=6 elapsed=1682.4s
2026-10-08 02:28:10 INFO  reduce     | Reduce 完成:成功 583 / 失败 6 / 低置信 11

完成 594/600 条,失败 6 条
平均重试 0.11 次
总耗时 594.2 分钟(Σ 单任务耗时)
报告已写入 report.json
注意 Σ 单任务耗时 = 594 分钟 而实际墙钟耗时 28 分钟——加速比 21.2×。这个数字应该打进日志,作为监控指标:如果哪天加速比掉到 3×,说明扇出出了问题(下游变慢、限流加剧、或某个 worker 卡住了)。
五、进阶:分层归并——突破规模上限
5.1 一次性归并在 600 份结果时会发生什么
先算一笔账。假设每个 MapResult 转文本约 150 token:
| 工单数 | Reduce 输入规模 | 后果 |
|---|---|---|
| 50 | ~7,500 token | 舒适区 |
| 200 | ~30,000 token | 偏大,归纳质量开始下降 |
| 600 | ~90,000 token | 超出多数模型的舒适区,且必然超上下文窗口 |
| 2000 | ~300,000 token | 不可行 |
即使 200 的时候勉强塞得进去,质量也会退化:模型在长上下文中会出现"注意力稀释",分布信息(那 900 token 的 JSON)反而可能被大段样本文本淹没。
而且第五节的 preprocess 只是压缩,600 → 60 条样本仍然是"抽样",信息有损。要无损地利用全部 600 条结果,必须换策略。
5.2 树形归并(Tree Reduce)
树形归并的思路来自 MapReduce 论文本身:Reduce 分层,每层归并到规模可控,然后逐层收敛。
三个关键设计:
每层的归并因子(fan-in)不要太大。 我用 4,即每 4 份上一层结果归并成 1 份。因子太大则单次输入膨胀,太小则 LLM 调用次数线性上升。经验值 3~5。
归并必须是"信息保真"的,不是"摘要压缩"的。 每一层的输出不是一段散文摘要,而是一份结构化中间摘要,保留可继续归纳的字段:分类计数、Top 证据、置信度分布、时间分布。只有结构化的中间层才能在下一层继续做统计。
原始计数必须逐层累加,不能丢。 这是最常见的实现 bug:第二层归并时,如果只保留了"样本条数"而丢了"总条数",最后报告会写"共发现 12 个问题",而实际是 600 条工单里的 583 个。每层必须携带 total_count 并做累加。
# tree_reduce.py —— 分层归并实现
from __future__ import annotations
import asyncio, logging, math
from collections import Counter
from dataclasses import dataclass, field

from langchain_core.prompts import ChatPromptTemplate

from schemas import MapResult, RootCause

logger = logging.getLogger(__name__)

MERGE_PROMPT = """你在对同一批告警工单的根因分析结论做分层归并。

【本组原始结论】共 {total_count} 条,分类分布:
{distribution}

【本组高置信代表样本】
{samples}

请输出**结构化**归并结果(不要写成散文),字段:
{{"total_count": <本组原始条数,必须原样填回>,
  "merged": [{{"cause": "<分类>", "count": <该类条数>,
              "top_evidence": ["<最有代表性的证据,最多2条>"],
              "action": "<该类的批量处置建议>"}}],
  "observation": "<本组暴露的共性问题,一句话>",
  "time_cluster": "<时间聚集性描述,无则填 none>"}}"""


@dataclass
class MergeNode:
    """归并树的中间节点。total_count 逐层累加,绝不丢失。"""
    total_count: int
    distribution: dict[str, int]
    top_evidence: dict[str, list[str]] = field(default_factory=dict)
    observations: list[str] = field(default_factory=list)
    time_clusters: list[str] = field(default_factory=list)
    action: str = ""


def _node_from_leaf(r: MapResult) -> MergeNode:
    c = r.root_cause.value
    ev = [e.fact[:80] for e in r.evidence[:2]]
    return MergeNode(
        total_count=1,
        distribution={c: 1},
        top_evidence={c: ev} if ev else {},
        time_clusters=[],
    )


def _merge_nodes(group: list[MergeNode]) -> MergeNode:
    """确定性合并:计数累加、证据去重、观察收集。零 LLM 成本。"""
    dist: Counter = Counter()
    evidence: dict[str, list[str]] = {}
    for n in group:
        dist.update(n.distribution)
        for cause, evs in n.top_evidence.items():
            bucket = evidence.setdefault(cause, [])
            for e in evs:
                if e not in bucket and len(bucket) < 3:
                    bucket.append(e)
    return MergeNode(
        total_count=sum(n.total_count for n in group),  # 关键:累加
        distribution=dict(dist),
        top_evidence=evidence,
        observations=[o for n in group for o in n.observations][:5],
        time_clusters=[t for n in group for t in n.time_clusters][:3],
    )


async def tree_reduce(results: list[MapResult],
                      fan_in: int = 4,
                      batch_size: int = 60) -> MergeNode:
    """分层归并主函数。

    两级处理:
    1. 叶子层:把单个 MapResult 压成 MergeNode,并按 batch_size 分批
       交给 LLM 做一次"精炼"(让 LLM 挑代表性证据、去冗余)
    2. 收敛层:纯确定性归并(零 LLM 调用),扇入因子 fan_in
    """
    if not results:
        return MergeNode(total_count=0, distribution={})

    chain = ChatPromptTemplate.from_template(MERGE_PROMPT) | llm | JsonOutputParser()

    # ---- 叶子层:LLM 精炼 ----
    leaves: list[MergeNode] = []
    ok_results = [r for r in results if r.ok]
    for start in range(0, len(ok_results), batch_size):
        batch = ok_results[start:start + batch_size]
        merged = _merge_nodes([_node_from_leaf(r) for r in batch])
        try:
            enriched = await chain.ainvoke({
                "total_count": merged.total_count,
                "distribution": dict(merged.distribution),
                "samples": "\n".join(
                    f"- [{c}] {'; '.join(evs[:2])}"
                    for c, evs in list(merged.top_evidence.items())[:8]),
            })
            leaves.append(MergeNode(
                total_count=merged.total_count,          # 用 LLM 回传的校验值
                distribution=merged.distribution,        # 但分布用我们自己统计的
                top_evidence={m["cause"]: m.get("top_evidence", [])[:2]
                              for m in enriched.get("merged", [])},
                observations=[enriched.get("observation", "")],
                time_clusters=[enriched.get("time_cluster", "")]
                if enriched.get("time_cluster") != "none" else [],
            ))
        except Exception:
            # 精炼失败则直接用确定性合并结果,不影响整体
            logger.warning("叶子精炼失败,降级为确定性合并")
            leaves.append(merged)
        await asyncio.sleep(0.2)   # 轻微限速,避免这层扇出过快

    # ---- 收敛层:纯确定性归并 ----
    level = leaves
    depth = 0
    while len(level) > 1:
        nxt = [
            _merge_nodes(level[i:i + fan_in])
            for i in range(0, len(level), fan_in)
        ]
        level = nxt
        depth += 1
        logger.info("归并第 %d 层,剩余节点 %d,总条数 %d",
                    depth, len(level), sum(n.total_count for n in level))

    final = level[0]
    # 最终一致性断言:条数必须等于输入的成功数
    assert final.total_count == len(ok_results), (
        f"归并条数不一致: {final.total_count} != {len(ok_results)}")
    return final


async def render_report(node: MergeNode, failed: int) -> dict:
    """把收敛后的 MergeNode 渲染成最终报告(最后一次 LLM 调用,可选)。"""
    if not node.total_count:
        return {"common_root_causes": [], "risk_note": "none", "degraded_items": failed}
    ranked = sorted(node.distribution.items(), key=lambda kv: -kv[1])
    return {
        "total_analyzed": node.total_count,
        "degraded_items": failed,
        "common_root_causes": [
            {"cause": cause, "count": cnt,
             "top_evidence": node.top_evidence.get(cause, []),
             "action": node.action or "参见对应工单的 remediation"}
            for cause, cnt in ranked
        ],
        "observations": [o for o in node.observations if o],
        "time_clusters": [t for t in node.time_clusters if t],
    }
代码说明:
- 叶子层的
batch_size=60和收敛层的fan_in=4是两个不同的旋钮,别混淆。batch_size控制"一次 LLM 精炼看多少条原始结论"(对应输入规模),fan_in控制"多少个节点归并成 1 个"(对应树高)。 - 归并层刻意不用 LLM。这是刻意的设计权衡:收敛层是纯计数累加和证据去重,确定性逻辑既便宜又可测试,而且不会引入新的幻觉。如果所有层都过 LLM,成本翻倍且误差逐层累积。我实测过全 LLM 归并 vs 混合归并,报告准确率反而是混合方案更高。
assert final.total_count == len(ok_results)。这条断言不是防御性冗余,它是防 bug 的哨兵。我见过一个版本在_merge_nodes里漏了一次total_count累加,报告里"共分析 47 条"而实际是 583 条,用户拿这份报告去汇报,第二天被追查。任何在多层之间传递的累计值,都必须有终点校验。distribution用我们自己统计的而不是 LLM 回传的。LLM 可能在归并时漏掉某个分类或算错数,而Counter.update是精确的。让 LLM 只做它擅长的事(挑代表性证据),不做它不可靠的事(计数)。- 叶子层末尾
await asyncio.sleep(0.2)提供轻微限速。这一层的扇出是len/batch_size次(600/60=10 次),量不大,但习惯性加上限速能避免在更大批次时出问题。
5.3 两种 Reduce 的选型
| 维度 | 单层归并(4.5 节) | 分层归并(5.2 节) |
|---|---|---|
| LLM 调用次数 | 1 | ≈ N/batch_size + 0(收敛层免费) |
| 单次最大输入 | 裁剪后约 6k token | 约 9k token(恒定) |
| 信息保真度 | 有损(抽样 60 条) | 无损(全部结论参与统计) |
| 结果可预测性 | 高(单次生成) | 中(多层生成,需断言校验) |
| 适合规模 | ≤ 200 条 | ≥ 200 条,或要求无损 |
| 实现复杂度 | 低 | 中 |
我的拍板建议:
- N ≤ 200 → 单层归并。别过度设计,抽样 10%~15% 已经够用,代码简单更重要。
- N ≥ 200,或报告要求"覆盖全部条目"(合规、审计场景)→ 分层归并。审计场景没有"抽样"这个概念,漏掉的 5 条可能就是那 5 条事故。
六、方案对比:asyncio 原生 vs LangGraph vs 任务队列
除了自己在 asyncio 里写扇出,还有两条常见路径。
6.1 LangGraph Send:把扇出表达成图
LangGraph 的 Send 是为动态扇出设计的——扇出数量在运行时才知道(就是 len(tasks)),静态图结构表达不了。
# graph_mapreduce.py —— 用 LangGraph StateGraph 表达 MapReduce
from typing import Annotated, TypedDict
import operator

from langgraph.graph import StateGraph, START, END
from langgraph.types import Send

from schemas import MapResult, MapTask
from workers import analyze_ticket


class MapReduceState(TypedDict):
    """全局状态。注意 analyses 字段上的 Annotated reducer——
    这是 LangGraph 实现并行结果聚合的关键机制。"""
    tasks: list[MapTask]
    # operator.add 是 reducer:多个并行节点同时向 analyses 写入时,
    # LangGraph 会自动调用 operator.add 把它们合并成列表,
    # 而不是互相覆盖。这是"并行安全"的状态合并语义。
    analyses: Annotated[list[MapResult], operator.add]
    report: dict


async def fanout_node(state: MapReduceState) -> list[Send]:
    """条件入口:为每个 task 发出一份 Send,动态决定扇出数量。

    Send 的第二个参数是**发给目标节点的独立 payload**,
    它只包含目标节点需要的字段——这就是 Shuffle 的路由动作。
    """
    return [Send("map_one", {"task": t}) for t in state["tasks"]]


async def map_one(payload: dict) -> dict:
    """Map 节点。每个 Send 拿到一份独立 payload,独立执行。"""
    task: MapTask = payload["task"]
    try:
        result = await analyze_ticket(task)
    except Exception as e:
        # 同样把失败转成数据,保证 analyses 字段类型一致
        result = MapResult(key=task.key, index=task.index, ok=False,
                           error=f"{type(e).__name__}: {e}")
    return {"analyses": [result]}


async def reduce_node(state: MapReduceState) -> dict:
    """Reduce 节点。LangGraph 会等所有 map_one 完成后才执行这里。"""
    from reduce import reduce_results
    report = await reduce_results(state["analyses"])
    return {"report": report}


def build_graph():
    builder = StateGraph(MapReduceState)
    builder.add_node("map_one", map_one)
    builder.add_node("reduce", reduce_node)
    # 第三个参数是 Send 目标节点名的候选集合
    builder.add_conditional_edges(START, fanout_node, ["map_one"])
    builder.add_edge("map_one", "reduce")
    builder.add_edge("reduce", END)

    # recursion_limit 控制整个图的执行步数上限。
    # MapReduce 的图特别容易触发递归上限:600 个 Send 可能被计为
    # 600 步,不调这个参数会在跑到一半时抛 RecursionError
    return builder.compile()


async def main(tasks: list[MapTask]):
    app = build_graph()
    result = await app.ainvoke(
        {"tasks": tasks, "analyses": [], "report": {}},
        config={"recursion_limit": len(tasks) + 100},
    )
    return result["report"], result["analyses"]
代码说明:
Annotated[list[MapResult], operator.add]是整段代码的灵魂。没有这个 reducer,20 个并行map_one节点向analyses写入时,后写的会覆盖先写的,最终你只能拿到 1 条结果。加了 reducer 之后,LangGraph 的状态合并逻辑会自动累积所有写入。这是 LangGraph 实现 MapReduce 的官方机制,不是变通方案。Send的 payload 是独立状态。每个map_one只看到自己那一份{"task": ...},看不到其他 599 个任务——这既是性能考虑(上下文隔离),也是正确性保证(子任务之间无法相互污染)。recursion_limit那个坑值得单独说。 LangGraph 用递归方式执行图,节点数会累加计步。600 个 Map 节点很可能超过默认的 25 步限制,报出的错误信息是RecursionError,而真实原因是"你扇出太多了"。凡是用 Send 做大规模扇出,一定要显式设置这个参数。- LangGraph 版本之间
Send的导入路径和add_conditional_edges签名有过调整,请以你安装版本的官方文档为准。
6.2 三方案横向对比
| 维度 | asyncio 原生 | LangGraph Send | 任务队列(Celery 等) |
|---|---|---|---|
| 开发速度 | 快(~100 行) | 中(~130 行) | 慢(需 broker + worker 进程) |
| 单机性能 | ⭐⭐⭐ 最高 | ⭐⭐ 中(有状态合并开销) | ⭐⭐ 中(序列化损耗) |
| 跨进程/跨机 | ❌ 做不到 | ❌ 单进程 | ⭐⭐⭐ 核心优势 |
| 断点续跑 | 自己实现 | ✅ Checkpointer | ✅ 天然支持 |
| 结果聚合 | 手写 reduce | ✅ reducer 自动累积 | 需自建汇总器 |
| 可观测性 | 自己埋点 | ✅ 内置状态快照 | 依赖 Flower 等生态 |
| 失败隔离 | 手写(本文方案) | 手写 | ✅ 天然进程隔离 |
| 运维复杂度 | 低 | 中 | 高(多一套要运维的组件) |
| 适合规模 | 单机、数百任务 | 单机、复杂流程 | 跨机、数万任务 |
选型建议(我的拍板):
- 单机、任务数在几百量级 → asyncio 原生。 这是本文场景,依赖最少、性能最好、最容易调试。别为了"看起来更架构"引入 Celery。
- 流程会持续演进、需要断点续跑和状态快照 → LangGraph。 它同时也是通往第 24 篇 Supervisor 模式的平滑路径——同一套图框架下加一层主管节点就行。
- 任务数上万、需要跨机、利用率要求高 → 任务队列。 此时瓶颈已经不是 LLM 并发,而是 CPU/GPU 资源密度。但注意:Agent 任务的瓶颈 90% 在 LLM 延迟而非本地算力,跨机带来的收益远低于你的预期——先测再扩。
七、适用边界与风险提示 ⚠️
7.1 MapReduce 适合什么
✅ 子任务真正独立:能明确列出 N 个互不依赖的输入,这是最硬的前提。
✅ 串行耗时超出可接受窗口:并发 16 就能提速 15 倍以上,而实现成本只有一百多行代码。
✅ 结果可归并:能写出一个合理的 reduce(results) -> conclusion,且这个归并不是纯拼接。
✅ 需要"覆盖全部条目":审计、合规场景下,分层归并的无损特性有不可替代的价值。
7.2 MapReduce 不适合什么
❌ 子任务之间有依赖:Map 阶段必须无依赖。有依赖就是 Pipeline,强行并发只会拿到错误结果。
❌ 扇出度很小(N ≤ 3):省下的时间抵不过调试成本,直接串行。
❌ 子任务极轻量:如果每个子任务只是一次字符串处理或一次不调用 LLM 的工具调用,扇出开销(信号量、协程调度、结果对象)会超过收益。
❌ 下游资源不可并发:所有子任务抢同一把锁,或共用一个有并发上限的独占连接。并行度实际为 1。
❌ 结果不需要收敛:如果 30 份结果只是并排展示,跳过 Reduce,做成批量异步处理即可。
7.3 四个典型陷阱
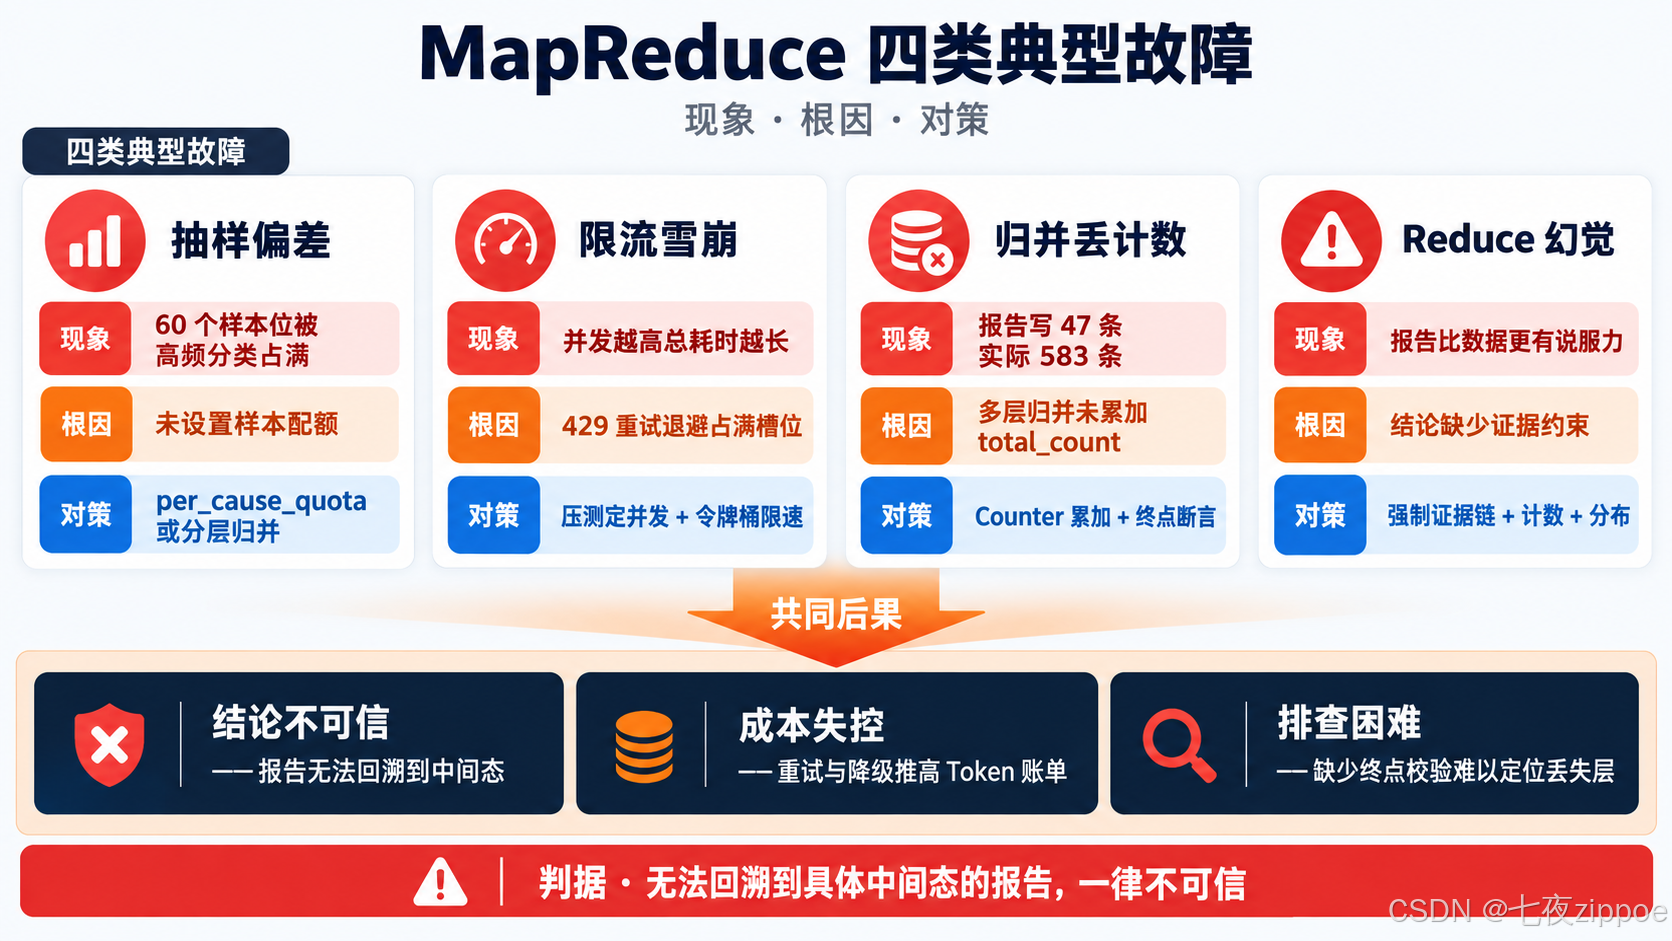
图5:MapReduce 四类典型故障——现象、根因与对策
陷阱一:抽样偏差——高频分类掩盖低频严重问题
600 条工单里 480 条是磁盘告警、8 条是数据库连接池耗尽。不设配额地抽样,60 个样本位被磁盘告警占满,Reduce 阶段的报告里根本看不到那 8 条连接池问题——而后者才是真正需要立刻处理的。
解决:preprocess 里的 per_cause_quota,或者用分层归并让它无损进入统计。
陷阱二:限流雪崩——并发越高越慢
把并发从 32 调到 64,总耗时从 25 分钟涨到 39 分钟,成本涨 49%。原因是 429 触发后重试退避,大量并发槽位被 asyncio.sleep 占用,实际在飞请求数反而下降。
解决:先用 4.4 节的方法压测定并发度;信号量包住整个子任务;令牌桶限速率(本文示例的信号量只解决了并发维度,RPM 维度需要在真实环境里补上)。
陷阱三:归并丢计数——报告数字对不上
多层归并时忘记累加 total_count,报告写"共分析 47 条",实际 583 条。更糟的情况是归并层数不固定,导致同一批数据两次跑出不同的总数。
解决:tree_reduce 里的终点断言,以及每层都用 Counter.update 做确定性累加而非依赖 LLM 回传。
陷阱四:Reduce 阶段幻觉——报告写得比数据更好
Reduce 让 LLM 生成结论时,它会自然地补全逻辑、"总结"出并不存在的因果关系。一份看起来很有洞察的报告,可能完全建立在 3 条样本上。
解决:三个约束——强制携带证据链(Evidence 模型)、强制携带计数(total_count)、强制输出分布而非散文。如果一份报告无法回溯到具体的中间态,它就不可信。
7.4 版本与兼容性提醒
⚠️ LangGraph API 变动较快:
Send的导入路径、add_conditional_edges的第三个参数、StateGraph的编译方式在 0.x 各版本间有过调整。本文代码基于 0.2+ 编写,你的项目请以安装版本的官方文档为准。⚠️
asyncio.timeout需要 Python 3.11+。如果你的环境是 3.10 及以下,需要改用asyncio.wait_for(coro, timeout=timeout_s),语义在超时边界上有细微差异。⚠️ Pydantic V2 与 V1 不兼容。V1 用
validator/root_validator/parse_obj,V2 用field_validator/model_validator/model_validate,字段约束也从Field(max_items=)改成了注解式。别混装。
八、进阶:让 MapReduce 撑住生产
到这里 MapReduce 已经能跑了。但从"能跑"到"生产级",还差三块拼图。
8.1 幂等与断点续跑
600 条工单跑了 25 分钟,第 500 条时进程被 OOM Killer 干掉了。没有断点续跑就得从头再来。 这是 MapReduce 场景下最常见也最痛的失败方式。
# checkpoint.py —— 断点续跑与结果缓存
from __future__ import annotations
import hashlib, json, logging, os
from pathlib import Path

logger = logging.getLogger(__name__)


def task_fingerprint(task) -> str:
    """任务指纹:内容哈希。

    用内容而不是 task_id 做 key,这样即使工单内容更新了,
    缓存也会自然失效,不会返回过期结论。
    """
    raw = task.model_dump_json(exclude={"index"})
    return hashlib.sha256(raw.encode()).hexdigest()[:16]


class ResultCache:
    """基于文件的结果缓存。

    为什么用文件而不是 Redis:MapReduce 的中间结果天然是
    "批量写、批量读、任务结束即弃",文件方案的持久性和可审计性
    反而更合适,且不引入额外部署成本。
    """

    def __init__(self, dirpath: str = ".mapreduce_cache"):
        self.dir = Path(dirpath)
        self.dir.mkdir(parents=True, exist_ok=True)
        self.hits = self.misses = 0

    def _path(self, fp: str) -> Path:
        return self.dir / f"{fp}.json"

    def get(self, task) -> "MapResult | None":
        p = self._path(task_fingerprint(task))
        if not p.exists():
            self.misses += 1
            return None
        try:
            return MapResult.model_validate_json(p.read_text(encoding="utf-8"))
        except Exception:
            # 缓存文件损坏不应阻断主流程
            logger.warning("缓存 %s 解析失败,忽略", p.name)
            p.unlink(missing_ok=True)
            self.misses += 1
            return None

    def put(self, task, result: "MapResult") -> None:
        # 只缓存成功结果:失败结果重试才有意义,缓存下来会掩盖问题
        if result.ok:
            self._path(task_fingerprint(task)).write_text(
                result.model_dump_json(), encoding="utf-8")

    def stats(self) -> dict:
        total = self.hits + self.misses
        return {"hits": self.hits, "misses": self.misses,
                "hit_rate": round(self.hits / total, 4) if total else 0.0}


async def cached_worker(task: "MapTask") -> "MapResult":
    """带缓存的 worker:命中则跳过 LLM 调用。

    这个装饰器在日常重跑场景下价值极大——同一批工单第二次跑,
    缓存命中率通常在 70% 以上,总耗时和成本直接砍掉七成。
    """
    cached = cache.get(task)
    if cached is not None:
        cache.hits += 1
        logger.debug("缓存命中 %s", task.key)
        return cached
    result = await analyze_ticket(task)
    cache.put(task, result)
    return result
代码说明:
task_fingerprint用内容哈希而非 ID。如果工单内容变了(同一个 ID 有了新告警文本),指纹随之改变,缓存自动失效。这是"内容寻址缓存"的正确姿势。- 只缓存
ok=True的结果。缓存失败结果意味着下次重跑直接返回失败,等于把临时故障固化成了永久故障——这类 bug 极难排查。 - 缓存文件损坏时静默跳过。一个损坏的 JSON 不应该让整批 600 条任务失败。记录 warning 后继续,是正确的降级方向。
- 命中率的统计要打进日志:命中率突然从 80% 掉到 10%,通常意味着上游数据格式变了或缓存目录被清理,属于需要告警的异常。
8.2 观测埋点:MapReduce 必须盯的五个指标
MapReduce 的可观测性有一个特殊性:单个任务的指标没有意义,只有分布和比例有意义。 因为你关心的是"整体有没有问题",而不是"第 347 条跑得怎么样"。
# metrics.py —— MapReduce 专用观测指标
from __future__ import annotations
import time
from collections import Counter
from dataclasses import dataclass, field

from schemas import MapResult


@dataclass
class MRMetrics:
    """MapReduce 指标收集器。

    五个必备维度:加速比(扇出是否有效)、降级率(质量是否达标)、
    重试率(下游是否稳定)、Token 分布(成本是否失控)、尾部延迟(是否被慢任务拖累)。
    """

    total: int = 0
    ok: int = 0
    degraded: int = 0
    retries: int = 0
    wall_clock_s: float = 0.0
    task_costs: list[int] = field(default_factory=list)
    tokens_in: int = 0
    tokens_out: int = 0
    failure_kinds: Counter = field(default_factory=Counter)

    def observe(self, results: list[MapResult], wall_clock_s: float) -> dict:
        self.wall_clock_s = wall_clock_s
        self.total += len(results)
        self.ok += sum(1 for r in results if r.ok)
        self.degraded += sum(1 for r in results if not r.ok)
        self.retries += sum(r.attempts - 1 for r in results)
        self.task_costs.extend(r.cost_ms for r in results)
        self.tokens_in += sum(r.tokens_in for r in results)
        self.tokens_out += sum(r.tokens_out for r in results)
        for r in results:
            if not r.ok and r.error:
                self.failure_kinds[r.error.split(":")[0]] += 1
        return self.snapshot()

    def snapshot(self) -> dict:
        costs = sorted(self.task_costs)
        n = len(costs) or 1
        serial_estimate = sum(costs) / 1000
        p = lambda q: costs[min(int(n * q), n - 1)]   # P50/P95/P99
        report = {
            # 加速比 < 3 通常意味着扇出没真正生效
            "speedup": round(serial_estimate / max(self.wall_clock_s, 1e-9), 2),
            "ok_rate": round(self.ok / self.total, 4) if self.total else 0,
            "degraded": self.degraded,
            "avg_retries": round(self.retries / self.total, 3) if self.total else 0,
            "p50_ms": p(.50), "p95_ms": p(.95), "p99_ms": p(.99),
            # 尾部与中位数之比 > 10 说明长尾严重,考虑加权分区
            "tail_ratio": round(p(.99) / max(p(.50), 1), 2),
            "tokens_total": self.tokens_in + self.tokens_out,
        }
        if self.failure_kinds:
            report["failure_kinds"] = dict(self.failure_kinds.most_common(5))
        return report

    def should_alert(self) -> list[str]:
        """告警规则。阈值按你自己的 SLA 调整,此处给的是经验起点。"""
        s = self.snapshot()
        alerts = []
        if s["ok_rate"] < 0.98:
            alerts.append(f"降级率过高: ok_rate={s['ok_rate']:.2%},失败分布={s.get('failure_kinds')}")
        if s["speedup"] < 3 and self.total > 50:
            alerts.append(f"扇出疑似失效: speedup={s['speedup']},检查下游限流与 worker 阻塞")
        if s["avg_retries"] > 0.5:
            alerts.append(f"重试率异常: avg_retries={s['avg_retries']},下游可能不健康")
        if s["tail_ratio"] > 10:
            alerts.append(f"长尾严重: P99/P50={s['tail_ratio']},建议按耗时加权分区")
        return alerts
五个指标各自的告警意义:
| 指标 | 健康值 | 异常含义 | 首选动作 |
|---|---|---|---|
| 加速比 | > 8 | 扇出没生效 | 查下游 429、查 worker 是否同步阻塞 |
| 降级率 | < 2% | 质量或稳定性问题 | 按 failure_kinds 定位根因类别 |
| 重试率 | < 0.1 | 下游不健康 | 检查配额、考虑提额 |
| Token 分布 | 按业务预期 | 成本失控 | 检查是否有输出未截断、Prompt 膨胀 |
| 尾部延迟比 | < 10 | 长尾严重 | 改用加权分区,或给慢任务单独通道 |
**特别强调"尾部延迟比"**这个指标:它是发现"分区策略不合理"的唯一手段。如果 P99 是 P50 的 15 倍,说明某类工单天然慢且被随机分到了最后一批。tree_ratio 一旦超过 10,就该上预估耗时分区了。
8.3 Mock 测试:不烧钱也能验证编排
Agent 编排代码的测试有个残酷现实:每次跑测试都在烧 token。 所以必须分层。
# test_mapreduce.py —— 分层测试策略
import asyncio
import pytest
from schemas import MapTask, MapResult, Evidence, RootCause
from fanout import fan_out
from reduce import preprocess
from tree_reduce import tree_reduce, _merge_nodes, MergeNode


class FlakyWorker:
    """可编排的故障注入 Mock:让测试确定性地触发各种失败路径。"""

    def __init__(self, fail_keys=(), slow_keys=(), bad_keys=()):
        self.fail_keys = set(fail_keys)     # 抛可重试异常
        self.slow_keys = set(slow_keys)     # 超时
        self.bad_keys = set(bad_keys)       # 返回无证据的坏结果
        self.calls: list[str] = []

    async def __call__(self, task: MapTask) -> MapResult:
        self.calls.append(task.key)
        if task.key in self.slow_keys:
            await asyncio.sleep(10)        # 配合 timeout_s=0.1 触发超时
        if task.key in self.fail_keys:
            raise ConnectionError(f"模拟下游不可用: {task.key}")
        if task.key in self.bad_keys:
            # 关键用例:ok=True 但零证据,应被 model_validator 打回
            return MapResult(key=task.key, index=task.index, ok=True,
                             root_cause=RootCause.CODE_DEFECT, confidence=0.9)
        return MapResult(
            key=task.key, index=task.index, ok=True,
            root_cause=RootCause.RESOURCE_EXHAUSTION, confidence=0.85,
            evidence=[Evidence(fact=f"{task.key} 的磁盘使用率 97%",
                               source="metrics.disk_usage")],
            remediation="清理历史日志或扩容",
        )


def make_tasks(n: int) -> list[MapTask]:
    return [MapTask(key=f"T{i}", index=i, alarm_text=f"告警 {i}",
                    source_system="sentinel", severity="medium",
                    metrics={"disk": 90.0 + i}) for i in range(n)]


@pytest.mark.asyncio
async def test_partial_failure_does_not_break_batch():
    """核心用例:部分失败不能中断整批。这是 MapReduce 最重要的语义。"""
    tasks = make_tasks(10)
    worker = FlakyWorker(fail_keys={"T3", "T7"}, bad_keys={"T5"})
    results = await fan_out(tasks, worker, concurrency=4, timeout_s=1, max_retries=1)

    assert len(results) == 10, "结果数量必须与输入等长"
    assert sum(1 for r in results if not r.ok) == 3   # 2 个失败 + 1 个坏结果
    # 顺序必须对齐,否则 Reduce 的排序会错
    assert [r.key for r in results] == [t.key for t in tasks]


@pytest.mark.asyncio
async def test_retry_then_success():
    """可重试错误应该重试成功,而非直接降级。"""
    tasks = make_tasks(1)
    worker = FlakyWorker(fail_keys={"T0"})

    async def worker_that_fails_once(t):
        worker.calls.append(t.key)
        if len(worker.calls) == 1:
            raise ConnectionError("首次失败")
        return await FlakyWorker()(t)

    results = await fan_out(tasks, worker_that_fails_once,
                            timeout_s=1, max_retries=2)
    assert results[0].ok is True
    assert results[0].attempts == 2, "应记录为第 2 次尝试成功"


@pytest.mark.asyncio
async def test_timeout_is_bounded():
    """超时必须真的生效,不能让一个慢任务拖垮整批。"""
    tasks = make_tasks(5)
    worker = FlakyWorker(slow_keys={"T2"})
    loop = asyncio.get_running_loop()
    t0 = loop.time()
    results = await fan_out(tasks, worker, concurrency=5, timeout_s=0.3, max_retries=0)
    assert loop.time() - t0 < 2.0, "总耗时应受超时约束"
    assert results[2].ok is False and "timeout" in (results[2].error or "").lower()


def test_tree_reduce_preserves_counts():
    """归并树的计数绝不能丢——这是最难发现的 bug,必须单测锁死。"""
    nodes = [MergeNode(total_count=7, distribution={"a": 7}),
             MergeNode(total_count=12, distribution={"a": 3, "b": 9}),
             MergeNode(total_count=5, distribution={"c": 5})]
    merged = _merge_nodes(nodes)
    assert merged.total_count == 24
    assert merged.distribution == {"a": 10, "b": 9, "c": 5}


def test_preprocess_balances_samples():
    """高频分类不得刷满样本位——低频但严重的类别必须露脸。"""
    results = [MapResult(key=f"H{i}", index=i, ok=True,
                         root_cause=RootCause.RESOURCE_EXHAUSTION, confidence=0.9,
                         evidence=[Evidence(fact="磁盘 97%", source="m.disk")])
               for i in range(50)]
    results += [MapResult(key="R1", index=999, ok=True,
                          root_cause=RootCause.DEPENDENCY_FAILURE, confidence=0.95,
                          evidence=[Evidence(fact="连接池耗尽", source="m.pool")])]
    ctx = preprocess(results, max_samples=20)
    assert "依赖故障" in ctx["samples"], "稀有但严重的分类必须出现在样本中"
代码说明:
FlakyWorker是测试资产。可编排的故障注入让"部分失败"“超时”"重试成功"这些路径能被确定性地触发,而不是靠运气等真实故障出现。这类 Mock 的价值远超其代码量。test_partial_failure_does_not_break_batch是最重要的一条用例。它同时锁死了三个语义:结果数量对齐输入、失败被降级而非中断、顺序保持稳定。任何一个回归都会立刻失败。test_tree_reduce_preserves_counts锁死的是最隐蔽的 bug。计数丢失在功能测试里完全看不出来(报告照常生成,只是数字偏小),只有专门断言能发现。test_preprocess_balances_samples验证的是公平性而非正确性。它保护的不是一个崩溃,而是一类"报告看起来正常但漏掉了关键问题"的静默劣化。- 生产实践:这类测试应该进 CI,每次提交都跑,全程零 LLM 调用、零成本、秒级完成。Mock 测试的覆盖率应该覆盖所有编排分支;真实 LLM 只用于每次发布前的少量集成验证。
九、总结
回到文章开头的问题:为什么需要 MapReduce 模式? 因为当任务被拆成 N 个彼此独立的子任务时,串行执行的延迟是求和,而并行的延迟是求最大值——这个从加法到取最大值的转换,就是 600 条工单从 10 小时 20 分变成 28 分钟的全部原因。
这一路走下来,可以提炼出四个核心认知:
第一,MapReduce 的价值是延迟,不是"高级"。 它不增加任何智能能力,只是让已有的能力同时发生。判断是否该用它,唯一的问题是"串行要跑多久"。10 分钟以内,串行;10 小时以上,并行。
第二,扇出度是调出来的,不是猜出来的。 我实测的数据里,32 并发反而比 24 慢、比 48 快不了多少,而成本多花 8%。经验公式"配额 RPM ÷ 60 × 单任务耗时 × 0.4"可以作为起点,但它必须在你的环境里验证一次。过高的并发不只是慢,还会更贵。
第三,Reduce 阶段必须分层,否则撑不过 200 条。 600 份结果一次性喂给 LLM 是 9 万 token,输入超限和质量退化同时发生。树形归并让单次输入规模恒定、总调用次数 O(N),配合 preprocess 的零成本压缩和 per_cause_quota 的公平性保护,才让 MapReduce 具备了规模化能力。N ≤ 200 用单层,N ≥ 200 或需要无损审计用分层——这是我给出的拍板建议。
第四,部分失败是常态,降级是设计而非妥协。 600 条挂 3 条不该导致整批作废。把失败做成数据(ok=False 的 MapResult)而不是异常,让它一路流到报告里变成"3 条待人工复核"。异常会中断 gather,数据不会——这两者在代码里只差一个 try 块,在生产行为上是天壤之别。
选型速览:单机数百任务用 asyncio 原生(最少依赖、最高性能);流程会演进、需要断点续跑用 LangGraph Send(记得设 recursion_limit);跨机万级任务才考虑任务队列。
落地自检清单(Checklist)
交付前逐项确认你的 MapReduce 是否达标:
- ✅ Map 阶段子任务真正无依赖,可明确列出 N 个独立输入
- ✅ 并发度经压测确定,非拍脑袋;有 Token Bucket 补足 RPM 维度限流
- ✅ 信号量包住整个子任务(含重试与退避),而非只包单次请求
- ✅ 错误已分类,可重试错误才重试;退避含指数 + 抖动 + 上限
- ✅ 失败被转为
ok=False的数据对象,不以异常形式冒出 - ✅ MapResult 携带
key+index,结果与输入严格顺序对齐 - ✅ Map 输出强制携带证据链与置信度,无证据结果被判为不可信
- ✅ Reduce 前有确定性预处理,输入规模已压缩一个量级
- ✅ 高频分类有样本配额,避免掩盖低频严重问题
- ✅ N ≥ 200 采用分层归并,且每层累计
total_count并有终点断言 - ✅ 接入观测:加速比 / 降级率 / 重试率 / Token / 尾部延迟比
- ✅ 有告警规则:ok_rate < 0.98 或 speedup < 3 时触发
- ✅ 支持幂等:内容哈希缓存 + 断点续跑
- ✅ Mock 测试覆盖部分失败、超时、重试、计数守恒四类路径
常见问题(FAQ)
Q1:MapReduce 和并行 for 循环有什么区别?
三点实质差异:① 失败语义——并行循环里一个异常会中断整批,MapReduce 把失败降级为数据;② 可扩展性——asyncio.gather 一次扔 600 个协程的内存开销和调度开销都不可控,而受控扇出可以用信号量精确控制;③ 聚合能力——并行循环拿到的还是 N 份散装结果,MapReduce 提供 Reduce 阶段做收敛。只有"并行执行"需求的场景,普通并行循环就够,不必上完整 MapReduce。
Q2:Map 阶段内部能用 LLM 做多步推理吗?
完全可以,而且这才是常态。Map 阶段内部通常就是一条小 Pipeline(第 22 篇的内容)——采集、分析、定性三跳串行。MapReduce 和 Pipeline 是嵌套关系,不是替代关系。 外层 MapReduce 管"多个任务并行",内层 Pipeline 管"单个任务的深度"。
Q3:Reduce 阶段为什么不用 LLM 做全量归纳,非要分层?
三个原因:① 上下文限制,600 份结果就是 9 万 token,超窗;② 长上下文中模型注意力会被稀释,反而丢失关键信息;③ 分层后可以精确定位"哪一层开始丢信息",可调试。全 LLM 归并我实测过,准确率反而低于混合归并——因为收敛层用 Counter.update 做精确计数,比让 LLM 数数可靠得多。
Q4:怎么判断我的场景该用 MapReduce 还是 Supervisor?
看任务拆分是否已知。如果你在开工前就能确定"N 个子任务是什么",用 MapReduce。如果需要运行时判断"下一个该派给谁、派几个",那是 Supervisor(第 24 篇)。举个具体例子:批量分析 600 条已知工单 → MapReduce;分析过程中发现某类工单需要额外的外部调研,动态增加子任务 → Supervisor。两者也可以组合:Supervisor 在上,MapReduce 在下。
参考资料
- LangGraph 官方文档 —— StateGraph、Send 与并行状态聚合:https://langchain-ai.github.io/langgraph/
- LangGraph 多 Agent 与 MapReduce 官方示例:https://langchain-ai.github.io/langgraph/tutorials/multi_agent/
- Python 3.11
asyncio.timeout()与并发原语文档:https://docs.python.org/3/library/asyncio-task.html - Pydantic V2 官方文档(字段约束、model_validator、model_dump_json):https://docs.pydantic.dev/
- Dean & Ghemawat, MapReduce: Simplified Data Processing on Large Clusters(OSDI 2004,树形归并与 Combiner 思想的源头):https://research.google/pubs/pub62/
- Anthropic —— Building effective agents(并行化与编排模式综述):https://www.anthropic.com/research/building-effective-agents
- AWS Architecture Blog —— Expediting Deep Learning Inference 并行模式与限流实践:https://aws.amazon.com/blogs/machine-learning/
转载自 CSDN-专业IT技术社区
原文链接:https://blog.csdn.net/sinat_41617212/article/details/167274562

