

第一次看到 Model Context Protocol 这个名字,很容易以为它是某种模型内部协议。其实 MCP 做的事情很朴素:给 AI 应用接工具、数据和外部服务。
比如用户问:
北京明天的天气怎么样?
模型能理解这句话,却没有明天的实时天气。应用必须先调用天气服务:
get_weather(city="北京", date="明天")
拿到查询结果后,模型才能回答。读取本地文件、搜索企业知识库、查询数据库、访问 GitHub,也都是同一回事:模型负责理解和生成,外部系统提供它原本拿不到的数据与能力。
只接一个天气 API 时,写几段调用代码就够了。可当一个 AI 应用要接十几个系统,另一个应用又要重复接一遍,问题就从“怎么调用 API”变成了“这些连接能不能复用”。MCP 填的正是这块空白。
它不是一个具体工具,也不会替代已有 API。它是一套开放协议,约定 AI 应用怎样发现、连接和使用外部能力。
每接一个系统,就多一套胶水代码
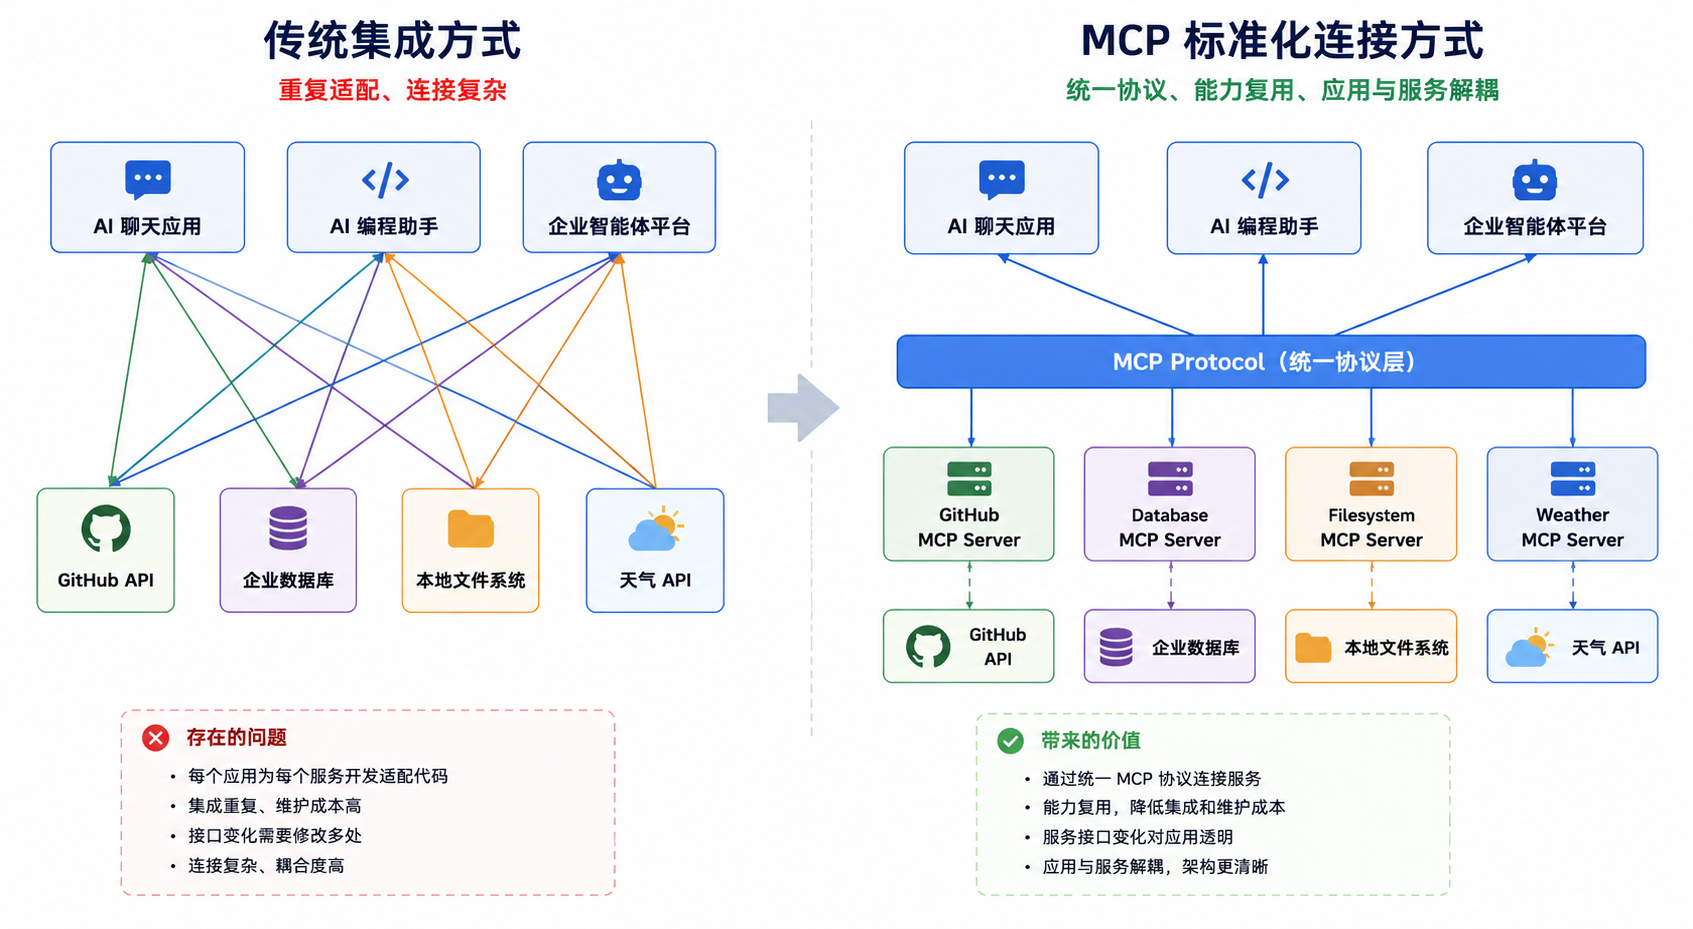
没有 MCP 时,聊天应用、编程助手和企业智能体平台通常会各自实现 GitHub、数据库、文件系统等连接器。项目规模不大时,这样做最直接;接入越来越多后,重复代码、鉴权方式、错误处理和接口变化就会一起冒出来。
MCP 的思路是在中间增加一层稳定接口。外部系统仍按自己的方式工作,MCP Server 负责把它包装成 AI 应用能够识别的能力:
AI 应用 ←── MCP ──→ MCP Server ←── API / SDK ──→ 外部系统
一个 GitHub MCP Server 可以暴露查询仓库、读取 Issue、创建 Pull Request 等能力。只要 Host 支持 MCP,就能用相同的协议连接它,不必再发明一套私有消息格式。
官方文档把 MCP 比作 AI 应用的“USB-C 接口”。这个类比并不严谨,但足够直观:USB-C 不生产键盘和硬盘,MCP 也不生产天气数据或企业数据;它们解决的都是“怎么接上”的问题。[1]
从 Anthropic 提案到开放协议
MCP 最初由 Anthropic 提出。2024 年 11 月 25 日,Anthropic 开源了协议规范和 SDK,同时在 Claude Desktop 中加入本地 MCP Server 支持,并提供了一批参考实现。[2]
协议随后很快走出 Claude 生态。ChatGPT、Codex、Cursor、Visual Studio Code 等产品先后加入支持,云厂商和企业平台也开始建设相关基础设施。2025 年 12 月,Anthropic 将 MCP 捐赠给 Linux Foundation 旗下的 Agentic AI Foundation。[3]
所以现在再把 MCP 称为“Claude 的工具协议”并不准确。它由 Anthropic 发起,如今已经是一个跨厂商采用的开放项目。
本文以 2025-11-25 版规范为基础。截至 2026 年 7 月,它仍是最新稳定版本;2026-07-28 版尚处于候选阶段。[4][5]
Host、Client 和 Server 到底是什么
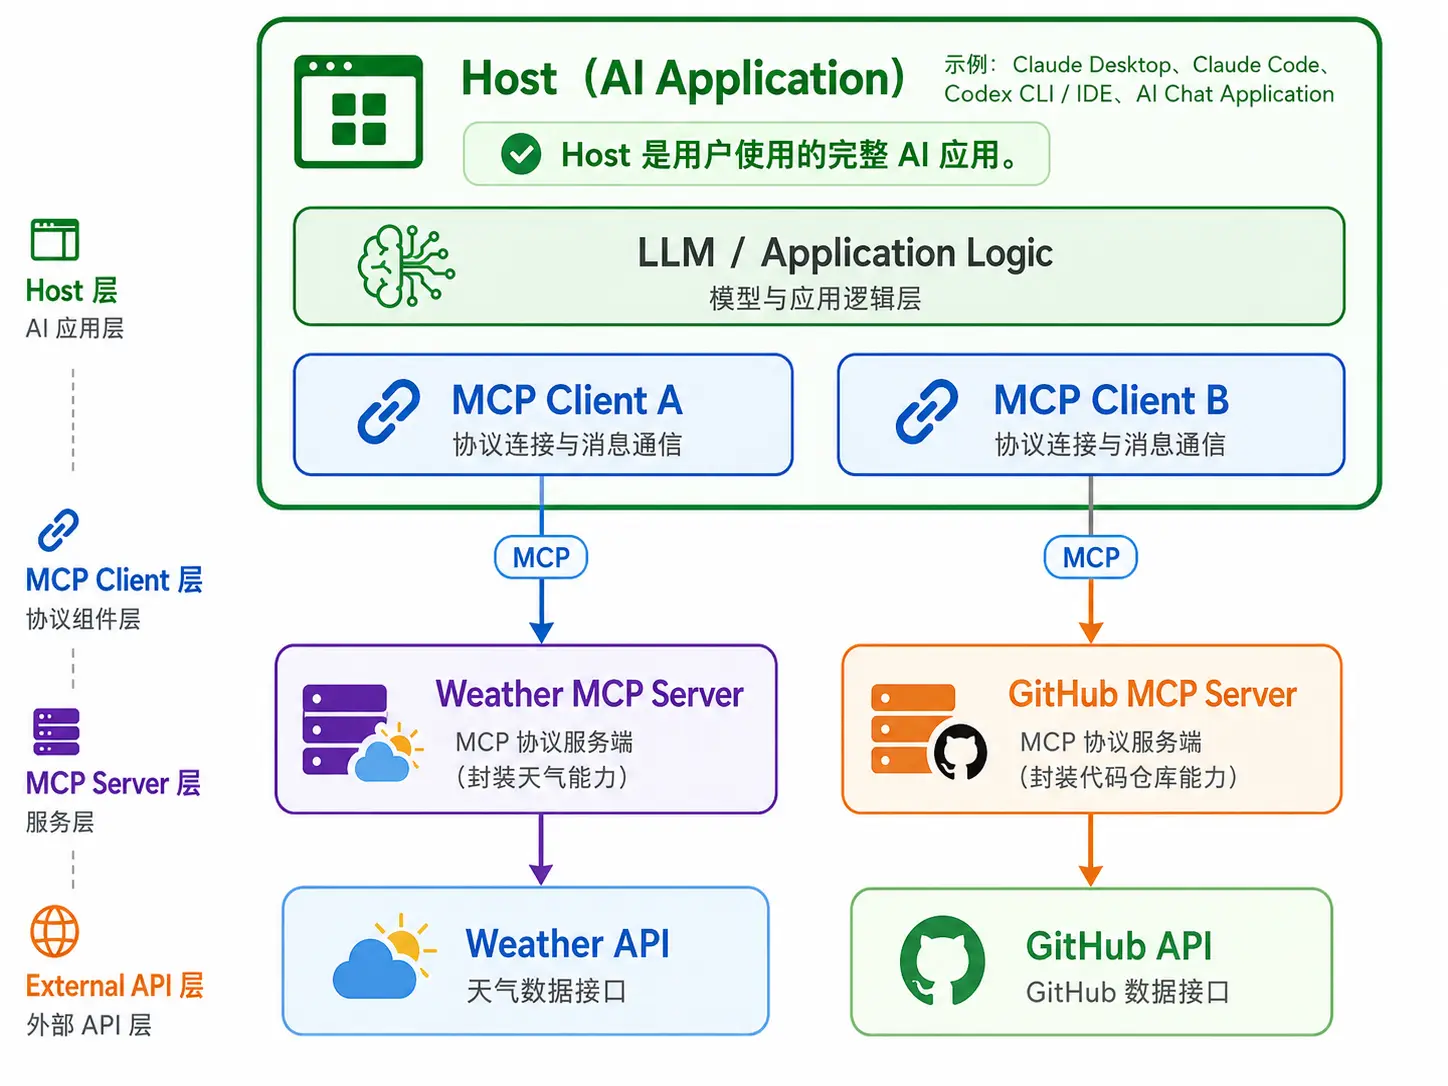
MCP 架构图里有三个名字反复出现:Host、MCP Client 和 MCP Server。第一次接触时,最容易漏掉的是 Client,因为它通常藏在 Host 内部,用户根本看不到。
Host 是完整的 AI 应用
Claude Desktop、ChatGPT、Codex CLI、AI IDE,以及企业自研的智能体平台,都可以承担 Host 的角色。用户实际面对的是 Host,而不是 MCP Server。
Host 负责接收输入、调用模型、维护上下文、展示结果和处理权限确认。它还要决定把哪些工具交给模型、模型发起调用后应该路由到哪个 Server。以 Codex CLI 为例,配置 MCP Server 后,Codex 就可以在任务中使用该 Server 暴露的能力。[6]
这里要把 Host 和模型分开看。模型只是 Host 使用的一个组件;真正掌握连接、权限和执行流程的是 Host。
Client 是 Host 内部的连接器
MCP Client 与某个 MCP Server 建立连接,完成初始化,发送请求并接收响应。从逻辑上看,一个 Client 通常维护一条到 Server 的连接。
Client 一般不理解用户想做什么,也不生成最终回答。它做的是协议层工作。虽然实际代码里 Host 和 Client 可能在同一个进程,甚至由同一个 SDK 实现,但排查问题时最好仍把两者分开:Host 负责协调,Client 负责通信。
Server 是能力适配层
MCP Server 按照协议暴露数据和操作。它背后可以接 REST API、GraphQL API、数据库、文件系统、SDK、CLI 程序,也可以只是几个本地函数。
天气 Server 通常不会自己生产天气数据。它接收 MCP 请求,转而调用第三方天气 API,再把结果整理成 MCP 能返回的格式。GitHub、数据库和企业内部系统的 Server 也是同样的角色。
这也是为什么把 MCP Server 理解为“能力适配层”更合适。真正的数据和业务逻辑还在底层系统里,原有的 API Key、账号权限和服务规则不会因为套了一层 MCP 就消失。
Server 里不只有 Tools
大多数人第一次使用 MCP,接触到的是 Tools。实际上,Server 可以提供三类主要能力:
| 能力 | 用来做什么 | 常见例子 |
|---|---|---|
| Tools | 执行一个动作 | 查询天气、创建 Issue、运行数据库查询 |
| Resources | 读取上下文数据 | 文件、文档、表结构、应用配置 |
| Prompts | 提供可复用的提示模板 | 代码审查、事故分析、报告生成 |
Tool 定义里通常会有名称、用途说明和输入参数的 JSON Schema。天气工具可能长这样:
{
  "name": "get_weather",
  "description": "查询指定城市和日期的天气",
  "inputSchema": {
    "type": "object",
    "properties": {
      "city": { "type": "string" },
      "date": { "type": "string" }
    },
    "required": ["city", "date"]
  }
}
模型根据这些信息判断工具是否适合当前任务,并生成参数。描述写得含糊,模型就更容易选错工具;参数定义不严谨,Server 端就要承担更多校验工作。
Resource 更像一份可寻址的数据。例如 file:///project/README.md 可以指向项目说明,database://schema/users 可以表示用户表结构。Prompt 则是一套可以带参数的消息模板,例如 review_code(language="Python", focus="security")。
一个 Server 可以同时提供三类能力。代码仓库 Server 既可以把仓库文件作为 Resource,也可以提供创建 Issue 的 Tool,还可以附带代码审查 Prompt。
一条 MCP 连接是怎么准备好的
模型能调用工具之前,Client 和 Server 要先完成连接与能力发现。这个过程通常发生在连接建立时,而不是每次用户提问时。
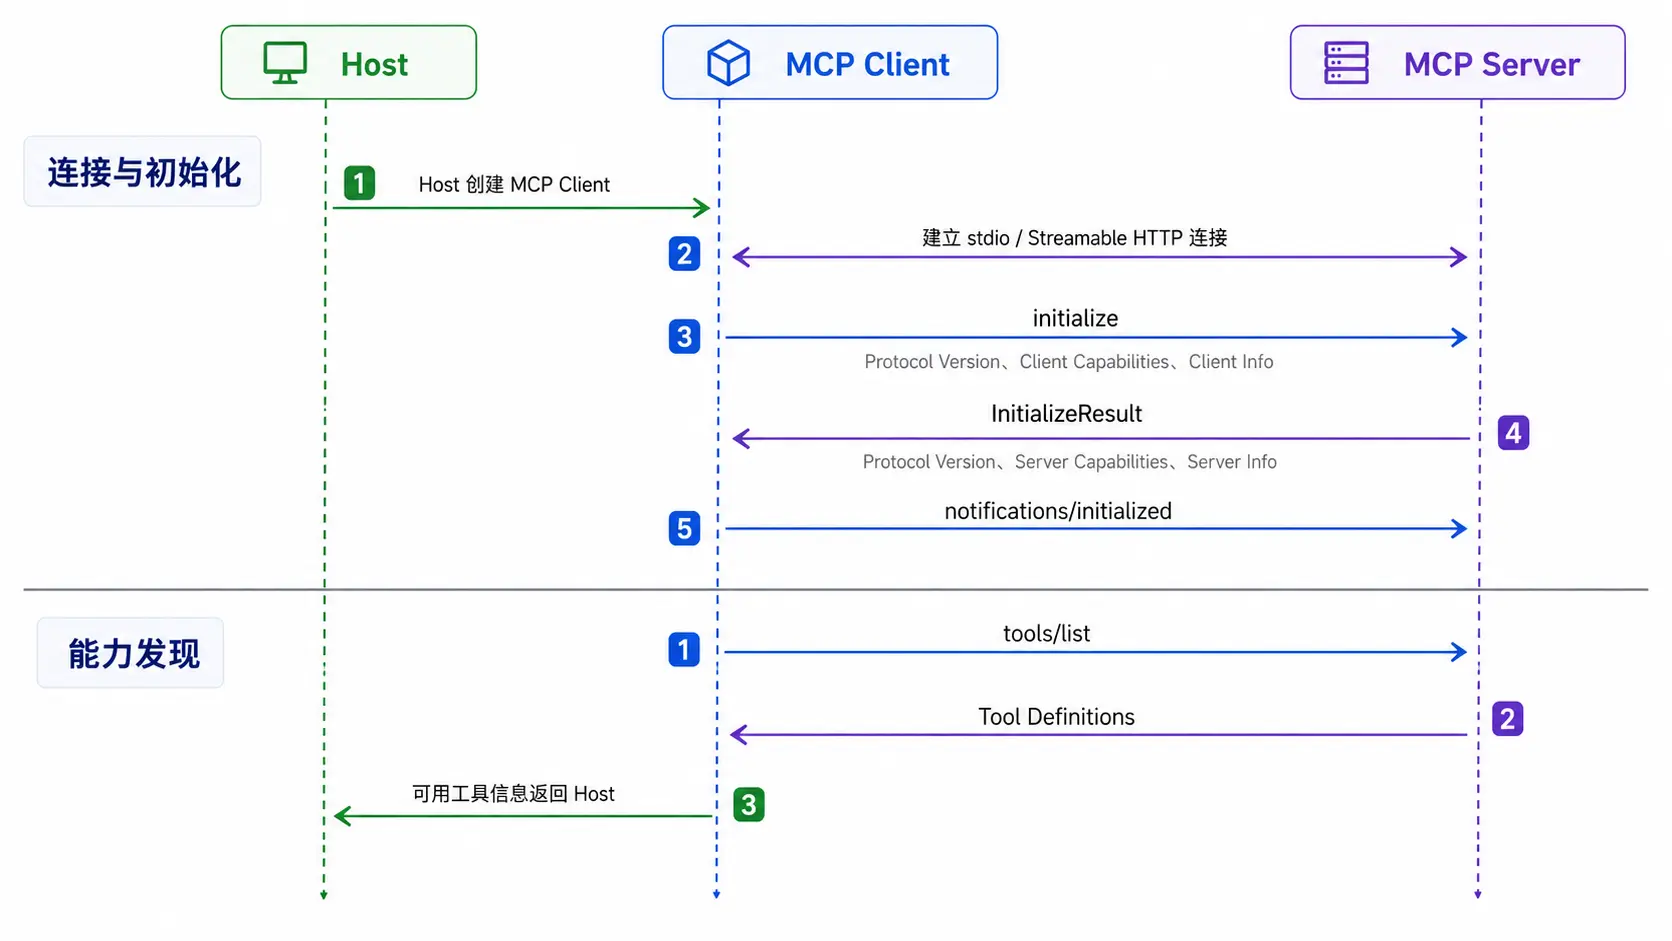
2025-11-25 版规范中,常见的标准传输方式有两种。stdio 用于本地 Server:Host 启动子进程,通过标准输入和标准输出收发消息。Streamable HTTP 更适合部署在远程,通过 HTTPS 连接。
如果自己实现 stdio Server,有一个很实际的坑:stdout 是协议通道,不能随手往里面打印调试日志,否则可能破坏 JSON-RPC 消息。日志通常应该写到 stderr。
传输连接建立后,Client 发送 initialize,告诉 Server 自己使用的协议版本、名称、版本和支持的能力。Server 返回接受的协议版本、Server 信息和能力列表。Client 再发送 notifications/initialized,初始化结束。
接着,Client 可以通过 tools/list 获取工具定义。Server 支持 Resources 或 Prompts 时,也有相应的发现方法。Host 拿到这些信息后,才知道可以向模型提供哪些能力。
这里还有一个实现细节:如果多个 Server 都暴露了同名 Tool,Host 必须保留工具来自哪个 Server 的信息。有的实现会给工具名加命名空间,有的维护内部路由表。无论采用哪种方式,模型发出调用后,Host 都要把它送到正确的 Client。
从一句天气查询看完整调用
现在回到开头的问题:
北京明天的天气怎么样?
假设 Weather MCP Client 已经连接到 Server,初始化和 tools/list 也已经完成,Host 手里有 get_weather 的工具定义。
Host 先把用户问题和工具定义一起交给模型。模型判断需要查询实时数据,生成一个结构化调用:
{
  "name": "get_weather",
  "arguments": {
    "city": "北京",
    "date": "明天"
  }
}
此时真正的天气服务还没有被访问。模型只是告诉 Host:我想调用哪个工具,参数是什么。
Host 根据工具来源找到 Weather MCP Client。Client 再按 MCP 的 JSON-RPC 2.0 格式向 Server 发送 tools/call:
{
  "jsonrpc": "2.0",
  "id": 2,
  "method": "tools/call",
  "params": {
    "name": "get_weather",
    "arguments": {
      "city": "北京",
      "date": "明天"
    }
  }
}
Weather MCP Server 收到请求后,检查工具和参数,调用背后的天气 API,并把返回数据转换成 Tool Result。结果沿原路回到 Host,再被加入模型上下文。模型看到真实数据后,才生成用户最终读到的回答。
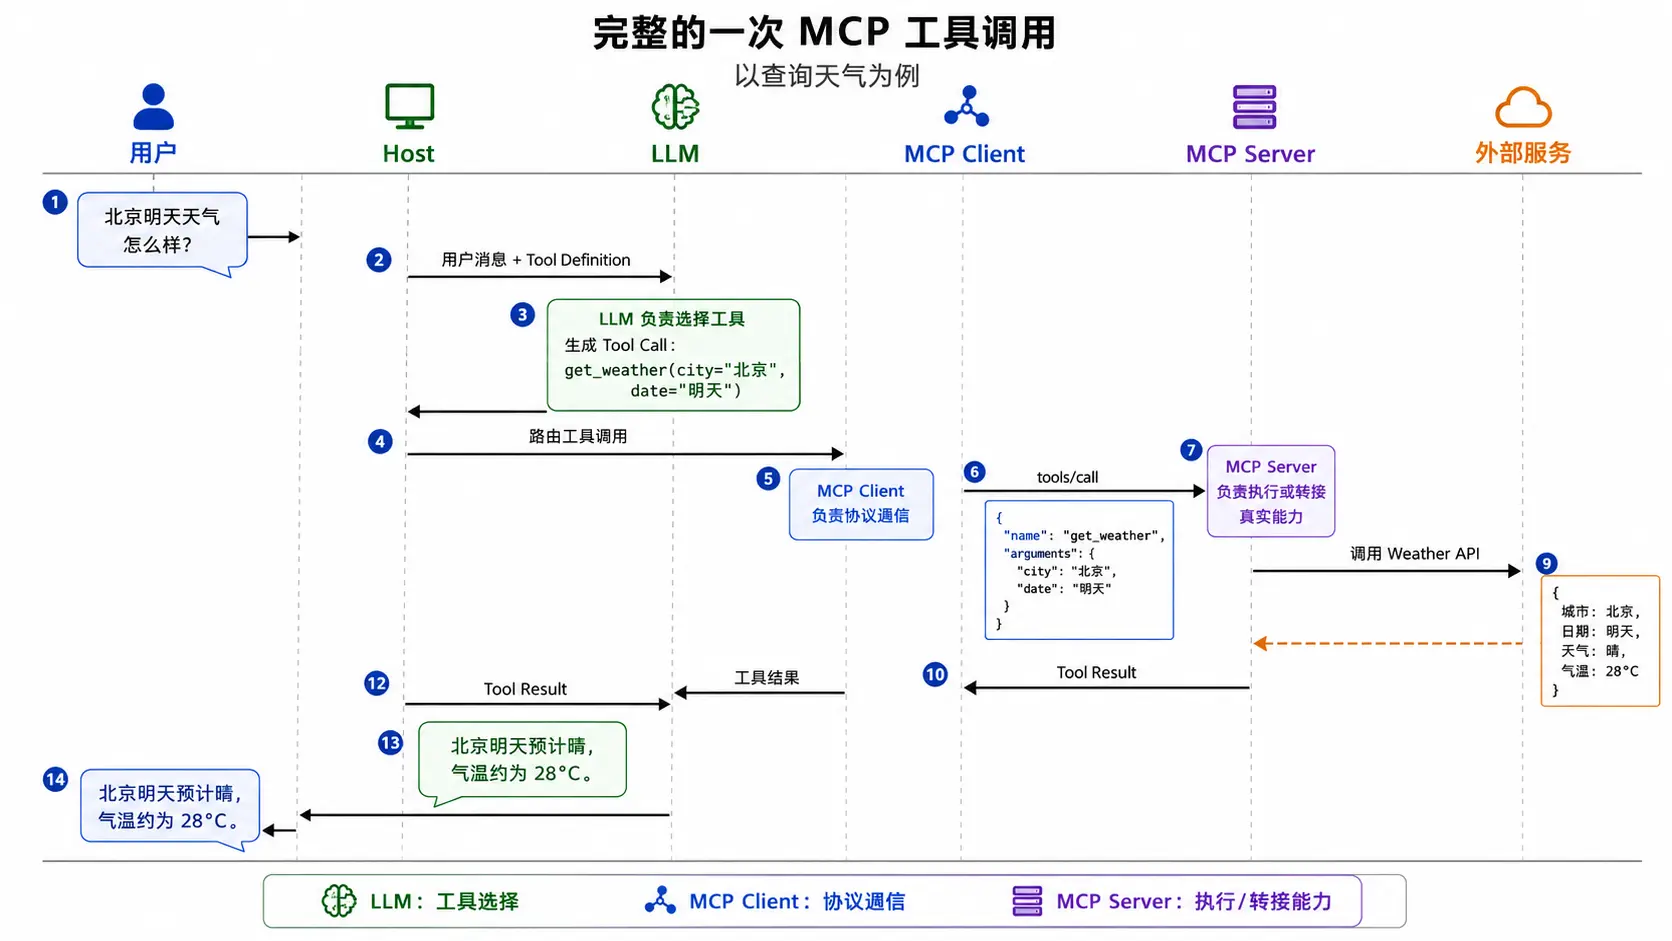
这条链路看起来长,却把责任切得很清楚。模型选工具和参数,Host 管流程与权限,Client 处理协议通信,Server 执行或转接能力,底层系统提供真实数据。
这种拆分对排障很有用。模型没有发起调用,通常要检查工具描述和上下文;调用发错地方,要看 Host 的路由;Server 收到请求却失败,则继续检查参数校验、鉴权和底层 API。笼统地说“MCP 调用失败”,往往很难定位问题。
MCP 和 Function Calling 不是同一层
MCP 经常和 Function Calling 一起出现,因为两者都涉及工具名称和参数,但它们解决的问题不同。
Function Calling 描述模型怎样向应用表达调用意图:应用给出函数定义,模型返回要调用的函数和参数。这个函数从哪里来、怎样发现、通过什么连接执行,不是 Function Calling 负责的事情。
MCP 处理的是应用与能力提供方之间的连接。它定义 Client 和 Server 怎样初始化、协商能力、发现工具、发起调用并返回结果。Host 从 MCP Server 获得 Tool 定义后,仍然可以使用模型的 Function Calling 能力来选择工具。
换句话说,Function Calling 让模型说出“我要调用 get_weather”,MCP 则负责把这句话变成一次发往正确 Server 的请求。MCP 没有让模型第一次学会调用函数,它让来自不同系统的函数更容易被接入和复用。
协议统一了,安全问题还在
MCP Server 可以拥有很高的权限:读取文件、查询企业数据库、执行命令、修改代码、创建工单或发送消息。连接方式统一以后,这些能力更容易被 AI 应用使用,风险也会跟着被放大。
身份认证、访问授权、用户确认、最小权限、敏感数据保护和调用审计,仍然要由 Host、Server 与底层系统共同完成。来自 Server 的工具名称和描述也不能天然视为可信内容,特别是接入第三方 Server 时。
实际设计中,读操作和写操作最好分开考虑。查询天气、读取公开文档通常可以直接执行;删除文件、修改代码、发送消息等不可逆或影响外部状态的操作,则应该有更明确的授权和确认。
MCP 提供的是连接能力,不是信任背书。
写在最后
回到最初的问题,MCP 并不负责天气数据,也不负责让模型变聪明。它只是让 Host 能以相对统一的方式找到 Weather MCP Server、调用它,再把结果交回模型。
这套协议的价值也正在这里。过去散落在不同 AI 应用里的定制连接,有机会沉淀成可以复用的 Server;工具开发者不必为每个客户端重新设计接口,Host 也能用更一致的方式管理能力、权限和调用结果。
理解 Host、Client、Server 三个角色,再顺着一次 tools/call 把链路走通,MCP 的主体就不再复杂。剩下的难点,已经不是“协议到底是什么”,而是如何把连接、权限和真实业务流程做扎实。
参考资料
- Model Context Protocol: Introduction
- Anthropic: Introducing the Model Context Protocol
- Anthropic: Donating the Model Context Protocol and establishing the Agentic AI Foundation
- Model Context Protocol Specification 2025-11-25
- OpenAI Codex: Model Context Protocol
- The 2026-07-28 MCP Specification Release Candidate
转载自 CSDN-专业IT技术社区
原文链接:https://blog.csdn.net/m0_65131933/article/details/163688077

