

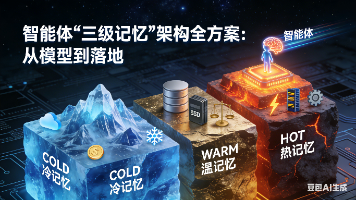
智能体记忆系统之「三级记忆」架构设计方案,涵盖:
-
记忆抽象模型
-
热 / 温 / 冷三类存储介质、延迟与成本
-
读写流程(智能体如何使用这些记忆)
-
自动升降级策略(含示例规则 & SQL/pseudo code)
-
策略配置与监控落地方案
一、统一「记忆单元」抽象
无论存在哪一层,都用同一种逻辑抽象:Memory Item(记忆单元)。
核心字段建议:
-
id:全局唯一 ID(UUID) -
user_id:所属用户/会话主体 -
type:memory 类型(对话片段 / 用户偏好 / 任务历史 / 文档切片等) -
content:原始文本或结构化 JSON -
embedding:向量(只在热 / 温层快速可用,或异步补全) -
created_at:创建时间 -
updated_at:最近修改时间 -
last_access_at:最近一次被检索或命中的时间 -
access_count_7d:近 7 天访问次数 -
access_count_30d:近 30 天访问次数 -
tier:当前所属层级(HOT/WARM/COLD) -
status:是否已删除 / 冻结
关键点:ID 与元数据统一存放在温记忆(关系型数据库)中;热 / 冷层更多是「索引 + 内容缓存」。
二、三级记忆的划分与技术选型
热记忆(HOT)——向量缓存层
定位:
-
存近期高频访问、对对话质量影响大的记忆(最近对话、重点用户偏好、正在进行的任务状态)
-
追求:极低延迟 + 高查询吞吐
推荐介质:
-
内存型向量缓存 + KV:
-
Redis + RedisSearch / Redis-Vector(或类似)
-
或 基于 Faiss / HNSW 的 in-memory 向量服务(自建 / Milvus / Qdrant 的内存集群)
-
-
可选:引入本地 LRU 缓存(per-Agent 进程内)做二级缓存
典型延迟 & 成本:
-
单次向量检索:1–10 ms
-
成本:高(内存 + 高性能节点)
适合存:
-
最近 N 轮对话的摘要 &关键信息
-
近 7~30 天内频繁命中(access_count 高)的知识片段
-
活跃用户的个性偏好、长期画像摘要
温记忆(WARM)——关系型数据库层
定位:
-
逻辑真相来源(Source of Truth)
-
负责:强一致的元数据管理 + 基本检索能力
-
读写量中等、可接受 10–100 ms 延迟
推荐介质:
-
PostgreSQL / MySQL + 向量扩展(如 pgvector)
-
或 关系型数据库 + 外部向量库(Milvus / Qdrant / Elasticsearch)
典型延迟 & 成本:
-
单次查询:10–100 ms(视索引 & 负载)
-
成本:中(SSD 磁盘为主,可水平扩展)
适合存:
-
所有记忆单元的元数据
-
近期到中长期(如 3~6 个月)的重要记忆内容
-
不那么高频,但偶尔要被搜
转载自 CSDN-专业IT技术社区
原文链接:https://blog.csdn.net/vaminal/article/details/157872604

