

YARN从入门到精通:架构原理 + 工作流程 + 三种调度器(面试必看)
本文从YARN的设计初衷出发,结合架构图和工作流程图,系统讲解 YARN四大核心组件、15步工作流程、三种调度器对比,并附上常用运维命令和高频面试题。大数据开发/运维面试必备,建议收藏!
📑 目录
一、YARN是什么?为什么需要YARN?
在学习YARN之前,先思考两个问题:
🤔 如何管理集群资源?
🤔 如何给任务合理分配资源?
这就是YARN要解决的问题。
YARN的定义
YARN(Yet Another Resource Negotiator) 是Hadoop 2.0引入的分布式资源调度平台,负责为运算程序(MapReduce、Spark、Flink等)提供服务器资源(CPU + 内存 + 磁盘 + 网络…)。
可以把YARN理解为一个分布式操作系统平台,而MapReduce/Spark/Flink等运算程序相当于运行在操作系统之上的应用程序。
为什么需要YARN?
在Hadoop 1.x时代,MapReduce同时承担了资源管理和任务计算两个职责,导致:
- ❌ 耦合度高:资源管理和计算逻辑混在一起
- ❌ 扩展性差:只能跑MapReduce,不支持其他计算框架
- ❌ 资源利用率低:JobTracker单点瓶颈
Hadoop 2.0引入YARN后,把资源调度功能从MapReduce中独立出来:
- ✅ 解耦:资源管理和计算框架分离
- ✅ 多框架支持:YARN上可以同时运行MapReduce、Spark、Flink、Storm等
- ✅ 高可用:ResourceManager支持HA
二、YARN核心架构(四大组件)
YARN采用经典的主从架构(Master/Slave),下面这张图完整展示了YARN的四大核心组件以及它们之间的关系:
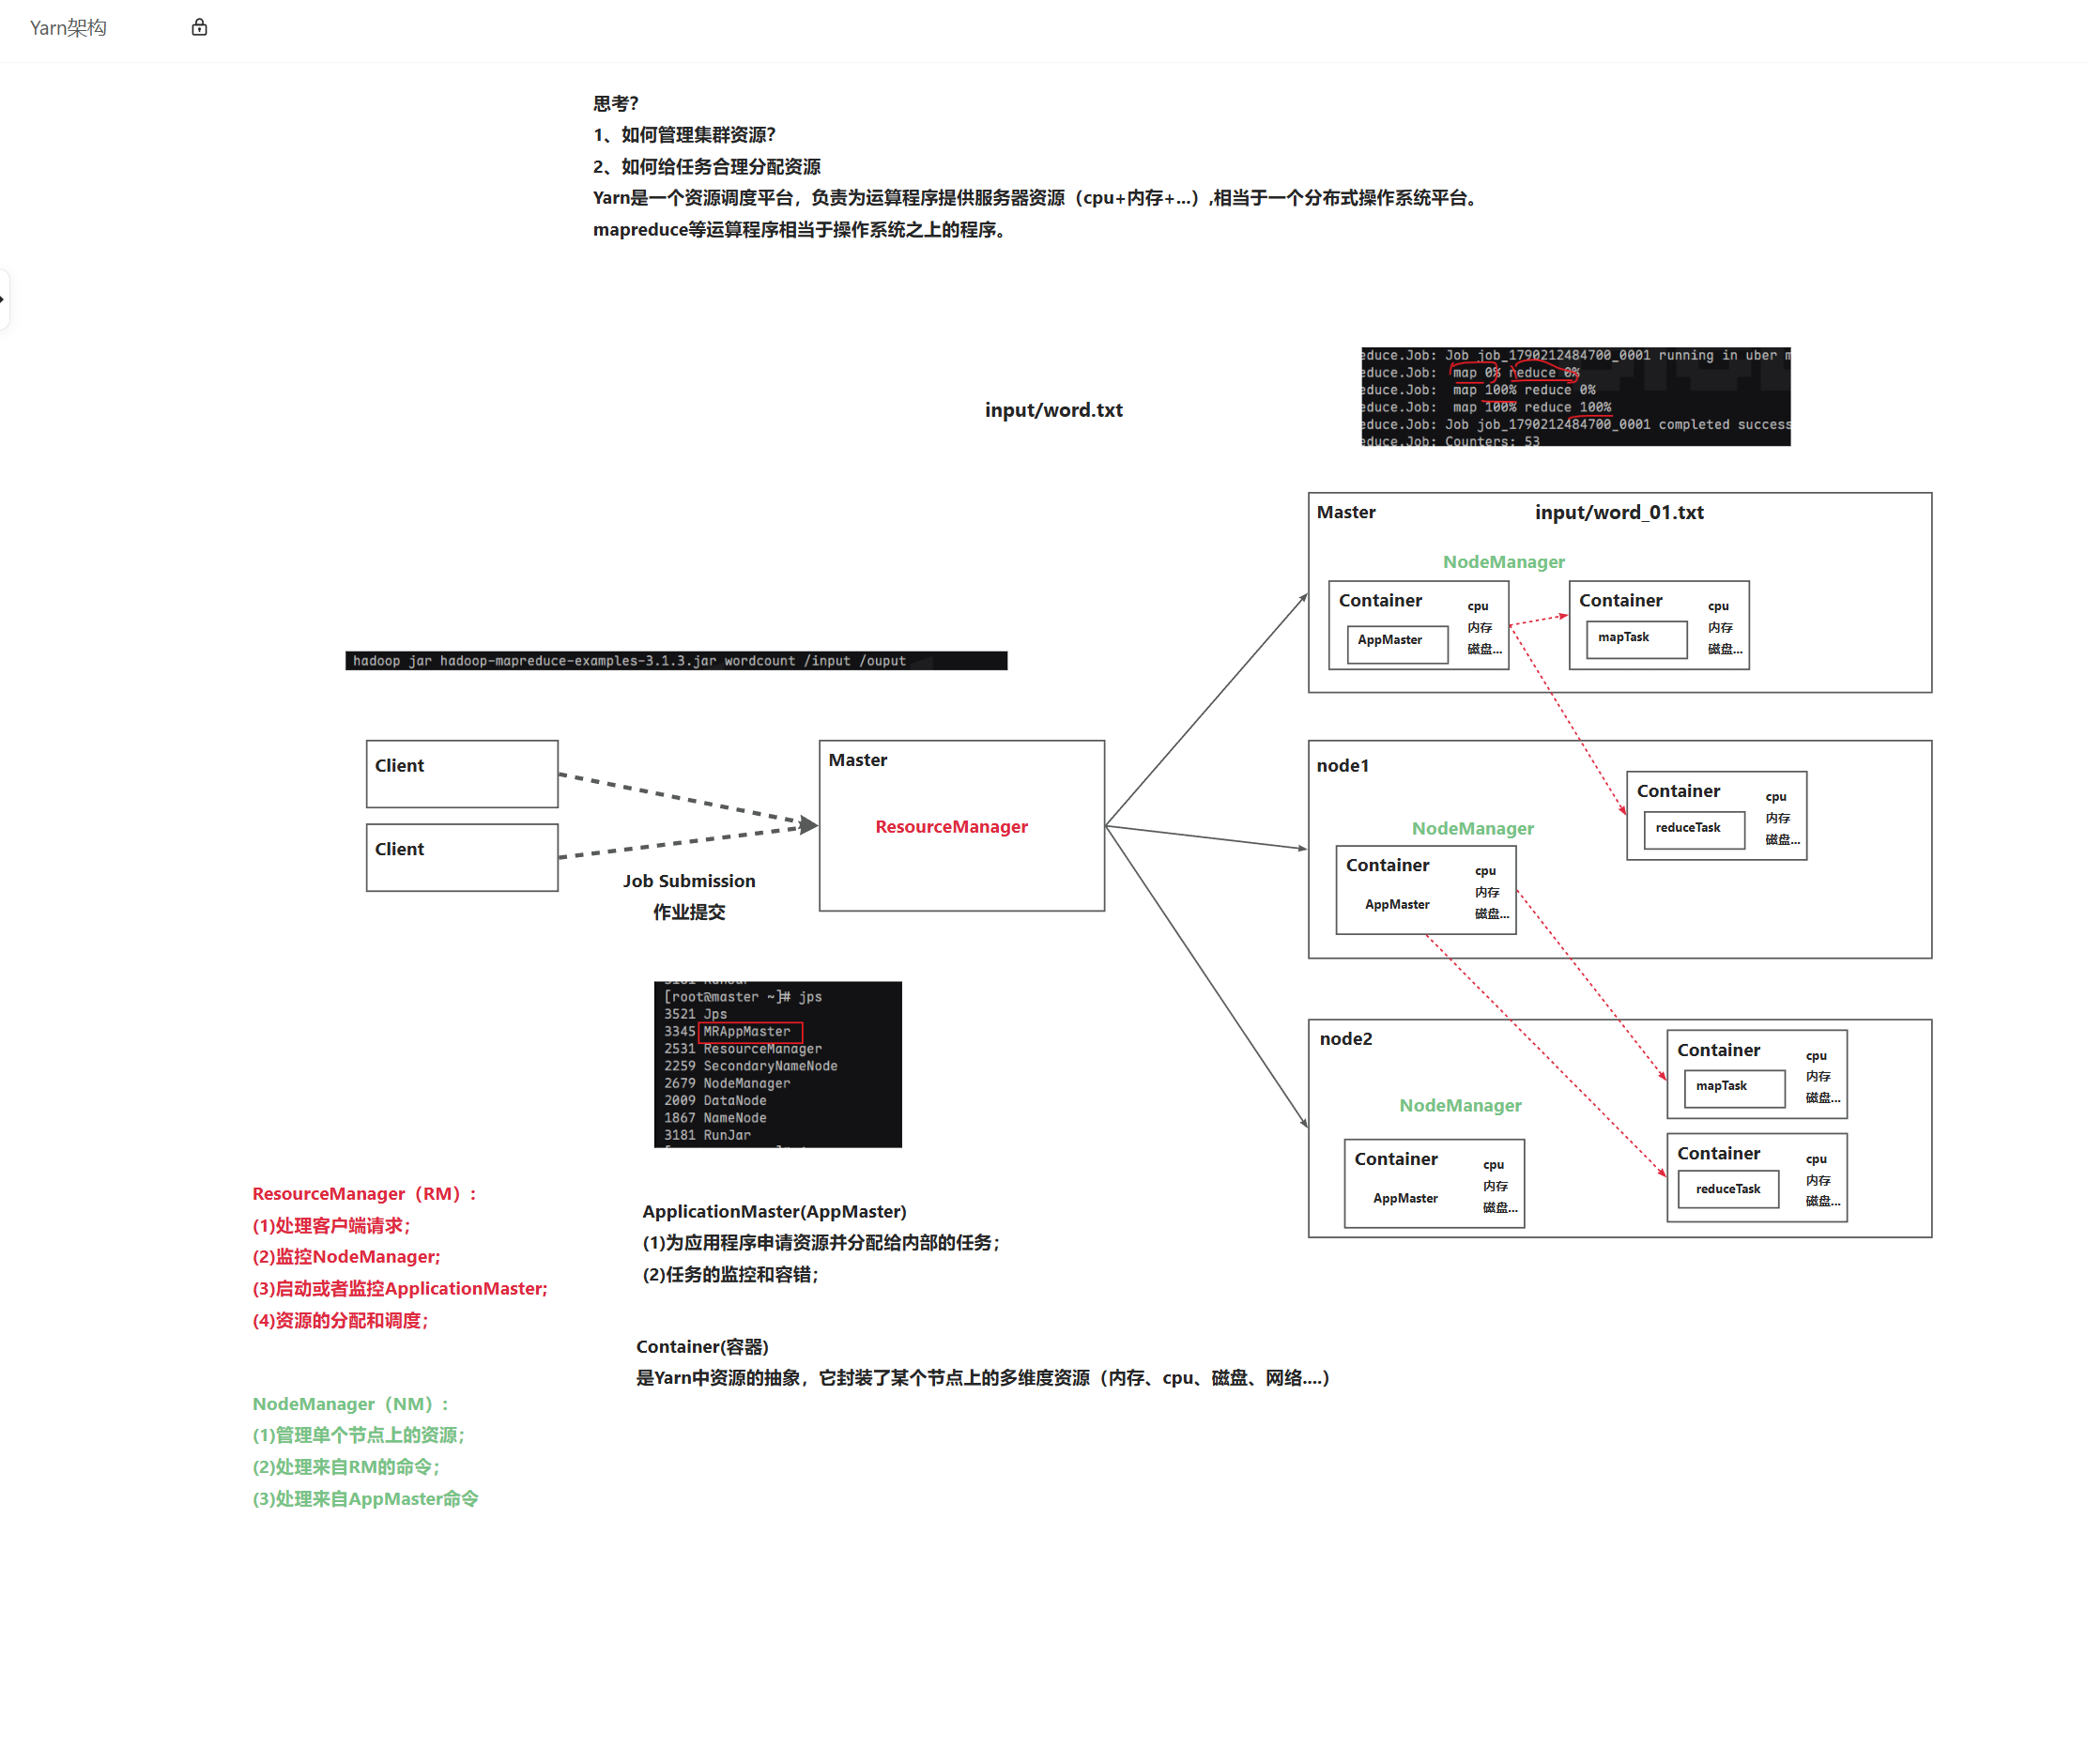
上图展示了一个典型的YARN集群运行场景:
- 客户端提交作业到 ResourceManager(Master)
- RM选择一个 NodeManager 启动 ApplicationMaster
- AM向RM申请资源,RM分配 Container
- AM在各个NM的Container中启动具体的 MapTask / ReduceTask
下面逐个拆解四大组件。
2.1 ResourceManager (RM) —— 集群大管家
RM是整个YARN集群的老大,全局只有一个(HA模式下有Active和Standby两个)。
核心职责:
| 职责 | 说明 |
|---|---|
| 处理客户端请求 | 接收客户端提交的作业 |
| 监控NodeManager | 接收NM的心跳和块报告,感知节点状态 |
| 启动/监控ApplicationMaster | 为每个应用分配第一个Container并启动AM |
| 资源的分配和调度 | 整个集群的资源调度决策核心 |
🏠 通俗理解:RM就像一家公司的CEO,管全局资源分配,但不直接管具体干活的人。
2.2 NodeManager (NM) —— 节点管理者
NM是每个节点上的资源管理者,集群中有多个(每个Slave节点一个)。
核心职责:
| 职责 | 说明 |
|---|---|
| 管理单个节点上的资源 | 监控本节点的CPU、内存、磁盘等资源使用情况 |
| 处理来自RM的命令 | 接收RM的指令,启动/停止Container |
| 处理来自AppMaster的命令 | 响应AM的Container启动请求 |
🏠 通俗理解:NM就像每个部门的经理,管理本部门的人和资源,向CEO汇报。
2.3 ApplicationMaster (AM) —— 应用负责人
每个应用程序(比如一个MapReduce作业)对应一个AM,AM运行在Container中。
核心职责:
| 职责 | 说明 |
|---|---|
| 申请资源 | 为应用程序向RM申请资源(Container) |
| 分配内部任务 | 将申请到的资源分配给内部的Map/Reduce任务 |
| 任务的监控和容错 | 监控任务运行状态,任务失败时重新申请资源重试 |
🏠 通俗理解:AM就像每个项目的项目经理,向CEO申请人力和资源,然后安排具体的开发人员干活。
注意:
- 每个应用有一个AM
- AM也运行在Container中(由NM启动)
- 不同计算框架有不同的AM实现(MRAppMaster、SparkAM等)
2.4 Container —— 资源容器
Container是YARN中资源的抽象,它封装了某个节点上的多维度资源:
- CPU
- 内存
- 磁盘
- 网络
核心特点:
| 特点 | 说明 |
|---|---|
| 动态资源分配 | 每个Container的资源量可以不同,根据应用需求分配 |
| 隔离性 | Container之间资源隔离,互不影响 |
| 生命周期 | 由RM分配,由NM管理,任务完成后释放 |
🏠 通俗理解:Container就像公司分配给项目组的办公室和工位,有大有小,项目结束后收回。
四大组件关系总结
客户端 → ResourceManager(全局调度)
                ↓
         NodeManager(节点管理)
                ↓
          Container(资源容器)
                ↓
     ApplicationMaster / MapTask / ReduceTask(运行任务)
三、YARN工作流程(15步完整解析)
理解了四大组件,我们来看一个MapReduce作业提交到YARN上运行的完整过程。下面这张图展示了全部15个步骤:
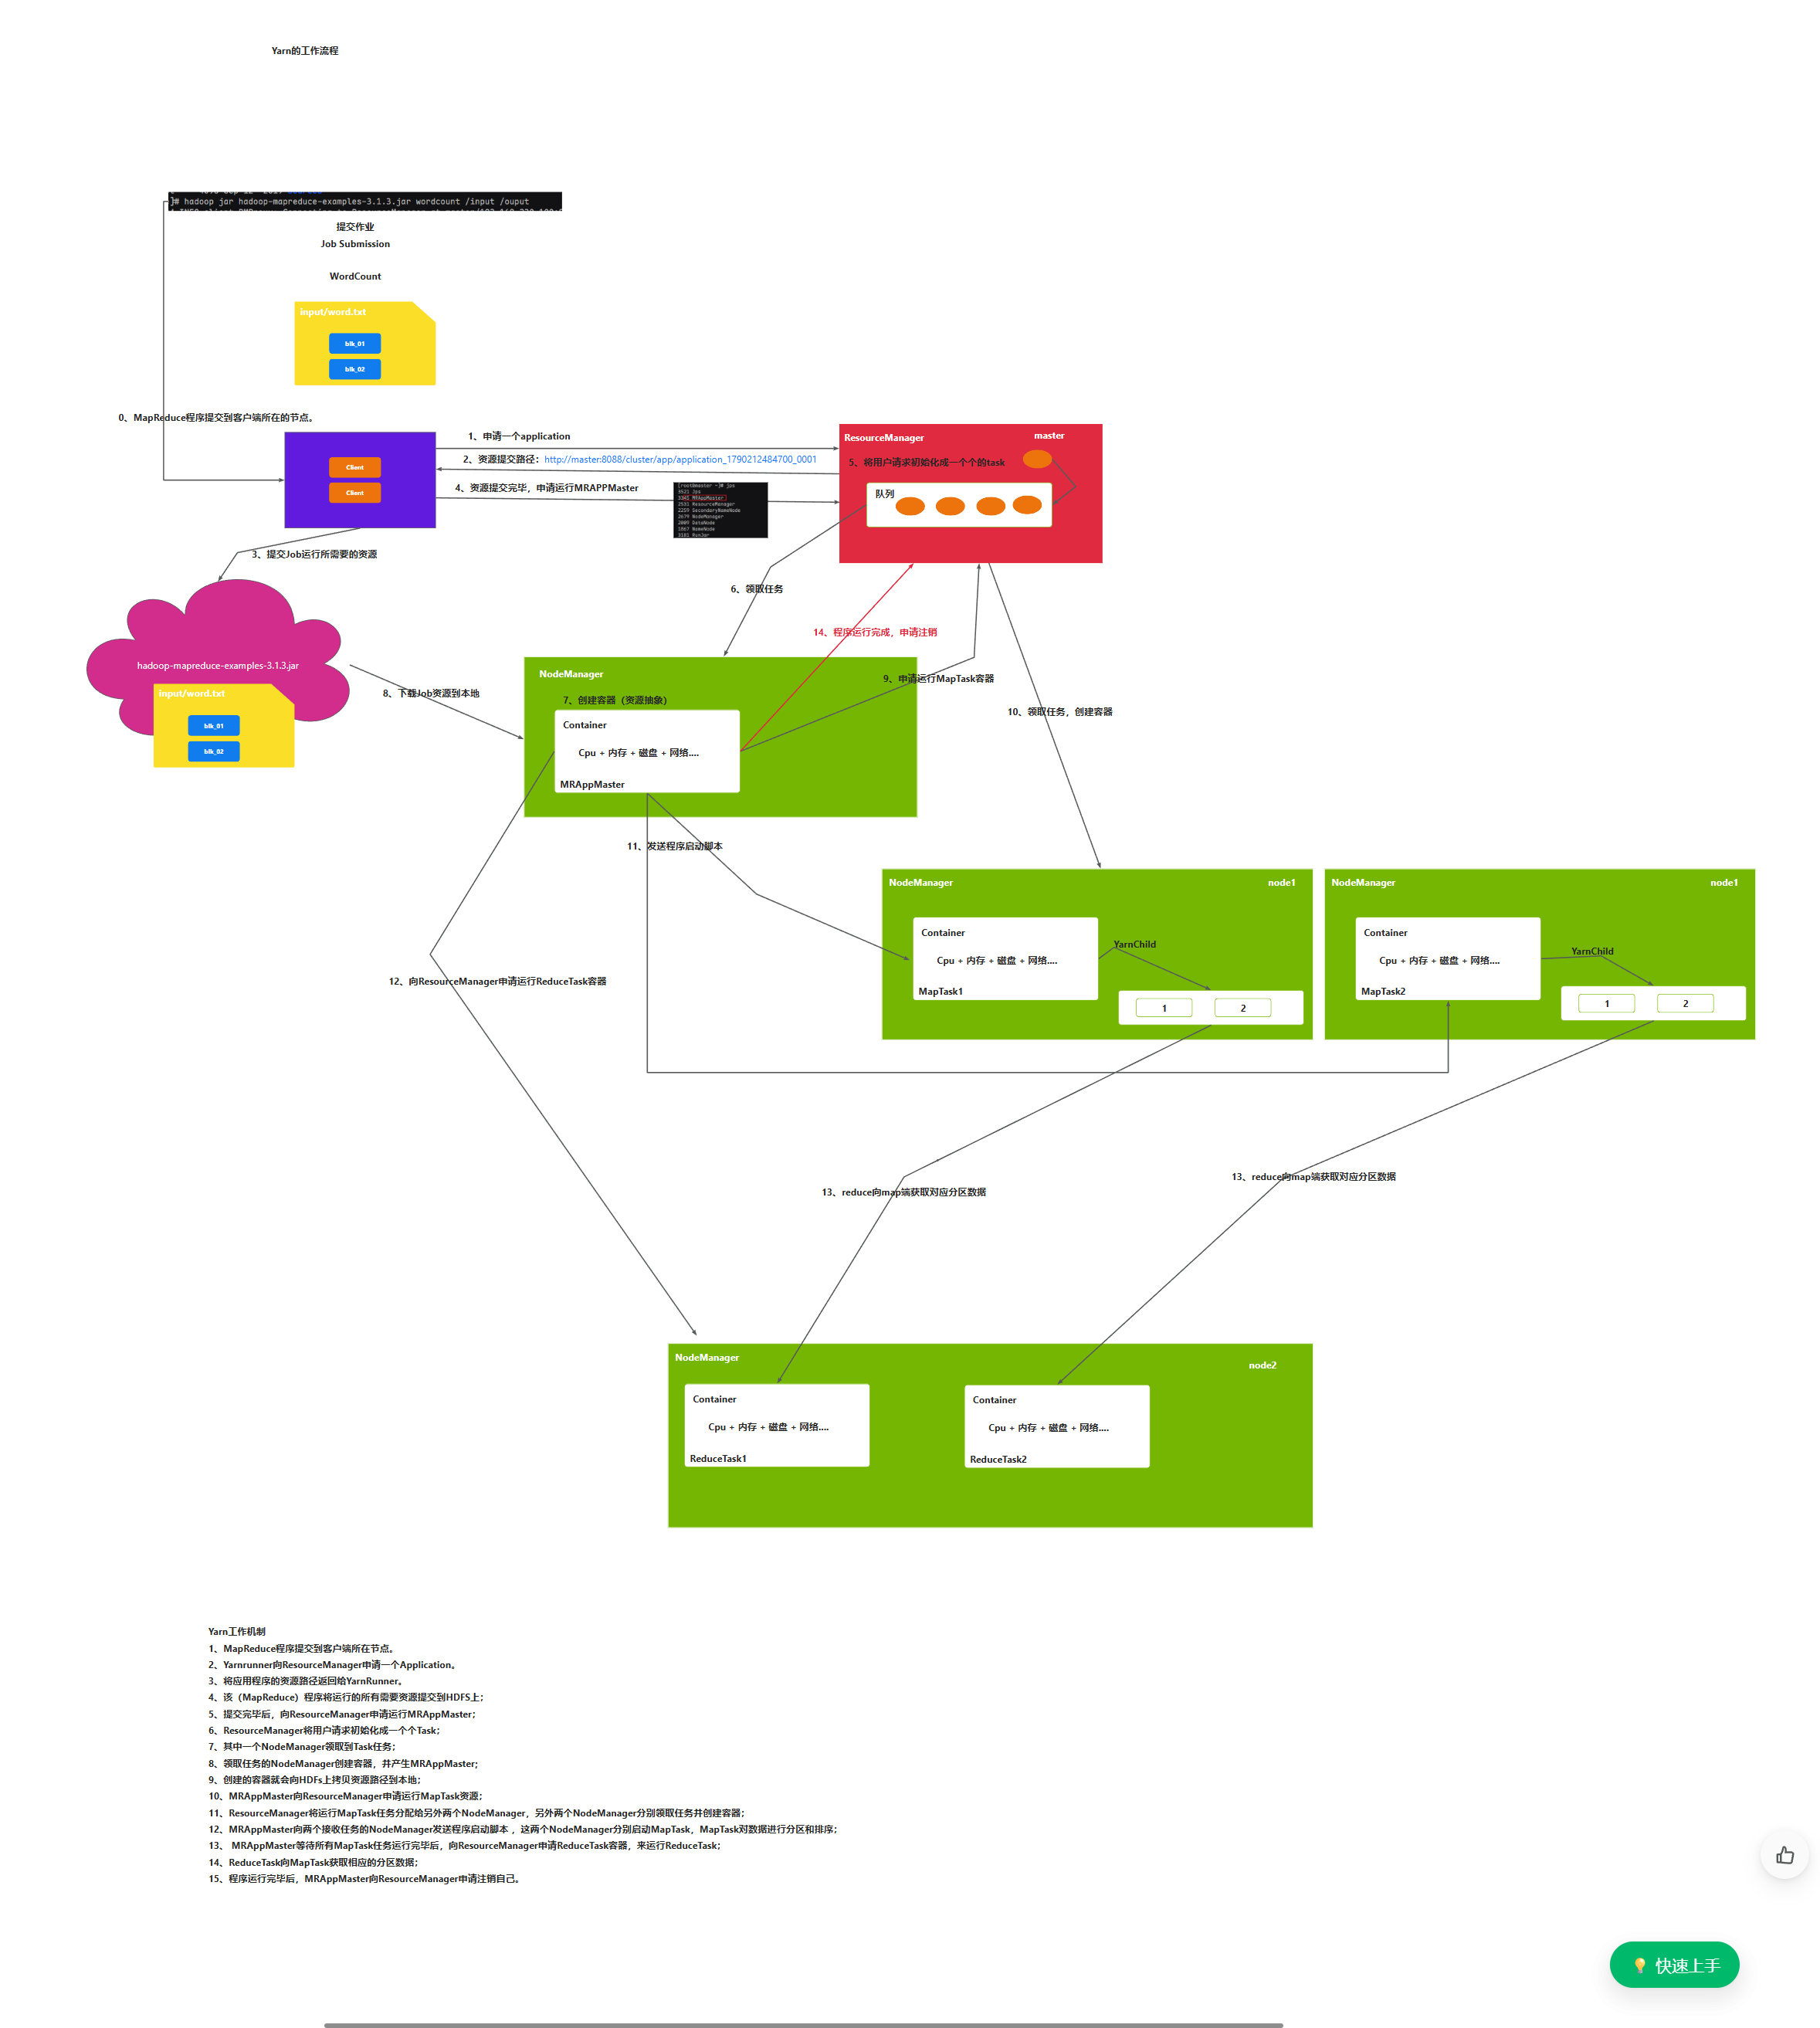
3.1 流程图总览
整个流程可以分为 三个阶段:
| 阶段 | 步骤 | 核心动作 |
|---|---|---|
| 作业提交 | 1~5步 | 客户端提交作业 → RM接收 → 分配第一个Container启动AM |
| 任务分配 | 6~12步 | AM向RM申请Map/Reduce资源 → RM分配Container |
| 任务执行与收尾 | 13~15步 | 任务执行 → Reduce拉取数据 → 完成注销 |
3.2 逐步详解
第1步:申请Application
- 客户端向ResourceManager申请一个Application ID
第2步:资源提交描述
- 客户端向RM提交作业资源描述(ApplicationSubmissionContext)
- 包含:作业名称、优先级、队列、所需资源、AM启动命令等
第3步:返回ApplicationId
- RM返回ApplicationId给客户端
第4步:资源提交(上传到HDFS)
- 客户端将运行程序所需的资源(jar包、配置文件、输入分片信息等)上传到HDFS
第5步:提交作业
- 客户端正式向RM提交作业
第6步:RM调度任务
- RM将作业加入调度队列
- 调度器(Scheduler)根据调度策略选择一个NodeManager
第7步:NM启动Container(资源隔离)
- NM在指定节点上启动一个Container
- 这个Container用于运行 ApplicationMaster
第8步:下载Job资源到本地
- AM启动后,从HDFS下载作业资源(jar包、配置等)到本地
第9步:向RM申请MapTask资源
- AM根据输入分片数量,向RM申请MapTask所需的Container资源
第10步:RM分配MapTask容器
- RM为MapTask分配Container,返回给AM
第11步:AM通知NM启动MapTask
- AM向对应的NodeManager发送启动MapTask的请求
- NM启动Container中的MapTask
第12步:向RM申请ReduceTask资源
- MapTask运行到一定程度后,AM向RM申请ReduceTask资源
第13步:Reduce端shuffle获取到分区数据
- ReduceTask启动后,通过Shuffle从各个MapTask拉取自己分区的数据
第14步:程序运行完成,申请注销
- 所有任务运行完成后,AM向RM申请注销自己
第15步:程序运行完毕后,MRAppMaster向ResourceManager申请注销自己
- RM回收资源,作业结束
💡 面试小技巧:回答YARN工作流程时,可以用"一提交、二启动AM、三申请资源、四运行任务、五注销"的思路来组织答案。
四、YARN三种调度器深度对比
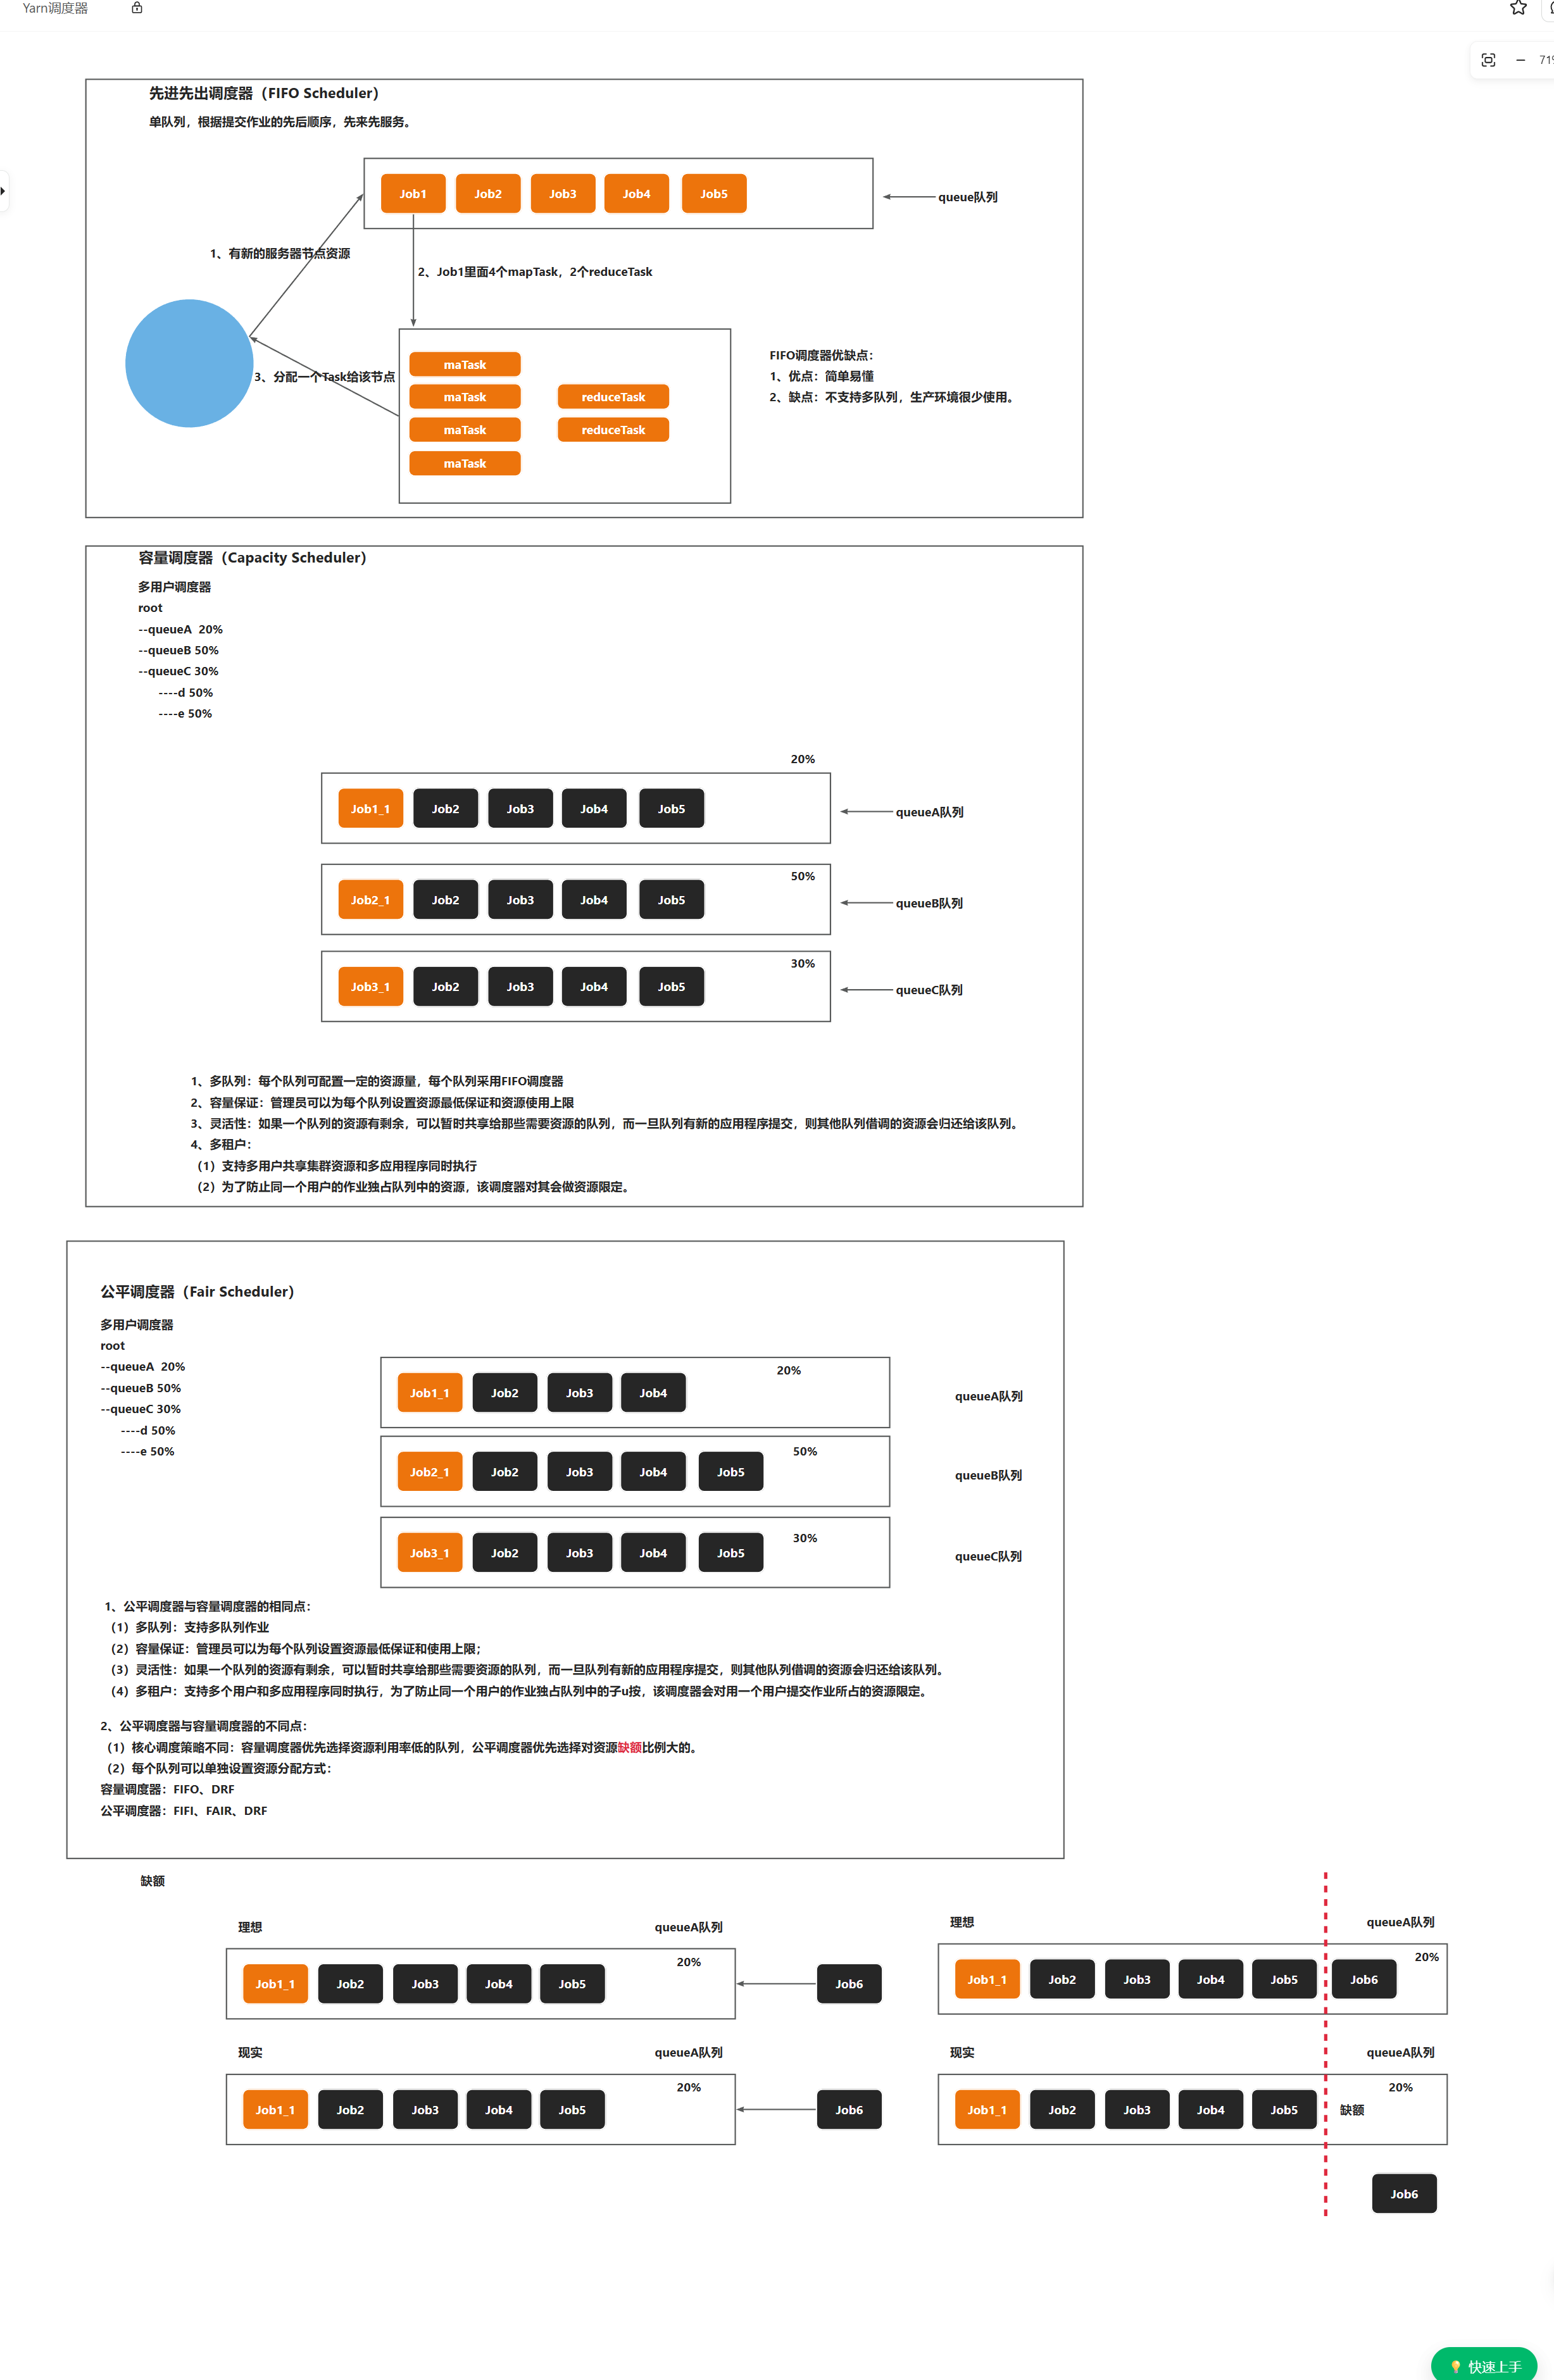
YARN的资源调度是由**调度器(Scheduler)**负责的。YARN提供了三种调度器实现,下面这张图完整展示了三种调度器的工作原理:
4.1 FIFO Scheduler(先进先出调度器)
调度策略:单队列,根据提交作业的先后顺序,先来先服务。
工作原理:
- 所有作业提交到同一个队列
- 按提交顺序排队,先到的作业先分配资源
- 只有前面的作业资源满足了,后面的作业才能运行
优缺点:
| 优点 | 缺点 |
|---|---|
| 简单易懂,实现简单 | 不支持多队列,大任务会阻塞小任务 |
| 生产环境很少使用 |
📌 适用场景:单用户、小集群、测试环境
4.2 Capacity Scheduler(容量调度器)
调度策略:多用户多队列,每个队列配置一定的资源容量,队列内部采用FIFO调度。
核心特点:
| 特点 | 说明 |
|---|---|
| 多队列 | 每个队列可配置一定的资源量,队列内部FIFO |
| 容量保证 | 可为每个队列设置资源最低保证和资源使用上限 |
| 灵活性 | 队列资源有剩余时,可暂时共享给需要资源的队列;一旦本队列有新任务,其他队列释放资源后归还给该队列 |
| 多租户 | 支持多用户共享集群,每个用户的作业独立队列 |
队列结构示例:
root
├── queueA  20%
├── queueB  50%
├── queueC  30%
└── default 50% (剩余资源)
📌 适用场景:企业生产环境最常用,适合有明确SLA要求、多团队共享集群的场景
4.3 Fair Scheduler(公平调度器)
调度策略:多用户多队列,按权重公平分配资源,同一队列内所有作业公平共享资源。
核心特点:
| 特点 | 说明 |
|---|---|
| 公平分配 | 所有作业公平共享资源,短任务不会饿死 |
| 多队列 | 支持多队列,队列之间按权重分配 |
| 资源抢占 | 队列资源不足时,可以从资源过剩的队列抢占资源 |
| 负载均衡 | 自动平衡各队列的资源使用 |
Capacity和Fair的相同点
- 都是多队列调度器
- 都支持容量保证(最低资源保障)
- 都支持资源共享(队列空闲资源可借给其他队列)
- 都支持多租户
Capacity和Fair的核心区别
| 对比维度 | Capacity Scheduler | Fair Scheduler |
|---|---|---|
| 调度策略 | 按队列容量比例分配,队列内FIFO | 按公平策略分配,队列内也公平 |
| 队列内调度 | FIFO(可配置优先级) | Fair / FIFO / DRF(可选) |
| 资源抢占 | 不支持(或有限支持) | 支持 |
| 适用场景 | 生产环境稳定运行,SLA明确 | 研发团队共享,追求公平性 |
🔥 面试高频题:Capacity和Fair调度器的区别?
- 核心区别:Capacity按容量分配,队列内FIFO;Fair按公平策略分配,队列内也公平共享
- Capacity更稳定可预测,Fair更灵活公平
4.4 三种调度器对比总结
| 对比维度 | FIFO | Capacity | Fair |
|---|---|---|---|
| 队列数 | 单队列 | 多队列 | 多队列 |
| 调度策略 | 先进先出 | 容量比例 + FIFO | 公平分配 |
| 多用户支持 | ❌ | ✅ | ✅ |
| 资源抢占 | ❌ | ❌ | ✅ |
| 小任务等待时间 | 长(可能被大任务阻塞) | 中(有队列隔离) | 短(公平分配) |
| 生产环境常用 | ❌ | ✅(最常用) | ✅ |
| 默认调度器 | ✅(YARN默认) | ❌ | ❌ |
💡 生产环境怎么选?
- 大多数公司用 Capacity Scheduler,因为稳定可预测,适合按团队划分队列
- 研发氛围浓厚、追求公平的团队可以用 Fair Scheduler
五、YARN常用运维命令
5.1 查看Application
# 列出所有Application
yarn application -list

# 按状态过滤(ALL/NEW/SUBMITTED/ACCEPTED/RUNNING/FINISHED/FAILED/KILLED)
yarn application -list -appStates RUNNING
yarn application -list -appStates FAILED

# 查看某个Application的状态
yarn application -status <applicationId>

# 杀死某个Application
yarn application -kill <applicationId>
5.2 查看日志
# 查询整个Application的日志
yarn logs -applicationId <applicationId>

# 查询某个Container的日志
yarn logs -applicationId <applicationId> -containerId <containerId>

# 查询某个ApplicationAttempt的日志
yarn logs -applicationId <applicationId> -appAttemptId <appAttemptId>
5.3 查看节点和队列
# 列出所有节点
yarn node -list -all

# 查看某个节点的状态
yarn node -status <nodeId>

# 查看队列状态
yarn queue -status <队列名称>

# 刷新队列配置(无需重启YARN)
yarn rmadmin -refreshQueues
5.4 Container和ApplicationAttempt
# 列出某个Application的所有attempt
yarn applicationattempt -list <applicationId>

# 查看某个attempt的状态
yarn applicationattempt -status <appAttemptId>

# 列出某个attempt下的所有Container
yarn container -list <appAttemptId>

# 查看某个Container的状态
yarn container -status <containerId>
六、高频面试题汇总
基础概念
Q1:YARN是什么?有什么作用?
YARN是Hadoop 2.0引入的分布式资源调度框架,负责集群资源的统一管理和调度。作用是将资源管理和计算框架解耦,支持多种计算框架运行在同一个集群上。
Q2:YARN的四大组件是什么?各自的作用?
- ResourceManager:全局资源管理,负责集群资源分配和调度
- NodeManager:节点资源管理,负责本节点的Container管理
- ApplicationMaster:每个应用的管理者,负责向RM申请资源、监控任务
- Container:资源抽象,封装CPU、内存等资源
Q3:Container是什么?和进程有什么区别?
Container是YARN的资源分配单位,封装了CPU、内存等资源。Container是逻辑概念,进程是实际运行的程序。一个Container中可以运行一个或多个进程。
工作流程
Q4:YARN的工作流程是怎样的?
- 客户端提交作业到RM
- RM选择一个NM启动AM(在Container中)
- AM向RM申请资源
- RM分配Container,AM在Container中启动任务
- 任务运行完成,AM向RM注销
Q5:ApplicationMaster的作用是什么?
- 向RM申请资源(Container)
- 与NM通信,启动/停止Container中的任务
- 监控任务运行状态,任务失败时重试
- 任务完成后向RM注销
调度器
Q6:YARN有哪三种调度器?区别是什么?
- FIFO:先进先出,单队列,简单但不适合共享集群
- Capacity:容量调度,多队列按容量分配,生产最常用
- Fair:公平调度,多队列按公平策略分配,支持资源抢占
Q7:Capacity和Fair调度器的区别?
- 核心调度策略不同:Capacity按容量比例,Fair按公平策略
- 队列内调度不同:Capacity是FIFO,Fair可以配置Fair/FIFO/DRF
- Fair支持资源抢占,Capacity不支持
- Capacity更稳定可预测,Fair更灵活公平
Q8:为什么FIFO调度器不适合生产环境?
因为FIFO是单队列,大任务会占用所有资源,导致后面的小任务长时间等待,无法满足多用户共享集群的需求。
调优与排障
Q9:Container被杀死的原因有哪些?
- 内存超限:物理内存或虚拟内存超过Container配置的上限
- 节点故障:NodeManager挂掉或失联
- 任务超时:任务运行时间超过设置的超时时间
- 资源抢占:被更高优先级的任务抢占资源
Q10:YARN的Web UI端口是多少?能看到什么?
默认端口是 8088。可以查看所有Application的状态、节点列表、队列状态、调度器信息等。
七、总结
本文系统梳理了YARN的核心知识,从架构到流程再到调度器,最后附上常用命令和面试题。
📌 核心知识速记
| 模块 | 核心要点 |
|---|---|
| YARN定位 | 分布式资源调度平台,操作系统级别的存在 |
| 四大组件 | RM(全局调度)+ NM(节点管理)+ AM(应用管理)+ Container(资源容器) |
| 工作流程 | 提交作业 → 启动AM → 申请资源 → 运行任务 → 注销(15步) |
| 三种调度器 | FIFO(简单少用)、Capacity(生产最常用)、Fair(公平灵活) |
| 生产推荐 | Capacity Scheduler |
🔥 面试必背:四大组件职责、工作流程、三种调度器对比,这三个是最高频考点!
转载自 CSDN-专业IT技术社区
原文链接:https://blog.csdn.net/2301_80420058/article/details/167587655

