

问知识库:「我们的数据保留政策最长多久?」
模型回答:「根据公司政策,客户数据最长保留 24 个月。」——听起来合理
但问题来了:这个 24 个月是从哪份文件里找到的?对应哪一条政策?如果点开引用,发现根本不是这份文件怎么办?
给 AI 回答加上 [1]、[2] 并不难,难的是保证这些编号真的对应检索到的证据。
在有谷大脑的 Agent 问答链路中,我们没有让模型自由编写脚注,而是设计了一套结构化引用机制:
工具检索 → citation_sources → 模型标注 → 前端定位原文。
它要解决的不是让回答看起来更可信,而是让每一条重要结论都能被核对。
一、为什么不能让模型自己生成引用?
假设知识库检索返回三份材料:
[1]数据保留政策 v3[2]客户服务协议[3]数据安全管理规范
模型生成回答时,可能写出:
“客户数据最长保留 24 个月 [1]。”
但如果模型只是根据上下文生成编号,没有明确的来源映射,就可能出现几个问题:
- 引用
[1],实际依据却来自文档[2]。 - 引用了已经失效的历史版本。
- 检索结果只有三份,模型却生成了
[4]。 - 回答看似正确,但无法定位到原文。
引用编号本身不是证据,编号与真实来源之间的映射关系才是关键。
因此,我们把检索结果拆成两部分。
第一部分:提供给模型的证据文本。
包括文档标题、documentId、正文片段及引用标记,帮助模型理解材料来自哪里。
第二部分:提供给系统和前端的结构化引用数据。
通过 citation_sources 保存每条来源的信息,例如:
{
  "index": 1,
  "type": "kb",
  "documentId": "abc-123",
  "title": "数据保留政策 v3",
  "snippet": "客户数据保留期限……"
}
其中:
index:引用编号。type:来源类型,例如知识库或网页。documentId:对应的知识库文档。title:文档标题。snippet:检索命中的证据片段。
模型负责组织答案,引用数据则由检索链路提供。
这样,前端就有了明确的来源映射,而不是只能相信模型生成的脚注。
二、从检索到点击原文,引用是怎么传递的?
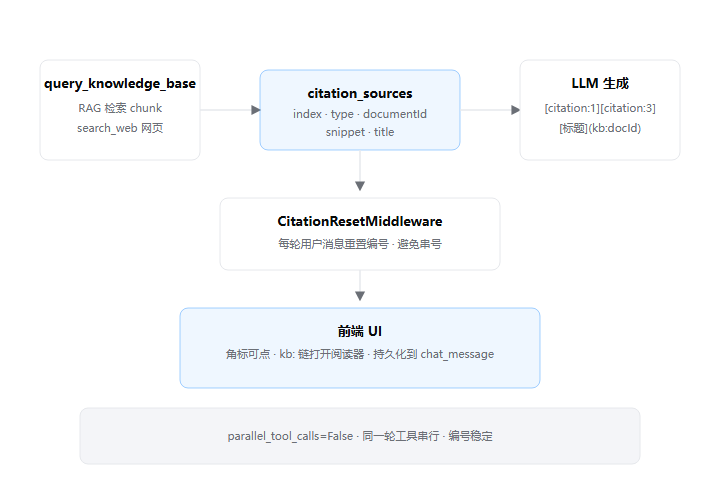
图 1:Agent 引用链架构——从知识库检索到前端来源定位
整个过程可以拆成四步。
第一步:检索知识库。
Agent 调用 query_knowledge_base,从 RAG 服务获取相关 chunk。
第二步:构造引用来源。
后端将检索结果整理成 citation_sources,为来源分配编号,同时向模型提供带有边界标记的证据文本。
例如:
[kb 1 begin]
documentId: abc-123
title: 数据保留政策 v3
cite: [数据保留政策 v3](kb:abc-123)

客户数据保留期限……
[kb 1 end]
这里的 [kb 1 begin] 和 [kb 1 end] 用于标识证据块边界,减少不同材料之间的混淆。
第三步:模型生成带引用的回答。
模型根据检索结果组织答案,并按约定格式标注:
根据数据保留政策,客户数据最长保留
24 个月。[citation:1]
这里的 [citation:1] 对应 citation_sources 中编号为 1 的来源。
第四步:前端解析引用。
前端根据编号找到对应的 citation_sources,展示来源信息。
对于知识库文档,系统还可以解析:
[数据保留政策 v3](kb:abc-123)
将 kb: 协议转换为站内文档路由,打开阅读器并定位相关内容。
这样,用户看到的不只是一个引用编号,而是一条可以追溯到原始文档的证据链。
不过,引用能够打开原文,并不自动证明模型的结论正确。还需要检查引用片段是否真正支持对应的回答。
三、两个工具同时检索,为什么引用会串号?
这是多工具 Agent 容易遇到的一个问题。
假设同一轮回答需要同时查询:
query_knowledge_base:企业内部知识库。search_web:外部网页信息。
如果两个工具独立编号,就可能出现:
知识库:
[1] 数据保留政策
[2] 客户服务协议

网页:
[1] 行业报告
[2] 监管政策
此时,模型输出 [citation:2],前端究竟应该打开客户服务协议,还是监管政策?
问题不在于检索结果是否正确,而在于引用编号缺少统一管理。
在当前实现中,我们采用:
parallel_tool_calls = False
让同一轮中的工具调用串行执行,并在共享状态中累加 citation_sources,统一分配递增编号。
例如:
[1] 数据保留政策
[2] 客户服务协议
[3] 行业报告
[4] 监管政策
这样,不同来源使用同一套编号空间,避免两个工具各自从 1 开始导致冲突。
需要注意的是,串行执行只是当前采用的一种实现方式,并不是解决编号冲突的唯一方法。
如果在并行调用后增加统一的引用收集与重编号机制,同样可以实现稳定映射。
另外,编号还需要解决跨轮次污染。
为此,CitationResetMiddleware 会在新用户消息开始时重置本轮的 citation_sources 和 tools_used。
这样,新一轮问答可以重新从 [citation:1] 开始,不会意外继承上一轮的来源编号。
四、为什么引用信息还要保存到数据库?
如果引用只存在于 Agent 的运行状态中,当前回答结束后可能还能正常显示,但历史对话就会出现问题。
例如,用户第二天打开昨天的聊天记录:
回答中仍然有 [citation:1],但对应的来源列表已经不存在。
结果就是:回答保留了,证据却丢了。
因此,引用信息需要和消息一起持久化。
在这套链路中,citation_sources 会保存到 chat_message,使历史回答仍能恢复引用列表。
流式回答时,引用状态通过 AG-UI 的 State 事件同步到前端;回答结束后,再保存最终的引用数据。
如果用户重新生成回答,工具可能检索到不同结果,因此需要用新一轮的引用列表替换原有映射,而不是继续沿用旧编号。
这里还有一个容易忽略的边界:
保存引用元数据,不等于永久保存证据本身。
如果原始文档后来被删除、修改或者用户失去了访问权限,历史引用仍可能无法打开。
因此,实际系统还需要结合文档版本、权限校验和失效处理策略,保证历史引用的行为符合业务要求。
五、知识库、网页和图片,能共用一套引用机制吗?
可以统一管理引用,但不同来源的打开方式并不相同。
| 来源 | 检索工具 | 引用方式 |
|---|---|---|
| 知识库文档 | query_knowledge_base | documentId + kb: 链接 |
| 外部网页 | search_web | URL + citation 编号 |
| 图片或图表 | recommend_assets | 资源地址 + citation 编号 |
例如,用户询问最新行业数据时,Agent 可以通过 search_web 获取网页来源。
如果用户问“有没有相关架构图”,则可以使用 recommend_assets 检索知识库中的图片资源。
这些工具返回的数据类型不同,但可以通过统一的 citation_sources 结构管理来源。
同样的思路也适用于 MCP 接入场景:外部 Host 可以使用统一的证据格式,而不必让每个客户端重新设计一套引用规则。
统一的是来源标识和证据结构,而不是强迫所有来源使用同一种展示方式。
六、有引用,也不代表回答一定可靠
引用链解决的是来源追踪问题,但不能代替对答案质量的判断。
实际应用中,还可能遇到四种情况。
| 问题 | 可能原因 | 处理思路 |
|---|---|---|
| 回答正确,但没有出处 | 模型没有输出 citation | 明确引用格式要求,检查引用覆盖情况 |
| 引用指向错误文档 | 编号冲突或映射错误 | 统一编号、校验来源 ID |
| 引用存在,但不支持结论 | 检索片段不相关或模型过度推断 | 检查证据与结论的一致性 |
| 找不到证据却给出确定答案 | 模型忽略证据不足的情况 | 明确证据不足时的回答策略 |
其中,第三种尤其值得注意。
例如,原文只写了“部分客户数据保留 24 个月”,模型却回答“所有客户数据最长保留 24 个月”。
即使引用编号完全正确,回答依然可能存在问题。
因此,可追溯只是第一步,引用是否真正支持结论,才是更高层次的可靠性要求。
这也意味着,RAG 的检索质量、文档切块策略和引用机制需要配合设计。
检索负责找到可能相关的证据,引用机制负责建立可追溯关系,而模型还需要正确理解证据的适用范围。
写在最后
在有谷大脑的 Agent 问答实践中,引用不是简单地给回答添加几个 [1]、[2]。
它涉及检索结果结构化、跨工具编号管理、模型标注、前端路由解析,以及历史消息持久化。
让 AI 给出答案并不难,难的是让用户能够检查答案从哪里来、依据是什么。
对于企业知识库来说,真正有价值的不只是“回答得像专家”,而是当用户对某个结论产生疑问时,能够沿着引用回到原始资料进行核对。
这也是结构化引用链存在的意义。
如果想进一步了解这些能力在产品里的实际应用,可以体验:
了解更多:https://brain.yogu.pro
转载自 CSDN-专业IT技术社区
原文链接:https://blog.csdn.net/2401_88623943/article/details/167670101

