

Linux动静态库详解:从代码封装到静态库.a、动态库.so的制作、链接与使用
文章目录
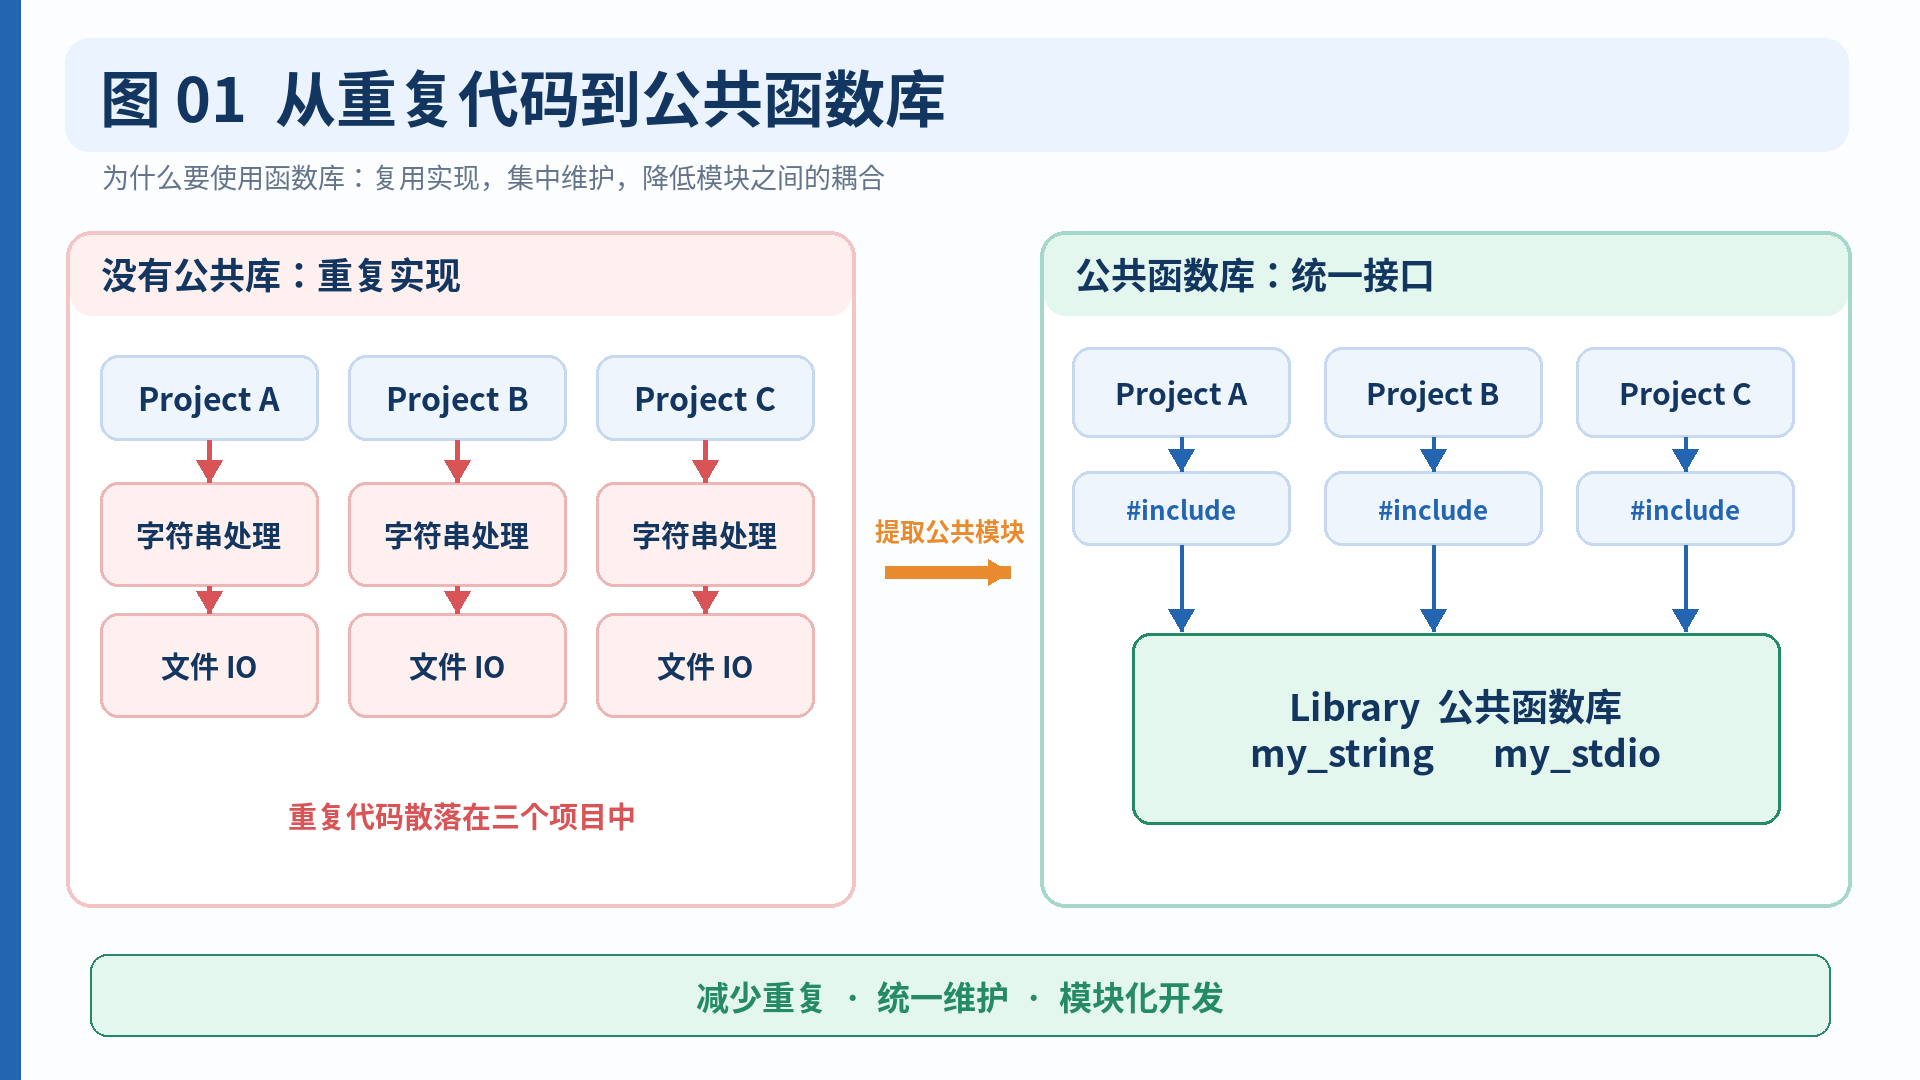
前言:为什么需要库?
在前面的 Linux 学习中,我们已经实现过一些独立程序,例如 MiniShell,以及对 open()、read()、write() 等系统调用的简单封装。
但假设现在有三个项目,都需要使用我们自己编写的字符串处理函数:
size_t my_strlen(const char* str);
最直接的办法当然是把对应源码复制到三个项目中。
但这种方式存在明显的问题:
- 代码重复。 不同项目保存了相同功能的实现。
- 维护困难。 修复一个 Bug 后,需要同步修改所有项目。
- 模块化程度低。 使用者需要关心功能的具体实现。
- 不方便交付。 我们可能只想提供功能接口,不想提供全部源代码。
因此,我们需要一种机制,将已经完成的功能封装起来,让其他程序直接使用。
这就是库(Library)。
本篇主要解决以下问题:
- 什么是库?静态库与动态库有哪些区别?
- 如何从
.c文件生成.o目标文件? - 如何使用
ar制作静态库.a? - 如何使用
-fPIC和-shared制作动态库.so? - 如何使用
-I、-L和-l链接自己的库? - 为什么链接成功以后,程序运行时仍然可能找不到动态库?
- 如何借助 Makefile 完成自动化构建和打包?
我们将沿用前面基础 IO 学习中的 my_stdio 思路,并增加一个 my_string 模块,完成从源码到库的完整实践。
一、什么是库?
1.1 库的基本概念
库可以理解为:
将一组已经实现、能够复用的代码组织起来,供其他程序在构建或运行时使用。
例如,平时在 C 语言中调用:
printf("hello world\n");
我们并没有自己实现 printf()。
类似地:
strlen("hello");
也不需要重新编写字符串长度计算逻辑。
这些功能通常由 C 标准库的实现提供。
C++ 中常用的:
std::vector
std::string
std::cout
也依赖相应的头文件及标准库实现;其中一些功能在编译期间通过模板或内联代码生成,另一些功能则通过链接库提供。
所以库的意义就是:
把通用功能从具体业务程序中抽离,实现代码复用和模块化开发。
1.2 Linux中常见的两种库
Linux 下最常见的是:
| 类型 | 常见扩展名 | 作用 |
|---|---|---|
| 静态库 | .a | 在静态链接时提取需要的目标代码,加入最终链接产物 |
| 动态库 | .so | 以共享对象形式参与动态链接,并在运行期间映射到进程地址空间 |
Windows 下也有类似的机制:
静态库:.lib
动态库:.dll
但 Windows 的 .lib 还可能是供 DLL 链接使用的导入库,不能仅凭扩展名认定其一定包含静态实现代码。
1.3 静态库与动态库最直观的区别
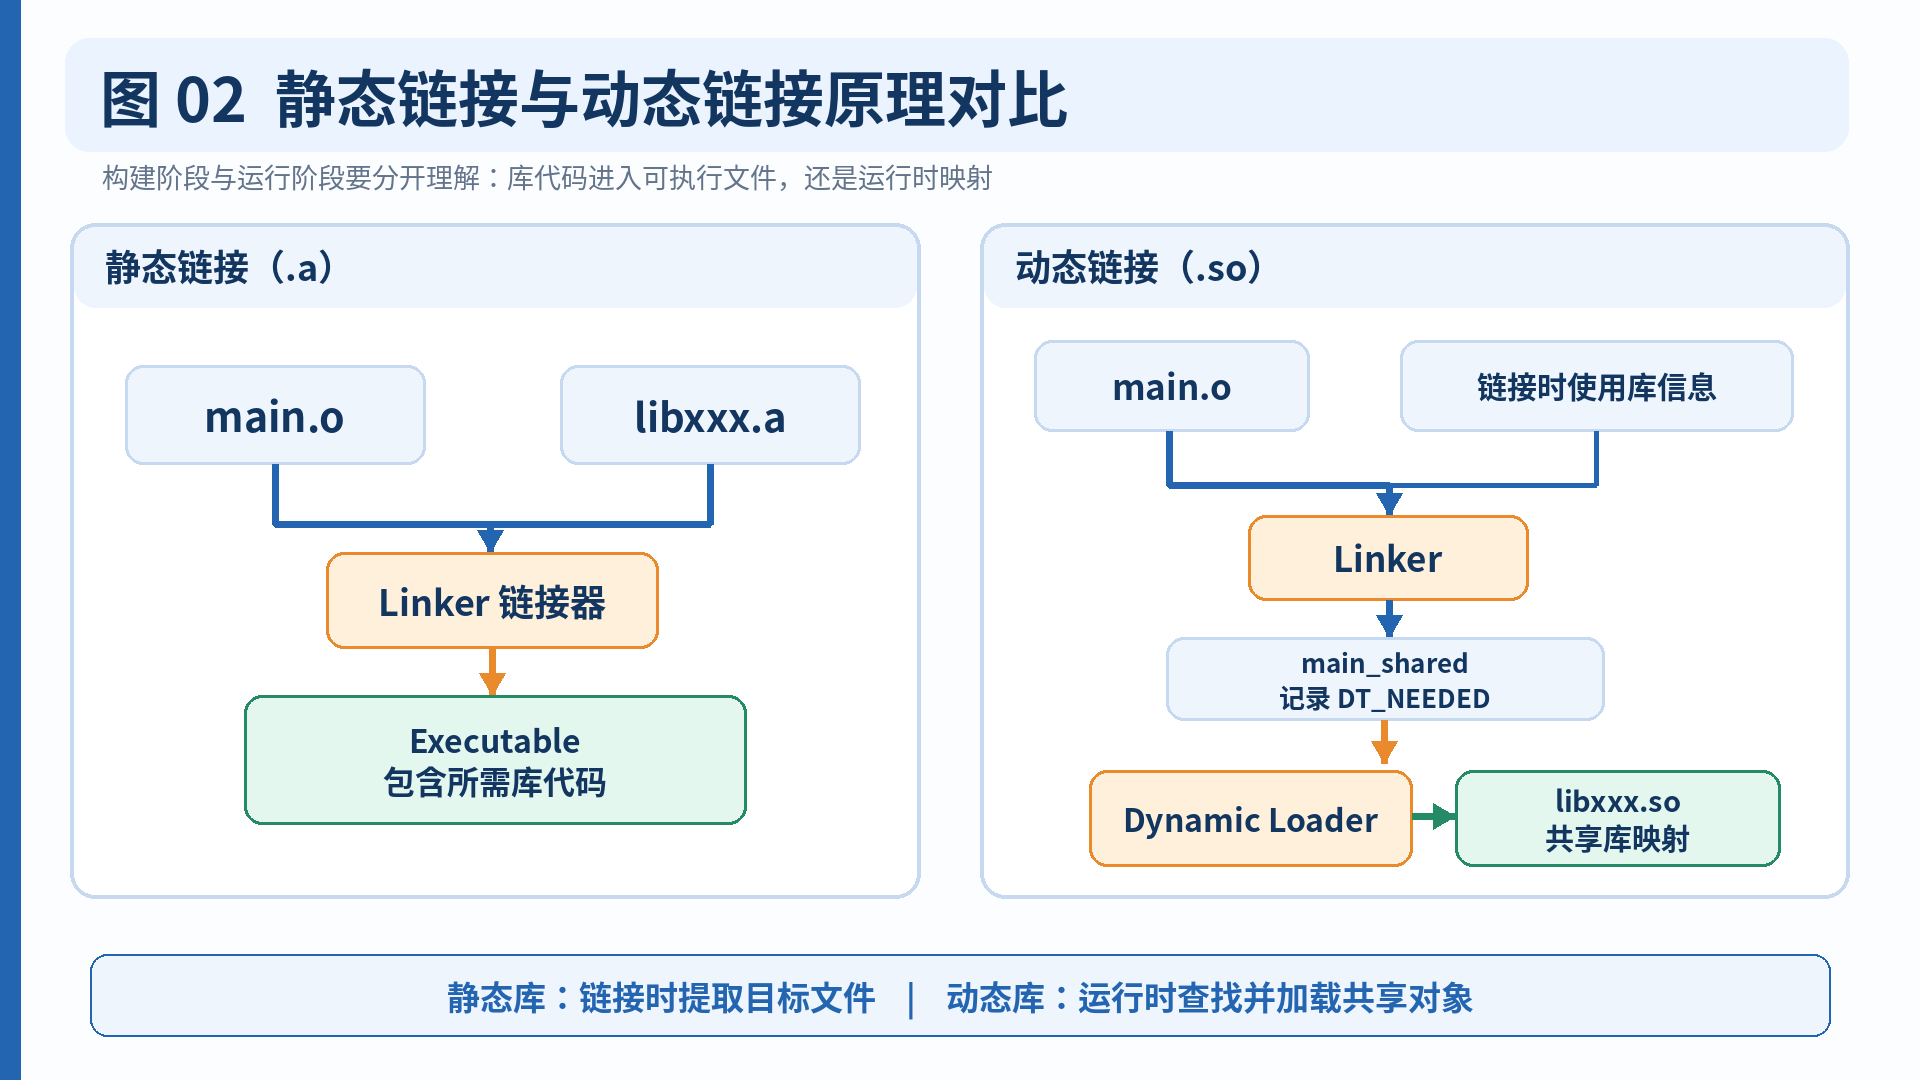
对于静态库:
程序构建时
    |
    v
将需要的库目标代码链接进程序
    |
    v
生成可执行文件
对于动态库:
程序构建时
    |
    v
记录共享库依赖与相关符号信息
    |
    v
生成可执行文件
    |
    v
程序启动时装载所需共享库
二者最大的区别之一,是库代码进入程序最终执行环境的时机与方式不同。
二、先理解源码、头文件和目标文件的关系
2.1 为什么制作库之前需要编译?
我们平时写的:
int add(int a, int b)
{
    return a + b;
}
是 C 语言源代码。
CPU 不能直接执行这段文本形式的 C 代码。
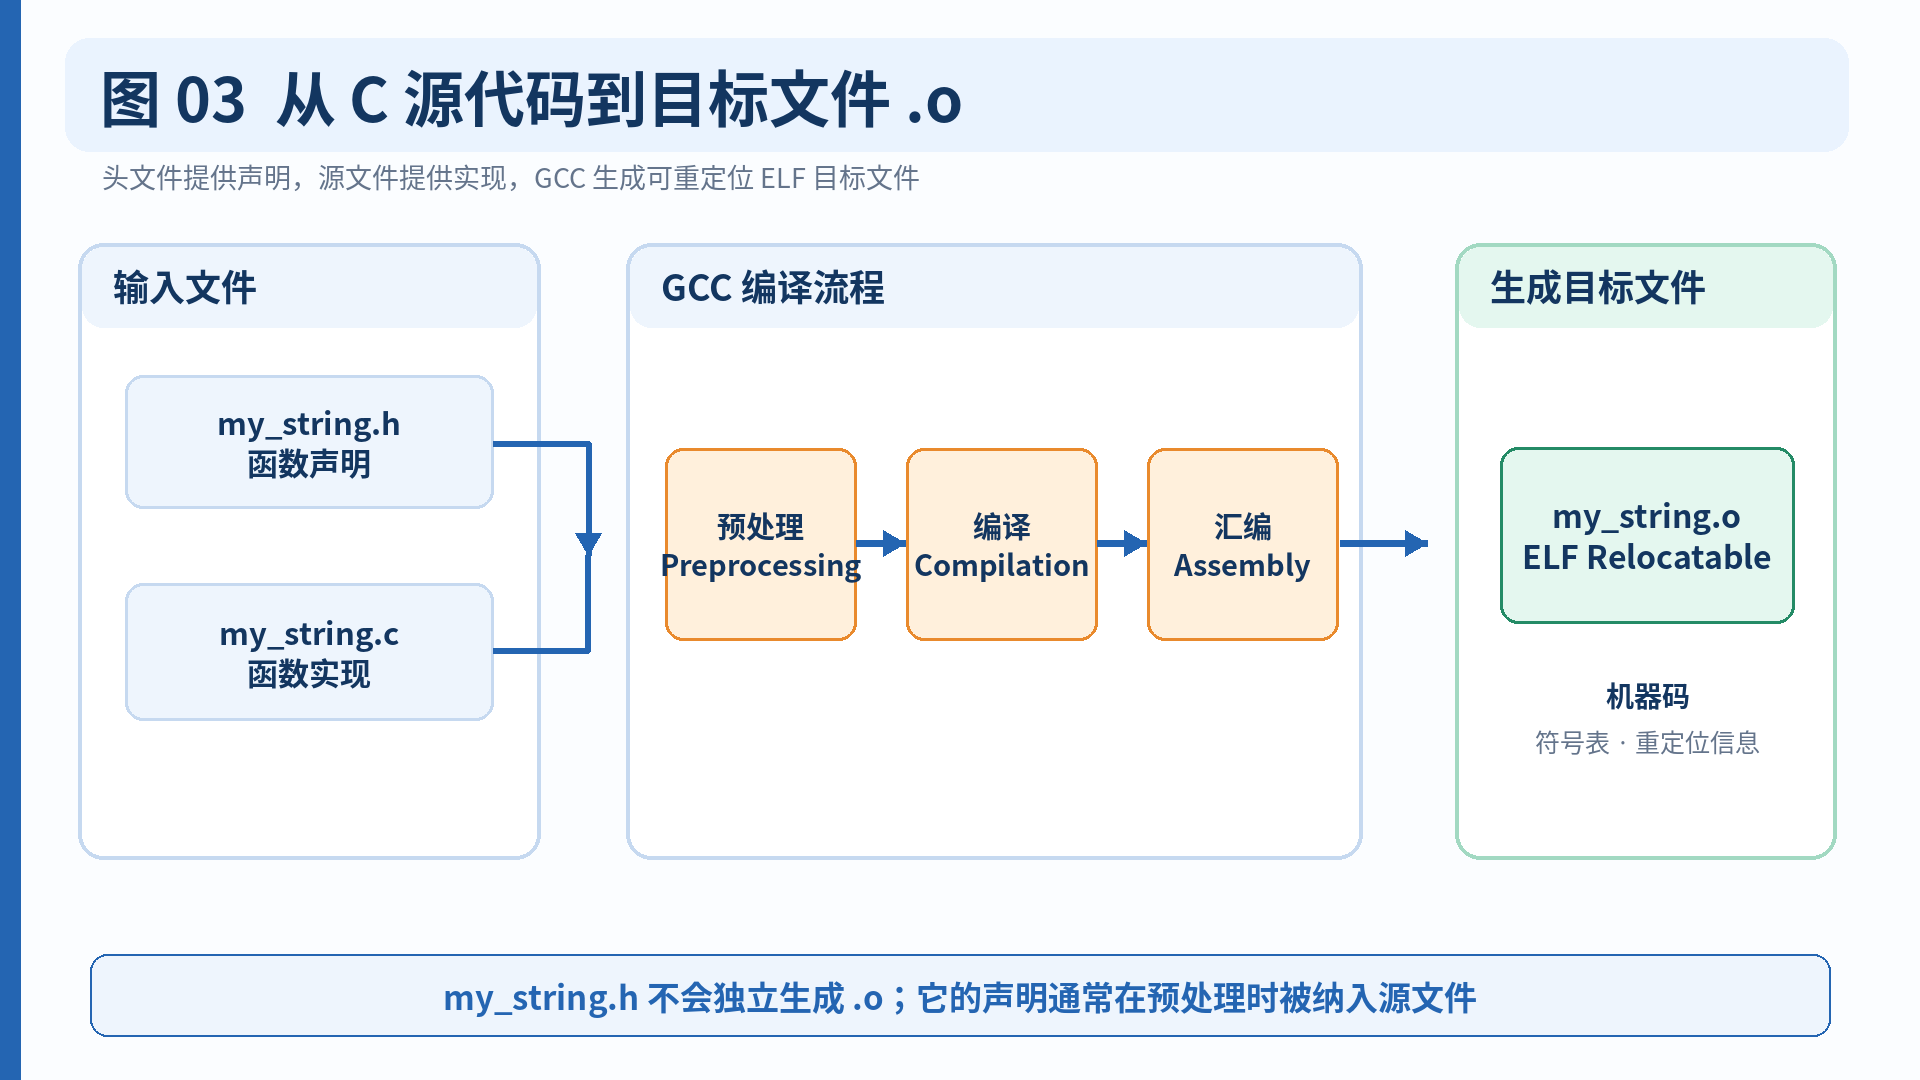
在 Linux 中,GCC 可以将源代码编译为目标文件。
例如:
gcc -c add.c -o add.o
这里的:
-c
表示完成编译、汇编并生成目标文件,但不执行最终的可执行程序链接。
于是得到:
add.c ---> add.o
add.o 通常是 ELF 格式的可重定位目标文件。
它已经包含机器代码等内容,但未必能直接运行,因为还可能存在尚未解析的外部符号。
2.2 头文件与源文件分别负责什么?
假设我们实现:
size_t my_strlen(const char* str);
可以把代码拆分为两个文件。
my_string.h:
#ifndef MY_STRING_H
#define MY_STRING_H

#include <stddef.h>

size_t my_strlen(const char* str);

#endif
my_string.c:
#include "my_string.h"

size_t my_strlen(const char* str)
{
    const char* p = str;

    while (*p != '\0')
    {
        ++p;
    }

    return (size_t)(p - str);
}
其中:
头文件 .h 提供函数声明,使其他源文件知道函数的名称、参数和返回类型。
源文件 .c 提供具体实现。
编译:
gcc -Wall -Wextra -c my_string.c -o my_string.o
这时形成:
my_string.h  :对外提供接口
my_string.c  :实现具体功能
my_string.o  :编译后的目标代码
注意:头文件本身不会因为 #include 就自动成为一个独立的已链接库。它主要向编译器提供声明等编译期信息。
三、准备一个可以重复使用的库项目
3.1 项目结构
这次制作一个名为:
mystdio
的小型教学库。
它包含两个模块:
my_string:简单字符串处理

my_stdio:基于Linux文件描述符的文件写入封装
目录结构:
mylib/
├── my_string.h
├── my_string.c
├── my_stdio.h
├── my_stdio.c
├── main.c
└── Makefile
其中 main.c 是测试程序,不属于库本身。
3.2 为什么选用这两个模块?
一方面,我们可以继续使用之前学过的:
open()
write()
close()
理解库函数与系统调用的关系。
另一方面,使用多个 .o 文件制作库,可以更清楚地观察:
多个目标文件
      |
      v
一个库文件
这一过程。
四、实现my_stdio:对系统调用进行简单封装
4.1 重新回顾FILE与fd
上一篇基础 IO 已经介绍:
int fd = open("log.txt", O_WRONLY);
使用的是文件描述符。
而:
FILE* fp = fopen("log.txt", "w");
使用的是标准 IO 文件流。
我们可以仿照标准 IO 的思想,实现一个简化版 mFILE。
注意:下面只是用于学习库封装与缓冲机制的教学实现,不等同于完整的 C 标准库,也没有实现读写混合、线程安全等功能。
4.2 定义my_stdio.h
#ifndef MY_STDIO_H
#define MY_STDIO_H

#include <stddef.h>

typedef struct
{
    int fd;                // 底层文件描述符
    char buffer[1024];     // 用户态输出缓冲区
    size_t used;           // 已经使用的缓冲区长度
} mFILE;

// 教学版仅实现w和a两种打开方式
mFILE* mfopen(const char* filename, const char* mode);

// 返回0表示成功,-1表示失败
int mfwrite(const void* ptr, size_t len, mFILE* stream);

int mfflush(mFILE* stream);

int mfclose(mFILE* stream);

#endif
这里值得注意的是:
int fd;
我们自己封装的文件流,仍然需要使用底层文件描述符完成实际 IO。
而:
char buffer[1024];
就是一个简单的用户态输出缓冲区。
4.3 实现my_stdio.c
#include "my_stdio.h"

#include <errno.h>
#include <fcntl.h>
#include <stdlib.h>
#include <string.h>
#include <unistd.h>

mFILE* mfopen(const char* filename, const char* mode)
{
    int flags;

    if (strcmp(mode, "w") == 0)
    {
        flags = O_WRONLY | O_CREAT | O_TRUNC;
    }
    else if (strcmp(mode, "a") == 0)
    {
        flags = O_WRONLY | O_CREAT | O_APPEND;
    }
    else
    {
        errno = EINVAL;
        return NULL;
    }

    int fd = open(filename, flags, 0666);

    if (fd < 0)
    {
        return NULL;
    }

    mFILE* stream = calloc(1, sizeof(*stream));

    if (stream == NULL)
    {
        close(fd);
        return NULL;
    }

    stream->fd = fd;

    return stream;
}

int mfflush(mFILE* stream)
{
    size_t done = 0;

    while (done < stream->used)
    {
        ssize_t n = write(
            stream->fd,
            stream->buffer + done,
            stream->used - done
        );

        if (n < 0 && errno == EINTR)
        {
            continue;
        }

        if (n <= 0)
        {
            // 保留本次尚未成功写出的数据
            if (done > 0)
            {
                memmove(
                    stream->buffer,
                    stream->buffer + done,
                    stream->used - done
                );

                stream->used -= done;
            }

            if (n == 0)
            {
                errno = EIO;
            }

            return -1;
        }

        done += (size_t)n;
    }

    stream->used = 0;

    return 0;
}

int mfwrite(const void* ptr, size_t len, mFILE* stream)
{
    const char* p = ptr;

    for (size_t i = 0; i < len; ++i)
    {
        stream->buffer[stream->used++] = p[i];

        // 遇到换行符,或者缓冲区满时刷新
        if (p[i] == '\n' ||
            stream->used == sizeof(stream->buffer))
        {
            if (mfflush(stream) < 0)
            {
                return -1;
            }
        }
    }

    return 0;
}

int mfclose(mFILE* stream)
{
    int flush_result = mfflush(stream);

    int close_result = close(stream->fd);

    free(stream);

    return (flush_result < 0 || close_result < 0)
        ? -1
        : 0;
}
这里的 mfwrite() 是我们定义的简化接口,返回 0/-1,并不采用标准库 fwrite() 返回完整元素个数的语义。
另外,mfflush() 只是刷新用户态缓冲,不等于 fsync()。如果需要保证数据持久化,还需要另外研究同步策略。
这个版本用于演示封装原理,不能直接当成完整的生产级文件 IO 库。
五、静态库的制作原理
5.1 什么是静态库?
Linux 静态库通常采用:
libxxx.a
的命名方式。
其中:
lib:常见的库名前缀

xxx:库的名称

.a:静态库扩展名
例如:
libmystdio.a
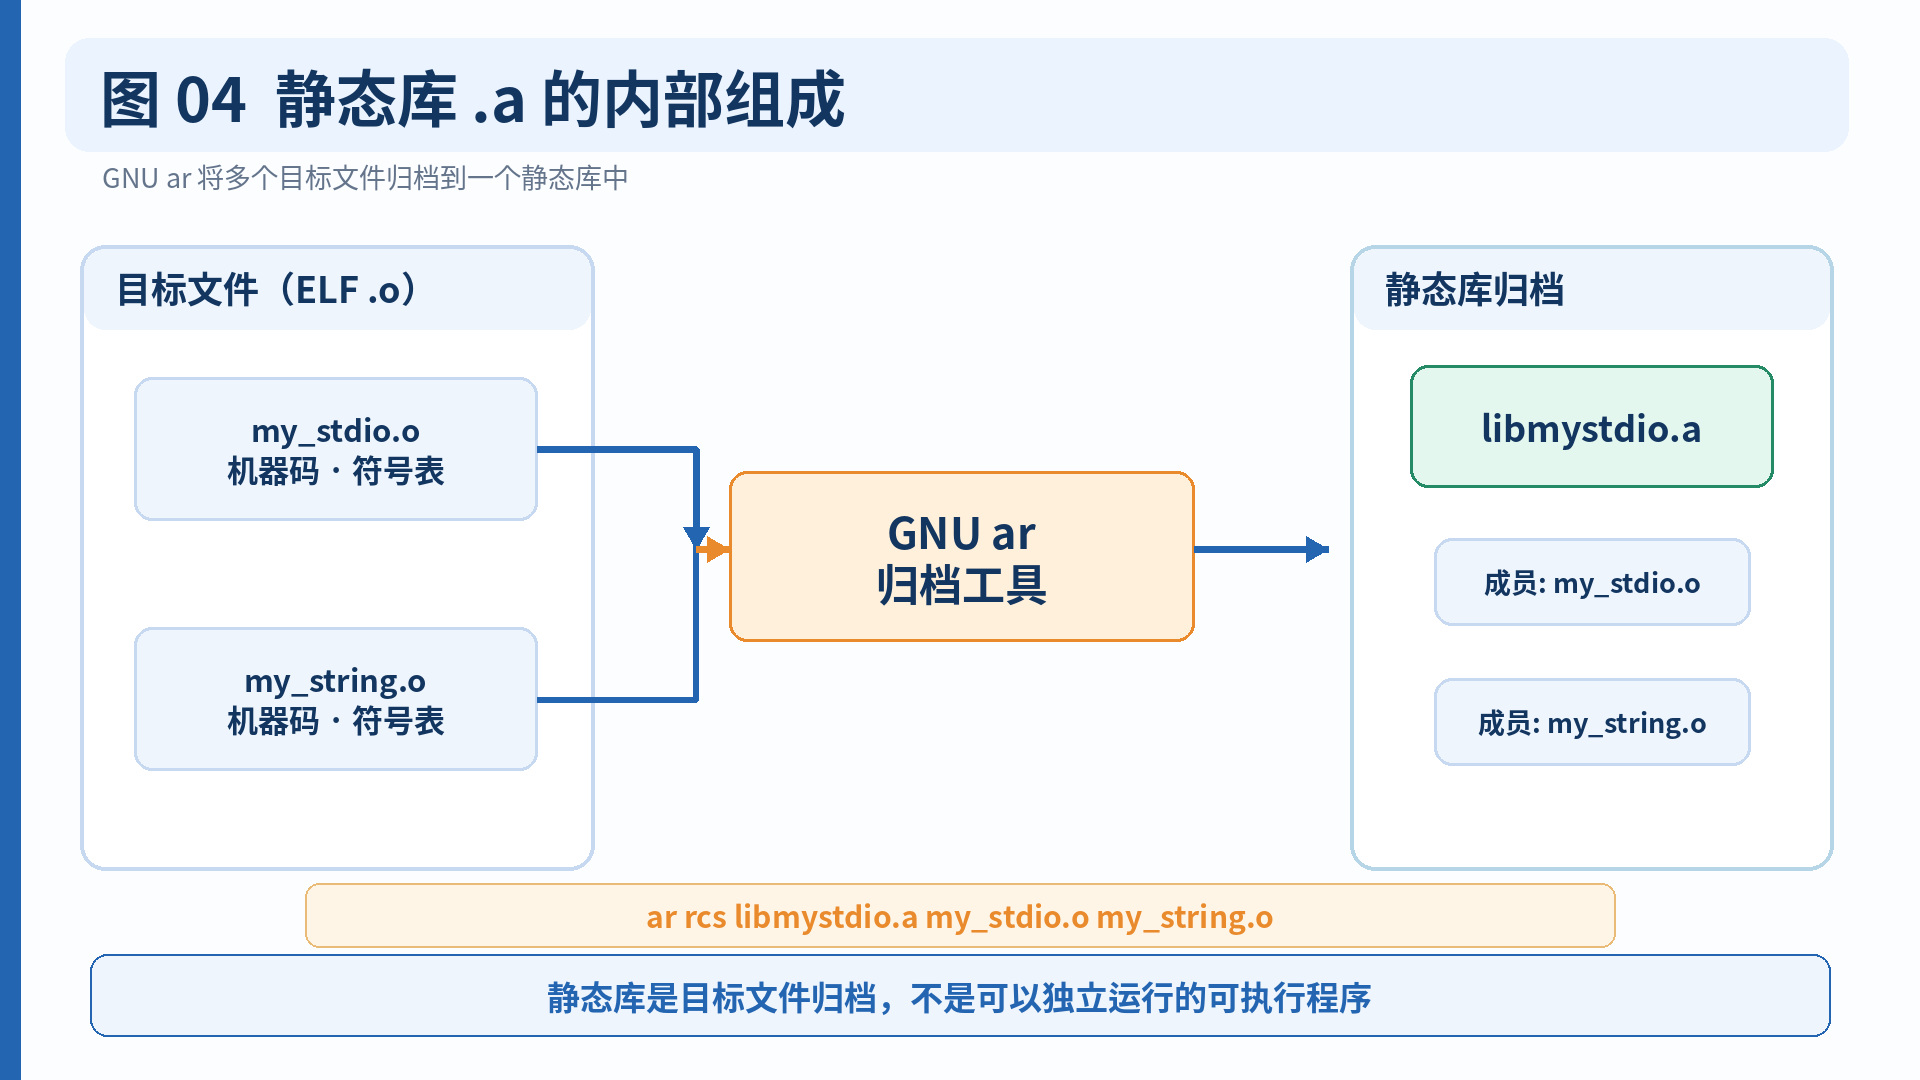
静态库可以理解为一个保存多个目标文件的归档文件。
例如:
libmystdio.a
├── my_stdio.o
└── my_string.o
它本身不是可以直接运行的程序。
链接器在构建程序时,会从静态库中提取所需的目标文件成员,参与符号解析和最终链接。
5.2 第一步:生成目标文件
进入项目目录:
cd mylib
执行:
gcc -Wall -Wextra -c my_stdio.c -o my_stdio.o
gcc -Wall -Wextra -c my_string.c -o my_string.o
现在拥有:
my_stdio.o
my_string.o
这两个文件已经包含各自模块编译后的代码。
5.3 第二步:使用ar创建静态库
执行:
ar rcs libmystdio.a my_stdio.o my_string.o
其中:
ar:GNU归档工具
参数:
| 参数 | 作用 |
|---|---|
r | 插入或替换归档成员 |
c | 创建归档时不输出通常的提示 |
s | 为归档建立或更新符号索引 |
因此:
ar rcs libmystdio.a my_stdio.o my_string.o
就是把两个目标文件归档为一个静态库。
5.4 第三步:查看静态库内部成员
执行:
ar t libmystdio.a
应该看到:
my_stdio.o
my_string.o
还可以使用:
ar tv libmystdio.a
查看详细成员信息。
如果想检查库里定义了哪些全局符号:
nm -g --defined-only libmystdio.a
可能看到:
mfopen
mfwrite
mfflush
mfclose
my_strlen
具体格式依赖平台和工具版本。
六、静态库如何被其他程序使用?
6.1 编写测试程序
在 main.c 中:
#include "my_stdio.h"
#include "my_string.h"

#include <stdio.h>

int main(void)
{
    const char* msg = "hello library\n";

    printf("len = %zu\n", my_strlen(msg));

    mFILE* fp = mfopen("log.txt", "a");

    if (fp == NULL)
    {
        perror("mfopen");
        return 1;
    }

    if (mfwrite(msg, my_strlen(msg), fp) < 0)
    {
        perror("mfwrite");
        mfclose(fp);
        return 1;
    }

    if (mfclose(fp) < 0)
    {
        perror("mfclose");
        return 1;
    }

    return 0;
}
这个程序同时使用:
my_string
和:
my_stdio
提供的函数。
6.2 最直接的链接方式
执行:
gcc main.c ./libmystdio.a -o main_static
这里直接把静态库文件作为链接输入。
运行:
./main_static
正常情况下输出:
len = 14
然后查看:
cat log.txt
能够看到:
hello library
6.3 静态链接时到底发生了什么?
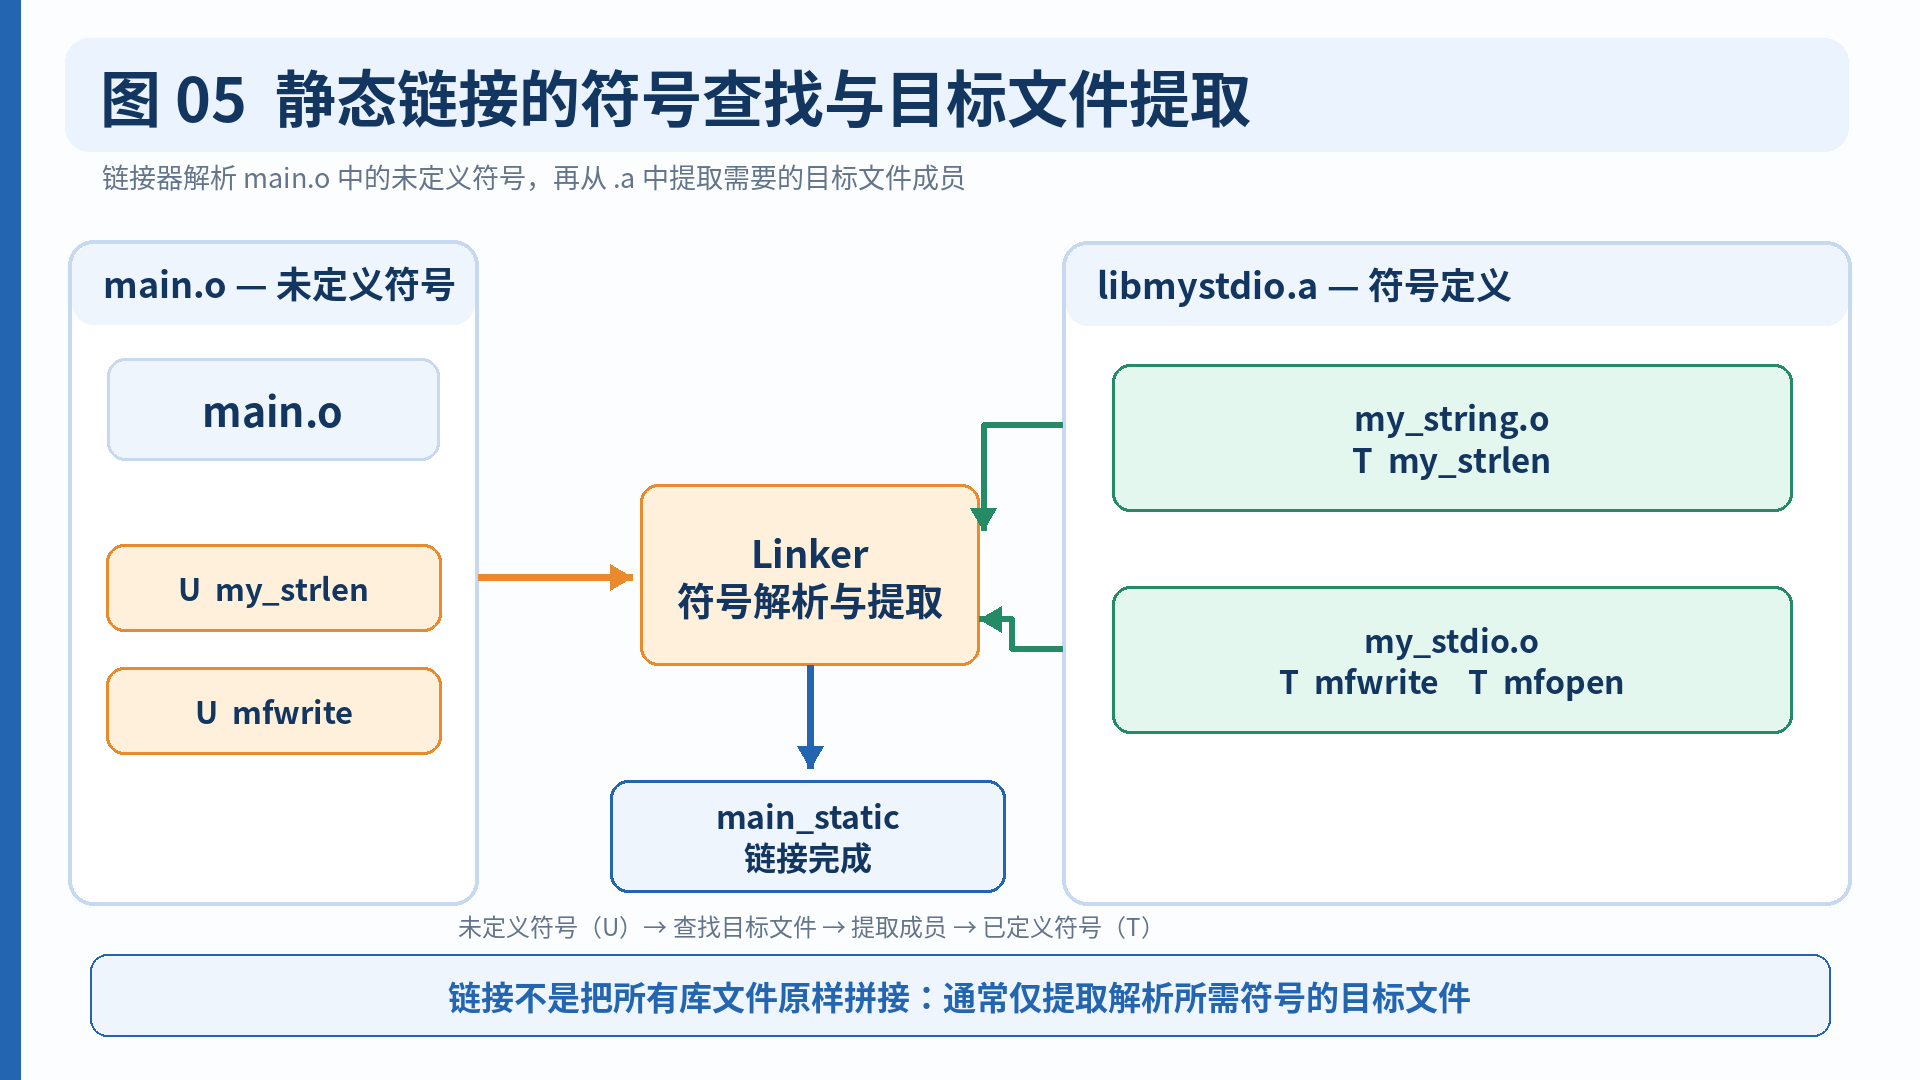
假设 main.c 中调用:
my_strlen(msg);
在单独编译 main.c 时,编译器知道 my_strlen() 的声明,但它的函数实现位于另一个目标文件中。
因此,链接器需要寻找:
my_strlen
这个符号的定义。
最终在:
libmystdio.a
中找到包含对应定义的 my_string.o,把需要的目标代码纳入链接。
可以简单理解为:
main.o
   |
   | 需要my_strlen
   v
链接器查找符号
   |
   v
libmystdio.a
   |
   v
找到my_string.o
   |
   v
完成链接
6.4 删除静态库以后,程序还能运行吗?
可以验证:
mv libmystdio.a libmystdio.a.bak
./main_static
在我们的示例中,即使把静态库移走,已经生成的 main_static 仍然能够调用其中的功能。
因为自定义库的相关代码已经参与最终链接。
但这里需要避免一个误解:
我们只把自己的 libmystdio.a 静态链接了,并不代表整个程序是完全静态链接的。
它仍然可能动态依赖 glibc 等系统共享库。
执行:
ldd ./main_static
仍然可能看到 libc.so.6。
如果希望尝试全静态链接,需要进一步研究:
gcc -static ...
但这要求系统提供相应的静态库,且不适合简单理解成“给 GCC 加个参数就一定能成功”。
测试完毕后恢复:
mv libmystdio.a.bak libmystdio.a
七、动态库的制作原理
7.1 什么是动态库?
动态库通常使用:
libxxx.so
命名。
其中:
.so
是 Shared Object,即共享对象。
它与静态库的重要区别是:
程序通常不会在链接时把共享库的全部实现代码复制到最终可执行文件中,而是记录对共享库的依赖,运行时由动态加载机制提供对应代码。
例如:
main_shared
     |
     | 依赖
     v
libmystdio.so
动态库还可以被多个进程映射使用。
但共享的主要是适合共享的只读代码页等,进程各自的可写数据并不意味着全部共享。
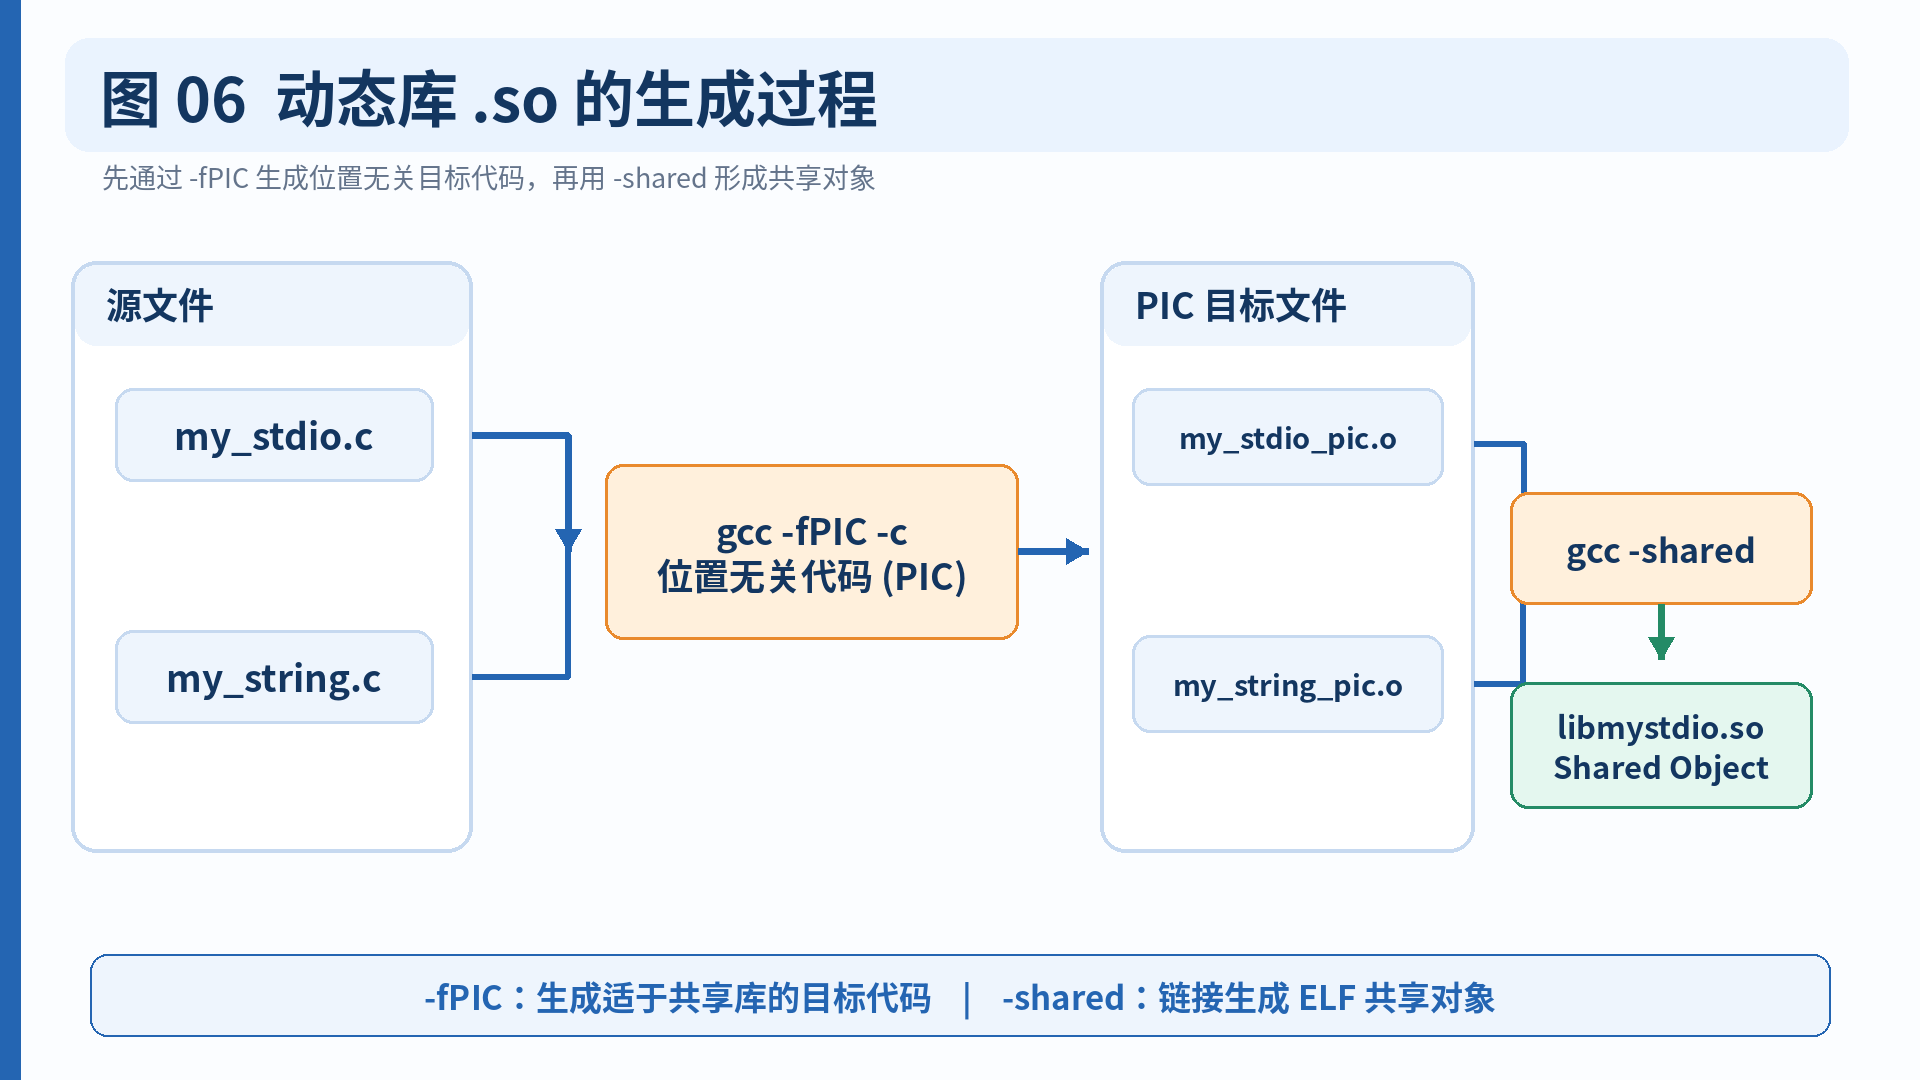
7.2 为什么需要-fPIC?
制作动态库时,常见命令包含:
-fPIC
它的含义是:
Position Independent Code
即位置无关代码。
动态库可能被映射到不同进程虚拟地址空间中的不同位置。
位置无关代码可以减少对固定装载地址的依赖,方便动态库进行映射和共享。
具体实现涉及相对寻址、GOT 等机制,将在第二篇文章详细说明。
7.3 编译位置无关目标文件
执行:
gcc -Wall -Wextra -fPIC -c my_stdio.c -o my_stdio_pic.o
gcc -Wall -Wextra -fPIC -c my_string.c -o my_string_pic.o
得到:
my_stdio_pic.o
my_string_pic.o
7.4 生成共享库
执行:
gcc -shared \
    -o libmystdio.so \
    my_stdio_pic.o my_string_pic.o
这里:
-shared
要求链接器生成共享对象。
至此,我们得到:
libmystdio.so
八、动态库如何使用?
8.1 GCC三个重要参数
使用自己编写的库时,经常遇到:
-I
-L
-l
它们的作用不同。
| 参数 | 作用 | 示例 |
|---|---|---|
-I | 指定头文件搜索路径 | -I./include |
-L | 指定链接时库文件搜索路径 | -L./lib |
-l | 指定要链接的库名 | -lmystdio |
假设库文件名称是:
libmystdio.so
链接时使用:
-lmystdio
而不是:
-llibmystdio.so
因为 -l 通常会按照平台约定的库文件命名规则查找库。
8.2 链接动态库
如果 .so 位于当前目录,执行:
gcc main.c -I. -L. -lmystdio -o main_shared
这里:
-I.:当前目录搜索头文件

-L.:当前目录搜索链接库

-lmystdio:链接mystdio库
注意:当当前目录中同时存在 libmystdio.so 和 libmystdio.a,并采用通常的动态链接模式时,链接器一般优先选择 .so。
也可以直接把具体 .so 文件路径作为链接输入。
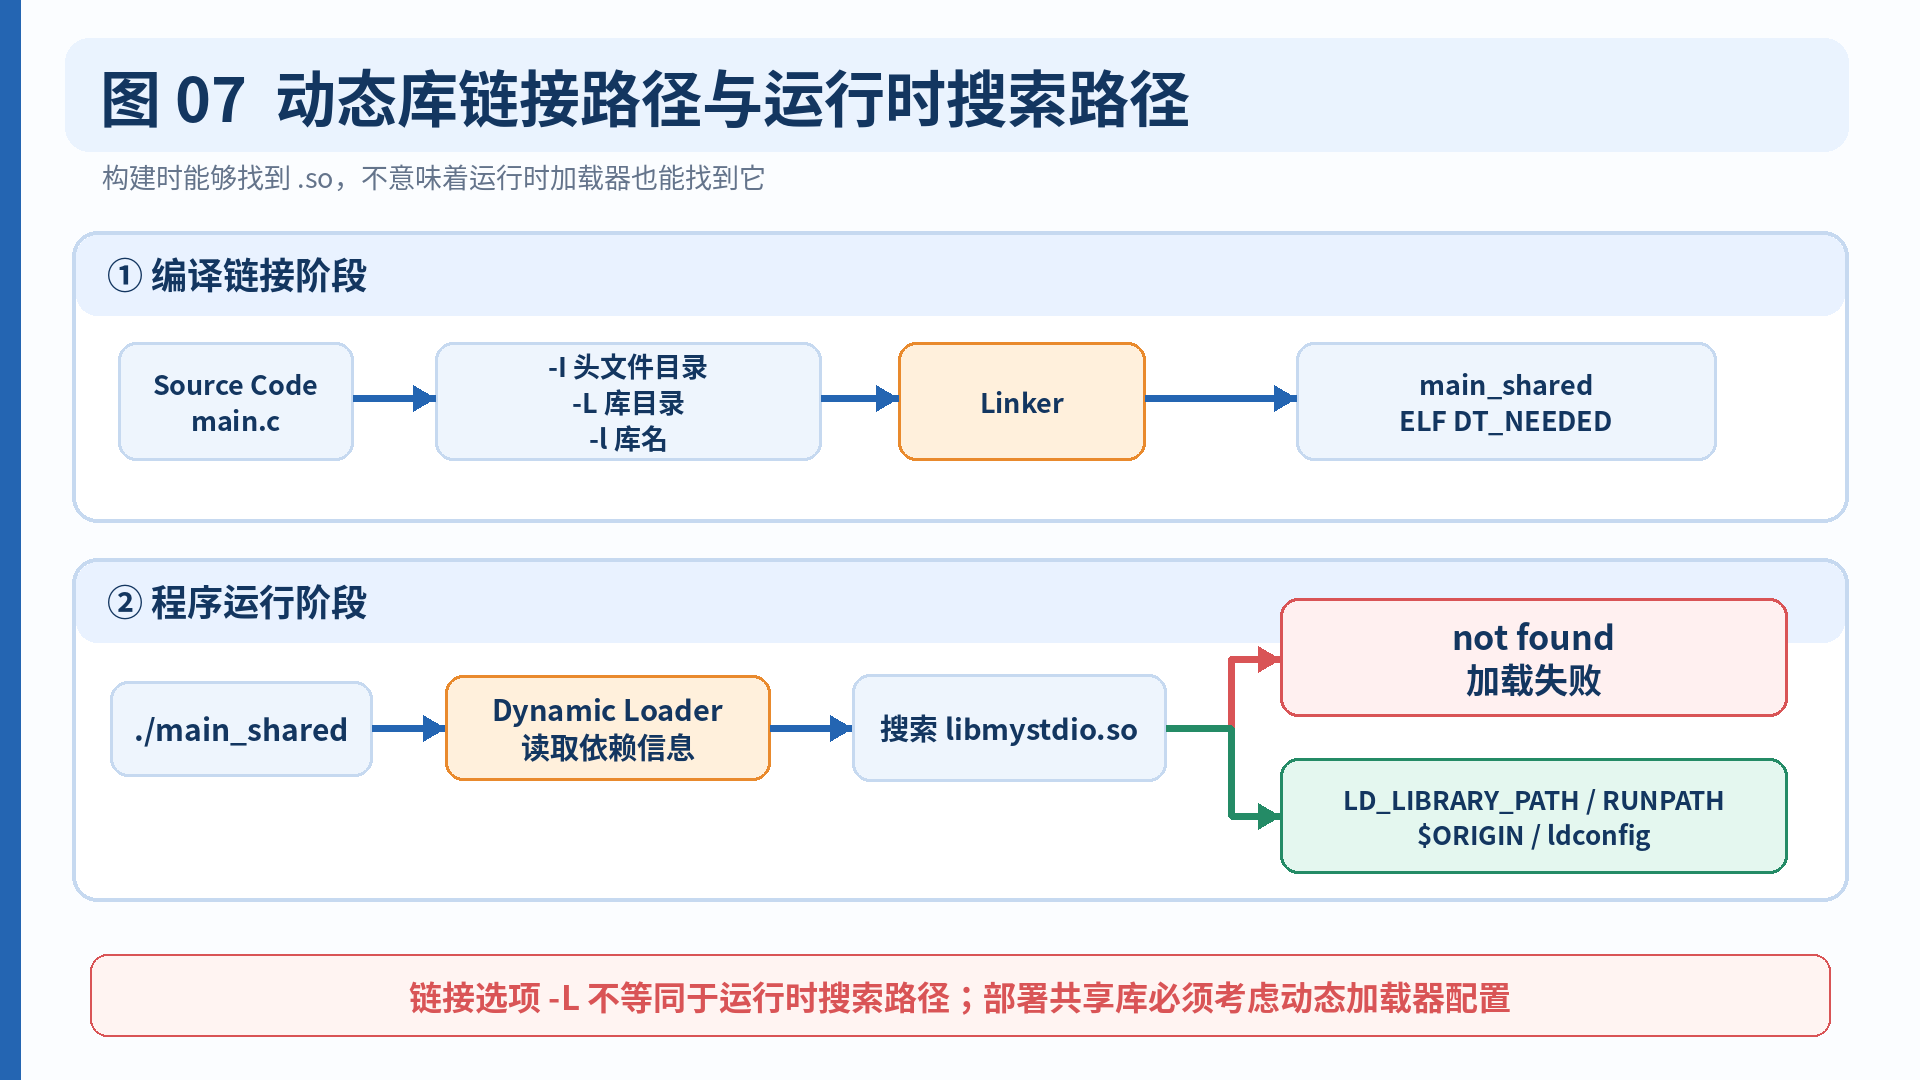
8.3 为什么程序运行时可能报错?
尝试执行:
./main_shared
可能出现:
error while loading shared libraries:
libmystdio.so: cannot open shared object file:
No such file or directory
明明:
libmystdio.so
就在当前目录,为什么还提示找不到?
因为:
链接时库文件的搜索路径,与运行时动态加载器查找共享库的路径,不是同一个概念。
例如:
-L.
只是在程序构建阶段帮助链接器寻找库。
它不代表动态加载器在程序启动时也一定搜索当前工作目录。
九、动态库的运行时搜索路径
9.1 使用ldd检查共享库依赖
执行:
ldd ./main_shared
可能看到:
libmystdio.so => not found
这表示程序需要的共享库尚未在运行时搜索路径中被定位到。
9.2 方案一:LD_LIBRARY_PATH
对于本地教学实验,最简单的方法是:
LD_LIBRARY_PATH=. ./main_shared
这样仅为这次执行设置共享库搜索路径。
也可以:
export LD_LIBRARY_PATH="$PWD${LD_LIBRARY_PATH:+:$LD_LIBRARY_PATH}"
./main_shared
注意,LD_LIBRARY_PATH 不是在所有安全执行模式下都生效,例如某些特权程序会受到动态加载器的安全限制。
9.3 方案二:设置RUNPATH
构建程序时还可以嵌入运行时库搜索路径:
gcc main.c -I. -L. -lmystdio \
    -Wl,-rpath,'$ORIGIN' \
    -o main_shared
这里:
$ORIGIN
通常表示可执行文件所在目录。
因此当程序和共享库放在同一目录时,加载器可以通过这个路径寻找 libmystdio.so。
-Wl, 表示将后面的选项传递给链接器。
这种方法适合演示将程序与它依赖的共享库一起发布。
需要注意,RPATH 与 RUNPATH 在动态库依赖传递等方面存在差异,具体行为还取决于 ELF 动态段实际记录的标签。
9.4 方案三:系统动态库配置
在具有系统管理权限的 Linux 环境中,可以将可信的库目录写入:
/etc/ld.so.conf.d/
然后运行:
sudo ldconfig
更新动态加载器相关缓存。
例如:
sudo sh -c 'echo /opt/mylib/lib > /etc/ld.so.conf.d/mylib.conf'
sudo ldconfig
这里的路径需要是实际存在、受信任的库安装目录。
不建议仅仅为了一个实验程序,把当前目录随意添加到系统级共享库路径中。
十、使用Makefile自动化制作动静态库
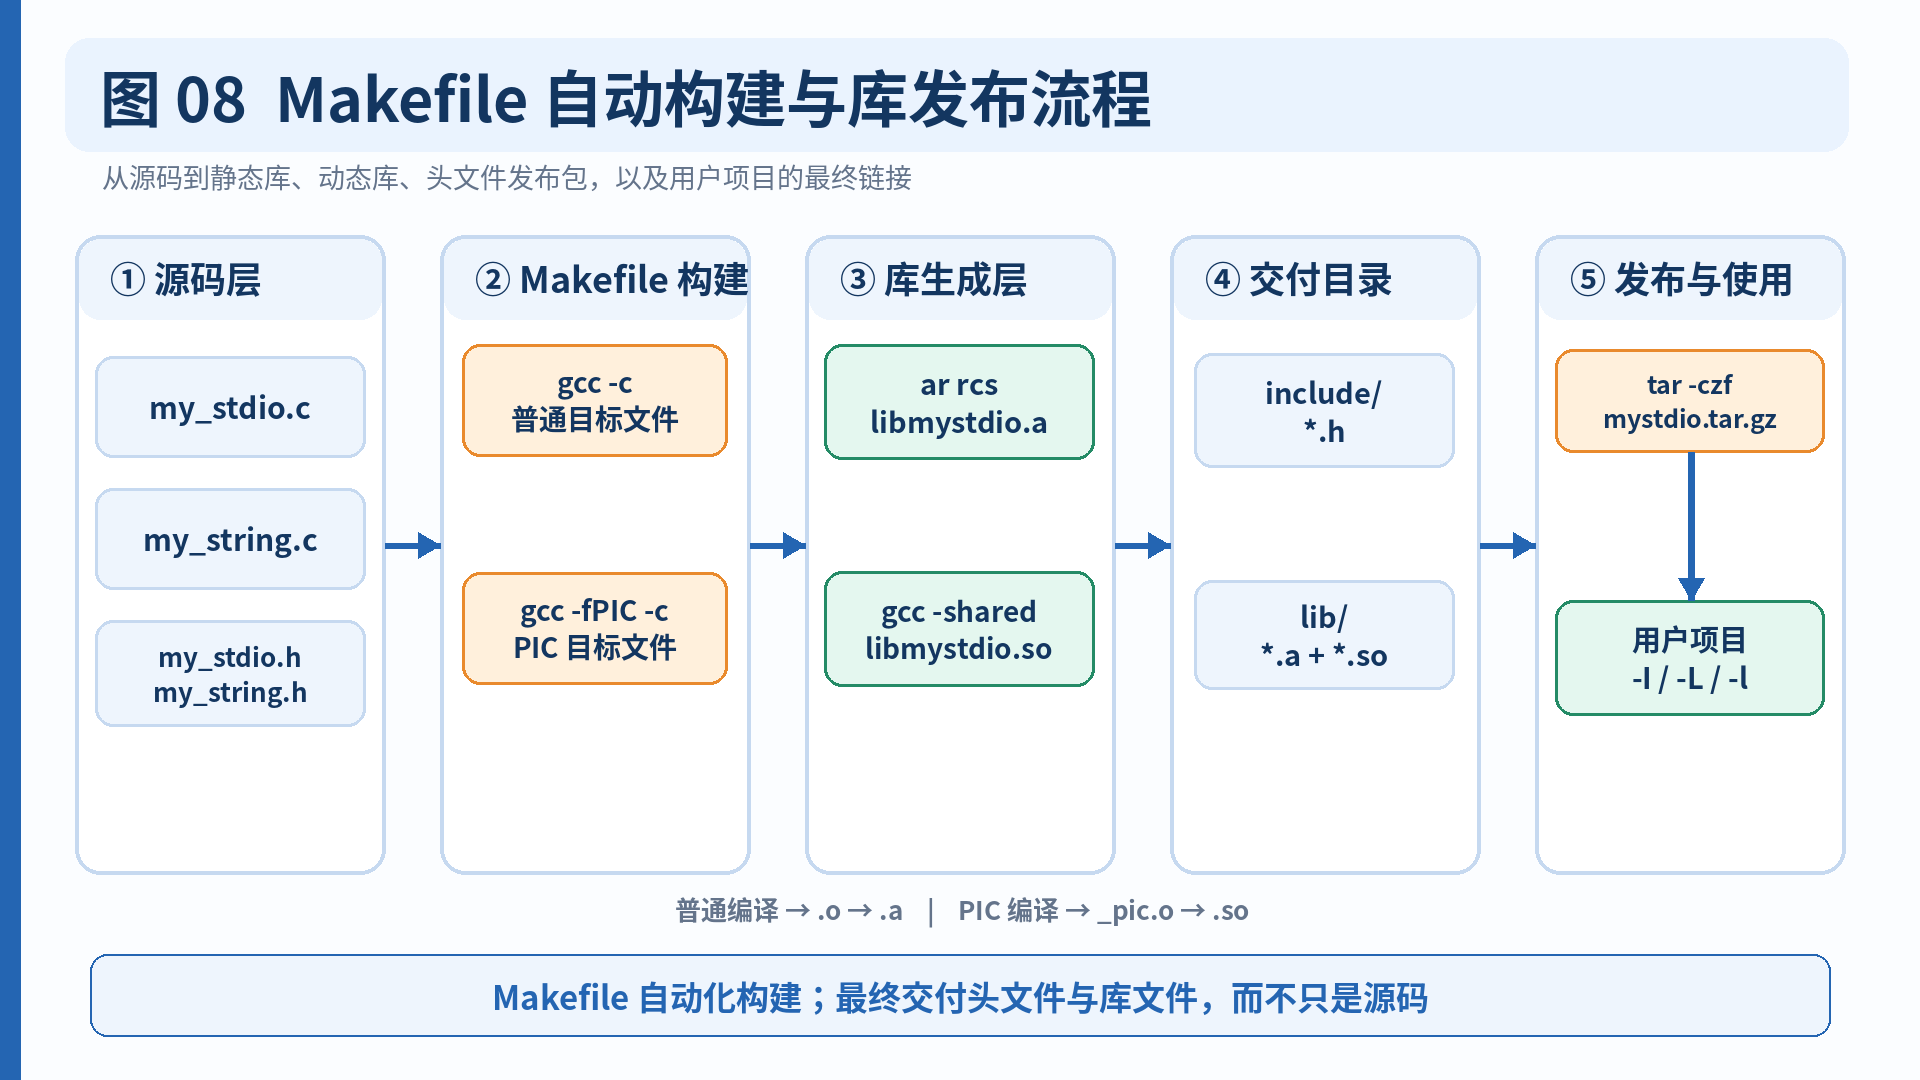
现在我们已经掌握了静态库和动态库的手工生成方式。
但每次都手动输入:
gcc -c ...
ar rcs ...
gcc -fPIC ...
gcc -shared ...
显然不够方便。
可以通过 Makefile 描述依赖关系和构建规则。
10.1 Makefile完整示例
CC = gcc

CFLAGS = -Wall -Wextra -O2 -I.

OBJ = my_stdio.o my_string.o

PICOBJ = my_stdio_pic.o my_string_pic.o

all: libmystdio.a libmystdio.so

# 静态库
libmystdio.a: $(OBJ)
	ar rcs $@ $^

# 动态库
libmystdio.so: $(PICOBJ)
	$(CC) -shared -o $@ $^

# 普通目标文件
%.o: %.c
	$(CC) $(CFLAGS) -c $< -o $@

# PIC目标文件
%_pic.o: %.c
	$(CC) $(CFLAGS) -fPIC -c $< -o $@

clean:
	rm -f *.o *.a *.so main_static main_shared

.PHONY: all clean
注意:Makefile命令行开头使用的是 Tab,而不是普通空格。
10.2 解释几个自动变量
$@
表示当前规则的目标文件。
例如:
libmystdio.a: $(OBJ)
	ar rcs $@ $^
这里:
$@ = libmystdio.a
$^
表示当前规则的全部依赖文件。
这里:
$^ = my_stdio.o my_string.o
$<
通常表示第一个依赖文件。
例如:
%.o: %.c
	$(CC) $(CFLAGS) -c $< -o $@
对于:
my_string.o
对应:
$< = my_string.c
$@ = my_string.o
10.3 执行构建
make
就能生成:
libmystdio.a
libmystdio.so
清理:
make clean
10.4 如何打包发布自己的库?
假设现在需要将库交给其他人使用。
通常可以准备:
mystdio/
├── include/
│   ├── my_stdio.h
│   └── my_string.h
└── lib/
    ├── libmystdio.a
    └── libmystdio.so
可以使用:
mkdir -p mystdio/include mystdio/lib

cp my_stdio.h my_string.h mystdio/include/

cp libmystdio.a libmystdio.so mystdio/lib/

tar -czf mystdio.tar.gz mystdio
使用者解压后,通过:
gcc main.c \
    -Imystdio/include \
    -Lmystdio/lib \
    -lmystdio \
    -o main
完成链接。
如果使用动态库,还需要处理相应的运行时搜索路径。
十一、课后扩展:尝试使用ncurses第三方库
前面的实验是我们自己制作库。
但在实际开发中,更多情况下需要使用其他人提供的库。
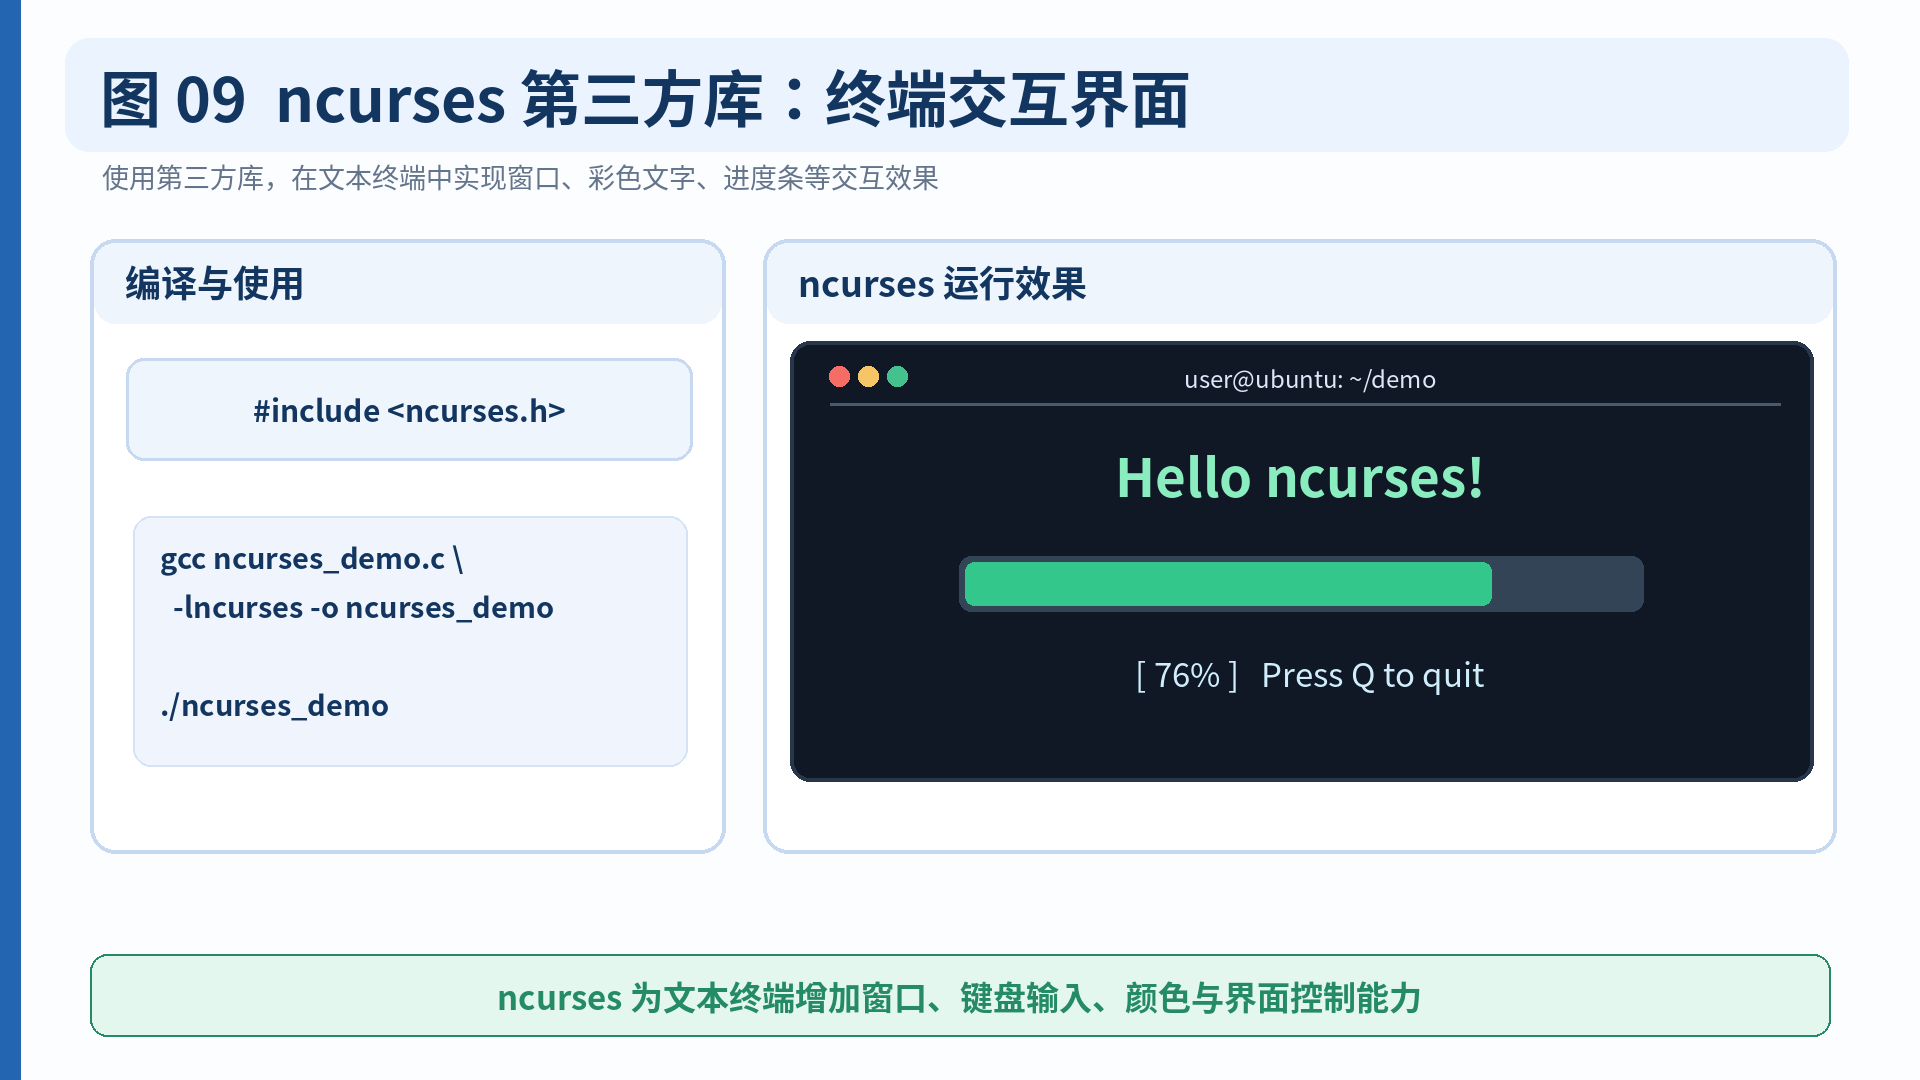
课程还介绍了一个很适合练习的终端界面库:
ncurses
它可以帮助我们在终端中创建文本界面,例如:
- 绘制窗口。
- 控制光标位置。
- 处理键盘输入。
- 显示颜色。
- 制作简单进度条。
11.1 安装
Ubuntu:
sudo apt update
sudo apt install libncurses-dev
11.2 编写简单程序
#include <ncurses.h>

int main(void)
{
    initscr();

    printw("Hello ncurses!");

    refresh();

    getch();

    endwin();

    return 0;
}
编译:
gcc ncurses_demo.c -lncurses -o ncurses_demo
运行:
./ncurses_demo
这里的:
-lncurses
就是我们在前面学习的库链接参数。
这也说明,无论是自己编写的库,还是系统中已经安装的第三方库,都需要理解头文件、链接库和相关运行依赖之间的关系。
十二、静态库与动态库的完整对比
| 对比项 | 静态库 .a | 动态库 .so |
|---|---|---|
| 基本形式 | 目标文件归档 | ELF共享对象 |
| 主要链接方式 | 提取所需目标文件参与链接 | 记录并处理动态库依赖和符号 |
| 自定义库实现代码 | 通常进入最终程序 | 通常由共享库提供 |
| 运行时是否需要原库文件 | 对已静态链接的代码通常不需要 | 通常需要相应共享对象 |
| 多进程共享代码页 | 不同程序各自拥有相关映像 | 可共享适合共享的库代码页 |
| 程序更新 | 更新静态库后通常需要重新链接程序 | 兼容更新可通过替换共享库部署 |
| 部署 | 自定义库依赖相对简单 | 需要注意运行时共享库搜索路径 |
| 常用制作工具 | gcc -c、ar | gcc -fPIC、gcc -shared |
需要特别注意:
静态库不意味着程序完全不依赖动态库,动态库也不意味着程序的所有代码都必须动态加载。
一个实际可执行程序可以同时使用静态链接与动态链接。
十三、常见错误总结
13.1 fatal error: my_string.h: No such file or directory
说明编译器没有找到需要的头文件。
检查头文件路径,并根据需要使用:
-I头文件目录
13.2 cannot find -lmystdio
说明链接阶段无法找到对应的库文件。
需要检查:
库文件是否存在
库文件命名是否正确
-L指定的路径是否正确
13.3 undefined reference to my_strlen
这属于链接错误。
常见原因是:
- 只包含了头文件,没有链接实现。
- 静态库没有打包对应目标文件。
- 库链接选项的顺序不合适。
- 函数定义与声明不一致。
对于传统 GNU 链接流程,静态库的链接顺序尤其需要注意。
通常推荐:
gcc main.o -L. -lmystdio -o main
而不是把静态库无条件放在需要其符号的目标文件前面。
13.4 error while loading shared libraries
说明运行时动态加载器没有成功定位或者加载所需的共享库。
首先检查:
ldd ./main_shared
然后检查运行时路径配置。
13.5 为什么我的程序仍然依赖libc.so?
如果只将 libmystdio.a 静态链接,而 printf() 等仍然使用系统共享库,那么程序依然可能依赖:
libc.so.6
这很正常。
不要把“链接了一个静态库”误解为“整个程序是静态可执行文件”。
总结
本篇从代码复用出发,完整学习了 Linux 静态库与动态库的制作和使用。
对于静态库:
源代码
   |
   v
目标文件.o
   |
   v
ar归档
   |
   v
静态库.a
   |
   v
链接器
   |
   v
可执行程序
对于动态库:
源代码
   |
   v
-fPIC生成目标文件
   |
   v
-shared链接
   |
   v
动态库.so
   |
   v
可执行程序记录共享库依赖
   |
   v
运行时动态加载
我们还掌握了:
-I
-L
-l
三个重要参数,并且理解了链接时搜索路径和运行时搜索路径的区别。
其中最重要的结论是:
库不仅是一组函数,更是一种将代码编译、组织、链接和交付的机制。
不过到这里,我们还有几个问题没有彻底解决:
- 静态库中的
.o为什么能够被链接器合并? .o、.so和可执行文件为什么可以使用同一种 ELF 格式?- 链接器怎样找到
my_strlen()等函数? - 动态库为什么能够映射到不同的虚拟地址?
- GOT、PLT 和位置无关代码到底怎样工作?
转载自 CSDN-专业IT技术社区
原文链接:https://blog.csdn.net/Face_FeaR/article/details/167656411

