

严格 schema 也放过三成三、非必填字段被拼错取代时五条全静默、契约加一个可选字段反而让最严格的客户端硬失败、前缀占了单次输入的八成九、修复回合天生贵两成四 —— 为什么"让它返回 JSON"会同时交出"格式正确"和"内容错误",附 Python 3.13 + Node 22 五组本地实测
实测于 2026 年 10 月 6 日 | 约 10,100 字 | 面向全栈工程师、后端工程师与 AI 应用开发者
目录
一、结构化输出被严重低估了
二、先看清楚:结构化输出在整条链路里的位置
三、三个直觉,三条岔路
四、实验台:怎么做的,为什么可信
五、实验一:JSON Schema 到底拦得住什么
六、实验二:字段被拼错取代时,四道关全部放行
七、实验三:契约一变,20 格里 11 格是静默失败
八、实验四:失败率的真实成本
九、实验五:好心修复的代价
十、落到代码:一个能直接用的输出管线
十一、判据:把输出契约当成 API 契约来治
十二、上线前的检查清单
十三、把这篇的发现折算成钱
十四、和这个系列其它篇的关系
十五、常见问题
十六、小结
数据时效声明与版权成本
参考资料
工单智能分诊上线第三个月,运维群里出现一条很平静的消息:
「上周有 17 条用水类的工单,派给了道路组。系统没有任何报错。」
我去翻了这批请求的日志。解析成功率 100%。每一条输出都是合法 JSON,每一个字段类型都对,schema 校验全绿,业务代码一次异常都没抛。contact 字段有值,priority 是 1 到 5 的整数,deadline_days 也都在合理区间。
可这批工单里,有 17 条的 category 填错了。
这就是结构化输出的真相:它能给你一个完美的"格式正确",同时把"内容是错的"这件事藏得严严实实。而这篇文章要讲的,是为什么——以及怎么把它从"看不见"变成"看得见"。
一、结构化输出被严重低估了
做 AI 功能时,大家最舍得花时间的地方通常是提示词、模型选型、检索质量。而"让它返回 JSON"这件事,往往被当成一行代码的事:
|
TypeScript |
|
const result = JSON.parse(await callModel(prompt)); |
这句话里藏着三个默认假设:
假设一:只要能解析,就说明这次调用是成功的。 假设二:schema 写得越严格,系统就越安全。 假设三:解析失败就重试,或者自动修一下就好。
这篇文章会用五组可复现的本地实验,一条条拆掉这三个假设。所有实验都在你本机上跑得出来,不依赖任何 API,也不需要花一分钱——这是这个系列一贯的规矩:先把自己能验证的东西验证到底,再去谈别人的经验。
二、先看清楚:结构化输出在整条链路里的位置
一个 AI 功能大致分四层:
|
层 |
干什么 |
出错的典型表现 |
本系列哪一篇讲过 |
|
输入层 |
把用户的话 / 图 / 语音变成文本 |
语音识别同音错字、图片糊 |
第 9 、 10 篇 |
|
上下文层 |
决定给模型看什么 |
越聊越贵、越聊越傻 |
第 13 篇 |
|
调用层 |
决定用哪个模型、调什么工具 |
降级比不降级更贵 |
第 4 、 14 、 15 篇 |
|
输出层 |
把模型的话变成程序能用的数据 |
格式对但值错 |
本篇 |
前三层都有人认真写过。输出层没有。
原因也很容易理解:输出层看起来最没有技术含量。它不像检索有向量、不像路由有策略、不像工具调用有协议。它就是"把一段文本变成对象"。
但恰恰因为它简单,它成了唯一一层没有任何人盯着的地方。检索不准会有人投诉"答得不像",路由错了会有人发现账单涨了,而输出层错了——系统安静得像什么都没发生。
三、三个直觉,三条岔路
在开始实验之前,先把结论摆在前面。这三个结论都和直觉相反,而每一个我都有实测数据撑着。
直觉一:「只要 JSON 能解析就没事」。 实测:20 条坏输出里,只做 JSON.parse 能"成功"10 条;而这 10 条里,7 条的值是错的。解析成功率 50%,但既通过校验、值又正确的只有 2 条。
直觉二:「schema 写得越严格越安全」。 实测:60 条样本、6 类错误,用最严格的 schema(additionalProperties:false + 全部约束)仍然漏过 33.3%;而最常见的写法漏过 50.0%。更要命的是——最严格的 schema 会让"加一个可选字段"这种无害变更变成硬失败。
直觉三:「解析失败就重试或自动修」。 实测:修复回合天生比首轮贵 23.6%(你要把坏输出和报错再发一遍)。而越"宽容"的自动修复,越容易把「会被发现的解析失败」转化成「永远不会被发现的错值」。
后面五章,一章一个实验。
四、实验台:怎么做的,为什么可信
先把可信度交代清楚。这五组实验全部在本地跑,用的都是业界标准工具,不是我自己写的"看起来对"的模拟器:
|
工具 |
用途 |
为什么选它 |
|
jsonschema 4.26.0 |
校验输出是否符合 schema |
Python 官方生态的 JSON Schema 参考实现, Draft 2020-12 |
|
gpt-tokenizer |
统计真实 token 数 |
上一篇文章(成本账)用过的同一套计数器,口径一致 |
|
Node.js 22 |
跑真实下游管线 |
断言 " 静默 " 必须有真实运行时行为,不能靠推演 |
|
纯手写语料 |
60 条 + 20 条 + 25 条样本 |
场景沿用本系列的村务工单分诊,每一条都是真实会出现的输出 |
数据来源声明:本篇所有百分比、条数、token 数均来自 lab/ 目录下五组脚本的实跑输出(2026-10-06),可逐条复现。模型单价沿用本系列第 8 篇的口径。本篇不涉及任何线上 API 调用,因此不包含模型版本的时效性风险——测的是工具与协议的行为,不是某个模型某一天的脾气。
五、实验一:JSON Schema 到底拦得住什么
这是整篇的地基。如果这一步的结论是错的,后面所有的策略都会建立在错误的假设上。所以我先用 60 条样本,把 schema 的能力边界精确量出来——它拦得住什么、拦不住什么、以及那条分界线到底画在哪里。
5.1 怎么设计样本
我按"错误发生在哪一层"造了 6 类样本,每类 10 条,共 60 条:
|
类别 |
错误类型 |
举例 |
|
A |
结构错误 |
缺必填字段、顶层是数组、 category 为 null |
|
B |
类型错误 |
priority 是字符串 "4" 、 need_onsite 是布尔以外的值 |
|
C |
范围格式错误 |
priority=9 越界、电话格式不对、 summary 空串 |
|
D |
业务语义非法 |
当天上门却说不用到场、爆管却给最低优先级 |
|
E |
多余字段 / 拼错重名 |
结果里多带 reasoning 、多带 contect |
|
F |
枚举选错 |
category 填 " 道路 " ,但描述的是水管爆裂 |
然后用两版 schema 逐条校验:
- 默认写法:老老实实写 properties、required、enum、pattern,不写 additionalProperties。
- 最严格写法:在默认写法上补 additionalProperties: false。
5.2 结果
|
错误类型 |
默认写法漏过 |
最严格写法漏过 |
|
A 结构错误 |
0 / 10 |
0 / 10 |
|
B 类型错误 |
0 / 10 |
0 / 10 |
|
C 范围格式错误 |
0 / 10 |
0 / 10 |
|
D 业务语义非法 |
10 / 10 |
10 / 10 |
|
E 多余字段 / 拼错重名 |
10 / 10 |
0 / 10 |
|
F 枚举选错 |
10 / 10 |
10 / 10 |
|
合计漏过 |
30 / 60 = 50.0% |
20 / 60 = 33.3% |
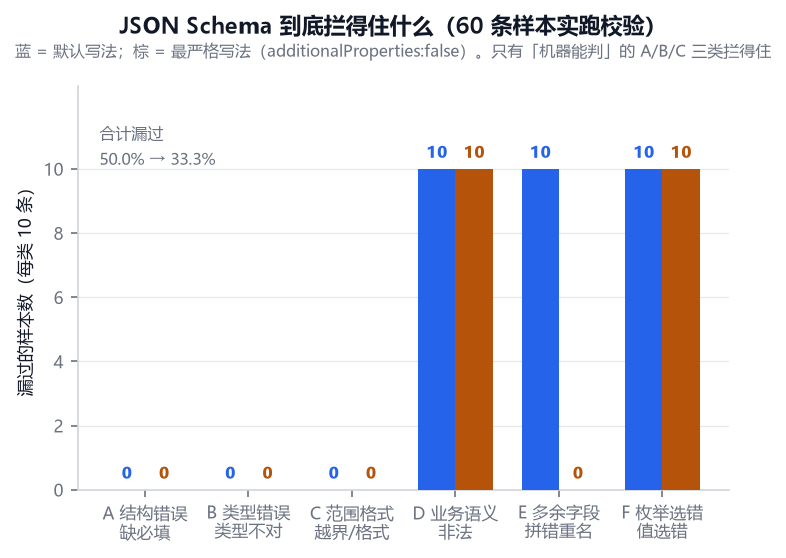 schema 约束覆盖边界
5.3 这张表在说什么
能被拦下的只有 A、B、C 三类:结构、类型、范围格式。 全是"机器能判"的东西——不需要懂业务,只要对着规则比就行。
拦不住的是 D 和 F 两类:业务语义、枚举选错。 这两类有个共同点:它们的答案不在 schema 里。
看几条具体的:
|
JSON |
|
{"category": "其他", "priority": 1, "summary": "水管爆了水淹到路上", "location": "村东头", "need_onsite": true, "contact": "13800138000", "deadline_days": 0} |
这条 JSON:类型全对、范围全对、必填全齐、category 在枚举里、电话符合 pattern。两版 schema 都判它合法。
可它同时犯了三个业务错误:真正的问题是水管(该填"用水"不是"其他");爆管属于最紧急却给了最低优先级;说好当天上门但跨村维修当天到不了。
|
JSON |
|
{"category": "道路", "priority": 4, "summary": "家里水管爆了流了一地", "location": "村东头", "need_onsite": true, "contact": "13800138000", "deadline_days": 2} |
这条也一样。category 是"道路",是枚举里的合法值,schema 只能确认"它是个合法分类",没法确认"它是对的分类"。
这就是 D/F 两类拦不住的根因:schema 校验的是"值是否属于允许集合",不是"这个值是否描述了事实"。
|
实测输出 |
|
实测输出(exp1) ======================================================= 默认写法 漏过 30/60 = 50.0% 最严格写法 漏过 20/60 = 33.3% 其中 D 类(业务语义)与 F 类(枚举选错)合计 20 条 在两版 schema 下**全部漏过**,拦截率 0.0% ======================================================= |
|
别急着抄:很多人看到这里的第一反应是"那就把所有能加的约束都加上,把 schema 写复杂"。先别。实验三会告诉你,把 schema 写严有它自己的代价,而且这个代价比你想的更贵——它会让无害的变更变成硬故障。另外还有一层更隐蔽的: |
|
JSON |
|
{"category": "用水", "priority": 4, "summary": "村东头水管漏水半天了", "location": "村东头", "need_onsite": true, "contact": "13800138000", "deadline_days": 2, "reasoning": "用户描述的是供水问题"} |
这条数据本身完全正确。它只是多带了一个模型自己的思考过程。在默认写法下它通过;在 additionalProperties:false 下它被拦下——而它其实是无害的。严格和正确,是两件事。
5.4 那 D 类和 F 类怎么办:把它们从"语义"挪到"结构"
既然 schema 判不了业务语义,一个务实的做法是:把能量化的那部分语义,搬进 schema 里。
以 priority 为例。原来它是 1..5 的整数,这个取值范围什么都说明不了。但如果我们在 schema 里把"业务规则"显式写出来,模型就必须自证:
|
JSON |
|
{ "type": "object", "required": ["priority", "need_onsite", "deadline_days", "priority_basis"], "properties": { "priority": { "type": "integer", "minimum": 1, "maximum": 5 }, "need_onsite": { "type": "boolean" }, "deadline_days": { "type": ["integer", "null"], "minimum": 0, "maximum": 30 }, "priority_basis": { "type": "string", "enum": ["爆管漏水停电等急件", "影响多人通行", "影响单户", "建议改进"] } } } |
加一个 priority_basis,逼模型把"它凭什么这么定级"说出来。这一步能自动发现的错误很具体:
|
原来看不见的错误 |
加了 priority_basis 之后 |
怎么发现 |
|
爆管却给最低优先级 |
模型写 " 爆管漏水停电等急件 " 却给 priority=1 |
两条规则冲突,可以写断言 |
|
说不用到场却要求现场 |
need_onsite=false 但 basis 是 " 急件 " |
交叉校验 |
|
当天上门但跨村维修 |
deadline_days=0 且 basis 是 " 影响多人 " |
规则拦截 |
关键不在这个字段本身,而在于它把"隐含的业务判断"变成了"必须显式说出的一小段文本"。 显式的文本能被规则匹配、能被抽样人工复核、能进评测集;而一个孤零零的 3 什么也做不了。
这也是 D 类和 F 类唯一务实的治理方向:不是让 schema 更严格,而是让"业务依据"变成输出的一部分。当然,这有代价——每次请求多几个字段,按实验四的口径会多花一点钱。所以要用在真正贵的那几个字段上,不是全量铺开。
六、实验二:字段被拼错取代时,四道关全部放行
上一个实验讲的是"值错了但结构没问题",这一个讲的是更土、也更常见的一类:结构本身就没对上,但校验器看不出来。它的危险不在于错得多,而在于整条链路上没有任何一层会喊。
6.1 这一节的问题更"土",但更常见
上一个实验讲的是"值错了"。这一个讲的是字段名错了。
模型把 contact 写成 contect、把 need_onsite 写成 needOnsite、把 deadline_days 写成 deadlineDays——这在真实场景里极其常见,尤其是模型被"顺手"换成另一个版本之后。
关键在于被拼错的是不是必填字段:
- 拼错必填字段 → 等于缺字段 → 结构校验会拦(甚至不用 additionalProperties)。
- 拼错非必填字段 → 必填都还在 → 结构校验完全通过。
我造了 5 条这样的输出,然后把它送进一条真实的 Node 下游管线:
|
TypeScript |
|
// 下游:把分诊结果写库 + 发短信通知 function toRow(o: any) { return { category: o.category, priority: o.priority, summary: String(o.summary || '').trim(), location: String(o.location || '').trim(), contact: String(o.contact || '').replace(/\D/g, ''), deadline_days: Number(o.deadline_days ?? 3), }; } const row = JSON.parse(raw) as Triage; // 类型断言:运行时零校验 |
6.2 结果
|
样本 |
默认写法 |
最严格写法 |
|
contact 被 contect 取代 |
通过 |
拦下 |
|
location 被 loction 取代 |
通过 |
拦下 |
|
deadline_days 被 deadline 取代 |
通过 |
拦下 |
|
location 被 Location 取代 |
通过 |
拦下 |
|
deadline_days 被 deadlineDays 取代 |
通过 |
拦下 |
|
漏过合计 |
5 / 5 |
0 / 5 |
而下游的真实运行结果:
|
指标 |
数值 |
|
静默错误(无异常、无日志、值已错) |
5 / 5 |
|
抛出异常(可见) |
0 |
|
字段静默丢失(变空串 / 默认值) |
5 |
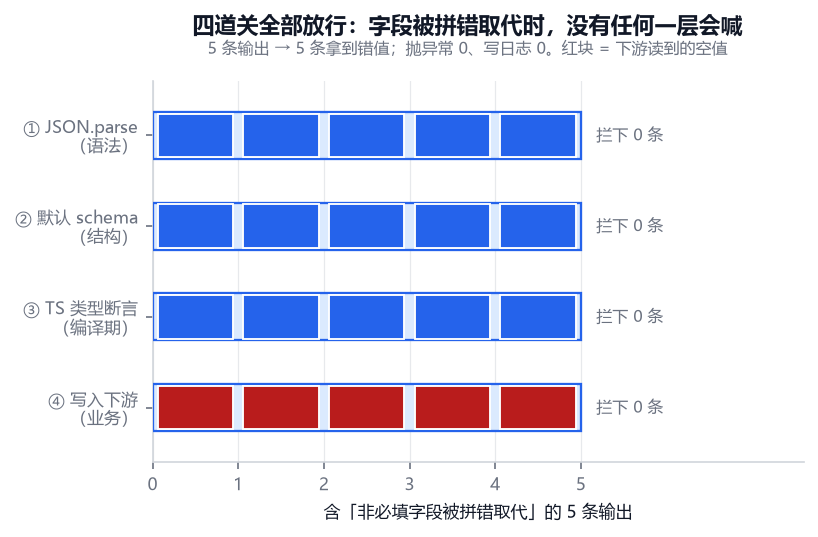 静默链条
具体的样子:
|
实测输出 |
|
实测输出(exp2 · Node 实跑) canonical → 期望 13800138000 实得 "" location → 期望 村东头 实得 "" deadline → 期望 2 实得 3 ======================================================= 5 条输出 → 5 条拿到错值;抛异常 0、写日志 0 |
contact 变成空串的后果是:短信发不出去,而系统认为已经通知过了。deadline_days 被默认值 3 覆盖的后果是:一个本该 2 天的工单,系统显示 3 天。
|
真正危险的地方:注意这四道关的顺序——JSON.parse管语法,schema 管结构,TS 类型断言管编译期,业务代码管取值。四道关全都不检查"字段名的拼写是否语义正确",因为它们都只认"这个名字在不在允许集合里"。而contect 这个名字,在不写 additionalProperties的 schema 里属于"额外字段",默认是允许的。 |
这里要澄清一个常见误解:TypeScript 的类型断言 as Triage 在运行时什么都不做。它不是校验器,它是一句"相信我,这个类型是对的"。编译期类型和运行时数据之间那道缝,就是上面这 5 条错值掉下去的地方。
6.3 字段拼错是可以在 CI 里拦住的
这一类错误的可爱之处在于:它有一个完全不依赖模型的一致性判据。同一个字段名,在三个地方出现——schema、TS 类型、下游取值代码。只要这三处对齐,拼错就会被抓住。
一个几行就能跑的检查,比任何"提示词里再强调一遍字段名"都可靠:
|
TypeScript |
|
// 从 schema 里取出所有属性名,与 TS 类型和取值代码做三方比对 const schemaFields = Object.keys(TRIAGE_SCHEMA.properties); const typeFields = readTypeFields('src/types/triage.ts', 'Triage'); const usedFields = readAccessorFields('src/domain/triage.ts', 'toRow'); for (const f of schemaFields) { assert(typeFields.includes(f), `TS 类型漏了字段 ${f}`); } for (const f of usedFields) { assert(schemaFields.includes(f), `下游用了 schema 里没有的字段 ${f}`); } |
最后那一条断言才是重点。它能抓住两种真实事故:
- 下游写错了字段名:代码里写 o.contect,而 schema 里是 contact。这类错在 TS 里会因为索引访问而静默通过(尤其是下游用了 any)。
- 契约改了但下游没跟上:schema 里 summary 改名成 description,而下游还在读 o.summary —— 正是实验三 CH3 那一格。
这类检查的价值在于它不依赖运行时数据。 前面说的"静默错必须靠线上统计才能发现"是针对语义错的;而字段名这一层,完全可以在 CI 里用静态比对做到"一旦错就红"。这是整套方案里性价比最高的一道防线,建议先做这一条。
七、实验三:契约一变,20 格里 11 格是静默失败
前两个实验说的是"单次输出可能出错"。这一节说的是线上最难排查的那一类事故:代码没改错、模型没变笨、schema 也没写错,只是契约动了。下面这张矩阵,是这个系列写到第十六篇以来我最想让你看的一张表。
7.1 为什么这一节最重要
前两个实验讲的是"单次输出可能错"。这一节讲的是线上最常见、也最难排查的一类事故:契约变了。
场景你一定遇到过:产品说要在结果里加一个字段;或者要把 summary 改名成 description;或者分类要新增一个类别。改动本身可能只有三行,但老客户端还在线上跑。
我设计了 5 种典型变更 × 4 种常见客户端行为,一共 20 格,每一格判三种结果:正常 / 可见失败 / 静默失败。
四种客户端:
|
代号 |
行为 |
说明 |
|
C1a |
严格 schema 校验 |
additionalProperties:false + 全约束,不合规就拒绝 |
|
C1b |
宽松 schema 校验 |
只查 required 与 type ,不写 additionalProperties |
|
C2 |
无校验 + 默认值兜底 |
JSON.parse 后直接取值,缺了给默认 |
|
C3 |
无校验 + 无兜底 |
undefined 直接往下传 |
7.2 结果
|
契约变更 |
C1a 严格 |
C1b 宽松 |
C2 无校验 + 默认 |
C3 无校验 + 无兜底 |
|
加一个必填字段 |
可见 |
静默 |
静默 |
静默 |
|
加一个可选字段 |
可见 |
正常 |
正常 |
正常 |
|
字段改名 summary → description |
可见 |
可见 |
静默 |
静默 |
|
枚举新增一个值 |
可见 |
可见 |
静默 |
静默 |
|
值域收窄 1-5 档 → 1-3 档 |
静默 |
静默 |
静默 |
静默 |
|
合计(20 格) |
可见 6 · 静默 11 · 正常 3 |
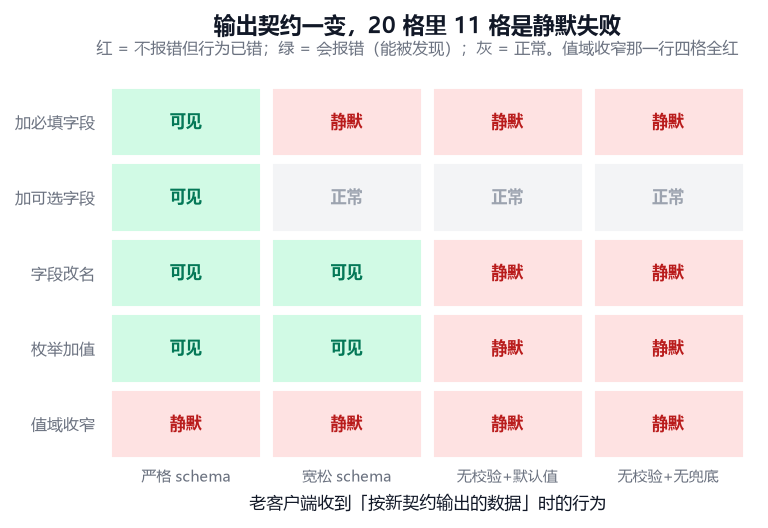 契约演进兼容矩阵
7.3 三个反直觉的发现
发现一:静默失败占 55%。 20 格里 11 格是"不报错、不告警,只是行为悄悄不对了"。
发现二:「加一个可选字段」这一行,四格里唯一失败的是最严格的那个客户端。
这一条值得单独说。加一个可选字段,在语义上是完全向后兼容的变更——老客户端不认识它,忽略就好。C1b / C2 / C3 都正常。可 C1a 报错了,因为 additionalProperties:false 把"出现了一个我没声明过的字段"本身判成非法。
于是现实中的剧本是这样的:
|
实测输出 |
|
第 1 步:为了"安全",给所有 schema 都加上 additionalProperties:false 第 2 步:产品加了个字段,严格客户端全线报错,告警刷屏 第 3 步:为了止血,把 additionalProperties 关掉 第 4 步:回到实验一的"默认写法",漏过率从 33.3% 变回 50.0% 第 5 步:E 类(多余字段/拼错重名)从 0 漏过变回 10 漏过 |
越严越不兼容,最后大家都去关它。 这是"严格 schema"这条路最真实的结局——不是被绕过,是被自己人关掉。
发现三:「值域收窄」这一行,四个客户端全部静默。
这一行是我在设计实验时最没想到的。变更内容是:priority 的语义从"1-5 五档"收窄成"1-3 三档",其中 3 代表最紧急 (SLA 0 天)。
而老客户端的调度表是按五档写的:priority=3 在老表里是"中等,SLA 3 天"。
这一格里,没有任何一层会报错:
- schema 校验通过——因为 3 在 1 到 5 之间,完全合法。
- 类型校验通过——整数。
- 业务代码不抛异常——它按老表查到了"3 天",返回了一个合法的数字。
结果是:最紧急的工单,被排到了 3 天后。
|
实测输出 |
|
实测输出(exp3 · 语义漂移) 变更:priority 值域 1-5 档 → 1-3 档(3 = 最紧急) 老客户端:priority=3 在老表里是「中等」,SLA = 3 天 新契约: priority=3 是「最紧急」,SLA = 0 天 四个客户端(严格/宽松/无校验/无兜底)全部通过校验 零报错、零告警 —— 差异只体现在「几天后到场」上 ======================================================= |
|
这一条最容易被忽略:前面几个变更(加字段、改名、加枚举值)都会在数据形状上留下痕迹,你至少有机会用 diff 发现。而"值域收窄"只改了同一个数字的含义——数据形状一模一样,schema 一模一样,类型一模一样。你唯一能发现它的方式,是有人告诉你"上周有三条爆管工单排到了三天后"。 |
给这条变更的处置建议:凡是会改变"同一个值含义"的契约变更,都不要复用原来的字段。要么换字段名(priority → urgency_level),要么换成字符串枚举("P0" / "P1" / "P2")。让语义变化在数据形状上可见,这是最便宜的一道保险。
八、实验四:失败率的真实成本
前面三节讲的是"会不会错、错在哪一层"。这一节换一个角度:错了以后要花多少钱。结论会有点反直觉——真正的成本大头从来不是那几次重试,而是每次请求都要重发一遍的那段固定前缀。
8.1 先看清楚一次请求的钱花在哪
用 gpt-tokenizer 对真实的请求体做计数(场景同本系列,村务工单分诊):
|
部件 |
tokens |
|
system prompt |
111 |
|
小 schema ( 7 个字段) |
249 |
|
大 schema ( 32 个字段) |
884 |
|
用户真正的输入 |
42 |
|
修复回合:坏输出 |
45 |
|
修复回合:报错文本 |
29 |
|
修复回合:指令 |
21 |
算一下就很难受了:
|
实测输出 |
|
实测输出(exp4 · 真实 token 计数) 小 schema 前缀 = 111 + 249 = 360 tokens 单次请求输入 = 360 + 42 = 402 tokens 前缀占比 = 360 / 402 = 89.6% 大 schema 前缀 = 111 + 884 = 995 tokens 单次请求输入 = 995 + 42 = 1037 tokens 前缀占比 = 995 / 1037 = 95.9% ======================================================= 一次请求里,90% 的钱花在「把你的要求再说一遍」上 只有 10.4% 花在真实内容上(42 tokens 的用户输入) ======================================================= |
用户真正说的话只有 42 tokens,比 schema 本身小 5.9 倍。
8.2 失败一次的代价
这里有个很朴素但常被忽略的事实:要让模型改错,你必须把"错的东西"和"为什么错"再发一遍。
|
回合 |
输入构成 |
tokens |
|
首轮 |
前缀 + 用户输入 |
402 |
|
修复回合 |
前缀 + 用户输入 + 坏输出 + 报错 + 指令 |
497 |
|
放大倍数 |
497 / 402 |
1.236 倍 |
所以重试不是"免费再来一次",它天生比第一次贵 23.6%。
8.3 成本放大曲线
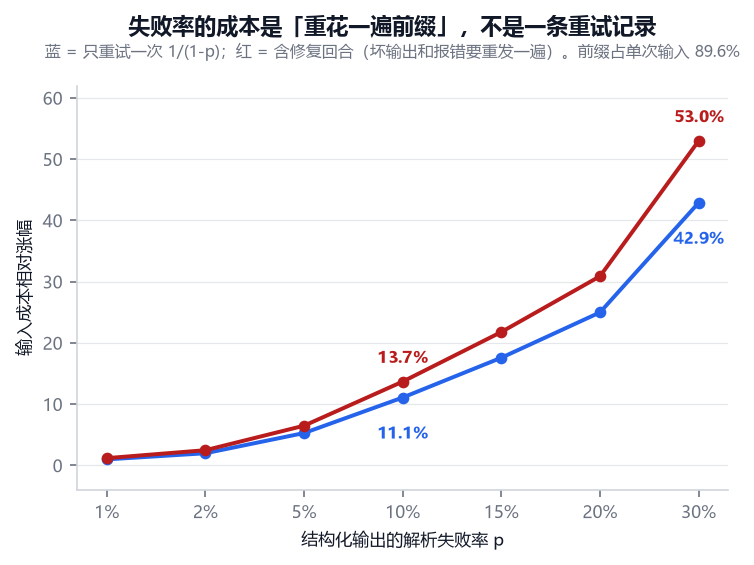
设失败率 p,期望调用次数是 1/(1-p);如果每次失败都触发一个修复回合,放大倍率是:
|
实测输出 |
|
放大 = 1 + p/(1-p) × (修复回合成本 / 首轮成本) = 1 + p/(1-p) × 1.236 |
|
失败率 p |
只重试一次 1/(1-p) |
含修复回合 |
|
1% |
+1.0% |
+1.2% |
|
2% |
+2.0% |
+2.5% |
|
5% |
+5.3% |
+6.5% |
|
10% |
+11.1% |
+13.7% |
|
15% |
+17.6% |
+21.8% |
|
20% |
+25.0% |
+30.9% |
|
30% |
+42.9% |
+53.0% |
 失败率的成本放大
|
记住这一句:失败率 10% 听起来是个"很小"的数,但成本要多花 13.7%;失败率 30% 时要多花 53.0%。而这里的放大是乘法意义上的——它不是在原成本上加一条重试记录,而是把占 89.6% 的固定前缀重花一遍。 |
这也解释了为什么"把 schema 写小"很值钱: 大 schema 的前缀是 995 tokens,是小的 2.77 倍(995 / 360)。而每次失败触发的修复回合,都要把这份更大的前缀重发一次。失败率不变的情况下,大 schema 的每一次失败都更贵。
8.4 大 schema 的另一重代价:约束点
我顺手数了一下两个 schema 的"约束点"(每一个 type / enum / minimum / maxLength / pattern / required 条目都算一个):
|
指标 |
小 schema |
大 schema |
倍数 |
|
属性数 |
7 |
32 |
4.57x |
|
约束点总数 |
21 |
66 |
3.14x |
|
schema tokens |
249 |
884 |
3.55x |
|
单次请求输入 tokens |
402 |
1037 |
2.58x |
每多一个约束点,就多一个"模型可能违反"的机会。 而每一次违反,都要按上一节的倍率重花一遍前缀的钱。所以"把 30 个字段一次全塞进一个 schema"这种写法,是同时在两个方向上变贵:一次更贵,而且更容易失败。
8.5 前缀缓存能救回多少
上一节的数据其实指向一个好消息:前缀占 89.6%,而前缀是固定的。固定前缀是所有请求里逐字节相同的一段,天生就是缓存(prompt cache)的理想对象。理论上,命中缓存的输入按更低的单价计费,能把"重发一遍前缀"这件事的伤害压下去。
但这里有两个必须认清的边界:
第一,缓存是按「模型 + 前缀」隔离的。 本系列第 15 篇(多模型路由)实测过一个反直觉的结论:把一个模型换成价格完全相同的另一个模型,总成本仍然贵 24.3%——因为前缀全部未命中,缓存资产直接归零。所以路由策略和缓存策略是耦合的,不能分开设计。
第二,修复回合的前半段仍然可以命中缓存。 修复回合的输入结构是「前缀 + 用户输入 + 坏输出 + 报错 + 指令」,它的开头还是那段一模一样的前缀。所以只要缓存粒度覆盖到前缀,修复回合真正按全价计费的就只有后面那段尾巴(用户输入 42 + 坏输出 45 + 报错 29 + 指令 21 = 137 tokens),而不是整个 497。
|
实测输出 |
|
实测数据(exp4 · 修复回合的两段结构) 修复回合输入 = 497 tokens ├─ 固定前缀 360 tokens ← 与首轮逐字节相同,可命中缓存 └─ 新增尾巴 137 tokens ← 只有这段按全价计费 ======================================================= 所以第八节的放大倍率 1.236 是**没有缓存**时的上限; 有缓存时,修复回合的实际增幅会显著低于这个数 |
这一节的实际行动项:如果你的网关或框架支持 prompt cache,那么"把 system prompt 和 schema 放在最前面、且保证逐字节稳定",是一件立刻能省钱的事。反过来说——任何会让前缀抖动的改动(换模型、改 schema 措辞、调 system prompt 的标点),都会把缓存打掉。
九、实验五:好心修复的代价
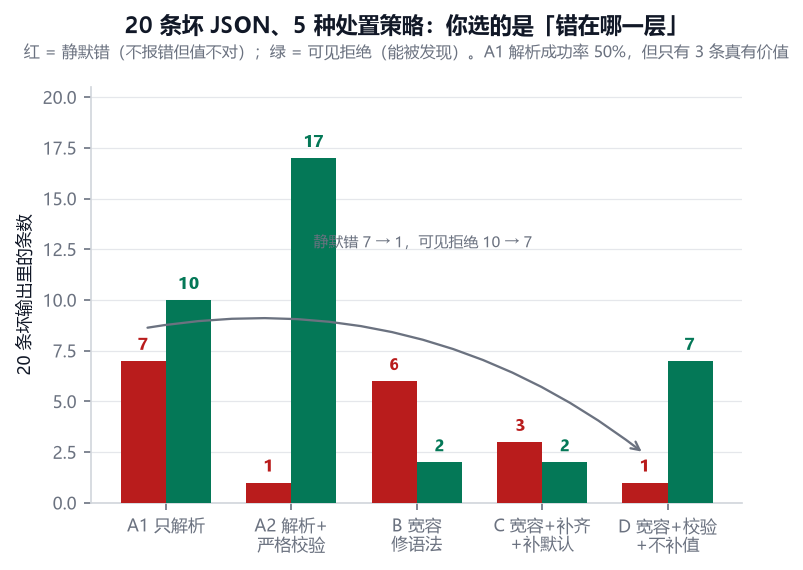
最后一个实验,也是最能直接影响你明天写代码方式的一个。"解析失败就修一下"几乎是所有团队都会做的事,问题只在于修到哪一层为止。我造了 20 条真实的坏输出,用 5 种典型策略分别处理,然后把结果按四个互不相同的口径分别统计——你会发现"修得更宽容"和"错得更安静"经常是同一件事。
9.1 现实里最常见的五种处置
解析失败之后,工程上一般有五种做法。我造了 20 条真实的坏输出(尾随逗号、代码块包裹、单引号、裸键名、JS 注释、URL、截断、全角引号、NaN、外层套数组……),然后分别用五种策略处理。
这里最关键的是把口径分开——很多人把三个不同的指标混成一个:
- 拿到对象:解析成功了(说明不了任何事)
- 通过校验:拿到的是对象且符合严格 schema
- 值正确:与真实意图一致
- 静默错:下游接受了它,但值与真实意图不符 ← 这一列才是要命的
9.2 结果
|
策略 |
拿到对象 |
通过严格校验 |
值正确 |
静默错 |
可见拒绝 |
|
A1 只解析(拿到就用) |
10 |
3 |
3 |
7 |
10 |
|
A2 解析 + 严格校验(拒绝) |
3 |
3 |
2 |
1 |
17 |
|
B 宽容修语法 |
18 |
13 |
12 |
6 |
2 |
|
C 宽容 + 类型补齐 + 补默认 |
18 |
16 |
15 |
3 |
2 |
|
D 宽容 + 严格校验 + 不补值 |
13 |
13 |
12 |
1 |
7 |
 五种处置策略对比
9.3 逐个读这张表
A1「只解析」是最会骗人的策略。
|
实测输出 |
|
实测输出(exp5 · A1 只解析) 拿到对象 10 / 20 —— 看起来解析成功率 50%,还不错 其中值正确的只有 3 条 既通过校验、值又正确的只有 2 条 另外 7 条:不报错、不告警、下游照常用 ======================================================= |
它是现状里最常见的写法(JSON.parse 加一句 as Triage)。而它的真实产出率是 2 / 20。
A2「解析 + 严格校验」把静默错从 7 压到 1,代价是拒绝率飙到 85%。 20 条里拒 17 条——因为真实模型输出里"尾随逗号""被代码块包住"这种事太常见了,全部让人重试,体验会很差。
B「宽容修语法」是对的方向,但不够。 拒绝从 17 降到 2,静默错 6 条——因为它不管类型:priority 还是字符串 "4",need_onsite 还是字符串 "true",deadline_days 干脆不见了。
C「宽容 + 类型补齐 + 补默认」——这一层的风险变了性质。
C 的静默错降到 3 条,看起来最好。但这 3 条的性质和前面的都不一样:
|
实测输出 |
|
实测输出(exp5 · C 策略的静默错,逐条) ① deadline_days 缺失 → 补默认 3;而真值是 2 ② priority = NaN → 归零;而真值是 4 ③ 截断在字符串中间 → 兜底抽取,把残缺的 summary 当完整的 ======================================================= 这 3 条不是「没修好」,是「工具替模型编造了数据」 |
第一条最典型。deadline_days 缺失时,代码里写着 o.deadline_days ?? 3——一个看起来非常贴心、非常"健壮"的默认值。可模型没给这个字段,说明它不知道。用一个默认值把它填上,等于让系统假装"我知道,是 3 天"。
D「宽容修语法 + 严格校验 + 绝不补值」是这五条路里的正解。
静默错 1 条、可见拒绝 7 条。拒绝数比 A2 的 17 条少了 59%——因为宽容修语法把"本来不该让人重试的"(尾随逗号、代码块、单引号)救回来了;而静默错几乎归零——因为不替模型补任何值。
9.4 D 还剩的那 1 条静默错,暴露了最后一个坑
D 唯一剩下的静默错是这一条:
|
实测输出 |
|
整个 deadline_days 缺失 → 通过严格 schema → 静默错 |
为什么?因为 deadline_days 没写进 required。schema 说"这个字段随便,有就有、没有就没有",于是"没有"是合法的,下游只好用"没有"。
这条给出的行动项非常具体:凡是下游会用到、缺失就会出错的字段,不管业务上是不是"可选",都要写进 required——哪怕它允许显式 null。
|
JSON |
|
{ "required": ["category", "priority", "summary", "location", "need_onsite", "contact", "deadline_days"], "properties": { "location": { "type": ["string", "null"] }, "deadline_days": { "type": ["integer", "null"], "minimum": 0, "maximum": 30 } } } |
区别在这里:"type": ["string", "null"] 要求模型显式表态——要么给值,要么明确说"我不知道"。而"字段直接消失"是一种沉默,沉默是无法被校验的。把沉默变成显式表态,这一层就补上了。
9.5 一张"该不该修"的判据表
"修复"这个词太笼统了。实际写代码时,你面对的是一个个具体决定。把上面的结论落实成一张可以贴在工位上的判据表:
|
你看到的情况 |
修不修 |
为什么 |
|
被 Markdown 代码块包住 |
修 |
这是模型排版的习惯,与数据无关 |
|
首尾多了 " 好的,结果如下 " |
修 |
同上,纯粹是包装 |
|
尾随逗号、单引号、裸键名 |
修 |
语法层问题,改完值不变 |
|
全角引号 “” |
修 |
输入法问题,改完值不变 |
|
结尾少一个 } |
修 |
语法层补全,不影响已写出的字段 |
|
priority 是字符串 "4" |
先别修,交给校验 |
转成 4 看起来没损失,但你放弃了 " 模型没遵守契约 " 这个信号 |
|
deadline_days 整个缺失 |
绝不修 |
补默认值 = 替模型编造数据 |
|
值是 null |
绝不修 |
null 是明确表态 " 我不知道 " ,不该被默认值覆盖 |
|
值是 NaN |
绝不修 |
归零会从一个错值变成另一个错值 |
|
文本在字符串中间被截断 |
绝不修 |
残缺内容被当完整的用,是最典型的静默错 |
规律很清楚:"修"只应该发生在语法层和包装层,"值"这一层一个字都不要碰。
一个便于记忆的边界:修完之后,如果这条数据在你眼里变得"更像一个正确结果"了,那就不该修。 修复的目标是让它"能被程序读",不是让它"看起来对"。
十、落到代码:一个能直接用的输出管线
把上面五个实验的结论合起来,一条可用的管线应该长这样:宽容修语法 → 严格校验 → 绝不补值 → 错误分型埋点。
|
TypeScript |
|
import Ajv from 'ajv'; import addFormats from 'ajv-formats'; const ajv = new Ajv({ allErrors: true, allowUnionTypes: true }); addFormats(ajv); /** 第 1 层:宽容修语法 —— 只动语法,不动语义 */ export function repairSyntax(raw: string): string { let s = raw.trim(); // 去掉 Markdown 代码块围栏 s = s.replace(/^```[a-zA-Z]*\s*/m, '').replace(/```\s*$/m, ''); // 剥掉首尾的解释文字:取第一个 { 到最后一个 } const i = s.indexOf('{'); const j = s.lastIndexOf('}'); if (i >= 0 && j > i) s = s.slice(i, j + 1); // 去尾随逗号 s = s.replace(/,(\s*[}\]])/g, '$1'); // 全角引号与单引号定界符 s = s.replace(/[\u201c\u201d]/g, '"').replace(/'/g, '"'); return s; } /** 第 2 层:解析 —— 失败就是失败,不猜 */ export function parseStrict(raw: string): unknown { const s = repairSyntax(raw); return JSON.parse(s); // 失败 -> 抛错 -> 走可见路径 } /** 第 3 层:严格校验 —— additionalProperties:false 只在这里生效 */ export const validate = ajv.compile(TRIAGE_SCHEMA); export type Outcome = | { kind: 'ok'; data: Triage } | { kind: 'parse_error'; raw: string; detail: string } | { kind: 'schema_error'; raw: string; errors: string[] }; export function normalizeOutput(raw: string): Outcome { let parsed: unknown; try { parsed = parseStrict(raw); } catch (e) { return { kind: 'parse_error', raw, detail: String(e) }; } if (!validate(parsed)) { return { kind: 'schema_error', raw, errors: (validate.errors ?? []).map( (x) => `${x.instancePath} ${x.message}`), }; } return { kind: 'ok', data: parsed as Triage }; // 绝不补值 } |
三个刻意的设计:
第一,repairSyntax 只做语法替换,绝不做类型转换。 它不去改 priority 的值,不加字段,不删字段。语法层和语义层的边界必须守住——实验五里 C 策略踩的就是这条线。
第二,normalizeOutput 不返回"补好默认值"的对象。 校验不过就返回 schema_error,把"缺了什么"原样报上去。宁可让这一条工单走人工,也不要让系统用一个编造的默认值假装成功。
第三,错误分型要按类型埋点。 这是把"静默"变"可见"的关键一步:
|
TypeScript |
|
/** 第 4 层:错误分型埋点 —— 让静默错有机会被看见 */ function record(outcome: Outcome, ctx: { taskId: string }) { const base = { taskId: ctx.taskId, at: Date.now() }; switch (outcome.kind) { case 'ok': metrics.inc('struct.ok'); break; case 'parse_error': metrics.inc('struct.parse_error'); logger.warn('output.parse_error', { ...base, detail: outcome.detail }); break; case 'schema_error': metrics.inc('struct.schema_error'); // 关键:把错误路径打散,才能看出是哪一类问题在涨 for (const e of outcome.errors) { metrics.inc('struct.field_error', { path: e.split(' ')[0] }); } break; } } |
|
落到代码上:很多人只统计一个 struct_fail_rate。那样你只能知道"失败变多了",不知道"哪一类失败变多了"。把schema_error 按字段路径打散(/deadline_days 涨了,还是 /contact涨了),你才能在看板上看出"这个模型最近开始漏deadline_days"这种事。 |
十一、判据:把输出契约当成 API 契约来治
五个实验的结论可以压成五条硬规矩:
|
规矩 |
具体做法 |
为什么 |
|
① 校验必须在运行时 |
别用 as 断言顶替校验 |
TS 断言在运行时什么都不做 |
|
② 语法宽容,语义严格 |
修语法可以,改值不行 |
实验五: C 策略的错全是 " 替模型编造 " |
|
③ 不补默认值 |
缺字段就报缺字段 |
默认值会把 " 不知道 " 伪装成 " 知道 " |
|
④ 必用字段全写进 required |
可空的写成 ["string","null"] |
实验五: D 唯一残留的静默错来自这里 |
|
⑤ 语义变化要改字段名 |
收窄值域时换新字段或换字符串枚举 |
实验三:值域收窄四格全静默 |
再加一条关于 additionalProperties 的实操建议——它是整个实验里最纠结的一个开关:
不要全局开 additionalProperties:false,而是按"模型输出"和"内部调用"分开对待。
|
场景 |
建议 |
理由 |
|
模型输出(不可信来源) |
开 false |
你确实希望 " 多带思考字段 " 被拦下来,逼团队显式处理 |
|
服务间调用(可信来源) |
不开 |
上游加字段不应该让下游硬失败 |
|
对外 API 响应 |
不开 |
加字段是兼容变更,不该当故障 |
11.1 契约变更需要一个流程,哪怕只有三行
实验三那张矩阵的根因不是技术问题,是流程问题:契约改了,但没人把"老客户端会怎样"过一遍。所以除了上面五条技术规矩,还需要一条很轻的流程——任何 schema 变更,先归到五类里,再决定要不要评审:
|
变更类别 |
兼容性 |
需要的动作 |
|
加可选字段 |
兼容 |
无(但如果开了 additionalProperties:false ,就必须先灰客户端) |
|
加必填字段 |
不兼容 |
必评审:老客户端要能容忍这个字段缺失 |
|
改字段名 |
不兼容 |
必评审:改名 = 删旧 + 加新,等价于两次不兼容 |
|
枚举加值 |
兼容(数据层) |
必评审:下游的 switch 有没有 default 分支 |
|
收窄值域 / 改语义 |
不兼容且不可见 |
强制换字段名 ,不允许复用 |
最后一行是需要重点盯的。前四类变更多少会在数据形状上留痕迹,而"收窄值域"只改了同一个数字的含义。处理方式很简单:不允许原地改语义,要么换字段名,要么换成字符串枚举。 让语义变化在数据形状上可见,成本几乎为零,收益是省掉一整类无法排查的线上事故。
十二、上线前的检查清单
结构化输出相关的检查,可以按这张清单逐条过:
- 每个 AI 功能的输出,都有独立的 schema 文件吗? 而不是散在代码里的 TS interface。
- schema 里 required 是否覆盖了所有下游会用到的字段? 包括业务上"可选"的那些。
- 有没有一个测试用例,专门验证"多一个未声明字段"的行为? 这个行为必须是你选择过的,不是默认碰巧如此的。
- 解析失败的分类埋点里,有没有按字段路径打散?
- 修复逻辑里有没有 ?? 默认值 这种写法? 有的话,逐条问:"如果模型没给这个字段,我凭什么能替它填?"
- schema 变更有没有对应的兼容性评审? 特别标记出"值域收窄""语义变更"这两类。
- 失败的输出有没有落盘留样? 不复现的错修不了;留样是唯一能让"静默错"变成"可分析"的手段。
- 线上有没有在算"值正确率"? 如果只有解析成功率和 schema 通过率,那 55% 的静默失败你一个都看不见。
这八条里,第 5 条和第 8 条是最容易被跳过的,也是回报最高的两条。
第 5 条的理由在实验五里写得很清楚:?? 默认值 这种写法在代码评审时几乎不会被质疑——它看起来是"防御性编程",是"健壮"。但它恰好是"工具替模型编造数据"的主要入口。每一次写默认值,都应该能回答"如果模型没给这个字段,我凭什么能替它填"这个问题。 如果答不上来,那就不是防御,是伪装。
第 8 条是整篇的落脚点。结构化输出的失败模式里,能被 try/catch 抓住的只是少数;大多数失败是"下游收到了一个格式完美、内容错误的对象"。能反映这一切的只有一个指标:在你有把握判断的那部分请求上,算一下"值正确率"是多少。 这个指标不需要全量算——抽样几百条,人工标一遍,就能得到一个稳定得多的信号,比盯着解析成功率有用得多。
十三、把这篇的发现折算成钱
沿用本系列一贯口径,按 1 万次分诊请求估算。假设小 schema 前缀 360 tokens、用户输入 42 tokens:
|
项 |
计算 |
结果 |
|
基准输入量 |
10000 × 402 |
4,020,000 tokens |
|
失败率 10% 、只重试 |
4.02M × 0.111 |
+446,220 tokens |
|
失败率 10% 、含修复回合 |
4.02M × 0.137 |
+550,740 tokens |
|
换成大 schema (前缀 995 ) |
10000 × 1037 |
10,370,000 tokens |
|
大 schema 的输入增幅 |
10.37M / 4.02M |
+157.9% |
最贵的一条不是重试,是把 schema 写大。 大 schema 让输入量涨 157.9%——而这笔钱花在"把 32 个字段的定义每次都说一遍"上。
再加一句关于"看不见"的成本:实验五里,C 策略(宽容+补默认)看起来最"健壮",静默错只有 3 条。但如果这 3 条落在 deadline_days 这种字段上,代价就不是 token 了——一个爆管工单被排到 3 天后,这个成本不在账单上。
所以这一节的表只能算一半的账。另一半是:
|
静默错的落点 |
看得见的成本 |
看不见的成本 |
|
summary 被截断 |
无 |
归档关键词缺失,检索命中率下降 |
|
location 变空串 |
无 |
派单靠电话确认,人工成本上升 |
|
category 选错 |
无 |
派错班组,一次往返的人力与时间 |
|
deadline_days 变默认值 |
无 |
SLA 失真,急件被排队 |
|
contact 被拼错 |
无 |
通知发不出去,而系统认为已通知 |
这张表的每一行,成本都不在 token 账单上。 这是结构化输出最容易被低估的地方:它的失败不会让你多花钱,它会让你以为一切正常。
十四、和这个系列其它篇的关系
本篇不是孤立的。结构化输出这一层,和前后几篇都有直接的接口——尤其是工具调用那一篇,工具参数的 schema 校验和这里的输出 schema 校验,本质是同一件事。
|
篇 |
讲的是 |
和本篇的接口 |
|
第 8 篇 成本账 |
单价没变账单却涨了十倍 |
本篇第八节沿用它的大 schema 与缓存口径 |
|
第 13 篇 上下文工程 |
越聊越贵、越聊越傻 |
输出契约是上下文里最容易被污染的一段 |
|
第 14 篇 工具设计 |
Agent 选错工具、填错参数 |
工具参数就是结构化输出的特例 —— 本篇的五个实验全部适用于工具调用 |
|
第 15 篇 多模型路由 |
换模型兜底比不兜底更贵 |
换模型最容易踩的坑就是本篇的实验二 :字段名悄悄变了 |
|
本篇 结构化输出 |
格式对但值错 |
输出契约层 |
如果你正在做工具调用(第 14 篇),本篇的实验二和实验五可以直接照搬——工具参数的 schema 校验和输出 schema 校验是同一件事。
十五、常见问题
Q1:用了约束解码(structured outputs / grammar)是不是就万无一失了?
不。约束解码保证的是语法与结构——它能让输出一定是合法 JSON、一定符合 schema。它保证不了"值是业务上正确的"。这正是实验一里 D 类和 F 类漏过率 100% 的原因:这两类错误在结构上完全合法。约束解码能帮你省掉实验五里"修语法"这件事,但省不掉校验和语义核对。
Q2:那 D 类和 F 类到底该怎么治?
schema 治不了,得靠其它层:
- 交叉校验:category 与 summary 的一致性单独判一次(比如用关键词规则或第二个模型)。
- 置信度显式化:让模型输出 confidence,低于阈值就转人工。
- 影子比对:新旧逻辑并跑,只比对不生效,等差异率稳定再切。
- 可回滚:分诊结果允许人工改派,且改派动作要有记录——这是把静默错变成训练数据的唯一途径。
Q3:为什么不干脆全部人工兜底?
成本。本系列第 15 篇算过:静态规则能省 62% 的模型钱,但误判 9 条之后,含人工兜底的总成本是纯模型的 58.6 倍。人工兜底必须只用在静默错概率最高的那一小撮请求上——所以你需要置信度,而不是全量兜底。
Q4:实验里的样本只有几十条,可信吗?
规模确实小,但这是类型学验证不是统计估计。60 条样本的作用是穷举"错误可能发生在哪一层",而不是估计"线上失败率是多少"。真正该被记住的是分层的结论(哪一层拦得住、哪一层拦不住),这个结论不会因为样本量翻十倍而改变。至于你自己的线上失败率——那必须用你自己的数据测,本篇给的是测量方法。
Q5:additionalProperties:false 到底开不开?
见第十一章的表。一句话:模型输出开,服务间调用和对外响应不开。 而且如果你开了它,就必须接受"加字段 = 硬失败"这个代价,并为此准备一个契约变更流程(加字段时先灰度客户端)。
Q6:这套东西对已经很便宜的模型还有必要吗?
更必要。模型越便宜,你就越会把更多业务交给它;而静默错的代价与单价无关——它取决于这个字段被用在哪里。一条被误分类的工单,代价是派人跑错地方,不是那 402 个 token。
十六、小结
把这篇最值钱的三句话留下:
第一句:「解析成功率」是最会骗人的指标。 20 条坏输出里,只解析能"成功" 10 条,但既通过校验、值又正确的只有 2 条。如果你的看板上只有解析成功率,那你看到的是一片祥和。
第二句:最严格的 schema 不是最安全的,它只是最先崩的。 20 格兼容矩阵里,静默失败占 11 格;而唯一"加一个可选字段"的无害变更,恰恰是最严格的客户端硬失败。现实里的结局是——为了止血把它关掉,然后漏过率从 33.3% 回到 50.0%。
第三句:你真正在选的不是"对不对",而是"错在看得见的地方还是看不见的地方"。 五种处置策略的静默错是 7 / 1 / 6 / 3 / 1,可见拒绝是 10 / 17 / 2 / 2 / 7。最有价值的组合是 D:宽容修语法、严格校验、绝不补值——把拒绝数降到 A2 的 41%,同时把静默错压到 1 条。
最后一个提醒。这个系列写了十五篇,反复出现的主题是同一件事:AI 功能的故障,绝大多数不是"报错",而是"安静地做错了"。结构化输出之所以是其中最脆弱的一环,是因为它处在"必须给程序一个确定的答案"和"模型只会给一个概率性的答案"这两件事的接缝上。
接缝处不需要更聪明的模型,需要更严格的契约。
数据时效声明与版权成本
按这个系列的规矩,把数据来源、时效性、成本口径和版权情况一次交代清楚,方便你判断这些结论能用到什么时候。
- 实验数据:本篇所有数字来自 2026-10-06 在本地实跑的五组实验(lab/exp1.py ~ lab/exp5.py),校验器为 jsonschema 4.26.0(Draft 2020-12 参考实现),token 计数使用 gpt-tokenizer。脚本与原始输出(exp*_out.txt / exp*_out.json)随文保存,可逐条复现。
- 时效性说明:本篇测的是工具与协议的行为(JSON Schema 语义、OAuth 式的契约兼容规则、tokenizer 计数),不是某个模型在某个版本上的表现。因此这批数字的有效期远长于"模型跑分"类数据。若 JSON Schema 规范或 tokenizer 版本发生变更,需重新跑一遍。
- 成本口径:token 单价沿用本系列第 8 篇《AI 成本账》的口径。本篇的"成本放大"是比例性结论(放大倍率、前缀占比),不依赖具体单价,因此单价变动不影响结论。
- 版权与引用:本篇所有样本、代码、图表均为原创,未引用第三方图表或代码。文中提到的 jsonschema、gpt-tokenizer、Ajv 均为开源项目,按其各自许可证使用。
- 写作成本:正文配图 5 张全部由本地 matplotlib 生成,无外部图片生成费用;本篇未使用 AI 生成封面以外的图像资源。
参考资料
以下资料是这篇里所有技术判断的依据。前四条是规范与官方工具,后三条是本系列中与本篇直接相关的三篇。
- JSON Schema 官方规范(Draft 2020-12):applications 一节中 additionalProperties 的默认值为 true。
- JSON Schema 官方规范:required 与 properties 的语义边界——required 只声明"键必须存在",不声明"值必须非空"。
- Python jsonschema 4.26.0(Draft 2020-12 参考实现),本篇全部校验结果的产出工具。
- OpenAI 系列文档中关于 Structured Outputs 的说明:约束解码保证 schema 遵从,不保证值在业务上的正确性。
- 本系列第 8 篇《全栈工程师的 AI 成本账》:token 计数方法与单价口径。
- 本系列第 14 篇《全栈工程师的工具设计》:工具参数即结构化输出的特例。
- 本系列第 15 篇《全栈工程师的多模型路由》:换模型会让输出契约静默漂移。
转载自 CSDN-专业IT技术社区
原文链接:https://blog.csdn.net/Rosanci/article/details/167221913

