

今天我们来讲解关于LangChain的相关工具调用。
1. 为什么需要工具
在 LangChain 的学习中需要学习工具,是因为工具相当于是大模型与 API 之间的桥梁。如果没有工具的话那么大模型是没有办法去调用API的。
同时大语言模型的话是可以做到自主调用工具的。
但是我们如果想要实现大模型对工具的调用的话是需要我们我们在工具的内部提前写好这个关于这个工具的描述的,这样模型才可以知道什么时候可以调用这个函数也就是这个工具。
2. @tool
这个的话是语法糖,我们只需要简单的几行代码就可以实现对模型的调用。
2.1 @tool方法一
我们来看下面这个代码,我们需要先写一个@tool,代表着我们开始了对工具的创建,接着我们def一个函数,然后设置好参数和返回值。接着我们需要打“”“”“”,然后再里面填入对这个函数的说明,以及里面每一个参数是什么,是啥东西。这个的话是写给模型看的。最后设置好返回值。
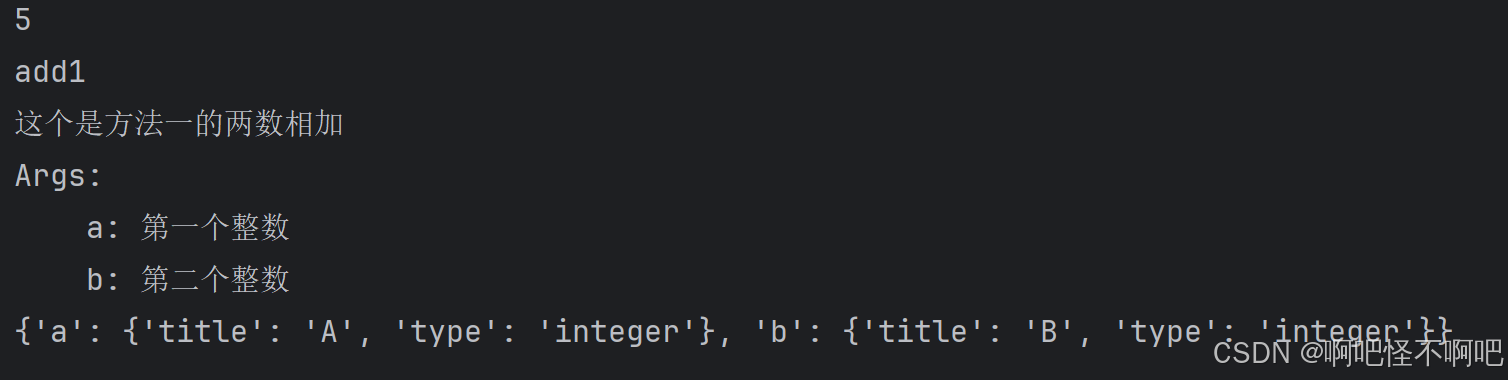
我们看下面的打印,invoke是用来提取的,提取这个add1函数的返回值,接着通过name,description,args等函数就可以打印出这个add1函数所对应的名字,描述,以及参数的类型。
@tool
def add1(a: int, b: int) -> int:
    """这个是方法一的两数相加
    Args:
        a: 第一个整数
        b: 第二个整数
    """
    return a + b

print(add1.invoke({"a": 2, "b": 3}))
print(add1.name)
print(add1.description)
print(add1.args)
print("\n")
我们看下面这个代码,这个的话就是打印的结果,因为我们没有改变过函数的名字,所以在这里面的话就是add1。
2.2 @tool方法二
我们来看下面这个代码,这个的话就和上面的方法一不一了,我们在这边的话就是先定义了一个类,接着在这边在空格里面输入BaseModel(BaseModel 用来定义数据结构、校验数据、自动生成 JSON Schema,给大模型函数调用用的。),接着我们老样子在"""""里面填入这个函数的描述,但是在下面我们需要再每一个参数后面设置一个Field,同时需要在第一个位置填入三个省略号(这代表这个参数必须要填入),第二个description则是用来给给大模型看,告诉模型这个参数是什么含义。
PS:Field() 是一个函数,专门用来给 BaseModel 里面的字段附加额外信息、校验规则Pydantic。
class AddInput(BaseModel):
    """这个是方法二的两数相加"""
    a: int=Field(...,description="第一个整数")
    b: int=Field(...,description="第二个整数")

@tool(args_schema=AddInput)
def add2(a:int, b:int)->int:
    return a+b

print(add2.invoke({"a": 2, "b": 3}))
print(add2.name)
print(add2.description)
print(add2.args)
print("\n")
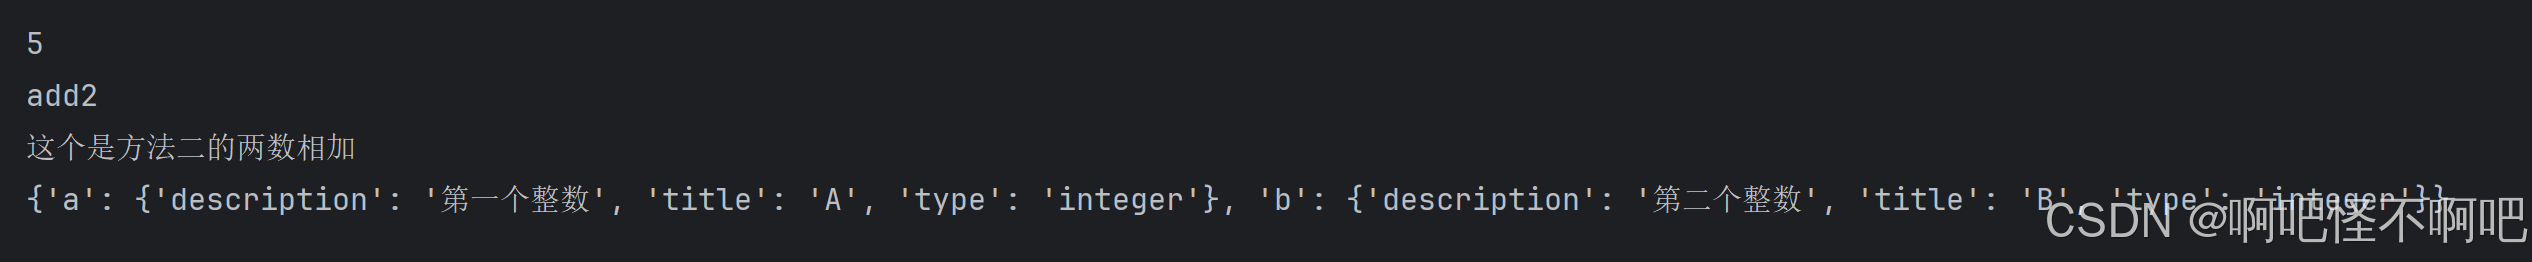
这个的话就是这个函数被调用之后的返回值。因为这两个的代码不一样,所以最后打印出来的结果也是不一样的。
2.2.1 description解释
我们看上面的两个代码,里面都有关于description的使用,同时对于模型来说它看到的结果是一样的,因为对于模型来说是只要有description就可以,但是底层 JSON Schema 里的参数描述来源完全不同,所以我们看到的结果不一样。
tool.description:工具整体功能描述(告诉模型什么时候调用这个工具)
tool.args:参数的 JSON Schema(告诉模型每个参数是什么含义)
2.3 @tool方法三
这个的话就是方法三,我们来看下面的代码,这个话有点像方法二,我们先定义一个def,然后在函数的参数后面加入一个Annotated,这个函数Annotated是 Python 的类型注解增强工具,简单来说相当于在这边是强调geiAI看的,这样我们在下面就不用专门为参数写注释了。只需要加上关于这个函数的描述就可以了。
@tool
def add3(
        a:Annotated[int,...,"第一个整数"],
        b:Annotated[int,...,"第一个整数"],
)->int:
    """这个是方法三的两数相加
    """
    return a+b

print(add3.invoke({"a": 2, "b": 3}))
print(add3.name)
print(add3.description)
print(add3.args)
print("\n")
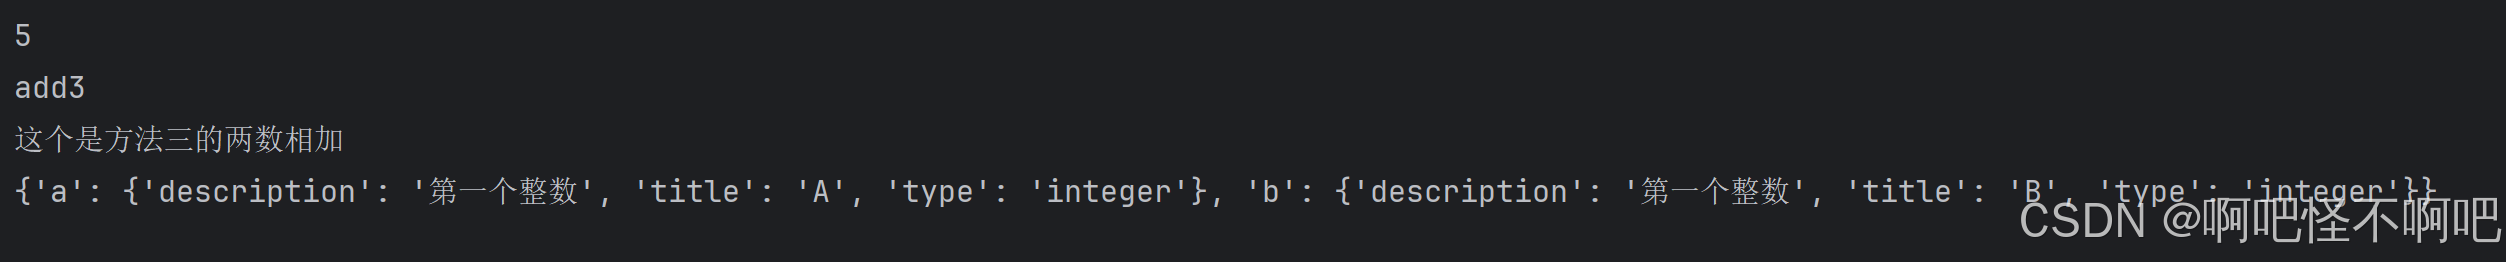
下面的图片就是运行的代码
3. struct工具
接下来我们来看struct工具,这个的话万能可以理解为更加的接近底层,因为@tool工具是被封装好的struct工具,相当于我们在使用@tool的时候会在底层被转换成struct工具。
3.1 struct方法一
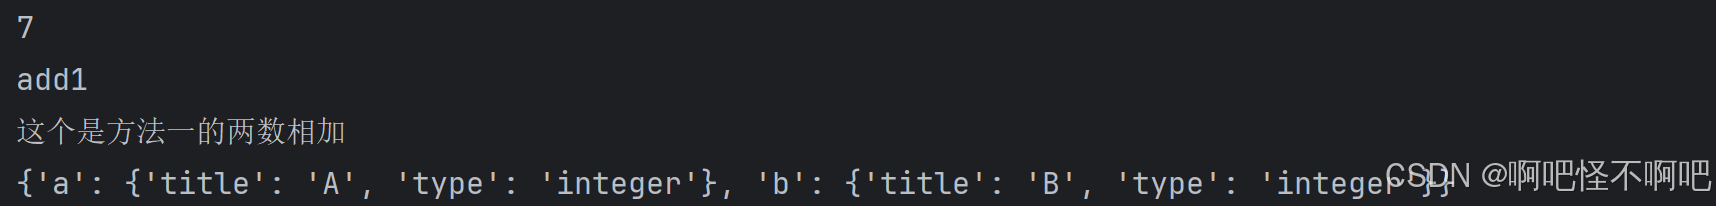
我们来看下面这个代码,我们先def一个函数同时加上对他的描述,接着设置一个变量用来接收structuredtool函数,接着放入前面我们写好的add1函数就可以了。接着我们直接去打印add1_tool相关的信息就可以了。
def add1(a:int, b:int) -> int:
    """这个是方法一的两数相加"""
    return a+b

add1_tool=StructuredTool.from_function(func=add1)

print(add1_tool.invoke({"a": 2, "b": 5}))
print(add1_tool.name)
print(add1_tool.description)
print(add1_tool.args)
我们看下面这个图片,这个就是方法一的输出结果。
3.2 struct方法二
我们接下来看这个方法二,这个的话有点像我们上面写的tool的方法二一样,先写一个class类,设定好相关的参数,接着def一个函数。到这一步的有些朋友可能节点有点疑惑了,因为我们在这边的add2和AddInput函数看起来有点重复,但其实是不一样的。因为他们两个对于struct工具来说是两个不同的东西,只是我们在这边的函数内部参数都正好选择了a和b而已。接着就直接在struct工具里面进行调用就可以了。
在这边我们是需要在struct工具里面填入四个常熟的,他们具体的作用我写在下面的表格里了。
| func=add2 | 告诉工具:真正要执行的业务函数是谁 |
| name="ADD2" | 给大模型看:这个工具叫什么名字,在这边的话相当于改名 |
| description="这个是方法二的两数相加" | 给大模型看:这个工具能干什么,什么时候该调用它 |
| args_schema=AddInput2 | 给大模型看:调用这个工具,需要传哪些参数、参数类型、参数说明 |
class AddInput2(BaseModel):
    a: int=Field(...,description="")
    b: int=Field(...,description="")

def add2(a:int, b:int) -> int:
    return a+b

add2_tool=StructuredTool.from_function(
    func=add2,
    name="ADD2",# 工具名
    description="这个是方法二的两数相加",# 工具描述
    args_schema=AddInput2,# 工具参数
)
print(add2_tool.invoke({"a": 2, "b": 5}))
print(add2_tool.name)
print(add2_tool.description)
print(add2_tool.args)
AddInput2(Pydantic BaseModel):专门给【大模型】用 生成 JSON Schema,告诉 Agent:调用这个工具需要什么参数、每个参数是什么含义,用来约束大模型输出 tool_call。大模型是文本模型,它要读这个 schema,生成
{"a":2,"b":5}这种参数。 同时 Pydantic 还会做参数校验:比如传字符串就直接报错。
add2普通函数:专门给【Python 解释器】执行 真正干活的逻辑,拿到 a、b,执行相加。这是业务逻辑,是真正运行的代码。
简单一句话:
AddInput2 = 和大模型沟通的 “接口说明书” add2 = 真正干活的代码
3.2.1 struct工具方法一和方法二的区别
他们的区别其实很简单,就是方法一是自动推导,方法二是我们自己去手动定义,通过亲手定义完整参数 schema,代码多一点,但是信息完整可控,LLM 更容易理解参数含义。
3.3 struct方法三
我们现需要创建一个类AddIntput3,这个类的话就是专门用来告诉模型这个工具需要什么参数,每一个参数又是什么意思,接着在def一个函数,这个函数才是真正运行的用的。后用 StructuredTool 把它们打包成工具实例 add_tool。
接着的话就是通过一个变量来进行输出结果了,在这边这个变量不是关键里面的内容才是关键,所以不管我们这个tool_call_request取什么名字,只要是按照这个格式这个内容进行填写的,那么最后的输出结果就是这样。
class AddInput3(BaseModel):
    a: int=Field(description="第一个整数")
    b: int=Field(description="第二个整数")

#`Tuple` 就是**元组**,Python 里用来一次性返回**多个值**。

def add (a:int, b:int) -> Tuple[str, List[int]]:
    nums=[a,b]
    content=f"{nums}相加的结果是{a+b}"
    return content,nums

add_tool=StructuredTool.from_function(
    func=add,
    name="ADD3",  # 工具名
    description="两数相加",  # 工具描述
    args_schema=AddInput3,  # 工具参数
    response_format="content_and_artifact"
)

# 模拟大模型调用姿势
tool_call_request = {
    "name": "ADD3",
    "args": {"a": 3, "b": 4},
    "type": "tool_call",
    "id": "111",
}
print(tool_call_request )
下面这个图片就是方法三的打印结果。

转载自 CSDN-专业IT技术社区

