

首屏导读 · 本教程配套付费专栏: 大模型工程师修炼手记
19.9 元(AI 编程 / Agent 实战 | 本文同主题系统课程)· AI时代程序员的自我提升49.9 元(AI 时代成长方法论)。单篇不过瘾?订阅解锁全量源码、实战与答疑;文末附资料包领取方式 ↓
【OAG vs RAG】OAG架构深度解析:从"检索文档"到"理解业务"的范式跃迁
在上一篇中,我们拆解了RAG的"语义崩溃"问题——当知识库突破1万份文档的临界点后,向量空间中的距离趋同,检索从"精准导航"退化为"随机撒网"。这个问题的根源在于RAG的知识表示方式:高维浮点向量永远无法承载业务逻辑与因果关系。
本篇将深入OAG(Ontology Augmented Generation,本体增强生成)的架构内核,拆解它的四维本体模型、工作原理五步流程,并与RAG进行全维度的技术对比。读完本文,你会理解为什么Palantir能靠这套架构拿下美国军方和全球最大港口的订单,以及为什么它被称为企业AI的"终极王牌"。
一、OAG是什么?
OAG的全称是Ontology Augmented Generation(本体增强生成),这个概念发源于Palantir的AIP(Artificial Intelligence Platform)平台。2023年Palantir推出AIP时,其核心卖点并非"更强的LLM",而是"让LLM理解你的业务"——达成这一目标的基石就是Ontology。
一句话定义:OAG将企业非结构化知识转化为结构化本体,让AI在"语义拓扑"中推理,而非在"向量空间"中碰撞。
如果觉得抽象,可以做一个类比:RAG像是给LLM外挂了一座图书馆(开卷考试),OAG则是给LLM植入了一个企业专属的"业务大脑"。前者能帮你找到相关信息,后者能帮你做出业务决策并直接执行。
OAG与传统知识图谱的本质区别
很多工程师第一次听到"本体"这个词,会联想到传统知识图谱(Knowledge Graph)。这两者有关联,但本质不同:
| 维度 | 传统知识图谱 | OAG本体 |
|---|---|---|
| 性质 | 静态的数据结构 | 可执行的业务语义系统 |
| 建模对象 | 通用实体(人物、地点、概念) | 企业业务实体(订单、工单、设备) |
| 执行能力 | 无(只读查询) | 有(通过Action驱动业务系统) |
| 安全模型 | 通常无内建权限 | 细粒度RBAC,对象级+属性级+动作级 |
| 与AI的关系 | 作为外挂知识源 | 作为AI的"业务说明书"和"操作护栏" |
| 演进方式 | 人工维护 | Data as Code,Git-like版本管理 |
传统知识图谱回答的是"世界有什么",OAG本体回答的是"在这个企业里,什么能做什么、谁有权限做什么"。前者是百科全书,后者是操作手册加权限系统。
Palantir的工程实践表明,Ontology不是简单的数据模型,而是一个由语义层(Semantic Layer)、**动能层(Kinetic Layer)和动态层(Dynamic Layer)**构成的三层协同系统。语义层定义"是什么"(名词),动能层定义"能做什么"(动词),动态层定义"按什么规则做"(逻辑与约束)。这三层共同构成了一个"有生命力"的业务数字孪生。
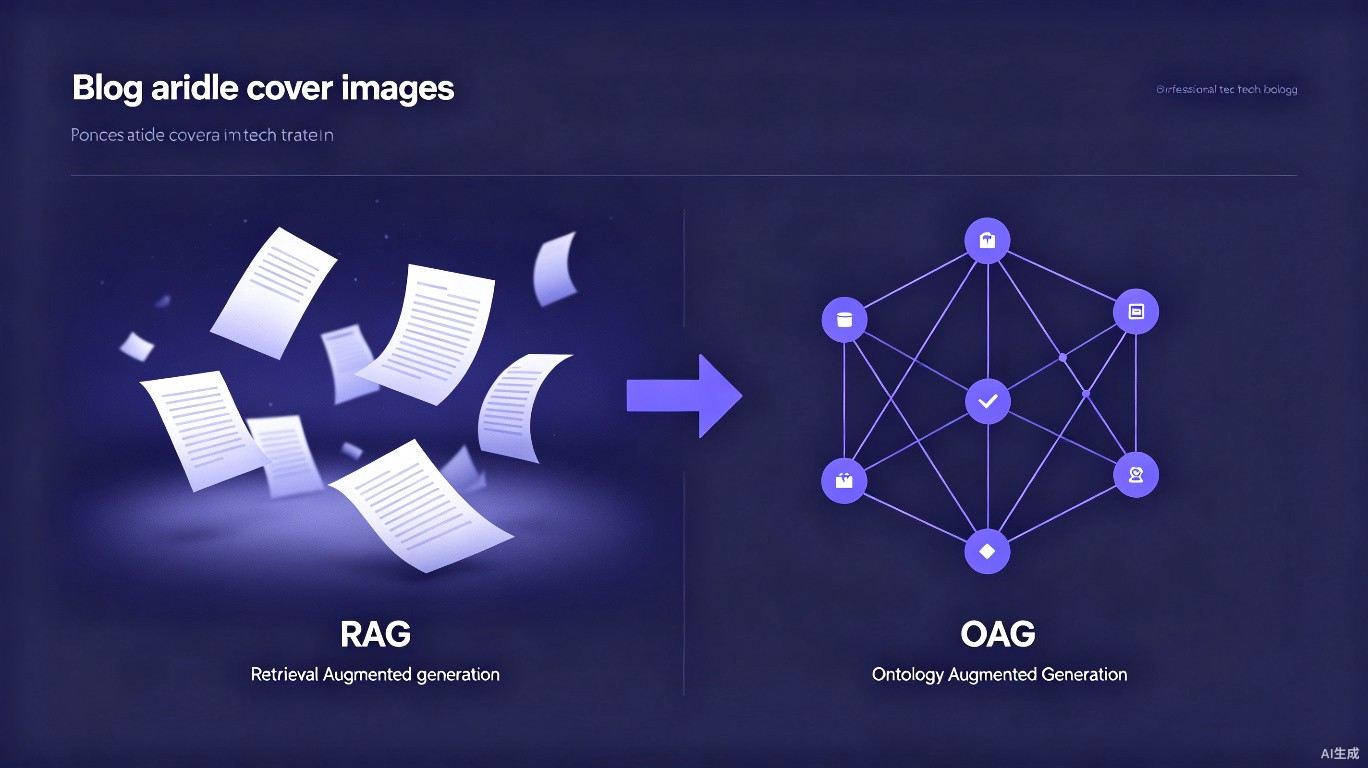
图1:RAG到OAG的范式跃迁
二、核心概念:Ontology(本体)
2.1 本体的定义与分类
在计算机科学中,本体(Ontology)是对共享概念模型的明确的形式化规范说明。通俗来说,它定义了一个领域内"存在哪些东西、这些东西有什么特征、它们之间有什么关系"。
本体按抽象层次分为三类:
- 上层本体(Upper Ontology):描述最通用的概念,如"时间"、“空间”、“因果”。例如SUMO、BFO。与企业应用距离较远。
- 领域本体(Domain Ontology):描述特定领域的概念体系。例如医疗领域的SNOMED CT(定义了30万+医疗概念)、金融领域的FIBO。
- 应用本体(Application Ontology):面向具体应用场景的本体,是OAG的核心关注点。例如某港口的调度本体、某制造企业的设备维护本体。
在OAG的语境下,我们关注的是应用本体——它不是学术意义上的哲学概念,而是Palantir所定义的"企业级操作系统的数字心脏":一个将企业的数据(Data)、逻辑(Logic)、动作(Action)、安全(Security)统一建模的语义层。
2.2 四维本体模型架构
Palantir Ontology的核心建模原语可以归纳为四个维度。这四个维度恰好对应自然语言中的四大词性——名词、形容词、介词、动词:
| 维度 | 词性类比 | 说明 | 示例 |
|---|---|---|---|
| 对象类型(Object Types) | 名词 | 业务实体的类型定义 | 客户、订单、产品、仓库、供应商 |
| 对象属性(Properties) | 形容词 | 实体的属性字段 | 订单金额、客户等级、库存数量 |
| 动作类型(Action Types) | 动词 | 可执行的业务操作 | 创建订单、库存调拨、审批流程 |
| 关系类型(Links) | 介词 | 实体间的关联关系 | 订单→客户、订单→产品、产品→仓库 |
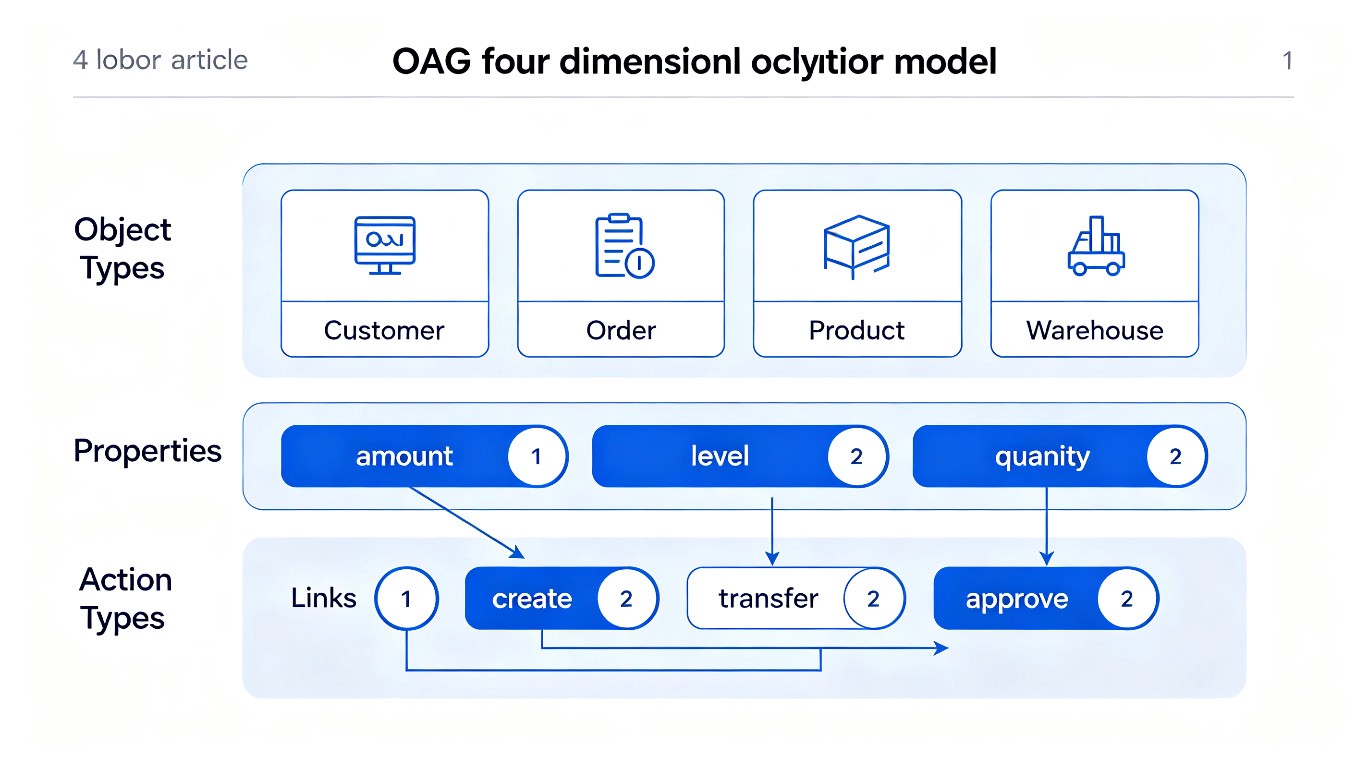
图2:OAG四维本体模型架构
2.3 港口管理实例:四维模型如何协同
以一个港口供应链场景为例,看看四维模型如何协同工作。
业务场景:某港口有3个泊位、5艘待卸货船舶、2个仓库(其中1个已满载)。调度员需要决定船舶的靠泊顺序和货物分配方案。
在本体模型中,这个场景会被建模为:
对象类型(Object Types):
  - Berth(泊位):Berth-01, Berth-02, Berth-03
  - Vessel(船舶):Vessel-A(集装箱船), Vessel-B(散货船), ...
  - Warehouse(仓库):WH-East(已满载), WH-West(剩余2000TEU)
  - Cargo(货物):各船所载货物的明细

关系类型(Links):
  - Vessel --assigned_to--> Berth    (船舶被分配到泊位)
  - Vessel --carries--> Cargo       (船舶载有货物)
  - Cargo --stored_in--> Warehouse  (货物存入仓库)

对象属性(Properties):
  - Vessel.draft(吃水深度): 12.5m
  - Vessel.ETA(预计到达时间): 2026-07-10 08:00
  - Berth.max_draft(最大允许吃水): 15m
  - Berth.status(状态): "occupied" / "available"
  - Warehouse.capacity(容量): 5000TEU
  - Warehouse.utilization(利用率): 100% / 60%

动作类型(Action Types):
  - assign_vessel_to_berth(vessel, berth)  (分配船舶靠泊)
  - transfer_cargo(vessel, warehouse)       (货物转运入库)
  - request_emergency_storage(cargo, qty)   (申请紧急仓储)
注意一个关键细节:Action不是自由文本生成,而是预定义的、带参数的、受权限控制的操作。 当AI Agent建议"将Vessel-A分配到Berth-01"时,它不是在"说",而是在"调用"一个名为assign_vessel_to_berth的函数——这个函数有明确的输入输出、业务校验规则和执行权限要求。
2.4 代码示例:用Python/JSON定义港口本体
以下是一个简化的港口本体定义示例:
import json

port_ontology = {

    "name": "PortSupplyChain",
    "version": "1.0.0",
    "description": "港口供应链调度本体模型",

    # 维度一:对象类型(Object Types)
    "object_types": [
        {

            "name": "Vessel",
            "description": "靠泊船舶",
            "primary_key": "vessel_id",
            "properties": [
                {
   "name": "vessel_id", "type": "string", "description": "船舶编号"},
                {
   "name": "vessel_name", "type": "string", "description": "船名"},
                {
   "name": "vessel_type", "type": "enum",
                 "values": ["container", "bulk", "tanker"], "description": "船舶类型"},
                {
   "name": "draft", "type": "float", "unit": "meter",
                 "description": "当前吃水深度"},
                {
   "name": "eta", "type": "datetime", "description": "预计到港时间"},
                {
   "name": "cargo_teu", "type": "integer", "description": "载货量(TEU)"},
                {
   "name": "priority", "type": "enum",
                 "values": ["urgent", "normal", "low"], "description": "优先级"},
                {
   "name": "status", "type": "enum",
                 "values": ["waiting", "berthing", "unloading", "departed"]}
            ]
        },
        {

            "name": "Berth",
            "description": "泊位",
            "primary_key": "berth_id",
            "properties": [
                {
   "name": "berth_id", "type": "string", "description": "泊位编号"},
                {
   "name": "max_draft", "type": "float", "unit": "meter",
                 "description": "最大允许吃水"},
                {
   "name": "length", "type": "float", "unit": "meter",
                 "description": "泊位长度"},
                {
   "name": "status", "type": "enum",
                 "values": ["available", "occupied", "maintenance"]},
                {
   "name": "current_vessel", "type": "ref:Vessel", "description": "当前靠泊船舶"}
            ]
        },
        {

            "name": "Warehouse",
            "description": "仓库",
            "primary_key": "warehouse_id",
            "properties": [
                {
   "name": "warehouse_id", "type": "string"},
                {
   "name": "capacity_teu", "type": "integer", "description": "总容量(TEU)"},
                {
   "name": "used_teu", "type": "integer", "description": "已用容量(TEU)"},
                {
   "name": "utilization", "type": "float", "description": "利用率(0-1)",
                 "computed": "used_teu / capacity_teu"}
            ]
        }
    ],

    # 维度二:关系类型(Links)
    "link_types": [
        {

            "name": "assigned_to",
            "description": "船舶被分配到泊位",
            "source": "Vessel",
            "target": "Berth",
            "cardinality": "many_to_one",
            "properties": [
                {
   "name": "assigned_at", "type": "datetime"},
                {
   "name": "estimated_duration", "type": "float", "unit": "hour"}
            ]
        },
        {

            "name": "cargo_destination",
            "description": "货物目标仓库",
            "source": "Vessel",
            "target": "Warehouse",
            "cardinality": "many_to_many"
        }
    ],

    # 维度三:动作类型(Action Types)
    "action_types": [
        {

            "name": "assign_vessel_to_berth",
            "description": "将船舶分配到指定泊位",
            "parameters": [
                {
   "name": "vessel_id", "type": "ref:Vessel", "required": True},
                {
   "name": "berth_id", "type": "ref:Berth", "required": True}
            ],
            "pre_conditions": [
                "berth.status == 'available'",
                "vessel.draft <= berth.max_draft",
                "vessel.status == 'waiting'"
            ],
            "effects": [
                "berth.status = 'occupied'",
                "berth.current_vessel = vessel",
                "vessel.status = 'berthing'"
            ],
            "confirmation_required": True,
            "rollback_supported": True
        },
        {

            "name": "transfer_cargo",
            "description": "将船舶货物转运到指定仓库",
            "parameters": [
                {
   "name": "vessel_id", "type": "ref:Vessel", "required": True},
                {
   "name": "warehouse_id", "type": "ref:Warehouse", "required": True},
                {
   "name": "quantity_teu", "type": "integer", "required": True}
            ],
            "pre_conditions": [
                "warehouse.used_teu + quantity_teu <= warehouse.capacity_teu",
                "vessel.status == 'unloading'"
            ],
            "effects": [
                "warehouse.used_teu += quantity_teu",
                "vessel.cargo_teu -= quantity_teu"
            ]
        }
    ]
}

print(json.dumps(port_ontology, ensure_ascii=False, indent=2))
仔细看action_types中的设计。每个Action都定义了三组关键信息:**前置条件(pre_conditions)**确保操作合法、**执行效果(effects)**声明状态变更、确认与回滚机制保障操作安全。这不是简单的API调用,而是一个完整的业务操作契约。这正是OAG与传统知识图谱最本质的区别——图谱只能"读",本体既能"读"也能"写",而且"写"是受控的。
三、RAG vs OAG 全面对比
我们在上一篇中已经做了一个简要对比,这里展开每一项差异的本质原因。
| 维度 | RAG | OAG |
|---|---|---|
| 核心比喻 | 开卷考试(外挂资料库) | 业务大脑(植入语义系统) |
| 增强对象 | 非结构化文档 | 结构化业务本体 |
| 知识表示 | 向量嵌入(高维浮点数) | 图谱结构(实体+关系+逻辑) |
| 检索方式 | 余弦相似度最近邻 | 本体查询(路径遍历+图推理) |
| 推理能力 | 无(依赖LLM自身) | 有(因果推理、规则推理) |
| 执行能力 | 无(仅生成文本) | 有(通过Action驱动业务系统) |
| 可解释性 | 引用来源文档 | 完整Chain of Thought+行动链 |
| 规模瓶颈 | 1万文档后语义崩溃 | 理论上无此瓶颈(结构化查询) |
| 适用场景 | 问答、文档摘要、知识查询 | 企业决策、流程自动化、合规风控 |
| 构建成本 | 低(向量化即可) | 高(需构建企业本体) |
| 维护成本 | 低 | 中(本体需随业务演进) |
3.1 增强对象的差异:文档 vs 本体
RAG增强的是"非结构化文档"——PDF、Word、网页、工单记录。这些文档被切分成chunk后向量化,存入向量数据库。LLM拿到的是文本片段。
OAG增强的是"结构化业务本体"——对象、属性、关系、动作。这些本体从ERP、CRM、IoT等系统中抽取和映射而来。LLM拿到的是带业务语义的结构化数据。
本质原因:文档是信息的"投影"(有人写了什么),本体是业务的"模型"(实际发生了什么)。前者有信息损耗和主观偏差,后者是对现实世界的直接映射。
3.2 知识表示的差异:向量 vs 图谱
RAG将知识压缩为高维向量(通常是768或1536维的浮点数数组)。这种表示方式丢失了知识的结构和逻辑——"订单金额是10万元"和"客户投诉了10万元"在向量空间中可能非常接近。
OAG用图谱结构表示知识:Order(order_id=123).amount = 100000。知识以显式的实体-属性-关系三元组存储,查询结果精确确定。
本质原因:向量表示是一种"模糊编码",擅长捕捉语义相似性但不擅长精确表达逻辑关系。图谱表示是一种"精确编码",牺牲了模糊匹配能力但换来了逻辑完整性。
3.3 推理能力的差异:无 vs 有
RAG本身不具备推理能力。当用户问"为什么订单延误了?“,RAG只能检索到与"延误"语义相似的文档片段,然后依赖LLM自身的推理能力来分析原因。如果相关文档没有被检索到(这在规模变大后经常发生),LLM就只能"猜测”。
OAG通过关系链路进行多跳推理。当用户问同一个问题,OAG会沿本体关系遍历:Order -> Supplier -> Shipment -> Logistics -> Delay_Reason,精确找到延误的根因节点。
本质原因:RAG的推理是"概率性"的(可能找到相关信息),OAG的推理是"确定性"的(沿关系链路一定能到达目标节点)。在企业决策场景中,确定性远比概率性有价值。
3.4 执行能力的差异:只读 vs 读写
这是OAG最被低估的差异化优势。RAG系统只能输出文本——它能告诉你"应该做什么",但无法帮你"实际去做"。
OAG通过Action Types实现了"分析即执行"的闭环。当OAG分析出最优调度方案后,可以直接调用assign_vessel_to_berth动作,将方案推送到生产系统。
本质原因:OAG的本体不仅包含"名词"(对象、属性、关系),还包含"动词"(Action)。这个设计哲学来自Palantir的核心洞察——企业需要的不是"更聪明的聊天机器人",而是"能直接操作的数字员工"。
3.5 规模瓶颈的差异:维度诅咒 vs 结构化查询
在上一篇中我们已经详细分析了RAG的语义崩溃问题。当知识库规模超过1万份文档,向量空间中的距离趋同,检索准确率骤降。
OAG使用的是结构化查询(类似图数据库的路径遍历),查询性能与"数据量"的关系是线性的(O(n)或O(log n)),而非向量空间中的指数级退化。10万个对象和1000万个对象在本体查询中的性能差异是可预测、可控的。
本质原因:向量检索是在连续空间中做近似匹配,规模越大匹配越模糊。本体查询是在离散图中做精确遍历,规模增大只影响遍历范围,不影响遍历精度。
3.6 构建与维护成本的差异
RAG的构建成本很低——文档收集、切分、向量化、存入数据库,一个工程师几天就能搭起来。这也是RAG普及率远高于OAG的根本原因。
OAG的构建成本很高。需要业务专家和数据工程师深度合作,梳理业务实体、定义关系、设计Action、配置权限。Palantir的实施周期通常以月甚至季度计。
但要注意一个关键点:OAG的维护成本是"中"而非"高"。 一旦本体构建完成,新增业务场景只需要扩展本体定义,而非推倒重来。Palantir的Data as Code机制让本体的变更像代码一样可控、可追溯、可回滚。
四、OAG的工作原理:五步流程
OAG处理一个用户查询的完整流程可以拆解为五个步骤。这五个步骤形成了一个从"理解问题"到"执行方案"的完整闭环。
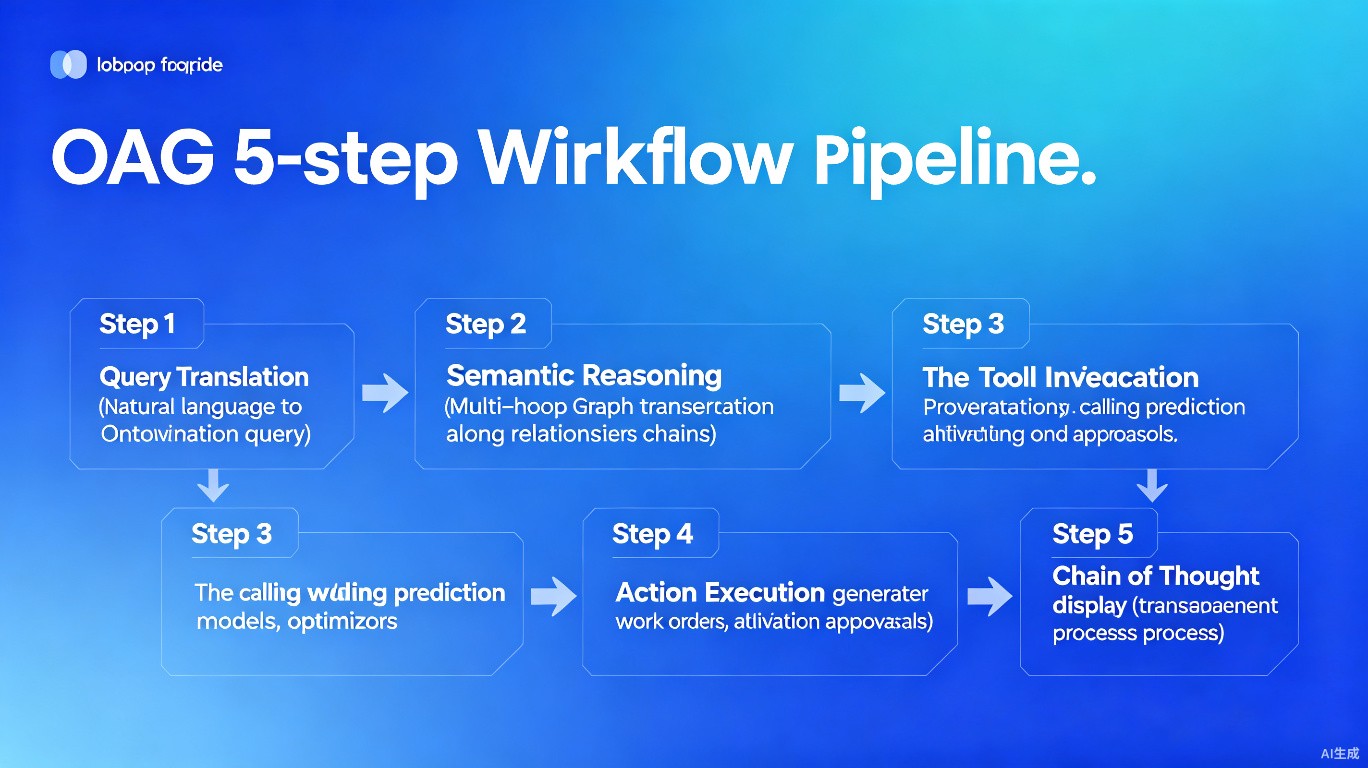
图3:OAG工作原理五步流程
4.1 查询转译:自然语言 -> 本体结构化查询
OAG的第一步是将用户的自然语言问题转译为对本体的结构化查询。这一步由LLM完成,但LLM不是"裸跑"的——它拿着本体的完整Schema作为上下文。
Prompt设计示例:
query_translation_prompt = """
你是一个港口供应链OAG系统的查询转译引擎。

## 你的任务
将用户的自然语言问题转译为对以下本体模型的结构化查询。

## 本体Schema
{
   ontology_schema}

## 可用的查询模式
1. 对象过滤:Filter(ObjectType, conditions)
2. 关系遍历:Traverse(ObjectType, link_name, depth)
3. 聚合计算:Aggregate(ObjectType, metric, group_by)
4. 排序:Sort(results, by=property, order=desc/asc)

## 用户问题
{
   user_question}

## 输出格式
请输出JSON格式的结构化查询:
```json
{

  "query_type": "filter|traverse|aggregate|composite",
  "steps": [
    {

      "operation": "Filter|Traverse|Aggregate|Sort",
      "object_type": "...",
      "conditions": [...],
      "link_name": "...",
      "depth": 1
    }
  ],
  "intent_summary": "用户意图的简短描述"
}
“”"
**示例**:用户问"今天有哪些船舶等待靠泊?",转译结果为:

```json
{
  "query_type": "filter",
  "steps": [
    {
      "operation": "Filter",
      "object_type": "Vessel",
      "conditions": [
        {"field": "status", "op": "==", "value": "waiting"},
        {"field": "eta", "op": "<=", "value": "2026-07-10T23:59:59"}
      ]
    }
  ],
  "intent_summary": "查询今日待靠泊船舶列表"
}
关键点在于:本体Schema充当了LLM的"业务说明书",让LLM知道有哪些对象、哪些属性、哪些关系可用。这极大减少了LLM的幻觉空间——它只能在本体定义的范围内"思考",而不是在无限的开放世界里"编造"。
4.2 语义推理:沿关系链路进行多跳推理
查询转译完成后,OAG引擎在本体中执行结构化查询,并沿关系链路进行多跳推理。这一步与图数据库的图遍历有相似之处,但有一个本质区别:OAG的推理不仅遍历数据关系,还执行业务规则。
与传统图查询的对比:
# Neo4j Cypher 查询(纯数据遍历)
MATCH (v:Vessel {status: 'waiting'})-[:carries]->(c:Cargo)
MATCH (c)-[:requires]->(w:Warehouse)
WHERE w.utilization > 0.9
RETURN v, c, w

# OAG本体查询(数据遍历 + 业务规则推理)
# Step 1: 找到所有等待靠泊的船舶
vessels = Filter(Vessel, status == "waiting")

# Step 2: 对每艘船,沿关系链路推理
for vessel in vessels:
    cargo = Traverse(vessel, "carries")
    warehouse = Traverse(cargo, "cargo_destination")

    # Step 3: 执行业务规则(图数据库做不到这一步)
    if warehouse.utilization > 0.9:
        vessel.risk_level = "high"  # 仓储风险高
        alternative_wh = Filter(Warehouse,
                                utilization < 0.8,
                                capacity_teu >= cargo.quantity)
        if not alternative_wh:
            vessel.recommendation = "需要申请紧急仓储"
区别很明确:图数据库只能"找数据",OAG能"找数据+跑规则+出建议"。后者才是企业决策者真正需要的能力。
4.3 工具调用:调用内嵌的业务逻辑
OAG的工具箱设计与传统Agent的Function Calling有本质区别。
传统Agent的工具是"通用工具"——搜索引擎、计算器、代码执行器——这些工具与具体业务无关。OAG的工具是"本体内嵌工具"——预测模型、优化算法、业务规则引擎——这些工具是围绕本体对象构建的。
OAG工具箱的设计理念:
class OAGToolbox:
    """OAG工具箱:工具围绕本体对象构建"""

    def __init__(self, ontology):
        self.ontology = ontology
        self.tools = {
   }
        self._register_builtin_tools()

    def _register_builtin_tools(self):
        # 预测类工具:基于历史数据的预测模型
        self.tools["predict_unloading_time"] = {

            "description": "根据船舶类型、货物量、泊位条件预测卸货时间",
            "input": ["vessel_id", "berth_id"],
            "output": "predicted_hours: float",
            "model": "xgboost_unloading_predictor_v3"
        }

        # 优化类工具:运筹优化算法
        self.tools["optimize_berth_allocation"] = {

            "description": "基于约束条件生成最优泊位分配方案",
            "input": ["vessel_list", "berth_list", "constraints"],
            "output": "allocation_plan: List[Assignment]",
            "solver": "ortools_cp_sat"
        }

        # 规则类工具:业务规则引擎
        self.tools["check_compliance"] = {

            "description": "检查调度方案是否符合安全合规要求",
            "input": ["allocation_plan"],
            "output": "compliance_report: Dict",
            "rules": ["draft_limit", "cargo_hazard_check", "crew_certification"]
        }
这种设计确保了:工具的输入输出都是本体对象,工具的执行结果可以无缝回流到本体中,形成推理链的闭环。
4.4 行动驱动:通过Action闭环操作
OAG的第四步是将推理结论转化为可执行的Action。这是OAG区别于所有其他AI架构的最核心特征。
Action的确认机制:
class ActionExecutor:
    """OAG Action执行器"""

    def execute(self, action: ActionType, params: dict,
                user_context: UserContext) -> ActionResult:
        # 1. 权限校验:当前用户是否有权执行此Action
        if not self.security.check_permission(
            user=user_context,
            action=action.name,
            target_objects=params
        ):
            raise PermissionDenied(
                f"用户 {
     user_context.user_id} 无权执行 {
     action.name}"
            )

        # 2. 前置条件校验
        for condition in action.pre_conditions:
            if not self.evaluate(condition, params):
                raise PreConditionFailed(
                    f"前置条件不满足: {
     condition}"
                )

        # 3. 高风险操作需要人工确认
        if action.confirmation_required:
            approval = self.request_human_approval(
                action=action,
                params=params,
                risk_assessment=self.assess_risk(action, params)
            )
            if not approval.approved:
                return ActionResult(status="rejected", reason=approval.reason)

        # 4. 执行Action并记录审计日志
        try:
            result = self.backend.execute(action, params)
            self.audit_log.record(
                action=action.name,
                params=params,
                result=result,
                user=user_context,
                timestamp=datetime.now()
            )
            return ActionResult(status="success", data=result)

        except Exception as e:
            # 5. 执行失败时自动回滚
            if action.rollback_supported:
                self.rollback(action, params)
            return ActionResult(status="failed", error=str(e))
Action的回滚机制:每个Action在定义时声明了rollback_supported。如果执行过程中发生异常,系统会自动将相关对象恢复到执行前的状态。这与数据库事务的回滚机制类似,但作用在业务语义层而非数据存储层。
4.5 思维链展示:完整的推理过程透明化
OAG的Chain of Thought(CoT)与普通LLM的CoT有本质区别。
普通LLM的CoT是"生成式"的——模型一边思考一边输出,你无法验证每一步推理是否正确,因为推理发生在不可观测的注意力机制中。
OAG的CoT是"可验证的"——每一步推理都对应一个确定性的本体查询或工具调用,每一步的结果都可以与源数据交叉验证。
OAG的CoT输出示例:
=== OAG推理链 ===

Step 1 [查询转译]
  输入: "如何优化今天的卸货调度?"
  转译: Filter(Vessel, status=="waiting", eta<=today)
        → Traverse(cargo, warehouse)
        → Check(warehouse.utilization)
  结果: 发现5艘待卸船舶,其中3艘目标仓库利用率超90%

Step 2 [语义推理]
  推理路径: Vessel-A → Cargo(500TEU) → WH-East(满载)
  推理路径: Vessel-B → Cargo(800TEU) → WH-West(剩余2000TEU)
  推理路径: Vessel-C → Cargo(1200TEU) → WH-West(剩余2000TEU) ⚠️ 不足
  发现: WH-East满载,Vessel-A和Vessel-C面临仓储瓶颈

Step 3 [工具调用]
  调用 optimize_berth_allocation(vessels=[A,B,C,D,E], berths=[1,2,3])
  结果: 最优方案 - Vessel-A→Berth-01, Vessel-B→Berth-02, Vessel-C→Berth-03
  调用 check_compliance(allocation_plan)
  结果: Vessel-A吃水12.5m < Berth-01最大吃水15m ✓ 通过

Step 4 [行动建议]
  Action 1: assign_vessel_to_berth(Vessel-A, Berth-01)
           [需确认] 预计卸货时间6.5小时
  Action 2: assign_vessel_to_berth(Vessel-B, Berth-02)
           [需确认] 预计卸货时间8.2小时
  Action 3: request_emergency_storage(Vessel-C, 1200TEU)
           [紧急] WH-West容量不足,需申请外部仓储

=== 推理链结束 ===
验证状态: 所有中间结果已与源系统交叉验证 ✓
这个推理链的每一行都可以溯源:Step 1的转译结果可以人工复核,Step 2的关系遍历可以用Cypher在图数据库中重放,Step 3的优化结果可以用独立求解器验证,Step 4的Action可以检查前置条件和权限。这就是OAG在企业级场景中的核心价值——不是"看起来很聪明",而是"每一步都可审计"。
五、实战案例:港口供应链调度
场景:某港口3个泊位、5艘待卸货船舶、2个仓库(WH-East已满载,WH-West剩余2000TEU)。调度员向AI提问:“如何优化今天的卸货调度?”
RAG的回答
RAG系统会在历史运营文档中检索与"卸货调度优化"语义相似的片段,然后让LLM基于这些片段生成建议:
根据历史运营记录(来源:《2025年Q3港口运营月报》),卸货调度优化建议如下:
- 优先安排高优先级船舶靠泊
- 合理利用泊位空闲时段
- 注意仓库容量预警
- 参考上季度"船舶A型"平均卸货时间约7.2小时的统计数据
建议调度员结合当前实际情况制定具体方案。
问题分析:
- 给出的是"正确的废话"——谁都知道要优先安排高优先级船舶
- 没有引用任何实时数据(因为RAG检索的是历史文档)
- 无法给出具体方案——因为向量空间中没有"今天5艘船的实时状态"
- 完全不具备执行能力
OAG的回答
OAG系统会基于本体中的实时业务数据进行结构化分析和推理:
当前态势分析:
船舶 类型 货量(TEU) 吃水(m) 优先级 目标仓库 仓储风险 Vessel-A 集装箱 500 12.5 urgent WH-East(满载) 高 Vessel-B 集装箱 800 11.0 normal WH-West 低 Vessel-C 散货 1200 14.2 normal WH-West 高 Vessel-D 集装箱 300 9.5 low WH-West 低 Vessel-E 滚装 特种 10.0 urgent - 低 关键瓶颈:WH-East已满载,Vessel-A(紧急)的500TEU货物无处存放。WH-West剩余2000TEU,但Vessel-C的1200TEU + Vessel-B的800TEU = 2000TEU,恰好占满,Vessel-A仍无仓储空间。
优化调度方案:
- Berth-01 → Vessel-A(紧急,优先靠泊),货物转运至WH-West预留区域(需向Vessel-D协调300TEU空间延迟入库)
- Berth-02 → Vessel-B(正常),货物正常入WH-West
- Berth-03 → Vessel-E(紧急+特种),使用专用滚装卸货设施
- 等待区 → Vessel-C(散货,吃水14.2m需等Berth-01腾出后才能靠泊,因Berth-02/03最大吃水分别为12m和11.5m)
执行建议(需确认):
- 将Vessel-A分配至Berth-01
- 将Vessel-B分配至Berth-02
- 将Vessel-E分配至Berth-03
- 为Vessel-A申请WH-West紧急仓储500TEU
- Vessel-C预计等待时间:6.5小时后(Vessel-A卸货完成)
风险提示:Vessel-A为urgent级但目标仓库满载,建议同步联系外部仓储服务商。
差异总结:
| 维度 | RAG回答 | OAG回答 |
|---|---|---|
| 数据来源 | 历史文档片段 | 本体实时数据 |
| 分析深度 | 泛泛而谈的原则 | 具体的数量化方案 |
| 推理过程 | 不可见 | 完整推理链可追溯 |
| 瓶颈识别 | 未识别 | 精确定位仓储瓶颈 |
| 执行能力 | 无 | 5个可执行Action |
| 审计追溯 | 引用文档名 | 每步推理可验证 |
六、OAG的局限与挑战
技术选型最忌讳"拿着锤子看什么都是钉子"。OAG虽然强大,但并非万能。以下是它的主要局限:
1. 本体构建成本高
这是OAG最大的门槛。构建一个覆盖核心业务的企业本体,需要业务专家(懂业务)、数据工程师(懂数据)、本体工程师(懂建模)三方深度协作。Palantir的典型实施周期是3-6个月,投入成本以百万人民币计。对于中小企业而言,这个门槛不低。
2. 需要深入的业务理解
本体的质量直接决定了OAG的上限。如果本体中的对象定义不准确、关系建模有遗漏、Action的前置条件有漏洞,OAG的推理结果就会出错。这要求构建团队对企业业务有极深的理解——不是"看过文档"的层面,而是"能写出SOP"的层面。
3. 对结构化数据依赖度高
OAG的强大推理能力建立在结构化本体之上。如果一个企业的核心知识全存在于非结构化文档中(如大量PDF合同、Word规章、会议纪要),且缺乏结构化的业务系统(ERP/CRM/MES),那么构建本体的难度会呈指数级上升。需要先将非结构化知识通过NER、关系抽取等技术转化为结构化本体——这本身就是一个巨大的工程挑战。
4. 不适合纯非结构化场景
如果你的需求是"让AI帮我总结这100份研报的核心观点"或者"基于这些技术文档回答开发者的问题",RAG仍然是更合适的选择。这类场景的核心需求是信息检索和文本生成,不涉及复杂的业务逻辑推理和系统操作,OAG的强大能力在这里毫无用武之地,反而增加了不必要的构建成本。
何时不应选OAG
- 知识库规模在1万文档以下,且以非结构化文档为主
- 需求以信息检索、文档摘要、知识问答为主
- 缺乏结构化业务系统支撑
- 团队没有业务专家深度参与
- 预算和周期有限,需要快速验证AI价值
在这些场景下,RAG(甚至是简单的Prompt Engineering)是更务实的选择。OAG适合的是那些RAG已经"撞墙"的场景——知识规模大、业务逻辑复杂、需要决策执行闭环的企业级应用。
七、小结与下篇预告
OAG不是RAG的"升级版",而是一种根本不同的范式。RAG在向量空间中做模糊匹配,OAG在语义拓扑中做精确推理;RAG只能输出文本,OAG能驱动业务系统执行操作;RAG的推理是黑盒,OAG的推理链每一步都可审计。
这两者不是非此即彼的关系。在成熟的企业AI架构中,RAG和OAG各有其位置:RAG处理非结构化知识的检索与生成,OAG处理结构化业务逻辑的推理与执行。真正的挑战在于——何时引入OAG、如何构建企业本体、如何让两种范式协同工作。
下一篇预告:我们将进入工程实战环节,详细拆解企业本体的构建过程——从数据源接入、自动本体推断,到Data Health数据治理。我会用真实的代码示例演示如何从零开始构建一个企业级本体,以及Palantir和迈富时Gen AI OS在本体构建上的工程实践。
关注我的付费专栏「大模型工程师修炼手记」,持续获取大模型工程化最前沿的实战经验!
href="https://csdnimg.cn/release/blogv2/dist/mdeditor/css/editerView/markdown_views-e1cc28b339.css" rel="stylesheet"> href="https://csdnimg.cn/release/blogv2/dist/mdeditor/css/style-d1e89cace4.css" rel="stylesheet">参考文献:
[1] Palantir Technologies. “Palantir AIP: Ontology-Driven AI Platform.” Official Documentation, 2024-2025.
[2] Zhang et al. “Ontology RAG: Better and Faster Biomedical Code Mapping with Retrieval-Augmented Generation.” arXiv:2502.18992, 2025.
[3] Schmid, P. “The Rise of Harness Engineering.” philschmid.blog, 2026.
[4] 迈富时(Marketingforce). “GenAI OS: 企业AI原生操作系统白皮书.” 2025.
[5] Fayyaz et al. “Collapse of Dense Retrievers.” arXiv:2503.05037, 2025.
内容来源:csdn.net
作者昵称:Tom·Ge
原文链接:https://blog.csdn.net/gedonshen/article/details/162788053
作者主页:https://blog.csdn.net/gedonshen


延伸阅读 · 我的付费专栏
觉得这篇文章对你有帮助?我把同类主题的系统化内容沉淀成了付费专栏,欢迎订阅支持持续输出:
| 专栏 | 定价 | 内容 |
|---|---|---|
| 大模型工程师修炼手记 | 19.9 元 | AI 编程 / Agent 深度实战 |
| AI时代程序员的自我提升 | 49.9 元 | AI 时代成长方法论 |
本文配套代码 / 资料包:欢迎在评论区留言「求代码」,我会私信发送完整资源!
转载自 CSDN-专业IT技术社区
原文链接:https://blog.csdn.net/gedonshen/article/details/162788053

