



💪 今日博客励志语录:
所谓前途,并不是远处有一条已经铺好的路,而是你每解决一个眼前的问题,脚下就多出一块路。
思维导图
CUDA 程序
│
├── Host Code:CPU 侧代码
│      ↓
│   nvcc 作为编译入口
│      ↓
│   调用 Host Compiler
│   例如 g++
│      ↓
│   CPU 目标代码
│
└── Device Code:GPU 侧代码
       ↓
    CUDA Device 编译链
       ↓
    compute_XX
    虚拟架构 / 虚拟计算能力目标
       ↓
       PTX
    虚拟 GPU 指令集
       ↓
      sm_XX
    真实 GPU 架构代码生成目标
       ↓
      Cubin / SASS
    GPU 真正可以执行的机器代码
       ↓
       GPU

与此同时,还需要区分两个兼容维度:

CUDA 软件栈  ↔  NVIDIA Driver
                 ↓
          nvidia-smi 中的
            CUDA Version

Device Code  ↔  GPU 硬件
                 ↓
          Compute Capability
引入
在此前学习 CUDA 的过程中,我们已经认识到一个最基本的事实:
CUDA 程序
=
CPU 侧代码
+
GPU 侧代码
例如:
#include <cuda_runtime.h>

__global__ void add(int* a, int* b, int* c)
{
    int i = blockIdx.x * blockDim.x + threadIdx.x;
    c[i] = a[i] + b[i];
}

int main()
{
    // CPU / Host 代码

    add<<<1, 256>>>(...);

    return 0;
}
这里:
int main()
主要运行在 CPU 上。
而:
__global__ void add(...)
则是最终需要运行在 GPU 上的代码。
因此 CUDA 程序与普通 C++ 程序最大的不同之一就在于:
同一个源文件中,同时存在两套最终运行在不同硬件上的代码。
普通的 g++ 主要负责 CPU 代码的编译,其并不能完整识别 CUDA 所扩展出来的:
__global__
__device__
<<<grid, block>>>
threadIdx
blockIdx
等 CUDA 语法和编程模型。
所以 CUDA 提供了:
nvcc
作为 CUDA 程序的编译入口。
但是如果只停留在:
nvcc test.cu -o test
这一条命令上,我们只能知道“CUDA 程序可以被编译”,却并不知道:
GPU 侧代码究竟经历了什么?

PTX 是什么?

compute_86 是什么?

sm_86 又是什么?

Compute Capability 和 GPU 架构有什么关系?

为什么 nvidia-smi 里还有一个 CUDA Version?

-arch=sm_86 到底指定了什么?
本文就沿着这一条逻辑链逐步展开。
一、为什么 CUDA 编译不能简单交给 g++
1. CUDA 程序同时面向 CPU 和 GPU
普通 C++ 程序最终主要面向 CPU:
C/C++
  ↓
g++
  ↓
CPU 机器代码
  ↓
CPU 执行
而 CUDA 程序不同:
                    CUDA .cu
                       │
              ┌────────┴────────┐
              ↓                 ↓
          Host Code         Device Code
          CPU 侧代码         GPU 侧代码
              ↓                 ↓
             CPU               GPU
CPU 与 GPU 本身就是两种不同的处理器。
它们:
硬件结构不同
执行模型不同
机器指令不同
所以最终自然也不可能使用完全相同的一套编译流程。
2. nvcc 更适合理解成“CUDA 编译总入口”
执行:
nvcc test.cu -o test
从使用者角度来看,这和:
g++ test.cpp -o test
非常相似。
都是:
输入源文件
    ↓
一条编译命令
    ↓
得到最终可执行文件
但这只是上层看到的结果。
nvcc 本身更适合理解成一个:
CUDA Compiler Driver,也就是 CUDA 编译流程的总入口和组织者。
其会针对 Host Code 与 Device Code 走不同的编译链。
可以先建立这样的心智模型:
                        test.cu
                           │
                          nvcc
                           │
               ┌───────────┴───────────┐
               ↓                       ↓
            Host Code               Device Code
            CPU 代码                 GPU 代码
               ↓                       ↓
       Host Compiler              CUDA Device
        例如 g++                   编译链
               ↓                       ↓
        CPU 目标代码                GPU 代码生成
               │                       │
               └───────────┬───────────┘
                           ↓
                          链接
                           ↓
                     最终可执行文件
因此:
nvcc并不是简单地把整个.cu文件当成一种普通源代码直接编到底,而是负责组织 CUDA 程序中 Host 与 Device 两侧的编译工作。
二、为什么 GPU 代码不是一步直接生成机器指令
现在先把 CPU 一侧放下,只聚焦:
Device Code
也就是 GPU 代码这一侧。
最终目标显然是:
CUDA C++
   ↓
GPU 能真正执行的机器指令
但是和 CPU 编译类似,中间通常并不是简单一步到位。
我们熟悉的 CPU 编译过程,可以粗略理解成:
C / C++
   ↓
编译器
   ↓
汇编层
   ↓
CPU 机器指令
CUDA GPU 代码同样存在一个非常重要的中间层:
CUDA C++
   ↓
PTX
   ↓
GPU 机器代码
这里的:
PTX
就是理解 CUDA GPU 编译链的第一个关键概念。
三、PTX:CUDA C++ 与真实 GPU 机器代码之间的中间层
1. PTX 是什么
PTX 全称:
Parallel Thread Execution
对于当前阶段,可以先把它理解成:
NVIDIA 为 CUDA GPU 代码定义的一套虚拟指令集 / 中间指令表示。
例如我们写:
__global__ void add(int* a, int* b, int* c)
{
    int i = blockIdx.x * blockDim.x + threadIdx.x;
    c[i] = a[i] + b[i];
}
这是人更容易编写和理解的 CUDA C++。
经过编译以后,其中类似:
blockIdx.x
blockDim.x
threadIdx.x
这样的 CUDA 编程模型概念,会继续向更加底层的表示进行转换。
PTX 中可能会看到类似:
mov.u32
mad.lo.s32
ld.global
st.global
这样的指令形式。
因此从抽象层次来看:
CUDA C++
    ↓
高级语言

PTX
    ↓
虚拟 GPU 指令

最终 GPU 机器代码
    ↓
真实硬件执行指令
2. PTX 可以类比 CPU 汇编,但不能完全等同
为了快速建立直觉,我们确实可以先做一个类比:
CPU:

C++
 ↓
汇编
 ↓
CPU 机器指令
CUDA:
CUDA C++
   ↓
PTX
   ↓
GPU 机器指令
但是这里只能写成:
PTX ≈ GPU 世界中的“中间汇编”
而不能简单写成:
PTX = 某款 GPU 的真实汇编
原因就在于:
PTX 并没有直接绑定死到某一款具体 GPU 的真实机器指令。
传统 CPU 汇编通常已经与某一套真实 ISA 强相关,例如:
x86-64 汇编
ARM64 汇编
而 PTX 更像是:
NVIDIA 定义的一套虚拟 GPU ISA
它后面仍然需要进一步针对真实 GPU 生成最终机器代码。
所以完整链路应该理解成:
CUDA C++
   ↓
PTX
   ↓
针对具体 GPU 架构继续编译
   ↓
真实 GPU 机器代码
这也是 PTX 被称为“虚拟指令集”的根本原因。
四、既然 PTX 是虚拟指令,为什么还需要计算能力
理解到这里,很容易产生一个问题:
如果 PTX 已经是一套统一的虚拟 GPU 指令集,那么是不是所有 NVIDIA GPU 都可以直接支持同一份 PTX?
答案并不是简单的“所有 GPU 都完全一样”。
因为不同 GPU 世代的硬件能力并不相同。
例如,较老的一些 GPU 可能只支持普通 CUDA Core 计算、全局内存访问、共享内存等基础能力;而更新的 GPU 还会增加新的硬件能力,例如 Tensor Core,用于加速特定类型的矩阵计算。
可以先直观理解成:
较老 GPU:
支持普通 CUDA Core 计算
支持全局内存访问
支持共享内存
……

较新 GPU:
支持普通 CUDA Core 计算
支持全局内存访问
支持共享内存
……
+
支持 Tensor Core 等新的硬件能力
如果我们的 CUDA 代码只使用这些较老 GPU 本来就支持的基础能力,那么旧 GPU 也有可能正常运行。
但是如果 CUDA 代码使用了某种只有新 GPU 才具备的硬件能力,例如依赖 Tensor Core 的功能,那么旧 GPU 本身没有对应的硬件支持,就无法完成这种计算。
为了方便后面继续讨论,我们可以把这些具体硬件能力进一步抽象一下。
假设:
较老 GPU:
支持 A
支持 B
支持 C
而更新一代 GPU 在此基础上增加了新的能力:
较新 GPU:
支持 A
支持 B
支持 C
支持 D
支持 E
这里的:
A / B / C
可以理解成较早已经存在的 GPU 硬件能力,而:
D / E
则代表后来新增加的硬件功能。
如果 CUDA 代码只使用:
A / B / C
那么较老 GPU 和较新 GPU 都可能支持。
但如果 CUDA 代码使用了:
D
那么:
较新 GPU
→ 支持 D
→ 可以实现

较老 GPU
→ 没有 D
→ 无法实现
于是问题就来了:
PTX 虽然是一套虚拟 GPU 指令集,但它依然必须告诉系统:这份 PTX 最低假设底层 GPU 具备哪一档硬件能力?
这也就是为什么 PTX 还需要和:
Compute Capability
联系起来。
也就是说,Compute Capability 本质上就是在描述:
这一档 GPU 到底支持哪些硬件能力
因此即使 PTX 是虚拟指令,它仍然需要表达:
这份 PTX 可以假设底层 GPU
至少具备什么能力?
于是就引出了:
Compute Capability
也就是:
计算能力
五、Compute Capability:GPU 的硬件能力版本
1. Compute Capability 不是“性能评分”
NVIDIA 会为 GPU 定义一个:
Compute Capability
通常简称:
CC
形式为:
X.Y
例如:
7.5
8.0
8.6
8.9
9.0
其中:
X = Major Version
    主版本号

Y = Minor Version
    次版本号
例如:
Compute Capability 8.6
                   │ │
                   │ └── Minor = 6
                   │
                   └──── Major = 8
但是这里一定不要把:
8.6
理解成:
GPU 性能 8.6 分
Compute Capability 描述的是:
这块 GPU 对 CUDA 编程模型暴露了哪一档硬件功能和指令能力。
它关注的是:
支持哪些计算特性
支持哪些指令语义
支持哪些数据类型
支持哪些原子操作
共享内存等硬件规格
SM 能力
Tensor Core 等相关能力
……
而不是直接描述:
显存多大
显存带宽多高
实际算力有多强
游戏帧数有多高
因此:
Compute Capability 越高,并不等价于实际性能一定越高。
同一个 Compute Capability 下,不同 GPU 也完全可以拥有不同的:
SM 数量
显存容量
显存带宽
工作频率
功耗设计
浮点运算吞吐
下面这张图正好体现了这一点。
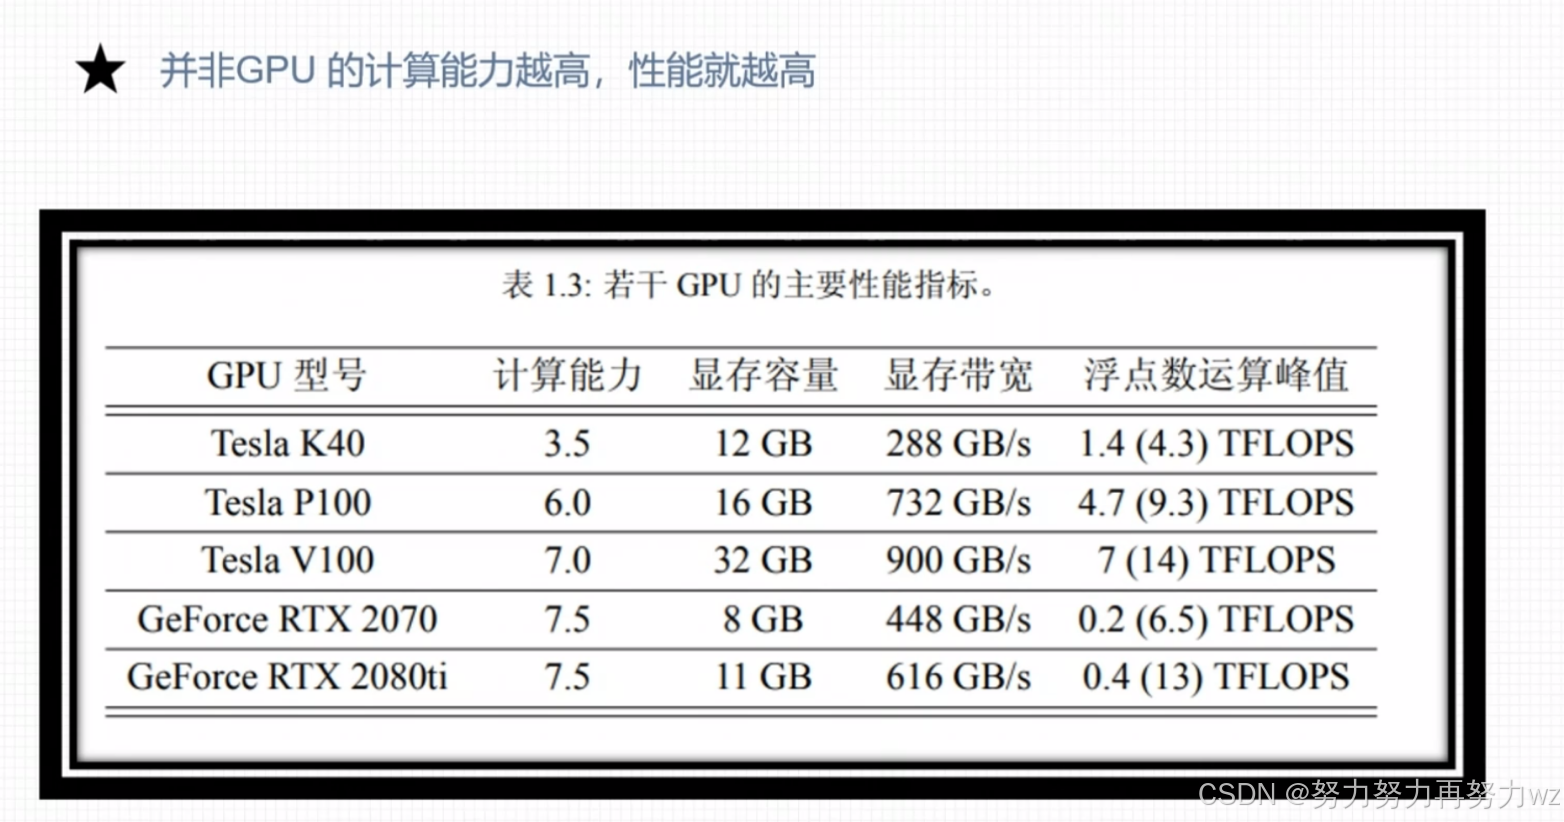
例如图中 RTX 2070 与 RTX 2080 Ti 都属于:
Compute Capability 7.5
但它们的显存容量、显存带宽以及实际浮点计算峰值明显不同。
所以应该建立:
Compute Capability
        ≠
GPU 性能评分
而应该理解成:
Compute Capability
        =
GPU 的 CUDA 硬件能力版本
2. Major 与 Minor 怎么理解
可以先建立一个直觉:
Major Version
    ↓
较大的硬件能力代际变化

Minor Version
    ↓
同一大能力体系中的进一步变化
例如:
8.0
8.6
8.9
它们 Major 都是:
8
但是 Minor 不同,因此具体硬件功能和代码生成目标仍然可能存在差异。
六、Kepler、Turing、Ampere 到底是什么
在 CUDA 和 GPU 资料中,我们经常会看到:
Kepler
Maxwell
Pascal
Volta
Turing
Ampere
Ada Lovelace
Hopper
Blackwell
这些并不是 CUDA API,也不是 CUDA Toolkit 版本。
它们本质上是:
NVIDIA 不同 GPU 微架构世代的名称。
NVIDIA 很喜欢使用科学家、数学家、计算机科学家等人物的名字来命名 GPU 架构,例如:
Kepler        → Johannes Kepler
Maxwell       → James Clerk Maxwell
Pascal        → Blaise Pascal
Volta         → Alessandro Volta
Turing        → Alan Turing
Ampere        → André-Marie Ampère
Ada Lovelace  → Ada Lovelace
Hopper        → Grace Hopper
Blackwell     → David Blackwell
但是要建立一个非常关键的认知:
GPU 架构名称和 Compute Capability 并不是简单的一一对应关系。
下面这张图展示了架构名称、Compute Capability 与 sm_XX 之间的关系。
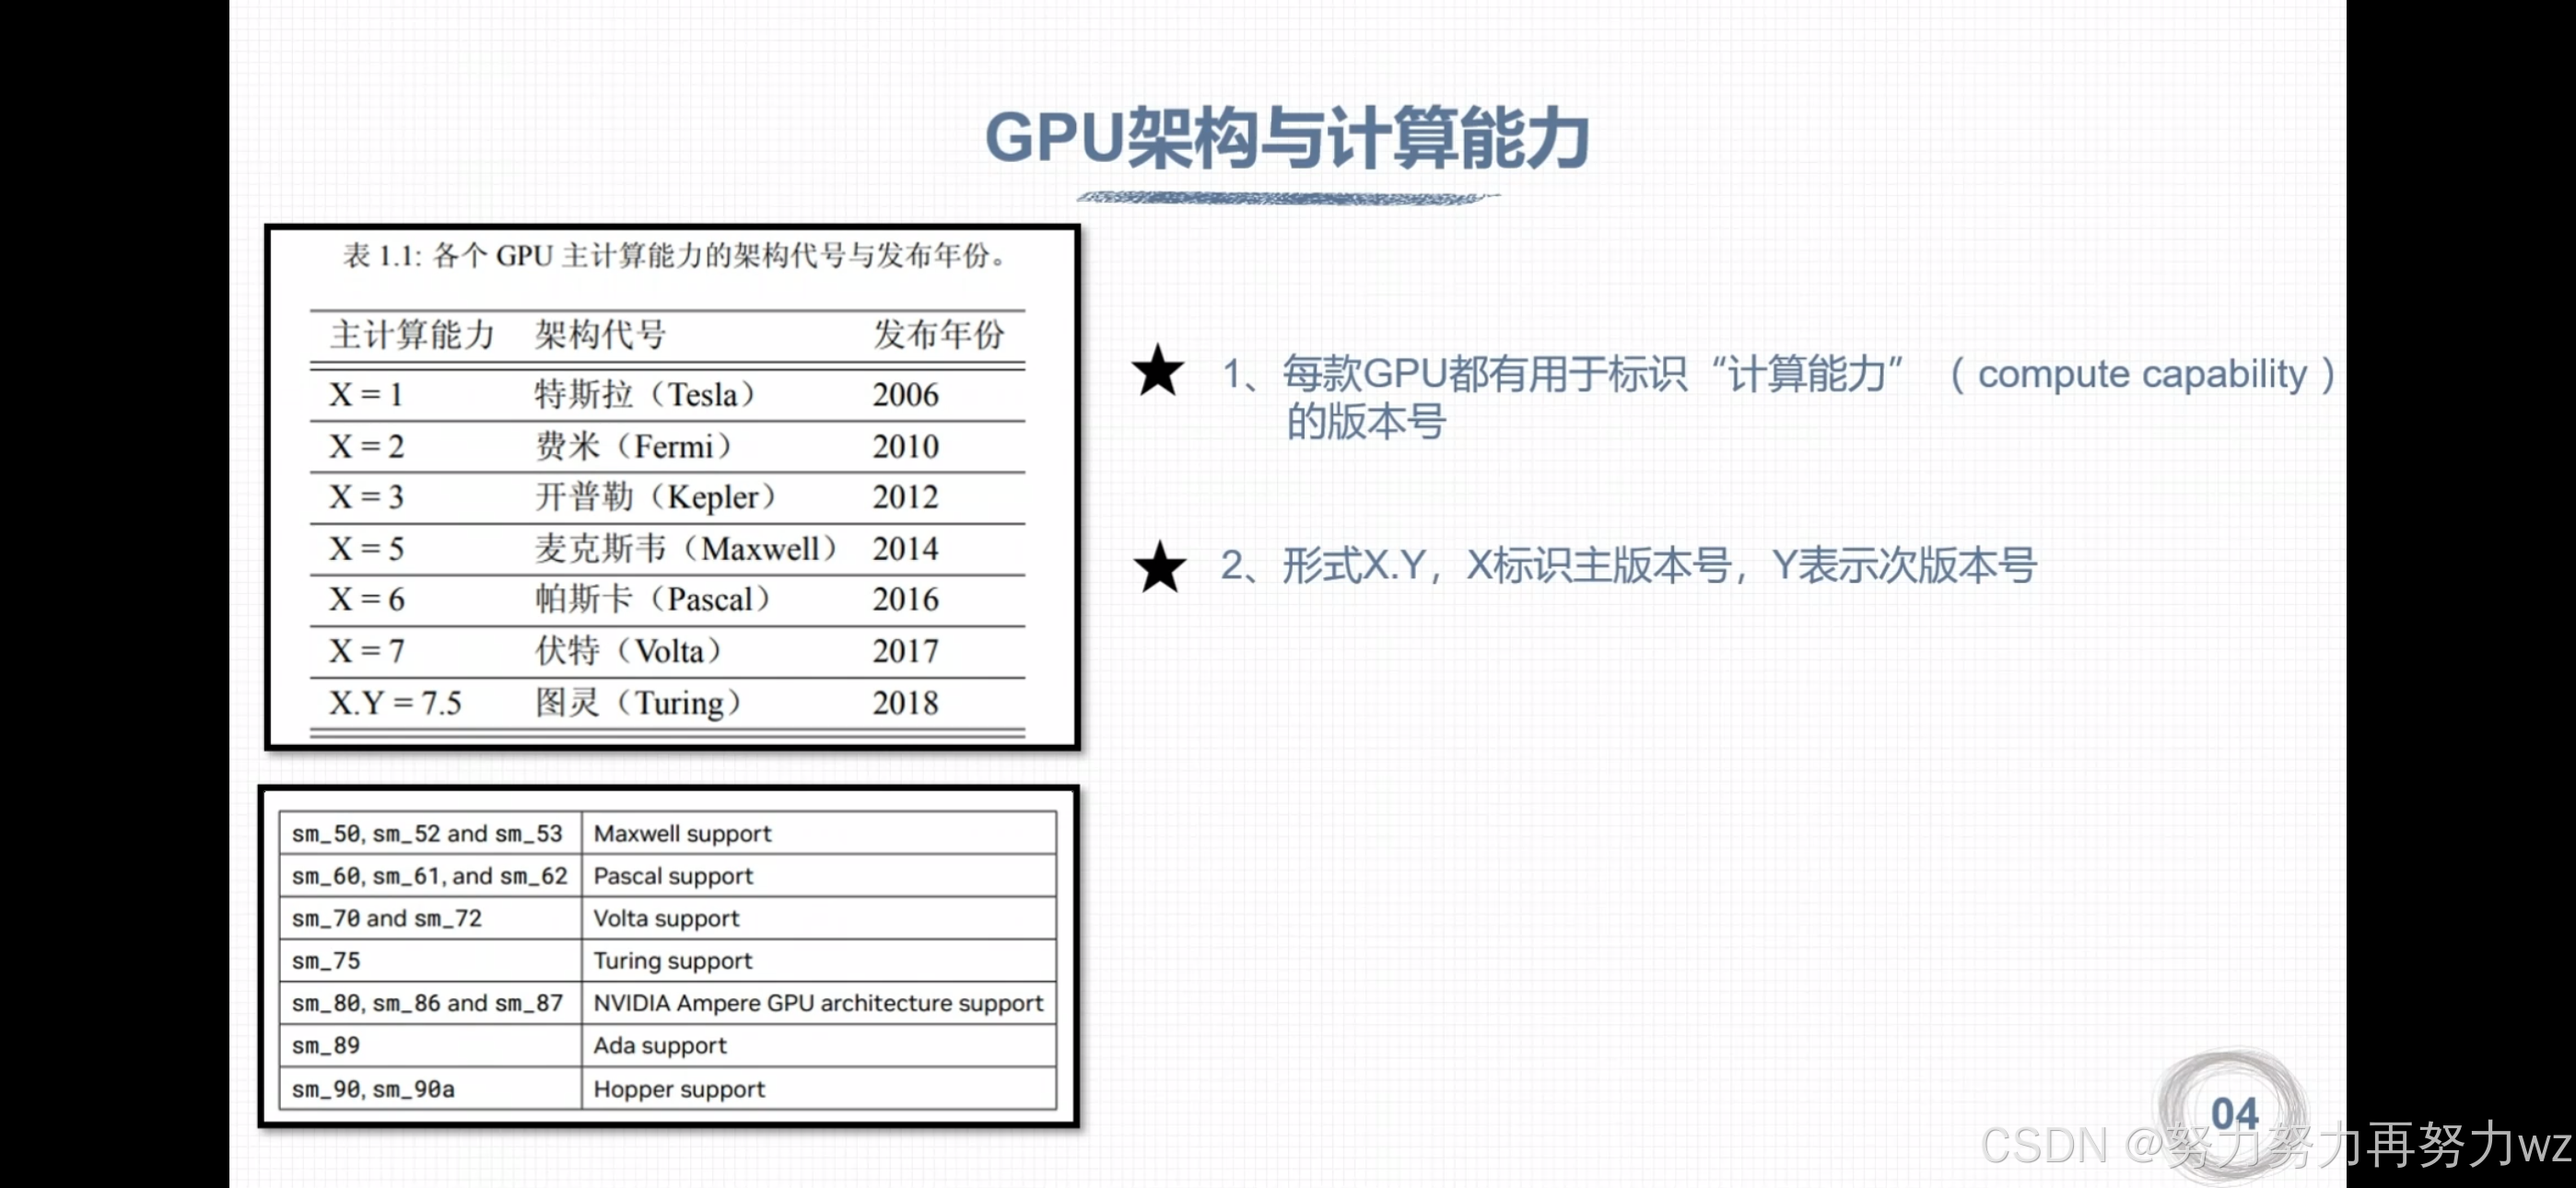
例如:
Volta
→ CC 7.0

Turing
→ CC 7.5
它们架构世代已经不同,但是 Major 都是:
7
再例如 Ampere 架构内部还可能对应:
CC 8.0
CC 8.6
CC 8.7
而后来的 Ada Lovelace:
CC 8.9
Major 依然是:
8
因此不能理解成:
Major 8
=
Ampere
更加准确的层次是:
GPU 微架构世代
例如 Ampere
        ↓
具体 GPU 芯片 / 产品
        ↓
拥有一个确定的 Compute Capability
例如 8.6
一个 GPU 架构世代可能对应一个或多个 Compute Capability;而某一块具体 GPU 设备本身只有一个确定的 Compute Capability。
因此:
Ampere
 ├── CC 8.0
 ├── CC 8.6
 └── CC 8.7
这种关系是合理的。
七、compute_XX:给 PTX 指定“虚拟计算能力目标”
认识了 Compute Capability 以后,再来看:
compute_80
compute_86
compute_89
就不再神秘了。
例如:
compute_86
数字 86 本质上就是:
Compute Capability 8.6
去掉小数点后的写法。
因此:
CC 7.5 → compute_75
CC 8.0 → compute_80
CC 8.6 → compute_86
CC 8.9 → compute_89
CC 9.0 → compute_90
这里的 compute_XX 被称为:
Virtual Architecture
虚拟架构目标
可以先这样理解:
在生成 PTX 时,告诉编译器:这份 PTX 可以假设底层 GPU 至少具备 Compute Capability X.Y 这一档提供的能力。
例如:
CUDA C++
   ↓
compute_80
   ↓
PTX
这里的含义不是:
我要在某一块具体 GPU 上运行
而是:
生成 PTX 时,
允许依赖 CC 8.0 这一档硬件能力
所以 compute_80 更像是:
一条能力门槛
1. 为什么 PTX 也需要版本约束
假设:
compute_86
那么这份 PTX 就可以使用:
CC 8.6 所允许的能力
如果实际 GPU 只有:
CC 8.0
那么问题并不是:
GPU 已经开始执行机器代码,
执行到一半发现某条指令不会。
更加准确的理解是:
compute_86 PTX
       ↓
准备针对 CC 8.0 GPU 生成机器代码
       ↓
发现 PTX 所依赖的能力
超过这块 GPU 的硬件能力
       ↓
无法生成合法的目标机器代码
因此普通 PTX 的兼容规则可以先记成一句非常简单的话:
实际 GPU Compute Capability
              >=
PTX 的 compute_XX
也就是:
大于等于即可。
例如:
compute_80 PTX
面对:
CC 7.5  → 不满足
CC 8.0  → 满足
CC 8.6  → 满足
CC 8.9  → 满足
CC 9.0  → 满足
因此:
compute_80
可以理解成:
这份普通 PTX 的最低硬件能力门槛是 CC 8.0。
八、SM 与 sm_XX:不要把两者混成一个概念
1. SM 本身是什么
SM 全称:
Streaming Multiprocessor
它是 NVIDIA GPU 内部真实存在的硬件执行单元。
我们此前已经建立过:
GPU
 ├── SM
 ├── SM
 ├── SM
 └── SM
线程块会被调度到 SM 上,Warp 最终在 SM 内进行调度和执行。
所以:
SM
本身不是“指令集”。
它是:
真实硬件执行单元
2. 那 sm_86 又是什么
当我们在 CUDA 编译命令中看到:
sm_86
此时已经不是在说:
某一个具体 SM 单元
而是在说:
以 Compute Capability 8.6 所对应的真实 GPU / SM 架构作为机器代码生成目标。
例如:
sm_80
sm_86
sm_89
sm_90
分别表示不同的真实 GPU 代码生成目标。
这里最关键的是:
sm_XX 后面的 XX
并不是 NVIDIA 另外设计的一套独立编号。
它直接来自:
Compute Capability X.Y
例如:
CC 7.5 → sm_75
CC 8.0 → sm_80
CC 8.6 → sm_86
CC 8.9 → sm_89
CC 9.0 → sm_90
所以:
sm_86
本质上可以理解成:
针对 CC 8.6 这一档真实硬件能力
生成 GPU 机器代码
九、CC、compute_XX 与 sm_XX 到底是什么关系
到这里可以把三个概念放到一张图里:
                 Compute Capability 8.6
                    硬件能力规范
                         │
             ┌───────────┴───────────┐
             ↓                       ↓
        compute_86                  sm_86
      虚拟架构目标               真实代码生成目标
             ↓                       ↓
            PTX                 GPU 二进制机器代码
因此可以把三者压缩成:
CC X.Y
=
硬件能力版本

compute_XY
=
这套能力规范在 PTX 虚拟架构层的表示

sm_XY
=
这套能力规范在真实 GPU 机器代码生成层的表示
例如:
CC 8.6
  │
  ├── compute_86
  │      ↓
  │   生成以 8.6 能力为基础的 PTX
  │
  └── sm_86
         ↓
      针对 8.6 真实硬件生成机器代码
因此以前很容易产生一种感觉:
sm_86 中的 86
是不是某种独立的 SM 架构版本?
这个直觉并不是完全错误,因为:
sm_80
sm_86
sm_89
确实是在区分不同的真实代码生成目标。
但是现在需要补充:
这套
sm_XX编号本身就是沿用 Compute Capability 的编号体系,并不是另一套独立版本系统。
十、PTX 与 Cubin 的兼容范围为什么不同
前面我们已经认识到:
普通 PTX
具有比较强的前向兼容能力。
例如:
compute_80 PTX
可以在运行时针对:
CC 8.0
CC 8.6
CC 8.9
CC 9.0
……
等满足能力要求的 GPU 继续 编译。
所以普通 PTX 可以先记:
实际 GPU CC
   >=
PTX compute_XX
即可。
但是如果已经生成:
sm_80
对应的 Cubin,那么它已经是:
面向某一档真实 GPU 架构生成的机器代码
因此兼容范围会明显更窄。
普通情况下可以先记成:
sm_XY Cubin
通常要求:
GPU Major 必须相同
并且 GPU Minor >= 目标 Minor
例如:
sm_80 Cubin

CC 8.0 → 可以
CC 8.6 → 可以
CC 8.9 → 可以
CC 9.0 → 不属于普通跨 Major 二进制兼容范围
而:
sm_86 Cubin

CC 8.0 → 不可以
CC 8.6 → 可以
CC 8.9 → 可以
因此:
PTX
承担了一个非常重要的作用:
为未来更高 Compute Capability 的 GPU 保留继续 JIT 编译的空间。
十一、CUDA Version 与 Compute Capability 是两个不同维度
学习到 Compute Capability 后,很容易联想到:
nvidia-smi
默认输出中经常看到:
Driver Version: ...
CUDA Version: ...
于是很容易产生一个误区:
nvidia-smi 中的 CUDA Version
是不是就等于 GPU 的计算能力?
或者:
是不是 CUDA 12.x 就对应 CC 8.x?
答案都是否定的。
这里必须拆成两个完全不同的分支。
1. 第一条分支:CUDA 软件栈与 Driver 的兼容
CUDA 程序并不是自己直接操作 GPU 硬件。
例如:
cudaMalloc(...)
cudaMemcpy(...)
kernel<<<...>>>(...)
最终都需要经过 CUDA 软件栈以及 NVIDIA Driver 与硬件完成交互。
可以先建立:
CUDA 应用
   ↓
CUDA Runtime / Driver API
   ↓
NVIDIA Driver
   ↓
GPU 硬件
因此上层 CUDA 软件需要调用 Driver 所提供的能力。
如果:
CUDA 软件栈太新
       ↓
需要较新的 Driver 能力
       ↓
当前 Driver 太老
就可能出现软件兼容问题。
所以:
nvidia-smi
默认输出中的:
CUDA Version
更加准确地说表示:
当前 NVIDIA Driver 所支持的最高 CUDA 软件兼容版本。
2. 第二条分支:Device Code 与 GPU 硬件能力的兼容
另一条链则是:
CUDA Device Code
       ↓
PTX / Cubin
       ↓
GPU Compute Capability
       ↓
真实 GPU 是否能够支持
这里关注的是:
GPU 硬件本身有没有这个能力
例如:
程序要求 CC 8.6 的硬件能力

实际 GPU
=
CC 8.0
即使 Driver 非常新,也无法凭空让硬件增加原本不存在的能力。
所以两个分支分别是:
第一维度:

CUDA 软件栈
    ↕
NVIDIA Driver

关注:
软件兼容
以及:
第二维度:

Device Code
    ↕
GPU

关注:
硬件 Compute Capability
3. 用一个服务器类比理解第一条分支
可以做一个不完全严格、但比较形象的类比。
假设 HTTP Server 只能正确处理某些协议版本和功能。
客户端发来的请求如果使用服务器完全不理解的新能力:
Client
  ↓
新版本请求能力
  ↓
Server 不支持
服务器就无法正确处理。
CUDA 软件栈与 Driver 之间也存在类似的“软件能力匹配”问题。
但是这里要注意:
CUDA Driver 不是在解析一种类似 HTTP 文本报文的东西。
CUDA 更准确的本质是:
API / ABI / Driver Capability
的兼容问题。
这个类比只用于理解:
上层软件提出的能力
必须是底层软件能够支持的
而不能继续把两者机械等同。
十二、三个经常混淆的“版本”必须彻底分开
到这里可以把:
nvcc --version

nvidia-smi 中的 CUDA Version

Compute Capability
彻底区分开。
nvcc --version
回答:
我实际安装的 CUDA Toolkit / nvcc
是什么版本?
例如:
nvcc --version
可能看到:
Cuda compilation tools, release 12.0
这属于:
CUDA 开发工具链版本
nvidia-smi 中的 CUDA Version
回答:
当前 Driver
最高支持到哪一档 CUDA 软件兼容能力?
属于:
CUDA 软件栈
     ↕
Driver
这一条兼容链。
Compute Capability
回答:
这块 GPU 硬件
属于哪一档 CUDA 硬件能力?
例如:
8.6
8.9
9.0
属于:
Device Code
    ↕
GPU 硬件
这一条兼容链。
最终可以画成:
             CUDA Toolkit
             nvcc --version
                   │
                   │ 软件兼容
                   ↓
            NVIDIA Driver
                   │
         nvidia-smi CUDA Version
                   │
                   ↓
                  GPU
                   ↑
                   │ 硬件能力
                   │
          Compute Capability
                   ↑
                   │
            PTX / Cubin
十三、回到 nvcc:-arch 到底指定了什么
现在有了:
PTX
Compute Capability
compute_XX
sm_XX
这些基础,再来看:
-arch
就非常自然了。
最简单的 CUDA 编译命令是:
nvcc test.cu -o test
它与:
g++ test.cpp -o test
在使用体验上类似:
一条命令
   ↓
完成编译与链接
   ↓
生成最终程序
这里并不是没有中间阶段,而是:
nvcc
帮助我们把多个编译阶段组织起来了。
加入:
-arch
以后,就是开始显式告诉 nvcc:
Device Code 希望按照什么 GPU 架构目标进行代码生成。
1. -arch=compute_86
例如:
nvcc test.cu -arch=compute_86 -o test
这里:
compute_86
就是:
虚拟架构目标
其核心含义是:
生成 PTX 时,
假设目标 GPU 至少具备 CC 8.6 的能力
可以先理解成:
CUDA C++
   ↓
compute_86
   ↓
PTX
当前 nvcc 中,这种写法属于 PTX-only 的目标形式。
2. -arch=sm_86
更常见的是:
nvcc test.cu -arch=sm_86 -o test
这里:
sm_86
表示:
以 CC 8.6 所对应的真实 GPU 架构作为代码生成目标。
所以从逻辑上可以理解为:
CUDA C++
   ↓
compute_86
   ↓
PTX
   ↓
sm_86
   ↓
真实 GPU 二进制
而当前 nvcc 对:
-arch=sm_86
提供了一个方便的简写语义。
可以近似展开为:
虚拟目标:
compute_86

真实代码目标:
sm_86

同时保留:
compute_86 PTX
因此:
nvcc test.cu -arch=sm_86 -o test
可以用一句人话理解成:
编译这个 CUDA 程序,GPU 侧以 CC 8.6 为能力基础生成 PTX,并为
sm_86真实架构生成对应的 GPU 二进制代码,同时保留相应 PTX 以提供更好的前向兼容能力。
3. 更完整的参数形式
以后继续深入 nvcc 时,会看到:
--gpu-architecture=compute_86
--gpu-code=sm_86,compute_86
其中:
--gpu-architecture
解决:
前端生成 PTX 时
假设什么虚拟计算能力
而:
--gpu-code
解决:
后端最终保留哪些真实 Cubin
以及是否保留 PTX
不过现阶段并不需要立刻深入复杂的:
-gencode
先把:
compute_XX
=
PTX 虚拟能力目标

sm_XX
=
真实 GPU 代码生成目标
固定下来即可。
十四、如何查询当前 GPU 的 Compute Capability
理解了这么多以后,一个最实际的问题就是:
我手上的 GPU 到底是什么 Compute Capability?
最直接的方法之一就是:
nvidia-smi --query-gpu=name,compute_cap
例如可能得到:
name, compute_cap
NVIDIA GeForce RTX XXXX, 8.9
这里:
8.9
就是这块 GPU 的:
Compute Capability
于是可以立刻得到:
CC = 8.9

对应虚拟目标:
compute_89

对应真实代码目标:
sm_89
如果想让输出更简洁,也可以使用:
nvidia-smi --query-gpu=name,compute_cap --format=csv,noheader
1. 也可以通过 CUDA Runtime API 查询
程序运行时,也可以通过 CUDA Runtime API 获取 Compute Capability。
例如:
#include <cuda_runtime_api.h>
#include <iostream>

int main()
{
    int device = 0;

    int major = 0;
    int minor = 0;

    cudaDeviceGetAttribute(
        &major,
        cudaDevAttrComputeCapabilityMajor,
        device
    );

    cudaDeviceGetAttribute(
        &minor,
        cudaDevAttrComputeCapabilityMinor,
        device
    );

    std::cout << "Compute Capability: "
              << major << "."
              << minor << '\n';

    return 0;
}
如果输出:
Compute Capability: 8.6
那么就可以对应:
compute_86
sm_86
十五、现在重新看整条 CUDA GPU 编译链
到这里,可以把此前零散的概念重新放回同一条链路。
CUDA .cu
   │
   │
   ├────────────────────────────────────┐
   │                                    │
   ↓                                    ↓
Host Code                           Device Code
CPU 代码                             GPU 代码
   │                                    │
   ↓                                    ↓
Host Compiler                        nvcc Device
例如 g++                              编译链
   │                                    │
   ↓                                    ↓
CPU 目标代码                     指定虚拟能力目标
                                   compute_XX
                                        │
                                        ↓
                                       PTX
                                虚拟 GPU 指令集
                                        │
                                        ↓
                                指定真实架构目标
                                     sm_XX
                                        │
                                        ↓
                                Cubin / GPU Binary
                                        │
                                        ↓
                                真实 GPU 机器指令
                                        │
   └──────────────────────┬─────────────┘
                          ↓
                       最终程序
                          ↓
                       运行阶段
                          ↓
                    NVIDIA Driver
                          ↓
                         GPU
其中:
Compute Capability
贯穿了虚拟与真实两个代码生成阶段。
例如:
CC 8.6
   │
   ├── compute_86
   │      ↓
   │   PTX 虚拟能力目标
   │
   └── sm_86
          ↓
       真实 GPU 代码目标
所以:
Compute Capability 是能力规范,
compute_XX是虚拟架构视角,sm_XX是真实代码生成视角。
十六、最后再把几个最容易混淆的问题一次说清
1. PTX 是不是 GPU 真正执行的机器指令?
不是。
PTX
=
虚拟 GPU ISA
其后还需要:
PTX
 ↓
针对 sm_XX 编译
 ↓
GPU Binary
GPU 最终执行的是面向真实硬件生成的机器代码。
2. compute_86 是不是某款具体 GPU?
不是。
它表示:
CC 8.6 的虚拟架构目标
用于约束:
生成 PTX 时可以依赖哪些 GPU 能力
3. sm_86 是不是第 86 个 SM?
不是。
这里:
86
来自:
Compute Capability 8.6
sm_86 表示:
面向 CC 8.6 对应真实 GPU/SM 架构
生成 GPU 二进制代码
4. SM 本身是不是指令集?
不是。
SM
=
Streaming Multiprocessor
=
GPU 内部真实硬件执行单元
而:
sm_86
是在 CUDA 编译语境下描述:
真实 GPU 代码生成架构目标
5. Compute Capability 越高是不是性能越强?
不一定。
它主要描述:
硬件功能版本
而实际性能还与:
SM 数量
频率
显存
带宽
功耗
芯片规模
具体工作负载
等大量因素有关。
6. Kepler、Turing、Ampere 是不是 Compute Capability 的主版本号?
不是。
它们是:
GPU 微架构世代名称
一个架构可能对应一个或多个 Compute Capability。
同时,不同架构也可能处于同一个 Compute Capability Major 之下。
7. nvidia-smi 中的 CUDA Version 是不是 GPU 的 Compute Capability?
不是。
nvidia-smi CUDA Version
主要反映:
Driver 的 CUDA 软件兼容能力
而:
Compute Capability
描述:
GPU 硬件能力
这是两个不同维度。
8. 普通 PTX 对 GPU 的版本要求是不是必须完全一致?
不是。
基础阶段可以直接记:
实际 GPU CC
   >=
PTX compute_XX
即可。
十七、最终心智模型
如果只保留本文最核心的一条链,可以记成:
我们写 CUDA C++
        ↓
程序员不用直接面对具体 GPU 机器指令
        ↓
nvcc 组织 CUDA 编译流程
        ↓
Host Code
交给 Host Compiler
例如 g++
        ↓
CPU 目标代码


Device Code
        ↓
指定 compute_XX
        ↓
告诉编译器:
PTX 可以假设什么 GPU 硬件能力
        ↓
生成 PTX
        ↓
PTX 是虚拟 GPU 指令集
        ↓
指定 sm_XX
        ↓
告诉编译器:
最终为哪一档真实 GPU 架构生成代码
        ↓
生成 Cubin / GPU 机器代码
        ↓
GPU 执行
而:
CC X.Y
是贯穿其中的核心硬件能力版本:
CC 8.6
   │
   ├── compute_86
   │     虚拟架构目标
   │
   └── sm_86
         真实架构目标
同时 CUDA 程序真正运行起来,还要再看两个维度:
维度一:
CUDA 软件栈
    ↕
NVIDIA Driver
    ↓
软件兼容性


维度二:
Device Code
    ↕
GPU Compute Capability
    ↓
硬件兼容性
到这里:
nvcc
PTX
Compute Capability
compute_XX
sm_XX
Cubin
Driver
nvidia-smi CUDA Version
这些原本看起来分散的概念,就能够真正被放进同一套 CUDA 编译与运行心智模型中。
转载自 CSDN-专业IT技术社区
原文链接:https://blog.csdn.net/2301_80260194/article/details/167083001

