

从 Fermi 到 Blackwell:英伟达 GPU 架构 15 年进化史,为什么每一代都"非升不可"?
摘要:英伟达 GPU 架构以科学家命名,Fermi 到 Blackwell 十代演进,都在回答:如何喂饱 AI 的算力饥渴。2012 年一张 Kepler 就能训 AlexNet,2023 年训 GPT-4 却需上万张 H100,算力需求每 3~4 个月翻一倍。升级围绕三件事:更多核心、更宽显存、AI 专用单元。Volta 发明 Tensor Core 让 AI 提速十倍,Turing 带来光追,Ampere 加稀疏,Hopper 引入 FP8,Blackwell 双芯合一支持 FP4,面向万亿参数 AI。
标签:#NVIDIA #GPU架构 #Blackwell #Hopper #TensorCore #AI算力 #CUDA
省流版
| 问题 | 一句话答案 |
|---|---|
| CPU 和 GPU 有什么区别? | CPU 是"全能博士",擅长复杂任务;GPU 是"小学生军团",擅长成千上万次简单重复计算 |
| 为什么架构总要升级? | AI 模型规模约每 3~4 个月翻一倍,算力追不上,只能靠新架构硬顶 |
| 每代升级主要在升什么? | 三件事:更多计算核心、更宽显存带宽、为 AI 定制的专用单元(Tensor Core / RT Core) |
| Tensor Core 是什么? | 专做矩阵乘法的加速器,而神经网络的计算大头就是矩阵乘法 |
| 为什么用科学家命名? | 致敬物理学/数学/计算机先驱:Fermi(费米)、Hopper(格蕾丝·赫柏)、Ada(洛夫莱斯)…… |
| 现在最新的是什么? | Blackwell(2024),为万亿参数生成式 AI 设计 |
1. 先讲个故事:CPU 是"博士",GPU 是"千军万马"
想象一个科研院所:
- CPU 是一位全能博士:智商高,什么难题都能解,但只有一个脑子,一次只能专心做一件事;
- GPU 是一支小学生军团:几千个孩子,每人只会"加减乘除"这种简单运算,但五千人同时开工,算得比博士快得多。
深度学习的核心运算(矩阵乘法)恰恰是海量简单重复计算:神经网络每一层都在做"一堆数乘起来再加起来"。这种事给博士做,委屈;给小学生军团做,完美。
一张对比表看清楚:
| 对比项 | CPU | GPU |
|---|---|---|
| 核心数 | 8~32 核 | 数千到上万核(H100 有 16896 个 CUDA 核心) |
| 单核能力 | 极强,能处理复杂逻辑 | 很弱,只会简单运算 |
| 擅长任务 | 操作系统、数据库、顺序逻辑 | 矩阵乘法、图像渲染、AI 训练推理 |
| 类比 | 全能博士 | 小学生军团 |
一句话:AI 不是"难题",而是"简单题 × 亿亿万次"——所以 GPU 天生就是为 AI 而生的。
2. 一张图看懂 15 年演进史
| 架构(中文) | 发布 | 关键创新 | 代表产品 |
|---|---|---|---|
| Fermi(费米) | 2010 | 统一计算架构,支持 CUDA 通用计算 | GTX 480、Tesla C2050 |
| Kepler(开普勒) | 2012 | 能效比大幅提升 | GTX 680、K20X |
| Maxwell(麦克斯韦) | 2014 | 功耗大幅优化,性能功耗比翻倍 | GTX 980、Titan X |
| Pascal(帕斯卡) | 2016 | 首次用上 HBM2 高带宽显存 | P100、GTX 1080 |
| Volta(伏特) | 2017 | 第一代 Tensor Core,AI 加速起点 | V100 |
| Turing(图灵) | 2018 | 第一代 RT Core,实时光线追踪 | RTX 20 系列、T4 |
| Ampere(安培) | 2020 | 第三代 Tensor Core、结构稀疏性 | A100、RTX 30 系列 |
| Ada Lovelace(艾达·洛芙莱斯) | 2022 | DLSS 3 帧生成,游戏 AI 化 | RTX 40 系列 |
| Hopper(赫柏) | 2022 | Transformer Engine、FP8 精度 | H100 |
| Blackwell(布莱克韦尔) | 2024 | 双芯封装、FP4、第五代 NVLink | B200、GB200 |
命名彩蛋:Hopper 是为了纪念计算机科学家 Grace Hopper(格蕾丝·赫柏,“bug” 一词的由来);Ada 则是致敬世界上第一位程序员 Ada Lovelace(艾达·洛芙莱斯)。
3. GPU 内部长什么样?拆开看核心组件
逐组件拆解(全部用生活类比):
| 组件 | 是什么 | 生活类比 |
|---|---|---|
| SM(流式多处理器) | GPU 的基本计算单元,由几百个核心组成 | 车间 |
| CUDA Core | SM 里的普通计算核心,做常规数学运算 | 车间里的普通工人 |
| Tensor Core | 专门做矩阵乘法/乘加的加速器,AI 专用 | 车间里的"AI 计算器" |
| RT Core | 专门计算光线与物体求交的单元,光追专用 | 车间里的"光影计算器" |
| 显存 + 带宽 | 存放数据的地方 + 数据搬运速度 | 仓库 + 传送带 |
| NVLink | 多张显卡之间的高速互联 | 卡与卡之间的高速公路 |
为什么越来越强调专用单元? 因为通用工人(CUDA Core)虽然万能,但效率有限。给数学计算配"计算器"(Tensor Core),给光影计算配"计算器"(RT Core),各司其职,速度和能效一起起飞——这也是近几代架构最大的升级主线:从"多雇工人"到"给工人发专用工具"。
4. 为什么必须升级?AI 的"算力饥渴"
4.1 模型规模十年涨了三万倍
| 模型 | 年份 | 参数量 | 训练代价 |
|---|---|---|---|
| AlexNet | 2012 | 0.6 亿 | 两张 GPU,几天 |
| VGG-19 | 2014 | 1.4 亿 | 数张 GPU |
| GPT-2 | 2019 | 15 亿 | 数十张 GPU |
| GPT-3 | 2020 | 1750 亿 | 数千张 V100,数月 |
| GPT-4 级别 | 2023(传闻) | 约 1.8 万亿(MoE) | 上万张 H100 |
从 2012 到 2022,模型参数规模大约涨了 3 万倍;OpenAI 在 AI and Compute 论文中的结论是:AI 训练算力需求约每 3.4 个月翻一倍。显卡升级的速度根本追不上,于是每一代架构都必须"开挂"。
4.2 一组真实数字:训练 GPT-3 到底有多费算力
GPT-3 论文公开的训练量约 3.14 × 10²³ FLOPs(浮点运算)。算一下需要多少张卡:
- 用 V100(FP16 约 125 TFLOPS):约 3 万 GPU·天(数千张卡跑数月);
- 用 H100(FP8 稀疏 3958 TFLOPS):约 900 多 GPU·天——快了一个数量级,但依然要千卡集群。
所以数据中心的本质变成了"AI 工厂":成千上万张卡连成一片,靠 NVLink 和高速网络把"仓库"(显存)和"传送带"(带宽)统一调度。
4.3 显存装不下模型
一张 H100 只有 80GB 显存,而一个万亿参数模型光权重就要 数 TB。放不下怎么办?只能把模型切碎,分到几千张卡的显存里,靠 NVLink(900GB/s~1.8TB/s)实时互传。显存带宽不够,显卡算得再快也白搭——这也是每一代都要升级 HBM 显存的原因。
4.4 精度越低,算得越快:从 FP64 到 FP4
AI 训练发现了一个"偷懒但有效"的规律:数值精度可以越用越低,反正神经网络很"皮实"。而精度每降一档,Tensor Core 算力几乎翻一倍。以 H100 官方数据表(带稀疏)为例:
| 精度 | Tensor Core 算力 | 典型用途 |
|---|---|---|
| FP64 | 67 TFLOPS | 科学计算(高精度) |
| FP32 | 67 TFLOPS | 常规计算 |
| TF32 | 989 TFLOPS | AI 训练入门精度 |
| FP16 / BF16 | 1,979 TFLOPS | 主流 AI 训练 |
| FP8 | 3,958 TFLOPS | Hopper 新增,大模型训练 |
| INT8 | 3,958 TOPS | 推理加速 |
到了 Blackwell,精度进一步压到 FP4,官方口径是"内存能撑起的模型大小直接翻倍"。
5. 逐代拆解:每一代解决了什么问题
2010 Fermi(费米)—— 统一计算架构的起点
- 痛点:早期 GPU 只能画图,通用计算很弱;
- 突破:统一 CUDA 架构,让 GPU 第一次成为"通用计算设备",奠定英伟达软件生态根基;
- 代表:GTX 480、Tesla C2050。
2012 Kepler(开普勒)—— 能效比革命
- 痛点:Fermi 性能强但功耗惊人(旗舰卡接近 300W);
- 突破:大幅提升每瓦性能,并支持 GPU 直连计算集群(Grid);
- 代表:K20X(当年的超算冠军卡)。
2014 Maxwell(麦克斯韦)—— 极致功耗优化
- 痛点:能效还不够,数据中心耗电太贵;
- 突破:性能功耗比近乎翻倍,同功耗下性能大幅提升;
- 代表:GTX 980、Titan X。
2016 Pascal(帕斯卡)—— 高带宽显存元年
- 痛点:算力上去了,显存带宽成了瓶颈(数据喂不饱计算);
- 突破:数据中心卡首次用 HBM2 高带宽显存(带宽翻数倍),消费卡普及 GDDR5X;
- 代表:P100、GTX 1080(当年一代神卡)。
2017 Volta(伏特)—— 发明 Tensor Core,AI 加速的"核弹"
- 痛点:AI 训练越来越贵,通用 CUDA Core 算矩阵太慢;
- 突破:发明第一代 Tensor Core,专门做矩阵乘法,AI 训练/推理直接提速一个数量级;NVLink 诞生,多卡互联成为可能;
- 代表:V100(深度学习时代的"功勋卡",当年几乎每篇顶会论文都靠它)。
2018 Turing(图灵)—— 发明 RT Core,光追 + 推理双线出击
- 痛点:游戏画面想要"电影级光影",传统光栅化算不动;
- 突破:发明第一代 RT Core,首次实现实时光线追踪;同时 Tensor Core 迭代到第二代,并推出面向数据中心的推理卡 T4;
- 代表:RTX 20 系列、T4。
2020 Ampere(安培)—— 第三代 Tensor Core + 稀疏计算
- 痛点:大模型来了(GPT-3),单卡算力和显存都不够;
- 突破:第三代 Tensor Core 支持 TF32 / BF16 / 稀疏计算(跳过一半的零权重,算力标称直接翻倍);A100 拥有 40/80GB HBM2e;
- 代表:A100(大模型时代的第一代"标准卡",云厂商抢购对象)、RTX 30 系列。
2022 Ada Lovelace(艾达·洛芙莱斯)—— 游戏卡也有 AI 大脑
- 痛点:4K 光追游戏帧率撑不住;
- 突破:DLSS 3 帧生成——用 Tensor Core AI 生成中间帧,帧率翻倍;能效比大幅提升;
- 代表:RTX 40 系列(4090 拥有 16384 个 CUDA 核心、24GB GDDR6X)。
2022 Hopper(赫柏)—— 为 Transformer 量身定制
- 痛点:大语言模型(Transformer)训练太贵,通用精度浪费算力;
- 突破:Transformer Engine 自动在 FP8/FP16 之间切换精度,新增 FP8 支持;NVLink Switch System 可把 256 张 H100 连成一张"巨型 GPU";80GB HBM3、3.35TB/s 带宽;
- 官方数字:相比 A100,大模型训练最快快 9 倍,推理最快快 30 倍;
- 代表:H100(2023~2024 年全球最抢手芯片,一卡难求,单价一度被炒到数十万元)。
2024 Blackwell(布莱克韦尔)—— 双芯合一,面向万亿参数
- 痛点:单颗芯片的物理极限到了(光刻尺寸受限),单卡再也装不下更大的模型;
- 突破:
- 用 10TB/s 片间互联把两颗芯片封装成一张卡,晶体管总数 2080 亿;
- 第二代 Transformer Engine 支持 FP4,模型可容纳规模翻倍;
- 第五代 NVLink(1.8TB/s)、HBM3e(单卡最高 186GB,带宽 8TB/s);
- GB200 NVL72 机架级方案:72 颗 GPU + 液冷,官方口径"万亿参数大模型实时推理快 30 倍";
- 代表:B200、GB200 Grace Blackwell Superchip。
6. 数据中心卡 vs 游戏卡:两条腿走路
英伟达的聪明之处在于:同一个架构,拆成两条产品线,一条赚 AI 的钱,一条赚游戏的钱:
| 对比项 | 数据中心卡 | 游戏卡 |
|---|---|---|
| 代表产品 | A100、H100、B200 | RTX 30/40 系列 |
| 目标用户 | 云厂商、科研机构、AI 公司 | 玩家、创作者、个人开发者 |
| 显存 | HBM2e/HBM3/HBM3e,80GB~186GB+ | GDDR6X,12~32GB |
| 精度取向 | 全面支持 FP16/FP8/FP4 等低精度 | 侧重 FP32 + Tensor Core(跑 DLSS) |
| 功耗 | 700W~1200W(需液冷) | 320~450W(风冷) |
| 互联 | NVLink 900GB/s~1.8TB/s | 标准 PCIe |
| 价格量级 | 每张数十万元 | 数千到两万元 |
为什么游戏卡也装 Tensor Core? 因为 DLSS(深度学习超采样)需要——用 Tensor Core 跑神经网络,把低分辨率画面"脑补"成高分辨率,再生成中间帧,帧率直接翻倍。这就是"AI 加持游戏"的典型例子。
实战:看看手里的显卡(命令行直接跑):
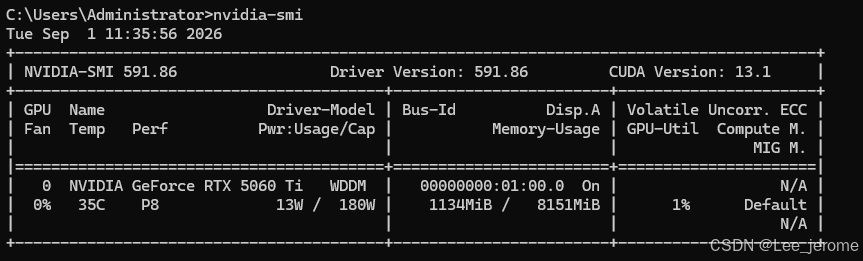
看到 Compute M. 一栏了吗?GPU 既可以渲染画面,也可以当通用计算卡跑 AI——这就是"统一架构"带来的红利。
7. 官方链接汇总
以下均为 NVIDIA 官方页面/文档
| 页面 | 链接 | 看点 |
|---|---|---|
| Blackwell 架构官方页 | https://www.nvidia.com/en-us/data-center/technologies/blackwell-architecture/ | 2080 亿晶体管、双芯 10TB/s 互联、GB200 NVL72 |
| Hopper 架构官方页 | https://www.nvidia.com/en-us/data-center/technologies/hopper-architecture/ | Transformer Engine、FP8 |
| H100 官方数据表(PDF) | https://resources.nvidia.com/en-us-gpu-resources/h100-datasheet-24306 | FP8 3958 TFLOPS、3.35TB/s、80GB HBM3 |
| Tensor Core 官方介绍 | https://www.nvidia.com/en-us/data-center/tensor-cores/ | 各代 Tensor Core 能力对比 |
| Volta 架构官方页 | https://www.nvidia.com/en-us/data-center/volta-gpu-architecture/ | 第一代 Tensor Core 的来历 |
| Ada Lovelace 官方页 | https://www.nvidia.com/en-us/geforce/ada-lovelace/ | RTX 40 系列、DLSS 3 |
| Turing 架构深度解析(官方博客) | https://developer.nvidia.com/blog/nvidia-turing-architecture-in-depth/ | RT Core 原理图文详解 |
| OpenAI:AI and Compute | https://openai.com/research/ai-and-compute | "算力每 3.4 个月翻一倍"的原始出处 |
8. 总结
- GPU 的本质:千军万马的"简单重复计算",正好命中 AI 的矩阵乘法特性;
- 升级主线:更多核心 → 更宽显存 → 专用单元(Tensor Core 管 AI、RT Core 管光追)→ 更低精度(FP16→FP8→FP4);
- 为什么非升不可:模型每 3~4 个月翻一倍,单卡物理极限已到(Blackwell 干脆双芯合一),不升级就喂不饱 AI;
- 两条产品线:数据中心卡卖算力,游戏卡卖体验(DLSS),同一架构两边收割;
- 看懂架构就看懂产业:H100 一卡难求、B200 抢购排到一年后——算力就是新时代的"石油"。
最后留个思考题:精度一路从 FP64 降到 FP4,再往下还有 FP2、甚至"不区分精度"吗?——这正是英伟达和各家 AI 芯片公司下一轮竞赛的看点。
转载自 CSDN-专业IT技术社区
原文链接:https://blog.csdn.net/qq_65148539/article/details/164256669

