

> 系列:VeapAI 自然语言操作实战(全体系架构专题)
> 本文要点:语义模板五步执行 · 4 个稳定字段 · 触发三态 · 目录资源预构建的两步铁律
## 最准的知识,系统自己就有
上一篇讲的是附件:外部资料进系统,先解析、再拆条。这一篇讲另一类素材——系统自身。
用户说"给张三授权用户查询功能",模型需要知道:系统里有哪些表、哪些接口可以授权、字典里的"启用"对应什么值。这些事实不在任何文档里,而是散落在数据字典、代码生成器、业务字典三处。
请人整理成知识库?不是不行,是三天就过期。表结构改一次、字典加一项,手工整理的清单就落后了。
这套体系的做法是:写一条 SQL 把系统元数据取出来,渲染成知识条目。加工机叫语义模板(semantic template),本文只看它在这条链上的用法。
## 一次执行,五步走完
![语义模板引擎:触发三态、执行五步与稳定契约]
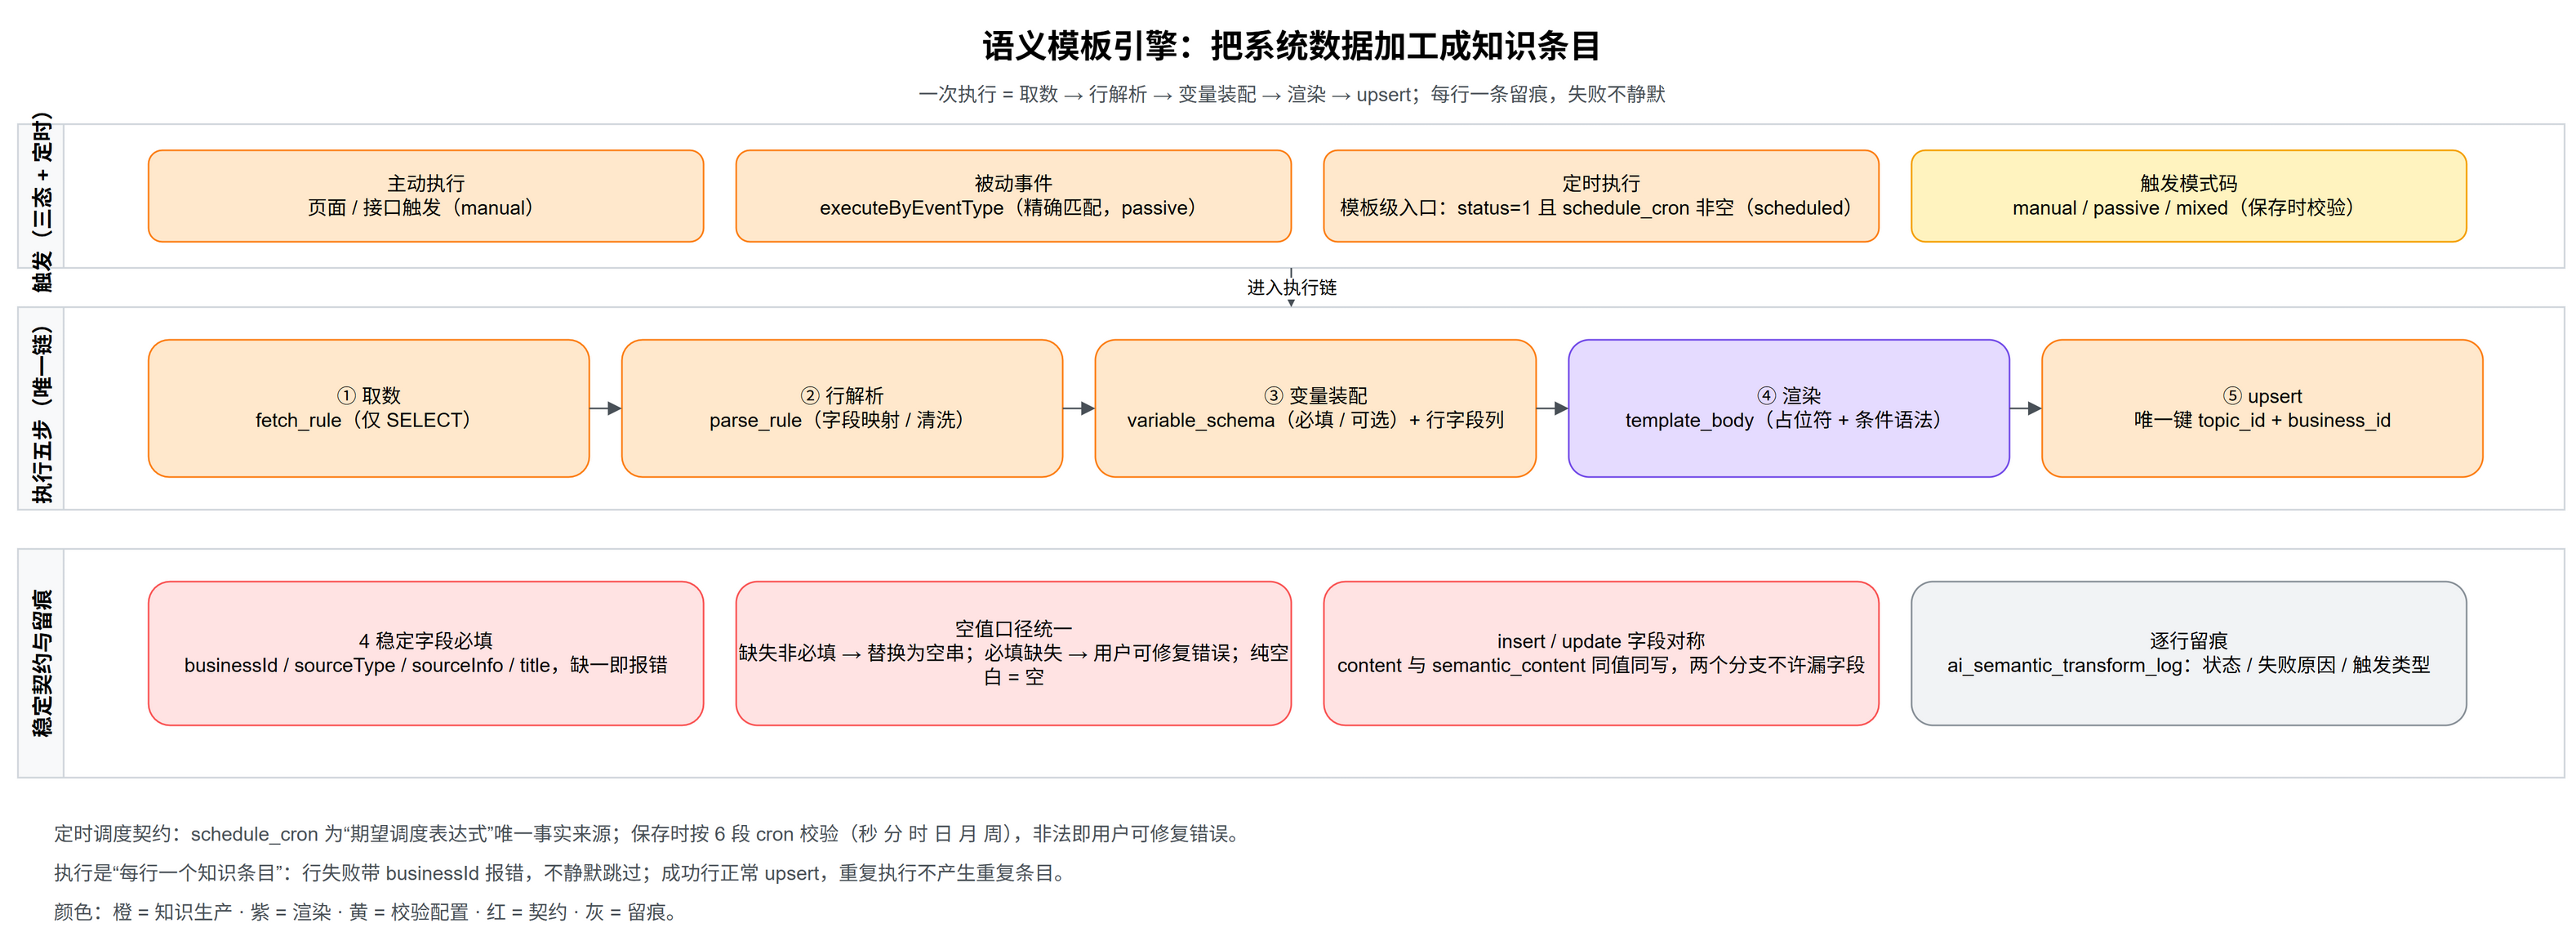
一次模板执行固定五步,全部由确定性代码编排:
1. 取数:执行 `fetch_rule` 里的 SQL。只允许 SELECT;系统会自动把 SQL 外包一层分页,所以脚本里不许自带 LIMIT、OFFSET 和结尾分号;
2. 行解析:按 `parse_rule` 的字段映射把结果集整理成标准行;
3. 变量装配:行字段 + `variable_schema` 声明的必填与可选变量,逐个装进渲染上下文;
4. 渲染:用 `template_body` 把每一行渲染成一段正文;
5. upsert:按唯一键 `topic_id + business_id` 写入知识条目。重复执行不产生重复条目。
这里有一组必须背下来的字段。每行取数结果里必须包含 4 个稳定字段,缺一个就报错:
| 稳定字段 | 用途 | 目录任务的取值 |
| --- | --- | --- |
| `businessId` | upsert 唯一键的另一半 | 表主键 / 字典主键 |
| `sourceType` | 溯源类型 | dictTable / dictType |
| `sourceInfo` | 溯源详情 | 同主键 |
| `title` | 条目标题 | 表标题 / 字典标题 |
为什么把字段卡这么死?因为"这一行是什么"必须有唯一答案。businessId 负责去重,sourceType 与 sourceInfo 负责追根溯源,title 负责给人看。四个字段一缺,这条知识在后面的检索、审计里都会成为孤儿。
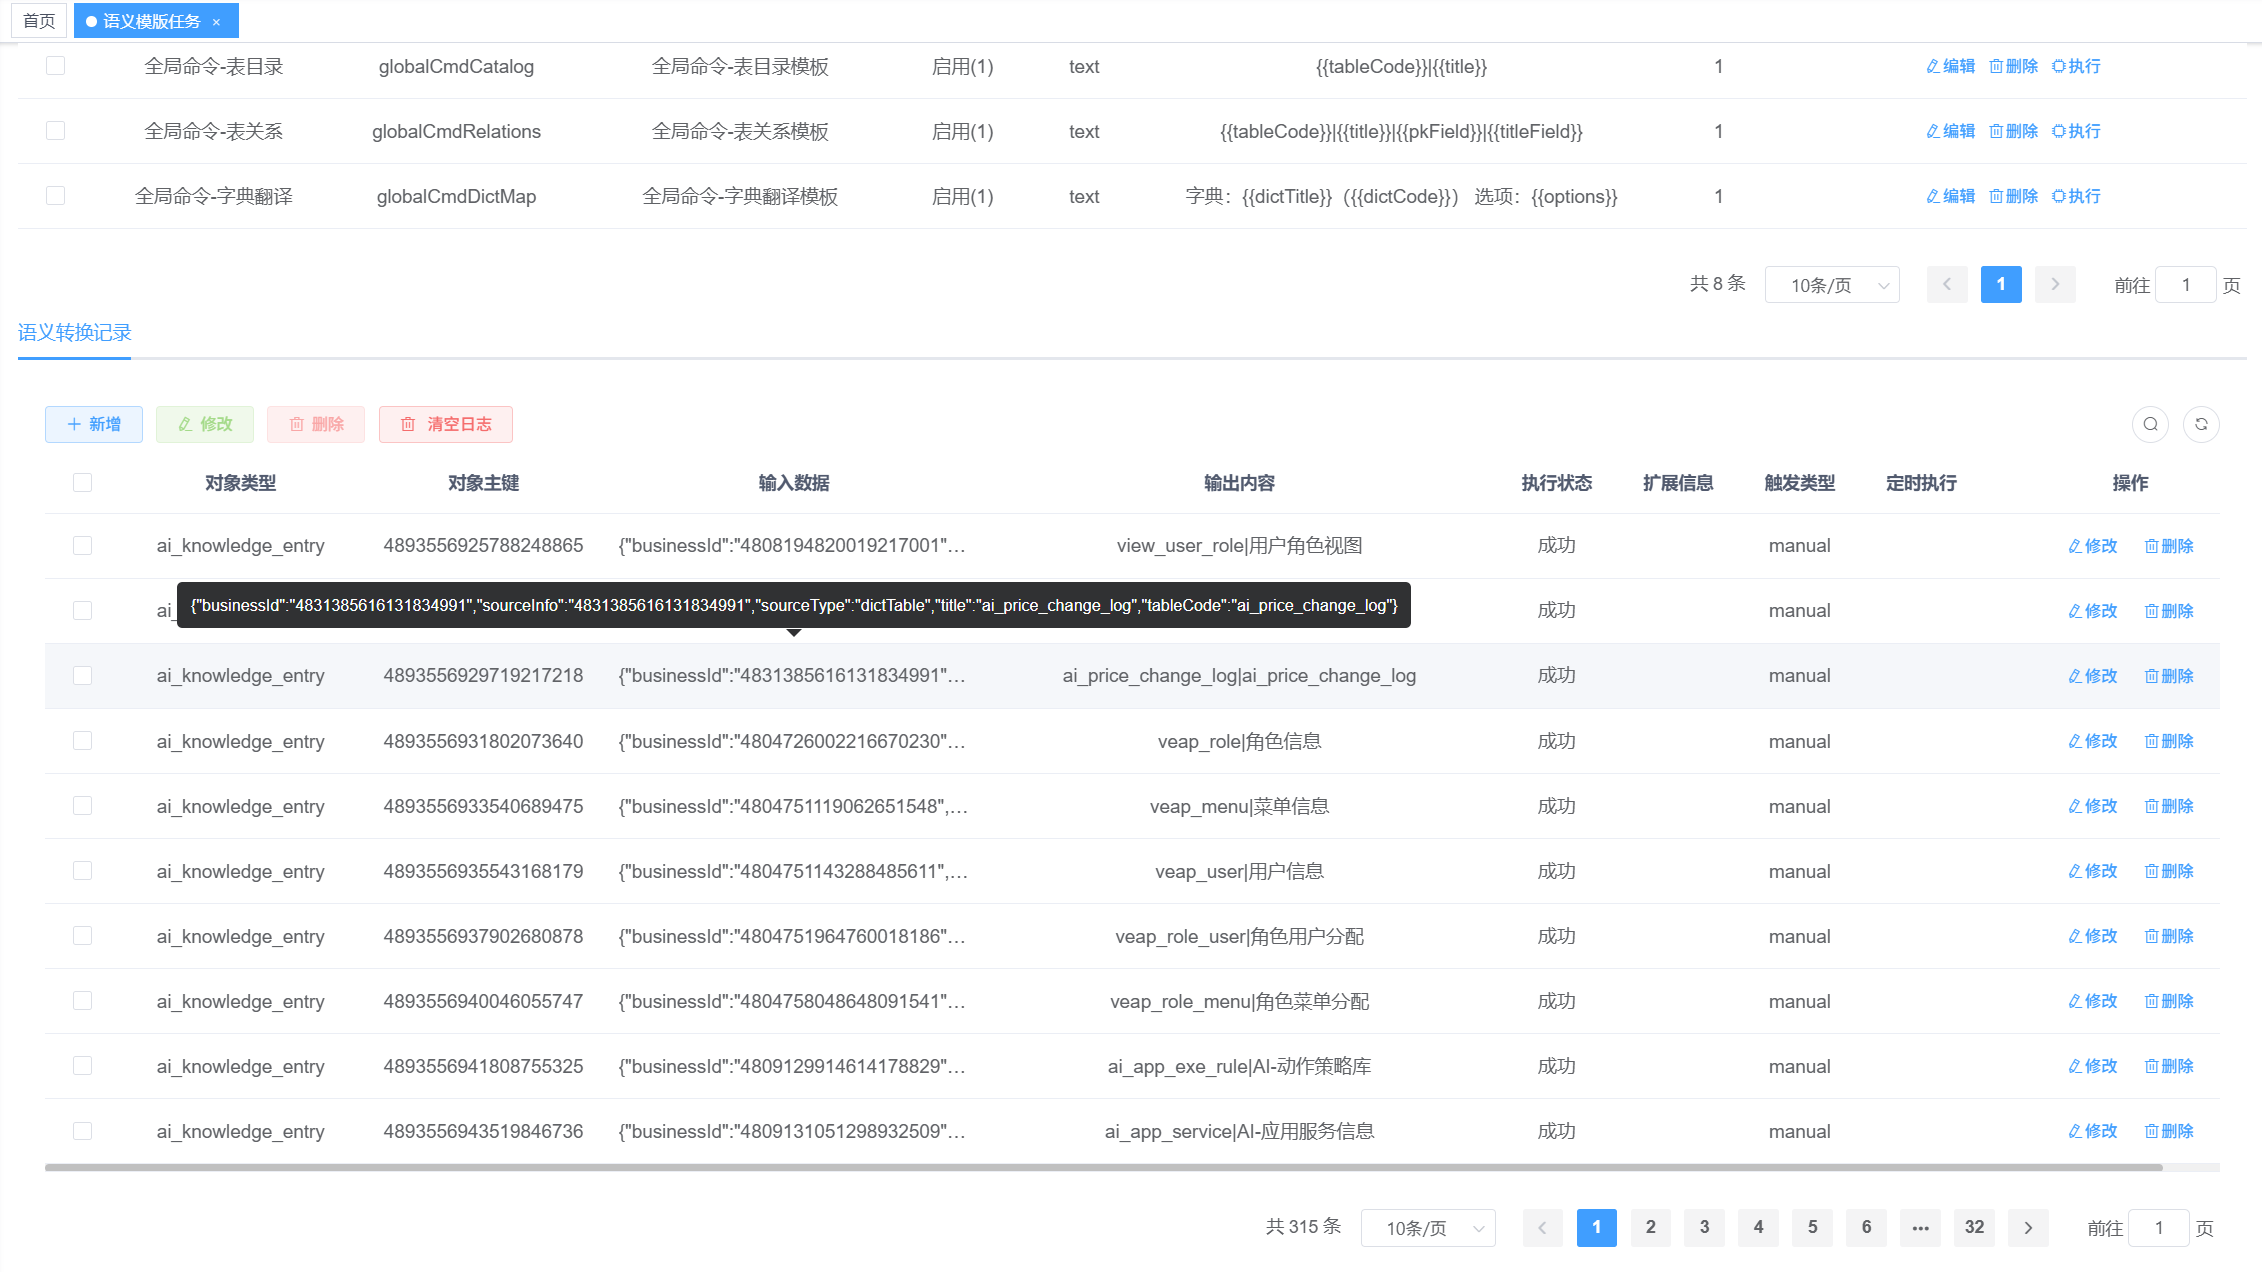
执行过程逐行留痕。`ai_semantic_transform_log` 记录三个关键字段:状态(待处理 / 处理中 / 成功 / 失败)、失败原因、触发类型。行失败不静默跳过,报错里带上 businessId,知道该去查哪一行。
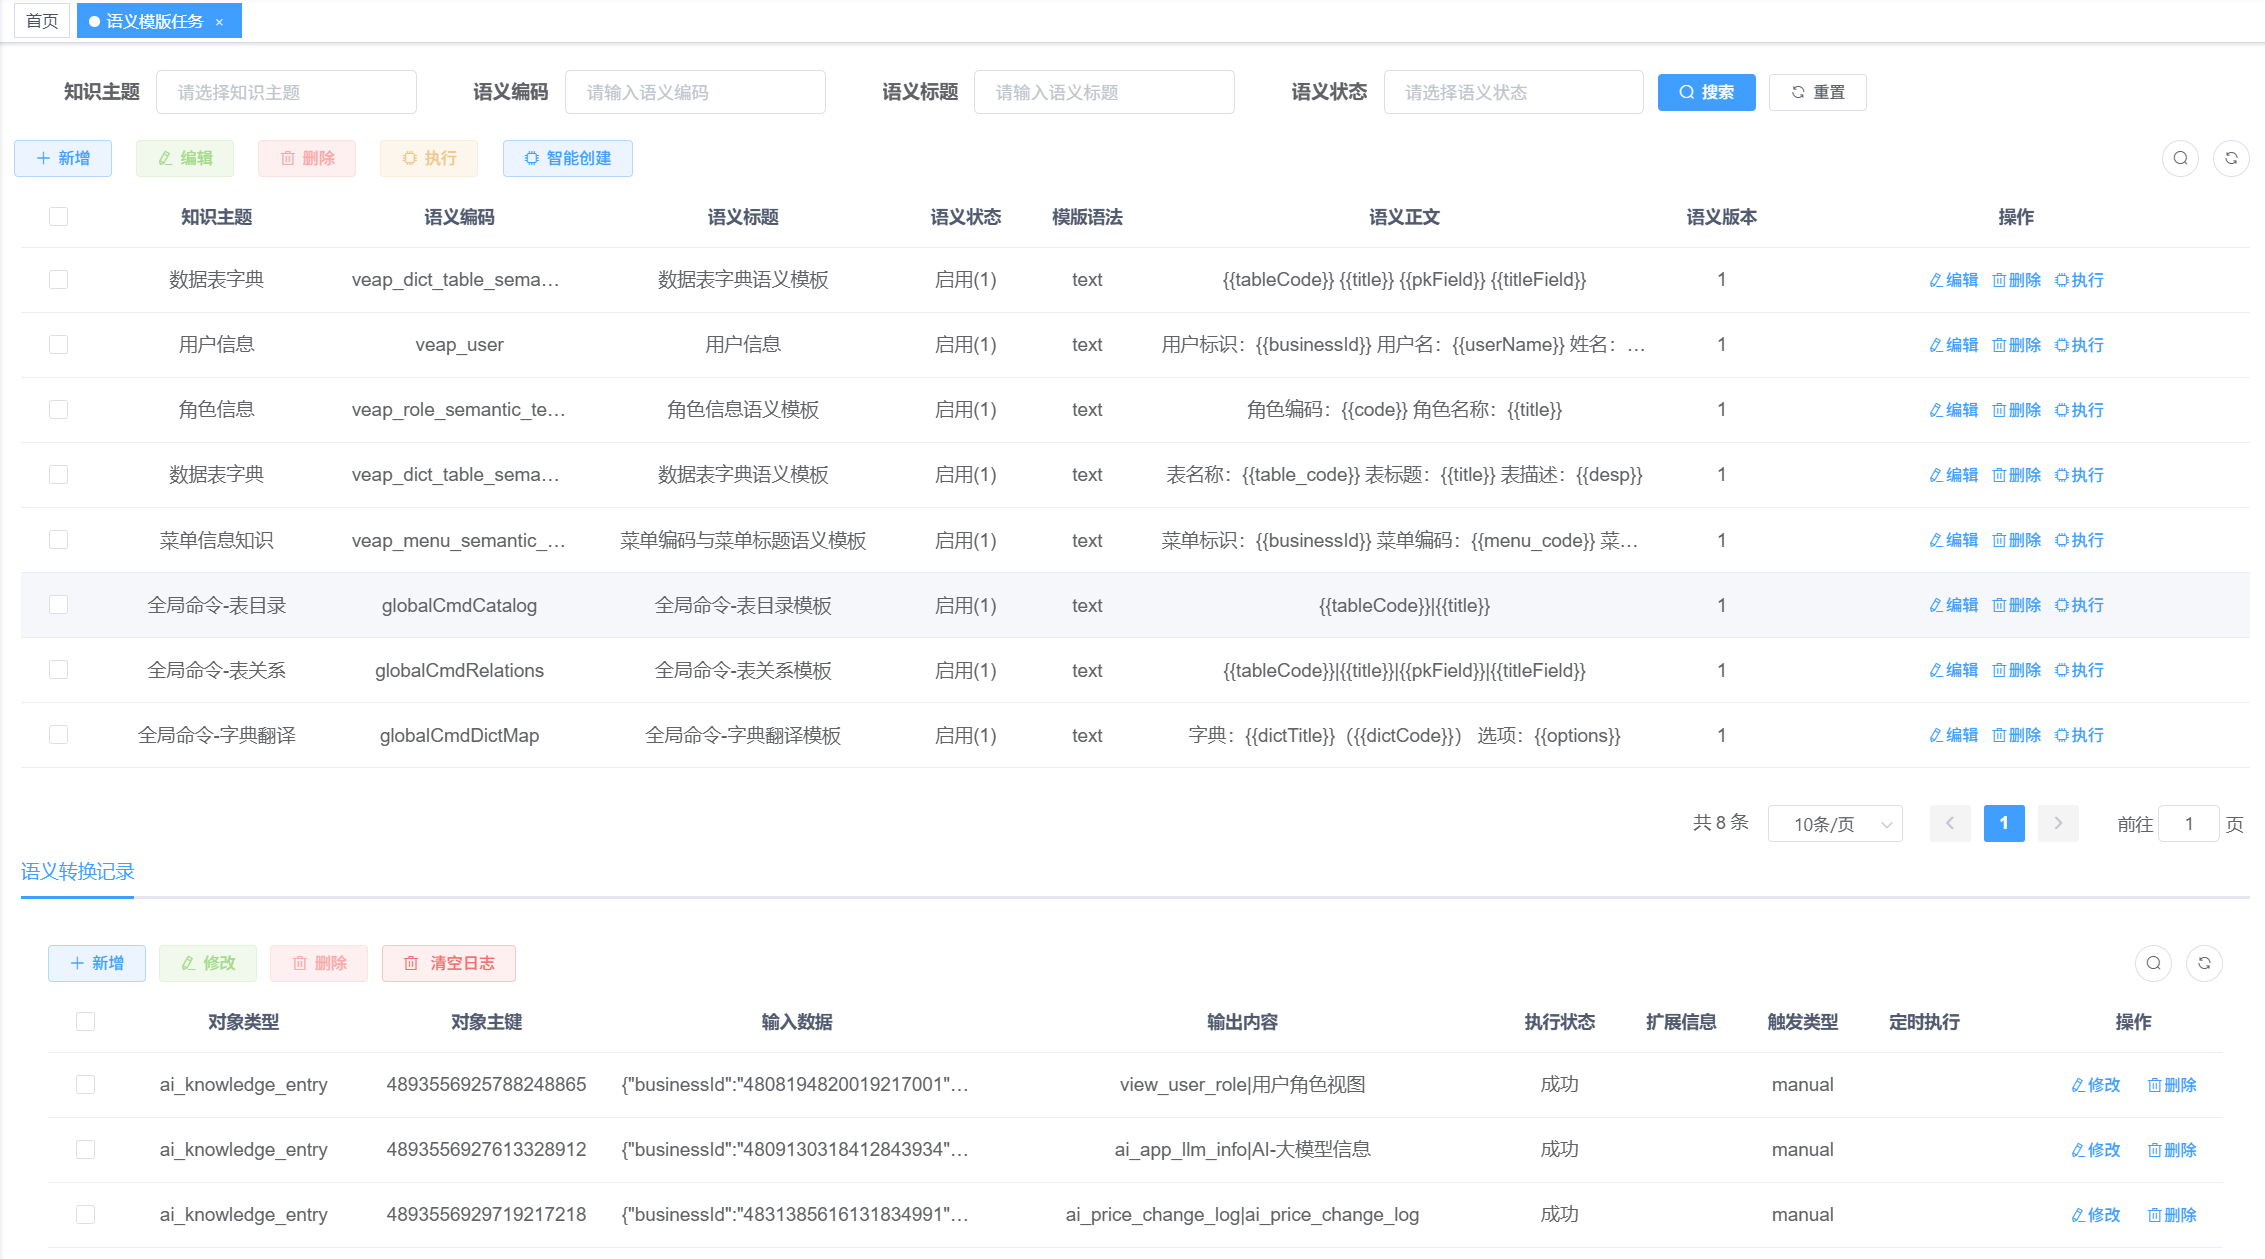
![语义模板配置:取数规则、变量定义与模板正文都在这里维护]
## 渲染与空值:一个口径说了算
模板正文支持占位符和条件语法。有没有值,直接决定一段话怎么写:
- 变量缺失且非必填 → 替换为空串(标签和内容一起消失,不留噪点);
- 必填变量缺失 → 用户可修复错误,明确告诉你是哪个变量;
- 值是纯空白 → 与空值同处理。
这三条口径的背后是一次返工。早期执行、校验、预览三个地方对空值的判定不一致。执行时认为纯空白可以保留,校验却按"有值"放行,预览又把它当未解析变量标红。同一个模板,三个地方三种答案。
修法是收敛到同一个判定实现(`hasText` 口径),执行、校验、预览共用。经验写在这里:凡是"空"这个概念,全链路只能有一种解释。
预览还有一个顺手的设计:模板里出现未解析变量时会直接标出来,不用等执行失败才发现变量名拼错了。
![语义转换日志:每一行的执行结果与失败原因都可追溯]
## 触发:手动、事件、定时各走各的门
模板的触发模式有三种取值:主动(manual)、被动(passive)、混合(mixed)。对应的入口也是三个:
- 手动执行:管理页或接口触发;
- 事件触发:内网入口 `POST /ai/inner/semanticTemplate/executeByEventType?eventType=...`,按事件类型精确匹配模板,没有匹配就返回"无匹配模板",不做推断;
- 定时执行:模板级入口要求 `status=1` 且 `schedule_cron` 非空。
定时表达式在保存时就要过校验:必须是合法的 6 段 cron(秒 分 时 日 月 周),非法直接报用户可修复错误。`schedule_cron` 被定义为"期望调度表达式"的唯一事实来源,实际调度由定时任务按这个值发起。
## 目录资源预构建:三个任务,一根铁律
把镜头拉回总览图里的"全局语义命令"。它运行时要看三份目录:表目录、表关系、字典翻译。这三份都不是运行时现查的,而是离线预构建的上下文资源。
![目录资源预构建链:三个任务、执行与同步两步、以及挂载点]
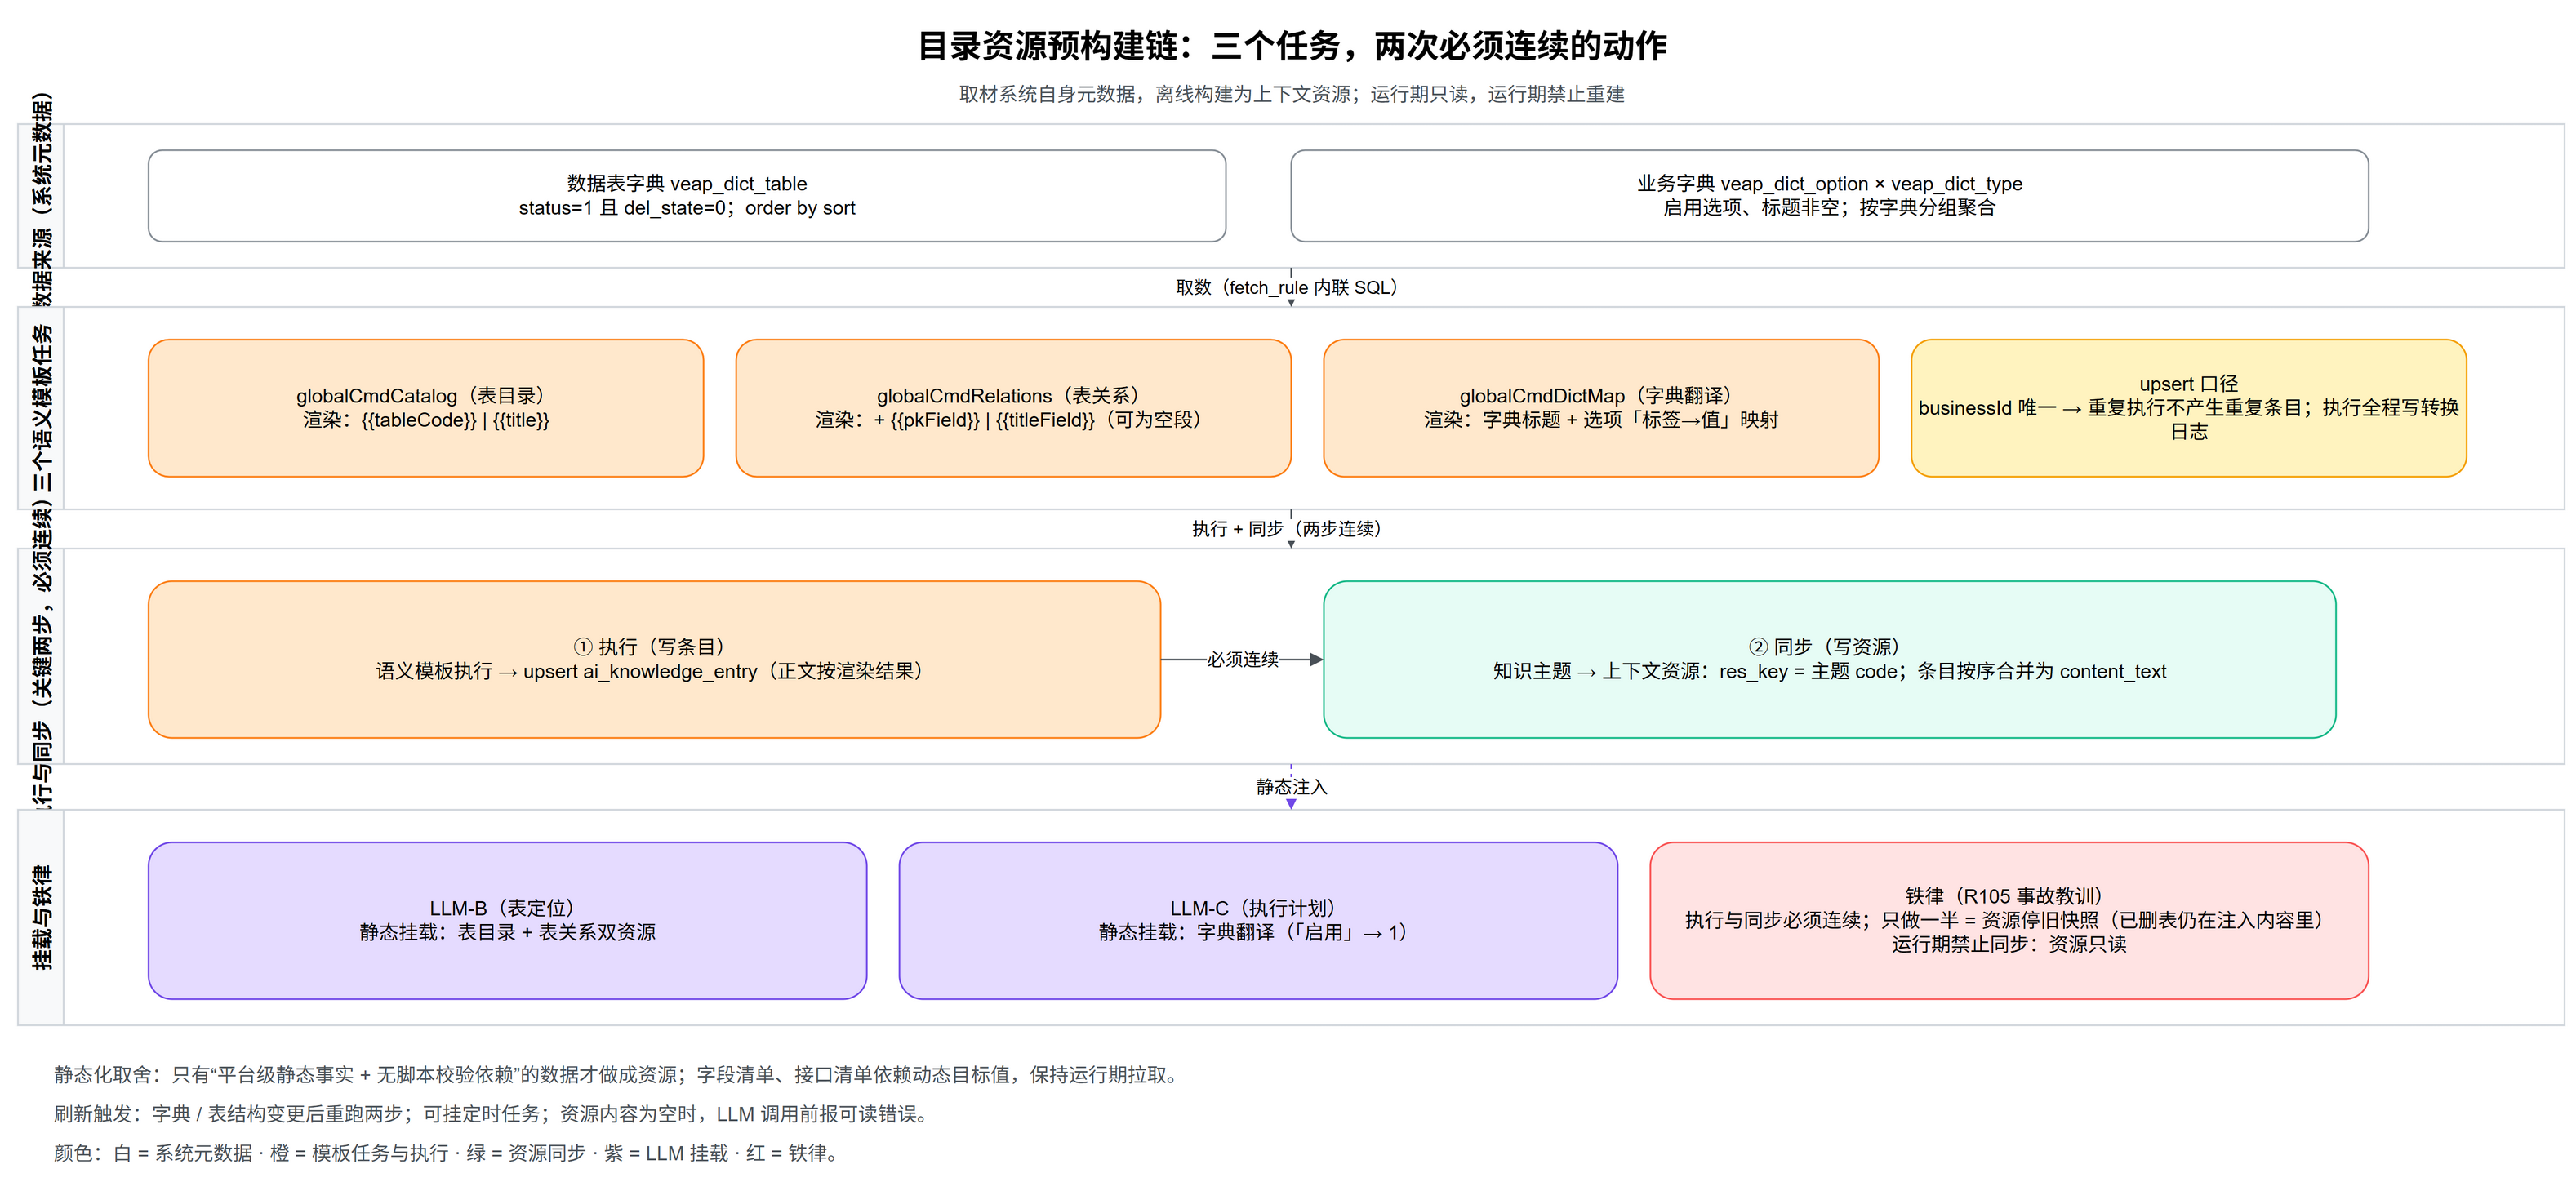
三个任务全部取材系统自身的元数据:
| 任务 | 知识主题 code | 取数来源 | 渲染格式 |
| --- | --- | --- | --- |
| 表目录 | `agent.globalCmd.catalog` | 数据表字典(status=1、del_state=0,按 sort 排序) | `表编码 竖线 表标题` |
| 表关系 | `agent.globalCmd.relations` | 同表,追加"主键非空"过滤 | `表编码 竖线 表标题 竖线 主键 竖线 标题字段` |
| 字典翻译 | `agent.globalCmd.dictMap` | 业务字典选项(启用、标题非空,按字典分组) | `字典标题 + 选项「标签→值」` |
构建分两步,而且必须连续执行:
1. 执行:跑三个语义模板,把系统元数据渲染成知识条目;
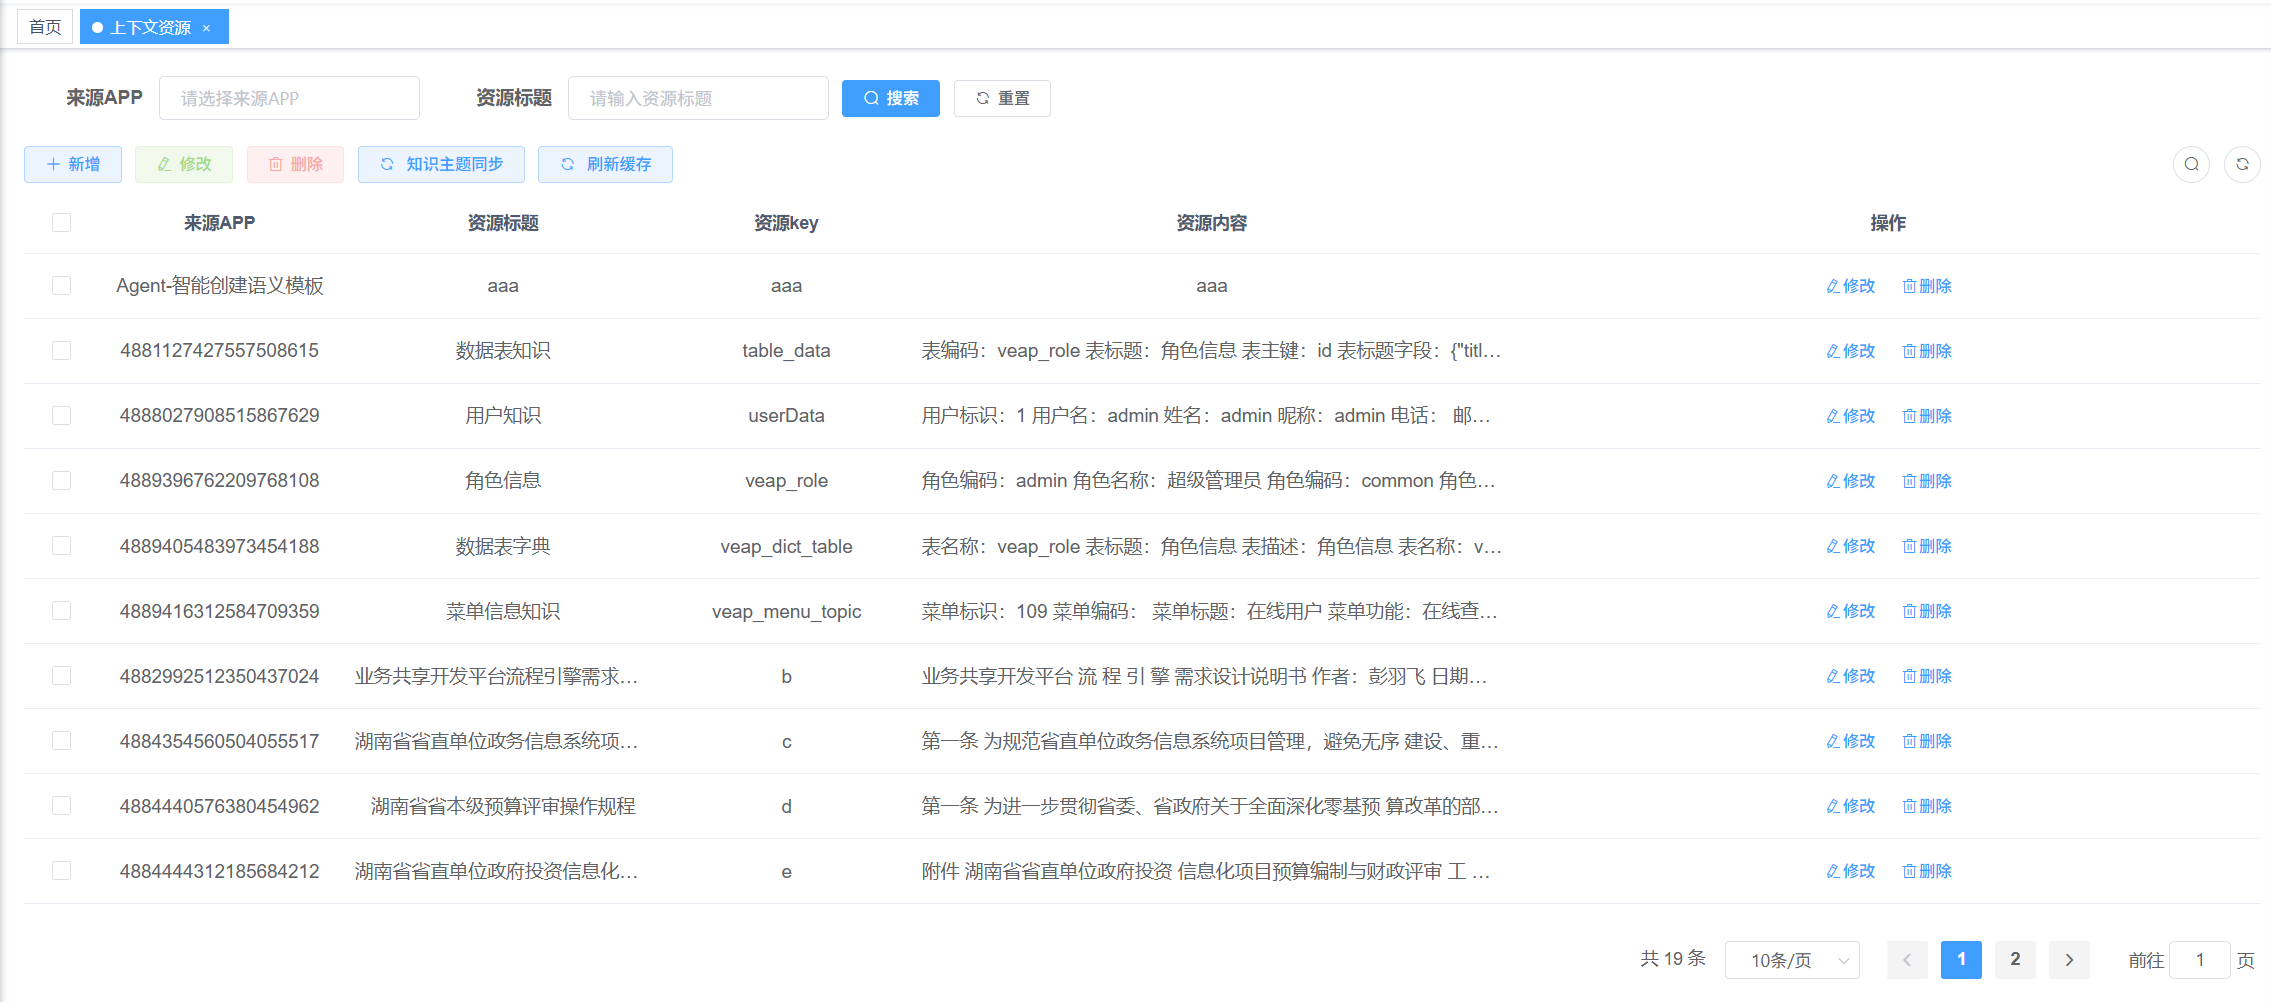
2. 同步:把知识主题同步成上下文资源,`res_key` 就是主题 code,条目正文按序合并。
之后 LLM-B(表定位)静态挂载表目录与表关系,LLM-C(执行计划)静态挂载字典翻译。运行期只读资源,禁止在运行期重建。
![上下文资源:主题同步后的资源内容,等待被 LLM 节点静态注入]
## 源码走读
- 执行引擎:`veap-cloud/veap-modules/veap-ai` 的 `AiSemanticTemplateExecuteService`——`executeByEventTypeOrThrow`(事件)、`executeByTemplateIdOrThrow`(模板级定时)、`upsertKnowledgeEntryOrThrow`(写入)与 4 稳定字段校验;
- 保存校验:`AiSemanticTemplateValidationService`——cron 合法性等写侧校验;
- 内网入口:`InnerAiSemanticTemplateController`(事件与模板级定时);
- 资源同步:`AiAppContextResourceKnowledgeSyncAppService`——主题 → 资源(`res_key` = 主题 code,正文按序合并);
- 前端加工台:`veap-ui/src/components/AiConsole/mods/semanticTemplateGen`;渲染器家族(simple / placeholder / text 三种语法码)共用同一套占位符实现。
## 较真:两次"只做了一半"的返工
这一篇的两个坑,本质上是同一种错误:对称性破了。
第一次是代码只改了一半。模板执行后,知识主题页显示的正文没更新。排查发现写入逻辑在 upsert 时,新增分支写了 `content`,更新分支却只写了 `semantic_content` 和元数据。展示端读的是 `content`,自然看到旧值。修复很直接:更新分支补上 `content`,两个分支字段对齐。
从那次起,我们把"upsert 两个分支字段必须对称"写成了硬约束。审计方式也很具体:以页面展示字段为锚,逐字段比对两个分支。
第二次是运维只做了一半。有一轮测试,"分析近 30 天登录活跃趋势"突然报"命令可定位到多个数据表"。查下去发现:表字典里一张表已经清理,条目侧也重建了。但资源侧还停着几天前的快照,已删除的表仍留在 LLM 的注入内容里。模型定位时自然撞了重名。
处置是把资源同步重跑一遍,并立下规矩:执行与同步必须连续,只做一半等于没做。后来的巡检会专门断言"资源块集合 = 条目集合",防的就是"清而不生效"。
## 复现与验证
1. 看模板:`SELECT code, template_code, trigger_mode, schedule_cron FROM ai_semantic_template WHERE code = 'globalCmdCatalog';`
2. 执行一次:调 `POST /ai/semanticTemplate/execute`(传 `templateId`),再查 `SELECT code, title FROM ai_knowledge_entry WHERE topic_id = <主题id>;`,确认条目按渲染格式生成;
3. 看留痕:`SELECT status, trigger_type, fail_reason FROM ai_semantic_transform_log WHERE template_id = <模板id> ORDER BY id DESC LIMIT 5;`
4. 看资源:`SELECT res_key, LEFT(content_text, 60) FROM ai_app_context_resource WHERE res_key = 'agent.globalCmd.catalog';`
一个边界要说清楚:不是所有东西都适合静态化成资源。冻结进资源的,必须同时满足"平台级静态事实"和"没有脚本校验依赖"两个条件。字段清单和接口清单依赖运行时的目标表,就留在运行期拉取——静态化是优化,不是默认。
系统数据吃完之后,知识版图基本齐了:一份来自附件,一份来自系统自身。接下来轮到那条"能被计算的"路径:把知识条目变成向量。
转载自 CSDN-专业IT技术社区
原文链接:https://blog.csdn.net/wespaul/article/details/167920449

