

📋 目录
- 目录
- ⚡ 一、先纠正一个正在流传的说法
- 🔧 二、Intelligent UI 到底做了什么
- 💰 三、三档模型:差价 100 倍,差在哪
- 🏗️ 四、这次更新对企业的三层真实影响
- ⚠️ 五、四个必须提前想清楚的坑
- 🧭 六、可以直接拿去用的四条判断标准
目录
- ⚡ 一、先纠正一个正在流传的说法
- 🔧 二、Intelligent UI 到底做了什么
- 💰 三、三档模型:差价100 倍,差在哪
- 🏢 四、这次更新对企业的三层真实影响
- ⚠️ 五、四个必须提前想清楚的坑
- 🧭 六、可以直接拿去用的四条判断标准
⚡ 一、先纠正一个正在流传的说法
这两天中文技术圈流传一个说法:“OpenAI 发布了 Decisions API,开发者可以不写前端代码,让 AI 自动生成界面”,还有文章说这是"把前端工程师全部淘汰"“UI 设计师从界面创作者变成生成规则架构师”。
这个说法是错的,而且错得不小。 我把官方文档翻了一遍:
Decisions API 是 2026 年 10 月 6 日进入公开测试版(public beta)的,10 月 7 日在 OpenAI 开发者社区正式公告。它确实和 GPT-6 Luna 有关,但它的功能跟"生成界面"没有任何关系。
Decisions API 的实际形态是这样一个结构化判断接口:
| 能力 | 输入 | 返回 | 典型用途 |
|---|---|---|---|
predicate 谓词判断 | 一段文字或图文 | 该条件为真的概率 0~1 | “这张产品照片有凹痕吗” |
choice 选项选择 | 固定选项集 | 选中项 + 各选项概率 + 置信度 | 客诉分流到计费/技术/物流 |
score 评分 | 有序等级 | 概率加权平均分 | “这个缺陷严重度打几分” |
官方给的速度是比 Responses API 快约 10 倍。接入方式是独立的 POST /v1/decisions 端点,目前只支持 gpt-6-luna 一个模型。计价方式很特别——只算输入 token,不收缓存读、不收缓存写、不收输出。按 Luna 的$0.10/百万输入 token 算。
所以 Decisions API 干的事是:把"分类、路由、打分"这类需要极快响应的小判断,从生成式 API 里拆出来,单独做成一个 10 倍速的廉价接口。
它是一个分类器,不是界面生成器。
真正做界面生成的是 Intelligent UI,而那个目前只在 ChatGPT 客户端里,没有对应的开放 API。官方文档明确写了:Intelligent UI 的组件库是 OpenAI 侧的原生组件,公告里没有描述 API 可用性。
这里还藏着一个很容易踩的坑。OpenAI 开发者社区里,一位做游戏判断任务的用户(jev 的使用者)实测 Decisions API 后的结论是:
在需要判断力的场景(比如"两个词是否有语义关联"、“一个人在对话里到底想要什么”),jev 明显更准,Luna 做出了大约三倍的"自信错误"。窄口径的事实判断(比如"这是不是一个真实的英文单词")两者差不多。多步对话场景里 jev 的中位响应约 0.3 秒,Luna 是 1.6 秒。成本上 Luna 贵 2~3 倍。
这个用户最后说:“Jev 是更好的默认值。我们测的几百道题里,Luna 没有在任何一项上表现出明显优势。”
也就是说——OpenAI 自己的快速判断接口,社区实测下来在关键判断维度上未必优于现有方案,而且更慢更贵。 这个信号非常值得注意,下面第四节会展开讲为什么。
🔧 二、Intelligent UI 到底做了什么
先说机制,一句话概括:从"先出内容、再排版"改成"边生成、边编译界面"。
传统模式是串行的:模型把完整答案生成完 → 前端拿到文本 → 再渲染成加粗、分段、表格、图。这中间有一个天然的等待,而且呈现形态由前端模板写死,用户改不了。
Intelligent UI 换了做法:模型一边推理,一边判断当前场景需要什么交互形态,同步调用组件,实时编译出界面。
| 对比项 | 传统文本回答 | Intelligent UI |
|---|---|---|
| 生成顺序 | 串行:出内容 → 再渲染 | 并行:内容与界面同步编译 |
| 呈现形态 | 前端模板预设,固定 | 模型按问题实时选择 |
| 呈现时机 | 等完整答案 | 流式,边生成边出界面 |
| 组件范围 | 自己搭 | OpenAI 原生封装组件库 |
OpenAI 公布的典型用例:
- 拆解一台 7 速自行车的结构 → 可点击的拆解图
- 每月存 200 美元、20 年按不同利率增长 → 可调参数的计算器
- 四个人分摊晚餐账单含小费滑块 → 带滑块的表单
- 西雅图到波特兰三站自驾 → 地图上标注停靠点和绕道景点
- 解释复利 → 改输入看结果如何变化的交互示意
- 食谱旁边并排显示烹饪时间轴
技术底座是一套原生流式组件库 + 一个编译器。编译器在模型生成界面的同时就处理它,所以界面是渐进出现的,不用等整段答案。
有两个细节值得单独拎出来:
第一,模型会自己判断什么时候不该用界面。 OpenAI 明确说,当纯文本是最有用的答案时,GPT-6 还是用纯文本。这是它和"万物皆可卡片"的最大区别——但也正是它最不确定的地方。
第二,OpenAI 自己承认这个判断力还没做好。 官方原话是"模型的设计判断力仍需改进"。
这句话是本文后续所有讨论的起点。
还有一个提速数字容易被误读:官方说 GPT-6 Instant 在需要联网检索的问题上,首个响应比 GPT-5.6 Instant 平均快 44%。注意限定条件——是联网检索类,不是所有问题。
另一组数据来自内部评测:GPT-6 Extra High 的开始响应时间与 GPT-5.6 Medium 相当,但分数高于 GPT-5.6 Extra High。这句话常被读成"Extra High 白菜价",实际是"中配的速度 + 高配的成绩",不便宜。
💰 三、三档模型:差价 100 倍,差在哪
这是我觉得对做技术选型的人最有用的一张表。
GPT-6 家族三档,2026 年 9 月 22 日发布 Sol 和 Luna(比 Astra 晚 19 天),10 月 7 日随 Intelligent UI 全面开放到 ChatGPT。
| 维度 | GPT-6 Astra | GPT-6 Sol | GPT-6 Luna |
|---|---|---|---|
| 输入 / 1M token | $10.00 | $2.00 | $0.10 |
| 缓存读 / 1M | $1.00 | $0.20 | $0.01 |
| 输出 / 1M | $50.00 | $10.00 | $0.50 |
| 缓存写/ 1M | $12.50 | $2.50 | $0.125 |
| 上下文窗口 | 1,050,000 | 1,050,000 | 1,050,000 |
| 最大输出 | 128,000 | 128,000 | 128,000 |
| 推理档位 | low → max | none → max | none → max |
| 知识截止 | 2026-04-30 | 2026-04-20 | 2026-05-18 |
| ChatGPT 档位 | 顶配(Pro 的 Extra High 不支持) | Plus / Pro / Business / Enterprise | Free / Go 桌面版 |
Astra 是 Sol 的 5 倍、 Luna 的 100 倍。 这三个数字不是营销话术,是可以直接算的。
我按一个典型 Agent 回合算了一下(30K 输入,其中 80% 命中缓存,5K 输出):
| 模型 | 单轮成本 | 1000 轮 |
|---|---|---|
| Astra | $0.334 | $334 |
| Sol | $0.067 | $67 |
| Luna | $0.0033 | $3.34 |
有个反直觉的地方:Sol 在 OSWorld 2.0 上是 60.5%(xhigh),比它的前身 GPT-5.6 Sol 的 65.7% 还要低。独立评测里 Sol 在部分指标上也没赢过 GPT-5.6 Sol 的最好成绩。
所以"降价 + 升级"这个说法要拆开看:Sol 相对 GPT-5.6 Sol 是输出价降了 20%($12 → $10),输入价持平,但分数是退的。
再一个值得注意的:DeepSWE v1.1 上,Luna(max)66.6%,Sol(max)68.8%。只差 2.2 分,价格差 20 倍。OpenAI 说 Luna(max)在同等成绩下比 Claude Opus 5 和 Fable 5(medium)便宜 93~96%。
仓库级编码这种任务,最便宜的模型已经接近中间那档了。 这是选型时最该记住的一条。
三个必须知道的隐藏规则
272K 规则:GPT-6 全系,输入超过 272,000 token 后,整个请求的输入和缓存费率翻倍、输出费率乘1.5。
一个 300K token 的仓库提示,在 Sol 上是 $4/$15,在 Astra 上是 $20/$75。
所以 Claude Opus 5.5($4/$20)和 Fable 5.1 在超过 272K 之后可能反而比 Sol 便宜。别把大仓库整个塞进去——分块、摘要、或者用 file_search。
Astra 不支持 none 推理档,Sol 和 Luna 支持。如果你现在的代码里写的是 effort: "none" 当分类器用,迁到 Astra 会直接失败,得改成 low。
GitHub 的缓存数据:过去几个月 GitHub 报告称,明确的缓存断点让"需要重新处理的提示 token 占比降低了超过 50%",覆盖数十亿次请求。这对做 Agent 循环的人是实打实的成本优化点。
🏗️ 四、这次更新对企业的三层真实影响
第一层:软件的分发逻辑变了吗?变了,但没那么彻底
"ChatGPT 成为软件超级入口"这个说法被讲得很多。技术上确实成立:汇率换算、账单统计、行程规划这类轻量需求,现在对话窗口里能直接生成可用界面,不用下载、注册、学操作。
但需要泼一点冷水。 至少三个约束还在:
第一,Intelligent UI 目前没有开放 API。你不能在自己的应用里调它,只能在 ChatGPT 里用。
第二,界面基于 OpenAI 预封装的组件库做组合编排,不是从零自由创作。工业软件、专业设计软件、大型办公系统这类场景,生成结果只能作为参考。
第三,延迟。如果每个快速查询都要启动一个小应用,交互体验会明显变差。Hacker News 上 jjcm 把这叫"一次性的纸盘 UI"(disposable / paper-plate UI)——这个比喻很准:用一次就扔。jjcm 说自己是这个理念的粉丝,前提是"交付得足够快"。
我的判断:单场景工具类的 SaaS 受冲击最大,比如各类小型计算器、单一功能网站。它们的护城河本来就很浅,现在 ChatGPT 免费档顺手就给了。但这不等于"所有 App 都要死"——需要长期状态、需要多步流程、需要对接真实业务系统的应用,替代不了。
第二层:前端工程师的中间层被压缩,但两端变厚
前端开发的基础工作——页面搭建、组件适配、样式调试、终端适配——确实在被大量自动化。
但同一批分析里也指出了分化:会搭基础设计系统和可访问性框架的人,以及会管 Agent 能力边界、验证生成界面的人,这两端在增值。中间那层"把 Figma 稿翻译成组件库"的活儿在压缩。
这里有个技术细节值得单独强调:可访问性。
静态 UI 是可预测的——屏幕阅读器知道会读到什么,键盘导航遵循既定模式。动态生成 UI 会打破这一点,除非 OpenAI 在训练里内置了可访问性原语。官方文档目前没有说明这一点。
对做企业系统的来说,这是能不能上生产的关键卡点,不是nice to have。
第三层:选型逻辑变了——从"选哪个模型"变成"哪一步用哪个模型"
这层影响最实在。Astra 是 Luna 的 100 倍,这个价差意味着"所有请求都走最强的模型"在经济上完全不成立。
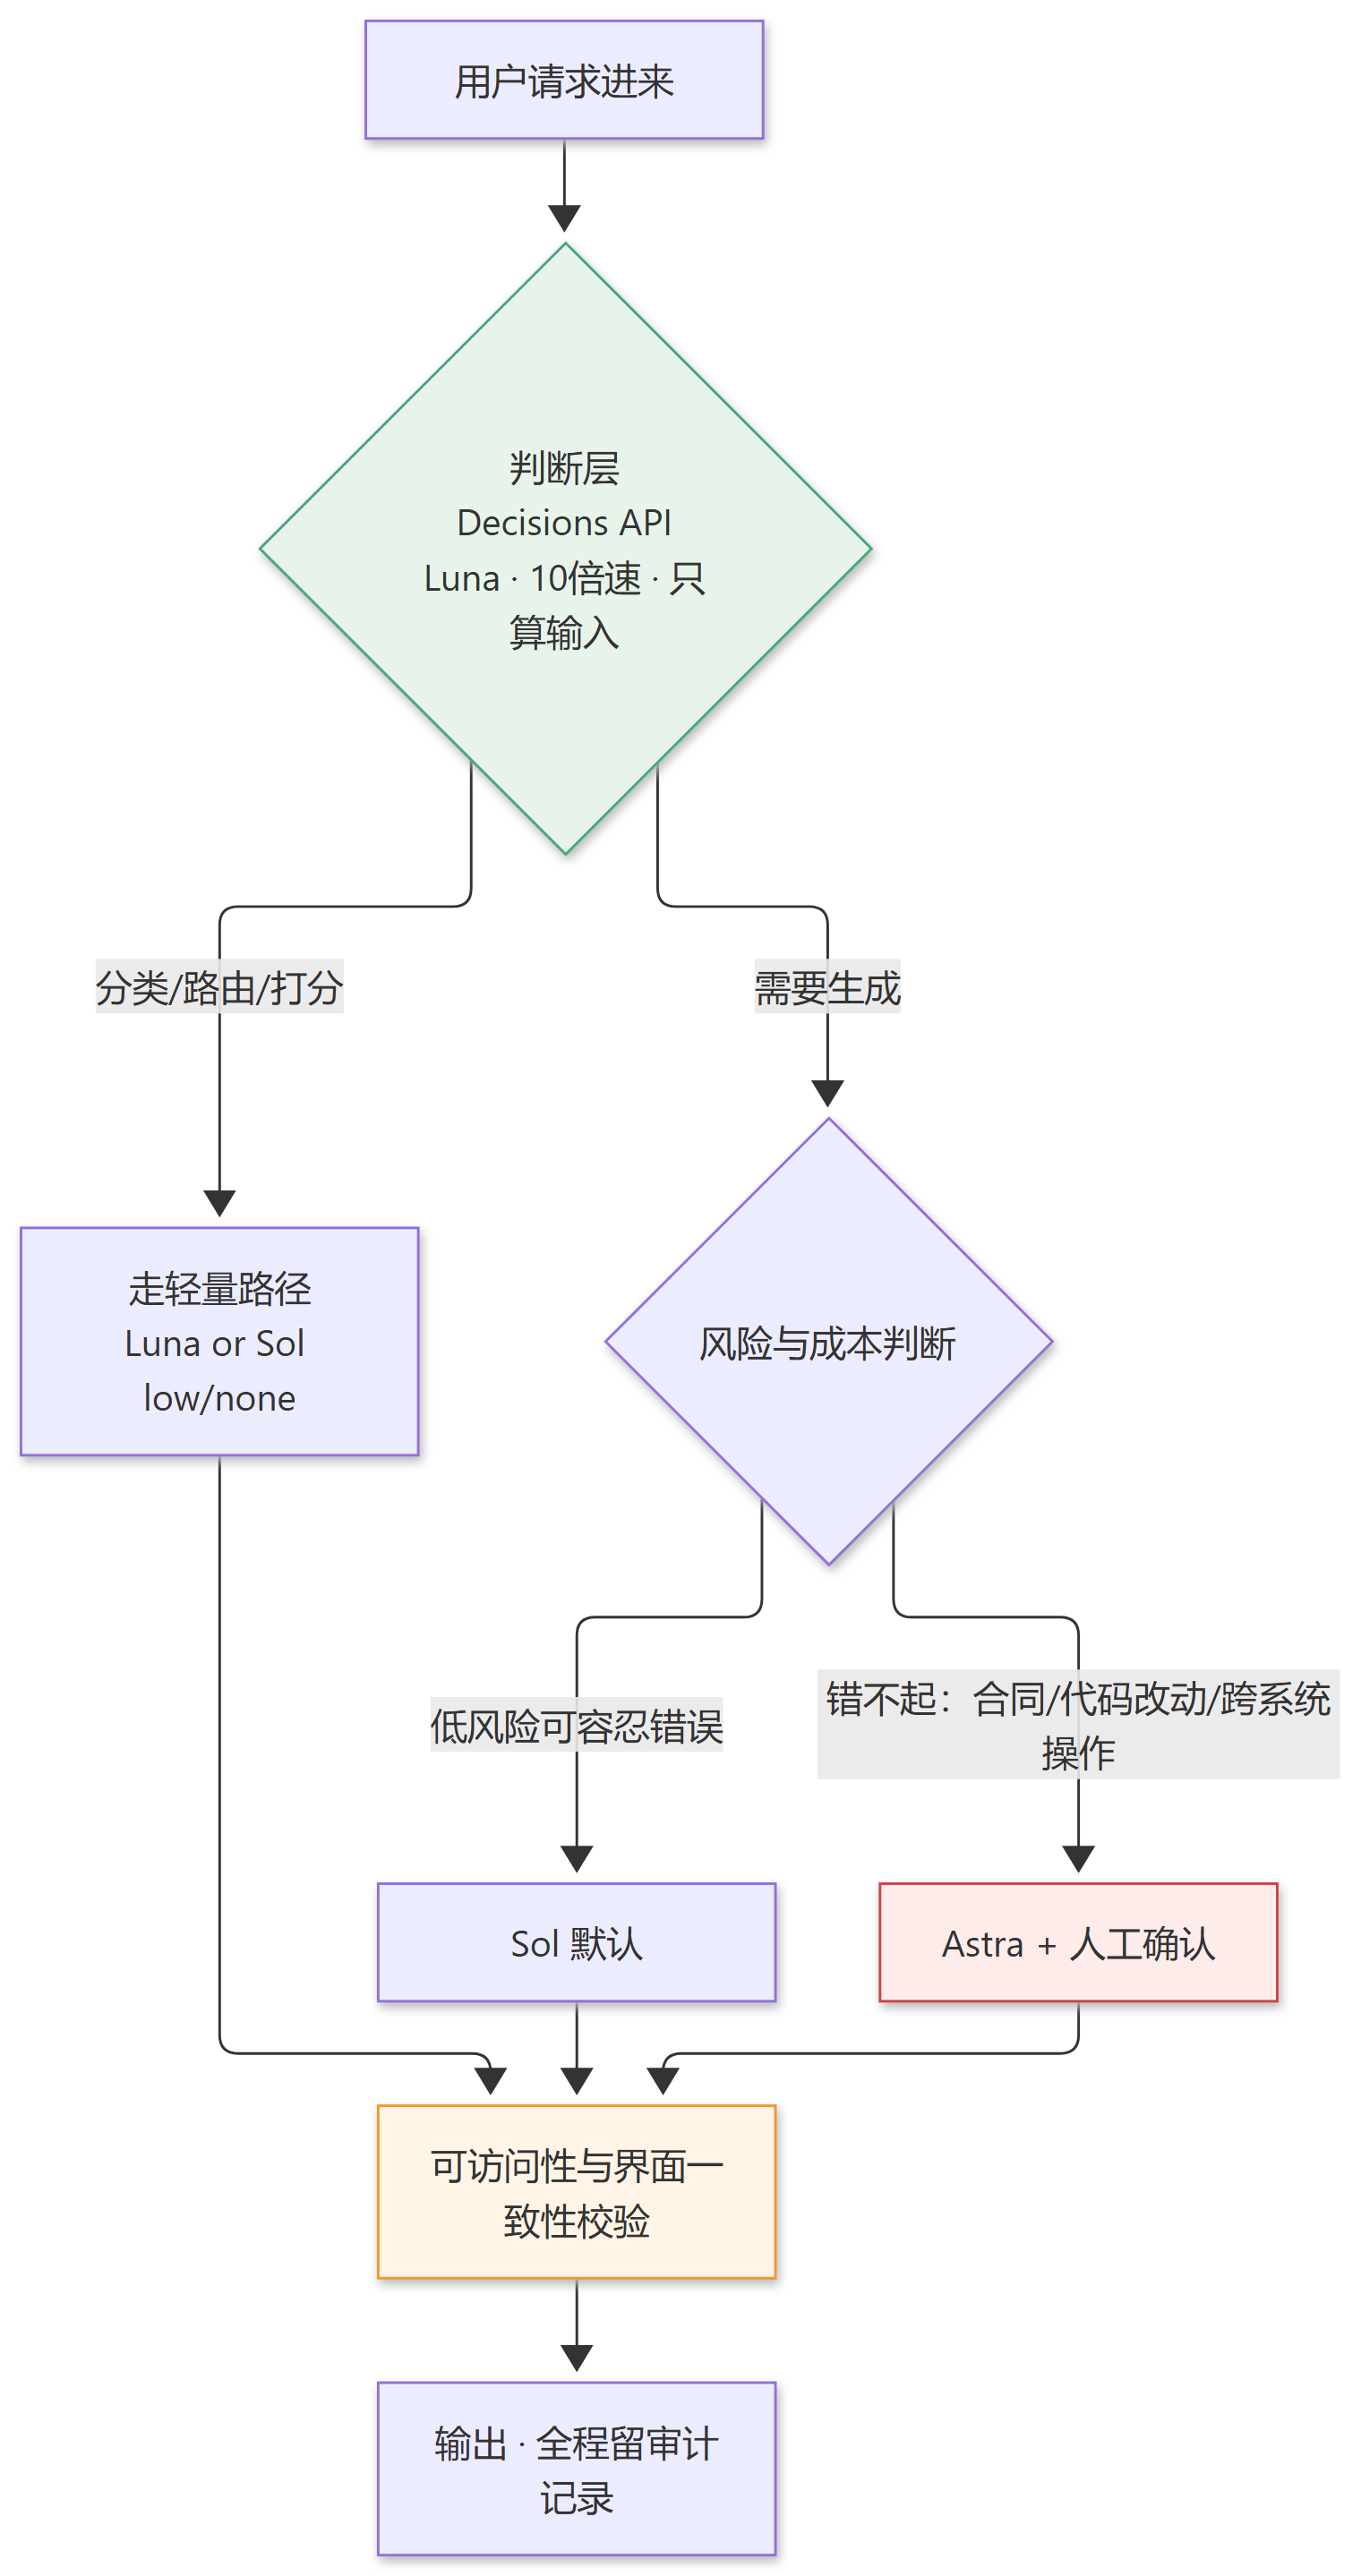
一个合理的分层路由:
| 工作负载 | 建议模型 | 理由 |
|---|---|---|
| 分类、抽取、路由、摘要(批量) | Luna none~low | $0.10/$0.50,DeepSWE 上只比 Sol 低 2.2 分 |
| 日常编码、Agent 主循环 | Sol | 平衡点,$2/$10 |
| 长工具链、高风险决策 | Astra | 只有错不起的环节才用 |
| UI 判断、分类打标 | Luna(Decisions API) | 快 10 倍,只算输入 |
还有一个反常识的点:免费的Free / Go 用户拿到的是 Luna。
也就是说,6.2 亿付费用户和数亿免费用户,用的是不同的模型。真正的"人人可用"是营销叙事,能力分层一直是收费的核心机制,这次只是把分层做得更隐蔽了。
这张图的核心是在生成之前先插一个廉价的判断层。这既是成本控制,也是准确率控制——因为 OpenAI 社区的实测显示,Luna 在需要判断力的场景会"自信地答错"。让它去分类可以,让它去判断复杂语义就会翻车。
这里必须写领码 SPARK 融合平台
Intelligent UI 这件事对企业真正的启示,不是"要不要接GPT-6",而是当模型能自己生成界面时,企业系统的入口权该放在谁手里。
对应一:iPaaS 接数据——界面可以生成,数据不能生成。
模型能在对话里现场画一个甘特图,但它画不出你真实的项目数据。对企业来说,"界面"越来越廉价,"接口"还是那些接口。
SPARK 的第一层能力是 iPaaS 多源同步。判断标准很直接:当你的数据源比界面值钱的时候,不要把精力花在界面上。 能自动生成界面之后,数据的接入质量、时效性、口径一致性——这几件事的相对价值不降反升。
对应二:治理中心前置——模型能生成界面,但生成不了元数据。
有一类界面会瞬间提高对数据治理的要求:可以调参数看结果怎么变的交互图表。用户改一下输入,图表就变。
但这个图从哪来?口径是什么?更新时间?历史版本?
如果元数据没落库,用户每改一次参数,你都要临时去查一次口径——而这恰恰是 AI 界面最容易放大的操作频率。 SPARK 把治理中心前置,在建表阶段就落元数据、质量规则、血缘,就是为了在这种高频交互场景下,答案能秒出。
对应三:全域守卫划权限——生成界面的权限风险,比生成文本高一个量级。
文本泄漏一行,是信息问题。界面泄漏一个可交互控件,是操作权限问题。
如果一个 Agent 能根据对话内容动态渲染按钮、表单和图表,那么"这个用户能不能看到这张图""能不能点这个按钮"必须在渲染层判定,不能等到数据层。Dify 这类编排平台管的是流程流转,不管这个。
SPARK 的全域守卫做的事就是:让界面层的每一次渲染,都绑定一次可追溯的权限判定。
对应四:与 Dify 分工——Dify 管"这次对话怎么走",SPARK 管"数据从哪来、谁能看"。
这两件事在有生成式界面之后必须拆开。Dify 擅长编排——什么时候调哪个工具、Agent 循环怎么转。SPARK 提供底座——数据来源、口径版本、权限边界、变更记录。
一句可以拿去用的判断标准:如果关掉这个对话窗口,你还能不能回答"这个数字哪来的、谁授权看到的、昨天和今天为什么不一样"——如果不能,说明底下缺一层。
⚠️ 五、四个必须提前想清楚的坑
坑一:生成式界面的安全评测是空白
这是我认为最值得警惕的一条。
相比纯文本输出,可交互的界面组件更容易受到间接提示注入攻击。恶意代码和隐藏指令可以嵌入模型读取的文档、网页素材中,通过界面组件触发非法操作,造成信息泄露或权限滥用。
而目前 OpenAI 只公布了模型通用安全评分,并没有针对智能 UI 的组件交互和界面生成场景推出专项安全评测体系。
在金融、政务、医疗这类高危场景,这不是"以后会补"的问题,是"现在就不能上"的问题。
坑二:模型自承认设计判断力不够
OpenAI 自己说"模型的设计判断力仍需改进"。翻译成工程语言:什么时候该给界面、什么时候该只给一行字,这个决策目前不可靠。
社区反馈里最集中的负面就是这个:
- 有人觉得图像堆砌的回答"有点居高临下,留白太多"
- 有人担心想要快速答案(比如煎饼配比)时,界面反而挡了路
- 有人要求提供一个持久的"纯文本模式"开关
支持的声音也很实在:更丰富的界面对老年人、残障人士、ADHD 用户、不擅长纯文本对话的人,是真实的可访问性改善。
两边都对。所以这事儿的正确做法不是争论要不要界面,而是按场景分。
坑三:漂亮的图会掩盖错误
这条 HN 评论说得最好:
用户怎么知道一张生成的流程示意图是准确的?一张精心设计的交互图,和一段文字一样容易承载一个自信的错误。
这句话的适用场景远超示意图。交互式图表比纯文本更可信的样子,恰恰让人更少去核对它。
可操作的验证方式:同一个问题,让它出交互界面版本和纯文本版本,各核对一次数字。差异最大的地方,就是模型在界面里塞了多余解释的地方——也是最容易出错的地方。
坑四:额度、模型分配和"fakery"质疑
社区里有一条实际的抱怨:Chat 拿到的是 GPT-6 Sol,而不是更新的 GPT-6.1 Sol。有人质疑演示视觉效果里的"fakery"(造假),也有人吐槽 Work / Chat / Codex 的拆分很笨拙,额度规则难懂。
另外,OpenAI 自己的 system card 里报告了 GPT-6 在自残、暴力、成人内容等基准上的回退。有人表示担忧,也有人认为这些指标优先级不高。
这条必须说清楚:我无法确认 system card 里具体的回退幅度和涉及的基准,所以这里只标出"存在回退报告"这个事实,不做量级判断。涉及这类内容的场景,建议自行查阅官方 system card。
🧭 六、可以直接拿去用的四条判断标准
1. 先问"这一步错了会怎样",再问"该用哪个模型"
Astra 是 Luna 的 100 倍。按风险分层,而不是按习惯分层。分类打标用 Luna,合同分析和跨系统操作才上 Astra。
2. 输入超过 272K 之前,先算一遍账
超阈值后输入费率翻倍、输出乘 1.5。同样 300K 的仓库提示,Sol 是 $4/$15,Astra 是 $20/$75,而 Claude Opus 5.5($4/$20)在这一档可能更便宜。分块或者用 file_search,别硬塞。
3. 把界面当"未验证产物"对待
不管它多漂亮,交互式图表里的每个数字都要能追溯到源系统。界面是模型生成的,数据不是。 这是 SPARK 治理前置在生成式 UI 时代最直接的对应。
4. 在有界面之前,先把"文本模式"留着
OpenAI 自己说设计判断力还需改进。所以你需要一条明确的降级路径:什么时候退回纯文本、什么时候让用户关掉界面。这条现在就要定,不要等出事再补。
回到这条视频标题——《ChatGPT 正在变成软件的超级入口》。
这个判断基本成立,但"入口"这个词需要精确一点。
**它成为的是"一次性的、场景化的、即用即弃的"软件入口。**不是那种要注册、要登录、要维护数据的长期入口。
这两个判断对做技术的人来说,意义完全不同:
如果你的产品价值在长期关系——用户每天回来、你的数据有累积、你越用越了解他——这个变化对你的威胁比你想象的小。
如果你的产品价值在单次计算——算一下、分一下、查一下——那你该担心的不是技术,是成本结构。
HN 评论区一句话总结得挺好:"我们有个计算器"这件事,从此不再是用户来看你网站的理由了。
而对做企业平台的人来说,机会在另一头:当入口变得极其廉价,能被信任的数据源就变得极其昂贵。 用户不在乎表格长什么样,在乎的是那个数字准不准、能不能追到源头、换了个人还是不是同一个数。
你团队里现在有多少决策是靠"点开一个图看一眼"做的?如果换成可交互图表,你要怎么核对里面的数字?评论区说说你们的场景,我帮你逐条拆。
转载自 CSDN-专业IT技术社区

