

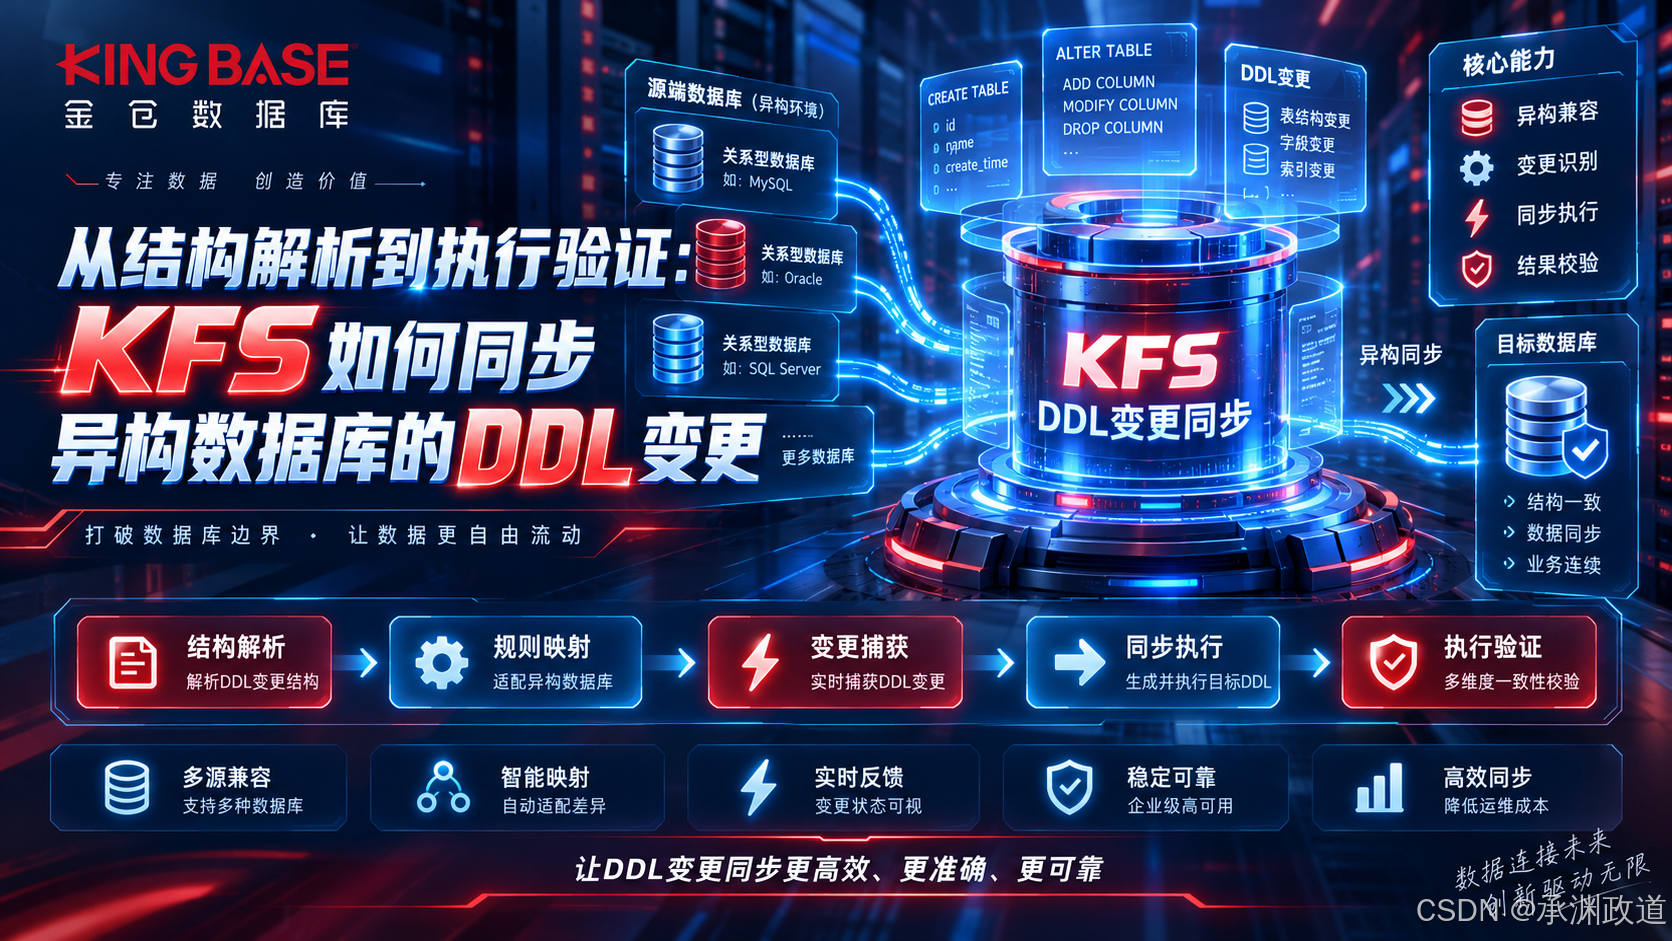
一条数据同步链路运行正常,并不意味着它能一直沿用最初的表结构.业务系统新增字段、调整类型、修改索引或增删约束后,源端与目标端都需要及时更新结构.否则,即使后续数据变化已经被捕获,也可能因为字段或类型不匹配而无法写入目标库.当同步涉及多种数据库时,结构变更还要跨过语法差异这一关.同样是增加字段,不同数据库使用的数据类型、默认值表达和语句格式可能并不一致.源端能够执行的DDL,也就是数据定义语言,直接交给另一个数据库未必能够执行.金仓介绍的某大型医院数据同步项目,就面临这样的情况:260 多条同步链路同时运行,源端涉及Oracle、MySQL、SQL Server、KES V8R6、Vastbase等 10多种数据库,并持续向目标库汇聚数据.如果每次结构变化都要由工程师分析SQL、编写转换规则、验证执行结果,再恢复链路,日常维护工作就会随着链路数量增加.KFS的DDL自动转换能力,将这些工作组织成一套连续的处理流程:识别结构变化、拆解操作内容、应用映射规则、生成目标端语句,最后检查执行结果.
一、先识别结构变化,再处理具体语句
DDL 转换首先需要弄清楚一条语句包含哪些操作。对于较简单的语句,字符串替换或正则匹配可以处理部分差异;但当一条 ALTER TABLE 同时包含字段类型修改、默认值设置和约束变更时,匹配条件会随之增加,规则之间也更容易相互影响。
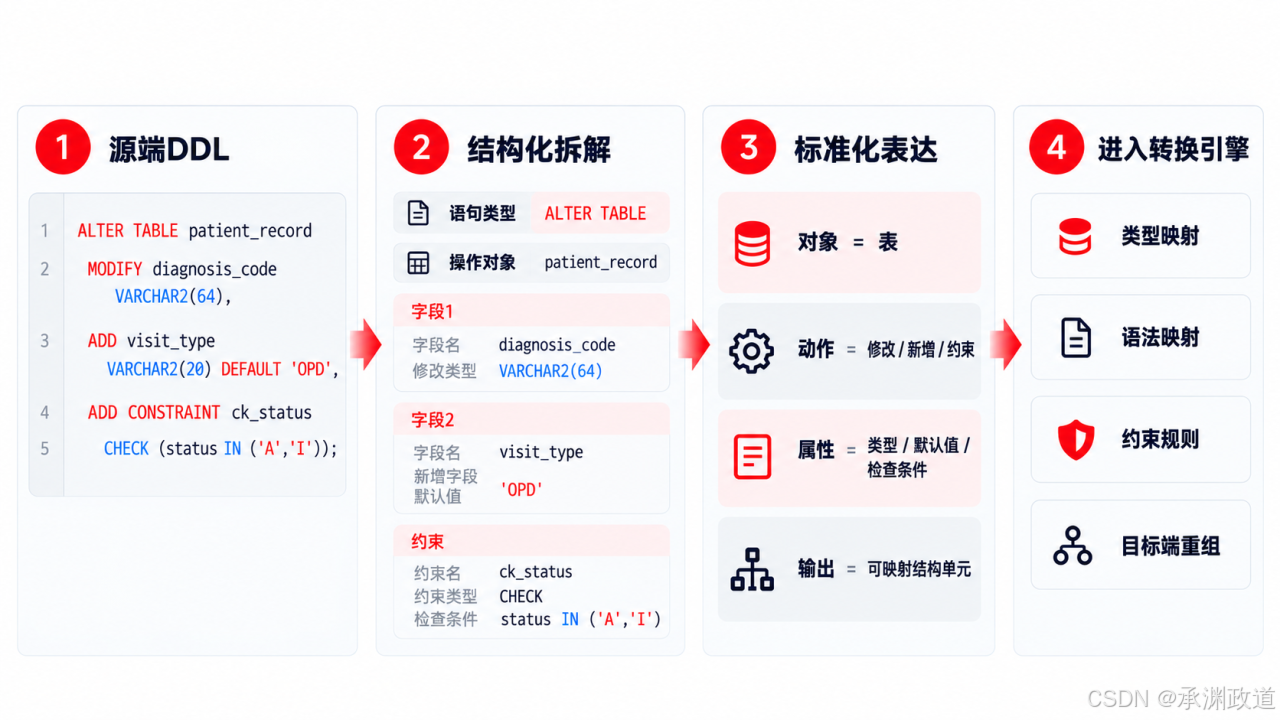
KFS 在源端增量解析过程中,先区分 DML 与 DDL。对于 DDL,再继续提取语句类型、操作对象、涉及的字段及其动作,并保留数据类型、默认值和约束等属性。
以案例中的 patient_record 表为例,一条结构变更示意语句包含以下操作。
| 结构单元 | 变更内容 | 需要保留的信息 |
|---|---|---|
字段 diagnosis_code | 修改字段类型 | 源端类型 VARCHAR2(64) |
字段 visit_type | 新增字段 | 源端类型 VARCHAR2(20),默认值为 'OPD' |
约束 ck_status | 新增检查约束 | 检查条件为 status IN ('A', 'I') |
拆解之后,转换引擎可以分别处理表对象、字段动作及相关属性。源语句的内容被整理成可映射的结构单元,后续规则便有了明确的作用对象。
二、通用差异使用内置规则,业务差异按链路配置
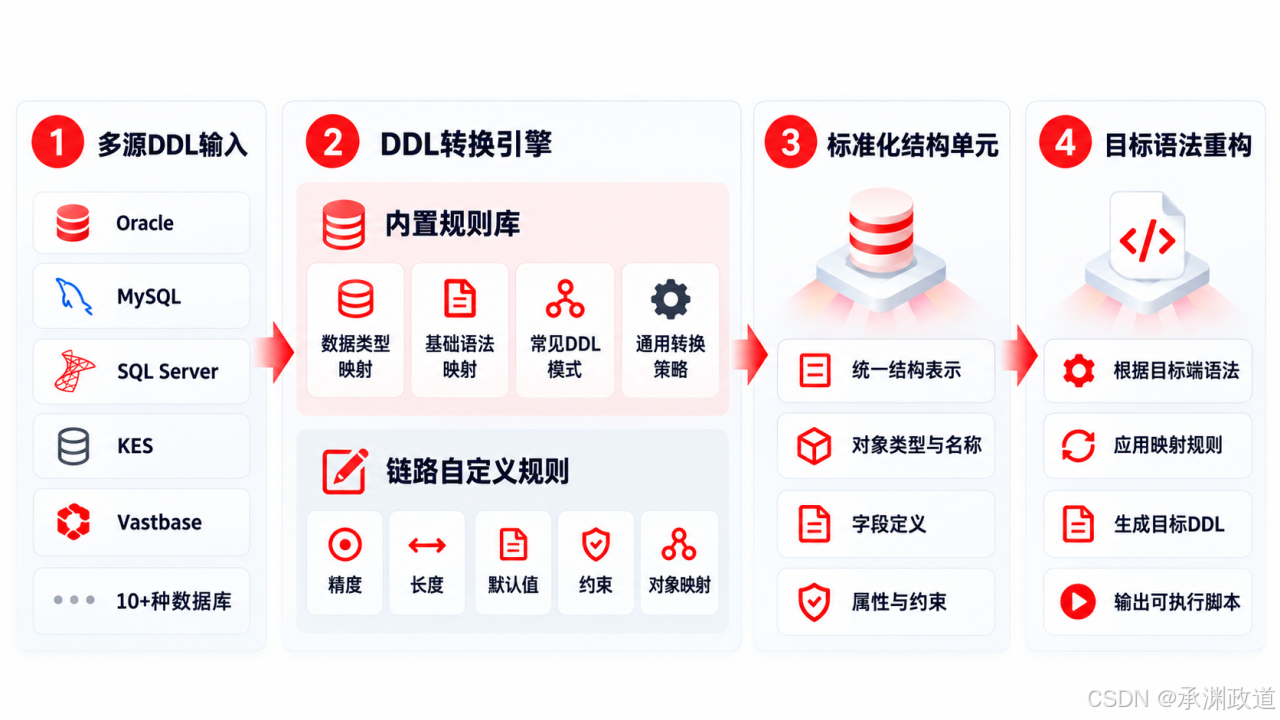
多条同步链路之间,有不少转换工作是重复的。例如,一种源端数据类型应当怎样映射到目标端,某类基础 DDL 操作应当采用什么语法表达。这些差异相对稳定,适合沉淀为通用规则。
KFS 内置了数据类型映射和基础语法映射规则,转换引擎可以复用这些规则处理常见情况。在连接多个业务系统的项目中,这能够减少逐条链路重复配置相同映射关系的工作。
业务系统也会带来各自的要求。字段精度、长度、默认值、特殊约束和对象名称等内容,可能需要结合具体链路处理。KFS 因而同时提供链路自定义规则,用于补充通用映射无法覆盖的项目差异。
按照案例介绍,KFS 已覆盖建表、字段新增与删除、字段修改、表和字段重命名、索引变更,以及约束增删和启停等常见结构变化。在该项目的典型 DDL 样本中,约 95% 的常规变化可以直接进入自动转换;少量包含特殊默认值、复杂约束或业务定制逻辑的 DDL,仍需要人工补充规则。
这里的自动化程度与规则覆盖范围直接相关。重复出现的基础差异交由内置规则处理,项目特有的部分由链路规则补充,能够让规则维护更有针对性。
三、按照目标端语法重新组织 DDL
识别出结构变化、完成属性映射后,还需要把结果表达为目标数据库能够接受的语句。
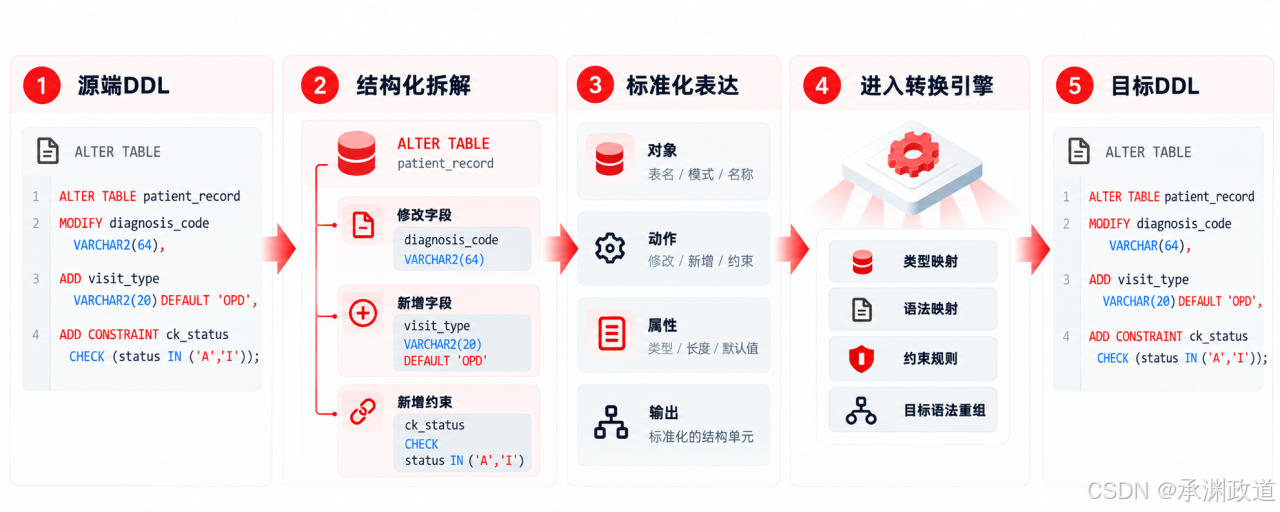
KFS 根据目标端的语法结构,重新组织操作对象、字段动作、数据类型及相关约束,生成目标 DDL。源端语句的写法与目标端语句的生成,通过中间的结构信息和映射规则连接起来。
仍以 patient_record 表的变更为例,转换过程中需要明确三件事:diagnosis_code 要修改成什么类型,visit_type 应当如何新增并设置默认值,以及 ck_status 的检查条件应当怎样表达。这些信息经过映射后,再按目标端支持的语法重组为相应语句。
这样的处理方式,将源端解析和目标端生成分成了不同环节。当源端写法更复杂,或需要适配更多数据库时,可以围绕结构解析、映射规则和目标语法分别调整,减少整条 SQL 字符串之间的直接耦合。
在案例的执行示意中,源端集中描述的类型修改、新增字段和新增约束,被组织为目标端相应的 ALTER TABLE 语句。转换过程保留的是结构操作的含义,最终表达则服从目标数据库的语法要求。
四、执行成功之后,结构同步才算完成
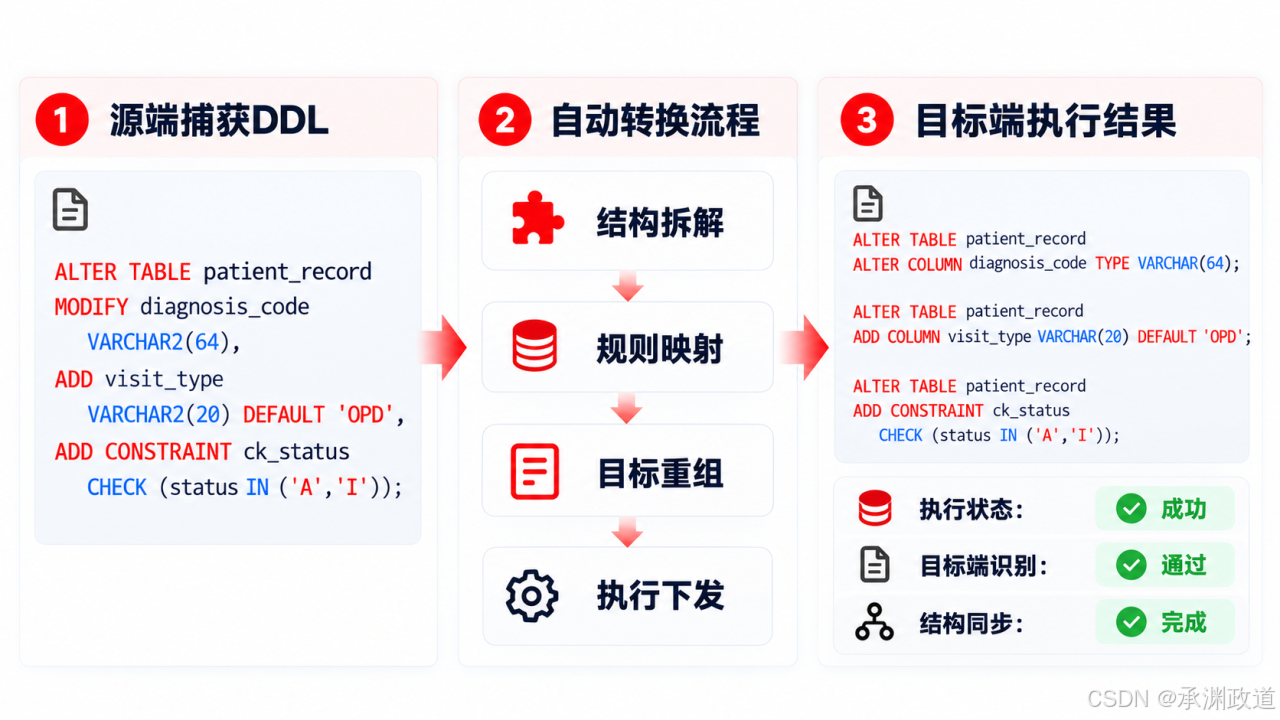
生成目标 DDL 后,转换流程还需要继续向前。KFS 会将语句下发到目标库执行,并检测执行结果。执行成功,意味着本次结构变化已经同步完成,后续 DML 可以按照更新后的表结构继续写入;执行异常时,则捕获错误信息,供后续处理。
对于当前规则无法转换的 DDL,案例中描述的处理方式是保留原始 DDL 并跳过。这个状态需要与“结构同步成功”明确区分:如果后续 DML 依赖这次尚未完成的结构变化,链路会中断,转入人工干预。
因此,自动转换流程既包含正常执行路径,也包含无法转换或执行异常时的处理。能够确定转换结果的操作由系统完成,暂时无法处理的变化则保留信息并暴露问题,避免不确定的转换结果在目标端继续执行。
在该项目典型场景的抽样验证中,经过自动转换的常规 DDL,目标端一次执行通过率达到 98% 以上。这个比例衡量的是已自动转换语句的执行表现,与前面约 95% 的常规变化可进入自动转换,分别对应流程中的不同阶段。
五、让重复的结构适配工作随链路规模复用
260 多条链路长期运行时,结构变更会成为持续发生的维护事项。一次手工转换可以解决眼前的问题;把反复出现的类型和语法差异整理成规则,才能减少后续相似变更中的重复劳动。
KFS 将 DDL 同步拆成可连续处理的步骤,使通用规则可以在多条链路中复用,同时为特殊业务保留自定义配置和人工处理路径。工程师的工作也因此可以更多集中在通用规则尚未覆盖的变化,以及需要结合业务判断的异常上。
对异构数据同步项目而言,观察自动化效果,需要同时看转换规则能够覆盖哪些变化,以及生成的语句能否在目标端正确执行。结构解析、规则映射、目标语法重构与执行结果检查共同完成这一过程,才能让后续数据写入继续使用匹配的表结构。

敬请期待下一篇文章内容
每日心灵鸡汤: 放下攀比与浮躁,专注自己的成长!
放弃不属于自己的东西,放下不切实际的空想与浮躁.不必羡慕别人的成绩而盲目攀比,把精力收回到自己的课本和错题,不属于你的捷径,再诱人也别追寻,踏实抓好当下,才是成长的底气;舍弃无用的娱乐,守住学习的初心,专注自身节奏,稳步追赶目标方向.轻装上阵前行,方能收获属于你的光亮.
转载自 CSDN-专业IT技术社区
原文链接:https://blog.csdn.net/2401_87629362/article/details/167922096

