


Python + Django 旅游数据推荐系统:爬虫采集、可视化与协同过滤实战
本文复盘一个基于 Python、Django 与 MySQL 的旅游信息采集和推荐系统:以去哪儿网景点信息为示例数据源,介绍数据采集、入库、分析展示和基于用户的协同过滤流程,并结合项目页面与核心代码说明实现思路。
一、项目背景与目标
旅游信息分散在不同页面,手动查找景点资料、价格和评价比较耗时。这个项目尝试把旅游数据采集、结构化存储、统计展示和个性化推荐放进一个 Web 系统中,形成从数据进入系统到用户查看结果的完整流程。
项目材料中展示的采集来源是去哪儿网。需要说明的是,网页结构和接口会变化,本文中的采集逻辑是项目实现示例,不代表当前仍可直接运行,也不代表覆盖所有旅游平台。
二、技术栈与系统流程
| 环节 | 项目使用的技术 | 作用 |
|---|---|---|
| 数据采集 | Python、requests、XPath | 请求页面或数据接口,抽取景点信息与详情 |
| 数据处理 | Python | 对采集结果进行整理,并处理缺失评分、评论等字段 |
| 数据存储 | MySQL 8.0 | 保存景点及相关旅游数据,供后续查询和分析 |
| Web 服务 | Django | 提供用户端页面、业务流程和后台管理入口 |
| 推荐计算 | NumPy、余弦相似度、协同过滤 | 根据用户评分的相似程度生成候选景点 |
| 页面展示 | Bootstrap、图表与页面组件 | 展示景点信息、统计结果和推荐内容 |
整体流程可以概括为:
去哪儿网示例数据
      ↓ requests 请求与 XPath 抽取
字段整理、缺失值处理
      ↓
MySQL 存储
      ↓ Django 查询与业务处理
统计图表、景点页面、用户推荐
三、旅游数据采集与入库
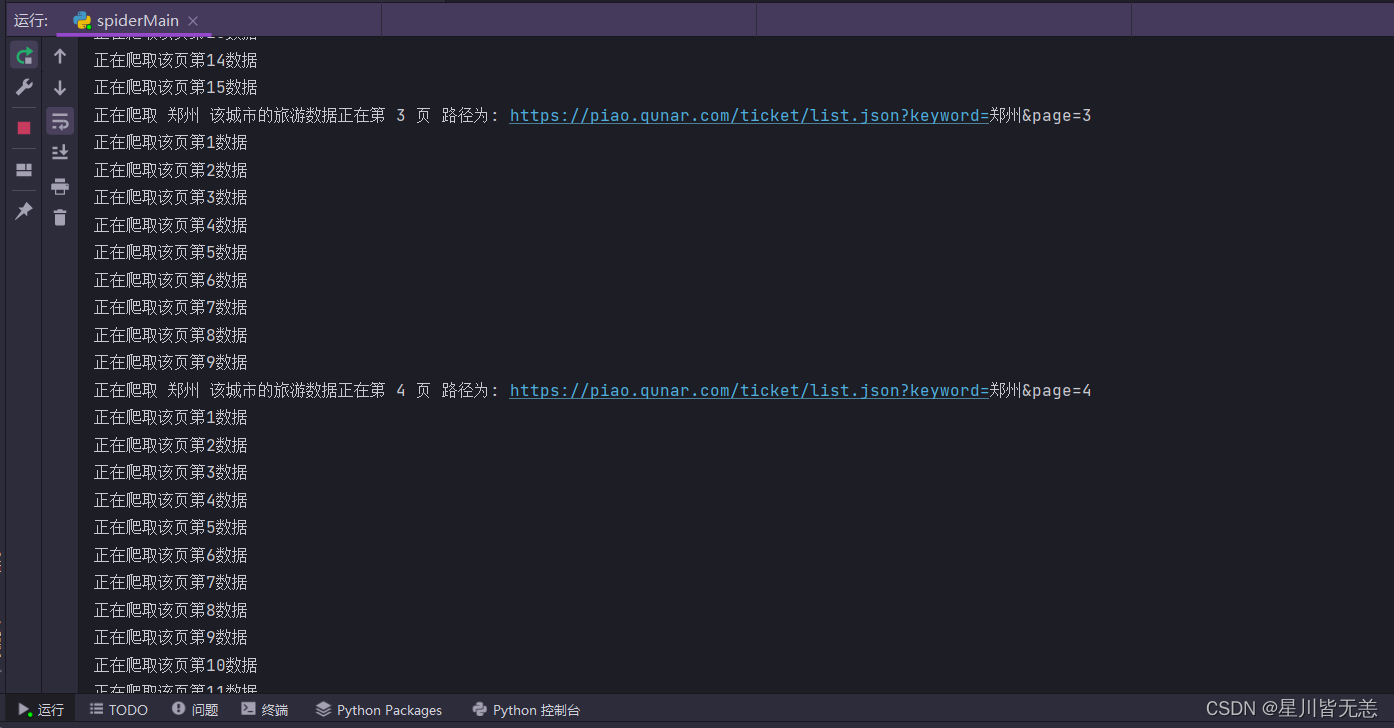
项目的爬虫围绕景点列表和详情页组织数据。列表数据中包含景点名称、地址、简介、价格、销量、等级、图片和景点 ID;随后根据景点 ID 请求详情,补充评分、评论数量、景点介绍、图片及评论内容。部分页面没有评分或评论时,代码会尝试设置默认值或跳过异常数据。
原项目中的核心逻辑示例如下,字段名和页面选择规则对应当时的项目代码:
def spiderMain(self, resp, province):
    resp_json = resp.json()['data']['sightList']
    result_data = []

    for index, travel in enumerate(resp_json):
        print('正在爬取该页第%s条数据' % (index + 1))
        time.sleep(2)

        detail_address = travel['address']
        discount = travel['discount']
        short_intro = travel['intro']
        price = travel['qunarPrice']
        sale_count = travel['saleCount']
        title = travel['sightName']
        cover = travel['sightImgURL']
        sight_id = travel['sightId']

        detail_url = self.detailUrl % sight_id
        detail_html = etree.HTML(self.send_request(detail_url).text)
        score = detail_html.xpath(
            '//span[@id="mp-description-commentscore"]/span/text()'
        )
        # 后续继续提取详情、图片和评论,并整理为待入库数据
爬取完成后,项目通过 spiderObj.start() 启动采集,再调用 spiderObj.save_to_sql() 保存数据。实际运行前需要确认数据库连接配置、字段映射及目标页面结构;页面选择器失效时,应先更新解析规则并检查异常记录。
采集和入库过程截图:

四、基于用户的协同过滤推荐
项目给出的推荐示例以用户评分字典为输入:先取目标用户的评分,再把其他用户在相同景点上的评分转换为向量,使用余弦相似度计算用户间相似程度;接着选出相似用户,并把他们评分过、但目标用户尚未评分的景点作为推荐候选。
from sklearn.metrics.pairwise import cosine_similarity
import numpy as np

def user_based_collaborative_filtering(user_id, user_ratings, top_n=20):
    target_ratings = user_ratings[user_id]
    target_items = list(target_ratings)
    target_vector = np.array([target_ratings[item] for item in target_items])
    similarity_scores = {}

    for other_user, ratings in user_ratings.items():
        if other_user == user_id:
            continue
        other_vector = np.array([ratings.get(item, 0) for item in target_items])
        similarity_scores[other_user] = cosine_similarity(
            [other_vector], [target_vector]
        )[0][0]

    similar_users = sorted(
        similarity_scores.items(), key=lambda item: item[1], reverse=True
    )[:top_n]
    candidates = set()
    for similar_user, _ in similar_users:
        candidates.update(user_ratings[similar_user])

    return [item for item in candidates if item not in target_ratings]
这段逻辑适合说明推荐流程,但它返回的是候选景点集合,并没有按相似度加权、预测评分或保证结果排序。真实业务中还要处理冷启动、评分稀疏、候选去重与排序,并根据当前数据结构验证用户和景点标识的一致性。项目页面展示了推荐模块,具体效果取决于数据库中的评分数据和实际调用链。

五、系统页面与可视化
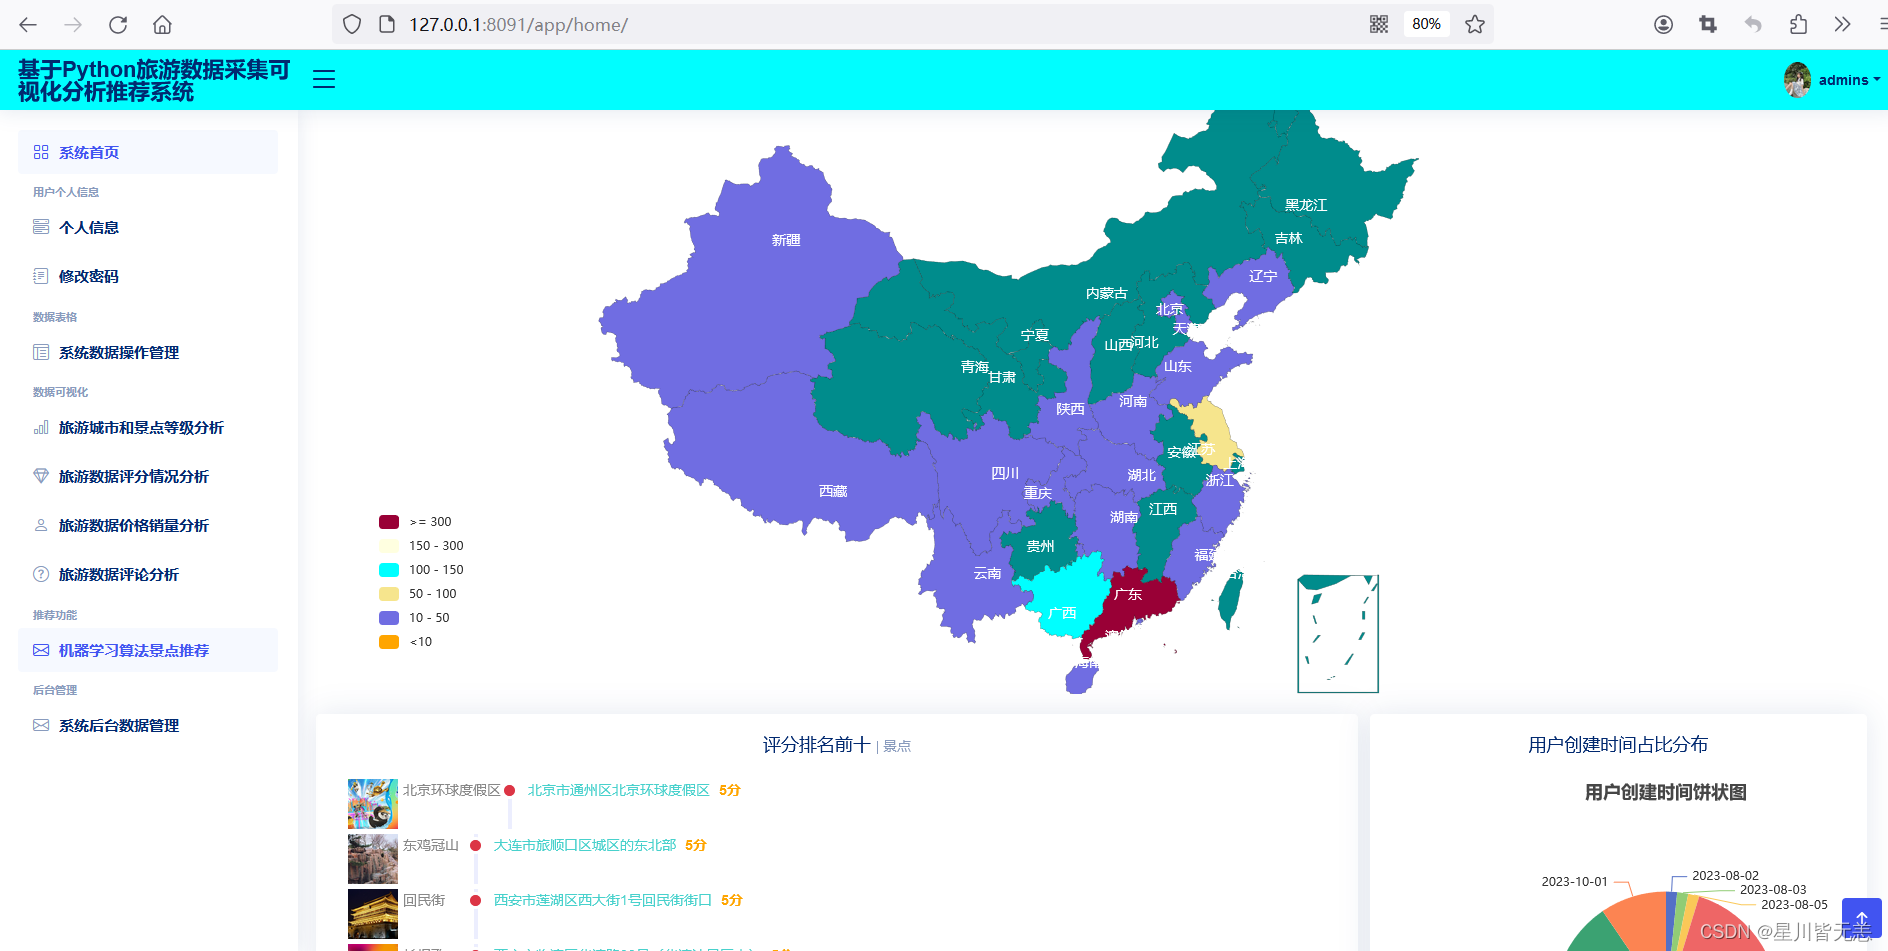
项目页面覆盖用户注册登录、景点信息浏览、数据操作管理、价格与销量分析、城市和景点等级分析、评分与评论统计、景点评价以及推荐页面;Django 管理后台用于查看和维护系统数据。下图为原稿中的页面记录,展示内容以项目当时的运行环境为准。
用户入口与首页



数据分析与用户反馈


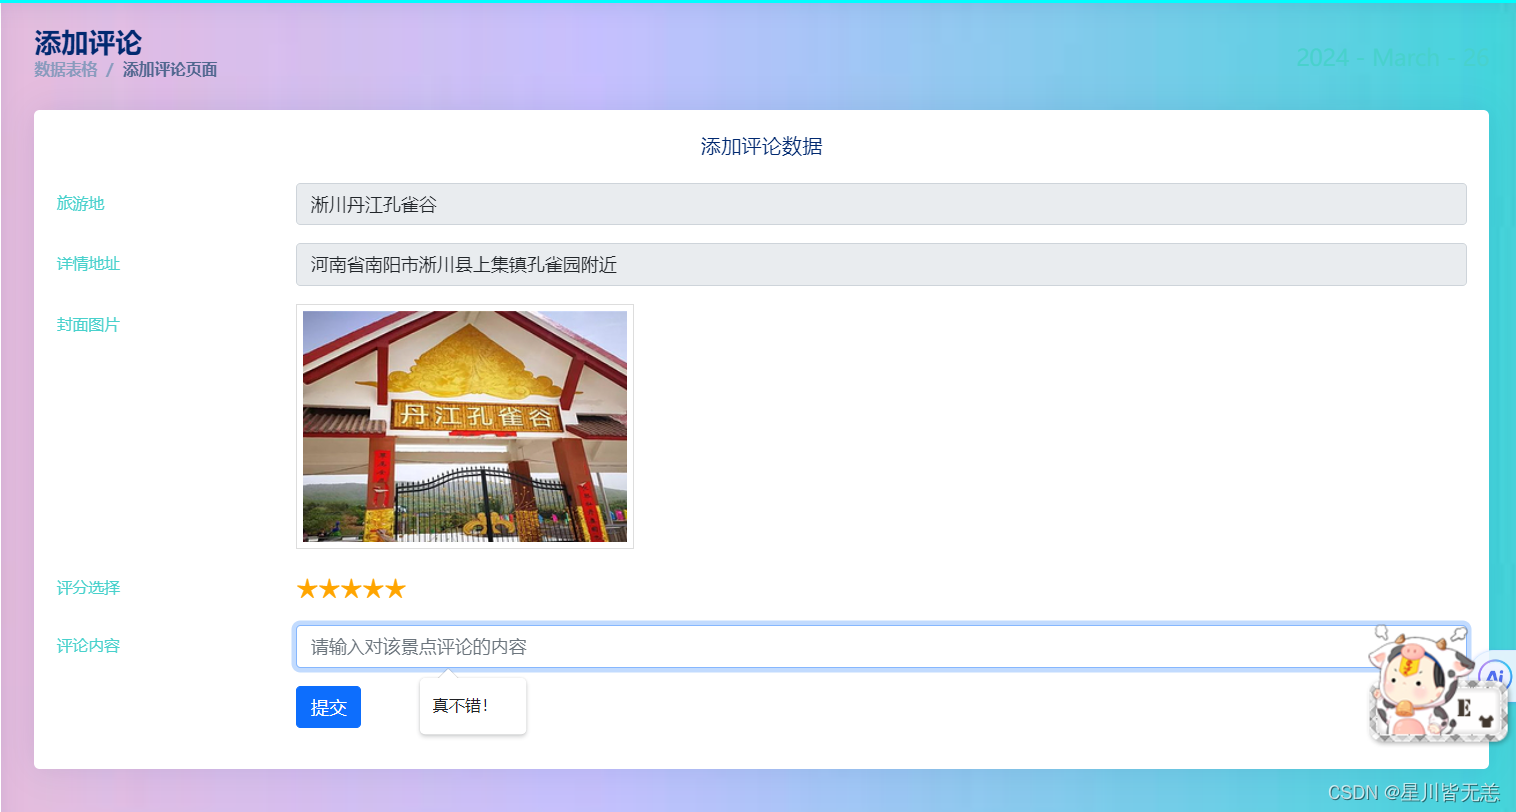

Django 管理后台
项目原稿记录的本地开发入口为:
http://127.0.0.1:8091/admin


六、开发环境与运行提示
原项目记录的环境为 Python 3.9.0、Django、MySQL 8.0.26 和 Windows 10,开发工具为 PyCharm 2021.2.1。项目通过 Django 开发服务器在 8091 端口运行:
python manage.py runserver 8091
运行前需在本地项目中准备 Django 配置、数据库连接和依赖包;原稿没有提供可复现的完整依赖清单或数据库初始化脚本,因此这里不补写未经确认的安装命令。runserver 适用于开发调试,不应直接视为生产部署方案。
七、结语
如需项目源码文档解析等资料/解析/商业合作/交流探讨~等可以评论留言/添加下面个人名片,感谢各位的喜欢与支持!
后面有时间和精力也会分享更多优质内容,喜欢的小伙伴可以点赞收藏加关注,感谢各位的喜欢与支持!
源码文档等资料
如需项目源码、部署文档、功能解析、二次开发、界面优化、项目定制、课程设计或毕业设计辅导,可通过评论区、私信或个人主页方式交流。支持全栈系统开发与技术咨询。
转载自 CSDN-专业IT技术社区
原文链接:https://blog.csdn.net/Myx74270512/article/details/168656540

